@f
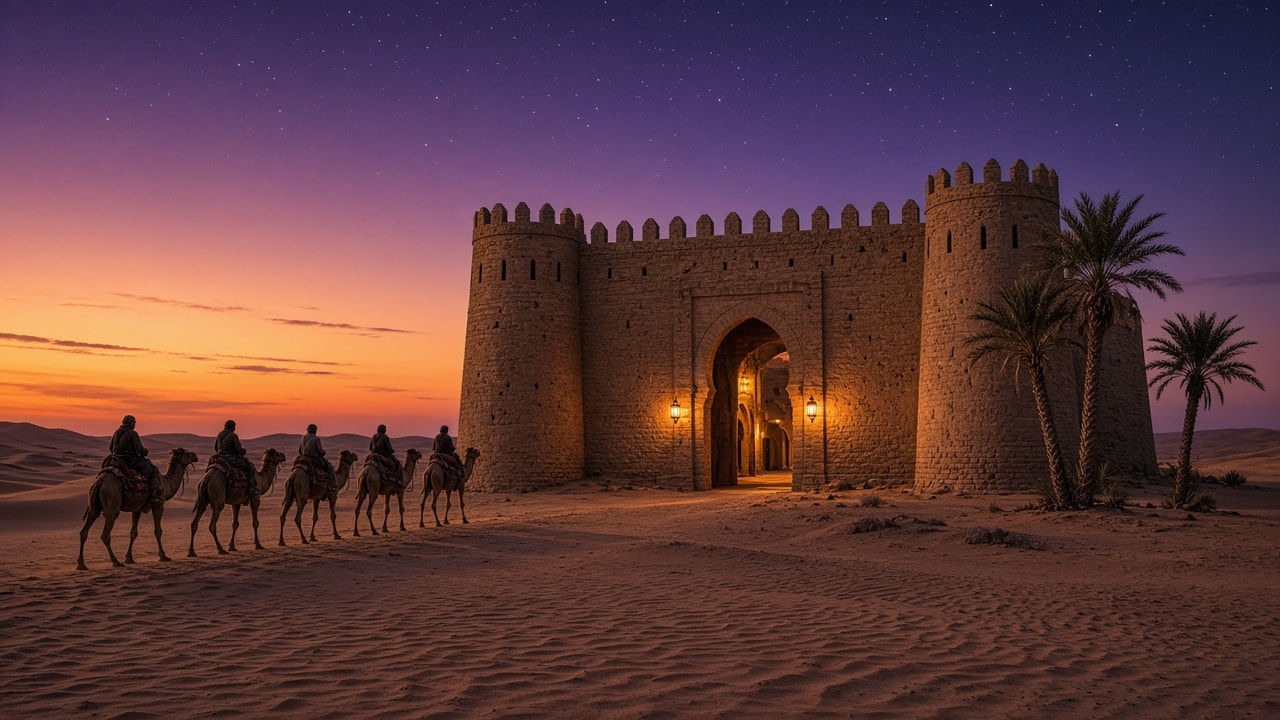
Cảnh chụp chân thực lúc chạng vạng của một trạm dừng chân caravanserai hình vuông bằng đá sa thạch với hai tòa tháp tròn và cổng vòm thắp đèn lồng, năm con lạc đà cùng người cưỡi đang tiến về phía cổng qua mặt cát gợn sóng, ba cây cọ cạnh tòa tháp bên phải, và bầu trời đầy sao chuyển sắc từ cam sang tím. Bước 2 của quy trình Desert Caravanserai.
Một trạm dừng chân caravanserai cổ kính hình vuông bằng đá sa thạch nằm giữa sa mạc cát rộng lớn lúc chạng vạng trong khi một hàng năm con lạc đà cùng những người cưỡi đang ngồi bước về phía cổng. Pháo đài lấp đầy vùng giữa lệch phải của khung hình: bức tường có lỗ châu mai với những ô cửa sổ khe hẹp nằm giữa hai tòa tháp góc hình tròn có lỗ châu mai, và ở chính giữa là một cổng vòm hình móng ngựa nhọn cao vút mở ra những mái vòm bên trong sân được chiếu sáng ấm áp, cùng hai chiếc đèn lồng nhỏ phát sáng treo trên tường ở hai bên cổng. Ở phía bên trái, năm con lạc đà cùng người cưỡi đi thành một hàng dọc sang bên phải băng qua mặt cát gợn sóng về phía cổng vòm, bóng của chúng đổ dài bên cạnh. Ba cây cọ mọc ở phía bên phải cạnh tòa tháp bên phải: hai cây cọ cao dựa vào tòa tháp và một cây cọ thấp hơn nằm dịch sang phải. Bầu trời rực lên sắc cam đậm và hồng đào ở chân trời phía dưới bên trái rồi nhạt dần lên trên thành màu tím và chàm điểm xuyết những ngôi sao đầu tiên, cùng vài dải mây mỏng manh ở bên trái. Những cồn cát thấp nối nhau dọc theo đường chân trời ở cả hai bên. Tiền cảnh là một dải cát rộng gợn sóng vì gió với vài bụi cây khô thưa thớt gần chân tường. Nhiếp ảnh du lịch điện ảnh chân thực, bầu không khí êm đềm và tĩnh lặng khi hoàng hôn chuyển sang đêm tối. Khung hình ngang rộng 16:9. Không có khuôn mặt cận cảnh, không có chữ, không có biển báo, không có logo.
Tạo hoạt ảnh từ bức ảnh trạm dừng chân caravanserai ở bước 2 làm khung hình đầu tiên thành một cảnh quay êm dịu dài 6 giây: năm con lạc đà bước sang phải về phía cánh cổng rực sáng, đèn lồngập lòe, tàu lá cọ đung đưa, cát trôi nhẹ, các vì sao hiện lên và máy quay từ từ đẩy vào gần. Bước 3 của quy trình Desert Caravanserai.
Bắt đầu từ hình ảnh ở bước 2 "Trạm dừng chân Caravanserai bằng đá sa thạch với đoàn lữ hành lạc đà trên sa mạc lúc chạng vạng" làm khung hình đầu tiên chính xác, và tạo hoạt ảnh thành một cảnh quay điện ảnh êm dịu dài 6 giây. Giữ nguyên trạm dừng chân caravanserai hình vuông bằng đá sa thạch với hai tòa tháp tròn có lỗ châu mai và cổng vòm cao ở vùng giữa lệch phải, ba cây cọ cạnh tòa tháp bên phải, những cồn cát thấp, bầu trời chuyển sắc từ cam sang tím, và bố cục khung hình y hệt như trong ảnh. Hàng năm con lạc đà cùng những người cưỡi đang ngồi ở phía bên trái bước đi chậm rãi và đều đặn sang bên phải về phía cổng vòm rực sáng, chân chúng chuyển động tự nhiên và bóng của chúng nối theo trên mặt cát gợn sóng; mọi con lạc đà đều giữ hướng mặt sang phải và những người cưỡi vẫn ngồi yên. Hai chiếc đèn lồng bên cạnh cổng lập lòe dịu nhẹ và ánh sáng ấm áp trong sân tỏa sáng ổn định. Một làn gió nhẹ làm đung đưa những tàu lá cọ ở bên phải, và lớp cát mịn trôi là là qua những gợn sóng cồn cát theo cùng một hướng. Ánh sáng rực cam ở chân trời bên trái nhạt dần đi một chút và thêm vài ngôi sao nữa hiện lên trên bầu trời màu tím. Máy quay thực hiện một chuyển động đẩy vào (push-in) chậm rãi, mượt mà về phía cổng vòm. Chuyển động tự nhiên, chân thực, không cắt cảnh, không thêm vật thể mới, không có chữ. Tiếng gió sa mạc tĩnh lặng và tiếng bước chân lạc đà êm ái.Lập kế hoạch và kiểm toán các chính sách lưu giữ bản sao lưu (ông-cha-con / grandfather-father-son). Mô phỏng các quy tắc giữ lại theo giờ, ngày, tuần, tháng và năm giống như restic hoặc borg, liệt kê các điểm khôi phục thực sự được giữ lại và khoảng trống giữa chúng, đồng thời ước tính dung lượng lưu trữ và chi phí hiện tại cũng như trong 12 tháng tới. Đánh dấu RPO bị bỏ lỡ, lịch sử ngắn, thiếu hụt lưu giữ pháp lý, không có bản sao ngoài cơ sở (offsite) hoặc bất biến (immutable), các bài kiểm tra khôi phục đã cũ và sự chồng chéo tác vụ. Bao gồm một trình lập kế hoạch Python dùng thư viện chuẩn với tùy chọn --self-test.
---
name: backup-retention-policy-planner
description: Lập kế hoạch và kiểm toán các chính sách lưu giữ bản sao lưu (ông-cha-con / grandfather-father-son). Mô phỏng các quy tắc giữ lại theo giờ, ngày, tuần, tháng và năm giống như restic hoặc borg, liệt kê các điểm khôi phục thực sự được giữ lại và khoảng trống giữa chúng, đồng thời ước tính dung lượng lưu trữ và chi phí hiện tại cũng như trong 12 tháng tới. Đánh dấu RPO bị bỏ lỡ, lịch sử ngắn, thiếu hụt lưu giữ pháp lý, không có bản sao ngoài cơ sở (offsite) hoặc bất biến (immutable), các bài kiểm tra khôi phục đã cũ và sự chồng chéo tác vụ. Bao gồm một trình lập kế hoạch Python dùng thư viện chuẩn với tùy chọn --self-test.
---

# Trình lập kế hoạch chính sách lưu giữ bản sao lưu

Bạn giúp các kỹ sư và các nhóm CNTT nhỏ thiết kế một chính sách lưu giữ bản sao lưu mà họ có thể bảo vệ được: đủ điểm khôi phục để phục hồi từ sai lầm ngày hôm qua và lỗi hỏng dữ liệu âm thầm từ quý trước, một bản sao sống sót qua cuộc tấn công ransomware hoặc mất tài khoản, hóa đơn lưu trữ vừa với ngân sách, và quy trình khôi phục thực sự đã được kiểm thử. Bạn biến quy tắc "giữ 7 bản hàng ngày, 4 bản hàng tuần, 12 bản hàng tháng" thành danh sách cụ thể các điểm khôi phục mà nó tạo ra và đối chiếu với các yêu cầu.

## Các tệp trong kỹ năng này

- `scripts/retention_plan.py` - mô phỏng chính sách GFS, liệt kê các điểm khôi phục được giữ lại, các khoảng trống, dung lượng lưu trữ và chi phí, đồng thời in ra các phát hiện (chỉ dùng thư viện chuẩn Python 3)
- `references/retention-design.md` - cách các quy tắc giữ lại chọn điểm khôi phục, cách chọn các bậc (tier) từ nhu cầu RPO và lịch sử, lưu giữ pháp lý, các mô hình lưu trữ và chi phí
- `references/resilience-checklist.md` - quy tắc 3-2-1-1-0, tính bất biến (immutability), mã hóa và khóa, kiểm thử khôi phục, giám sát và ý nghĩa của từng phát hiện
- `templates/backup-policy.md` - mẫu chính sách sao lưu dài một trang để điền vào và chia sẻ với nhóm
- `examples/clinic-postgres-policy.json` - cơ sở dữ liệu PostgreSQL được sao lưu hàng đêm lên S3 với RPO 4 giờ và thời gian lưu giữ pháp lý 3 năm

## Quy trình làm việc

### 1. Thu thập thông tin thực tế
Hỏi về: những gì được sao lưu và bằng cách nào (công cụ, sao lưu toàn phần hay tăng dần), tần suất sao lưu và thời gian chạy một lần mất bao lâu, các quy tắc giữ lại hiện tại, kích thước dữ liệu, tỷ lệ thay đổi hàng ngày và mức tăng trưởng, nơi lưu trữ các bản sao (tại chỗ, ngoài cơ sở, bất biến/khóa đối tượng, được mã hóa), giá lưu trữ, ngày kiểm thử khôi phục thành công gần nhất, và các yêu cầu: RPO (mức mất dữ liệu tối đa), họ phải có khả năng khôi phục lùi về quá khứ bao xa, bất kỳ yêu cầu lưu giữ pháp lý hoặc theo hợp đồng nào, và ngân sách lưu trữ. Nếu họ không biết tỷ lệ thay đổi, hãy bắt đầu với mức 2-5% mỗi ngày đối với cơ sở dữ liệu và 1% đối với chia sẻ tệp, đồng thời nêu rõ giả định đó.

### 2. Chạy trình lập kế hoạch
```
python3 scripts/retention_plan.py examples/clinic-postgres-policy.json
python3 scripts/retention_plan.py policy.json --json
python3 scripts/retention_plan.py --self-test
```
Mã thoát 1 có nghĩa là có các phát hiện mức HIGH, 2 có nghĩa là đầu vào không hợp lệ.

### 3. Giải thích kết quả
Bắt đầu với các điểm khôi phục mà họ thực sự có (số lượng, bản cũ nhất, các khoảng trống lớn nhất) vì hầu hết mọi người đều đánh giá quá cao chúng. Sau đó đi qua các phát hiện theo mức độ nghiêm trọng bằng cách sử dụng `references/retention-design.md` và `references/resilience-checklist.md`, đồng thời đưa ra một thay đổi cụ thể cho từng vấn đề: quy tắc giữ lại mới, vận chuyển WAL hoặc nhật ký (log shipping) cho RPO chặt chẽ, khóa đối tượng (object lock), ngày diễn tập khôi phục. Chạy lại trình lập kế hoạch với chính sách được đề xuất và hiển thị dung lượng lưu trữ cũng như chi phí trước và sau khi thay đổi.

### 4. Bàn giao
Điền vào `templates/backup-policy.md` với các quy tắc giữ lại cuối cùng, các bản sao, yêu cầu, kế hoạch kiểm thử khôi phục và người phụ trách.

## Kết quả ví dụ
Đối với `examples/clinic-postgres-policy.json` (sao lưu hàng đêm, giữ 7 bản hàng ngày, 4 bản hàng tuần, 6 bản hàng tháng): 14 điểm khôi phục, bản cũ nhất 4,8 tháng, khoảng trống lên tới 31 ngày sau tháng đầu tiên, 968 GB hiện tại và 1550 GB sau 12 tháng (22,27 đến 35,66 USD/tháng). Các phát hiện: HIGH RPO_MISSED (sao lưu 24 giờ một lần so với RPO 4 giờ; cần thêm lưu trữ WAL hoặc sao lưu tăng dần mỗi 4 giờ), HIGH LEGAL_RETENTION (cần 3 năm; hãy đặt bậc hàng năm thành 5), MEDIUM RESTORE_TEST_OLD (193 ngày), MEDIUM NO_IMMUTABLE, MEDIUM STORAGE_OVER (1550 GB so với ngân sách 1500 GB sau 12 tháng).

## Quy tắc

- Một bản sao lưu chưa bao giờ được khôi phục thử thì chưa được chứng minh là hoạt động. Luôn hỏi về lần kiểm thử khôi phục gần nhất và khuyến nghị một buổi diễn tập có bấm giờ.
- Các quy tắc giữ lại đếm theo các khung thời gian (bucket), không phải số ngày: "monthly 12" giữ lại bản sao lưu mới nhất của mỗi tháng trong 12 tháng gần nhất có bản sao lưu, bao gồm cả tháng hiện tại.
- Nêu rõ mô hình lưu trữ mà bạn đã giả định; ước tính sao lưu tăng dần (incremental) là mức trần vì việc chống trùng lặp (deduplication) và các thay đổi khối lặp đi lặp lại làm cho kích thước thực tế nhỏ hơn.
- RPO được quyết định bởi tần suất sao lưu (hoặc log shipping), không phải bởi thời gian lưu giữ; độ sâu lịch sử được quyết định bởi thời gian lưu giữ, không phải bởi tần suất.
- Không bao giờ đề xuất xóa các bản sao lưu hiện có cho đến khi chính sách mới đã chạy và việc khôi phục từ chính sách đó đã được kiểm thử.
FILE:references/retention-design.md
# Thiết kế chính sách lưu giữ

## Cách các quy tắc giữ lại chọn điểm khôi phục
Các công cụ như restic (`forget --keep-daily 7 --keep-weekly 4`), borg (`prune --keep-daily 7`), pgBackRest và hầu hết các thiết bị sao lưu chuyên dụng đều sử dụng chung một ý tưởng. Đối với mỗi bậc (tier), duyệt qua các bản sao lưu từ mới nhất đến cũ nhất và giữ lại một bản sao lưu khi khung thời gian (bucket) của nó khác với bản cuối cùng được giữ lại bởi bậc đó, cho đến khi dùng hết số lượng của bậc đó:

| Bậc | Khung thời gian (Bucket) | "giữ N" có nghĩa là |
|---|---|---|
| hourly | giờ theo lịch | bản sao lưu mới nhất của mỗi giờ trong N giờ gần nhất có bản sao lưu |
| daily | ngày theo lịch | bản sao lưu mới nhất của mỗi ngày trong N ngày gần nhất |
| weekly | tuần ISO (Thứ Hai đến Chủ Nhật) | bản sao lưu mới nhất của mỗi tuần trong N tuần gần nhất |
| monthly | tháng theo lịch | bản sao lưu mới nhất của mỗi tháng trong N tháng gần nhất |
| yearly | năm theo lịch | bản sao lưu mới nhất của mỗi năm trong N năm gần nhất |

Những hệ quả mà mọi người thường bỏ sót:
- Mọi bậc đều bắt đầu bằng bản sao lưu mới nhất, vì vậy các bậc có sự chồng lấn. 7 daily + 4 weekly + 12 monthly là 20 điểm, không phải 23.
- Tuần, tháng và năm hiện tại mỗi thứ được tính là một khung thời gian. "monthly 12" chỉ lùi về trước khoảng 11 tháng, và "yearly 3" chỉ lùi về đến cuối năm kia (khoảng 1,8 năm nếu tính vào cuối tháng Mười).
- Các điểm hàng tháng là các bản sao lưu cuối tháng (mới nhất trong mỗi tháng), các điểm hàng tuần là các bản sao lưu ngày Chủ Nhật đối với tuần ISO.
- Những ngày không có bản sao lưu không làm tiêu tốn một vị trí (slot) hàng ngày, vì vậy một tuần bị lỗi sẽ kéo dài lịch sử hàng ngày lùi xa hơn về trước nhưng lại để lại một lỗ hổng.

`scripts/retention_plan.py` tái tạo quy tắc này, in ra mọi điểm được giữ lại cùng với các bậc của nó (D/W/M/Y/H) và liệt kê các khoảng trống lớn nhất.

## Chọn các bậc từ yêu cầu
| Yêu cầu | Yếu tố quyết định | Câu trả lời điển hình |
|---|---|---|
| RPO (mức mất dữ liệu tối đa) | tần suất sao lưu hoặc log shipping | 24 giờ: hàng đêm; 1-4 giờ: snapshot hoặc sao lưu tăng dần hàng giờ; tính bằng phút: lưu trữ WAL/binlog của cơ sở dữ liệu với khả năng khôi phục tại một thời điểm (point-in-time recovery) |
| Phục hồi từ sai lầm được phát hiện muộn | độ sâu hàng ngày và hàng tuần | ít nhất 14-35 ngày: khoảng thời gian cần thiết để ai đó nhận ra một đợt triển khai lỗi, một thư mục bị xóa hoặc một lần nhập dữ liệu hỏng |
| Lỗi hỏng dữ liệu âm thầm, kiểm toán | độ sâu hàng tháng | 6-13 tháng |
| Lưu giữ pháp lý hoặc theo hợp đồng | bậc hàng năm hoặc một kho lưu trữ riêng | N năm cần mức yearly N+2 để luôn có một điểm cũ N năm xuyên suốt cả năm; thường tốt hơn nếu tách thành một tác vụ lưu trữ riêng biệt với khóa bảo vệ riêng |
| Ngân sách | mô hình lưu trữ và tỷ lệ thay đổi | xem bên dưới |

Một điểm khởi đầu phổ biến, dễ bảo vệ cho dữ liệu doanh nghiệp: hourly 24 (nếu RPO < 24 giờ), daily 14, weekly 8, monthly 12, yearly theo yêu cầu của pháp luật.

Các khoảng trống: khi một bậc thô bắt đầu rất lâu sau khi bậc chi tiết kết thúc (ví dụ daily 7 rồi nhảy sang monthly), việc khôi phục trong khoảng từ ngày thứ 8 đến cuối tháng sẽ rơi vào một điểm cũ hơn tới 30 ngày so với điểm bạn mong muốn. Hãy thêm các điểm hàng tuần hoặc tăng thêm các điểm hàng ngày (`TIER_GAP`).

## Các mô hình lưu trữ
- **Full (Toàn phần)**: mọi điểm được giữ lại đều là một bản sao hoàn chỉnh (băng từ, các tệp dump đơn giản, một số bản xuất snapshot). Dung lượng lưu trữ = số điểm x kích thước toàn phần.
- **Incremental / deduplicated (Tăng dần / chống trùng lặp)** (restic, borg, pgBackRest incremental, ZFS/EBS snapshot): một bản toàn phần cộng với dữ liệu đã thay đổi giữa các điểm được giữ lại. Trình lập kế hoạch tính `daily_change_pct x days` giữa các điểm liền kề, giới hạn tối đa ở mức 100% kích thước toàn phần. Đây là mức trần: khi cùng các khối dữ liệu đó thay đổi mỗi ngày, khoảng trống một tháng sẽ tốn ít dung lượng hơn nhiều so với 30 ngày thay đổi cộng dồn. Hãy đo các con số thực tế bằng `restic stats --mode raw-data`, `borg info` hoặc hóa đơn lưu trữ và điều chỉnh `daily_change_pct`.
- Mức tăng trưởng: `growth_pct_per_month` tính lãi kép trong 12 tháng để hiển thị dung lượng lưu trữ và chi phí của năm tới.

Các đòn bẩy chi phí, từ rẻ nhất đến có tác động lớn nhất tới khả năng phục hồi: nén và chống trùng lặp; chuyển các điểm hàng tháng và hàng năm sang lớp lưu trữ lạnh hơn (lưu ý thời gian lưu trữ tối thiểu và phí truy xuất); bỏ các điểm hàng giờ sau 2-3 ngày; giảm các điểm hàng tháng sau khi nhu cầu pháp lý đã được đáp ứng bởi một bản lưu trữ hàng năm.

## Ví dụ minh họa
Sao lưu hàng đêm lúc 02:00, giữ daily 7, weekly 4, monthly 6, tính đến ngày 2026-10-24:
- daily: 10-24 lùi về 10-18
- weekly: 10-24 (tuần ISO hiện tại), 10-18, 10-11, 10-04
- monthly: 10-24, 09-30, 08-31, 07-31, 06-30, 05-31
- 14 điểm riêng biệt; bản cũ nhất là 2026-05-31 (khoảng 4,8 tháng); các khoảng trống sau tháng đầu tiên là 30-31 ngày.
FILE:references/resilience-checklist.md
# Danh sách kiểm tra khả năng chống chịu

## Quy tắc 3-2-1-1-0
- **3** bản sao dữ liệu (bản production cộng với hai bản sao lưu)
- **2** loại hoặc hệ thống lưu trữ khác nhau
- **1** bản sao ngoài cơ sở - offsite (một vùng, nhà cung cấp hoặc tòa nhà khác)
- **1** bản sao bất biến hoặc ngoại tuyến (khóa đối tượng ở chế độ tuân thủ, lưu trữ WORM, băng từ lấy ra khỏi thư viện, bản sao lưu dạng kéo mà hệ thống nguồn không thể xóa)
- **0** lỗi trong lần khôi phục đã xác minh gần nhất

## Ý nghĩa của từng phát hiện và cách khắc phục
| Mã | Mức độ nghiêm trọng | Tại sao điều này quan trọng | Cách khắc phục điển hình |
|---|---|---|---|
| RPO_MISSED | HIGH | Sự cố xảy ra ngay trước lần sao lưu tiếp theo làm mất nhiều dữ liệu hơn mức doanh nghiệp chấp nhận | Khoảng thời gian ngắn hơn, sao lưu tăng dần hàng giờ, hoặc vận chuyển nhật ký liên tục (lưu trữ PostgreSQL WAL với pgBackRest/WAL-G, MySQL binlog, sao lưu nhật ký SQL Server) |
| HISTORY_SHORT | HIGH | Các vấn đề được phát hiện muộn (nhập dữ liệu lỗi, thư mục bị xóa, hỏng dữ liệu chậm) không thể hoàn tác | Thêm nhiều điểm hàng ngày/hàng tuần hơn; ít nhất bằng thời gian cần thiết để phát hiện sự cố cộng với một khoảng dự phòng |
| LEGAL_RETENTION | HIGH | Các quy định hợp đồng, thuế hoặc hồ sơ y tế có thể yêu cầu lưu giữ lịch sử nhiều năm | Bậc hàng năm ở mức N+2 hoặc một tác vụ lưu trữ hàng năm riêng biệt có khóa đối tượng được đặt theo thời hạn pháp lý |
| NO_OFFSITE | HIGH | Hỏa hoạn, mất điện toàn vùng hoặc tài khoản bị xâm phạm sẽ xóa sổ cả môi trường production lẫn bản sao lưu cùng lúc | Nhân bản sang vùng/nhà cung cấp khác với thông tin xác thực riêng biệt |
| NEVER_RESTORED | HIGH | Các bản sao lưu thất bại âm thầm: thiếu tệp, sai quyền truy cập, mất khóa mã hóa, sổ tay vận hành (runbook) chưa được kiểm thử | Diễn tập khôi phục ngay; ghi lại thời gian thực hiện (RTO thực tế) |
| OVERLAP | HIGH | Các tác vụ va chạm hoặc bị bỏ qua, khiến khoảng cách thực tế dài hơn kế hoạch | Sao lưu tăng dần, thiết bị lưu trữ nhanh hơn, hoặc khoảng cách dài hơn kết hợp với vận chuyển nhật ký (log shipping) |
| RESTORE_TEST_OLD | MEDIUM | Hệ thống thay đổi liên tục; bài kiểm tra từ mùa xuân năm ngoái không nói lên được nhiều điều về hiện tại | Diễn tập hàng quý; tự động khôi phục và kiểm tra checksum hàng tháng đối với dữ liệu quan trọng |
| NO_IMMUTABLE | MEDIUM | Ransomware và kẻ tấn công luôn xóa các bản sao lưu trước tiên | S3 Object Lock / Azure immutable blob / GCS bucket lock, hoặc một bản sao ngoại tuyến |
| NOT_ENCRYPTED | MEDIUM | Bản sao ngoài cơ sở sẽ làm lộ toàn bộ dữ liệu nếu bucket hoặc băng từ bị phơi bày | Mã hóa phía máy khách (client-side); khóa được lưu trữ bên ngoài hệ thống sao lưu và được ký quỹ (escrow) an toàn |
| STORAGE_OVER | MEDIUM | Ngân sách buộc ai đó phải cắt giảm thời gian lưu giữ một cách vội vàng về sau | Lưu trữ lạnh hơn cho các bậc cũ, giảm bớt các điểm hàng tháng, đo tỷ lệ thay đổi thực tế |
| TIER_GAP | LOW | Việc khôi phục rơi vào khoảng trống sẽ phải dùng điểm cũ hơn nhiều so với mong muốn | Thêm các điểm hàng tuần hoặc kéo dài các điểm hàng ngày |
| TIGHT_WINDOW | LOW | Sự gia tăng dữ liệu sẽ đẩy tác vụ vào tình trạng chồng chéo | Lên kế hoạch sao lưu tăng dần hoặc song song trước khi điều đó xảy ra |

## Diễn tập khôi phục (một trang)
1. Chọn một điểm khôi phục ngẫu nhiên, không phải điểm mới nhất.
2. Khôi phục vào một môi trường cô lập chỉ sử dụng sổ tay vận hành (runbook) và các khóa được ký quỹ.
3. Kiểm tra: số lượng hàng hoặc số lượng tệp, ứng dụng khởi động được, một bản ghi đã biết từ ngày đó có tồn tại.
4. Ghi lại thời gian bắt đầu và kết thúc (RTO thực tế), các vấn đề gặp phải và những điểm cần sửa trong sổ tay vận hành.
5. Xóa bản sao đã khôi phục và ghi nhận ngày diễn tập; trường `last_restore_test` của trình lập kế hoạch chính là ngày này.

## Giám sát
- Cảnh báo khi bản sao lưu mới nhất cũ hơn 1,5 lần khoảng cách định kỳ.
- Cảnh báo khi có các tác vụ thất bại hoặc chỉ hoàn thành một phần, chứ không chỉ khi thiếu bản sao lưu.
- Theo dõi kích thước bản sao lưu mỗi lần chạy; sự sụt giảm đột ngột thường có nghĩa là đường dẫn bao gồm (include path) bị hỏng, sự tăng vọt đột ngột có thể là dấu hiệu bị ransomware mã hóa.
- Kiểm tra xem các tác vụ prune/forget có chạy hay không; một chính sách không bao giờ được thực thi sẽ âm thầm làm đầy bộ nhớ.

## Khóa và quyền truy cập
- Thông tin xác thực sao lưu nên chỉ có quyền ghi (write-only) từ phía nguồn ở những nơi có thể; việc xóa cần một định danh khác.
- Giữ các khóa mã hóa và sổ tay vận hành khôi phục ở nơi vẫn tồn tại được ngay cả khi mất môi trường chính (kho lưu trữ của trình quản lý mật khẩu, bản in niêm phong).
FILE:templates/backup-policy.md
# Chính sách Sao lưu - <system name>

**Chủ sở hữu:** <team / person>  **Đã xem xét:** <date>  **Lần xem xét tiếp theo:** <date + 6 months>

## Phạm vi
- Dữ liệu: <databases, buckets, file shares, configs>
- Loại trừ: <caches, rebuildable artifacts>

## Yêu cầu
| Hạng mục | Mục tiêu | Nguồn yêu cầu |
|---|---|---|
| RPO (mức mất dữ liệu tối đa) | <4 h> | <business owner> |
| RTO (thời gian khôi phục tối đa) | <2 h> | <business owner> |
| Lịch sử tối thiểu | <35 days> | <ops> |
| Lưu giữ pháp lý / theo hợp đồng | <3 years> | <contract, regulation> |
| Ngân sách lưu trữ | <1500 GB / 40 USD per month> | <finance> |

## Lịch trình và quy tắc giữ lại
| Tác vụ | Tần suất | Phương thức | Quy tắc giữ lại |
|---|---|---|---|
| <full/incremental> | <daily 02:00> | <pgBackRest incr to S3> | <daily 14, weekly 8, monthly 12, yearly 5> |
| <log shipping> | <continuous> | <WAL archive> | <14 days> |

Các điểm khôi phục được tạo ra (từ `scripts/retention_plan.py`): <count>, bản cũ nhất <age>, khoảng trống lớn nhất <days>.

## Các bản sao (3-2-1-1-0)
| Bản sao | Vị trí | Bất biến | Mã hóa | Thông tin xác thực |
|---|---|---|---|---|
| Bản sao lưu chính | <region A bucket> | <no> | <yes> | <backup-writer role> |
| Ngoài cơ sở (Offsite) | <region B / provider B> | <object lock 35 d> | <yes> | <separate account> |

## Dung lượng lưu trữ và chi phí
- Hiện tại: <GB> / <cost per month>  - Sau 12 tháng: <GB> / <cost per month>

## Kiểm thử khôi phục
- Tần suất: <quarterly drill, monthly automated check>
- Lần kiểm thử gần nhất: <date>, kết quả <ok / issues>, RTO thực tế <time>
- Sổ tay vận hành (Runbook): <link>  - Khóa được ký quỹ tại: <location>

## Giám sát và cảnh báo
- <newest backup older than 36 h -> page on-call>
- <job failed / size change > 30% -> ticket>

## Các phát hiện đang mở
- <severity code: action, owner, due date>
FILE:examples/clinic-postgres-policy.json
{
  "name": "clinic-booking PostgreSQL (pgBackRest to S3)",
  "today": "2026-10-24",
  "backup_interval_hours": 24,
  "backup_duration_hours": 2.5,
  "policy": {"daily": 7, "weekly": 4, "monthly": 6, "yearly": 0},
  "size": {"full_gb": 180, "daily_change_pct": 3, "growth_pct_per_month": 4, "storage_model": "incremental"},
  "requirements": {
    "rpo_hours": 4,
    "min_history_days": 90,
    "legal_retention_years": 3,
    "max_storage_gb": 1500,
    "restore_test_max_age_days": 90
  },
  "copies": {"onsite": false, "offsite": true, "immutable": false, "encrypted": true},
  "price_per_gb_month": 0.023,
  "currency": "USD",
  "last_restore_test": "2026-04-14"
}
FILE:scripts/retention_plan.py
#!/usr/bin/env python3
"""Backup retention policy planner (Python 3 standard library only).

Simulates a grandfather-father-son (GFS) retention policy the way restic/borg "keep" rules
work, then reports the restore points you really keep, the gaps between them, storage and
cost, and the gaps against your requirements (RPO, minimum history, legal retention, 3-2-1).

Input JSON:
  {"name": "orders-db", "today": "2026-10-24",
   "backup_interval_hours": 24, "backup_duration_hours": 1.5,
   "policy": {"hourly": 0, "daily": 7, "weekly": 4, "monthly": 12, "yearly": 3},
   "size": {"full_gb": 120, "daily_change_pct": 4, "growth_pct_per_month": 3,
            "storage_model": "incremental"},          # or "full" (every point is a full copy)
   "requirements": {"rpo_hours": 24, "min_history_days": 35, "legal_retention_years": 0,
                    "max_storage_gb": 0, "restore_test_max_age_days": 90},
   "copies": {"onsite": true, "offsite": true, "immutable": false, "encrypted": true},
   "price_per_gb_month": 0.023, "currency": "USD",
   "last_restore_test": "2026-03-02"}                 # or null if never tested
Selection rule per tier (newest backup first): keep a backup if its bucket (hour, day, ISO week,
month, year) differs from the previous kept bucket of that tier, until the tier count is used.
A backup kept by several tiers is stored once.
Storage: "full" = points x full size; "incremental" = one full + each later point's changed data
(daily_change_pct x days since the previous kept point, capped at 100%).
Findings (severity):
  HIGH   RPO_MISSED          backup interval longer than the RPO
  HIGH   HISTORY_SHORT       oldest restore point younger than min_history_days
  HIGH   LEGAL_RETENTION     oldest point younger than legal_retention_years
  HIGH   NO_OFFSITE          no offsite copy (breaks 3-2-1)
  HIGH   NEVER_RESTORED      no restore test recorded
  HIGH   OVERLAP             backup takes longer than the interval
  MEDIUM RESTORE_TEST_OLD    last restore test older than restore_test_max_age_days
  MEDIUM NO_IMMUTABLE        no immutable/air-gapped copy (ransomware can delete backups)
  MEDIUM STORAGE_OVER        storage (now or in 12 months) above max_storage_gb
  MEDIUM NOT_ENCRYPTED       offsite copy not encrypted
  LOW    TIER_GAP            a coarse tier starts long after the finer tier ends (e.g. weekly
                             4 then monthly: weeks 5-8 have one point a month)
  LOW    TIGHT_WINDOW        backup duration above 50% of the interval
Usage:
  python3 retention_plan.py policy.json
  python3 retention_plan.py policy.json --json
  python3 retention_plan.py --self-test
Exit code: 0 no HIGH findings, 1 HIGH findings, 2 bad input.
"""
import argparse
import datetime as dt
import json
import sys

TIERS = ["hourly", "daily", "weekly", "monthly", "yearly"]
SEV_ORDER = {"HIGH": 0, "MEDIUM": 1, "LOW": 2}


class DataError(ValueError):
    pass


def bucket(tier, t):
    if tier == "hourly":
        return t.strftime("%Y-%m-%d %H")
    if tier == "daily":
        return t.date().isoformat()
    if tier == "weekly":
        y, w, _ = t.isocalendar()
        return f"{y}-W{w:02d}"
    if tier == "monthly":
        return t.strftime("%Y-%m")
    return str(t.year)


def simulate(policy, interval_h, today):
    """Return (kept list of (datetime, [tiers])) newest first."""
    for k in policy:
        if k not in TIERS:
            raise DataError(f"unknown policy tier '{k}' (use {', '.join(TIERS)})")
        if not isinstance(policy[k], int) or policy[k] < 0:
            raise DataError(f"policy.{k} must be a whole number >= 0")
    if sum(policy.get(t, 0) for t in TIERS) == 0:
        raise DataError("policy keeps nothing")
    if not interval_h or interval_h <= 0:
        raise DataError("backup_interval_hours must be > 0")
    span_days = max(policy.get("hourly", 0) / 24, policy.get("daily", 0), policy.get("weekly", 0) * 7,
                    policy.get("monthly", 0) * 31, policy.get("yearly", 0) * 366) + 400
    newest = dt.datetime.combine(today, dt.time(2, 0))
    step = dt.timedelta(hours=interval_h)
    n = int(span_days * 24 / interval_h) + 1
    times = [newest - i * step for i in range(n)]
    kept = {}
    for tier in TIERS:
        want = policy.get(tier, 0)
        last = None
        for t in times:
            if want == 0:
                break
            b = bucket(tier, t)
            if b != last:
                kept.setdefault(t, []).append(tier)
                last = b
                want -= 1
    return sorted(kept.items(), key=lambda kv: kv[0], reverse=True)


def storage_gb(kept, size):
    full = float(size.get("full_gb", 0))
    model = size.get("storage_model", "incremental")
    if model not in ("incremental", "full"):
        raise DataError("size.storage_model must be 'incremental' or 'full'")
    if model == "full":
        return full * len(kept)
    change = float(size.get("daily_change_pct", 5)) / 100
    total = full
    for (newer, _), (older, _) in zip(kept, kept[1:]):
        days = (newer - older).total_seconds() / 86400
        total += full * min(1.0, change * days)
    return total


def plan(cfg, today=None):
    try:
        today = today or dt.date.fromisoformat(cfg.get("today") or dt.date.today().isoformat())
    except ValueError:
        raise DataError("today must be YYYY-MM-DD")
    policy = cfg.get("policy") or {}
    interval = float(cfg.get("backup_interval_hours", 24))
    kept = simulate(policy, interval, today)
    newest = kept[0][0]
    ages = [(newest - t).total_seconds() / 86400 for t, _ in kept]
    oldest_days = ages[-1]
    size = cfg.get("size") or {}
    req = cfg.get("requirements") or {}
    copies = cfg.get("copies") or {}
    price = float(cfg.get("price_per_gb_month", 0))
    gb = storage_gb(kept, size)
    growth = float(size.get("growth_pct_per_month", 0)) / 100
    gb12 = gb * (1 + growth) ** 12
    tiers = []
    for tier in TIERS:
        pts = [(t, a) for (t, tl), a in zip(kept, ages) if tier in tl]
        if pts:
            tiers.append({"tier": tier, "count": len(pts), "newest_age_days": round(pts[0][1], 1),
                          "oldest_age_days": round(pts[-1][1], 1)})
    gaps = []
    for (t1, _), (t2, _), a in zip(kept, kept[1:], ages[1:]):
        gaps.append({"from": t2.date().isoformat(), "to": t1.date().isoformat(),
                     "gap_days": round((t1 - t2).total_seconds() / 86400, 1), "age_days": round(a, 1)})
    findings = []

    def add(sev, code, msg):
        findings.append({"severity": sev, "code": code, "message": msg})

    rpo = req.get("rpo_hours")
    if rpo and interval > rpo:
        add("HIGH", "RPO_MISSED", f"backups every {interval:g} h but RPO is {rpo:g} h; up to {interval:g} h of data can be lost")
    mh = req.get("min_history_days")
    if mh and oldest_days < mh:
        add("HIGH", "HISTORY_SHORT", f"oldest restore point is {oldest_days:.0f} days old; requirement is {mh} days")
    ly = req.get("legal_retention_years")
    if ly and oldest_days < ly * 365:
        add("HIGH", "LEGAL_RETENTION", f"oldest point {oldest_days / 365:.1f} years; legal retention needs {ly} years; yearly N also counts the current year, so set yearly >= {ly + 2} to cover it all year round")
    if not copies.get("offsite"):
        add("HIGH", "NO_OFFSITE", "no offsite copy; a site loss, account compromise or region outage takes every backup")
    dur = cfg.get("backup_duration_hours")
    if dur and dur > interval:
        add("HIGH", "OVERLAP", f"backup takes {dur:g} h but runs every {interval:g} h; jobs overlap or get skipped")
    elif dur and dur > interval / 2:
        add("LOW", "TIGHT_WINDOW", f"backup takes {dur:g} h of a {interval:g} h interval; growth will push it into overlap")
    lrt = cfg.get("last_restore_test")
    max_age = req.get("restore_test_max_age_days", 90)
    if not lrt:
        add("HIGH", "NEVER_RESTORED", "no restore test recorded; an untested backup is a hope, not a backup")
    else:
        age = (today - dt.date.fromisoformat(lrt)).days
        if age > max_age:
            add("MEDIUM", "RESTORE_TEST_OLD", f"last restore test {age} days ago (limit {max_age}); schedule a timed restore")
    if not copies.get("immutable"):
        add("MEDIUM", "NO_IMMUTABLE", "no immutable or air-gapped copy; ransomware or a stolen admin key can delete every backup")
    if copies.get("offsite") and copies.get("encrypted") is False:
        add("MEDIUM", "NOT_ENCRYPTED", "offsite copy is not encrypted at rest")
    mx = req.get("max_storage_gb")
    if mx and max(gb, gb12) > mx:
        add("MEDIUM", "STORAGE_OVER", f"storage {gb:.0f} GB now, {gb12:.0f} GB in 12 months; budget {mx} GB")
    order = [t for t in TIERS if policy.get(t, 0) > 0]
    span = {"hourly": 1 / 24, "daily": 1, "weekly": 7, "monthly": 30.4, "yearly": 365}
    for fine, coarse in zip(order, order[1:]):
        fine_end = policy[fine] * span[fine]
        if span[coarse] >= 4 * fine_end and fine != "hourly":
            add("LOW", "TIER_GAP", f"{fine} points cover ~{fine_end:.0f} days, then only one {coarse} point per {span[coarse]:.0f} days")
    findings.sort(key=lambda f: SEV_ORDER[f["severity"]])
    return {
        "name": cfg.get("name", "backup set"), "today": today.isoformat(), "interval_hours": interval,
        "restore_points": len(kept), "oldest_age_days": round(oldest_days, 1),
        "tiers": tiers, "largest_gaps": sorted(gaps, key=lambda g: -g["gap_days"])[:5],
        "storage_gb": round(gb, 1), "storage_gb_12m": round(gb12, 1),
        "monthly_cost": round(gb * price, 2), "monthly_cost_12m": round(gb12 * price, 2),
        "currency": cfg.get("currency", "USD"), "storage_model": size.get("storage_model", "incremental"),
        "kept": [{"time": t.strftime("%Y-%m-%d %H:%M"), "tiers": tl} for t, tl in kept],
        "findings": findings,
    }


def age_label(d):
    if d < 2:
        return f"{d * 24:.0f} h"
    if d < 60:
        return f"{d:.0f} d"
    if d < 730:
        return f"{d / 30.4:.1f} mo"
    return f"{d / 365:.1f} y"


def render(r):
    out = [f"# Backup retention plan: {r['name']} (as of {r['today']})", "",
           f"Backups every {r['interval_hours']:g} h -> {r['restore_points']} restore points kept, oldest {age_label(r['oldest_age_days'])} old",
           f"Storage ({r['storage_model']}): {r['storage_gb']:.0f} GB now, {r['storage_gb_12m']:.0f} GB in 12 months"
           f" -> {r['monthly_cost']:.2f} -> {r['monthly_cost_12m']:.2f} {r['currency']}/month", "",
           "| Tier | Points | Newest age | Oldest age |", "|---|---|---|---|"]
    for t in r["tiers"]:
        out.append(f"| {t['tier']} | {t['count']} | {age_label(t['newest_age_days'])} | {age_label(t['oldest_age_days'])} |")
    out += ["", "## Largest gaps between restore points", "| Older point | Newer point | Gap | Age of older point |", "|---|---|---|---|"]
    for g in r["largest_gaps"]:
        out.append(f"| {g['from']} | {g['to']} | {g['gap_days']:g} d | {age_label(g['age_days'])} |")
    out += ["", "## Restore points kept"]
    out.append(", ".join(f"{k['time'][:10]} ({'/'.join(x[0].upper() for x in k['tiers'])})" for k in r["kept"]))
    out += ["", "## Findings"]
    if not r["findings"]:
        out.append("- none")
    for f in r["findings"]:
        out.append(f"- {f['severity']} {f['code']}: {f['message']}")
    return "\n".join(out) + "\n"


def self_test():
    ok = 0
    tests = []

    def check(name, cond):
        nonlocal ok
        tests.append(name)
        print(("PASS " if cond else "FAIL ") + name)
        ok += bool(cond)

    today = dt.date(2026, 10, 24)
    base = {"today": "2026-10-24", "backup_interval_hours": 24, "policy": {"daily": 7, "weekly": 4, "monthly": 12},
            "size": {"full_gb": 100, "daily_change_pct": 2}, "requirements": {"rpo_hours": 24, "min_history_days": 35},
            "copies": {"offsite": True, "immutable": True, "encrypted": True}, "last_restore_test": "2026-10-01"}
    r = plan(base, today)
    # daily 7 = 7 newest days; weekly 4 overlaps with dailies; monthly 12
    check("daily 7 + weekly 4 + monthly 12 -> 20 distinct points", r["restore_points"] == 20)
    check("clean policy has no findings", r["findings"] == [])
    check("oldest point is the 2025-11-30 monthly", r["kept"][-1]["time"].startswith("2025-11-30"))
    k = simulate({"daily": 3}, 24, today)
    check("daily 3 keeps 3 newest days", [t.date().day for t, _ in k] == [24, 23, 22])
    k = simulate({"hourly": 6}, 1, today)
    check("hourly 6 keeps 6 points one hour apart", len(k) == 6 and (k[0][0] - k[5][0]) == dt.timedelta(hours=5))
    k = simulate({"weekly": 2}, 24, today)
    check("weekly keeps newest of each ISO week", [t.date().isoformat() for t, _ in k] == ["2026-10-24", "2026-10-18"])
    k = simulate({"monthly": 2}, 24, today)
    check("monthly keeps last day of previous month", [t.date().isoformat() for t, _ in k] == ["2026-10-24", "2026-09-30"])
    k = simulate({"daily": 2, "weekly": 1}, 24, today)
    check("point kept by two tiers stored once", len(k) == 2 and k[0][1] == ["daily", "weekly"])
    k = simulate({"daily": 7}, 12, today)
    check("12 h interval: daily keeps newest per day", len(k) == 7 and [t.hour for t, _ in k[:2]] == [2, 14])
    check("full storage = points x full", storage_gb([(dt.datetime(2026, 1, 2), []), (dt.datetime(2026, 1, 1), [])], {"full_gb": 50, "storage_model": "full"}) == 100)
    check("incremental storage = full + change x days", abs(storage_gb([(dt.datetime(2026, 1, 11), []), (dt.datetime(2026, 1, 1), [])], {"full_gb": 100, "daily_change_pct": 2}) - 120) < 1e-9)
    check("incremental change capped at 100%", storage_gb([(dt.datetime(2026, 6, 1), []), (dt.datetime(2026, 1, 1), [])], {"full_gb": 10, "daily_change_pct": 5}) == 20)

    def codes(**over):
        c = json.loads(json.dumps(base))
        for key, val in over.items():
            if key != "policy" and isinstance(val, dict) and isinstance(c.get(key), dict):
                c[key].update(val)
            else:
                c[key] = val
        return {f["code"] for f in plan(c, today)["findings"]}

    check("RPO missed HIGH", "RPO_MISSED" in codes(requirements={"rpo_hours": 4}))
    check("history short HIGH", "HISTORY_SHORT" in codes(policy={"daily": 14}))
    check("legal retention HIGH", "LEGAL_RETENTION" in codes(requirements={"legal_retention_years": 7}))
    check("yearly 9 satisfies legal 7, yearly 8 does not", "LEGAL_RETENTION" in codes(policy={"daily": 7, "monthly": 12, "yearly": 8}, requirements={"legal_retention_years": 7}) and "LEGAL_RETENTION" not in codes(policy={"daily": 7, "monthly": 12, "yearly": 9}, requirements={"legal_retention_years": 7}))
    check("no offsite HIGH", "NO_OFFSITE" in codes(copies={"offsite": False}))
    check("never restored HIGH", "NEVER_RESTORED" in codes(last_restore_test=None))
    check("restore test old MEDIUM", "RESTORE_TEST_OLD" in codes(last_restore_test="2026-01-01"))
    check("no immutable MEDIUM", "NO_IMMUTABLE" in codes(copies={"immutable": False}))
    check("not encrypted MEDIUM", "NOT_ENCRYPTED" in codes(copies={"encrypted": False}))
    check("overlap HIGH", "OVERLAP" in codes(backup_duration_hours=30))
    check("tight window LOW", "TIGHT_WINDOW" in codes(backup_duration_hours=14))
    check("storage over MEDIUM", "STORAGE_OVER" in codes(requirements={"max_storage_gb": 150}))
    check("tier gap LOW (daily 7 then monthly)", "TIER_GAP" in codes(policy={"daily": 7, "monthly": 12}))
    try:
        plan({"policy": {"daily": 0}}, today)
        check("empty policy rejected", False)
    except DataError:
        check("empty policy rejected", True)
    try:
        plan({"policy": {"fortnightly": 2}}, today)
        check("unknown tier rejected", False)
    except DataError:
        check("unknown tier rejected", True)
    print(f"{ok}/{len(tests)} passed")
    return 0 if ok == len(tests) else 1


def main():
    ap = argparse.ArgumentParser(description="Backup retention (GFS) policy planner")
    ap.add_argument("policy", nargs="?", help="policy JSON file")
    ap.add_argument("--json", action="store_true", help="print JSON instead of Markdown")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args()
    if a.self_test:
        return self_test()
    if not a.policy:
        ap.error("policy file required")
    try:
        with open(a.policy, encoding="utf-8") as fh:
            cfg = json.load(fh)
        r = plan(cfg)
    except (OSError, json.JSONDecodeError, DataError, ValueError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(r, indent=2) if a.json else render(r), end="" if not a.json else "\n")
    return 1 if any(f["severity"] == "HIGH" for f in r["findings"]) else 0


if __name__ == "__main__":
sys.exit(main())Kiểm toán các nhánh từ xa (remote branch) của kho lưu trữ và lập kế hoạch dọn dẹp an toàn. Phân loại từng nhánh thành xóa (đã gộp, đã squash-merge hoặc trống), lưu trữ rồi xóa (công việc chưa gộp bị bỏ không), hỏi chủ sở hữu, PR đang mở, đang hoạt động hoặc được bảo vệ, đồng thời nhóm các yêu cầu hỏi theo tác giả. Đánh dấu các tên trùng lặp không phân biệt hoa thường, PR cũ, các nhánh tụt hậu quá xa so với main, các nhánh tồn tại lâu và tên đặt sai quy cách, đồng thời in ra kịch bản gắn thẻ rồi xóa có thể xem xét trước. Bao gồm một trình kiểm toán Python dùng thư viện chuẩn với tùy chọn --self-test.
---
name: stale-git-branch-cleanup-auditor
description: Kiểm toán các nhánh từ xa (remote branch) của kho lưu trữ và lập kế hoạch dọn dẹp an toàn. Phân loại từng nhánh thành xóa (đã gộp, đã squash-merge hoặc trống), lưu trữ rồi xóa (công việc chưa gộp bị bỏ không), hỏi chủ sở hữu, PR đang mở, đang hoạt động hoặc được bảo vệ, đồng thời nhóm các yêu cầu hỏi theo tác giả. Đánh dấu các tên trùng lặp không phân biệt hoa thường, PR cũ, các nhánh tụt hậu quá xa so với main, các nhánh tồn tại lâu và tên đặt sai quy cách, đồng thời in ra kịch bản gắn thẻ rồi xóa có thể xem xét trước. Bao gồm một trình kiểm toán Python dùng thư viện chuẩn với tùy chọn --self-test.
---

# Trình kiểm toán dọn dẹp nhánh Git cũ

Bạn giúp các nhóm dọn dẹp hàng chục hoặc hàng trăm nhánh bị lãng quên trên một remote dùng chung mà không làm mất công việc của bất kỳ ai. Bạn quyết định, từng nhánh một, nhánh nào an toàn để xóa, nhánh nào nên được lưu trữ dưới dạng thẻ (tag) trước, và ai cần được hỏi ý kiến, sau đó tạo ra một kịch bản dọn dẹp để mọi người xem xét trước khi bất kỳ thứ gì bị gỡ bỏ.

## Các tệp trong kỹ năng này

- `scripts/branch_audit.py` - phân loại các nhánh từ xa từ tệp xuất TSV hoặc CSV hoặc trực tiếp từ bản clone cục bộ (`--repo`), in ra các phát hiện, danh sách chủ sở hữu và kịch bản dọn dẹp (chỉ dùng thư viện chuẩn Python 3; không bao giờ tự xóa bất kỳ thứ gì)
- `references/cleanup-rules.md` - các quy tắc quyết định, phát hiện squash-merge, thẻ lưu trữ, nhánh được bảo vệ, quy ước đặt tên và cách khôi phục nhánh đã xóa
- `references/exporting-branch-data.md` - các lệnh git và GitHub/GitLab để tạo dữ liệu đầu vào, bao gồm cả trạng thái PR
- `templates/cleanup-announcement.md` - thông báo cho nhóm kèm theo kế hoạch, các câu hỏi dành cho chủ sở hữu và thời hạn chót
- `examples/webshop-branches.csv` - 16 nhánh của kho lưu trữ cửa hàng trực tuyến với các nhánh đã gộp, đã squash-merge, cũ, xung đột tên và được bảo vệ

## Quy trình làm việc

### 1. Lấy dữ liệu nhánh
Ưu tiên: một bản clone cục bộ mới (`git fetch --prune origin`) và chạy kịch bản với `--repo`. Hỏi nhánh cơ sở (main, master hoặc develop), trạng thái PR từ `gh pr list` hoặc GitLab API (squash merge không thể thấy được trong lịch sử git), các mẫu nhánh được bảo vệ và quy ước đặt tên của nhóm. Nếu họ dán một danh sách thay thế, hãy chuyển đổi nó thành các cột CSV trong `references/exporting-branch-data.md`.

### 2. Chạy trình kiểm toán
```
python3 scripts/branch_audit.py examples/webshop-branches.csv --today 2026-10-24
python3 scripts/branch_audit.py --repo . --base main --prs prs.tsv --stale-days 90 --ask-days 30
python3 scripts/branch_audit.py --self-test
```
Mã thoát 1 có nghĩa là có các phát hiện mức HIGH, 2 có nghĩa là đầu vào không hợp lệ.

### 3. Xem xét cùng người dùng
Đi qua các hành động theo thứ tự sau: DELETE_MERGED (an toàn, công việc đã nằm trong nhánh cơ sở), ARCHIVE_AND_DELETE (có thể khôi phục từ thẻ lưu trữ), ASK_OWNER (cần câu trả lời), sau đó là các phát hiện. Sửa lỗi CASE_COLLISION trước tiên vì nó làm hỏng các bản clone trên macOS và Windows. Điều chỉnh các ngưỡng theo tốc độ làm việc của nhóm (một kho lưu trữ nghiên cứu có thể muốn 180 ngày không hoạt động). Sử dụng `references/cleanup-rules.md` để giải thích từng quyết định.

### 4. Bàn giao
Điền vào `templates/cleanup-announcement.md` với số lượng thống kê, danh sách theo từng chủ sở hữu và thời hạn chót (thường là 7 ngày). Bàn giao kịch bản đã tạo cùng với lời khuyên nên chạy các dòng DELETE_MERGED trước và các dòng lưu trữ sau thời hạn chót.

## Kết quả ví dụ
Đối với `examples/webshop-branches.csv` (tính đến 2026-10-24, cũ 90 ngày, hỏi 30 ngày): 16 nhánh -> 3 xóa (đã gộp, PR đã squash-merge, không có commit nào đi trước), 3 lưu trữ và xóa (spike/graphql-gateway, feature/gift-cards, johns-test), 2 hỏi chủ sở hữu, 3 PR đang mở, 1 đang hoạt động, 4 được bảo vệ. Các phát hiện: HIGH CASE_COLLISION (fix/search-timeout so với fix/Search-Timeout), MEDIUM PR_STALE (feature/checkout-redesign, không hoạt động 205 ngày), 3 MEDIUM FAR_BEHIND, 2 LOW BAD_NAME, 2 LOW LONG_LIVED, LOW OLD_PROTECTED (release/2.3).

## Quy tắc

- Không bao giờ tự ý xóa các nhánh và không bao giờ chạy kịch bản thay cho người dùng; hãy in kịch bản ra để họ xem xét.
- Công việc chưa gộp sẽ được lưu trữ dưới dạng thẻ (`archive/<branch>`) trước khi nhánh bị xóa, để có thể khôi phục lại.
- Squash merge và rebase merge khiến nhánh trông như "chưa gộp" trong git; hãy tin tưởng trạng thái PR chứ không chỉ dựa vào `--merged`.
- Các nhánh được bảo vệ, nhánh phát hành (release) và nhánh cơ sở (base) không bao giờ nằm trong danh sách xóa, ngay cả khi chúng có vẻ không hoạt động.
- Hỏi ý kiến chủ sở hữu trước khi chạm vào công việc chưa gộp và đưa ra thời hạn chót rõ ràng.
FILE:references/cleanup-rules.md
# Quy tắc dọn dẹp

## Thứ tự quyết định (khớp đầu tiên sẽ được áp dụng)
| Hành động | Điều kiện | Tại sao an toàn hoặc không an toàn |
|---|---|---|
| KEEP_PROTECTED | khớp với `--protect` (main, master, develop, trunk, gh-pages, release/*, hotfix/*) | Các đợt triển khai, bảo trì bản phát hành và quy tắc bảo vệ nhánh phụ thuộc vào chúng |
| DELETE_MERGED | có thể truy cập từ nhánh cơ sở, 0 commit đi trước, hoặc PR của nó đã được gộp | Mọi commit (hoặc bản tương đương đã squash của nó) đều đã nằm trong nhánh cơ sở |
| KEEP_OPEN_PR | yêu cầu pull/merge đang mở | Xóa nhánh sẽ đóng PR; hãy hỏi ý kiến thay vì xóa (xem PR_STALE) |
| ARCHIVE_AND_DELETE | chưa gộp và không hoạt động >= số ngày cũ (mặc định 90) | Các commit duy nhất: gắn thẻ trước để công việc có thể khôi phục được |
| ASK_OWNER | chưa gộp và không hoạt động >= số ngày cần hỏi (mặc định 30) | Có thể vẫn đang được sử dụng; chủ sở hữu sẽ quyết định |
| KEEP_ACTIVE | chưa gộp, có các commit gần đây | Công việc đang tiến hành |

"Không hoạt động" (Idle) là ngày committer của commit đầu mút nhánh. Thao tác rebase sẽ cập nhật ngày này, vì vậy một nhánh được rebase ngày hôm qua vẫn được tính là đang hoạt động ngay cả khi không ai làm việc trên đó trong nhiều tháng.

## Squash merge và rebase merge
`git branch -r --merged main` chỉ tìm thấy các nhánh có commit đầu mút nằm trong main. Khi một PR được squash-merge hoặc rebase-merge, main nhận các commit mới còn nhánh đó trông vẫn như chưa gộp với N commit đi trước. Hãy sử dụng trạng thái PR (`pr = merged`) để bắt các trường hợp này. Nếu không có dữ liệu PR, hãy kiểm tra thủ công:
```
git diff --stat origin/main...origin/<branch>     # trống hoặc rất nhỏ = các thay đổi đã có trong main
git log --oneline origin/main --grep "<PR title or number>"
```
Một PR đã đóng (nhưng không gộp) với các commit cũ là công việc đã bị từ bỏ: hãy lưu trữ nó.

## Thẻ lưu trữ
```
git tag archive/<branch> origin/<branch>
git push origin refs/tags/archive/<branch>
git push origin --delete <branch>
```
Khôi phục sau này bằng lệnh `git push origin archive/<branch>:refs/heads/<branch>`. Các thẻ giúp giữ cho các commit tồn tại mãi mãi (không bị dọn rác - garbage collection). Nếu các thẻ lưu trữ làm rối danh sách thẻ, hãy đẩy chúng lên một remote lưu trữ riêng biệt.

Đã xóa mà không gắn thẻ? Trên GitHub, một nhánh bị xóa khỏi trang PR có thể được khôi phục từ PR đó trong một khoảng thời gian; nếu không, bản clone cục bộ của ai đó hoặc `git reflog` trên bản sao (mirror) phía máy chủ là cách duy nhất để lấy lại. Đó là lý do tại sao kịch bản luôn gắn thẻ trước.

## Các phát hiện
| Mã | Mức độ nghiêm trọng | Ý nghĩa | Hành động |
|---|---|---|---|
| CASE_COLLISION | HIGH | `fix/Login` và `fix/login` cùng tồn tại; hệ thống tệp không phân biệt hoa thường lưu trữ các tham chiếu (ref) dưới dạng tệp, nên thao tác fetch sẽ thất bại hoặc một tham chiếu sẽ che khuất tham chiếu kia | Xóa hoặc đổi tên một nhánh ngay hôm nay |
| PR_STALE | MEDIUM | PR đang mở không có commit nào trong >= số ngày cũ | Chủ sở hữu hoàn thiện, tách nhỏ hoặc đóng nó |
| FAR_BEHIND | MEDIUM | Nhánh chưa gộp tụt hậu > 300 commit so với nhánh cơ sở | Sớm rebase/merge nhánh cơ sở hoặc lưu trữ; xung đột sẽ tăng lên mỗi ngày |
| LONG_LIVED | LOW | > 50 commit chưa gộp và không hoạt động >= số ngày cần hỏi | Tách thành các PR nhỏ hơn; ẩn phần công việc chưa hoàn thành sau một cờ tính năng (feature flag) |
| OLD_PROTECTED | LOW | release/* hoặc hotfix/* không hoạt động >= số ngày cũ | Gắn thẻ cho bản phát hành (`v2.3.x`), gỡ bảo vệ, rồi xóa |
| BAD_NAME | LOW | Không có tiền tố `<type>/` được phép, hoặc chứa chữ hoa/khoảng trắng | Đổi tên thành `feature/...`, `fix/...`, `chore/...` |

## Quy ước đặt tên
`<type>/<short-kebab-description>` với mã ticket tùy chọn: `feature/cart-coupons`, `fix/1423-vat-rounding`, `chore/bump-node-22`. Các loại được phép mặc định: feature, feat, fix, bugfix, hotfix, release, chore, docs, refactor, test, ci, perf, build, deps, dependabot, renovate, experiment, spike. Ghi đè bằng `--prefixes`.

## Giữ kho lưu trữ sạch sẽ sau đó
- Bật tùy chọn "Automatically delete head branches" (GitHub) hoặc "Delete source branch" (GitLab) khi gộp.
- Chỉ bảo vệ những nhánh thực sự cần thiết, bằng các mẫu (pattern).
- Chạy kiểm toán hàng tháng; hầu hết các nhóm ổn định ở mức 90 ngày cũ và 30 ngày cần hỏi.
- Các bot (dependabot, renovate) sẽ tự tạo lại nhánh của chúng; hãy giữ cho các PR của chúng được xử lý liên tục thay vì xóa nhánh.
FILE:references/exporting-branch-data.md
# Xuất dữ liệu nhánh

## Tùy chọn A: để kịch bản đọc bản clone
```
git fetch --prune origin
python3 scripts/branch_audit.py --repo . --remote origin --base main
```
Kịch bản sẽ chạy `git for-each-ref`, `git branch -r --merged origin/main` và `git rev-list --left-right --count origin/main...origin/<branch>` cho mọi nhánh. Các kho lưu trữ lớn với hàng nghìn nhánh sẽ mất khoảng một phút.

## Tùy chọn B: tự tạo tệp TSV (hoặc CSV)
Các cột (phân tách bằng tab hoặc dấu phẩy, bắt buộc có dòng tiêu đề; ký tự phân tách được phát hiện từ dòng tiêu đề): `branch last_commit author ahead behind merged pr`

```
base=origin/main
printf 'branch\tlast_commit\tauthor\tahead\tbehind\tmerged\tpr\n' > branches.tsv
git branch -r --merged "$base" | sed 's/^ *//' > /tmp/merged.txt
git for-each-ref --format='%(refname:short)%09%(committerdate:short)%09%(authorname)' refs/remotes/origin |
while IFS="$(printf '\t')" read -r ref date author; do
  case "$ref" in origin|origin/HEAD|"$base") continue;; esac
  set -- $(git rev-list --left-right --count "$base...$ref")
  merged=no; grep -qx "$ref" /tmp/merged.txt && merged=yes
  printf '%s\t%s\t%s\t%s\t%s\t%s\tnone\n' "ref#origin/" "$date" "$author" "$2" "$1" "$merged" >> branches.tsv
done
```
`$1` là "behind" (các commit chỉ có trong nhánh cơ sở) và `$2` là "ahead" (các commit chỉ có trong nhánh đang xét).

## Trạng thái PR
GitHub CLI (`gh pr list` trả về các PR mới nhất trước; awk giữ lại dòng đầu tiên, tức là PR mới nhất, cho mỗi nhánh):
```
gh pr list --state all --limit 1000 --json headRefName,state \
  -q '.[] | [.headRefName, (.state|ascii_downcase)] | @tsv' | awk -F'\t' '!seen[$1]++' > prs.tsv
python3 scripts/branch_audit.py --repo . --prs prs.tsv
```
Các trạng thái trên GitHub ánh xạ thành open, merged, closed. GitLab: `glab mr list --all` hoặc API `GET /projects/:id/merge_requests?state=all` (`source_branch`, `state`: opened -> open, merged, closed).

Đối với tệp TSV hoặc CSV, hãy đặt trạng thái vào cột `pr` (open, merged, closed hoặc none).

## Các ngưỡng
| Tùy chọn | Mặc định | Ghi chú |
|---|---|---|
| `--stale-days` | 90 | Các nhánh chưa gộp không hoạt động vượt quá mức này sẽ được lưu trữ |
| `--ask-days` | 30 | Các nhánh chưa gộp không hoạt động vượt quá mức này cần câu trả lời từ chủ sở hữu |
| `--behind-limit` | 300 | Ngưỡng FAR_BEHIND tính bằng số commit |
| `--protect` | main,master,develop,trunk,gh-pages,release/*,hotfix/* | Các mẫu fnmatch, có phân biệt hoa thường |
| `--prefixes` | feature,fix,chore,... | Các tiền tố tên được phép đối với lỗi BAD_NAME |
| `--today` | today | Cố định ngày để tạo các báo cáo có thể lặp lại |

## Quyền riêng tư
Tên tác giả được lấy từ các commit. Chỉ chia sẻ danh sách theo từng chủ sở hữu trong nội bộ nhóm.
FILE:templates/cleanup-announcement.md
# Dọn dẹp nhánh trên <repository> - vui lòng kiểm tra trước <deadline date>

Chào cả nhóm,

Chúng ta hiện có <N> nhánh trên `<remote>`. Vào ngày <cleanup date>, chúng ta sẽ tiến hành dọn dẹp:

- **<n> nhánh đã gộp** sẽ bị xóa (các thay đổi của chúng đã có trong `<base>`).
- **<n> nhánh chưa gộp không hoạt động** (không có commit nào trong hơn <stale days> ngày) sẽ được lưu thành các thẻ `archive/<branch>` và sau đó bị xóa. Bạn có thể khôi phục bất kỳ nhánh nào trong số đó bằng lệnh `git push origin archive/<branch>:refs/heads/<branch>`.
- **<n> nhánh cần câu trả lời của bạn** (không có commit nào trong hơn <ask days> ngày): giữ lại, gộp, hay lưu trữ?

## Các nhánh của bạn
| Chủ sở hữu | Các nhánh | Cần bạn phản hồi |
|---|---|---|
| <name> | <branch, branch> | <giữ lại / lưu trữ / gộp trước thời hạn> |

## Vui lòng khắc phục
- <CASE_COLLISION: fix/search-timeout và fix/Search-Timeout - Lena, hãy xóa một nhánh ngay hôm nay>
- <PR_STALE: feature/checkout-redesign - Marco, hãy hoàn thiện, tách nhỏ hoặc đóng lại>

## Từ nay trở đi
- Tên nhánh: `<type>/<short-description>` (feature/, fix/, chore/, ...)
- Các nhánh đầu mút (head branch) sẽ tự động bị xóa sau khi gộp.
- Đợt kiểm toán này sẽ chạy vào thứ Hai đầu tiên của mỗi tháng.

Hãy phản hồi tại <channel/thread> nếu có nhánh nào bắt buộc phải giữ lại. Cảm ơn mọi người!
FILE:examples/webshop-branches.csv
branch,last_commit,author,ahead,behind,merged,pr
main,2026-10-23,Selin Kaya,0,0,yes,none
develop,2026-10-22,Selin Kaya,4,0,no,none
release/2.3,2025-11-12,Selin Kaya,2,611,no,none
release/2.8,2026-09-30,Selin Kaya,1,48,no,none
feature/cart-coupons,2026-10-20,Marco Rossi,12,6,no,open
feature/checkout-redesign,2026-04-02,Marco Rossi,134,742,no,open
feature/wishlist-sharing,2026-09-08,Aiko Tanaka,7,95,no,none
feature/gift-cards,2026-05-19,Aiko Tanaka,23,401,no,closed
fix/vat-rounding,2026-10-02,Lena Fischer,3,22,yes,merged
fix/search-timeout,2026-08-14,Lena Fischer,5,130,no,merged
fix/Search-Timeout,2026-08-13,Lena Fischer,1,131,no,none
chore/bump-node-22,2026-07-01,Omar Haddad,0,210,no,none
spike/graphql-gateway,2026-02-10,Omar Haddad,58,988,no,none
johns-test,2026-06-21,John Miller,2,260,no,none
dependabot/npm_and_yarn/axios-1.7.4,2026-10-18,dependabot[bot],1,9,no,open
experiment/ab-banner,2026-10-12,Aiko Tanaka,4,14,no,none
FILE:scripts/branch_audit.py
#!/usr/bin/env python3
"""Stale Git branch cleanup auditor (Python 3 standard library only).

Sorts every remote branch into an action, flags risky branches and prints a reviewable
cleanup script. Nothing is deleted: the script only prints commands.

Input, either:
  1. a TSV or CSV export (header required, delimiter detected from the header, extra columns ignored):
       branch  last_commit  author  ahead  behind  merged  pr
     last_commit = YYYY-MM-DD, ahead/behind = commits vs the base branch,
     merged = yes/no (reachable from base), pr = open | merged | closed | none
  2. --repo PATH: reads the remote branches straight from a local clone with git
     (run `git fetch --prune` first). PR state comes from --prs FILE (lines "branch<TAB>state",
     e.g. from `gh pr list --state all --json headRefName,state`), otherwise "none".
Actions (first match wins):
  KEEP_PROTECTED      name matches --protect patterns (main, master, develop, release/*, ...)
  DELETE_MERGED       merged into base, 0 commits ahead, or its PR was merged (squash/rebase)
  KEEP_OPEN_PR        has an open pull request
  ARCHIVE_AND_DELETE  unmerged and no commit for >= --stale-days (tag archive/<name>, then delete)
  ASK_OWNER           unmerged and no commit for >= --ask-days
  KEEP_ACTIVE         recent unmerged work
Findings (severity):
  HIGH   CASE_COLLISION  branch names that differ only by case (break on macOS/Windows clones)
  MEDIUM PR_STALE        open PR whose branch has had no commit for >= --stale-days
  MEDIUM FAR_BEHIND      unmerged branch more than --behind-limit commits behind base
  LOW    LONG_LIVED      unmerged branch more than 50 commits ahead and older than --ask-days
  LOW    OLD_PROTECTED   protected release/hotfix branch older than --stale-days (tag it, unprotect, delete)
  LOW    BAD_NAME        name without an allowed prefix, or with uppercase/space characters
Usage:
  python3 branch_audit.py branches.csv --today 2026-10-24
  python3 branch_audit.py --repo . --base main --prs prs.tsv
  python3 branch_audit.py branches.tsv --json
  python3 branch_audit.py --self-test
Exit code: 0 no HIGH findings, 1 HIGH findings, 2 bad input.
"""
import argparse
import csv
import datetime as dt
import fnmatch
import json
import shlex
import subprocess
import sys

DEFAULT_PROTECT = "main,master,develop,trunk,gh-pages,release/*,hotfix/*"
DEFAULT_PREFIXES = "feature,feat,fix,bugfix,hotfix,release,chore,docs,refactor,test,ci,perf,build,deps,dependabot,renovate,experiment,spike"
ACTION_ORDER = ["DELETE_MERGED", "ARCHIVE_AND_DELETE", "ASK_OWNER", "KEEP_OPEN_PR", "KEEP_ACTIVE", "KEEP_PROTECTED"]
SEV_ORDER = {"HIGH": 0, "MEDIUM": 1, "LOW": 2}


class DataError(ValueError):
    pass


def yes(v):
    return str(v).strip().lower() in ("yes", "y", "true", "1")


def parse_tsv(text):
    lines = text.splitlines()
    delim = "\t" if lines and "\t" in lines[0] else ","
    rows = list(csv.DictReader(lines, delimiter=delim))
    need = {"branch", "last_commit", "author", "ahead", "behind", "merged"}
    if not rows:
        raise DataError("no branches in input")
    missing = need - set(rows[0].keys())
    if missing:
        raise DataError("missing columns: " + ", ".join(sorted(missing)))
    out = []
    for i, r in enumerate(rows, 2):
        try:
            out.append({"branch": r["branch"].strip(), "last_commit": dt.date.fromisoformat(r["last_commit"].strip()[:10]),
                        "author": r["author"].strip() or "unknown", "ahead": int(r["ahead"]), "behind": int(r["behind"]),
                        "merged": yes(r["merged"]), "pr": (r.get("pr") or "none").strip().lower() or "none"})
        except (ValueError, TypeError) as e:
            raise DataError(f"line {i}: {e}")
    return out


def git(repo, *args):
    r = subprocess.run(["git", "-C", repo, *args], capture_output=True, text=True)
    if r.returncode != 0:
        raise DataError(f"git {' '.join(args)}: {r.stderr.strip()}")
    return r.stdout


def read_repo(repo, remote, base, prs):
    base_ref = f"{remote}/{base}"
    git(repo, "rev-parse", "--verify", base_ref)
    merged = {l.strip() for l in git(repo, "branch", "-r", "--merged", base_ref).splitlines()}
    out = []
    fmt = "%(refname:short)%09%(committerdate:short)%09%(authorname)"
    for line in git(repo, "for-each-ref", f"--format={fmt}", f"refs/remotes/{remote}").splitlines():
        ref, date, author = line.split("\t")
        if ref in (remote, f"{remote}/HEAD") or ref == base_ref:
            continue
        behind, ahead = git(repo, "rev-list", "--left-right", "--count", f"{base_ref}...{ref}").split()
        name = ref[len(remote) + 1:]
        out.append({"branch": name, "last_commit": dt.date.fromisoformat(date), "author": author,
                    "ahead": int(ahead), "behind": int(behind), "merged": ref in merged, "pr": prs.get(name, "none")})
    return out


def audit(branches, today, base="main", remote="origin", stale_days=90, ask_days=30, behind_limit=300,
          protect=DEFAULT_PROTECT, prefixes=DEFAULT_PREFIXES):
    protect_pats = [p.strip() for p in protect.split(",") if p.strip()]
    allowed = {p.strip() for p in prefixes.split(",") if p.strip()}
    findings, rows = [], []

    def add(sev, code, branch, msg):
        findings.append({"severity": sev, "code": code, "branch": branch, "message": msg})

    for b in branches:
        name, age = b["branch"], (today - b["last_commit"]).days
        prot = name == base or any(fnmatch.fnmatchcase(name, p) for p in protect_pats)
        if prot:
            action = "KEEP_PROTECTED"
        elif b["merged"] or b["ahead"] == 0 or b["pr"] == "merged":
            action = "DELETE_MERGED"
        elif b["pr"] == "open":
            action = "KEEP_OPEN_PR"
        elif age >= stale_days:
            action = "ARCHIVE_AND_DELETE"
        elif age >= ask_days:
            action = "ASK_OWNER"
        else:
            action = "KEEP_ACTIVE"
        why = {"KEEP_PROTECTED": "protected pattern",
               "DELETE_MERGED": "merged into " + base if b["merged"] else ("no commits ahead" if b["ahead"] == 0 else "PR merged (squash/rebase)"),
               "KEEP_OPEN_PR": "open pull request", "ARCHIVE_AND_DELETE": f"unmerged, idle {age} days",
               "ASK_OWNER": f"unmerged, idle {age} days", "KEEP_ACTIVE": f"active {age} days ago"}[action]
        rows.append({**b, "last_commit": b["last_commit"].isoformat(), "age_days": age, "action": action, "reason": why})
        unmerged = action in ("ARCHIVE_AND_DELETE", "ASK_OWNER", "KEEP_OPEN_PR", "KEEP_ACTIVE")
        if action == "KEEP_OPEN_PR" and age >= stale_days:
            add("MEDIUM", "PR_STALE", name, f"open PR but no commit for {age} days; ask {b['author']} to finish or close it")
        if unmerged and b["behind"] > behind_limit:
            add("MEDIUM", "FAR_BEHIND", name, f"{b['behind']} commits behind {base}; rebase soon or expect painful conflicts")
        if unmerged and b["ahead"] > 50 and age >= ask_days:
            add("LOW", "LONG_LIVED", name, f"{b['ahead']} unmerged commits; split into smaller PRs or put it behind a feature flag")
        if prot and name != base and age >= stale_days and (name.startswith("release/") or name.startswith("hotfix/")):
            add("LOW", "OLD_PROTECTED", name, f"protected branch idle {age} days; tag it, remove protection and delete")
        if not prot:
            prefix = name.split("/", 1)[0] if "/" in name else ""
            if prefix not in allowed or name != name.lower() or " " in name:
                add("LOW", "BAD_NAME", name, "use lowercase <type>/<short-description> (e.g. feature/cart-coupons)")
    seen = {}
    for b in branches:
        seen.setdefault(b["branch"].lower(), []).append(b["branch"])
    for names in seen.values():
        if len(names) > 1:
            add("HIGH", "CASE_COLLISION", " / ".join(names), "names differ only by case; clones on macOS/Windows see one ref and fetches fail; delete or rename one")
    findings.sort(key=lambda f: (SEV_ORDER[f["severity"]], f["code"], f["branch"]))
    rows.sort(key=lambda r: (ACTION_ORDER.index(r["action"]), -r["age_days"]))
    counts = {a: sum(r["action"] == a for r in rows) for a in ACTION_ORDER}
    owners = {}
    for r in rows:
        if r["action"] in ("ASK_OWNER", "ARCHIVE_AND_DELETE"):
            owners.setdefault(r["author"], []).append(r["branch"])
    script = ["#!/bin/sh", "# Review before running. Generated by branch_audit.py; nothing has been deleted.", "set -e"]
    for r in rows:
        q = shlex.quote(r["branch"])
        if r["action"] == "DELETE_MERGED":
            script.append(f"git push {remote} --delete {q}   # {r['reason']}")
    for r in rows:
        if r["action"] == "ARCHIVE_AND_DELETE":
            q = shlex.quote(r["branch"])
            tag = shlex.quote("archive/" + r["branch"])
            script.append(f"git tag {tag} {shlex.quote(remote + '/' + r['branch'])} && git push {remote} {shlex.quote('refs/tags/archive/' + r['branch'])} && git push {remote} --delete {q}")
    return {"today": today.isoformat(), "base": base, "remote": remote, "stale_days": stale_days, "ask_days": ask_days,
            "branches": len(rows), "counts": counts, "rows": rows, "owners": owners, "findings": findings,
            "cleanup_script": "\n".join(script) + "\n"}


def render(r):
    c = r["counts"]
    out = [f"# Branch cleanup audit ({r['remote']}, base {r['base']}, as of {r['today']})", "",
           f"{r['branches']} branches: {c['DELETE_MERGED']} delete (merged), {c['ARCHIVE_AND_DELETE']} archive and delete, "
           f"{c['ASK_OWNER']} ask owner, {c['KEEP_OPEN_PR']} open PR, {c['KEEP_ACTIVE']} active, {c['KEEP_PROTECTED']} protected",
           f"Rules: stale >= {r['stale_days']} days idle, ask owner >= {r['ask_days']} days", "",
           "| Action | Branch | Last commit | Author | Ahead/behind | Reason |", "|---|---|---|---|---|---|"]
    for row in r["rows"]:
        out.append(f"| {row['action']} | {row['branch']} | {row['last_commit']} | {row['author']} | {row['ahead']}/{row['behind']} | {row['reason']} |")
    out += ["", "## Ask the owners"]
    if not r["owners"]:
        out.append("- nobody")
    for who, names in sorted(r["owners"].items()):
        out.append(f"- {who}: {', '.join(names)}")
    out += ["", "## Findings"]
    if not r["findings"]:
        out.append("- none")
    for f in r["findings"]:
        out.append(f"- {f['severity']} {f['code']} {f['branch']}: {f['message']}")
    out += ["", "## Cleanup script (review first, run after owners agree)", "```sh", r["cleanup_script"].rstrip(), "```"]
    return "\n".join(out) + "\n"


def self_test():
    tests, ok = [], 0

    def check(name, cond):
        nonlocal ok
        tests.append(name)
        print(("PASS " if cond else "FAIL ") + name)
        ok += bool(cond)

    today = dt.date(2026, 10, 24)

    def b(name, days, ahead=3, behind=10, merged=False, pr="none", author="ana"):
        return {"branch": name, "last_commit": today - dt.timedelta(days=days), "author": author,
                "ahead": ahead, "behind": behind, "merged": merged, "pr": pr}

    def act(**kw):
        name = kw.pop("name", "feature/x")
        days = kw.pop("days", 10)
        return audit([b(name, days, **kw)], today)["rows"][0]["action"]

    check("main protected", act(name="main", days=500) == "KEEP_PROTECTED")
    check("release/* protected", act(name="release/2.4", days=200) == "KEEP_PROTECTED")
    check("merged -> DELETE_MERGED", act(merged=True, days=5) == "DELETE_MERGED")
    check("0 ahead -> DELETE_MERGED", act(ahead=0) == "DELETE_MERGED")
    check("squash-merged PR -> DELETE_MERGED", act(pr="merged", ahead=4) == "DELETE_MERGED")
    check("open PR kept", act(pr="open", days=200) == "KEEP_OPEN_PR")
    check("idle 120 d unmerged -> ARCHIVE", act(days=120) == "ARCHIVE_AND_DELETE")
    check("idle 45 d -> ASK_OWNER", act(days=45) == "ASK_OWNER")
    check("idle 5 d -> KEEP_ACTIVE", act(days=5) == "KEEP_ACTIVE")
    check("closed PR idle 100 d -> ARCHIVE", act(pr="closed", days=100) == "ARCHIVE_AND_DELETE")

    def codes(rows, **kw):
        return {f["code"] for f in audit(rows, today, **kw)["findings"]}

    check("case collision HIGH", "CASE_COLLISION" in codes([b("feature/Login", 3), b("feature/login", 3)]))
    check("stale PR MEDIUM", "PR_STALE" in codes([b("feature/a", 100, pr="open")]))
    check("far behind MEDIUM", "FAR_BEHIND" in codes([b("feature/a", 10, behind=900)]))
    check("merged far behind not flagged", "FAR_BEHIND" not in codes([b("feature/a", 10, behind=900, merged=True)]))
    check("long lived LOW", "LONG_LIVED" in codes([b("feature/a", 40, ahead=80)]))
    check("old release LOW", "OLD_PROTECTED" in codes([b("release/1.0", 400)]))
    check("bad name LOW", "BAD_NAME" in codes([b("johns-test", 3)]) and "BAD_NAME" in codes([b("feature/NewThing", 3)]))
    check("good name not flagged", "BAD_NAME" not in codes([b("fix/cart-total", 3)]))
    r = audit([b("feature/old", 200), b("fix/done", 3, merged=True)], today)
    check("script deletes merged branch", "git push origin --delete fix/done" in r["cleanup_script"])
    check("script tags before deleting stale", "git tag archive/feature/old origin/feature/old && git push origin refs/tags/archive/feature/old && git push origin --delete feature/old" in r["cleanup_script"])
    r = audit([b("main", 1, ahead=0, behind=0), b("feature/old", 200), b("develop", 300)], today)
    check("script never deletes protected branches", "--delete main" not in r["cleanup_script"] and "--delete develop" not in r["cleanup_script"]
          and r["cleanup_script"].rstrip().endswith("git push origin --delete feature/old"))
    r = audit([b("feature/it's", 200)], today)
    check("odd names are shell-quoted", "'feature/it'\"'\"'s'" in r["cleanup_script"])
    r = audit([b("feature/a", 200, author="ana"), b("feature/b", 40, author="ana"), b("feature/c", 2, author="bo")], today)
    check("owners grouped", r["owners"] == {"ana": ["feature/a", "feature/b"]})
    rows = parse_tsv("branch\tlast_commit\tauthor\tahead\tbehind\tmerged\tpr\nfeature/x\t2026-10-01\tAna\t2\t5\tno\topen\n")
    check("TSV parsed", rows[0]["ahead"] == 2 and rows[0]["pr"] == "open" and not rows[0]["merged"])
    rows = parse_tsv("branch,last_commit,author,ahead,behind,merged,pr\nfix/y,2026-09-01,Bo,0,3,yes,none\n")
    check("CSV parsed", rows[0]["branch"] == "fix/y" and rows[0]["merged"] and rows[0]["behind"] == 3)
    try:
        parse_tsv("branch\tauthor\nx\ty\n")
        check("missing columns rejected", False)
    except DataError:
        check("missing columns rejected", True)
    # real git repository round trip (skipped if git is missing)
    import os, shutil, tempfile
    if shutil.which("git"):
        d = tempfile.mkdtemp()
        try:
            env = {**os.environ, "GIT_AUTHOR_NAME": "Ana", "GIT_AUTHOR_EMAIL": "a@x", "GIT_COMMITTER_NAME": "Ana", "GIT_COMMITTER_EMAIL": "a@x"}
            run = lambda *a, cwd=d: subprocess.run(["git", *a], cwd=cwd, env=env, capture_output=True, check=True)
            os.makedirs(f"{d}/remote.git"); run("init", "-q", "--bare", "-b", "main", cwd=f"{d}/remote.git")
            run("clone", "-q", f"{d}/remote.git", "w"); w = f"{d}/w"
            run("checkout", "-q", "-b", "main", cwd=w); run("commit", "-q", "--allow-empty", "-m", "init", cwd=w)
            run("checkout", "-q", "-b", "fix/done", cwd=w); run("commit", "-q", "--allow-empty", "-m", "fix", cwd=w)
            run("checkout", "-q", "main", cwd=w); run("merge", "-q", "--ff-only", "fix/done", cwd=w)
            run("checkout", "-q", "-b", "feature/wip", cwd=w); run("commit", "-q", "--allow-empty", "-m", "wip", cwd=w)
            run("push", "-q", "origin", "main", "fix/done", "feature/wip", cwd=w)
            r = audit(read_repo(w, "origin", "main", {}), today)
            acts = {x["branch"]: x["action"] for x in r["rows"]}
            check("git repo: merged and active branches read", acts == {"fix/done": "DELETE_MERGED", "feature/wip": "KEEP_ACTIVE"})
        finally:
            shutil.rmtree(d, ignore_errors=True)
    print(f"{ok}/{len(tests)} passed")
    return 0 if ok == len(tests) else 1


def main():
    ap = argparse.ArgumentParser(description="Stale Git branch cleanup auditor")
    ap.add_argument("tsv", nargs="?", help="branch TSV or CSV export")
    ap.add_argument("--repo", help="read remote branches from this local clone instead of a TSV")
    ap.add_argument("--prs", help="TSV 'branch<TAB>state' with PR states (open/merged/closed), used with --repo")
    ap.add_argument("--remote", default="origin")
    ap.add_argument("--base", default="main")
    ap.add_argument("--today", help="YYYY-MM-DD (default: today)")
    ap.add_argument("--stale-days", type=int, default=90)
    ap.add_argument("--ask-days", type=int, default=30)
    ap.add_argument("--behind-limit", type=int, default=300)
    ap.add_argument("--protect", default=DEFAULT_PROTECT)
    ap.add_argument("--prefixes", default=DEFAULT_PREFIXES)
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args()
    if a.self_test:
        return self_test()
    try:
        today = dt.date.fromisoformat(a.today) if a.today else dt.date.today()
        if a.repo:
            prs = {}
            if a.prs:
                with open(a.prs, encoding="utf-8") as fh:
                    for line in fh:
                        if "\t" in line:
                            k, v = line.rstrip("\n").split("\t", 1)
                            prs[k] = v.strip().lower()
            branches = read_repo(a.repo, a.remote, a.base, prs)
        elif a.tsv:
            with open(a.tsv, encoding="utf-8") as fh:
                branches = parse_tsv(fh.read())
        else:
            ap.error("give a TSV/CSV file or --repo PATH")
        r = audit(branches, today, a.base, a.remote, a.stale_days, a.ask_days, a.behind_limit, a.protect, a.prefixes)
    except (OSError, DataError, ValueError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(r, indent=2) if a.json else render(r), end="\n" if a.json else "")
    return 1 if any(f["severity"] == "HIGH" for f in r["findings"]) else 0


if __name__ == "__main__":
sys.exit(main())Tính toán mức đơn giá theo giờ và theo ngày mà một freelancer cần thu dựa trên mức thu nhập thực nhận mong muốn. Tính đủ thuế, chi phí kinh doanh, khoản tiết kiệm, kỳ nghỉ phép, ngày lễ, ngày ốm, tỷ lệ giờ làm tính phí thực tế và khoản đệm rủi ro; hiển thị sự biến đổi của đơn giá theo thời gian tính phí và định giá dự án kèm khoản dự phòng. Cảnh báo các mức giá thấp hơn điểm hòa vốn hoặc mục tiêu, số giờ tính phí thiếu thực tế và mức giá lệch chuẩn thị trường. Bao gồm công cụ tính viết bằng thư viện chuẩn Python có hỗ trợ --self-test.
---
name: freelance-hourly-rate-calculator
description: Tính toán mức đơn giá theo giờ và theo ngày mà một freelancer cần thu dựa trên mức thu nhập thực nhận mong muốn. Tính đủ thuế, chi phí kinh doanh, khoản tiết kiệm, kỳ nghỉ phép, ngày lễ, ngày ốm, tỷ lệ giờ làm tính phí thực tế và khoản đệm rủi ro; hiển thị sự biến đổi của đơn giá theo thời gian tính phí và định giá dự án kèm khoản dự phòng. Cảnh báo các mức giá thấp hơn điểm hòa vốn hoặc mục tiêu, số giờ tính phí thiếu thực tế và mức giá lệch chuẩn thị trường. Bao gồm công cụ tính viết bằng thư viện chuẩn Python có hỗ trợ --self-test.
---

# Công Cụ Tính Đơn Giá Theo Giờ Cho Freelancer

Bạn giúp các freelancer và những người sắp chuyển sang làm freelance tìm ra mức đơn giá đủ để trang trải cuộc sống. Hầu hết mọi người đều định giá quá thấp vì họ lấy mức lương chia cho 2080 giờ mà quên mất thuế, bảo hiểm, trang thiết bị, những ngày nghỉ lễ không lương, ngày nghỉ ốm cũng như số giờ phải dành cho việc tìm kiếm khách hàng và quản trị hành chính. Bạn tính ngược từ mức thu nhập thực nhận (take-home income) mà họ mong muốn để tìm ra đơn giá theo giờ tối thiểu, làm tròn thành mức giá có thể báo cho khách hàng, chỉ rõ mức giá hiện tại thực chất mang lại cho họ bao nhiêu tiền và định giá cho dự án tiếp theo của họ.

## Các tệp trong kỹ năng này

- `scripts/rate_calc.py` - tính toán doanh thu cần thiết, số giờ tính phí (billable hours), đơn giá tối thiểu, đơn giá báo khách, đơn giá theo ngày và đơn giá hòa vốn, bảng tỷ lệ giờ tính phí, khoảng cách chênh lệch của mức giá hiện tại và giá trọn gói dự án (chỉ dùng thư viện chuẩn Python 3)
- `references/rate-math.md` - các công thức tính từng bước, danh sách chi phí điển hình, tỷ lệ giờ tính phí theo loại hình công việc, hướng dẫn ước tính thuế sơ bộ và những sai lầm thường gặp
- `references/pricing-and-raising-rates.md` - cách định giá theo ngày, theo dự án, theo gói duy trì (retainer) và theo giá trị mang lại, cách gửi báo giá và cách tăng giá với khách hàng hiện tại
- `templates/rate-card.md` - bảng báo giá (rate card) gói gọn trong một trang gồm giá theo giờ, theo ngày, giá theo gói và các điều khoản
- `examples/ux-designer-rate-plan.json` - ví dụ về một nhà thiết kế UX tại Berlin muốn thu nhập thực nhận 48.000 EUR và hiện đang tính phí 65 EUR/giờ

## Quy trình thực hiện

### 1. Thu thập các con số
Hãy hỏi người dùng về: mức thu nhập thực nhận mong muốn mỗi năm (sau khi trừ thuế và chi phí kinh doanh), các khoản tiết kiệm muốn để dành riêng (lương hưu, quỹ dự phòng khẩn cấp), mức thuế suất thực tế và tỷ lệ đóng bảo hiểm xã hội (nếu chưa rõ, hãy dùng hướng dẫn ước tính trong `references/rate-math.md` và nhắc họ xác nhận lại với kế toán), mọi chi phí kinh doanh (bảo hiểm, phần mềm, thiết bị, không gian làm việc, kế toán, tiếp thị, đào tạo), số giờ làm việc mỗi tuần, số tuần nghỉ phép, số ngày nghỉ lễ, số ngày nghỉ ốm và học tập nâng cao, cùng tỷ lệ thời gian làm việc thực sự có thể tính phí cho khách hàng. Đồng thời hỏi thêm về mức giá hiện tại của họ, mức giá thị trường phổ biến cho lĩnh vực và khu vực của họ, cũng như ước tính cho một dự án sắp tới nếu có.

### 2. Chạy công cụ tính toán
```
python3 scripts/rate_calc.py examples/ux-designer-rate-plan.json
python3 scripts/rate_calc.py plan.json --round 10 --json
python3 scripts/rate_calc.py --self-test
```
Mã thoát (exit code) 1 nghĩa là có phát hiện mức độ HIGH, 2 nghĩa là dữ liệu đầu vào không hợp lệ.

### 3. Giải thích kết quả
Mở đầu bằng mức đơn giá tối thiểu và mức đơn giá dùng để báo khách, sau đó phân tích chuỗi tính toán từ thu nhập thực nhận đến tổng doanh thu để họ thấy rõ dòng tiền đi đâu. Sử dụng bảng tỷ lệ giờ tính phí để chứng minh lý do vì sao mức 60% thời gian tính phí là con số mặc định thực tế. Nếu mức giá hiện tại quá thấp, hãy chỉ ra khoản thiếu hụt và số giờ tính phí cần thiết để bù đắp khoản đó, sau đó đưa ra các phương án từ `references/pricing-and-raising-rates.md`: ưu tiên tăng giá cho khách hàng mới trước, chuyển sang định giá theo ngày hoặc theo dự án, cắt giảm chi phí hoặc hạ thấp mục tiêu thu nhập.

### 4. Bàn giao
Điền vào mẫu `templates/rate-card.md` với đơn giá theo giờ, theo ngày và theo gói dịch vụ, các điều khoản thanh toán cùng ngày rà soát điều chỉnh giá tiếp theo.

## Ví dụ kết quả
Đối với `examples/ux-designer-rate-plan.json`: 48.000 EUR thu nhập thực nhận + 7.800 EUR khoản để dành = 83.284 EUR lợi nhuận trước mức thuế 33%; + 13.500 EUR chi phí và 8% khoản đệm rủi ro = 105.200 EUR doanh thu. 214 ngày làm việc với 60% thời gian tính phí = 1027 giờ tính phí, do đó mức tối thiểu là 102,41 EUR/giờ: nên báo giá 105 EUR/giờ hoặc 840 EUR/ngày. Với mức giá hiện tại 65 EUR/giờ, thu nhập thực nhận sẽ chỉ đạt 24.311 EUR (thiếu hụt 23.689 EUR), và để đạt được mục tiêu thì cần tới 94,5% thời gian làm việc đều tính phí được (HIGH BELOW_REQUIRED). Dự án thiết kế lại ứng dụng phòng khám dài 120 giờ cộng thêm 20% dự phòng sẽ có giá 15.120 EUR thay vì 9.360 EUR.

## Quy tắc

- Các con số về thuế chỉ là ước tính sơ bộ, không phải tư vấn thuế chuyên nghiệp; hãy nhắc người dùng xác nhận mức thuế suất với kế toán tại địa phương.
- Tuyệt đối không giả định thời gian tính phí vượt quá 70% nếu không có bằng chứng từ dữ liệu theo dõi thời gian thực tế của chính họ.
- Hiển thị rõ các công thức và dữ liệu đầu vào để họ có thể thay đổi một giả định và chạy lại.
- Mức giá thấp hơn thị trường thì có thể tăng lên; nhưng nếu mức tối thiểu cao hơn mặt bằng thị trường thì cần thay đổi gói giải pháp cung cấp chứ không chỉ đơn thuần đưa ra một con số cao hơn.
- Sử dụng đúng đơn vị tiền tệ và bối cảnh thuế mà họ cung cấp; không trộn lẫn các loại tiền tệ.
FILE:references/rate-math.md
# Công Thức Tính Đơn Giá

## Chuỗi công thức chi tiết từng bước
1. **Số tiền cần có sau thuế** = thu nhập thực nhận mục tiêu + các khoản để dành (lương hưu, quỹ khẩn cấp, mục tiêu tiết kiệm)
2. **Lợi nhuận trước thuế** = số tiền cần có sau thuế / (1 - thuế suất thực tế và tỷ lệ đóng bảo hiểm xã hội)
3. **Doanh thu cần thiết** = (lợi nhuận trước thuế + chi phí kinh doanh) / (1 - khoản đệm rủi ro)
4. **Số ngày làm việc** = 260 ngày trong tuần - số tuần nghỉ phép x 5 - số ngày nghỉ lễ - số ngày nghỉ ốm - số ngày đào tạo
5. **Số giờ tính phí (Billable hours)** = số ngày làm việc x số giờ làm mỗi tuần / 5 x tỷ lệ thời gian tính phí
6. **Đơn giá tối thiểu** = doanh thu cần thiết / số giờ tính phí
7. **Đơn giá báo khách** = đơn giá tối thiểu làm tròn lên (theo bội số của 5 hoặc 10); **đơn giá theo ngày** = đơn giá báo khách x số giờ làm mỗi ngày
8. **Đơn giá hòa vốn** = chi phí kinh doanh / (1 - khoản đệm) / số giờ tính phí (chỉ đủ trả các hóa đơn chi phí, bạn không nhận được đồng nào)

Kiểm tra ngược: thu nhập thực nhận tại mức giá R = (R x số giờ tính phí x (1 - khoản đệm) - chi phí) x (1 - thuế) - các khoản để dành.

## Tại sao công thức "lương / 2080" lại sai lầm
2080 = 52 tuần x 40 giờ. Một freelancer không hề được trả tiền cho bất kỳ khoản nào sau đây: kỳ nghỉ phép (20-30 ngày), ngày nghỉ lễ (8-14 ngày), ngày nghỉ ốm (5-10 ngày), thời gian học tập nâng cao (3-10 ngày), và 30-50% thời gian làm việc phải dành cho việc bán hàng, viết đề xuất (proposal), hành chính, xuất hóa đơn và học hỏi. Mức lương 60.000 khi đi làm công ăn lương còn đi kèm với khoản đóng góp hưu trí và bảo hiểm xã hội từ phía công ty, nghỉ phép có lương và trang thiết bị làm việc. Quy tắc ước lượng thông thường là đơn giá theo giờ = tiền lương / 1000 đến 1200, con số này khá sát với kết quả của phép tính đầy đủ.

## Tỷ lệ giờ tính phí theo loại hình công việc
| Tình huống | Tỷ lệ giờ tính phí thực tế |
|---|---|
| Freelancer mới, vẫn đang tìm kiếm khách hàng | 35-50% |
| Kết hợp nhiều dự án, có khách hàng quen | 50-65% |
| Hợp đồng toàn thời gian dài hạn với một khách hàng | 70-85% (nhưng hoạt động bán hàng bị ngưng trệ, và khoảng trống sau khi kết thúc hợp đồng thường kéo dài) |
| Mô hình kiểu agency với khối lượng quản lý tài khoản khách hàng lớn | 45-60% |

Cách đo lường: theo dõi mọi giờ làm việc trong vòng 4-8 tuần, sau đó sử dụng tỷ lệ thực tế thu được.

## Các chi phí kinh doanh điển hình
- Bảo hiểm y tế, bảo hiểm mất khả năng lao động và bảo hiểm trách nhiệm nghề nghiệp (khi phải tự đóng)
- Khoản đóng quỹ hưu trí nếu bắt buộc (hoặc đưa vào mục các khoản để dành)
- Phần cứng tính theo chu kỳ thay mới (laptop 3 năm, điện thoại 2-3 năm), thuê bao phần mềm, dịch vụ đám mây và tên miền
- Không gian làm việc: văn phòng chia sẻ (coworking), phần chi phí văn phòng tại nhà, internet, điện thoại
- Kế toán, phí ngân hàng, phí cổng thanh toán, công cụ xuất hóa đơn
- Tiếp thị: trang web, hồ sơ năng lực (portfolio), phí nền tảng, sự kiện, chi phí đi lại gặp khách hàng
- Đào tạo: khóa học, sách vở, hội thảo
- Phí thành viên hiệp hội nghề nghiệp, giấy phép, mẫu hợp đồng pháp lý

## Thuế suất thực tế và tỷ lệ đóng bảo hiểm (chỉ mang tính tham khảo sơ bộ)
Tỷ lệ thực tế là tổng thuế thu nhập và các khoản đóng bảo hiểm xã hội bắt buộc chia cho lợi nhuận. Con số này phụ thuộc vào quốc gia, khu vực, loại hình pháp lý, hoàn cảnh gia đình và các khoản giảm trừ. Ước tính sơ bộ ban đầu cho một người độc thân có lợi nhuận khoảng 60.000-100.000 tại Châu Âu hoặc Bắc Mỹ thường rơi vào khoảng 25-40%; các chế độ thuế thấp và chương trình thuế khoán có thể thấp hơn nhiều. Luôn luôn xác nhận với kế toán địa phương và thay thế con số ước tính này.

## Khoản đệm rủi ro
Dùng để bù đắp cho các hóa đơn thanh toán chậm hoặc bị nợ xấu, khoảng trống giữa các đợt khách hàng, phần phạm vi công việc phát sinh không thể tính phí và những tháng vắng khách. Đặt ở mức 5% đối với các hợp đồng duy trì (retainer) ổn định, 10-15% đối với công việc theo dự án làm cùng khách hàng mới.

## Những sai lầm thường gặp
- Coi tổng doanh thu gộp là thu nhập bỏ túi (thuế và chi phí sẽ bị trừ đi sau đó)
- Lên kế hoạch như thể 100% số giờ làm việc đều tính phí được
- Quên rằng thuế GTGT (VAT/sales tax) không phải là thu nhập (các mức giá tính ở đây đều chưa bao gồm VAT)
- Không tính chi phí ngày nghỉ vào giá: mỗi tuần nghỉ ngơi đều phải được bù đắp bởi những tuần làm việc
- Giảm giá theo giờ cho các dự án dài hạn mà không có cam kết đảm bảo khối lượng công việc
FILE:references/pricing-and-raising-rates.md
# Các Mô Hình Định Giá Và Cách Tăng Giá

## Lựa chọn mô hình định giá
| Mô hình | Khi nào nên dùng | Cách tính từ đơn giá tối thiểu |
|---|---|---|
| Theo giờ (Hourly) | Phạm vi chưa rõ ràng, công việc hỗ trợ, chỉnh sửa nhỏ | Đơn giá báo khách; tính phí theo từng bước 15 hoặc 30 phút |
| Theo ngày (Day rate) | Buổi workshop, làm việc cắm chốt cùng nhóm khách hàng, hợp đồng ngắn hạn | Đơn giá báo khách x số giờ mỗi ngày; nửa ngày = 55-60% của cả ngày (do chi phí chuyển đổi ngữ cảnh) |
| Theo dự án (Giá cố định) | Đầu mục bàn giao rõ ràng, bạn ước lượng thời gian chuẩn xác | Số giờ ước tính x (1 + tỷ lệ dự phòng) x đơn giá báo khách; liệt kê rõ những gì bao gồm trong gói và số vòng chỉnh sửa |
| Gói duy trì (Retainer) | Công việc diễn ra đều đặn hàng tháng | Số giờ đặt trước mỗi tháng x đơn giá báo khách, thường giảm 5-10% nhờ khối lượng được cam kết; số giờ không dùng hết sẽ hết hạn |
| Dựa trên giá trị (Value-based) | Công việc của bạn tạo ra doanh thu hoặc khoản tiết kiệm đo lường được | 5-20% giá trị mang lại trong năm đầu tiên, tuyệt đối không thấp hơn giá tính theo dự án |

Tỷ lệ dự phòng (contingency) cho giá cố định: 10-15% đối với công việc bạn đã làm nhiều lần, 20-30% đối với loại công việc mới, 30-50% khi yêu cầu chưa rõ ràng hoặc có nhiều bên liên quan phê duyệt.

## Cách gửi báo giá
- Báo một con số cụ thể, không báo một khoảng giá; khoảng giá sẽ luôn bị đàm phán ép xuống mức thấp nhất.
- Khi định giá theo dự án, hãy hiển thị mức giá theo từng gói hoặc hạng mục bàn giao, không hiển thị số giờ.
- Đưa các điều khoản thanh toán vào báo giá: tạm ứng trước 30-50% đối với khách hàng mới, hạn thanh toán trong 14 ngày (net 14) hoặc 30 ngày (net 30), phí trả chậm, và quy định xử lý khi phạm vi công việc thay đổi.
- Nêu rõ đơn giá chưa bao gồm thuế GTGT (VAT/sales tax).

## Khi đơn giá tối thiểu thấp hơn thị trường
Hãy báo giá ít nhất bằng mức trung bình của thị trường cho cấp độ kỹ năng của bạn. Thu phí thấp hơn sẽ phát đi tín hiệu về chất lượng thấp và không để lại khoản dư nào cho những tháng ít việc.

## Khi đơn giá tối thiểu cao hơn thị trường
Chỉ đưa ra một con số cao hơn sẽ không thuyết phục được khách hàng. Các phương án giải quyết:
1. Chuyên môn hóa sâu (theo ngành nghề hoặc vấn đề cụ thể) để cạnh tranh với ít người hơn và có thể định giá cao hơn mặt bằng chung.
2. Đóng gói theo kết quả đầu ra và áp dụng định giá theo dự án hoặc theo giá trị.
3. Cắt giảm những chi phí không giúp mang lại công việc.
4. Tăng tỷ lệ giờ tính phí bằng các hợp đồng duy trì (retainer) và làm việc với ít khách hàng hơn nhưng quy mô lớn hơn.
5. Hạ mục tiêu thu nhập trong năm đầu tiên và lên lộ trình tăng giá theo từng giai đoạn.

## Cách tăng giá với khách hàng hiện tại
- Khách hàng mới áp dụng ngay mức giá mới.
- Khách hàng hiện tại: thông báo trước 30-60 ngày, nêu rõ ngày bắt đầu áp dụng, lý do ngắn gọn (thêm kinh nghiệm, phạm vi công việc, mặt bằng thị trường) và không cần xin lỗi.
- Mỗi lần tăng khoảng 10-20%, mỗi năm một lần hoặc khi bạn đã kín lịch làm việc từ 3 tháng trở lên.
- Đề xuất giữ nguyên mức giá cũ nếu khách hàng mua trả trước một gói giờ làm việc hoặc ký hợp đồng retainer dài hạn hơn khi bạn muốn giữ chân một khách hàng trọng điểm.

Mẫu thông báo tham khảo:
> Kể từ ngày 1 tháng 1, đơn giá của tôi cho các công việc mới sẽ là 105 EUR mỗi giờ (840 EUR mỗi ngày). Các công việc đã thỏa thuận trước đó vẫn giữ nguyên mức giá hiện tại cho đến khi hoàn thành. Cảm ơn sự hợp tác tuyệt vời của quý vị trong năm qua; tôi rất mong chờ được đồng hành trong các dự án tiếp theo.

## Các dấu hiệu cho thấy mức giá đang quá thấp
- Bạn kín lịch làm việc trong nhiều tháng liền và không ai thắc mắc hay phàn nàn về giá cả.
- Bạn thắng thầu gần như mọi bản đề xuất (proposal) gửi đi.
- Bạn không dám nghỉ phép hoặc không đủ khả năng chi trả cho việc học tập nâng cao.
FILE:templates/rate-card.md
# Bảng Báo Giá (Rate Card) - <name>, <role>

**Có hiệu lực từ:** <date>  **Kỳ rà soát tiếp theo:** <date + 12 months>  **Tiền tệ:** <EUR>, giá chưa bao gồm VAT

## Đơn giá cơ bản
| Dịch vụ | Mức giá |
|---|---|
| Đơn giá theo giờ | <105> mỗi giờ |
| Đơn giá theo ngày (8 giờ) | <840> mỗi ngày |
| Nửa ngày (4 giờ) | <480> |
| Gói duy trì hàng tháng (<20> giờ, giờ không dùng hết sẽ hết hạn) | <2,000> mỗi tháng |

## Các gói dịch vụ trọn gói
| Gói dịch vụ | Bao gồm | Mức giá |
|---|---|---|
| <UX audit> | <đánh giá chuyên sâu 10 màn hình chính, báo cáo sắp xếp theo mức độ ưu tiên, cuộc gọi trao đổi 1 giờ> | <2,400> |
| <App redesign> | <nghiên cứu, wireframe, thiết kế UI cho <n> màn hình, 2 vòng chỉnh sửa, hệ thống thiết kế (design system)> | <15,120> |

## Điều khoản
- Thanh toán: <tạm ứng 40%, phần còn lại khi bàn giao>, hóa đơn thanh toán trong vòng <14> ngày; phí trả chậm <x%> mỗi tháng
- Thay đổi phạm vi công việc: báo giá riêng trước khi bắt đầu thực hiện
- Chỉnh sửa: bao gồm <2> vòng chỉnh sửa, sau đó tính phí theo giờ
- Hủy dịch vụ: <thời gian báo trước / phí hủy>
- Đi lại: <ngoài thành phố tính theo chi phí thực tế + thời gian di chuyển tính bằng 50% đơn giá>

## Các con số hậu trường (riêng tư, không gửi cho khách hàng)
- Đơn giá tối thiểu: <102.41>/giờ ở mức <60>% thời gian tính phí (<1027> giờ/năm)
- Đơn giá hòa vốn: <14.29>/giờ
- Thu nhập thực nhận mục tiêu: <48,000>, doanh thu cần thiết: <105,200>
FILE:examples/ux-designer-rate-plan.json
{
  "name": "Deniz, freelance UX/UI designer (Berlin)",
  "currency": "EUR",
  "target_net_income": 48000,
  "set_asides": [
    {"name": "retirement", "annual": 6000},
    {"name": "emergency fund top-up", "monthly": 150}
  ],
  "tax": {"effective_rate_pct": 33},
  "business_costs": [
    {"name": "health and care insurance (self-paid)", "monthly": 520},
    {"name": "coworking desk", "monthly": 190},
    {"name": "software (Figma, Adobe, Notion)", "monthly": 95},
    {"name": "laptop and display (3-year write-off)", "annual": 1100},
    {"name": "accountant", "monthly": 110},
    {"name": "liability insurance", "annual": 280},
    {"name": "website, portfolio and domain", "annual": 240},
    {"name": "courses and conferences", "annual": 900}
  ],
  "time": {
    "hours_per_week": 40,
    "vacation_weeks": 5,
    "public_holidays_days": 10,
    "sick_days": 6,
    "training_days": 5,
    "billable_pct": 60,
    "hours_per_day": 8
  },
  "risk_buffer_pct": 8,
  "current_rate": 65,
  "market_rate": {"low": 70, "high": 110},
  "project": {"name": "Clinic booking app redesign", "estimated_hours": 120, "contingency_pct": 20}
}
FILE:scripts/rate_calc.py
#!/usr/bin/env python3
"""Freelance hourly rate calculator (Python 3 standard library only).

Works backwards from the take-home income you want to the hourly and day rate you must charge,
counting taxes, business costs, unpaid time and a risk buffer. Compares the result with your
current rate and the market, and prices a project.

Input JSON (amounts per year unless "monthly" is given):
  {"name": "...", "currency": "EUR",
   "target_net_income": 48000,                      # take-home after tax and costs
   "set_asides": [{"name": "retirement", "annual": 6000}],          (optional, after tax)
   "tax": {"effective_rate_pct": 32},               # income tax + social contributions on profit
   "business_costs": [{"name": "coworking", "monthly": 180}, {"name": "laptop", "annual": 2400}],
   "time": {"hours_per_week": 40, "vacation_weeks": 5, "public_holidays_days": 10,
            "sick_days": 6, "training_days": 5, "billable_pct": 60, "hours_per_day": 8},
   "risk_buffer_pct": 10,                           # unpaid invoices, gaps between clients
   "current_rate": 55, "market_rate": {"low": 60, "high": 95},       (optional)
   "project": {"name": "...", "estimated_hours": 120, "contingency_pct": 20}}  (optional)
Formulas:
  needed after tax   = target net + set-asides
  profit before tax  = needed after tax / (1 - tax rate)
  revenue needed     = (profit before tax + business costs) / (1 - risk buffer)
  working days       = 260 - vacation weeks x 5 - holidays - sick days - training days
  billable hours     = working days x hours per week / 5 x billable %
  minimum rate       = revenue needed / billable hours; quoted rate = minimum rounded up to
                       the next --round (default 5); project price rounded up to 10; day rate = quoted x hours per day
  break-even rate    = business costs / (1 - buffer) / billable hours (no income at all)
  net at a rate      = (rate x billable hours x (1 - buffer) - costs) x (1 - tax) - set-asides
Findings (severity):
  HIGH   NO_TAX            tax rate missing or 0
  HIGH   BELOW_BREAK_EVEN  current rate does not even cover business costs
  HIGH   BELOW_REQUIRED    current rate below the minimum rate (yearly shortfall shown)
  MEDIUM ABOVE_MARKET      minimum rate above the market high: niche, value pricing or lower target
  MEDIUM BILLABLE_HIGH     billable share above 75% of working time
  MEDIUM LONG_HOURS        more than 50 hours per week
  MEDIUM SHORT_VACATION    under 3 weeks of vacation
  LOW    UNDER_MARKET      quoted rate below the market low: you can likely charge more
  LOW    NO_BUFFER         risk buffer 0
  LOW    NO_SICK_DAYS      no sick days planned
  LOW    NO_CONTINGENCY    project quote without contingency
Usage:
  python3 rate_calc.py plan.json
  python3 rate_calc.py plan.json --round 10 --json
  python3 rate_calc.py --self-test
Exit code: 0 no HIGH findings, 1 HIGH findings, 2 bad input.
"""
import argparse
import json
import math
import sys

SEV_ORDER = {"HIGH": 0, "MEDIUM": 1, "LOW": 2}


class DataError(ValueError):
    pass


def annual(item):
    if "annual" in item:
        return float(item["annual"])
    if "monthly" in item:
        return float(item["monthly"]) * 12
    raise DataError(f"cost '{item.get('name', '?')}' needs 'annual' or 'monthly'")


def round_up(x, step):
    return math.ceil(x / step - 1e-9) * step


def calc(cfg, step=5):
    t = cfg.get("time") or {}
    hpw = float(t.get("hours_per_week", 40))
    hpd = float(t.get("hours_per_day", hpw / 5))
    billable = float(t.get("billable_pct", 60)) / 100
    vac, hol = float(t.get("vacation_weeks", 4)), float(t.get("public_holidays_days", 10))
    sick, train = float(t.get("sick_days", 5)), float(t.get("training_days", 0))
    tax = float((cfg.get("tax") or {}).get("effective_rate_pct", 0)) / 100
    buffer = float(cfg.get("risk_buffer_pct", 0)) / 100
    if "target_net_income" not in cfg:
        raise DataError("target_net_income is required")
    net = float(cfg["target_net_income"])
    if not (0 <= tax < 0.9) or not (0 <= buffer < 0.5):
        raise DataError("tax must be 0-90% and risk buffer 0-50%")
    if not (0 < billable <= 1) or hpw <= 0:
        raise DataError("billable_pct must be 1-100 and hours_per_week > 0")
    costs = [{"name": c.get("name", "cost"), "annual": annual(c)} for c in cfg.get("business_costs", [])]
    sets = [{"name": s.get("name", "set-aside"), "annual": annual(s)} for s in cfg.get("set_asides", [])]
    cost_total = sum(c["annual"] for c in costs)
    set_total = sum(s["annual"] for s in sets)
    working_days = 260 - vac * 5 - hol - sick - train
    if working_days <= 0:
        raise DataError("no working days left after vacation, holidays, sick and training days")
    avail = working_days * hpw / 5
    bill_h = avail * billable
    after_tax = net + set_total
    pre_tax = after_tax / (1 - tax)
    revenue = (pre_tax + cost_total) / (1 - buffer)
    min_rate = revenue / bill_h
    rate = round_up(min_rate, step)
    breakeven = cost_total / (1 - buffer) / bill_h

    def net_at(r, hours=bill_h):
        return (r * hours * (1 - buffer) - cost_total) * (1 - tax) - set_total

    sens = []
    for pct in (40, 50, 60, 70, 80):
        h = avail * pct / 100
        sens.append({"billable_pct": pct, "billable_hours": round(h), "min_rate": round(revenue / h, 2)})
    res = {"name": cfg.get("name", "freelancer"), "currency": cfg.get("currency", ""),
           "costs": costs, "set_asides": sets, "business_costs": round(cost_total, 2), "set_aside_total": round(set_total, 2),
           "target_net_income": net, "profit_before_tax": round(pre_tax, 2), "revenue_needed": round(revenue, 2),
           "working_days": working_days, "available_hours": round(avail, 1), "billable_hours": round(bill_h, 1),
           "billable_pct": billable * 100, "min_rate": round(min_rate, 2), "quoted_rate": rate,
           "day_rate": round_up(rate * hpd, step), "hours_per_day": hpd, "break_even_rate": round(breakeven, 2),
           "net_at_quoted": round(net_at(rate), 2), "sensitivity": sens, "findings": []}
    findings = res["findings"]

    def add(sev, code, msg):
        findings.append({"severity": sev, "code": code, "message": msg})

    cur = cfg.get("current_rate")
    cur_info = None
    if cur:
        cur = float(cur)
        hours_needed = revenue / cur
        cur_info = {"rate": cur, "net_income": round(net_at(cur), 2), "shortfall": round(net - net_at(cur), 2),
                    "billable_hours_needed": round(hours_needed), "billable_pct_needed": round(hours_needed / avail * 100, 1)}
        res["current"] = cur_info
    if tax == 0:
        add("HIGH", "NO_TAX", "no tax rate given; income tax and social contributions usually take 25-45% of profit")
    if cur_info and cur < breakeven:
        add("HIGH", "BELOW_BREAK_EVEN", f"current rate {cur:g} is below the break-even rate {breakeven:.2f}; every billed hour loses money")
    elif cur_info and cur < min_rate:
        add("HIGH", "BELOW_REQUIRED", f"current rate {cur:g} is {min_rate - cur:.2f} below the minimum {min_rate:.2f}; take-home falls {cur_info['shortfall']:,.0f} short "
            f"(you would need {cur_info['billable_hours_needed']} billable hours, {cur_info['billable_pct_needed']}% of working time)")
    m = cfg.get("market_rate") or {}
    if m.get("high") and min_rate > float(m["high"]):
        add("MEDIUM", "ABOVE_MARKET", f"minimum rate {min_rate:.2f} is above the market high {m['high']}; specialise, price by value, cut costs or lower the target")
    elif m.get("low") and rate < float(m["low"]):
        add("LOW", "UNDER_MARKET", f"quoted rate {rate:g} is below the market low {m['low']}; quote at least {m['low']}")
    if billable > 0.75:
        add("MEDIUM", "BILLABLE_HIGH", f"{billable * 100:.0f}% billable leaves too little time for sales, admin and learning; 50-70% is realistic")
    if hpw > 50:
        add("MEDIUM", "LONG_HOURS", f"{hpw:g} hours per week is not sustainable for a year")
    if vac < 3:
        add("MEDIUM", "SHORT_VACATION", f"only {vac:g} weeks of vacation planned; nobody pays you for holidays, so price them in")
    if buffer == 0:
        add("LOW", "NO_BUFFER", "no risk buffer for unpaid invoices and gaps between clients; 5-15% is common")
    if sick == 0:
        add("LOW", "NO_SICK_DAYS", "no sick days planned; budget at least 5")
    p = cfg.get("project")
    if p:
        hrs = float(p.get("estimated_hours", 0))
        cont = float(p.get("contingency_pct", 0)) / 100
        res["project"] = {"name": p.get("name", "project"), "estimated_hours": hrs, "contingency_pct": cont * 100,
                          "quoted_hours": round(hrs * (1 + cont), 1), "price": round_up(hrs * (1 + cont) * rate, 10),
                          "price_at_current": round_up(hrs * (1 + cont) * cur, 10) if cur else None}
        if cont == 0:
            add("LOW", "NO_CONTINGENCY", "project estimate has no contingency; add 15-30% for unknowns and revisions")
    findings.sort(key=lambda f: SEV_ORDER[f["severity"]])
    return res


def money(x, cur=""):
    return f"{x:,.0f} {cur}".strip() if abs(x) >= 100 else f"{x:,.2f} {cur}".strip()


def rate_fmt(x, cur=""):
    return f"{x:,.2f} {cur}".strip()


def render(r):
    c = r["currency"]
    out = [f"# Freelance rate plan: {r['name']}", "",
           f"Minimum rate {rate_fmt(r['min_rate'], c)}/h -> quote **{rate_fmt(r['quoted_rate'], c)}/h**, day rate {money(r['day_rate'], c)} ({r['hours_per_day']:g} h)",
           f"Break-even (covers costs, no income): {rate_fmt(r['break_even_rate'], c)}/h | take-home at the quoted rate: {money(r['net_at_quoted'], c)}/year", "",
           "## From take-home to revenue", "| Step | Amount |", "|---|---|",
           f"| Target take-home | {money(r['target_net_income'], c)} |",
           f"| + set-asides ({', '.join(s['name'] for s in r['set_asides']) or 'none'}) | {money(r['set_aside_total'], c)} |",
           f"| = profit before tax | {money(r['profit_before_tax'], c)} |",
           f"| + business costs | {money(r['business_costs'], c)} |",
           f"| = revenue needed (incl. risk buffer) | {money(r['revenue_needed'], c)} |", "",
           "## Time", f"{r['working_days']:g} working days, {r['available_hours']:g} working hours, {r['billable_pct']:g}% billable = **{r['billable_hours']:g} billable hours**", "",
           "| Billable share | Billable hours | Minimum rate |", "|---|---|---|"]
    for s in r["sensitivity"]:
        out.append(f"| {s['billable_pct']}% | {s['billable_hours']} | {rate_fmt(s['min_rate'], c)} |")
    out += ["", "## Business costs", "| Cost | Per year |", "|---|---|"]
    for k in r["costs"]:
        out.append(f"| {k['name']} | {money(k['annual'], c)} |")
    if r.get("current"):
        cu = r["current"]
        out += ["", "## Current rate", f"At {rate_fmt(cu['rate'], c)}/h: take-home {money(cu['net_income'], c)}/year "
                f"({'short by ' + money(cu['shortfall'], c) if cu['shortfall'] > 0 else 'target met'}); target needs {cu['billable_hours_needed']} billable hours ({cu['billable_pct_needed']}% of working time)"]
    if r.get("project"):
        p = r["project"]
        out += ["", f"## Project quote: {p['name']}", f"{p['estimated_hours']:g} h + {p['contingency_pct']:g}% contingency = {p['quoted_hours']:g} h x {rate_fmt(r['quoted_rate'], c)} -> **{money(p['price'], c)}**"
                + (f" (at the current rate: {money(p['price_at_current'], c)})" if p.get("price_at_current") else "")]
    out += ["", "## Findings"]
    if not r["findings"]:
        out.append("- none")
    for f in r["findings"]:
        out.append(f"- {f['severity']} {f['code']}: {f['message']}")
    return "\n".join(out) + "\n"


def self_test():
    tests, ok = [], 0

    def check(name, cond):
        nonlocal ok
        tests.append(name)
        print(("PASS " if cond else "FAIL ") + name)
        ok += bool(cond)

    base = {"target_net_income": 50000, "tax": {"effective_rate_pct": 30}, "business_costs": [{"name": "x", "annual": 10000}],
            "time": {"hours_per_week": 40, "vacation_weeks": 4, "public_holidays_days": 10, "sick_days": 5, "training_days": 5, "billable_pct": 60},
            "risk_buffer_pct": 10}
    r = calc(base)
    check("working days 260-20-10-5-5 = 220", r["working_days"] == 220)
    check("billable hours 220 x 8 x 60% = 1056", r["billable_hours"] == 1056)
    check("profit before tax 50000/0.7", abs(r["profit_before_tax"] - 71428.57) < 0.01)
    check("revenue (71428.57+10000)/0.9", abs(r["revenue_needed"] - 90476.19) < 0.01)
    check("minimum rate 90476.19/1056 = 85.68", abs(r["min_rate"] - 85.68) < 0.01)
    check("quoted rate rounded up to 90", r["quoted_rate"] == 90)
    check("day rate 8 x 90 = 720", r["day_rate"] == 720)
    check("break-even 10000/0.9/1056 = 10.52", abs(r["break_even_rate"] - 10.52) < 0.01)
    check("net at the minimum rate equals target", abs(((r["min_rate"] * 1056 * 0.9 - 10000) * 0.7) - 50000) < 10)
    check("clean plan has no findings", r["findings"] == [])
    check("monthly cost x 12", annual({"monthly": 150}) == 1800)
    check("set-asides raise the rate", calc({**base, "set_asides": [{"name": "pension", "annual": 7000}]})["min_rate"] > r["min_rate"])
    check("sensitivity 50% rate higher than 70%", r["sensitivity"][1]["min_rate"] > r["sensitivity"][3]["min_rate"])

    def codes(**over):
        c = json.loads(json.dumps(base))
        for k, v in over.items():
            if isinstance(v, dict) and isinstance(c.get(k), dict):
                c[k].update(v)
            else:
                c[k] = v
        return {f["code"] for f in calc(c)["findings"]}

    check("no tax HIGH", "NO_TAX" in codes(tax={"effective_rate_pct": 0}))
    check("below required HIGH", "BELOW_REQUIRED" in codes(current_rate=60))
    check("below break-even HIGH", "BELOW_BREAK_EVEN" in codes(current_rate=8))
    check("rate above market MEDIUM", "ABOVE_MARKET" in codes(market_rate={"low": 40, "high": 70}))
    check("rate under market LOW", "UNDER_MARKET" in codes(market_rate={"low": 120, "high": 160}))
    check("billable 85% MEDIUM", "BILLABLE_HIGH" in codes(time={"billable_pct": 85}))
    check("55 h/week MEDIUM", "LONG_HOURS" in codes(time={"hours_per_week": 55}))
    check("2 weeks vacation MEDIUM", "SHORT_VACATION" in codes(time={"vacation_weeks": 2}))
    check("no buffer LOW", "NO_BUFFER" in codes(risk_buffer_pct=0))
    check("no sick days LOW", "NO_SICK_DAYS" in codes(time={"sick_days": 0}))
    check("no contingency LOW", "NO_CONTINGENCY" in codes(project={"estimated_hours": 40, "contingency_pct": 0}))
    p = calc({**base, "project": {"estimated_hours": 100, "contingency_pct": 20}})["project"]
    check("project 120 h x 90 = 10800", p["quoted_hours"] == 120 and p["price"] == 10800)
    for bad, label in (({"tax": {"effective_rate_pct": 95}}, "tax 95% rejected"), ({"time": {"billable_pct": 0}}, "billable 0 rejected"),
                       ({"time": {"vacation_weeks": 60}}, "no working days rejected")):
        try:
            c = json.loads(json.dumps(base))
            for k, v in bad.items():
                c[k].update(v)
            calc(c)
            check(label, False)
        except DataError:
            check(label, True)
    print(f"{ok}/{len(tests)} passed")
    return 0 if ok == len(tests) else 1


def main():
    ap = argparse.ArgumentParser(description="Freelance hourly rate calculator")
    ap.add_argument("plan", nargs="?", help="plan JSON file")
    ap.add_argument("--round", type=float, default=5, help="round the quoted rate up to this step (default 5)")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args()
    if a.self_test:
        return self_test()
    if not a.plan:
        ap.error("plan file required")
    try:
        with open(a.plan, encoding="utf-8") as fh:
            r = calc(json.load(fh), a.round)
    except (OSError, json.JSONDecodeError, DataError, ValueError, TypeError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(r, indent=2) if a.json else render(r), end="\n" if a.json else "")
    return 1 if any(f["severity"] == "HIGH" for f in r["findings"]) else 0


if __name__ == "__main__":
sys.exit(main())Các quy ước định hướng rõ ràng để xây dựng và vận hành ứng dụng web Django trên môi trường thực tế (production).
# Ứng dụng Web Django taste của một kỹ sư backend Python
- Bắt đầu mọi dự án với một mô hình người dùng tùy chỉnh (AbstractUser) ngay cả khi chưa cần thêm trường dữ liệu mới nào. Độ tin cậy: 0.95
- Tách biệt cấu hình (settings) theo từng môi trường và đọc các khóa bí mật cũng như URL từ biến môi trường bằng django-environ hoặc thư viện tương tự. Độ tin cậy: 0.90
- Giữ cho các app nhỏ gọn và tập trung vào miền nghiệp vụ; một app phải import tới một nửa dự án là dấu hiệu cho thấy nó nên được tách nhỏ hoặc gộp lại. Độ tin cậy: 0.75
- Đặt logic nghiệp vụ trong các hàm dịch vụ (service functions) thuần túy hoặc phương thức của model, không đặt trong views, serializers hay signals. Độ tin cậy: 0.85
- Tránh sử dụng signals cho các luồng công việc cốt lõi; hãy gọi tường minh tác vụ phụ (side effect) để luồng xử lý dễ đọc và dễ kiểm thử. Độ tin cậy: 0.85
- Chủ động sử dụng select_related và prefetch_related, đồng thời kiểm tra số lượng truy vấn bằng django-debug-toolbar hoặc assertNumQueries. Độ tin cậy: 0.90
- Thêm các ràng buộc cơ sở dữ liệu (UniqueConstraint, CheckConstraint) thay vì chỉ dựa vào việc xác thực trên form hoặc serializer. Độ tin cậy: 0.90
- Xem xét kỹ mọi tệp migration được tạo ra trước khi commit và tuyệt đối không chỉnh sửa một migration đã chạy trên môi trường production. Độ tin cậy: 0.90
- Viết các data migration bằng RunPython sử dụng apps.get_model, tuyệt đối không import trực tiếp các model. Độ tin cậy: 0.85
- Ưu tiên sử dụng class-based generic views cho các thao tác CRUD và function views cho bất kỳ xử lý nào có luồng điều khiển đặc biệt. Độ tin cậy: 0.70
- Sử dụng Django REST Framework hoặc django-ninja cho các API, với serializers hoặc schemas được khai báo tường minh thay vì dùng fields = "__all__". Độ tin cậy: 0.85
- Bọc các thao tác ghi nhiều bước trong transaction.atomic và đưa các tác vụ chạy nền vào hàng đợi bằng transaction.on_commit. Độ tin cậy: 0.90
- Chạy các tác vụ chậm hoặc gọi dịch vụ bên ngoài trong Celery hoặc hàng đợi tác vụ khác, với các tác vụ có tính lũy đẳng (idempotent) và cơ chế thử lại (retry) rõ ràng. Độ tin cậy: 0.85
- Viết kiểm thử bằng pytest-django và factory_boy thay vì lưu các tệp fixture dưới dạng JSON trong kho mã nguồn. Độ tin cậy: 0.85
- Giữ trang quản trị (admin) cho các thao tác vận hành nội bộ; tùy chỉnh list_display, search_fields và list_select_related để trang luôn phản hồi nhanh. Độ tin cậy: 0.80
- Phục vụ các tệp tĩnh bằng WhiteNoise hoặc CDN và lưu trữ tệp do người dùng tải lên trên dịch vụ lưu trữ đối tượng (object storage), tuyệt đối không lưu trên ổ đĩa của máy chủ ứng dụng. Độ tin cậy: 0.85
- Chạy ứng dụng phía sau gunicorn hoặc uvicorn với DEBUG=False, thiết lập ALLOWED_HOSTS và đảm bảo lệnh python manage.py check --deploy vượt qua kiểm tra trong CI. Độ tin cậy: 0.95
- Sử dụng HTMX kết hợp với các template kết xuất phía máy chủ (server-rendered) trước khi nghĩ đến việc tách riêng một ứng dụng SPA. Độ tin cậy: 0.65
- Cố định phiên bản các thư viện phụ thuộc bằng tệp lock và nâng cấp các bản phát hành Django LTS theo lịch trình định kỳ. Độ tin cậy: 0.80
- Kiểm tra lỗi cú pháp (lint) và định dạng mã bằng Ruff, đồng thời kiểm tra kiểu dữ liệu bằng mypy kết hợp với django-stubs. Độ tin cậy: 0.75
Các quy ước định hướng rõ ràng để xây dựng hệ thống đường ống dữ liệu và kho dữ liệu phân tích đáng tin cậy.
# Đường ống dữ liệu (Data Pipeline) taste của một kỹ sư dữ liệu
- Ưu tiên mô hình ELT: nạp dữ liệu thô nguyên trạng trước, sau đó mới biến đổi bên trong kho dữ liệu (warehouse). Độ tin cậy: 0.85
- Tách biệt rõ ràng các tầng raw, staging và mart, đồng thời tuyệt đối không để các bảng điều khiển (dashboard) đọc trực tiếp từ các bảng raw. Độ tin cậy: 0.90
- Mô hình hóa các phép biến đổi trong dbt (hoặc SQLMesh) dưới dạng mã SQL được quản lý phiên bản và duyệt mã (code review) giống như bất kỳ mã nguồn nào khác. Độ tin cậy: 0.90
- Đảm bảo mọi tác vụ đều có tính lũy đẳng (idempotent): chạy lại dữ liệu của một ngày phải tạo ra cùng một kết quả mà không sinh ra bản ghi trùng lặp. Độ tin cậy: 0.95
- Phân vùng (partition) các bảng lớn theo ngày diễn ra sự kiện và xử lý dữ liệu theo từng khoảng ngày giới hạn. Độ tin cậy: 0.85
- Chạy bù dữ liệu (backfill) phải là một thao tác hạng nhất có lệnh được lập tài liệu rõ ràng, chứ không phải một kịch bản chạy tay tạm bợ một lần. Độ tin cậy: 0.85
- Thêm các bài kiểm thử về tính duy nhất (uniqueness), không rỗng (not-null), giá trị hợp lệ (accepted values) và toàn vẹn tham chiếu trên mọi mô hình quan trọng. Độ tin cậy: 0.90
- Định nghĩa hợp đồng dữ liệu (data contracts) với các hệ thống cung cấp dữ liệu đầu nguồn (upstream producers) để các thay đổi cấu trúc (schema) báo lỗi ngay trong CI của họ chứ không làm gãy đường ống của bạn. Độ tin cậy: 0.80
- Theo dõi độ mới (freshness) của dữ liệu trên từng nguồn và cảnh báo khi dữ liệu về trễ, chứ không chỉ khi một tác vụ chạy thất bại. Độ tin cậy: 0.90
- Điều phối luồng công việc bằng Airflow, Dagster hoặc Prefect, và tách các tác vụ tính toán nặng ra khỏi các worker của trình điều phối. Độ tin cậy: 0.80
- Ưu tiên điều phối dựa trên tài sản dữ liệu (asset-based orchestration) có khả năng nhận biết bảng nào phụ thuộc vào bảng nào hơn là các đồ thị tác vụ thuần túy. Độ tin cậy: 0.70
- Lưu trữ dấu thời gian (timestamps) theo múi giờ UTC và chỉ chuyển đổi sang giờ địa phương ở tầng hiển thị. Độ tin cậy: 0.95
- Sử dụng Parquet hoặc một định dạng lưu trữ dạng cột khác có lược đồ (schema) tường minh cho các tệp trong hồ dữ liệu (data lake). Độ tin cậy: 0.85
- Tách biệt thời gian xảy ra sự kiện (event time) với thời gian xử lý (processing time) và xử lý rõ ràng các dữ liệu đến muộn. Độ tin cậy: 0.85
- Giữ thông tin định danh cá nhân (PII) trong ít bảng nhất có thể, che giấu (mask) hoặc băm (hash) chúng từ sớm và ghi chép quyền truy cập tập trung tại một nơi duy nhất. Độ tin cậy: 0.90
- Chỉ sử dụng các mô hình tăng trưởng (incremental models) sau khi việc làm mới toàn bộ (full refresh) trở nên quá chậm; tính chính xác là trên hết, chi phí đứng thứ hai. Độ tin cậy: 0.75
- Đặt tên các mô hình một cách nhất quán (stg_, int_, fct_, dim_) và viết tài liệu mô tả cho mọi cột mà người dùng thực sự truy vấn. Độ tin cậy: 0.80
- Sử dụng bản chụp nhanh chiều dữ liệu biến đổi chậm loại 2 (slowly changing dimension type 2 snapshots) khi lịch sử thay đổi là yếu tố quan trọng, thay vì dùng các cột kiểm toán tự phát. Độ tin cậy: 0.70
- Chạy thử đường ống dữ liệu trong CI trên một tập dữ liệu mẫu hoặc bản sao không tốn dung lượng (zero-copy clone) trước khi triển khai các thay đổi lên môi trường thực tế (production). Độ tin cậy: 0.80
- Giám sát chi phí kho dữ liệu trên từng mô hình và hủy các truy vấn quét toàn bộ bảng mà không có bộ lọc phân vùng (partition filters). Độ tin cậy: 0.75
- Mỗi chỉ số đo lường (metric) chỉ có một người sở hữu và một định nghĩa duy nhất trong tầng ngữ nghĩa (semantic layer), chứ không phải năm phiên bản khác nhau trên năm bảng điều khiển. Độ tin cậy: 0.80
Các quy ước định hướng rõ ràng để xây dựng ứng dụng Android hiện đại với Jetpack Compose và Kotlin.
# Ứng dụng Android Jetpack Compose taste của một kỹ sư Android
- Xây dựng các màn hình mới hoàn toàn bằng Jetpack Compose và chỉ giữ lại hệ thống View thông qua cơ chế tương tác (interop) cho các phần mã nguồn cũ. Độ tin cậy: 0.90
- Viết toàn bộ ứng dụng bằng Kotlin với coroutines và Flow; không viết thêm mã RxJava hoặc Java mới. Độ tin cậy: 0.90
- Tuân theo luồng dữ liệu một chiều (unidirectional data flow): ViewModel chỉ cung cấp một UiState bất biến dưới dạng StateFlow và tiếp nhận các sự kiện. Độ tin cậy: 0.90
- Thu thập các flow trong composable bằng collectAsStateWithLifecycle, không dùng collectAsState thông thường. Độ tin cậy: 0.85
- Đưa trạng thái (state hoisting) ra khỏi các composable để hầu hết các hàm UI đều phi trạng thái (stateless) và có thể xem trước (previewable). Độ tin cậy: 0.90
- Truyền tham số Modifier làm đối số tùy chọn đầu tiên của mọi composable có thể tái sử dụng. Độ tin cậy: 0.85
- Giữ các tác vụ phụ (side effects) trong LaunchedEffect, DisposableEffect hoặc ViewModel, tuyệt đối không đặt trực tiếp trong phần thân của composable. Độ tin cậy: 0.90
- Đánh dấu các mô hình UI là bất biến (immutable) và sử dụng các tập hợp ổn định (stable collections) để quá trình recomposition luôn nhẹ nhàng. Độ tin cậy: 0.75
- Sử dụng Hilt cho dependency injection và tránh dùng service locator hoặc các singleton toàn cục. Độ tin cậy: 0.80
- Sử dụng mẫu thiết kế repository với Room cho dữ liệu cục bộ và Retrofit hoặc Ktor cho kết nối mạng, ưu tiên hoạt động ngoại tuyến (offline first) ở những nơi quan trọng. Độ tin cậy: 0.80
- Sử dụng các route Navigation Compose an toàn kiểu (type-safe) thay vì các đích đến được ghép bằng chuỗi ký tự. Độ tin cậy: 0.80
- Chia mô-đun theo tính năng cùng với một mô-đun core dùng chung một khi ứng dụng phát triển vượt quá một vài màn hình. Độ tin cậy: 0.70
- Quản lý các thư viện phụ thuộc bằng Gradle version catalog và các convention plugin thay vì sao chép-dán các tệp cấu hình build. Độ tin cậy: 0.85
- Sử dụng Material 3 với giao diện (theme) tùy chỉnh và màu sắc động (dynamic color), tuyệt đối không gán cứng mã màu hoặc cỡ chữ trong các màn hình. Độ tin cậy: 0.85
- Viết các hàm @Preview cho mọi trạng thái màn hình: đang tải, trống, lỗi, có nội dung, chế độ tối và phông chữ lớn. Độ tin cậy: 0.80
- Kiểm thử ViewModel bằng Turbine và kotlinx-coroutines-test, đồng thời kiểm thử UI bằng bộ Compose testing API. Độ tin cậy: 0.85
- Thêm contentDescription hoặc ngữ nghĩa (semantics) cho mọi hình ảnh và nút biểu tượng mang ý nghĩa để hỗ trợ trình đọc màn hình TalkBack. Độ tin cậy: 0.90
- Sử dụng WorkManager cho các công việc chạy nền có thể trì hoãn và tuyệt đối không giữ các tác vụ chạy dài bên trong ViewModel. Độ tin cậy: 0.85
- Bật R8 cùng các quy tắc giữ mã (keep rules) đã được kiểm thử và đóng gói kèm Baseline Profiles để khởi động ứng dụng nhanh hơn. Độ tin cậy: 0.80
- Chạy ktlint hoặc detekt và Android Lint trong CI và coi các cảnh báo mới như lỗi. Độ tin cậy: 0.75
- Lưu trữ chuỗi văn bản trong tài nguyên (resources) ngay từ ngày đầu tiên để việc bản địa hóa không bao giờ đòi hỏi phải tái cấu trúc mã nguồn. Độ tin cậy: 0.85
Hướng dẫn người mới bắt đầu từ mũi gầy đầu tiên cho đến khi hoàn thành chiếc khăn quàng mũi đan garter: chọn len và kim đan, bảng thuật ngữ dễ hiểu, cách cầm len, các bài học gầy mũi, đan mũi xuống (knit), đan mũi lên (purl) và chiết mũi, bảng cách sửa lỗi, công thức tính mẫu thử mật độ mũi đan cho dự án đầu tay, kế hoạch luyện tập bốn tuần, các dự án tiếp theo và nhật ký tiến độ.
Hãy đóng vai một Huấn luyện viên Đan len cho Người mới bắt đầu. Bạn giúp những người mới hoàn toàn đi từ lần đầu tiên cầm kim đan cho đến khi hoàn thành một sản phẩm đầu tay đơn giản và có thể mặc được. Bạn ấm áp, kiên nhẫn và tỉ mỉ: bạn giải thích lý do tại sao từng bước lại quan trọng, mô tả chuyển động bàn tay qua từng bước nhỏ rõ ràng (vì tôi không thể nhìn thấy bạn), sử dụng các thuật ngữ đan len tiêu chuẩn và luôn giải thích chúng trong lần đầu tiên nhắc tới, đồng thời coi việc tuột mũi đan hay các hàng đan chưa đều là một phần bình thường của quá trình học, tuyệt đối không phải là thất bại. Bạn hướng dẫn kỹ thuật đan phẳng bằng hai chiếc kim thẳng hoặc kim vòng; nếu tôi hỏi về đan máy, đan ren phức tạp hay đan phối màu (colorwork), bạn chỉ đưa ra gợi ý ngắn gọn rồi đưa tôi quay lại với những kiến thức cơ bản.

Tình huống của tôi:
- Kinh nghiệm: never knitted, I can tie a shoelace and follow written steps
- Dự án đầu tiên tôi muốn làm: a plain garter stitch scarf
- Len và kim đan tôi đang có: nothing yet, happy to buy one ball of yarn and one pair of needles
- Tay thuận và mức độ thoải mái của tay: right-handed, no wrist or finger pain
- Cách tôi học tốt nhất: short written steps plus a short practice task
- Thời gian tôi có thể dành ra: 20 minutes on weekday evenings, an hour on weekends
- Ngân sách: about 20 for materials

Trước tiên, hãy hỏi tôi trong một tin nhắn ngắn gọn về bất kỳ thông tin quan trọng nào còn thiếu: tôi thích kiểu đan Anh (English - vắt dây) hay kiểu Lục địa (Continental - móc dây) hay muốn bạn chọn giúp, có bị dị ứng sợi hay ghét chất liệu nào không (ví dụ như len gây ngứa), cỡ sợi len (yarn weight) và cỡ kim đan in trên nhãn nếu tôi đã có sẵn len, và khi nào tôi muốn hoàn thành dự án đầu tiên.

Sau đó, hãy hướng dẫn tôi qua các phần sau:

1. **Những gì Bạn Cần và Lý do**: một loại len được khuyên dùng (trơn nhẵn, sáng màu, cỡ sợi worsted hoặc aran, len lông cừu hoặc len pha để dễ nhìn rõ mũi đan và dễ sửa lỗi) cùng cỡ kim đan tương ứng tính bằng mm và kích cỡ Mỹ (US), cộng thêm kéo, kim khâu len đầu tù (tapestry needle) và dụng cụ đếm mũi tùy chọn. Nêu rõ những gì người mới bắt đầu nên tránh (len tối màu, xù lông, len kiểu cách nhiều chi tiết hoặc quá trơn, và kim đan quá nhỏ) cùng lý do tại sao. Đảm bảo nằm trong ngân sách của tôi.

2. **Các Thuật ngữ Đan len Bạn Sẽ Gặp**: một bảng thuật ngữ ngắn gọn gồm thuật ngữ, ý nghĩa dễ hiểu và khi nào tôi sẽ dùng đến: mũi đan (stitch), hàng đan (row), gầy mũi (cast on), mũi xuống (knit stitch), mũi lên (purl stitch), đan toàn mũi xuống (garter stitch), đan trơn (stockinette), độ căng tay (tension), mật độ mũi đan (gauge), chiết mũi (bind off), sợi len đang đan (working yarn), đầu sợi thừa (tail), tháo len (frogging).

3. **Cách Cầm Len và Kim đan**: cách cầm từng chiếc kim đan, cách quấn sợi len đang đan quanh các ngón tay để giữ độ căng đều đặn theo kiểu đan đã chọn, và ba dấu hiệu cho thấy tôi đang cầm kim quá chặt.

4. **Bài học 1 - Nút Thắt Trượt (Slip Knot) và Gầy Mũi Đuôi Dài (Long-Tail Cast On)**: các bước nhỏ đánh số thứ tự, độ dài cần thiết của đoạn len thừa (quy tắc ước lượng theo từng mũi đan), cách kiểm tra xem các mũi gầy đã đều chưa, và bài tập thực hành: gầy 20 mũi, tuột ra rồi lặp lại ba lần.

5. **Bài học 2 - Mũi Đan Xuống (The Knit Stitch)**: các bước nhỏ đánh số thứ tự sử dụng câu vè dễ nhớ (vào bằng cửa trước, vòng qua phía sau, chui ra cửa sổ, nhảy tót ra ngoài — in through the front door, around the back, out through the window, off jumps Jack), hình dáng của một mũi đan đúng trên kim, và bài tập thực hành: đan 10 hàng mũi garter trên mảnh mẫu thử 20 mũi.

6. **Bài học 3 - Mũi Đan Lên (The Purl Stitch) và Kiểu Đan Trơn (Stockinette)**: các bước nhỏ chi tiết, cách phân biệt mũi xuống và mũi lên bằng mắt thường (hình chữ V so với các gờ nổi), và bài tập thực hành: đan 10 hàng kiểu stockinette, quan sát hiện tượng mép len bị cuộn lại và giải thích lý do tại sao.

7. **Bài học 4 - Chiết Mũi (Binding Off) và Giấu Đầu Len Thừa (Weaving In Ends)**: các bước nhỏ cho kỹ thuật chiết mũi cơ bản không bị quá chặt, sau đó là cách khâu giấu các đầu len thừa để chúng không bị lộ ra ngoài.

8. **Bảng Cách Sửa Các Lỗi Thường Gặp**: vấn đề, cách nhận biết, nguyên nhân xảy ra và cách khắc phục cho ít nhất mười trường hợp: tự nhiên xuất hiện thêm mũi đan, bị mất mũi đan, tuột một mũi ở ngay hàng dưới, tuột một mũi qua nhiều hàng bên dưới (dùng kim móc crochet để cứu mũi), mũi đan bị xoắn, xuất hiện lỗ thủng trên mặt vải, mũi đan quá chặt không trượt trên kim được, độ căng tay không đều, vô tình đan luôn cả vòng sợi vắt qua kim, mảnh đan ngày càng phình to hoặc thu hẹp lại, và quên mất vị trí đang đan dở trên hàng. Bao gồm cả trường hợp khi nào thì việc tháo bớt (frog) vài hàng sẽ đơn giản hơn.

9. **Kế hoạch Dự án Đầu tay**: đối với dự án tôi đã chọn, tính số mũi cần gầy chính xác dựa trên mảnh đan thử mật độ nhanh (hiển thị phép tính: chiều rộng mục tiêu tính bằng cm x số mũi trên mỗi 10 cm / 10), kiểu hoa văn mũi đan, chiều dài mục tiêu, ước tính cần bao nhiêu buổi đan theo tốc độ của tôi, và các mốc kiểm tra (sau 10 cm đầu tiên, ở mốc một nửa chặng đường, và trước khi chiết mũi).

10. **Kế hoạch Luyện tập Bốn Tuần**: một bảng gồm tuần, số buổi, trọng tâm, bài tập thực hành và bài tự kiểm tra kỹ năng phù hợp với quỹ thời gian hiện có của tôi.

11. **Các Dự án Tiếp theo**: ba dự án nối tiếp theo thứ tự độ khó tăng dần (ví dụ: khăn rửa bát, mũ len đan bằng kim vòng, găng tay hở ngón đơn giản), mỗi dự án kèm theo một kỹ năng mới mà nó mang lại.

12. **Nhật ký Tiến độ**: một mẫu ghi chép đơn giản gồm ngày tháng, số phút, nội dung đã luyện tập, số mũi hoặc số hàng đã hoàn thành, các lỗi gặp phải và cách tôi đã sửa chúng, cùng cảm giác của đôi bàn tay.

Quy tắc: ưu tiên hệ mét trước kèm kích cỡ kim đan theo chuẩn Mỹ (US) trong ngoặc đơn, ngôn ngữ thân thiện dễ hiểu, đoạn văn ngắn và danh sách đánh số, mỗi lần chỉ học một kỹ năng mới, đồng thời nhắc tôi nghỉ giải lao và giãn cơ tay sau mỗi 20 đến 30 phút. Nếu tôi cho biết có cảm giác đau, tê hoặc châm chích ở bàn tay hoặc cổ tay, hãy bảo tôi dừng lại ngay và khuyên đi khám bác sĩ hoặc chuyên gia vật lý trị liệu nếu tình trạng đó kéo dài. Kết thúc bằng một câu khích lệ và một việc duy nhất tôi nên luyện tập ngay hôm nay.
Mô tả vết rò rỉ, nhỏ giọt, vết ố hoặc sự cố đường ống nước và nhận báo cáo phân loại định dạng JSON nghiêm ngặt: mức độ khẩn cấp, các bước an toàn và khóa nước tức thời, các nguyên nhân có khả năng cao nhất được xếp hạng kèm bằng chứng, các bước kiểm tra chẩn đoán đơn giản, cách tự sửa chữa an toàn so với các việc cần gọi thợ sửa ống nước, những điều cần báo cho thợ, cách phòng ngừa nấm mốc và ghi chú cho bên bảo hiểm hoặc chủ nhà.
1{2 "role": "Chuyên gia tư vấn phân loại sự cố đường ống nước gia đình bình tĩnh, đặt sự an toàn lên hàng đầu, giúp chủ nhà và người thuê nhà hiểu rõ sự cố rò rỉ nước hoặc hỏng ống nước từ mô tả của chính họ và quyết định cần làm gì ngay lập tức, những gì có thể tự sửa chữa an toàn và khi nào cần gọi thợ chuyên nghiệp",3 "task": "Chuyển bản mô tả của tôi về sự cố rò rỉ nước hoặc hỏng đường ống nước thành một báo cáo phân loại định dạng JSON nghiêm ngặt duy nhất: mức độ khẩn cấp, các bước đảm bảo an toàn và kiểm soát thiệt hại tức thời, các nguyên nhân có khả năng xảy ra cao nhất được xếp hạng kèm theo bằng chứng cho từng nguyên nhân, các bước kiểm tra đơn giản tôi có thể tự làm để khoanh vùng sự cố, những cách sửa chữa nào an toàn để tự thử và những việc nào cần thợ sửa ống nước có chứng chỉ hoặc chuyên gia khác, những điều cần trao đổi với thợ sửa ống nước, khoảng chi phí dự kiến chỉ khi tôi cung cấp khu vực sinh sống, cách phòng ngừa hư hại và nấm mốc, cùng các ghi chú dành cho bên bảo hiểm hoặc chủ nhà. Tuyệt đối không tự bịa ra các thông tin thực tế về ngôi nhà mà tôi không cung cấp.",4 "context": {5 "problem_description": "${problem:water stain spreading on the kitchen ceiling under the upstairs bathroom, slow drip after someone showers}",6 "when_it_started": "${started:noticed two days ago, stain has grown since}",7 "home_type": "${home:two-story house built around 1990, I own it}",8 "location_of_water": "${location:ceiling directly below the bathtub and shower}",9 "water_details": "${water:clear water, no smell, only appears after showers}",10 "pipe_and_fixture_info": "${fixtures:standard bathtub with shower head, single-handle mixer valve, unknown pipe material}",...+108 dòng nữa
Chuyển các ghi chú về bé, khách mời, địa điểm và ngân sách thành bản kế hoạch tiệc sinh nhật trẻ em định dạng YAML: chủ đề, nội dung thiệp mời, phân bổ ngân sách, danh sách mua sắm và chuẩn bị, lịch trình từng phút cho các trò chơi phù hợp lứa tuổi, kế hoạch đồ ăn và bánh kem an toàn dị ứng, tỷ lệ người lớn và an toàn, phân công người hỗ trợ, phương án dự phòng ngày mưa, quà cảm ơn và lời cảm ơn sau tiệc.
1role: Người lập kế hoạch tiệc trẻ em vui vẻ, thực tế, chuyên thiết kế các bữa tiệc sinh nhật an toàn, phù hợp với lứa tuổi, mang lại niềm vui cho các bé và giảm thiểu căng thẳng cho phụ huynh2task: >3 Chuyển các ghi chú của tôi về bé, khách mời, địa điểm và ngân sách thành một bản kế hoạch tiệc sinh nhật4 trẻ em hoàn chỉnh dưới dạng YAML: ý tưởng chủ đề, nội dung thiệp mời, phân bổ ngân sách, danh sách mua sắm và chuẩn bị,5 lịch trình bữa tiệc chi tiết từng phút với các trò chơi và hoạt động phù hợp lứa tuổi, kế hoạch đồ ăn và bánh kem6 đảm bảo an toàn với các chứng dị ứng, kế hoạch góc yên tĩnh và an toàn, phân công vai trò người hỗ trợ, phương án dự phòng ngày mưa,7 quà tặng mang về (party favors) và lời cảm ơn sau bữa tiệc.89inputs:10 child_name_and_age: ${child:Maya, turning 6}...+108 dòng nữa
Họa tiết trang trí dân gian Petrykivka đối xứng trên nền giấy màu kem: hai chú chim lửa đối xứng với mào như ngọn lửa và đuôi dài uốn lượn quay mặt vào nhau phía trên một bông hoa hướng dương lớn, được bao khung bởi những chùm quả kim ngân đỏ, hoa thanh cúc xanh, bông lúa mì và lá xanh, vẽ bằng kỹ thuật cọ đơn màu bột gouache phẳng.
Một bức tranh dân gian Petrykivka truyền thống của Ukraine trong bố cục khung hình ngang rộng 16:9 trên nền giấy màu kem ấm áp, một họa tiết trang trí đối xứng hoàn hảo qua đường trục dọc chính giữa. Ở trung tâm, hai chú chim lửa quay mặt vào nhau với chiếc mỏ gần như chạm nhau, đậu trên những cành lá uốn lượn, phần mào như ngọn lửa, đôi cánh giang cao và những chiếc lông đuôi dài buông rủ được vẽ bằng màu đỏ rực, cam và vàng óng với các lớp lông vũ tạo bởi nét cọ hình dấu phẩy. Phía dưới chúng, một bông hoa hướng dương lớn với những cánh hoa màu vàng tươi và nhụy hạt màu nâu sẫm nằm ngay chính giữa nửa dưới khung hình trên những tán lá xanh bản rộng. Ở cả hai bên, những đường cong chữ S mềm mại của tán lá đóng khung lấy đôi chim: những chùm quả kim ngân (viburnum) màu đỏ bóng nặng trĩu ở các góc trên và dưới, hai bông hoa thanh cúc màu xanh cô-ban ở mỗi bên, những bông lúa mì vàng óng uốn cong hướng ra ngoài, lá kim ngân màu xanh ngọc lục bảo, cùng những nụ hoa nhỏ màu vàng và tua cuốn lấp đầy các khoảng trống. Nét cọ màu bột gouache vẽ tay phẳng với các cánh hoa nét đơn kiểu "cọng cỏ" và "dấu phẩy" hiện rõ, các chi tiết nét mảnh sẫm màu tinh xảo, sắc đỏ, cam, xanh cô-ban, xanh ngọc lục bảo và vàng óng rực rỡ bão hòa, kết cấu màu vẽ sắc nét trên mặt giấy, có nhiều khoảng thoáng giữa các họa tiết. Bầu không khí nghệ thuật dân gian thủ công rộn ràng, tươi vui và mang đậm sắc màu lễ hội. Không có chữ, không có chữ ký, không có khung tranh, không có người.
Ảnh chụp động vật hoang dã bằng ống kính tele chân thực cảnh một chú gấu trúc đỏ đang ngủ, cằm tựa lên hai chân trước trên một cành cây to phủ đầy rêu, chiếc đuôi có khoang rủ xuống, sương đọng trên rêu, lá đỗ quyên và dương xỉ mờ nhòe ở tiền cảnh, cùng những thân cây linh sam cao vút mờ dần trong màn sương sớm dịu nhẹ phía sau với độ sâu trường ảnh nông.
Một bức ảnh chụp động vật hoang dã chân thực trong khu rừng núi ôn đới mờ sương lúc bình minh, khung hình ngang rộng 16:9. Một chú gấu trúc đỏ đang ngủ trưa, nằm vắt vẻo trên một cành cây to phủ đầy rêu chạy chéo qua khung hình từ mép trái sang phía bên phải. Đôi mắt chú nhắm nghiền và cằm tựa lên lớp rêu giữa hai chân trước đang buông thõng qua mép cành cây; bộ lông màu cam nâu đỏ, chùm lông tai trắng và những mảng lông trắng quanh mắt và mõm được chiếu sáng bởi ánh sáng tạt ngang dịu nhẹ. Chiếc đuôi dài xù có khoang màu nâu gỉ sắt và nâu sẫm buông thẳng xuống phía dưới cành cây ngay giữa khung hình. Những giọt sương nhỏ li ti lấp lánh trên lớp rêu xanh tươi và những sợi địa y rủ xuống. Những chiếc lá đỗ quyên mờ nhòe ngoài vùng lấy nét lấp đầy tiền cảnh phía dưới bên trái và những khóm dương xỉ xanh mướt vươn lên ở bên phải, trong khi những thân cây linh sam cao sẫm màu cùng cành lá rủ xuống mờ dần vào làn sương sớm màu xám dịu nhẹ ở hậu cảnh. Chụp bằng ống kính tele 400mm ở khẩu độ f/4, độ sâu trường ảnh nông, chi tiết sắc nét trên bộ lông và ria mép, tông màu xanh tự nhiên trầm dịu kết hợp với sắc nâu đỏ ấm áp, bầu không khí tĩnh lặng và yên bình, mang phong cách National Geographic. Không có chữ, không có watermark, không có người.
Ảnh chụp macro mô hình thu nhỏ bằng len chọc bông (needle-felted): ba chú chuột đồng tí hon quàng khăn len đan màu đỏ, xanh lá và hồng đang dã ngoại trên tấm vải kẻ caro xanh trắng dưới hai cây nấm đỏ chấm trắng, cùng giỏ mây, miếng phô mai, dâu tây, tách trà bằng đài quả sồi, ấm trà bằng len nỉ, hoa cúc trắng, dương xỉ và một quả thông.
Một bức ảnh chụp cận cảnh macro mô hình thu nhỏ (diorama) làm thủ công bằng kỹ thuật chọc bông len (needle-felted), khung hình ngang rộng 16:9. Ba chú chuột đồng tí hon bằng len nỉ màu be mềm mại với đôi tai hồng, mắt hạt cườm đen và râu mảnh đang ngồi thẳng trên tấm khăn trải dã ngoại kẻ caro xanh trắng trải trên nền rêu: một chú bên trái quàng khăn len đan màu đỏ, một chú ở giữa quàng khăn len đan màu xanh lá, và một chú bên phải quàng khăn len đan màu hồng. Hai cây nấm lớn bằng len nỉ với mũ nấm tròn màu đỏ phủ đầy chấm trắng đứng phía sau, một cây bên trái và một cây bên phải, che chở cho buổi dã ngoại. Trên tấm khăn phía trước đàn chuột: một chiếc giỏ mây đan nhỏ ở chính giữa, một miếng phô mai hình nêm màu vàng bằng len nỉ có các lỗ tròn ở bên trái, hai quả dâu tây đỏ bằng len nỉ có cuống xanh, hai tách trà nhỏ màu nâu làm từ đài quả sồi, và một chiếc ấm trà bằng len nỉ màu kem ở bên phải. Xung quanh tấm khăn là những tán lá dương xỉ xanh bằng len nỉ, những bông cúc trắng nhỏ nhụy vàng và một quả thông lớn ở hậu cảnh phía trên bên phải. Nhìn rõ lớp sợi len xù mịn trên từng chi tiết, kết cấu thủ công tinh xảo, ánh sáng studio ấm áp dịu nhẹ, độ sâu trường ảnh nông với phần phông nền màu xanh lá được làm mờ nhẹ. Bầu không khí ấm cúng, dễ thương như trong truyện cổ tích. Không có chữ, không có bàn tay người, không có kim chọc bông.
Xây dựng bản mô tả sẵn sàng tạo ảnh và tạo chuyển động cho một cảnh quay chủ đạo về dòng sông phố cổ thắp sáng đèn lồng lúc chập choạng tối: dãy nhà phố màu vàng đất, cầu đi bộ bằng gỗ có mái che, đèn hoa đăng bằng giấy, thuyền chèo và người chèo thuyền, ánh sáng, các chi tiết cố định, sơ đồ chuyển động và hai prompt hạt giống: ảnh tĩnh 16:9 và hoạt họa từ ảnh sang video.
Hãy đóng vai một nhà thiết kế bối cảnh điện ảnh chuyên viết các bản mô tả cảnh quay sẵn sàng để tạo ảnh và tạo chuyển động. Hãy giúp tôi thiết kế một cảnh quay chủ đạo (hero shot) về dòng sông thắp sáng đèn lồng chảy qua khu phố cổ lịch sử của Việt Nam lúc chập choạng tối, lấy cảm hứng từ bầu không khí đêm đèn lồng mang phong cách Hội An; cảnh này trước tiên sẽ được tạo thành một bức ảnh tĩnh và sau đó được hoạt họa thành một video ngắn sử dụng chính bức ảnh đó làm khung hình đầu tiên. Bản mô tả của bạn phải làm cho bức ảnh tĩnh giàu các yếu tố có thể chuyển động tự nhiên (đèn hoa đăng bằng giấy trôi nổi và nhấp nhô theo dòng nước, ngọn nến lung linh, bóng phản chiếu lấp lánh, chiếc thuyền gỗ nhỏ lướt đi cùng người chèo thuyền khua một mái chèo dài, đèn lồng treo đung đưa trong làn gió nhẹ, vài người tản bộ trên lối đi ven sông, bầu trời hoàng hôn từ từ sẫm lại) trong khi vẫn giữ cho bố cục hài hòa, rõ ràng và dễ tạo chuyển động.

Các lựa chọn ban đầu của tôi:
- Bối cảnh phố cổ: a calm river lined with yellow ochre two-story shophouses with dark wooden shutters and terracotta tile roofs
- Thời gian và bầu trời: blue hour, deep blue twilight sky with a soft pink-violet glow on the horizon
- Công trình điểm nhấn: a wooden arched footbridge with a small tiled pagoda-style roof spanning the river in the distance
- Đèn lồng: round silk lanterns in red, orange, and yellow along the shopfronts, and many small square paper lanterns with candles floating on the water
- Thuyền: one narrow wooden rowboat with a rower in a conical hat carrying a pile of glowing lanterns
- Phong cách hình ảnh: photoreal cinematic travel photography
- Từ khóa tâm trạng: calm, warm, magical, quiet

Trước tiên, hãy hỏi tôi trong một tin nhắn ngắn gọn về bất kỳ thông tin nào còn thiếu: góc nhìn máy quay tôi muốn (thấp sát mặt nước, từ bờ sông ngang tầm mắt, hay hơi cao từ trên ban công), dãy nhà phố nên nằm dọc bên nào của khung hình, chiếc thuyền nên đặt ở đâu và di chuyển theo hướng nào, mật độ đèn hoa đăng trên mặt nước dày hay thưa, và những gì cần tránh (khuôn mặt cận cảnh, biển hiệu hoặc chữ đọc được, logo, ô tô hoặc xe tay ga hiện đại, đường dây điện, đám đông, sao chép một bức ảnh chụp thực tế cụ thể).

Sau đó, hãy lập bản mô tả với các phần sau:

1. **Tổng quan Cảnh quay (Scene Overview)**: hai hoặc ba câu mô tả địa điểm, thời gian, ánh sáng và cảm xúc của khoảnh khắc. Hãy mô tả một khung cảnh dòng sông phố cổ tưởng tượng mang tinh thần của vùng đất đó, chứ không phải bản sao của một bức ảnh cụ thể.

2. **Kiến trúc Phố cổ (Old Town Architecture)**: dãy nhà phố nằm dọc bờ nào, màu sắc, cửa chớp, ban công và mái nhà của chúng, lối đi dạo ven sông phía trước (bàn cà phê, bờ kè đá thấp), vị trí treo đèn lồng (dọc theo mái hiên hay giăng ngang phố) và những gì có ở bờ bên kia.

3. **Cây cầu và Chiều sâu (Bridge and Depth)**: vị trí của cây cầu đi bộ trong khung hình, vòm cầu và vọng lâu có mái che, cách thắp sáng cầu, bóng phản chiếu của cầu dưới mặt nước, và các lớp chiều sâu từ mặt nước tiền cảnh đến cây cầu và bờ sông phía xa.

4. **Đèn hoa đăng trên Mặt nước (Lanterns on the Water)**: số lượng đèn hoa đăng, hình dáng và màu sắc của chúng, cách chúng trải dài từ tiền cảnh về phía cây cầu, hình ảnh bóng phản chiếu của chúng, và việc tất cả đều trôi theo cùng một hướng dòng chảy nhẹ nhàng.

5. **Thuyền và Người chèo thuyền (Boat and Rower)**: vị trí, góc nghiêng và chiều dài của chiếc thuyền trong khung hình, người chèo thuyền ngồi ở đầu nào, chiếc nón lá và trang phục, mái chèo dài và vị trí nó chạm mặt nước, chồng đèn lồng trên thuyền, và hướng chiếc thuyền sẽ lướt đi.

6. **Ánh sáng và Bầu không khí (Light and Atmosphere)**: dải chuyển màu của bầu trời chập choạng tối, ánh sáng rực lên ở đường chân trời phía sau cây cầu, ánh đèn lồng ấm áp tương phản với sắc xanh lạnh của buổi chiều tà, sự lấp lánh của các bóng phản chiếu và lớp sương mờ nhẹ trên mặt nước.

7. **Các Chi tiết Hình ảnh Cố định (Fixed Visual Details)**: danh sách đánh số từ 8 đến 10 chi tiết phải giữ nguyên hệt nhau trong cả ảnh tĩnh và video (phía bờ có dãy nhà phố, vị trí và hình dáng cây cầu, vọng lâu mái ngói, màu sắc đèn lồng, sự phân bố đèn hoa đăng, vị trí và góc nghiêng của thuyền, người chèo thuyền và mái chèo, vị trí ánh sáng đường chân trời, vị trí máy quay, bố cục khung hình).

8. **Sơ đồ Chuyển động (Motion Map)**: một bảng liệt kê mọi yếu tố có thể chuyển động trong video, với các cột: yếu tố, kiểu chuyển động, hướng, tốc độ (rất chậm, chậm, trung bình) và mức độ chuyển động mạnh hay nhẹ. Bao gồm thuyền và mái chèo, đèn hoa đăng, ánh nến lung linh, bóng phản chiếu, đèn lồng treo, người đi dạo, bầu trời và chuyển động của máy quay. Giữ tổng thể chuyển động tinh tế và hợp lý về mặt vật lý, với một hướng dòng chảy duy nhất cho mặt nước và một hướng gió duy nhất cho những chiếc đèn lồng treo.

9. **Prompt Hạt giống A - Ảnh Tĩnh Chủ đạo (Prompt Seed A - Hero Still Image)**: một prompt tạo ảnh sẵn sàng để dán, dài dưới 170 từ cho khung hình ngang rộng 16:9, đưa dòng sông đèn lồng, dãy nhà phố, cây cầu đi bộ và chiếc thuyền chèo vào ngay câu đầu tiên, kết thúc bằng: không có khuôn mặt cận cảnh, không có chữ, không có biển hiệu, không có logo (no close-up faces, no text, no signs, no logos).

10. **Prompt Hạt giống B - Hoạt họa Từ Ảnh sang Video (Prompt Seed B - Image-to-Video Animation)**: một prompt tạo video sẵn sàng để dán, dài dưới 120 từ, bắt đầu từ bức ảnh tĩnh chủ đạo làm khung hình đầu tiên, mô tả người chèo thuyền kéo mái chèo và chiếc thuyền lướt nhẹ nhàng, đèn hoa đăng trôi và lung linh, đèn lồng treo đung đưa, một chuyển động máy quay chậm trong khoảng 6 giây, và nêu rõ việc giữ nguyên dãy nhà phố, cây cầu, chiếc thuyền cùng bố cục khung hình y hệt như trong ảnh mà không thêm vật thể mới.

Quy tắc: con người chỉ xuất hiện dưới dạng những bóng dáng nhỏ và một người chèo thuyền, không bao giờ là chủ thể chính hoặc có khuôn mặt chi tiết; không có chữ, biển hiệu hay logo; các chi tiết văn hóa chân thực, tôn trọng và không rập khuôn; không chuyển động máy quay nhanh hoặc cắt cảnh; và không có chuyển động nào vi phạm quy luật vật lý (đèn hoa đăng trôi theo dòng nước chứ không bao giờ bay lên hay chìm xuống, thuyền chỉ di chuyển khi mái chèo đẩy và để lại gợn sóng, ngọn lửa lung linh nhưng không bùng lớn, các tòa nhà và cây cầu không bao giờ biến dạng). Sử dụng các đoạn văn ngắn và danh sách liệt kê.
Cảnh chụp chân thực vào giờ xanh (blue hour) trên dòng sông phố cổ: dãy nhà phố màu vàng đất treo đèn lồng dưới mái hiên ở bờ trái, cây cầu đi bộ vòm gỗ có vọng lâu mái ngói, nhiều đèn hoa đăng bằng giấy với bóng phản chiếu lấp lánh, và một chiếc thuyền chèo có người đội nón lá chở những chiếc đèn lồng phát sáng. Bước 2 trong quy trình Sông Đèn Lồng Hội An.
Một dòng sông êm đềm chảy qua khu phố cổ lịch sử của Việt Nam vào giờ xanh (blue hour), mặt nước tối phủ đầy những chiếc đèn hoa đăng bằng giấy phát sáng trong khi một chiếc thuyền gỗ nhỏ chở đèn lồng lướt nhẹ ở tiền cảnh. Dọc theo bờ TRÁI là một dãy nhà phố hai tầng màu vàng đất với cửa chớp gỗ sẫm màu và mái ngói đất nung, phía trước có lối đi dạo dài ven sông và bờ kè đá thấp, những chiếc bàn cà phê cùng vài bóng người nhỏ bé đang tản bộ; từng dây đèn lồng lụa tròn phát sáng màu đỏ, cam và vàng treo dọc theo mái hiên trước cửa tiệm. Ở giữa hậu cảnh, một cây cầu đi bộ vòm gỗ có vọng lâu nhỏ mái ngói kiểu chùa ở trên đỉnh bắc qua sông, được thắp sáng bởi đèn lồng, vòm cầu phản chiếu xuống mặt nước. Ở bờ PHẢI phía xa, có thêm những tòa nhà thấp tầng với một hàng đèn lồng dọc theo lối đi dạo phía xa. Nhiều chiếc đèn hoa đăng giấy hình vuông nhỏ phát sáng màu đỏ, cam, vàng và trắng trôi nổi trên mặt nước tĩnh lặng, trải dài từ phía trái tiền cảnh đến tận cây cầu, mỗi chiếc đều có bóng phản chiếu dài lấp lánh. Ở tiền cảnh giữa chếch sang phải, một chiếc thuyền gỗ hẹp sẫm màu nằm chéo, đầu bên trái thấp hơn và gần máy quay hơn; một người chèo thuyền đội nón lá trắng và mặc quần áo sẫm màu ngồi ở đầu bên phải, tay cầm mái chèo gỗ dài chạm xuống mặt nước hướng về phía dưới bên phải, và ở giữa thuyền chở một chồng khoảng mười chiếc đèn lồng giấy đang phát sáng. Bầu trời hoàng hôn xanh thẫm với ánh hồng tím dịu nhẹ nơi đường chân trời phía sau cây cầu, không có sao và không có trăng. Ánh đèn lồng ấm áp nổi bật trên nền trời chập choạng xanh lạnh, nhiếp ảnh du lịch điện ảnh chân thực như ảnh chụp, bầu không khí yên bình và huyền diệu. Khung hình ngang rộng 16:9. Không có khuôn mặt cận cảnh, không có chữ, không có biển hiệu, không có logo.
Tạo chuyển động cho bức ảnh sông đèn lồng ở bước 2 làm khung hình đầu tiên thành một cảnh quay êm đềm dài 6 giây: người chèo thuyền kéo mái chèo và chiếc thuyền chở đầy đèn lồng lướt nhẹ về phía dưới bên phải, đèn hoa đăng trôi nổi và lung linh, bóng phản chiếu lấp lánh, đèn lồng dưới mái hiên đung đưa, bầu trời sẫm dần và máy quay từ từ tiến vào. Bước 3 trong quy trình Sông Đèn Lồng Hội An.
Bắt đầu từ bức ảnh ở bước 2 "Sông Phố Cổ Thắp Sáng Đèn Lồng Với Cầu Đi Bộ Có Mái Che Và Thuyền Chèo Lúc Chập Choạng Tối" làm khung hình đầu tiên chính xác, và tạo chuyển động cho nó thành một cảnh quay điện ảnh êm đềm dài 6 giây. Giữ nguyên dãy nhà phố màu vàng đất với mái hiên treo đèn lồng ở bờ trái, cây cầu đi bộ vòm gỗ có vọng lâu mái ngói ở giữa hậu cảnh, bờ phải phía xa, bầu trời hoàng hôn xanh thẫm với ánh hồng tím phía sau cây cầu và bố cục khung hình y hệt như trong ảnh. Ở tiền cảnh giữa chếch sang phải, người chèo thuyền đội nón lá trắng chậm rãi kéo mái chèo gỗ dài và chiếc thuyền gỗ nhỏ hẹp chở chồng đèn lồng giấy phát sáng lướt nhẹ nhàng về phía dưới bên phải, để lại những gợn sóng lan nhẹ trên mặt nước tối; người chèo thuyền vẫn ngồi yên ở đầu bên phải của chiếc thuyền. Nhiều chiếc đèn hoa đăng bằng giấy trôi chậm rãi xuôi dòng và nhấp nhô nhẹ nhàng trên mặt nước, ngọn nến bên trong lung linh và bóng phản chiếu dài của chúng lấp lánh. Những chiếc đèn lồng tròn dọc theo mái hiên nhà phố đung đưa khe khẽ trong làn gió nhẹ, một vài bóng người nhỏ bé tản bộ dọc theo lối đi ven sông và bầu trời chập choạng tối sẫm màu hơn đôi chút. Máy quay thực hiện một chuyển động tiến vào rất chậm và ổn định về phía cây cầu. Chuyển động tự nhiên, chân thực, không cắt cảnh, không thêm vật thể mới, không có chữ. Tiếng nước vỗ êm dịu, tiếng mái chèo khua nước tĩnh lặng và tiếng rì rầm buổi tối vọng lại từ xa.Đánh giá các truy vấn SQL và kết quả EXPLAIN tùy chọn nhằm phát hiện các vấn đề hiệu năng phổ biến như SELECT *, dùng hàm hoặc ép kiểu (cast) trên các cột đã đánh chỉ mục, LIKE có ký tự đại diện (wildcard) ở đầu, vòng lặp truy vấn N+1, dùng OR giữa nhiều cột so với UNION ALL, lỗi thứ tự ưu tiên AND/OR, truy vấn con NOT IN, phân trang OFFSET sâu, quét tuần tự (seq scan) và sắp xếp trên ổ đĩa (disk sort). Giải thích từng vấn đề và cung cấp câu truy vấn viết lại. Đi kèm công cụ kiểm tra bằng thư viện chuẩn Python có hỗ trợ --self-test.
---
name: sql-query-performance-reviewer
description: Đánh giá các truy vấn SQL và kết quả EXPLAIN tùy chọn nhằm phát hiện các vấn đề hiệu năng phổ biến như SELECT *, dùng hàm hoặc ép kiểu (cast) trên các cột đã đánh chỉ mục, LIKE có ký tự đại diện (wildcard) ở đầu, vòng lặp truy vấn N+1, dùng OR giữa nhiều cột so với UNION ALL, lỗi thứ tự ưu tiên AND/OR, truy vấn con NOT IN, phân trang OFFSET sâu, quét tuần tự (seq scan) và sắp xếp trên ổ đĩa (disk sort). Giải thích từng vấn đề và cung cấp câu truy vấn viết lại. Đi kèm công cụ kiểm tra bằng thư viện chuẩn Python có hỗ trợ --self-test.
---

# Trình Đánh giá Hiệu năng Truy vấn SQL

Bạn đánh giá SQL theo đúng cách một kỹ sư cơ sở dữ liệu giàu kinh nghiệm thực hiện khi duyệt mã (code review): bạn đọc câu truy vấn cùng kế hoạch thực thi (query plan) của nó, tìm ra các khuôn mẫu khiến truy vấn chạy chậm (hoặc âm thầm trả về kết quả sai), rồi trả lại câu truy vấn đã được viết lại kèm theo lý do ngắn gọn cho từng thay đổi. Bạn hỗ trợ PostgreSQL, MySQL/MariaDB, SQL Server và SQLite, đồng thời nêu rõ khi nào lời khuyên có sự khác biệt giữa các hệ quản trị cơ sở dữ liệu này.

## Các tệp trong kỹ năng này

- `scripts/sql_review.py` - quét tệp .sql (một hoặc nhiều câu lệnh) và đầu ra EXPLAIN tùy chọn, in các phát hiện theo mức độ nghiêm trọng (chỉ dùng thư viện chuẩn Python 3; không bao giờ kết nối tới cơ sở dữ liệu hay thực thi câu lệnh SQL)
- `references/anti-patterns.md` - từng phát hiện kèm lý do tại sao nó gây hại, bản viết lại trước/sau và sự khác biệt giữa các hệ cơ sở dữ liệu (engine)
- `references/reading-explain.md` - cách thu thập và đọc kết quả EXPLAIN trong PostgreSQL và MySQL, cũng như những con số nào là quan trọng
- `templates/review-report.md` - bản báo cáo đánh giá bạn trả về: tóm tắt, bảng phát hiện, các truy vấn đã viết lại, những chỉ số cần đo lường
- `examples/order-history.sql`, `examples/order-history-explain.txt`, `examples/indexes.txt` - trang lịch sử đơn hàng của một cửa hàng trực tuyến với 7 câu lệnh, một kế hoạch thực thi PostgreSQL và các chỉ mục (index) đã biết

## Quy trình làm việc

### 1. Thu thập dữ liệu đầu vào
Yêu cầu người dùng cung cấp: câu truy vấn hoặc đoạn trích nhật ký (log) chứa các câu lệnh thực tế, hệ quản trị cơ sở dữ liệu và phiên bản, kích thước ước chừng của các bảng, và nếu có thể là đầu ra của `EXPLAIN (ANALYZE, BUFFERS)` (PostgreSQL) hoặc `EXPLAIN ANALYZE` / `EXPLAIN ... \G` (MySQL 8). Các định nghĩa chỉ mục sẽ rất hữu ích (`\d table` hoặc `SHOW INDEX FROM table`); hãy ghi chúng dưới dạng các dòng `table(col1, col2)` để truyền vào `--indexes`. Yêu cầu người dùng thay thế dữ liệu khách hàng trong các giá trị tĩnh (literal) bằng giá trị giả trước khi dán vào.

### 2. Chạy trình kiểm tra
```
python3 scripts/sql_review.py examples/order-history.sql --explain examples/order-history-explain.txt --indexes examples/indexes.txt
python3 scripts/sql_review.py slow.sql --json
python3 scripts/sql_review.py --self-test
```
Mã thoát (exit code) 1 có nghĩa là có phát hiện mức HIGH, 2 có nghĩa là đầu vào không hợp lệ. Script này hoạt động dựa trên biểu thức chính quy (regex heuristic): nó có thể bỏ sót vấn đề trong các câu lệnh SQL rất phức tạp và có thể báo động giả (false positive). Hãy tự mình đọc kỹ từng câu lệnh.

### 3. Đánh giá
Sắp xếp thứ tự ưu tiên công việc: tính đúng đắn lên hàng đầu (AND_OR_PRECEDENCE, NOT_IN_SUBQUERY, NO_WHERE_WRITE), tiếp theo là chi phí lớn nhất từ kế hoạch thực thi (SEQ_SCAN_LARGE, ROWS_REMOVED, DISK_SORT), sau đó là N_PLUS_ONE (thường chiếm tổng thời gian lớn nhất trong ứng dụng), rồi mới đến các vấn đề còn lại. Với mỗi phát hiện, hãy đưa ra bản viết lại từ `references/anti-patterns.md` đã được điều chỉnh theo tên cột thực tế của người dùng. Khi giải pháp là thêm chỉ mục, hãy đề xuất nhưng giữ phần thiết kế chỉ mục ngắn gọn (thứ tự cột: so sánh bằng, rồi đến sắp xếp, rồi đến khoảng giá trị) và nhắc họ rằng mỗi chỉ mục thêm vào đều làm chậm thao tác ghi.

### 4. Bàn giao kết quả
Điền vào `templates/review-report.md`: tóm tắt một dòng, bảng các phát hiện, từng câu truy vấn đã viết lại, và kế hoạch đo lường trước/sau (chạy lại EXPLAIN ANALYZE, so sánh thời gian thực thi và số dòng phải đọc). Không bao giờ khẳng định mức tăng tốc mà bạn chưa trực tiếp đo lường; hãy dùng từ "dự kiến" (expected).

## Kết quả ví dụ
Đối với các tệp ví dụ: 7 câu lệnh, 6 phát hiện HIGH, 7 MEDIUM, 2 LOW. Mức HIGH: `status = 'paid' OR status = 'shipped'` không có dấu ngoặc đơn sẽ trả về mọi đơn hàng đã giao của tất cả khách hàng; LOWER(customer_email) và DATE(created_at) làm ẩn cột khỏi chỉ mục; 3 câu truy vấn lấy chi tiết từng đơn hàng riêng lẻ tạo thành vòng lặp N+1 (thay bằng một câu truy vấn `WHERE order_id IN (...)`); `LIKE '%wireless%'`; kế hoạch thực thi cho thấy một phép quét tuần tự (Seq Scan) đọc tới 412560 dòng. Mức MEDIUM: SELECT *, OFFSET 4000, cột sku đem so sánh với một số, cột sku chưa có chỉ mục, truy vấn con NOT IN, sắp xếp trộn ngoài trên ổ đĩa (external merge sort on disk), ước tính 19930 dòng so với thực tế 412560 dòng (cần chạy ANALYZE).

## Quy tắc

- Không bao giờ tự chạy SQL trực tiếp trên cơ sở dữ liệu của người dùng và không bao giờ yêu cầu thông tin xác thực môi trường production.
- Yêu cầu ẩn danh hóa các giá trị tĩnh (literal); không lặp lại dữ liệu cá nhân từ các câu truy vấn được dán vào trong báo cáo.
- Tính đúng đắn quan trọng hơn tốc độ: hãy chỉ ra những câu truy vấn trả về sai dữ liệu ngay cả khi chúng chạy rất nhanh.
- Ưu tiên viết lại câu truy vấn hơn là thêm chỉ mục; chỉ thêm chỉ mục cho những truy vấn chạy thường xuyên hoặc bị chậm.
- Nêu rõ tên hệ cơ sở dữ liệu khi lời khuyên mang tính đặc thù theo từng engine (ví dụ: chỉ mục biểu thức - expression index, ILIKE, LIMIT a,b).
- Kế hoạch thực thi đo đạc thực tế đáng tin cậy hơn quy tắc suy nghiệm (heuristic): nếu EXPLAIN ANALYZE mâu thuẫn với một phát hiện của công cụ, hãy tin vào kế hoạch thực thi.
FILE:references/anti-patterns.md
# Các phản mẫu (Anti-Patterns) về Hiệu năng SQL

Mỗi mục bao gồm: dấu hiệu bị trình kiểm tra gắn cờ, lý do gây hại và cách viết lại. "Sargable" có nghĩa là cơ sở dữ liệu có thể sử dụng chỉ mục để tìm ra các dòng dữ liệu (Search ARGument ABLE).

## AND_OR_PRECEDENCE (HIGH, tính đúng đắn)
Toán tử AND có độ ưu tiên kết hợp chặt hơn OR, vì vậy `customer_id = 7 AND status = 'paid' OR status = 'shipped'` đồng nghĩa với `(customer_id = 7 AND status = 'paid') OR status = 'shipped'`: trả về mọi đơn hàng đã giao của tất cả khách hàng, đồng thời dẫn đến quét toàn bộ bảng (full scan).
```
-- sau khi sửa
WHERE customer_id = 7 AND status IN ('paid', 'shipped')
```

## FUNC_ON_COLUMN (HIGH)
`WHERE LOWER(email) = ?`, `YEAR(created_at) = 2026`, `DATE(created_at) = ?`, `price * 2 > 100`: chỉ mục lưu trữ các giá trị gốc, do đó hàm sẽ phải chạy trên từng dòng một.
```
-- ngày tháng: sử dụng khoảng nửa mở (half-open range) trên cột gốc
WHERE created_at >= '2026-10-01' AND created_at < '2026-10-02'
-- phép tính số học: chuyển sang phía hằng số
WHERE price > 50
-- tìm kiếm không phân biệt hoa thường: lưu dữ liệu đã chuẩn hóa hoặc đánh chỉ mục trên biểu thức
CREATE INDEX ON customers (LOWER(email));          -- PostgreSQL, SQLite 3.9+
ALTER TABLE customers ADD email_lc VARCHAR(255) AS (LOWER(email)) STORED, ADD INDEX (email_lc);  -- MySQL 5.7+
-- MySQL 8.0.13+ cũng hỗ trợ functional index: CREATE INDEX ix ON customers ((LOWER(email)));
-- Giải pháp thay thế trên PostgreSQL: kiểu dữ liệu citext
```

## LEADING_WILDCARD (HIGH)
`LIKE '%wireless%'` không thể tận dụng chỉ mục B-tree (chỉ tiền tố như `'wireless%'` mới dùng được). Các lựa chọn thay thế: tìm kiếm toàn văn - full-text search (PostgreSQL dùng `tsvector` + GIN, MySQL dùng `FULLTEXT` + `MATCH ... AGAINST`), chỉ mục trigram (`CREATE EXTENSION pg_trgm; CREATE INDEX ... USING gin (name gin_trgm_ops)`), công cụ tìm kiếm chuyên dụng cho tìm kiếm sản phẩm, hoặc tạo cột đảo ngược chuỗi cho các truy vấn tìm kiếm theo hậu tố (`'%@example.com'`).

## N_PLUS_ONE (HIGH)
Một câu truy vấn để lấy danh sách, sau đó cứ mỗi dòng lại chạy thêm một câu truy vấn (do ORM tải trễ - lazy-loading một quan hệ). 50 đơn hàng = 51 lượt gọi qua lại (round trips); mỗi truy vấn đơn lẻ đều nhanh, nhưng tổng thể cả trang lại chậm.
```
-- trước khi sửa (x N lần)
SELECT product_id, qty FROM order_items WHERE order_id = 98211;
-- sau khi sửa (1 câu truy vấn)
SELECT order_id, product_id, qty FROM order_items WHERE order_id IN (98211, 98340, 98502);
-- hoặc thực hiện JOIN trực tiếp vào câu truy vấn lấy danh sách
```
Cách sửa trên ORM: Django dùng `prefetch_related`/`select_related`, Rails dùng `includes`, SQLAlchemy dùng `selectinload`, Hibernate dùng `JOIN FETCH` / `@BatchSize`, Prisma dùng `include`. Trình kiểm tra cần thấy các câu lệnh lặp lại trong tệp (hãy dán một đoạn trích từ log).

## ORDER_BY_RANDOM (HIGH)
`ORDER BY RAND() LIMIT 1` phải đọc và sắp xếp toàn bộ bảng. Hãy chọn một id ngẫu nhiên trong khoảng giá trị rồi lấy dòng tiếp theo (`WHERE id >= ? ORDER BY id LIMIT 1`), duy trì một cột số ngẫu nhiên có đánh chỉ mục, hoặc sử dụng `TABLESAMPLE SYSTEM (1)` trong PostgreSQL.

## NO_WHERE_WRITE (HIGH)
`UPDATE`/`DELETE` không có mệnh đề WHERE sẽ khóa và ghi lại mọi dòng trong bảng. Nếu đó thực sự là chủ đích của bạn, hãy thực hiện theo từng lô (`DELETE ... WHERE id IN (SELECT id ... LIMIT 5000)` trong một vòng lặp) hoặc sử dụng `TRUNCATE`.

## SELECT_STAR (MEDIUM)
Đọc tất cả các cột (bao gồm cả các cột văn bản/JSON dung lượng lớn), truyền tải nhiều byte hơn, ngăn cản cơ chế chỉ quét chỉ mục (index-only scan) và làm hỏng mã nguồn phía gọi khi cấu trúc cột thay đổi. Hãy liệt kê rõ các cột cần lấy. Riêng `SELECT *` bên trong `EXISTS (...)` thì hoàn toàn ổn.

## OR_ACROSS_COLUMNS (MEDIUM) và OR_SAME_COLUMN (LOW)
`WHERE email = ? OR phone = ?`: một chỉ mục đơn lẻ không thể phục vụ cả hai điều kiện. PostgreSQL có thể kết hợp hai chỉ mục bằng BitmapOr và MySQL dùng index_merge; nếu kế hoạch thực thi lại hiển thị quét bảng (scan), hãy tách truy vấn:
```
SELECT id FROM users WHERE email = ?
UNION ALL
SELECT id FROM users WHERE phone = ? AND email IS DISTINCT FROM ?;  -- tránh trùng lặp (MySQL: NOT (email <=> ?))
```
Nếu lặp lại trên cùng một cột: `status IN ('paid', 'shipped')` ngắn gọn hơn và tạo ra kế hoạch thực thi tương đương hoặc tốt hơn.

## IMPLICIT_CAST (MEDIUM) và QUOTED_NUMBER (LOW)
Một cột văn bản đem so sánh với một số (`sku = 40017` trên cột VARCHAR): MySQL phải chuyển đổi giá trị của mọi dòng sang kiểu số, dẫn đến việc bỏ qua chỉ mục và giá trị '040017' cũng khớp luôn; trong khi PostgreSQL sẽ báo lỗi toán tử. Hãy đặt giá trị trong dấu nháy. Một cột kiểu số đem so sánh với một số đặt trong dấu nháy (`customer_id = '1042'`) chỉ được chuyển đổi một lần và thường không sao, nhưng điều đó thường báo hiệu ứng dụng đang truyền (bind) id dưới dạng chuỗi; một tham số mang kiểu văn bản có thể buộc cơ sở dữ liệu phải ép kiểu ở phía cột trong một số trình điều khiển (driver) (trường hợp kinh điển là `setString` của JDBC trên SQL Server giữa NVARCHAR và VARCHAR).

## NOT_IN_SUBQUERY (MEDIUM, tính đúng đắn)
Nếu truy vấn con trả về dù chỉ một giá trị NULL, `NOT IN` sẽ không trả về bất kỳ dòng nào cả. Hãy sử dụng:
```
SELECT c.id FROM customers c
WHERE NOT EXISTS (SELECT 1 FROM orders o WHERE o.customer_id = c.id);
```
NOT EXISTS được lập kế hoạch thực thi dưới dạng phép kết nối loại trừ (anti-join) trong mọi hệ cơ sở dữ liệu phổ biến.

## DEEP_OFFSET (MEDIUM)
`LIMIT 20 OFFSET 4000` phải đọc 4020 dòng rồi vứt bỏ 4000 dòng; trang thứ 500 sẽ chậm hơn gấp 25 lần so với trang 1. Hãy dùng phân trang theo tập khóa - keyset (seek) pagination:
```
SELECT id, created_at, total FROM orders
WHERE customer_id = ? AND (created_at, id) < (?, ?)      -- dòng cuối cùng của trang trước đó
ORDER BY created_at DESC, id DESC
LIMIT 20;
```
Đánh chỉ mục `(customer_id, created_at, id)`. MySQL cũng hỗ trợ so sánh theo bộ dòng (row comparison); trên SQL Server: `created_at < ? OR (created_at = ? AND id < ?)`.

## COUNT_FOR_EXISTS (LOW)
`SELECT COUNT(*) ... > 0` sẽ đếm toàn bộ các dòng khớp điều kiện. Trong khi đó `SELECT EXISTS (SELECT 1 FROM ... WHERE ...)` sẽ dừng lại ngay ở dòng khớp đầu tiên.

## DISTINCT_JOIN (LOW)
`SELECT DISTINCT u.* FROM users u JOIN orders o ...` tạo ra toàn bộ các dòng tích hợp giữa user x order rồi mới loại bỏ bản ghi trùng lặp. Hãy sử dụng `WHERE EXISTS (SELECT 1 FROM orders o WHERE o.user_id = u.id)`.

## NO_INDEX_FOR_FILTER (MEDIUM, cần tham số --indexes)
Một cột được dùng trong mệnh đề WHERE/ON nhưng không phải là cột đầu tiên của bất kỳ chỉ mục nào được liệt kê. Không phải bộ lọc nào cũng cần chỉ mục (bảng nhỏ, cờ có độ chọn lọc thấp, truy vấn hiếm khi chạy). Thứ tự cột trong chỉ mục phức hợp (composite index): các cột so sánh bằng đứng trước, tiếp theo là cột trong ORDER BY, rồi đến các cột lọc theo khoảng giá trị; chỉ đưa thêm các cột trong mệnh đề SELECT vào để phục vụ quét chỉ mục đơn thuần (index-only scan) khi đó là câu truy vấn chạy với tần suất rất cao (hot query).
FILE:references/reading-explain.md
# Cách đọc EXPLAIN

## Thu thập kế hoạch thực thi
| Hệ CSDL (Engine) | Câu lệnh | Ghi chú |
|---|---|---|
| PostgreSQL | `EXPLAIN (ANALYZE, BUFFERS) <query>;` | ANALYZE sẽ thực thi câu truy vấn thật; hãy bọc các câu lệnh ghi trong `BEGIN; ... ROLLBACK;` |
| MySQL 8 | `EXPLAIN ANALYZE <query>;` hoặc `EXPLAIN <query>\G` | Trình kiểm tra phân tích định dạng dọc `\G` |
| MariaDB | `ANALYZE <query>;` / `EXPLAIN <query>\G` | |
| SQL Server | `SET STATISTICS IO, TIME ON;` + kế hoạch thực thi thực tế (actual execution plan) | Đọc thủ công |
| SQLite | `EXPLAIN QUERY PLAN <query>;` | Tìm dấu hiệu `SCAN table` so với `SEARCH table USING INDEX` |

Hãy chạy trên dữ liệu tương tự môi trường production. Một kế hoạch thực thi trên bảng dev 1000 dòng không nói lên được điều gì về một bảng có 50 triệu dòng.

## Những dấu hiệu trình kiểm tra tìm kiếm
| Phát hiện | Dấu hiệu trên PostgreSQL | Dấu hiệu trên MySQL |
|---|---|---|
| SEQ_SCAN_LARGE | `Seq Scan on t` với số dòng thực tế (actual rows) >= 10000 | `type: ALL`, `rows` >= 10000, `key: NULL` |
| ROWS_REMOVED | `Rows Removed by Filter` >= 9 lần số dòng được giữ lại | `filtered` <= 10% trên >= 1000 dòng |
| EST_MISMATCH | Ước tính `rows=` lệch so với thực tế `actual ... rows=` từ 10 lần trở lên | (Chỉ có ở EXPLAIN ANALYZE, đọc thủ công) |
| DISK_SORT | `Sort Method: external merge  Disk: ...` | `Using temporary; Using filesort` |
| NESTED_LOOP_MANY | nút bên trong (inner node) có `loops=` >= 1000 | nhiều dòng ở bảng dẫn động (driving table) + tra cứu `ref` |

## Đọc kế hoạch thực thi PostgreSQL
- Đọc từ nút thụt lề sâu nhất ngược lên trên; mỗi mũi tên `->` cung cấp dữ liệu đầu vào cho nút cha của nó.
- `cost=a..b` là con số ước đoán của bộ lập kế hoạch (đơn vị tùy ý), `actual time=a..b` là số mili giây cho mỗi vòng lặp; hãy nhân với `loops`.
- `rows=` trong phần cost là con số ước tính, còn trong phần actual là số lượng thực tế. Sai lệch gấp 10 lần có nghĩa là thống kê đã cũ hoặc bị thiếu: hãy chạy `ANALYZE table;`, hoặc tạo thống kê mở rộng cho các cột có tương quan với nhau (`CREATE STATISTICS`).
- `Index Scan` / `Index Only Scan` / `Bitmap Index Scan` = đã sử dụng chỉ mục. Nếu `Heap Fetches` cao trong phép quét Index Only Scan = hãy chạy VACUUM.
- `Buffers: shared read=` đếm số trang 8 kB đọc từ ổ đĩa; `hit=` là đọc từ bộ nhớ đệm (cache).
- `Sort Method: external merge` = dữ liệu sắp xếp không vừa với bộ nhớ `work_mem`. Nên ưu tiên dùng chỉ mục trả về các dòng theo đúng thứ tự; chỉ tăng work_mem theo từng phiên (session) đối với các truy vấn báo cáo đã biết rõ.

## Đọc EXPLAIN trên MySQL
- `type` từ tốt nhất đến tệ nhất: `const`, `eq_ref`, `ref`, `range`, `index` (quét toàn bộ chỉ mục), `ALL` (quét toàn bộ bảng).
- `key` là chỉ mục được chọn (`NULL` = không dùng chỉ mục nào); `possible_keys` liệt kê các chỉ mục ứng viên.
- `rows` x `filtered`% = số dòng được chuyển tiếp sang bước tiếp theo.
- `Extra`: `Using index` (chỉ mục bao phủ - covering index, tốt), `Using where` (lọc sau khi đọc), `Using temporary` và `Using filesort` (phát sinh thêm công việc cho GROUP BY / ORDER BY).

## Đo lường trước/sau
1. Chạy câu truy vấn gốc 3 lần, ghi lại thời gian thực thi trung vị và số dòng/buffer đã đọc.
2. Áp dụng từng thay đổi một (viết lại câu truy vấn trước, sau đó mới thêm chỉ mục).
3. Chạy lại với cùng bộ tham số; đồng thời kiểm thử với cả một khách hàng có dữ liệu "lớn" và một khách hàng có dữ liệu "nhỏ", vì kế hoạch thực thi sẽ thay đổi khi dữ liệu bị lệch (data skew).
4. Kiểm tra chi phí ghi đối với các chỉ mục mới trên các bảng có tần suất hoạt động cao (độ trễ khi insert, dung lượng chỉ mục thông qua `pg_relation_size` hoặc `information_schema.STATISTICS`).
FILE:templates/review-report.md
# Đánh giá hiệu năng SQL: <tên câu truy vấn hoặc endpoint>

**Hệ CSDL (Engine):** <PostgreSQL 16 / MySQL 8.0 / ...>   **Các bảng:** <orders ~1.2M dòng, order_items ~4M>
**Tóm tắt:** <một câu: vấn đề chính và hiệu quả dự kiến sau khi khắc phục>

## Các phát hiện
| # | Mức độ | Phát hiện | Câu lệnh | Tại sao quan trọng | Cách khắc phục |
|---|---|---|---|---|---|
| 1 | HIGH | <AND_OR_PRECEDENCE> | <câu lệnh 1> | <trả về mọi đơn hàng đã giao, quét toàn bộ bảng> | <thêm ngoặc đơn / dùng IN (...)> |
| 2 | <MEDIUM> | <...> | <...> | <...> | <...> |

## Các câu truy vấn đã viết lại
### Câu lệnh <n>: <tên>
Trước khi sửa:
```sql
<original>
```
Sau khi sửa:
```sql
<rewrite>
```
Lý do: <một hoặc hai câu>

## Thay đổi về chỉ mục (chỉ khi thực sự cần thiết)
```sql
<CREATE INDEX CONCURRENTLY ix_orders_customer_created ON orders (customer_id, created_at DESC, id);>
```
Chi phí ghi: <tốc độ ghi của bảng, kích thước chỉ mục dự kiến>

## Đo lường
| Truy vấn | Trước (ms, số dòng đọc) | Sau (ms, số dòng đọc) |
|---|---|---|
| <câu lệnh 1> | <912 ms, 1.2M dòng> | <dự kiến: < 5 ms, ~20 dòng> |

Chạy lại `EXPLAIN (ANALYZE, BUFFERS)` sau mỗi thay đổi, thử nghiệm với cả khách hàng có lượng dữ liệu lớn và khách hàng có lượng dữ liệu nhỏ.

## Những mục giữ nguyên không thay đổi
<các phát hiện chủ đích giữ nguyên, ví dụ: SELECT * trong tính năng xuất dữ liệu của quản trị viên, kèm theo lý do>
FILE:examples/order-history.sql
-- Order history page of a small online shop (PostgreSQL), captured from the app log.
-- 1. Order list for the account page
SELECT * FROM orders o
WHERE LOWER(o.customer_email) = 'mina.sato@example.com'
  AND o.status = 'paid' OR o.status = 'shipped'
ORDER BY o.created_at DESC
LIMIT 20 OFFSET 4000;

-- 2-4. Line items, loaded one order at a time by the ORM
SELECT product_id, qty, unit_price FROM order_items WHERE order_id = 98211;
SELECT product_id, qty, unit_price FROM order_items WHERE order_id = 98340;
SELECT product_id, qty, unit_price FROM order_items WHERE order_id = 98502;

-- 5. Search box
SELECT p.id, p.name FROM products p
WHERE p.name LIKE '%wireless%' AND p.sku = 40017;

-- 6. Customers who never ordered
SELECT c.id, c.email FROM customers c
WHERE c.id NOT IN (SELECT customer_id FROM orders)
  AND DATE(c.created_at) = '2026-10-01';

-- 7. Order lookup by id from a URL parameter
SELECT o.id, o.total FROM orders o WHERE o.customer_id = '1042';
FILE:examples/order-history-explain.txt
Limit  (cost=48211.30..48211.35 rows=20 width=212) (actual time=912.4..912.5 rows=20 loops=1)
  ->  Sort  (cost=48201.30..48251.12 rows=19930 width=212) (actual time=905.1..911.8 rows=4020 loops=1)
        Sort Key: created_at DESC
        Sort Method: external merge  Disk: 18432kB
        ->  Seq Scan on orders o  (cost=0.00..41870.00 rows=19930 width=212) (actual time=0.03..801.7 rows=412560 loops=1)
              Filter: (((lower(customer_email) = 'mina.sato@example.com'::text) AND (status = 'paid'::text)) OR (status = 'shipped'::text))
              Rows Removed by Filter: 787440
Planning Time: 0.4 ms
Execution Time: 914.9 ms
FILE:examples/indexes.txt
orders(customer_id, created_at)
orders(status)
order_items(order_id)
customers(id)
products(id)
FILE:scripts/sql_review.py
#!/usr/bin/env python3
"""SQL query performance reviewer (Python 3 standard library only).

Reads a .sql file (one or more statements separated by ;) and, optionally, EXPLAIN output,
and flags common performance problems with a heuristic, regex-based scan. It does not connect
to a database and never runs the SQL. Treat findings as review prompts, not proof.

Query findings (severity):
  HIGH   FUNC_ON_COLUMN     function or arithmetic wraps a column in WHERE/ON (index cannot be used)
  HIGH   LEADING_WILDCARD   LIKE/ILIKE pattern starts with % or _ (full scan)
  HIGH   N_PLUS_ONE         the same statement shape repeats >= --repeat times with different literals
  HIGH   ORDER_BY_RANDOM    ORDER BY RAND()/RANDOM() sorts the whole table
  HIGH   NO_WHERE_WRITE     UPDATE or DELETE without WHERE
  HIGH   AND_OR_PRECEDENCE  AND and OR mixed without parentheses: AND binds first, so the OR branch
                            matches rows from the whole table (wrong results and a full scan)
  MEDIUM SELECT_STAR        SELECT * or alias.* (wide rows, no covering index, breaks on schema change)
  MEDIUM OR_ACROSS_COLUMNS  OR between different columns in WHERE (consider UNION ALL)
  MEDIUM IMPLICIT_CAST      code/phone/sku-like (text) column compared with a bare number: MySQL
                            casts every row and skips the index, PostgreSQL raises a type error
  MEDIUM NOT_IN_SUBQUERY    NOT IN (SELECT ...): NULL trap and poor anti-join plans; use NOT EXISTS
  MEDIUM DEEP_OFFSET        OFFSET (or LIMIT a,b) >= 1000: keyset pagination instead
  MEDIUM NO_INDEX_FOR_FILTER  (needs --indexes) filtered/joined column not leading any known index
  LOW    QUOTED_NUMBER      id/number column compared with a quoted number: usually fine for a literal,
                            but a sign the app binds ids as text (typed text parameters can force a cast)
  LOW    OR_SAME_COLUMN     col = a OR col = b: write col IN (a, b)
  LOW    COUNT_FOR_EXISTS   COUNT(*) > 0 used as an existence check; use EXISTS
  LOW    DISTINCT_JOIN      SELECT DISTINCT with JOIN may hide a join fan-out
EXPLAIN findings (PostgreSQL text format and MySQL EXPLAIN \\G vertical format):
  HIGH   SEQ_SCAN_LARGE     Seq Scan / type ALL over >= --large-rows rows
  MEDIUM ROWS_REMOVED       a filter throws away >= 90% of the rows it reads
  MEDIUM EST_MISMATCH       estimated vs actual rows differ by >= 10x (stale statistics)
  MEDIUM DISK_SORT          external merge sort / Using filesort with Using temporary
  LOW    NESTED_LOOP_MANY   inner side of a nested loop runs >= 1000 loops
Usage:
  python3 sql_review.py query.sql
  python3 sql_review.py query.sql --explain plan.txt --indexes indexes.txt --json
  python3 sql_review.py --self-test
--indexes file: one index per line, e.g. "orders(customer_id, created_at)".
Exit code: 0 no HIGH findings, 1 HIGH findings, 2 bad input.
"""
import argparse
import json
import re
import sys
from collections import defaultdict

SEV_ORDER = {"HIGH": 0, "MEDIUM": 1, "LOW": 2}
FUNCS = ("lower", "upper", "trim", "ltrim", "rtrim", "date", "year", "month", "day", "cast",
         "coalesce", "ifnull", "nvl", "substring", "substr", "left", "right", "to_char",
         "date_trunc", "extract", "date_format", "convert", "abs", "round", "concat", "length")
ID_COL = re.compile(r"(^|_)(id|number|count|qty|quantity|amount)$")
TEXT_COL = re.compile(r"(phone|zip|postal_code|postcode|sku|isbn|iban|code|_no)$")
KEYWORDS = {"where", "on", "and", "or", "not", "join", "left", "right", "inner", "outer", "full",
            "cross", "group", "order", "by", "limit", "offset", "having", "union", "select", "from",
            "as", "using", "set", "values", "into", "lateral", "natural", "straight_join", "with"}


class DataError(ValueError):
    pass


def mask(sql):
    """Remove comments, replace string literals with 'Sn' tokens; return (masked, literals)."""
    sql = re.sub(r"--[^\n]*", " ", sql)
    sql = re.sub(r"/\*.*?\*/", " ", sql, flags=re.S)
    lits = []

    def rep(m):
        lits.append(m.group(0)[1:-1].replace("''", "'"))
        return f"'S{len(lits) - 1}'"
    return re.sub(r"'(?:[^']|'')*'", rep, sql), lits


def split_statements(text):
    masked, lits = mask(text)
    out = []
    for part in masked.split(";"):
        s = " ".join(part.split())
        if s:
            out.append(s)
    return out, lits


def clause(stmt, start, enders):
    m = re.search(r"\b" + start + r"\b", stmt, re.I)
    if not m:
        return ""
    rest = stmt[m.end():]
    e = re.search(r"\b(" + "|".join(enders) + r")\b", rest, re.I)
    return rest[:e.start()] if e else rest


def where_part(stmt):
    return clause(stmt, "where", ["group\\s+by", "order\\s+by", "limit", "offset", "having",
                                  "union", "returning", "for\\s+update", "window"])


def join_on_parts(stmt):
    return re.findall(r"\bon\b(.*?)(?=\b(?:join|left|right|inner|full|cross|where|group|order|limit|union)\b|$)",
                      stmt, re.I)


def aliases(stmt):
    amap = {}
    for m in re.finditer(r"\b(?:from|join)\s+([a-z_][\w.]*)(?:\s+(?:as\s+)?([a-z_]\w*))?", stmt, re.I):
        table, alias = m.group(1).lower(), (m.group(2) or "").lower()
        if table == "select" or table.startswith("("):
            continue
        amap[table.split(".")[-1]] = table.split(".")[-1]
        if alias and alias not in KEYWORDS:
            amap[alias] = table.split(".")[-1]
    return amap


def shape(stmt):
    s = re.sub(r"'S\d+'", "?", stmt)
    s = re.sub(r"\b\d+(\.\d+)?\b", "?", s)
    s = re.sub(r"\(\s*\?(\s*,\s*\?)*\s*\)", "(?)", s)
    return s.lower()


def review_sql(text, repeat=3, indexes=None):
    stmts, lits = split_statements(text)
    if not stmts:
        raise DataError("no SQL statements found")
    findings = []

    def add(sev, code, n, msg):
        findings.append({"severity": sev, "code": code, "statement": n, "message": msg})

    shapes = defaultdict(list)
    for n, st in enumerate(stmts, 1):
        low = st.lower()
        kind = low.split()[0]
        shapes[shape(st)].append(n)
        where = where_part(st)
        ons = join_on_parts(st)
        filt = " AND ".join([where] + ons)
        if re.search(r"\bselect\s+(distinct\s+)?(\w+\.)?\*", low) or re.search(r",\s*\w+\.\*", low):
            add("MEDIUM", "SELECT_STAR", n, "SELECT * reads every column; list the columns you need so a covering index can serve the query")
        for m in re.finditer(r"\b(" + "|".join(FUNCS) + r")\s*\(\s*([a-z_][\w]*(?:\.[a-z_]\w*)?)\b[^()]*\)\s*(=|<>|!=|<=|>=|<|>|\bin\b|\blike\b|\bbetween\b)",
                             filt, re.I):
            col = m.group(2)
            if col.lower() in KEYWORDS or re.fullmatch(r"S\d+", col):
                continue
            add("HIGH", "FUNC_ON_COLUMN", n, f"{m.group(1)}({col}) in a filter hides {col} from its index; compare the bare column (e.g. a range on the raw value) or add an expression index")
        for m in re.finditer(r"([a-z_][\w.]*)\s*[+\-*/]\s*\d+\s*(=|<|>|<=|>=)", filt, re.I):
            add("HIGH", "FUNC_ON_COLUMN", n, f"arithmetic on {m.group(1)} in a filter; move it to the other side of the comparison")
        for m in re.finditer(r"([a-z_][\w.]*)\s+(not\s+)?(i?like)\s+'S(\d+)'", st, re.I):
            pat = lits[int(m.group(4))]
            if pat[:1] in ("%", "_"):
                add("HIGH", "LEADING_WILDCARD", n, f"{m.group(1)} {m.group(3).upper()} '{pat}' starts with a wildcard, so no B-tree index helps; use full-text search, a trigram index or a reversed column")
        if re.search(r"order\s+by\s+(rand|random|newid)\s*\(\s*\)", low):
            add("HIGH", "ORDER_BY_RANDOM", n, "ORDER BY random sorts every row; pick random ids or use TABLESAMPLE")
        if kind in ("update", "delete") and not where.strip():
            add("HIGH", "NO_WHERE_WRITE", n, f"{kind.upper()} without WHERE touches every row; add a WHERE clause or batch it")
        if where:
            top = where
            while re.search(r"\([^()]*\)", top):
                top = re.sub(r"\([^()]*\)", " _ ", top)
            top = re.sub(r"\bbetween\s+\S+\s+and\b", "between x", top, flags=re.I)
            if re.search(r"\band\b", top, re.I) and re.search(r"\bor\b", top, re.I):
                add("HIGH", "AND_OR_PRECEDENCE", n, "AND and OR are mixed without parentheses; AND binds first, so 'a AND b OR c' returns every row matching c; add parentheses: a AND (b OR c)")
            for group in re.split(r"\band\b", where, flags=re.I):
                if not re.search(r"\bor\b", group, re.I):
                    continue
                cols = re.findall(r"([a-z_][\w.]*)\s*(?:=|<>|!=|<|>|\bin\b|\blike\b)", group, re.I)
                cols = [c.lower() for c in cols if c.lower() not in KEYWORDS and not re.fullmatch(r"s\d+", c.lower())]
                if len(set(cols)) >= 2:
                    add("MEDIUM", "OR_ACROSS_COLUMNS", n, f"OR across {', '.join(sorted(set(cols)))}: one index cannot serve both sides; split into UNION ALL of indexed queries (or check the plan uses a bitmap OR)")
                elif len(cols) >= 2:
                    add("LOW", "OR_SAME_COLUMN", n, f"repeated OR on {cols[0]}; write {cols[0]} IN (...)")
        for m in re.finditer(r"([a-z_][\w.]*)\s*(=|<>|!=|<|>)\s*'S(\d+)'", filt, re.I):
            col = m.group(1).split(".")[-1].lower()
            if ID_COL.search(col) and re.fullmatch(r"-?\d+(\.\d+)?", lits[int(m.group(3))]):
                add("LOW", "QUOTED_NUMBER", n, f"{m.group(1)} compared with the string '{lits[int(m.group(3))]}'; bind it as a number so the driver never sends a text parameter")
        for m in re.finditer(r"([a-z_][\w.]*)\s*(=|<>|!=)\s*(\d{3,})\b", filt, re.I):
            col = m.group(1).split(".")[-1].lower()
            if TEXT_COL.search(col):
                add("MEDIUM", "IMPLICIT_CAST", n, f"{m.group(1)} looks like a text column but is compared with the number {m.group(3)}; MySQL then casts every row and skips the index (PostgreSQL raises a type error); quote the value")
        if re.search(r"\bnot\s+in\s*\(\s*select\b", low):
            add("MEDIUM", "NOT_IN_SUBQUERY", n, "NOT IN (SELECT ...) returns no rows if the subquery yields a NULL and often plans badly; use NOT EXISTS")
        m = re.search(r"\boffset\s+(\d+)", low) or re.search(r"\blimit\s+(\d+)\s*,\s*\d+", low)
        if m and int(m.group(1)) >= 1000:
            add("MEDIUM", "DEEP_OFFSET", n, f"OFFSET {m.group(1)} reads and throws away {m.group(1)} rows; use keyset pagination (WHERE (created_at, id) < (?, ?) ORDER BY ... LIMIT n)")
        if re.search(r"count\s*\(\s*(\*|1)\s*\)\s*(>\s*0|>=\s*1)", low):
            add("LOW", "COUNT_FOR_EXISTS", n, "COUNT(*) > 0 counts every match; EXISTS stops at the first")
        if re.search(r"\bselect\s+distinct\b", low) and re.search(r"\bjoin\b", low):
            add("LOW", "DISTINCT_JOIN", n, "DISTINCT on a join often hides duplicate rows from a one-to-many join; use EXISTS or aggregate first")
        if indexes is not None:
            amap = aliases(st)
            seen = set()
            for m in re.finditer(r"\b([a-z_]\w*)\.([a-z_]\w*)\s*(?:=|<|>|<=|>=|\bin\b|\bbetween\b)", filt, re.I):
                table = amap.get(m.group(1).lower())
                col = m.group(2).lower()
                if not table or (table, col) in seen:
                    continue
                seen.add((table, col))
                if table in indexes and col not in indexes[table]:
                    add("MEDIUM", "NO_INDEX_FOR_FILTER", n, f"{table}.{col} is filtered or joined but no listed index on {table} starts with it")
    for sh, ns in shapes.items():
        if len(ns) >= repeat and ("where" in sh):
            add("HIGH", "N_PLUS_ONE", ns[0], f"statements {', '.join(map(str, ns))} have the same shape with different values ({len(ns)}x); fetch them in one query with IN (...) or a JOIN")
    findings.sort(key=lambda f: (SEV_ORDER[f["severity"]], f["statement"], f["code"]))
    shown = [re.sub(r"'S(\d+)'", lambda m: "'" + lits[int(m.group(1))].replace("'", "''") + "'", st) for st in stmts]
    return shown, findings


def parse_indexes(text):
    idx = defaultdict(set)
    for line in text.splitlines():
        m = re.match(r"\s*([\w.]+)\s*\(\s*([\w\s,]+)\)", line)
        if m:
            idx[m.group(1).split(".")[-1].lower()].add(m.group(2).split(",")[0].strip().lower())
    return idx


def review_explain(text, large=10000):
    findings = []

    def add(sev, code, msg):
        findings.append({"severity": sev, "code": code, "statement": 0, "message": msg})
    lines = text.splitlines()
    if re.search(r"^\s*(\*+ \d+\. row|select_type:)", text, re.M):
        for block in re.split(r"\*+ \d+\. row \*+", text):
            f = dict(re.findall(r"^\s*(\w+):\s*(.*?)\s*$", block, re.M))
            if not f:
                continue
            rows = int(f.get("rows", "0") or 0)
            if f.get("type") == "ALL" and rows >= large:
                add("HIGH", "SEQ_SCAN_LARGE", f"full table scan (type ALL) on {f.get('table')} ~{rows} rows; key={f.get('key', 'NULL')}")
            extra = f.get("Extra", "")
            if "Using filesort" in extra and "Using temporary" in extra:
                add("MEDIUM", "DISK_SORT", f"{f.get('table')}: Using temporary; Using filesort - an index matching GROUP BY/ORDER BY avoids it")
            filtered = float(f.get("filtered", "100") or 100)
            if rows >= 1000 and filtered <= 10:
                add("MEDIUM", "ROWS_REMOVED", f"{f.get('table')}: only {filtered:g}% of {rows} rows pass the filter")
        return findings
    for i, line in enumerate(lines):
        m = re.search(r"(Parallel )?Seq Scan on (\S+).*?rows=(\d+)", line)
        if m:
            act = re.search(r"actual[^)]*rows=(\d+)", line)
            rows = int(act.group(1) if act else m.group(3))
            if rows >= large:
                add("HIGH", "SEQ_SCAN_LARGE", f"Seq Scan on {m.group(2)} returns ~{rows} rows; an index on the filter columns may help")
        m = re.search(r"Rows Removed by Filter:\s*(\d+)", line)
        if m:
            removed = int(m.group(1))
            prev = next((l for l in reversed(lines[:i]) if "actual" in l), "")
            k = re.search(r"actual[^)]*rows=(\d+)", prev)
            kept = int(k.group(1)) if k else 0
            if removed >= 1000 and removed >= 9 * max(kept, 1):
                add("MEDIUM", "ROWS_REMOVED", f"filter removed {removed} rows to keep {kept} ({prev.strip()[:60]}...)")
        m = re.search(r"cost=[\d.]+\.\.[\d.]+ rows=(\d+).*actual time=[\d.]+\.\.[\d.]+ rows=(\d+) loops=(\d+)", line)
        if m:
            est, act, loops = int(m.group(1)), int(m.group(2)), int(m.group(3))
            if max(est, act) >= 100 and max(est, act) >= 10 * max(min(est, act), 1):
                node = line.strip().lstrip("->").strip().split("  ")[0]
                add("MEDIUM", "EST_MISMATCH", f"{node[:50]}: estimated {est} rows, actual {act}; run ANALYZE")
            if loops >= 1000:
                node = line.strip().lstrip("->").strip().split("  ")[0]
                add("LOW", "NESTED_LOOP_MANY", f"{node[:50]} runs {loops} loops; check the join index or consider a hash join")
        if re.search(r"Sort Method: external merge", line):
            add("MEDIUM", "DISK_SORT", "sort spilled to disk (external merge); add an index for ORDER BY or raise work_mem for this query")
    findings.sort(key=lambda f: SEV_ORDER[f["severity"]])
    return findings


def render(path, stmts, findings):
    out = [f"# SQL performance review: {path}", "",
           f"{len(stmts)} statement(s); {sum(f['severity'] == 'HIGH' for f in findings)} HIGH, "
           f"{sum(f['severity'] == 'MEDIUM' for f in findings)} MEDIUM, {sum(f['severity'] == 'LOW' for f in findings)} LOW", ""]
    for n, st in enumerate(stmts, 1):
        out.append(f"{n}. {st[:110]}{'...' if len(st) > 110 else ''}")
    out += ["", "## Findings"]
    if not findings:
        out.append("- none (heuristics only: still check the real plan with EXPLAIN ANALYZE)")
    for f in findings:
        where = f"stmt {f['statement']}" if f["statement"] else "EXPLAIN"
        out.append(f"- {f['severity']} {f['code']} ({where}): {f['message']}")
    return "\n".join(out)


def self_test():
    results = []

    def check(name, cond):
        results.append(cond)
        print(("PASS " if cond else "FAIL ") + name)

    def codes(sql, **kw):
        return [f["code"] for f in review_sql(sql, **kw)[1]]
    check("select star", "SELECT_STAR" in codes("SELECT * FROM users WHERE id = 1"))
    check("alias star", "SELECT_STAR" in codes("SELECT o.* FROM orders o WHERE o.id = 1"))
    check("explicit columns ok", "SELECT_STAR" not in codes("SELECT id, name FROM users WHERE id = 1"))
    check("lower(col) HIGH", "FUNC_ON_COLUMN" in codes("SELECT id FROM users WHERE LOWER(email) = 'a@b.c'"))
    check("year(col) HIGH", "FUNC_ON_COLUMN" in codes("SELECT id FROM orders WHERE YEAR(created_at) = 2026"))
    check("arithmetic HIGH", "FUNC_ON_COLUMN" in codes("SELECT id FROM t WHERE price * 2 > 100"))
    check("function on value side ok", "FUNC_ON_COLUMN" not in codes("SELECT id FROM users WHERE email = LOWER('A@B.C')"))
    check("leading wildcard", "LEADING_WILDCARD" in codes("SELECT id FROM p WHERE name LIKE '%phone%'"))
    check("trailing wildcard ok", "LEADING_WILDCARD" not in codes("SELECT id FROM p WHERE name LIKE 'phone%'"))
    check("wildcard inside string literal ignored", "LEADING_WILDCARD" not in codes("SELECT 'x LIKE %y' AS note FROM p WHERE id = 1"))
    check("N+1 detected", "N_PLUS_ONE" in codes("SELECT name FROM users WHERE id = 1; SELECT name FROM users WHERE id = 2; SELECT name FROM users WHERE id = 3;"))
    check("2 repeats not N+1", "N_PLUS_ONE" not in codes("SELECT name FROM users WHERE id = 1; SELECT name FROM users WHERE id = 2;"))
    check("OR across columns", "OR_ACROSS_COLUMNS" in codes("SELECT id FROM u WHERE email = 'a' OR phone = 'b'"))
    check("OR same column LOW", "OR_SAME_COLUMN" in codes("SELECT id FROM u WHERE status = 'a' OR status = 'b'"))
    check("quoted number LOW", "QUOTED_NUMBER" in codes("SELECT id FROM orders WHERE customer_id = '42'"))
    check("implicit cast phone number", "IMPLICIT_CAST" in codes("SELECT id FROM users WHERE phone = 5551234"))
    check("number id ok", "QUOTED_NUMBER" not in codes("SELECT id FROM orders WHERE customer_id = 42"))
    check("NOT IN subquery", "NOT_IN_SUBQUERY" in codes("SELECT id FROM a WHERE id NOT IN (SELECT a_id FROM b)"))
    check("deep offset", "DEEP_OFFSET" in codes("SELECT id FROM a ORDER BY id LIMIT 20 OFFSET 50000"))
    check("mysql limit a,b offset", "DEEP_OFFSET" in codes("SELECT id FROM a ORDER BY id LIMIT 20000, 20"))
    check("order by rand", "ORDER_BY_RANDOM" in codes("SELECT id FROM a ORDER BY RAND() LIMIT 1"))
    check("delete without where", "NO_WHERE_WRITE" in codes("DELETE FROM sessions"))
    check("AND/OR precedence HIGH", "AND_OR_PRECEDENCE" in codes("SELECT id FROM o WHERE a = 1 AND b = 2 OR b = 3"))
    check("parenthesized OR ok", "AND_OR_PRECEDENCE" not in codes("SELECT id FROM o WHERE a = 1 AND (b = 2 OR b = 3)"))
    check("BETWEEN ... AND not an AND", "AND_OR_PRECEDENCE" not in codes("SELECT id FROM o WHERE d BETWEEN 1 AND 5 OR e = 2"))
    check("literals restored in output", "'mina'" in review_sql("SELECT id FROM u WHERE name = 'mina'")[0][0])
    check("count for exists", "COUNT_FOR_EXISTS" in codes("SELECT CASE WHEN COUNT(*) > 0 THEN 1 END FROM a WHERE b = 1"))
    check("distinct join", "DISTINCT_JOIN" in codes("SELECT DISTINCT u.id FROM users u JOIN orders o ON o.user_id = u.id"))
    idx = parse_indexes("orders(customer_id, created_at)\nusers(id)")
    c = codes("SELECT o.id FROM orders o JOIN users u ON u.id = o.customer_id WHERE o.status = 'paid'", indexes=idx)
    check("no index for filter", c.count("NO_INDEX_FOR_FILTER") == 1)
    check("comments stripped", codes("-- SELECT * FROM x\nSELECT id FROM users WHERE id = 1") == [])
    pg = """Seq Scan on orders  (cost=0.00..25000.00 rows=50 width=8) (actual time=0.1..310.2 rows=48210 loops=1)
  Filter: (status = 'paid'::text)
  Rows Removed by Filter: 951790
Sort Method: external merge  Disk: 51200kB"""
    e = [f["code"] for f in review_explain(pg)]
    check("pg seq scan large", "SEQ_SCAN_LARGE" in e)
    check("pg rows removed", "ROWS_REMOVED" in e)
    check("pg estimate mismatch", "EST_MISMATCH" in e)
    check("pg disk sort", "DISK_SORT" in e)
    my = """*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: orders
         type: ALL
          key: NULL
         rows: 980000
     filtered: 5.00
        Extra: Using where; Using temporary; Using filesort"""
    e = [f["code"] for f in review_explain(my)]
    check("mysql type ALL", "SEQ_SCAN_LARGE" in e and "DISK_SORT" in e and "ROWS_REMOVED" in e)
    try:
        review_sql("  -- only a comment\n")
        check("empty input rejected", False)
    except DataError:
        check("empty input rejected", True)
    print(f"{sum(results)}/{len(results)} passed")
    return 0 if all(results) else 1


def main():
    ap = argparse.ArgumentParser(description="SQL query performance reviewer (heuristic)")
    ap.add_argument("sql", nargs="?", help=".sql file with one or more statements")
    ap.add_argument("--explain", help="EXPLAIN output (PostgreSQL text or MySQL \\G)")
    ap.add_argument("--indexes", help="known indexes, one per line: table(col1, col2)")
    ap.add_argument("--repeat", type=int, default=3, help="N+1 threshold (default 3)")
    ap.add_argument("--large-rows", type=int, default=10000, help="rows for SEQ_SCAN_LARGE (default 10000)")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args()
    if a.self_test:
        return self_test()
    if not a.sql:
        ap.error("give a .sql file or --self-test")
    try:
        with open(a.sql, encoding="utf-8") as fh:
            text = fh.read()
        idx = None
        if a.indexes:
            with open(a.indexes, encoding="utf-8") as fh:
                idx = parse_indexes(fh.read())
        stmts, findings = review_sql(text, a.repeat, idx)
        if a.explain:
            with open(a.explain, encoding="utf-8") as fh:
                findings += review_explain(fh.read(), a.large_rows)
    except (OSError, DataError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    if a.json:
        print(json.dumps({"statements": stmts, "findings": findings}, indent=2))
    else:
        print(render(a.sql, stmts, findings))
    return 1 if any(f["severity"] == "HIGH" for f in findings) else 0


if __name__ == "__main__":
sys.exit(main())Đánh giá cấu hình chính sách mật khẩu theo tiêu chuẩn NIST SP 800-63B-4, bao gồm độ dài tối thiểu, không áp đặt quy tắc kết hợp ký tự hay bắt buộc đổi mật khẩu định kỳ, kiểm tra danh sách chặn (blocklist), giới hạn tốc độ thử (rate limiting), hỗ trợ dán (paste) và Unicode, không dùng gợi ý mật khẩu hay câu hỏi bảo mật, cùng các tham số băm (hashing) an toàn. Ước tính entropy của các mật khẩu mẫu giả định và chỉ ra những mật khẩu yếu nào vẫn được chính sách hiện tại chấp nhận. Không bao giờ yêu cầu mật khẩu thật. Đi kèm công cụ kiểm tra bằng thư viện chuẩn Python có hỗ trợ --self-test.
---
name: password-policy-and-entropy-checker
description: Đánh giá cấu hình chính sách mật khẩu theo tiêu chuẩn NIST SP 800-63B-4, bao gồm độ dài tối thiểu, không áp đặt quy tắc kết hợp ký tự hay bắt buộc đổi mật khẩu định kỳ, kiểm tra danh sách chặn (blocklist), giới hạn tốc độ thử (rate limiting), hỗ trợ dán (paste) và Unicode, không dùng gợi ý mật khẩu hay câu hỏi bảo mật, cùng các tham số băm (hashing) an toàn. Ước tính entropy của các mật khẩu mẫu giả định và chỉ ra những mật khẩu yếu nào vẫn được chính sách hiện tại chấp nhận. Không bao giờ yêu cầu mật khẩu thật. Đi kèm công cụ kiểm tra bằng thư viện chuẩn Python có hỗ trợ --self-test.
---

# Trình Kiểm tra Chính sách Mật khẩu và Entropy

Bạn giúp các lập trình viên, quản trị viên CNTT và chuyên gia đánh giá bảo mật điều chỉnh chính sách mật khẩu phù hợp với hướng dẫn NIST hiện hành (SP 800-63B-4, 2025), đồng thời giải thích tại sao các quy tắc cũ (8 ký tự, chữ hoa+chữ thường+chữ số+ký tự đặc biệt, đổi mỗi 90 ngày) lại tạo ra những mật khẩu yếu và dễ đoán. Bạn chứng minh điều đó bằng những con số cụ thể: ước tính entropy cho các mật khẩu mẫu giả định và danh sách các mẫu mật khẩu yếu mà chính sách hiện tại vẫn cho phép lọt qua.

## Các tệp trong kỹ năng này

- `scripts/pw_policy.py` - kiểm tra tệp JSON chính sách đối chiếu với NIST SP 800-63B-4 và mức tối thiểu về băm mật khẩu của OWASP, đồng thời ước tính entropy cho các mẫu tổng hợp, mặc định được che (mask) ở đầu ra (chỉ dùng thư viện chuẩn Python 3; không kết nối mạng, không lưu trữ bất cứ thứ gì)
- `references/nist-800-63b-rules.md` - các yêu cầu về mật khẩu (SHALL / SHOULD) cùng ý nghĩa thực tế của từng yêu cầu
- `references/entropy-and-hashing.md` - cách thức hoạt động của hai phương pháp ước tính entropy, giới hạn của chúng, các giả định về tốc độ đoán mật khẩu và các tham số băm
- `templates/policy-recommendation.md` - bản khuyến nghị bạn trả về: thiết lập hiện tại so với thiết lập khuyến nghị, lý do và kế hoạch triển khai
- `examples/legacy-portal-policy.json` và `examples/synthetic-samples.txt` - một chính sách cổng thông tin khách hàng kiểu cũ và 8 mật khẩu mẫu giả định

## Quy trình làm việc

### 1. Thu thập chính sách, tuyệt đối không thu thập mật khẩu thật
Yêu cầu người dùng cung cấp các thiết lập chính sách (từ nhà cung cấp danh tính - IdP, chính sách mật khẩu chi tiết của Active Directory, cấu hình framework như `AUTH_PASSWORD_VALIDATORS` của Django, hoặc tài liệu chính sách bằng văn bản) và chuyển đổi chúng thành các khóa JSON như trong docstring của script. Hỏi xem mật khẩu là yếu tố xác thực duy nhất hay luôn được kết hợp với MFA (`single_factor`). Nếu người dùng muốn kiểm tra độ mạnh, hãy yêu cầu họ tự nghĩ ra các mẫu giống với cách người dùng thường đặt. Nếu ai đó dán nội dung trông giống mật khẩu thật, tuyệt đối không lặp lại mật khẩu đó, hãy nhắc họ đổi mật khẩu ngay và tiếp tục làm việc bằng các mẫu giả định.

### 2. Chạy trình kiểm tra
```
python3 scripts/pw_policy.py examples/legacy-portal-policy.json --samples examples/synthetic-samples.txt --context northwind
python3 scripts/pw_policy.py policy.json --samples synthetic.txt --blocklist top-10k.txt --json
python3 scripts/pw_policy.py --self-test
```
`--context` thêm tên dịch vụ, thương hiệu và các từ tương tự vào bước kiểm tra danh sách chặn (blocklist). Mã thoát (exit code) 1 có nghĩa là có phát hiện mức HIGH, 2 có nghĩa là đầu vào không hợp lệ.

### 3. Giải thích các phát hiện
Bắt đầu với những gì thay đổi đối với người dùng: độ dài tối thiểu lớn hơn (15 ký tự nếu dùng đơn lẻ, 8 ký tự nếu có MFA), bỏ quy tắc bắt buộc đủ nhóm ký tự, bỏ bắt buộc đổi mật khẩu định kỳ, từ chối mật khẩu nằm trong danh sách chặn kèm lý do rõ ràng. Tiếp theo là phần hậu cần (back end): giới hạn tốc độ thử (rate limiting), thuật toán và tham số băm, gỡ bỏ gợi ý mật khẩu và câu hỏi bảo mật. Sử dụng bảng mẫu để chỉ ra rằng các mật khẩu kiểu `Password1!` vượt qua được các quy tắc kết hợp ký tự trong khi một cụm mật khẩu (passphrase) gồm bốn từ lại bị chúng từ chối. Sử dụng `references/nist-800-63b-rules.md` để trích dẫn yêu cầu chính xác và `references/entropy-and-hashing.md` khi người dùng hỏi "mạnh bao nhiêu là đủ".

### 4. Bàn giao kết quả
Điền vào `templates/policy-recommendation.md` với từng thiết lập (hiện tại, khuyến nghị, tham chiếu NIST), lộ trình chuyển đổi thuật toán băm (băm lại trong lần đăng nhập tiếp theo) và kế hoạch triển khai: áp dụng quy tắc mới vào lần đổi mật khẩu tiếp theo, gỡ bỏ ngay lập tức quy định hết hạn định kỳ, và kiểm tra mật khẩu bị lộ lọt ngay khi đăng nhập ở những nơi có thể thực hiện.

## Kết quả ví dụ
Đối với chính sách cổng thông tin kiểu cũ cùng 8 mẫu tổng hợp và `--context northwind`: 11 phát hiện HIGH, 5 MEDIUM, 2 LOW. Mức HIGH: độ dài tối thiểu 8 (cần 15 khi không có MFA), có quy tắc kết hợp ký tự, hết hạn sau 90 ngày, không có danh sách chặn, dùng gợi ý mật khẩu, dùng câu hỏi bảo mật, và 5 mẫu yếu được chính sách chấp nhận (Password1!, Summer2025!, Northwind#1, Qwerty123$, P@ssw0rd2026, mỗi mẫu chỉ khoảng ~15-20 bit). Mức MEDIUM: PBKDF2 ở mức 10000 vòng lặp, độ dài tối đa 20, chặn dấu cách và thao tác dán, không có hướng dẫn độ mạnh. Cụm mật khẩu 4 từ (~54 bit) và cụm 5 từ (~67 bit) bị quy tắc hiện tại từ chối nhưng hoàn toàn hợp lệ theo chuẩn NIST.

## Quy tắc

- Không bao giờ yêu cầu, lưu trữ hoặc lặp lại mật khẩu thật, mã băm (hash) thật hay tệp mật khẩu thật. Chỉ làm việc với các mẫu giả định.
- Các con số entropy là mức ước tính để so sánh, không phải sự đảm bảo tuyệt đối; hãy nêu rõ điều đó.
- Trích dẫn chính xác mức SHALL và SHOULD của NIST; không trình bày các con số khuyến nghị băm của OWASP như thể đó là yêu cầu bắt buộc của NIST.
- MFA chống giả mạo (phishing-resistant MFA) hoặc passkey vượt trội hơn bất kỳ quy tắc mật khẩu nào; hãy khuyến nghị chúng ở những nơi mức độ rủi ro đòi hỏi.
- Không khuyến nghị làm suy yếu một biện pháp kiểm soát (ví dụ: giới hạn tốc độ thử) để cải thiện tính tiện dụng mà không có biện pháp thay thế.
FILE:references/nist-800-63b-rules.md
# Quy tắc Mật khẩu NIST SP 800-63B-4 (bản chính thức, 2025)

Mục 3.1.1.2 "Password Verifiers" áp dụng cho mật khẩu được xác minh tập trung (biểu mẫu đăng nhập được kiểm tra bởi máy chủ). Mã PIN mở khóa cục bộ là "activation secrets" (bí mật kích hoạt) với các quy tắc khác (Mục 3.2.10). SHALL = bắt buộc, SHOULD = khuyến nghị.

| # | Yêu cầu | Mức độ | Mã trong script | Trong thực tế |
|---|---|---|---|---|
| 1 | Tối thiểu 15 ký tự khi mật khẩu là yếu tố duy nhất; tối thiểu 8 ký tự nếu chỉ dùng kèm MFA | SHALL | MIN_LENGTH | Đặt 15 cho đăng nhập chỉ dùng mật khẩu; mức 8 chỉ chấp nhận được nếu MFA luôn được áp dụng bắt buộc |
| 2 | Cho phép độ dài tối đa ít nhất 64 ký tự | SHOULD | MAX_LENGTH | Cụm mật khẩu và đầu ra của trình quản lý mật khẩu cần không gian; kích thước lưu trữ đằng nào cũng cố định theo mã băm |
| 3 | Chấp nhận tất cả các ký tự ASCII in được và dấu cách | SHOULD | NO_SPACES | Không từ chối `"`, `'`, `<`, dấu cách; thay vào đó hãy xử lý thoát ký tự (escape) đúng cách |
| 4 | Chấp nhận Unicode; đếm mỗi điểm mã (code point) là một ký tự | SHOULD | NO_UNICODE | Áp dụng chuẩn hóa NFC trước khi băm (NO_NORMALIZATION) |
| 5 | Không áp đặt các quy tắc kết hợp ký tự khác (trộn các nhóm ký tự) | SHALL NOT | COMPOSITION_RULES | Gỡ bỏ quy định "1 chữ hoa, 1 chữ số, 1 ký tự đặc biệt" |
| 6 | Không bắt buộc đổi mật khẩu định kỳ; chỉ bắt buộc đổi khi có bằng chứng lộ lọt | SHALL NOT | PERIODIC_EXPIRY | Gỡ bỏ thời hạn 90 ngày; đặt lại mật khẩu khi có bằng chứng rò rỉ |
| 7 | Không cung cấp gợi ý mật khẩu mà người dùng chưa xác thực có thể truy cập | SHALL NOT | HINTS | Xóa các gợi ý mật khẩu đang lưu trữ |
| 8 | Không sử dụng xác thực dựa trên kiến thức (KBA) / câu hỏi bảo mật | SHALL NOT | SECURITY_QUESTIONS | Sử dụng mã khôi phục hoặc một kênh đã được xác minh |
| 9 | Xác minh toàn bộ mật khẩu, không cắt bớt (truncation), không yêu cầu kiểu "nhập ký tự thứ 3, 5 và 8" | SHALL | TRUNCATION | Lưu ý giới hạn 72 byte của bcrypt (BCRYPT_72_BYTES) |
| - | So sánh toàn bộ mật khẩu với danh sách chặn gồm các giá trị phổ biến, dễ đoán và đã bị lộ; nêu rõ lý do khi từ chối | SHALL | NO_BLOCKLIST, BLOCKLIST_THIN | Kho dữ liệu mật khẩu bị rò rỉ (ví dụ: API truy vấn theo dải k-anonymity hoặc danh sách tải về), từ điển, tên dịch vụ, tên người dùng |
| - | Cung cấp hướng dẫn giúp người dùng chọn mật khẩu mạnh, đặc biệt là sau khi mật khẩu bị từ chối | SHALL | NO_GUIDANCE | Thanh đo độ mạnh và lý do từ chối bằng ngôn ngữ dễ hiểu |
| - | Giới hạn tốc độ các lần thử thất bại: không quá 100 lần thất bại liên tiếp trên mỗi tài khoản (Mục 3.2.2) | SHALL | NO_RATE_LIMIT | Độ trễ tăng dần, CAPTCHA, kiểm tra rủi ro; khóa cứng tài khoản sau 3 lần thử dễ dẫn đến tấn công từ chối dịch vụ (LOCKOUT_STRICT) |
| - | Cho phép trình quản lý mật khẩu và tự động điền (autofill); cho phép dán (paste) | xem Mục 3.1.1.2 | PASTE_BLOCKED | Không bao giờ chặn thao tác dán trên các trường mật khẩu |
| - | Lưu trữ mật khẩu đã thêm muối (salted) và băm (hashed) bằng lược đồ băm mật khẩu phù hợp (Mục 3.1.1.2, phần cuối) | SHALL | WEAK_STORAGE | Argon2id, scrypt, bcrypt hoặc PBKDF2 với salt duy nhất; các tham số đặt cao nhất có thể trong thực tế |

## Quy mô danh sách chặn (Blocklist)
NIST lưu ý rằng danh sách chặn chủ yếu ngăn chặn việc đoán mật khẩu trực tuyến (vốn đã bị giới hạn tốc độ), vì vậy danh sách này nên bao quát những mật khẩu mà kẻ tấn công sẽ thử trước khi chạm ngưỡng giới hạn (từ vài nghìn đến vài trăm nghìn mục); những danh sách quá lớn chủ yếu chỉ gây phiền toái cho người dùng. Hãy kiểm tra toàn bộ mật khẩu chứ không kiểm tra chuỗi con, nhưng cần bao gồm các biến thể hiển nhiên của tên dịch vụ và tên người dùng.

## Tại sao nên loại bỏ quy tắc kết hợp ký tự và thời hạn mật khẩu
Người dùng đối phó với quy định "chữ hoa + chữ số + ký tự đặc biệt" bằng `Password1!`; việc bắt buộc đổi mật khẩu định kỳ tạo ra `Password2!`, `Password3!`. Các công cụ tấn công đều mô hình hóa những khuôn mẫu này, vì vậy các quy tắc đó chỉ làm tăng sự phiền phức mà không mang lại entropy thực sự. Độ dài cộng với danh sách chặn mang lại hiệu quả cao hơn nhiều.

## Nguồn tham khảo
- NIST SP 800-63B-4, Digital Identity Guidelines: Authentication and Authenticator Management (Tháng 7 năm 2025), https://pages.nist.gov/800-63-4/sp800-63b.html
- Phụ lục A "Strength of Passwords" trong cùng tài liệu
FILE:references/entropy-and-hashing.md
# Ước tính Entropy và Băm Mật khẩu (Password Hashing)

## Hai phương pháp ước tính
**Entropy tập ký tự (Charset entropy)** = độ dài x log2(pool), với pool = 26 chữ thường + 26 chữ hoa + 10 chữ số + 33 ký tự đặc biệt (+100 nếu có ký tự ngoài bảng ASCII), chỉ tính các nhóm ký tự thực sự được sử dụng. Công thức này chính xác đối với các mật khẩu được tạo ngẫu nhiên từ tập ký tự đó nhưng lại đánh giá quá cao một cách sai lệch đối với lựa chọn của con người: `Password1!` đạt tới 65.7 bit.

**Entropy theo mẫu (Pattern entropy)** (trong script) xấp xỉ cách một công cụ bẻ khóa đoán mật khẩu: nó duyệt mật khẩu từ trái sang phải và tính điểm
| Thành phần | Chi phí |
|---|---|
| từ thông dụng trong danh sách tích hợp sẵn (bao gồm cả dạng leet như `P@ssw0rd`, các từ ngữ cảnh) | log2(kích thước danh sách) ~ 7.6 bit, +1 nếu viết hoa chữ cái đầu, +2 nếu dùng leet |
| năm từ 1950-2039 | log2(90) ~ 6.5 bit |
| chuỗi phím liền kề trên bàn phím hoặc bảng chữ cái (`qwerty`, `1234`, `zyx`) | log2(26) + log2(độ dài) |
| ký tự lặp lại (`aaaa`) | một ký tự + log2(số lần lặp) |
| chữ số/ký tự đặc biệt nối thêm vào cuối sau một từ | -1.5 bit (khuôn mẫu phổ biến nhất) |
| bất kỳ ký tự nào khác | log2(pool) |
| cụm mật khẩu (passphrase) từ 3 từ trở lên | 12.9 bit cho mỗi từ không phổ biến (danh sách Diceware gồm 7776 từ), 1 bit cho mỗi từ phổ biến |

Con số của cụm mật khẩu là giới hạn trên: nó chỉ đúng nếu các từ được chọn hoàn toàn ngẫu nhiên (bằng xúc xắc hoặc trình tạo ngẫu nhiên). Cụm "my dog loves pizza" yếu hơn thế rất nhiều. Danh sách từ tích hợp sẵn có quy mô nhỏ; một công cụ bẻ khóa thực tế sử dụng hàng tỷ mật khẩu bị rò rỉ, vì vậy hãy coi mọi ước tính đều là mức lạc quan đối với mật khẩu do con người tự chọn.

## Thang đánh giá (số bit theo mẫu)
| Số bit | Đánh giá | Ý nghĩa |
|---|---|---|
| < 28 | rất yếu (very weak) | Bị hạ gục bởi đoán trực tuyến hoặc bị bẻ khóa tức thì khi tấn công ngoại tuyến |
| 28-35 | yếu (weak) | Giới hạn tốc độ trực tuyến có giúp ích; nhưng tấn công ngoại tuyến chỉ mất vài phút |
| 36-59 | trung bình (fair) | Ổn trước các cuộc tấn công trực tuyến có giới hạn tốc độ; nhưng yếu nếu mã băm nhanh bị lộ |
| 60-79 | mạnh (strong) | Chống chịu được các cuộc tấn công ngoại tuyến trên các hàm băm chậm |
| >= 80 | rất mạnh (very strong) | Chống chịu được các cuộc tấn công ngoại tuyến ngay cả trên các hàm băm nhanh |

## Tốc độ đoán dùng để tính thời gian
- Ngoại tuyến, hàm băm nhanh (MD5/SHA-x trên GPU): 1e10 lần đoán mỗi giây.
- Ngoại tuyến, hàm băm chậm (Argon2id/bcrypt ở mức chi phí khuyến nghị): khoảng 1e4 lần đoán mỗi giây trên mỗi dàn máy của kẻ tấn công.
- Trực tuyến với cơ chế giới hạn tốc độ của NIST (<= 100 lần thất bại trên mỗi tài khoản, sau đó áp dụng độ trễ): chỉ vài trăm đến vài nghìn lần đoán đầu tiên là có ý nghĩa, đó là lý do danh sách chặn là biện pháp kiểm soát trực tuyến then chốt.
Thời gian hiển thị = trường hợp trung vị, 2^(bits-1) / tốc độ.

## Các tham số băm (mức tối thiểu theo OWASP Password Storage Cheat Sheet)
| Thuật toán | Mức tối thiểu | Ghi chú |
|---|---|---|
| Argon2id | m = 19456 KiB (19 MiB), t = 2, p = 1 | Lựa chọn ưu tiên hàng đầu |
| scrypt | N = 2^17, r = 8, p = 1 | |
| bcrypt | cost 10 | Đầu vào giới hạn ở 72 byte; cần băm sơ bộ (pre-hash) bằng HMAC-SHA256 + base64 hoặc giới hạn độ dài |
| PBKDF2-HMAC-SHA256 | 600000 vòng lặp | Sử dụng ở những nơi yêu cầu mật mã đạt chuẩn xác thực FIPS-140 |
Mỗi mã băm cần một muối (salt) ngẫu nhiên duy nhất (>= 16 byte). Một hạt tiêu (pepper - khóa bí mật được giữ bên ngoài cơ sở dữ liệu) tùy chọn sẽ bổ sung thêm lớp phòng thủ chiều sâu. NIST yêu cầu thêm muối và sử dụng hàm băm mật khẩu một chiều phù hợp; các con số của OWASP là mức cơ sở được sử dụng rộng rãi, không phải quy tắc của NIST.

## Chuyển đổi từ các mã băm yếu
1. Thêm thuật toán mới song song với thuật toán cũ.
2. Khi đăng nhập thành công, xác minh bằng mã băm cũ, sau đó băm lại bằng thuật toán mới.
3. Đối với những tài khoản không bao giờ đăng nhập, hãy bọc mã băm cũ lại (Argon2id(old_hash)) và đánh dấu chúng, hoặc bắt buộc đặt lại mật khẩu sau một thời hạn nhất định.
4. Kiểm tra lại trạng thái mật khẩu bị lộ lọt khi đăng nhập nếu nhà cung cấp của bạn hỗ trợ.
FILE:templates/policy-recommendation.md
# Khuyến nghị chính sách mật khẩu: <tên hệ thống>

**Phạm vi:** <cổng thông tin khách hàng / SSO nhân sự / bảng điều khiển quản trị>   **Yếu tố xác thực:** <chỉ mật khẩu / mật khẩu + MFA>
**Cơ sở:** NIST SP 800-63B-4 (2025); các tham số băm từ OWASP Password Storage Cheat Sheet
**Tóm tắt:** <một câu: ví dụ: "Thay thế các quy tắc độ phức tạp và hết hạn định kỳ bằng độ dài tối thiểu 15 ký tự và danh sách chặn mật khẩu bị rò rỉ; chuyển đổi mã băm sang Argon2id.">

## Các thiết lập
| Thiết lập | Hiện tại | Khuyến nghị | NIST | Lý do |
|---|---|---|---|---|
| Độ dài tối thiểu | <8> | <15 (8 nếu luôn bật MFA)> | SHALL | <...> |
| Độ dài tối đa | <20> | <64 trở lên> | SHOULD | <...> |
| Quy tắc kết hợp ký tự | <chữ hoa, chữ thường, chữ số, ký tự đặc biệt> | không áp dụng | SHALL NOT | <...> |
| Thời hạn hiệu lực | <90 ngày> | không áp dụng; đặt lại khi bị lộ | SHALL NOT | <...> |
| Danh sách chặn (Blocklist) | <không có> | mật khẩu rò rỉ + từ điển + từ ngữ cảnh, khớp toàn bộ mật khẩu | SHALL | <...> |
| Dấu cách / Unicode | <từ chối> | chấp nhận, chuẩn hóa NFC | SHOULD | <...> |
| Dán / trình quản lý mật khẩu | <bị chặn> | cho phép | | <...> |
| Gợi ý / câu hỏi bảo mật | <có> | gỡ bỏ | SHALL NOT | <...> |
| Số lần thử thất bại | <khóa sau 3 lần trong 60 phút> | điều tiết tốc độ, <= 100 lần thất bại liên tiếp | SHALL | <...> |
| Hướng dẫn độ mạnh | <không có> | thanh đo độ mạnh + lý do từ chối | SHALL | <...> |
| Lưu trữ | <PBKDF2-SHA256, 10000> | <Argon2id m=19 MiB t=2 p=1> | SHALL (băm có muối) | <...> |

## Những gì các mẫu mật khẩu cho thấy (chỉ dùng mật khẩu giả định)
<Bảng ngắn hoặc câu tóm tắt: ví dụ: "4 trong số 5 khuôn mẫu điển hình (Password1!, Summer2025!) vượt qua được các quy tắc hiện nay ở mức ~20 bit; một cụm mật khẩu ngẫu nhiên gồm 4 từ (~54 bit) hiện bị từ chối nhưng sẽ được chấp nhận theo chính sách mới.">

## Lộ trình triển khai
1. <Ngày 0: gỡ bỏ thời hạn mật khẩu, cho phép dán và dùng dấu cách, bật thanh đo độ mạnh>
2. <Tuần 1: áp dụng danh sách chặn cho mật khẩu tạo mới và đổi mật khẩu; hiển thị rõ lý do từ chối>
3. <Tuần 2: nâng độ dài tối thiểu cho mật khẩu mới; áp dụng cho người dùng hiện tại vào lần đổi mật khẩu tiếp theo>
4. <Băm lại sang Argon2id vào lần đăng nhập tiếp theo; bắt buộc đặt lại mật khẩu đối với các tài khoản không hoạt động sau 6 tháng>
5. <Gỡ bỏ gợi ý mật khẩu và câu hỏi bảo mật; chuyển quy trình khôi phục sang email đã xác minh + mã khôi phục>

## Truyền thông tới người dùng
<2-3 câu: mật khẩu càng dài càng mạnh, khuyến khích dùng cụm mật khẩu (passphrase), khuyến khích dùng trình quản lý mật khẩu, không còn bắt buộc đổi mật khẩu định kỳ>

## Các câu hỏi mở
<Phạm vi bao phủ MFA, giới hạn của nhà cung cấp danh tính (IdP), các khung tuân thủ vẫn còn đề cập đến thời hạn mật khẩu (hãy kiểm tra các phiên bản hiện hành; nhiều khung tiêu chuẩn hiện đã cập nhật theo NIST)>
FILE:examples/legacy-portal-policy.json
{
  "name": "Northwind customer portal (legacy policy)",
  "single_factor": true,
  "min_length": 8,
  "max_length": 20,
  "composition": {"upper": true, "lower": true, "digit": true, "symbol": true},
  "expiry_days": 90,
  "blocklist": {"enabled": false},
  "allow_spaces": false,
  "allow_unicode": false,
  "allow_paste": false,
  "truncate_at": null,
  "hints": true,
  "security_questions": true,
  "strength_guidance": false,
  "rate_limit": {"max_failed_attempts": 3, "lockout_minutes": 60},
  "storage": {"algorithm": "PBKDF2-SHA256", "iterations": 10000, "salted": true}
}
FILE:examples/synthetic-samples.txt
# Made-up sample passwords for the review. NEVER put real passwords in this file.
Password1!
Summer2025!
Northwind#1
Qwerty123$
P@ssw0rd2026
tundra velvet orbit cactus
vT9#qLm2!xR4wZp7
glacier-mango-quietly-violin-ember
FILE:scripts/pw_policy.py
#!/usr/bin/env python3
"""Password policy and entropy checker (Python 3 standard library only).

Checks a password policy config against NIST SP 800-63B-4 (2025) password guidance and estimates
the strength of SYNTHETIC sample passwords. Never use real passwords: samples are masked in the
output unless --show-samples is given, and nothing is stored or sent anywhere.

Policy JSON (all keys optional except min_length):
  {"name": "Customer portal", "single_factor": true,        # password alone, no MFA
   "min_length": 8, "max_length": 20,
   "composition": {"upper": true, "lower": true, "digit": true, "symbol": true},
   "expiry_days": 90,
   "blocklist": {"enabled": true, "breached": true, "context_words": ["acme", "portal"]},
   "allow_spaces": true, "allow_unicode": true, "unicode_normalization": "NFC",
   "allow_paste": true, "truncate_at": null, "hints": false, "security_questions": false,
   "strength_guidance": true,
   "rate_limit": {"max_failed_attempts": 10, "lockout_minutes": 15},
   "storage": {"algorithm": "argon2id", "memory_kib": 19456, "iterations": 2, "salted": true}}
Policy findings (severity):
  HIGH   MIN_LENGTH          < 15 for single-factor passwords, < 8 with MFA (SHALL)
  HIGH   COMPOSITION_RULES   required character classes (SHALL NOT)
  HIGH   PERIODIC_EXPIRY     forced change every N days (SHALL NOT; change only on compromise)
  HIGH   NO_BLOCKLIST        no blocklist check of the full password (SHALL)
  HIGH   HINTS / SECURITY_QUESTIONS   password hints or KBA prompts (SHALL NOT)
  HIGH   TRUNCATION          only part of the password is verified (SHALL verify the whole)
  HIGH   NO_RATE_LIMIT       no throttling of failed attempts (SHALL; at most 100 in a row)
  HIGH   WEAK_STORAGE        plaintext, reversible encryption, MD5/SHA-x or unsalted hashes
  MEDIUM WEAK_KDF_PARAMS     below OWASP minimums (PBKDF2-SHA256 600000, bcrypt cost 10,
                             Argon2id 19 MiB / t=2, scrypt N=2^17)
  MEDIUM BCRYPT_72_BYTES     bcrypt ignores bytes after 72 but max length allows more
  MEDIUM MAX_LENGTH          maximum below 64 (SHOULD allow at least 64)
  MEDIUM NO_SPACES           spaces not accepted (SHOULD accept printing ASCII and space)
  MEDIUM PASTE_BLOCKED       paste / password managers blocked (SHOULD allow)
  MEDIUM NO_GUIDANCE         no strength guidance shown to users (SHALL offer guidance)
  MEDIUM BLOCKLIST_THIN      blocklist without breached passwords or context words
  LOW    NO_UNICODE          Unicode not accepted (SHOULD)
  LOW    NO_NORMALIZATION    Unicode accepted without NFC normalization (SHOULD)
  LOW    LOCKOUT_STRICT      lockout after < 5 attempts: easy denial of service, use throttling
Sample findings:
  HIGH   SAMPLE_WEAK_ACCEPTED  a blocklisted or < 36-bit sample passes the current policy
Entropy (bits): charset = length x log2(pool of character classes used); pattern = a simple
guess-model estimate that charges little for common words, leet, years, keyboard runs, repeats
and passphrase words, and log2(pool) for every other character (per word log2(7776) = 12.9 bits at most). Rating uses the pattern estimate:
< 28 very weak, < 36 weak, < 60 fair, < 80 strong, else very strong.
Usage:
  python3 pw_policy.py policy.json
  python3 pw_policy.py policy.json --samples synthetic.txt [--context northwind,portal] [--blocklist list.txt] [--json]
  python3 pw_policy.py --self-test
Exit code: 0 no HIGH findings, 1 HIGH findings, 2 bad input.
"""
import argparse
import json
import math
import re
import sys
import unicodedata

SEV_ORDER = {"HIGH": 0, "MEDIUM": 1, "LOW": 2}
COMMON = """password passw0rd welcome letmein qwerty qwertz azerty admin administrator login master
dragon monkey sunshine princess football baseball soccer hockey shadow superman batman iloveyou
trustno1 secret summer winter spring autumn fall monday friday january october december love
hello freedom whatever charlie michael jessica jordan pepper ginger cookie chocolate flower
computer internet google apple samsung starwars pokemon matrix killer hunter ranger thunder
tiger lion eagle dolphin falcon soccer liverpool chelsea arsenal barcelona madrid london paris
berlin newyork america canada company office service portal change changeme default guest user
test testing temp temporary access security system server database root toor manager support
student school teacher family mother father daddy mommy baby angel blessed jesus god heaven
money dollar euro bitcoin crypto summer2024 welcome1 password1 password123 abc123 iloveyou1
""".split()
COMMON_SET = set(COMMON)
TOP_BLOCK = set(COMMON) | {"123456", "12345678", "123456789", "1234567890", "111111", "000000",
                           "123123", "654321", "qwerty123", "1q2w3e4r", "zaq12wsx", "p@ssw0rd",
                           "password1!", "welcome123", "admin123", "letmein1", "qwertyuiop"}
LEET = str.maketrans({"@": "a", "4": "a", "0": "o", "1": "i", "!": "i", "3": "e", "$": "s",
                      "5": "s", "7": "t", "+": "t", "8": "b", "9": "g"})
ROWS = ["qwertyuiop", "asdfghjkl", "zxcvbnm", "1234567890", "abcdefghijklmnopqrstuvwxyz", "qwertzuiop", "azertyuiop"]
WORD_BITS = math.log2(7776)


class DataError(ValueError):
    pass


def char_pool(pw):
    pool = 0
    if re.search(r"[a-z]", pw):
        pool += 26
    if re.search(r"[A-Z]", pw):
        pool += 26
    if re.search(r"[0-9]", pw):
        pool += 10
    if re.search(r"[ -/:-@\[-`{-~]", pw):
        pool += 33
    if any(ord(c) > 126 for c in pw):
        pool += 100
    return pool or 1


def class_bits(c):
    if c.islower() and c.isascii():
        return math.log2(26)
    if c.isupper() and c.isascii():
        return math.log2(26)
    if c.isdigit():
        return math.log2(10)
    if ord(c) > 126:
        return math.log2(100)
    return math.log2(33)


def charset_bits(pw):
    return len(pw) * math.log2(char_pool(pw))


def seq_len(s, i):
    """Length of a keyboard/alphabet run (forward or backward) starting at i."""
    best = 1
    low = s.lower()
    for row in ROWS:
        for r in (row, row[::-1]):
            j = r.find(low[i]) if low[i] in r else -1
            if j < 0:
                continue
            n = 1
            while i + n < len(low) and j + n < len(r) and low[i + n] == r[j + n]:
                n += 1
            best = max(best, n)
    return best


def pattern_bits(pw, context=()):
    """Greedy left-to-right guess model. Returns (bits, notes)."""
    notes = []
    vocab = COMMON_SET | {w.lower() for w in context if len(w) >= 3}
    words = [w for w in re.split(r"[\s\-_.]+", pw) if w]
    if len(words) >= 3 and all(re.fullmatch(r"[A-Za-z]{3,}", w) for w in words):
        bits = sum(1.0 if w.lower() in vocab else WORD_BITS for w in words) + math.log2(4)
        notes.append(f"passphrase of {len(words)} words (upper bound if words were picked at random)")
        return min(bits, charset_bits(pw)), notes
    i, bits, low = 0, 0.0, pw.lower()
    brute = math.log2(char_pool(pw))
    while i < len(pw):
        # dictionary word (with leet), longest first
        hit = None
        for L in range(min(len(pw) - i, 14), 3, -1):
            chunk = low[i:i + L]
            plain = chunk.translate(LEET)
            if plain in vocab:
                hit = (L, plain, chunk != plain)
                break
        run = seq_len(pw, i)
        if hit and run < hit[0]:
            L, word, leet = hit
            b = math.log2(len(COMMON)) + (1 if pw[i].isupper() else 0) + (2 if leet else 0)
            notes.append(f"common word '{word}'" + (" (leet)" if leet else ""))
            bits += b
            i += L
            continue
        m = re.match(r"(19[5-9]\d|20[0-3]\d)", pw[i:])
        if m:
            notes.append(f"year {m.group(1)}")
            bits += math.log2(90)
            i += 4
            continue
        n = run
        if n >= 3:
            notes.append(f"keyboard/alphabet run '{pw[i:i + n]}'")
            bits += math.log2(26) + math.log2(n)
            i += n
            continue
        r = 1
        while i + r < len(pw) and pw[i + r] == pw[i]:
            r += 1
        if r >= 3:
            notes.append(f"repeated '{pw[i]}' x{r}")
            bits += class_bits(pw[i]) + math.log2(r)
            i += r
            continue
        bits += brute
        i += 1
    if notes and re.search(r"[0-9!?.]{1,3}$", pw) and len(pw) > 4:
        bits -= 1.5
        notes.append("digits/symbol appended at the end (most common pattern)")
    return max(bits, 0.0), notes


def rating(bits):
    return ("very weak" if bits < 28 else "weak" if bits < 36 else "fair" if bits < 60
            else "strong" if bits < 80 else "very strong")


def crack_time(bits, rate):
    sec = 2 ** (bits - 1) / rate
    for unit, n in (("years", 31557600), ("days", 86400), ("hours", 3600), ("minutes", 60)):
        if sec >= n:
            v = sec / n
            return f"{v:.3g} {unit}" if v < 100 else f"{v:,.0f} {unit}" if v < 1e6 else f"{v:.1e} {unit}"
    return "instant" if sec < 1 else f"{sec:.0f} seconds"


def mask_pw(pw):
    if len(pw) <= 4:
        return "*" * len(pw)
    return pw[:2] + "*" * (len(pw) - 3) + pw[-1:]


def policy_accepts(policy, pw):
    reasons = []
    if len(pw) < int(policy.get("min_length", 0)):
        reasons.append("too short")
    mx = policy.get("max_length")
    if mx and len(pw) > int(mx):
        reasons.append("too long")
    comp = policy.get("composition") or {}
    for key, rx in (("upper", r"[A-Z]"), ("lower", r"[a-z]"), ("digit", r"[0-9]"), ("symbol", r"[^A-Za-z0-9\s]")):
        if comp.get(key) and not re.search(rx, pw):
            reasons.append(f"needs {key}")
    if " " in pw and policy.get("allow_spaces") is False:
        reasons.append("space not allowed")
    if any(ord(c) > 126 for c in pw) and policy.get("allow_unicode") is False:
        reasons.append("unicode not allowed")
    if (policy.get("blocklist") or {}).get("enabled") and pw.lower() in TOP_BLOCK:
        reasons.append("blocklisted")
    return not reasons, reasons


def core_word(low):
    """Strip leading/trailing digits and symbols, undo leet, keep letters: 'P@ssw0rd2026!' -> 'password'."""
    core = re.sub(r"^[\d\W_]+|[\d\W_]+$", "", low)
    return re.sub(r"[^a-z]", "", core.translate(LEET))


def blocklisted(pw, extra=(), context=()):
    low = unicodedata.normalize("NFC", pw).lower()
    if low in TOP_BLOCK or low in extra:
        return "common/breached password"
    core = core_word(low)
    for w in context:
        if w and len(w) >= 3 and w.lower() in core and len(low) - len(w) <= 6:
            return f"based on context word '{w}'"
    if core in COMMON_SET and len(low) - len(core) <= 6:
        return "common word with a few digits/symbols"
    return None


def check_policy(p):
    f = []

    def add(sev, code, msg):
        f.append({"severity": sev, "code": code, "message": msg})
    if "min_length" not in p:
        raise DataError("policy needs min_length")
    single = p.get("single_factor", True)
    mn = int(p["min_length"])
    need = 15 if single else 8
    if mn < need:
        add("HIGH", "MIN_LENGTH", f"minimum {mn} characters; NIST requires >= {need} for passwords used {'alone' if single else 'with MFA'}")
    comp = [k for k, v in (p.get("composition") or {}).items() if v]
    if comp:
        add("HIGH", "COMPOSITION_RULES", f"requires {', '.join(comp)}; composition rules SHALL NOT be imposed (they produce 'Password1!' patterns); rely on length + blocklist")
    if int(p.get("expiry_days") or 0) > 0:
        add("HIGH", "PERIODIC_EXPIRY", f"forced change every {p['expiry_days']} days; SHALL NOT expire periodically, force a change only on evidence of compromise")
    bl = p.get("blocklist") or {}
    if not bl.get("enabled"):
        add("HIGH", "NO_BLOCKLIST", "no blocklist; new passwords SHALL be checked in full against common, expected and breached passwords")
    elif not bl.get("breached") or not bl.get("context_words"):
        miss = [x for x, ok in (("breached passwords", bl.get("breached")), ("context words (service name, username)", bl.get("context_words"))) if not ok]
        add("MEDIUM", "BLOCKLIST_THIN", f"blocklist lacks {' and '.join(miss)}")
    if p.get("hints"):
        add("HIGH", "HINTS", "password hints are stored; SHALL NOT be accessible to unauthenticated users - remove them")
    if p.get("security_questions"):
        add("HIGH", "SECURITY_QUESTIONS", "security questions (KBA) SHALL NOT be used; offer recovery via a verified email/phone or recovery codes")
    if p.get("truncate_at"):
        add("HIGH", "TRUNCATION", f"only the first {p['truncate_at']} characters are checked; the whole password SHALL be verified")
    rl = p.get("rate_limit") or p.get("lockout")
    if not rl:
        add("HIGH", "NO_RATE_LIMIT", "no throttling of failed attempts; SHALL limit to at most 100 consecutive failures per account")
    else:
        n = int(rl.get("max_failed_attempts") or 0)
        if n > 100:
            add("HIGH", "NO_RATE_LIMIT", f"{n} failed attempts allowed; at most 100 consecutive failures")
        elif 0 < n < 5:
            add("LOW", "LOCKOUT_STRICT", f"lockout after {n} attempts lets anyone lock users out; prefer growing delays, CAPTCHA or risk checks before a hard lock")
    st = p.get("storage") or {}
    alg = str(st.get("algorithm", "")).lower().replace("-", "").replace("_", "")
    if not alg:
        add("MEDIUM", "WEAK_STORAGE", "storage algorithm not stated; confirm a salted password hashing function (Argon2id, scrypt, bcrypt, PBKDF2)")
    elif alg in ("plaintext", "plain", "none", "aes", "encrypted", "base64", "md5", "sha1", "sha256", "sha512", "ntlm"):
        add("HIGH", "WEAK_STORAGE", f"{st.get('algorithm')} is not a password hashing function; use Argon2id (or scrypt, bcrypt, PBKDF2) with a unique salt and rehash on next login")
    else:
        if st.get("salted") is False:
            add("HIGH", "WEAK_STORAGE", "hashes are not salted; every password needs a unique random salt")
        it = int(st.get("iterations") or 0)
        if alg.startswith("pbkdf2") and it < 600000:
            add("MEDIUM", "WEAK_KDF_PARAMS", f"PBKDF2 with {it} iterations; OWASP suggests >= 600000 for PBKDF2-HMAC-SHA256")
        if alg == "bcrypt":
            if int(st.get("cost") or 0) < 10:
                add("MEDIUM", "WEAK_KDF_PARAMS", f"bcrypt cost {st.get('cost')}; use >= 10 (tune to ~250 ms)")
            if int(p.get("max_length") or 999) > 72:
                add("MEDIUM", "BCRYPT_72_BYTES", "bcrypt ignores input after 72 bytes; pre-hash (HMAC-SHA256, base64) or switch to Argon2id")
        if alg.startswith("argon2") and (int(st.get("memory_kib") or 0) < 19456 or it < 2):
            add("MEDIUM", "WEAK_KDF_PARAMS", "Argon2id below m=19456 KiB, t=2, p=1 (OWASP minimum)")
        if alg == "scrypt" and int(st.get("n") or 0) < 2 ** 17:
            add("MEDIUM", "WEAK_KDF_PARAMS", "scrypt N below 2^17 (r=8, p=1)")
    mx = p.get("max_length")
    if mx and int(mx) < 64:
        add("MEDIUM", "MAX_LENGTH", f"maximum {mx} characters blocks passphrases and generated passwords; allow at least 64")
    if p.get("allow_spaces") is False:
        add("MEDIUM", "NO_SPACES", "spaces rejected; accept all printing ASCII characters and space so passphrases work")
    if p.get("allow_paste") is False:
        add("MEDIUM", "PASTE_BLOCKED", "paste blocked; allow paste and autofill so password managers work")
    if p.get("strength_guidance") is False:
        add("MEDIUM", "NO_GUIDANCE", "no guidance when a password is rejected; SHALL help users choose (strength meter, reason for rejection)")
    if p.get("allow_unicode") is False:
        add("LOW", "NO_UNICODE", "Unicode rejected; SHOULD accept it (count each code point as one character)")
    elif p.get("allow_unicode") and str(p.get("unicode_normalization", "")).upper() != "NFC":
        add("LOW", "NO_NORMALIZATION", "Unicode accepted without NFC normalization before hashing; the same password typed on two devices may not match")
    return f


def check_samples(policy, samples, extra=(), context=()):
    rows, f = [], []
    ctx = (policy.get("blocklist") or {}).get("context_words") or []
    if isinstance(ctx, bool):
        ctx = []
    ctx = list(ctx) + list(context)
    for pw in samples:
        cb = charset_bits(pw)
        pb, notes = pattern_bits(pw, ctx)
        bl = blocklisted(pw, extra, ctx)
        ok, why = policy_accepts(policy, pw)
        single = policy.get("single_factor", True)
        nist_ok = bl is None and len(pw) >= (15 if single else 8)
        row = {"sample": pw, "length": len(pw), "charset_bits": round(cb, 1), "pattern_bits": round(pb, 1),
               "rating": "very weak" if bl else rating(pb), "blocklist": bl, "policy_accepts": ok,
               "policy_reasons": why, "nist_ok": nist_ok, "notes": notes,
               "offline_fast": crack_time(0 if bl else pb, 1e10), "offline_slow": crack_time(0 if bl else pb, 1e4)}
        rows.append(row)
        if ok and (bl or pb < 36):
            f.append({"severity": "HIGH", "code": "SAMPLE_WEAK_ACCEPTED", "sample": pw,
                      "message": f"sample {{s}} passes the current policy but is {'blocklisted (' + bl + ')' if bl else rating(pb) + f' (~{pb:.0f} bits)'}"})
    return rows, f


def render(policy, findings, rows, show):
    def s(pw):
        return pw if show else mask_pw(pw)
    out = [f"# Password policy review: {policy.get('name', 'policy')}", "",
           f"Basis: NIST SP 800-63B-4 (2025), passwords used {'as the only factor' if policy.get('single_factor', True) else 'with MFA'}",
           f"Findings: {sum(x['severity'] == 'HIGH' for x in findings)} HIGH, {sum(x['severity'] == 'MEDIUM' for x in findings)} MEDIUM, {sum(x['severity'] == 'LOW' for x in findings)} LOW", ""]
    for x in findings:
        msg = x["message"].replace("{s}", s(x["sample"])) if "sample" in x else x["message"]
        out.append(f"- {x['severity']} {x['code']}: {msg}")
    if rows:
        out += ["", "## Synthetic samples" + ("" if show else " (masked; --show-samples to print)"),
                "| Sample | Len | Charset bits | Pattern bits | Rating | Current policy | NIST verdict | Offline fast hash / slow hash |",
                "|---|---|---|---|---|---|---|---|"]
        for r in rows:
            cur = "accepts" if r["policy_accepts"] else "rejects (" + ", ".join(r["policy_reasons"]) + ")"
            nist = "ok" if r["nist_ok"] else ("reject: " + r["blocklist"] if r["blocklist"] else "reject: too short")
            out.append(f"| {s(r['sample'])} | {r['length']} | {r['charset_bits']} | {r['pattern_bits']} | {r['rating']} | {cur} | {nist} | {r['offline_fast']} / {r['offline_slow']} |")
        out += ["", "Charset bits overstate human-chosen passwords; pattern bits are the better guide. Offline times assume 1e10 guesses/s (fast hash) and 1e4 guesses/s (Argon2id/bcrypt), median case."]
    out += ["", "Samples must be made up for the review. Never paste or store real passwords."]
    return "\n".join(out)


def self_test():
    results = []

    def check(name, cond):
        results.append(cond)
        print(("PASS " if cond else "FAIL ") + name)

    def codes(**over):
        p = {"min_length": 15, "max_length": 64, "blocklist": {"enabled": True, "breached": True, "context_words": ["acme"]},
             "allow_spaces": True, "allow_unicode": True, "unicode_normalization": "NFC", "allow_paste": True,
             "strength_guidance": True, "rate_limit": {"max_failed_attempts": 10},
             "storage": {"algorithm": "argon2id", "memory_kib": 19456, "iterations": 2, "salted": True}}
        p.update(over)
        return [x["code"] for x in check_policy(p)]
    check("compliant policy has no findings", codes() == [])
    check("min 8 single factor HIGH", "MIN_LENGTH" in codes(min_length=8))
    check("min 8 with MFA ok", "MIN_LENGTH" not in codes(min_length=8, single_factor=False))
    check("min 6 with MFA HIGH", "MIN_LENGTH" in codes(min_length=6, single_factor=False))
    check("composition HIGH", "COMPOSITION_RULES" in codes(composition={"upper": True, "symbol": True}))
    check("expiry HIGH", "PERIODIC_EXPIRY" in codes(expiry_days=90))
    check("no blocklist HIGH", "NO_BLOCKLIST" in codes(blocklist={"enabled": False}))
    check("thin blocklist MEDIUM", "BLOCKLIST_THIN" in codes(blocklist={"enabled": True}))
    check("hints + KBA HIGH", {"HINTS", "SECURITY_QUESTIONS"} <= set(codes(hints=True, security_questions=True)))
    check("truncation HIGH", "TRUNCATION" in codes(truncate_at=16))
    check("no rate limit HIGH", "NO_RATE_LIMIT" in codes(rate_limit=None))
    check("lockout 3 LOW", "LOCKOUT_STRICT" in codes(rate_limit={"max_failed_attempts": 3}))
    check("sha256 HIGH", "WEAK_STORAGE" in codes(storage={"algorithm": "SHA-256", "salted": True}))
    check("unsalted HIGH", "WEAK_STORAGE" in codes(storage={"algorithm": "pbkdf2-sha256", "iterations": 600000, "salted": False}))
    check("pbkdf2 low iterations MEDIUM", "WEAK_KDF_PARAMS" in codes(storage={"algorithm": "PBKDF2-SHA256", "iterations": 10000}))
    check("bcrypt cost 8 + 72 bytes", {"WEAK_KDF_PARAMS", "BCRYPT_72_BYTES"} <= set(codes(storage={"algorithm": "bcrypt", "cost": 8}, max_length=128)))
    check("max 20 MEDIUM", "MAX_LENGTH" in codes(max_length=20))
    check("spaces/paste/guidance MEDIUM", {"NO_SPACES", "PASTE_BLOCKED", "NO_GUIDANCE"} <= set(codes(allow_spaces=False, allow_paste=False, strength_guidance=False)))
    check("no unicode LOW", "NO_UNICODE" in codes(allow_unicode=False))
    check("no NFC LOW", "NO_NORMALIZATION" in codes(unicode_normalization=None))
    check("charset bits 8 lowercase", abs(charset_bits("abcdefgh") - 8 * math.log2(26)) < 1e-9)
    check("charset pool all classes", char_pool("aA1!") == 95)
    check("leet word cheap", pattern_bits("P@ssw0rd")[0] < 15)
    check("year + word weak", pattern_bits("Summer2025!")[0] < 28)
    check("keyboard run cheap", pattern_bits("qwertyuiop")[0] < 10)
    check("repeat cheap", pattern_bits("aaaaaaaaaa")[0] < 10)
    check("random 16 strong", pattern_bits("vT9#qLm2!xR4wZp7")[0] > 80)
    check("4 random words ~ 53 bits", 50 < pattern_bits("tundra-velvet-orbit-cactus")[0] < 56)
    check("common words passphrase weak", pattern_bits("love summer football")[0] < 10)
    check("blocklisted exact", blocklisted("Password1!") is not None)
    check("context word blocked", blocklisted("Acme2026!", context=["acme"]) is not None)
    check("leet + year blocked", blocklisted("P@ssw0rd2026") is not None)
    check("context word cheap in pattern", pattern_bits("Northwind#1", ["northwind"])[0] < 28)
    check("long random not blocked", blocklisted("vT9#qLm2!xR4wZp7") is None)
    pol = {"min_length": 8, "composition": {"upper": True, "lower": True, "digit": True, "symbol": True}}
    rows, f = check_samples(pol, ["Password1!", "tundra velvet orbit cactus"])
    check("composition policy accepts Password1!", rows[0]["policy_accepts"] and f and f[0]["code"] == "SAMPLE_WEAK_ACCEPTED")
    check("composition policy rejects passphrase", not rows[1]["policy_accepts"] and rows[1]["nist_ok"])
    check("mask hides middle", mask_pw("Password1!") == "Pa*******!")
    check("crack time units", crack_time(0, 1e10) == "instant" and "years" in crack_time(80, 1e10))
    try:
        check_policy({})
        check("missing min_length rejected", False)
    except DataError:
        check("missing min_length rejected", True)
    print(f"{sum(results)}/{len(results)} passed")
    return 0 if all(results) else 1


def main():
    ap = argparse.ArgumentParser(description="Password policy and entropy checker (NIST SP 800-63B-4)")
    ap.add_argument("policy", nargs="?", help="policy JSON")
    ap.add_argument("--samples", help="file with SYNTHETIC sample passwords, one per line (# = comment)")
    ap.add_argument("--blocklist", help="extra blocklist file, one password per line")
    ap.add_argument("--context", default="", help="comma-separated context words (service name, brand, usernames)")
    ap.add_argument("--show-samples", action="store_true", help="print samples unmasked")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args()
    if a.self_test:
        return self_test()
    if not a.policy:
        ap.error("give a policy JSON or --self-test")
    try:
        with open(a.policy, encoding="utf-8") as fh:
            policy = json.load(fh)
        findings = check_policy(policy)
        rows = []
        if a.samples:
            with open(a.samples, encoding="utf-8") as fh:
                samples = [l.rstrip("\n") for l in fh if l.strip() and not l.startswith("#")]
            extra = set()
            if a.blocklist:
                with open(a.blocklist, encoding="utf-8") as fh:
                    extra = {l.strip().lower() for l in fh if l.strip()}
            rows, sf = check_samples(policy, samples, extra, [w.strip() for w in a.context.split(",") if w.strip()])
            findings += sf
    except (OSError, ValueError, DataError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    findings.sort(key=lambda x: SEV_ORDER[x["severity"]])
    if a.json:
        if not a.show_samples:
            for r in rows:
                r["sample"] = mask_pw(r["sample"])
            for x in findings:
                if "sample" in x:
                    x["sample"] = mask_pw(x["sample"])
                    x["message"] = x["message"].replace("{s}", x["sample"])
        print(json.dumps({"findings": findings, "samples": rows}, indent=2))
    else:
        print(render(policy, findings, rows, a.show_samples))
    return 1 if any(x["severity"] == "HIGH" for x in findings) else 0


if __name__ == "__main__":
sys.exit(main())Ước tính chi phí vận hành của từng thiết bị gia dụng dựa trên công suất (watt), số giờ sử dụng mỗi ngày và biểu giá điện của bạn. Đọc tệp CSV, tính toán số kWh và chi phí theo ngày, tháng và năm, điện năng tiêu thụ ở chế độ chờ (tiêu thụ ngầm), tỷ trọng của từng thiết bị và giá điện giờ thấp điểm, so sánh tổng mức ước tính với hóa đơn thực tế, đồng thời xếp hạng các ý tưởng tiết kiệm như bóng đèn LED, giặt ở nhiệt độ 30 C và cắt giảm chế độ chờ theo mức tiết kiệm hàng năm. Bao gồm công cụ ước tính viết bằng thư viện chuẩn Python có hỗ trợ cờ --self-test.
---
name: home-appliance-energy-cost-estimator
description: Ước tính chi phí vận hành của từng thiết bị gia dụng dựa trên công suất (watt), số giờ sử dụng mỗi ngày và biểu giá điện của bạn. Đọc tệp CSV, tính toán số kWh và chi phí theo ngày, tháng và năm, điện năng tiêu thụ ở chế độ chờ (tiêu thụ ngầm), tỷ trọng của từng thiết bị và giá điện giờ thấp điểm, so sánh tổng mức ước tính với hóa đơn thực tế, đồng thời xếp hạng các ý tưởng tiết kiệm như bóng đèn LED, giặt ở nhiệt độ 30 C và cắt giảm chế độ chờ theo mức tiết kiệm hàng năm. Bao gồm công cụ ước tính viết bằng thư viện chuẩn Python có hỗ trợ cờ --self-test.
---

# Công Cụ Ước Tính Chi Phí Điện Năng Thiết Bị Gia Dụng

Bạn giúp các hộ gia đình nhìn rõ tiền điện của họ đang đi về đâu theo từng thiết bị gia dụng, và những thay đổi nhỏ nào thực sự đáng để thực hiện. Bạn quy đổi số watt và thói quen sinh hoạt thành số kWh và tiền bạc, trình bày rõ các phép tính số học, đồng thời giữ cho lời khuyên luôn thiết thực: không phán xét, không gợi ý những nâng cấp đắt đỏ chẳng bao giờ hoàn vốn nổi.

## Các tệp trong kỹ năng này

- `scripts/energy_cost.py` - đọc tệp CSV danh sách thiết bị và biểu giá điện, in ra bảng chi phí, các phát hiện và danh sách ý tưởng tiết kiệm được xếp hạng (chỉ sử dụng thư viện chuẩn của Python 3)
- `references/energy-math.md` - các công thức, chu kỳ hoạt động (duty cycles), chế độ chờ (standby), nhãn năng lượng, biểu giá điện và cách đo mức tiêu thụ thực tế
- `references/typical-wattages.md` - công suất watt khi chạy và khi ở chế độ chờ cùng số giờ sử dụng hàng ngày điển hình của các thiết bị phổ biến, dùng để lấp đầy các thông tin còn thiếu
- `templates/energy-report.md` - mẫu báo cáo hộ gia đình: tổng tiêu thụ, các thiết bị ngốn điện nhất, chế độ chờ, kế hoạch hành động kèm theo mức tiết kiệm và chi phí
- `examples/apartment-appliances.csv` - căn hộ hai người ở với 15 thiết bị (tủ lạnh từ năm 2011, đèn rọi halogen, máy sấy quần áo, máy chơi game ở chế độ chờ, máy sưởi dùng theo mùa)

## Quy trình thực hiện

### 1. Xây dựng danh sách thiết bị
Hỏi danh sách các thiết bị, công suất watt của chúng (trên tem nhãn thông số, sách hướng dẫn sử dụng, hoặc ổ cắm đo điện), thời gian mỗi thiết bị chạy trong một ngày và bao nhiêu ngày một tuần, cùng với giá điện mỗi kWh (cộng với giá giờ thấp điểm và phí cố định hàng ngày nếu có) từ hóa đơn gần đây. Đối với tủ lạnh và tủ đông, hãy ưu tiên chỉ số kWh/năm trên nhãn năng lượng; đối với bất kỳ thiết bị nào có bộ điều chỉnh nhiệt (thermostat), hãy thiết lập chu kỳ hoạt động (duty cycle). Bổ sung các thông tin còn trống từ `references/typical-wattages.md` và nêu rõ những giá trị nào là giả định. Nếu người dùng có hóa đơn tiền điện, hãy hỏi số kWh hàng tháng để đối chiếu chéo.

### 2. Chạy công cụ ước tính
```
python3 scripts/energy_cost.py examples/apartment-appliances.csv --rate 0.32 --offpeak-rate 0.21 --standing-charge 0.40 --bill-kwh 330 --currency EUR
python3 scripts/energy_cost.py my-home.csv --rate 0.15 --currency USD --json
python3 scripts/energy_cost.py --self-test
```
Mã thoát (exit code) bằng 1 có nghĩa là có các phát hiện mức HIGH (chế độ chờ chiếm trên 10% tổng mức sử dụng hoặc con số ước tính lệch xa so với hóa đơn), bằng 2 có nghĩa là dữ liệu đầu vào không hợp lệ.

### 3. Rà soát cùng người dùng
Nếu xuất hiện cảnh báo BILL_GAP, trước tiên hãy sửa lại dữ liệu đầu vào (bỏ sót bình nóng lạnh hoặc hệ thống sưởi điện, sử dụng theo mùa thông qua `months_per_year`, ước tính số giờ quá dư dả). Sau đó điểm qua các thiết bị tiêu thụ điện nhiều nhất, danh sách thiết bị ở chế độ chờ và các ý tưởng tiết kiệm. Các khoản tiết kiệm có thể chồng lấn lên nhau (máy sấy dùng ít đi thì cũng tiết kiệm được ít hơn khi chuyển sang chạy giờ thấp điểm), vì vậy hãy chọn lọc ra một kế hoạch hợp lý thay vì cộng dồn mọi ý tưởng lại. Sử dụng `references/energy-math.md` để giải thích cho bất kỳ con số nào.

### 4. Bàn giao báo cáo
Điền vào mẫu `templates/energy-report.md`: tổng mức tiêu thụ, 5 thiết bị ngốn điện nhất, mức tiêu thụ chế độ chờ, và kế hoạch hành động được phân loại thành các thói quen miễn phí, các giải pháp chi phí thấp (bóng đèn LED, ổ cắm thông minh) và các khoản mua sắm lớn hơn kèm theo số năm hoàn vốn (giá mua / mức tiết kiệm hàng năm).

## Kết quả ví dụ
Đối với tệp `examples/apartment-appliances.csv` ở mức giá EUR 0.32/kWh (giờ thấp điểm 0.21, phí cố định 0.40/ngày): 12.3 kWh/ngày, 373 kWh/tháng, 4479 kWh/năm, tiền điện năng EUR 118.38/tháng hoặc EUR 1420.54/năm (EUR 1566.54 nếu tính cả phí cố định). Sáu bóng đèn rọi halogen là thiết bị tiêu thụ lớn nhất (548 kWh, 12%), tiếp theo là máy sưởi sử dụng trong 5 tháng (479 kWh). Chế độ chờ tiêu tốn 319 kWh (7%), với các phát hiện mức MEDIUM cho TV (12 W) và máy chơi game (15 W). Nằm trong phạm vi chênh lệch 13% so với hóa đơn 330 kWh, do đó không có cảnh báo BILL_GAP. Các ý tưởng hàng đầu: thay đèn rọi LED tiết kiệm khoảng EUR 149/năm, phơi khô tự nhiên một nửa số mẻ giặt tiết kiệm EUR 63, giặt ở nhiệt độ 30 C tiết kiệm EUR 48, giặt đồ vào giờ thấp điểm, cắt giảm chế độ chờ của máy chơi game tiết kiệm EUR 40.

## Quy tắc

- Trình bày công thức tính một lần và nêu rõ các giả định cho mọi giá trị ước đoán.
- Sử dụng biểu giá và đơn vị tiền tệ của người dùng; tuyệt đối không tự mặc định mức giá của một quốc gia mà không nói rõ.
- Con số ước tính không phải là kết quả đo đạc thực tế: hãy đề xuất dùng ổ cắm đo điện cho 3 thiết bị ngốn điện nhất khi các con số đóng vai trò quan trọng.
- Xếp hạng các hành động theo số tiền tiết kiệm được trên mỗi công sức bỏ ra; đưa ra thời gian hoàn vốn tính bằng năm cho bất kỳ giải pháp nào tốn tiền mua sắm.
- An toàn là trên hết: tuyệt đối không bao giờ gợi ý tắt tính năng làm mát của tủ lạnh hoặc tủ đông, thiết bị báo khói, thiết bị y tế hoặc chế độ chống đóng băng để tiết kiệm điện.
FILE:references/energy-math.md
# Toán Học Năng Lượng

## Các công thức cốt lõi
```
kWh per day (running) = watts x quantity x hours per day x duty% / 1000 x days per week / 7 x months per year / 12
kWh per day (standby) = standby watts x quantity x (24 - average hours running) / 1000
kWh per year = kWh per day x 365        kWh per month = kWh per year / 12
cost = kWh x price per kWh (+ standing charge per day x 365, listed separately)
```
Ví dụ: một ấm đun nước 2000 W sử dụng 15 phút mỗi ngày = 2000 x 0.25 / 1000 = 0.5 kWh/ngày = 183 kWh/năm; ở mức giá 0.32 mỗi kWh = 58.40 một năm.

## Số Watt so với các con số khác trên nhãn thiết bị
- W (watt) là thông số bạn cần. kW x 1000 = W.
- VA trên bộ sạc và bộ lưu điện (UPS) là công suất biểu kiến; số watt thực tế thường chỉ bằng 60-90% con số đó.
- mAh hoặc Wh trên pin là dung lượng lưu trữ, không phải công suất tiêu thụ điện.
- Số watt trên nhãn thông số (nameplate watts) là mức tối đa. Máy sưởi, lò nướng, ấm đun nước chạy gần mức tối đa này; TV, máy tính và máy chơi game thường chỉ tiêu thụ khoảng 40-80% con số đó. Một chiếc ổ cắm đo điện sẽ cho biết con số chính xác chỉ sau một ngày.

## Chu kỳ hoạt động (Duty cycle)
Bất kỳ thiết bị nào có bộ điều chỉnh nhiệt (thermostat) hoặc máy nén đều tự động bật và tắt luân phiên. Tỷ lệ thời gian thiết bị thực sự chạy được gọi là chu kỳ hoạt động (duty cycle).
| Thiết bị | Chu kỳ hoạt động điển hình |
|---|---|
| Tủ lạnh, tủ lạnh kèm tủ đông | 30-50% (cao hơn nếu đặt trong căn bếp ấm hoặc gioăng cao su bị hở) |
| Tủ đông nằm ngang | 35-50% |
| Máy sưởi dầu hoặc máy sưởi tấm có bộ điều nhiệt | 50-80% trong thời tiết lạnh |
| Lò nướng khi đã đạt nhiệt độ (sau khi làm nóng trước) | 50-60% |
| Máy giặt (đun nóng nước ở giai đoạn đầu) | 50-70% công suất nhãn trong suốt một chu trình giặt |
| Máy rửa bát | 50-60% công suất nhãn trong suốt một chu trình rửa |
Tốt hơn hết: hãy sử dụng chỉ số kWh/năm trên nhãn năng lượng (nhãn EU, nhãn EnergyGuide của Mỹ), vì con số này đã tính sẵn chu kỳ bật tắt.

## Chế độ chờ (Standby)
Các thiết bị đã "tắt" nhưng vẫn tiêu thụ điện: chế độ khởi động nhanh (instant-on) của TV và máy chơi game (5-15 W), đầu thu truyền hình set-top box (10-20 W), máy in, lò vi sóng có đồng hồ hiển thị (2-3 W), củ sạc cắm sẵn ở ổ điện (0.1-0.5 W). Các thiết bị bật liên tục như bộ định tuyến Wi-Fi được tính là tải đang hoạt động (running load) chứ không phải chế độ chờ, vì vậy hãy liệt kê chúng với thời gian chạy 24 giờ. Mức tiêu thụ chờ 10 W liên tục suốt ngày đêm = 88 kWh/năm. Sử dụng ổ cắm kéo dài có công tắc, ổ cắm thông minh hẹn giờ hoặc tắt tính năng "khởi động nhanh" sẽ loại bỏ được phần lớn lượng điện tiêu thụ này.

## Biểu giá điện (Tariffs)
- Giá đồng nhất (Flat rate): một mức giá duy nhất cho mỗi kWh.
- Giá theo khung giờ (Time of use): giờ thấp điểm có giá rẻ hơn (thường là ban đêm). Đặt `offpeak_pct` bằng tỷ lệ phần trăm đã được sử dụng vào giờ thấp điểm; tập lệnh sẽ tính giá trị tiết kiệm khi chuyển phần còn lại của các phụ tải có thể dịch chuyển giờ chạy (máy giặt, máy rửa bát, máy sấy, bộ sạc xe điện EV, bình nóng lạnh, máy bơm hồ bơi) theo mức chênh lệch (giá tiêu chuẩn - giá thấp điểm) trên mỗi kWh.
- Giá bậc thang (Tiered/block rates): giá điện tăng dần theo mức sử dụng hàng tháng. Hãy sử dụng mức giá cận biên (bậc cao nhất đang dùng) để tính giá trị tiết kiệm.
- Phí cố định (Standing charge - phí thuê bao hàng ngày): vẫn phải trả ngay cả khi mức sử dụng bằng không, vì vậy các biện pháp tiết kiệm điện không bao giờ làm giảm được khoản phí này.
- Thuế và phụ phí: hãy sử dụng mức giá trọn gói trên mỗi kWh từ hóa đơn (tổng chi phí điện năng / tổng số kWh).

## Đối chiếu với hóa đơn tiền điện
So sánh số kWh ước tính hàng tháng với số kWh trên hóa đơn (chứ không so sánh bằng số tiền). Sai số trong phạm vi 25% là mức tốt đối với phương pháp ước tính dựa trên thói quen sử dụng. Các nguyên nhân phổ biến khiến con số ước tính quá thấp: bình đun nước nóng bằng điện (thường chiếm 15-25% lượng điện của một ngôi nhà), hệ thống sưởi hoặc làm mát bằng điện, xe điện (EV), chiếc tủ lạnh thứ hai bị bỏ quên, máy bơm hồ bơi hoặc bể cá. Quá cao: ước tính số giờ sử dụng quá hào phóng, các thiết bị dùng theo mùa lại được tính cho cả năm (hãy dùng `months_per_year`), lấy công suất tối đa trên nhãn để tính cho các thiết bị điện tử.

## Đo đạc thực tế
- Ổ cắm đo điện năng (rẻ tiền): đo số kWh trong vòng một tuần; sau đó nhân với 52.
- Ứng dụng công tơ thông minh hoặc cổng thông tin của công ty điện lực: dữ liệu theo từng giờ sẽ cho thấy phụ tải nền vào ban đêm (mọi thiết bị luôn bật); phụ tải nền x 8760 giờ / 1000 = số kWh/năm không bao giờ tắt.
- Đọc chỉ số công tơ điện trước và sau một lần chạy thiết bị đã biết (ví dụ: bật lò nướng trong một giờ) khi mọi thiết bị khác giữ nguyên trạng thái ổn định.

## Thời gian hoàn vốn (Payback)
số năm hoàn vốn = giá mua / mức tiết kiệm hàng năm. Bóng đèn LED: chỉ vài tháng. Ổ cắm thông minh cho chế độ chờ: 1-2 năm. Máy sấy bơm nhiệt (heat-pump dryer) hoặc tủ lạnh mới: thường mất 5-10 năm, vì vậy chỉ nên đề xuất khi thiết bị cũ đằng nào cũng đã đến lúc cần thay thế.
FILE:references/typical-wattages.md
# Công Suất Watt Và Mức Sử Dụng Điển Hình

Các giá trị khởi đầu để dùng khi người dùng không rõ thông số. Hãy luôn gắn nhãn chúng là các giả định; các mẫu máy thực tế có thể chênh lệch rất nhiều.

| Thiết bị | Công suất chạy (W) | Mức sử dụng điển hình | Chế độ chờ (W) | Ghi chú |
|---|---|---|---|---|
| Tủ lạnh kèm tủ đông | 100-200 | 24 giờ ở mức chu kỳ 30-50% | - | Nhãn năng lượng: 150-350 kWh/năm (loại A-E mới thấp hơn) |
| Tủ đông nằm ngang | 60-120 | 24 giờ ở mức chu kỳ 35-50% | - | Nhãn năng lượng: 150-250 kWh/năm |
| Máy giặt | 1800-2400 | 1-2 giờ mỗi mẻ, 3-5 mẻ/tuần | 0.5-2 | 0.5-1.0 kWh cho mỗi chu trình giặt 40 C |
| Máy sấy quần áo (thông hơi/ngưng tụ) | 2000-3000 | 1-1.5 giờ mỗi mẻ | 0.5-1 | Máy sấy bơm nhiệt chỉ tiêu thụ khoảng một nửa |
| Máy rửa bát | 1200-2000 | 1-2 giờ mỗi chu trình | 0.5-1 | 0.8-1.4 kWh mỗi chu trình; chế độ eco chạy lâu hơn nhưng tốn ít điện hơn |
| Lò nướng điện | 2000-3500 | 0.5-1 giờ | 2-4 (đồng hồ) | Làm nóng trước ở công suất tối đa, sau đó bật tắt theo chu kỳ |
| Bếp từ hoặc bếp hồng ngoại (mỗi vùng nấu) | 1200-2500 | 0.5-1 giờ | 0-2 | |
| Lò vi sóng | 800-1200 | 5-15 phút | 2-4 | |
| Nồi chiên không dầu | 1200-1800 | 15-30 phút | 0 | Tiết kiệm hơn lò nướng khi nấu khẩu phần nhỏ |
| Ấm đun nước siêu tốc | 2000-3000 | Tổng cộng 10-20 phút | 0 | |
| Máy pha cà phê | 1000-1500 | 10-20 phút | 1-3 | Đế giữ ấm sẽ làm tốn thêm khá nhiều điện |
| Bóng đèn sợi đốt / halogen | 40-60 | 3-6 giờ | 0 | Đèn LED tương đương chỉ tốn 5-9 W |
| Bóng đèn LED | 5-12 | 3-6 giờ | 0-0.5 (bóng thông minh) | |
| TV LED 43-65 inch | 60-150 | 3-5 giờ | 0.5-15 | Chế độ khởi động nhanh làm tăng điện năng chờ |
| Máy chơi game (Game console) | 100-220 | 1-3 giờ | 1-15 | Chế độ nghỉ/khởi động tức thì tốn khoảng 10-15 W |
| Máy tính để bàn (PC) + màn hình | 100-400 | 4-8 giờ | 2-5 | PC chơi game khi chạy nặng tốn 300-600 W |
| Máy tính xách tay (Laptop) | 30-70 | 4-8 giờ | 0.5 | |
| Bộ định tuyến Wi-Fi + modem | 8-20 | 24 giờ | - | Luôn bật: liệt kê vào mục phụ tải đang chạy |
| Đầu thu truyền hình / thiết bị phát trực tuyến | 10-20 | 4 giờ | 5-15 | |
| Máy sưởi phòng (quạt sưởi / sưởi dầu) | 1000-2000 | 2-6 giờ vào mùa đông, chu kỳ 50-80% | 0 | Sử dụng tham số months_per_year |
| Điều hòa di động | 800-1500 | 4-8 giờ vào mùa hè | 1-2 | |
| Máy hút ẩm | 200-500 | 6-12 giờ | 1 | |
| Bình nước nóng dùng điện (loại có bình chứa) | 2000-3000 | 2-4 giờ | - | Thường là thiết bị ngốn điện tiềm ẩn lớn nhất |
| Vòi sen nước nóng trực tiếp bằng điện | 7000-10000 | 10-20 phút | 0 | |
| Bộ sạc xe điện EV (tại nhà, 7 kW) | 7000-7400 | tính theo số km di chuyển: ~0.15-0.2 kWh/km | 2-5 | Dùng công thức kWh/năm = số km/năm x 0.17 |
| Máy bơm hồ bơi | 750-1500 | 6-10 giờ trong mùa sử dụng | 0 | Máy bơm biến tần thay đổi tốc độ giúp tiết kiệm khoảng một nửa |
| Bể cá (sưởi + lọc + đèn) | 50-200 | 24 giờ ở mức chu kỳ 30-60% | - | |

Nguồn tham khảo cho các khoảng giá trị: bảng thông số kỹ thuật và nhãn năng lượng của nhà sản xuất, kết hợp với các công cụ tính toán thiết bị gia dụng phổ biến của cơ quan năng lượng quốc gia. Hãy kiểm tra mẫu máy cụ thể của người dùng khi một giá trị có ảnh hưởng trực tiếp đến việc ra quyết định.
FILE:templates/energy-report.md
# Báo cáo điện năng hộ gia đình: <tên hộ gia đình hoặc địa chỉ>

**Biểu giá:** <EUR 0.32/kWh, giờ thấp điểm 0.21 (23:00-07:00), phí cố định 0.40/ngày>   **Đối chiếu hóa đơn:** <ước tính 373 kWh/tháng so với hóa đơn 330 (-13%)>
**Tóm tắt:** <một câu: ví dụ "Chiếu sáng và giặt giũ chiếm 40% hóa đơn; thay đèn rọi LED và giặt ở nhiệt độ 30 C giúp tiết kiệm khoảng EUR 200 một năm với chi phí đầu tư EUR 40.">

## Tiền điện đi về đâu
| Thiết bị | kWh/năm | Chi phí/năm | Tỷ trọng | Giả định |
|---|---|---|---|---|
| <Đèn rọi Halogen x6> | <548> | <175.20> | <12%> | <50 W, 5 giờ/ngày> |
| <...> | | | | |

Tổng cộng: <4479 kWh/năm, EUR 1420.54 tiền điện + EUR 146 phí cố định>

## Chế độ chờ (luôn phải trả tiền nhưng không mang lại lợi ích gì)
<319 kWh/năm, khoảng EUR 102. Lớn nhất: máy chơi game 15 W, TV 12 W.>

## Kế hoạch hành động
### Thói quen miễn phí
| Hành động | Tiết kiệm/năm |
|---|---|
| <Giặt ở nhiệt độ 30 C, giặt đủ tải> | <EUR 48> |
| <Chạy máy giặt và máy rửa bát vào giờ thấp điểm> | <EUR 70-110> |

### Giải pháp chi phí thấp
| Hành động | Chi phí | Tiết kiệm/năm | Thời gian hoàn vốn |
|---|---|---|---|
| <6 bóng đèn rọi LED> | <EUR 30> | <EUR 149> | <2-3 tháng> |
| <Ổ cắm thông minh cho TV + máy chơi game> | <EUR 15> | <EUR 68> | <3 tháng> |

### Khoản mua sắm lớn hơn (chỉ thực hiện khi đằng nào cũng cần thay mới)
| Hành động | Chi phí | Tiết kiệm/năm | Thời gian hoàn vốn |
|---|---|---|---|
| <Máy sấy bơm nhiệt> | <EUR 600> | <EUR 63> | <~10 năm> |

## Các bước tiếp theo
- <Đo máy sưởi phòng và tủ lạnh bằng ổ cắm đo điện trong vòng một tuần>
- <Chạy lại công cụ ước tính sau khi thay bóng đèn LED và so sánh hai kỳ hóa đơn tiếp theo>

Các con số là ước tính dựa trên công suất định mức và mức sử dụng điển hình; các khoản tiết kiệm có sự giao thoa và không cộng dồn trực tiếp.
FILE:examples/apartment-appliances.csv
appliance,watts,hours_per_day,days_per_week,quantity,duty_cycle_pct,standby_watts,kwh_per_year,offpeak_pct,months_per_year
Fridge-freezer (2011),,,7,1,,,320,,
Chest freezer,90,24,7,1,45,,,,
Washing machine,2000,1.5,4,1,60,1.5,,,
Tumble dryer,2500,1,3,1,,0.5,,,
Dishwasher,1800,1.5,5,1,55,1,,30,
Electric oven,2400,1,4,1,60,3,,,
Kettle,2200,0.25,7,1,,,,,
Microwave,1100,0.2,7,1,,3,,,
Halogen spotlight,50,5,7,6,,,,,
LED bulb,9,5,7,8,,,,,
TV (55 inch),110,4,7,1,,12,,,
Game console,160,1.5,5,1,,15,,,
Desktop computer,180,6,5,1,,4,,,
Wi-Fi router,10,24,7,1,,,,,
Space heater (bedroom),1500,3,7,1,70,,,,5
FILE:scripts/energy_cost.py
#!/usr/bin/env python3
"""Home appliance energy cost estimator (Python 3 standard library only).

Reads a CSV of appliances and works out daily, monthly and yearly kWh and cost, standby
("vampire") loads, each appliance's share, and savings ideas with estimated yearly savings.

CSV columns (header required; comma or semicolon; only the first three are required):
  appliance        name, e.g. "Fridge-freezer" (keywords drive the savings ideas)
  watts            power while running (nameplate or plug-in meter), per unit
  hours_per_day    hours running on a day it is used
  days_per_week    days used per week (default 7)
  quantity         number of identical units (default 1), e.g. 8 bulbs
  duty_cycle_pct   share of running time the motor/heater is really on (default 100;
                   fridges ~35-50, thermostatic heaters ~50-70)
  standby_watts    power when off but plugged in, per unit (default 0)
  kwh_per_year     energy-label figure per unit; replaces watts x hours when given
  offpeak_pct      share of running energy already used in off-peak hours (default 0)
  months_per_year  months in use, for seasonal loads like heaters or air conditioning (default 12)
Formulas:
  running kWh/day  = watts x quantity x hours x duty% / 1000 x days_per_week / 7 x months / 12
                     (or kwh_per_year x quantity / 365), averaged over the whole year
  standby kWh/day  = standby_watts x quantity x (24 - hours x days_per_week / 7) / 1000
  month = year / 12, year = day x 365; cost = kWh x rate (off-peak share x --offpeak-rate);
  standby is charged at the standard rate; the standing charge is listed separately.
Findings (severity):
  HIGH   STANDBY_SHARE    standby is >= 10% of all estimated kWh
  HIGH   BILL_GAP         estimate differs from --bill-kwh (monthly) by more than 25%
  MEDIUM BIG_CONSUMER     one appliance uses >= 25% of all kWh
  MEDIUM STANDBY_DEVICE   a unit draws >= 5 W on standby
  LOW    CHECK_DUTY_CYCLE fridge/freezer/heater running 24 h at 100% duty (likely overestimated)
  LOW    HIGH_WATTS       > 3500 W for an appliance that is not a known heavy load
Usage:
  python3 energy_cost.py appliances.csv --rate 0.32 --currency EUR
  python3 energy_cost.py appliances.csv --rate 0.32 --offpeak-rate 0.21 --standing-charge 0.40 --bill-kwh 260 --json
  python3 energy_cost.py --self-test
Exit code: 0 no HIGH findings, 1 HIGH findings, 2 bad input.
"""
import argparse
import csv
import io
import json
import sys

SEV_ORDER = {"HIGH": 0, "MEDIUM": 1, "LOW": 2}
HEAVY = ("heater", "oven", "stove", "hob", "cooktop", "dryer", "kettle", " ev ", "charger", "boiler",
         "water heater", "sauna", "heat pump", "air conditioner", " ac ", "furnace", "pool")
SHIFTABLE = ("wash", "dishwasher", "dryer", " ev ", "ev charger", "pool", "water heater", "boiler")
# keyword -> (idea, share of that appliance's running cost saved)
IDEAS = [
    (("bulb", "lamp", "light"), "replace with LED (about 85% less power for the same light)", 0.85, "watts>=25"),
    (("dryer",), "line-dry half the loads or switch to a heat-pump dryer (about 50%)", 0.5, None),
    (("water heater", "boiler"), "set to 55-60 C with a timer and insulate the tank (about 10%)", 0.10, None),
    (("space heater", "heater", "radiator"), "heat only the room in use and lower the thermostat 1 C (about 10%); a heat pump uses 2-4x less", 0.10, None),
    (("fridge", "freezer"), "set 4 C / -18 C, clean coils, check door seals (about 10%); a 15-year-old unit may use twice a new A-class one", 0.10, None),
    (("dishwasher",), "use the eco program and skip pre-rinsing with hot water (about 20%)", 0.20, None),
    (("washing machine", "washer"), "wash at 30 C instead of 40-60 C and run full loads (about 40%)", 0.40, None),
    (("kettle",), "boil only the water you need (about 25%)", 0.25, None),
    (("oven",), "use a microwave or air fryer for small meals (about 30%)", 0.30, None),
    (("pool",), "run the pump fewer hours or fit a variable-speed pump (about 50%)", 0.50, None),
    (("air conditioner", " ac ", "aircon"), "set 1-2 C warmer and clean filters (about 10%)", 0.10, None),
    (("dehumidifier",), "use a humidistat at 50-55% instead of running continuously (about 30%)", 0.30, None),
    (("desktop", "gaming pc", "computer"), "enable sleep after 15 minutes idle (about 20%)", 0.20, None),
]


class DataError(ValueError):
    pass


def num(row, key, default, line):
    v = (row.get(key) or "").strip().replace(",", ".") if isinstance(row.get(key), str) else row.get(key)
    if v in (None, ""):
        if default is None:
            raise DataError(f"line {line}: '{key}' is required")
        return float(default)
    try:
        x = float(v)
    except ValueError:
        raise DataError(f"line {line}: '{key}' must be a number, got '{v}'")
    if x < 0:
        raise DataError(f"line {line}: '{key}' cannot be negative")
    return x


def read_csv(text):
    first = text.splitlines()[0] if text.strip() else ""
    delim = ";" if first.count(";") > first.count(",") else ","
    rd = csv.DictReader(io.StringIO(text), delimiter=delim)
    if not rd.fieldnames or not {"appliance", "watts", "hours_per_day"} <= {f.strip().lower() for f in rd.fieldnames}:
        if not rd.fieldnames or "kwh_per_year" not in [f.strip().lower() for f in rd.fieldnames]:
            raise DataError("CSV needs columns appliance, watts, hours_per_day (or kwh_per_year)")
    items = []
    for line, raw in enumerate(rd, 2):
        row = {(k or "").strip().lower(): v for k, v in raw.items()}
        name = (row.get("appliance") or "").strip()
        if not name:
            continue
        label = (row.get("kwh_per_year") or "").strip()
        it = {"appliance": name,
              "watts": num(row, "watts", 0 if label else None, line),
              "hours": num(row, "hours_per_day", 24 if label else None, line),
              "days": num(row, "days_per_week", 7, line),
              "qty": num(row, "quantity", 1, line),
              "duty": num(row, "duty_cycle_pct", 100, line),
              "standby_w": num(row, "standby_watts", 0, line),
              "label_kwh": num(row, "kwh_per_year", 0, line) if label else None,
              "offpeak": num(row, "offpeak_pct", 0, line) / 100,
              "months": num(row, "months_per_year", 12, line)}
        if it["hours"] > 24:
            raise DataError(f"line {line}: hours_per_day {it['hours']:g} > 24")
        if it["days"] > 7 or it["duty"] > 100 or it["offpeak"] > 1 or it["months"] > 12:
            raise DataError(f"line {line}: days_per_week <= 7, months_per_year <= 12, duty_cycle_pct and offpeak_pct <= 100")
        items.append(it)
    if not items:
        raise DataError("no appliances in the CSV")
    return items


def has(name, words):
    low = " " + name.lower() + " "
    return any(w in low for w in words)


def estimate(items, rate, offpeak_rate=None, standing=0.0, bill_kwh=None):
    off = rate if offpeak_rate is None else offpeak_rate
    rows, findings, ideas = [], [], []

    def add(sev, code, msg):
        findings.append({"severity": sev, "code": code, "message": msg})
    for it in items:
        avg_hours = it["hours"] * it["days"] / 7
        if it["label_kwh"] is not None:
            run_day = it["label_kwh"] * it["qty"] / 365
        else:
            run_day = it["watts"] * it["qty"] * avg_hours * it["duty"] / 100 / 1000 * it["months"] / 12
        sb_day = it["standby_w"] * it["qty"] * (24 - avg_hours) / 1000
        run_cost_y = run_day * 365 * ((1 - it["offpeak"]) * rate + it["offpeak"] * off)
        sb_cost_y = sb_day * 365 * rate
        rows.append({"appliance": it["appliance"], "qty": it["qty"], "kwh_day": run_day + sb_day,
                     "kwh_month": (run_day + sb_day) * 365 / 12, "kwh_year": (run_day + sb_day) * 365,
                     "standby_kwh_year": sb_day * 365, "cost_month": (run_cost_y + sb_cost_y) / 12,
                     "cost_year": run_cost_y + sb_cost_y, "standby_cost_year": sb_cost_y,
                     "run_kwh_year": run_day * 365, "run_cost_year": run_cost_y})
        name = it["appliance"]
        if it["standby_w"] >= 5:
            add("MEDIUM", "STANDBY_DEVICE", f"{name}: {it['standby_w']:g} W standby per unit = {sb_day * 365:.0f} kWh/year; a switched power strip or unplugging saves {sb_cost_y:.2f}/year")
        if has(name, ("fridge", "freezer", "heater")) and it["label_kwh"] is None and it["hours"] >= 24 and it["duty"] >= 100:
            add("LOW", "CHECK_DUTY_CYCLE", f"{name}: 24 h at 100% duty; compressors and thermostats cycle, so set duty_cycle_pct (fridge ~40) or use the energy-label kWh/year")
        if it["watts"] > 3500 and not has(name, HEAVY):
            add("LOW", "HIGH_WATTS", f"{name}: {it['watts']:g} W is unusually high; check the nameplate (W, not mAh or VA)")
        for words, text, share, cond in IDEAS:
            if has(name, words) and (cond is None or it["watts"] >= 25):
                ideas.append({"appliance": name, "idea": text, "saving_year": run_cost_y * share,
                              "kwh_year": run_day * 365 * share})
                break
        if sb_cost_y > 0 and it["standby_w"] >= 1:
            ideas.append({"appliance": name, "idea": "cut standby with a switched strip or smart plug", "saving_year": sb_cost_y,
                          "kwh_year": sb_day * 365})
        if offpeak_rate is not None and offpeak_rate < rate and has(name, SHIFTABLE) and it["offpeak"] < 1:
            kwh = run_day * 365 * (1 - it["offpeak"])
            ideas.append({"appliance": name, "idea": "run in off-peak hours (timer or delay start)",
                          "saving_year": kwh * (rate - offpeak_rate), "kwh_year": 0.0})
    tot_kwh = sum(r["kwh_year"] for r in rows)
    tot_sb = sum(r["standby_kwh_year"] for r in rows)
    for r in rows:
        r["share"] = r["kwh_year"] / tot_kwh if tot_kwh else 0
        if r["share"] >= 0.25:
            add("MEDIUM", "BIG_CONSUMER", f"{r['appliance']} is {r['share']:.0%} of the estimated use ({r['kwh_year']:.0f} kWh/year); check it first")
    if tot_kwh and tot_sb / tot_kwh >= 0.10:
        add("HIGH", "STANDBY_SHARE", f"standby is {tot_sb / tot_kwh:.0%} of all use ({tot_sb:.0f} kWh/year, {tot_sb * rate:.2f}/year) - the cheapest saving to get")
    if bill_kwh:
        est_m = tot_kwh / 12
        gap = (bill_kwh - est_m) / bill_kwh
        if abs(gap) > 0.25:
            add("HIGH", "BILL_GAP", f"estimate {est_m:.0f} kWh/month vs bill {bill_kwh:g} kWh/month ({gap:+.0%}); "
                + ("missing appliances (water heating, electric heating, EV?) or hours too low" if gap > 0 else "hours or watts are too high, or some appliances are not used every day"))
    rows.sort(key=lambda r: -r["kwh_year"])
    ideas.sort(key=lambda x: -x["saving_year"])
    findings.sort(key=lambda f: SEV_ORDER[f["severity"]])
    totals = {"kwh_day": tot_kwh / 365, "kwh_month": tot_kwh / 12, "kwh_year": tot_kwh,
              "standby_kwh_year": tot_sb, "energy_cost_year": sum(r["cost_year"] for r in rows),
              "standing_charge_year": standing * 365}
    totals["energy_cost_month"] = totals["energy_cost_year"] / 12
    totals["total_cost_year"] = totals["energy_cost_year"] + totals["standing_charge_year"]
    totals["total_cost_month"] = totals["total_cost_year"] / 12
    totals["savings_year"] = sum(i["saving_year"] for i in ideas)
    return rows, totals, findings, ideas


def render(rows, totals, findings, ideas, rate, cur, offpeak_rate, standing, top):
    c = (cur + " ") if cur else ""
    out = ["# Home appliance energy cost estimate", "",
           f"Tariff: {c}{rate:g}/kWh" + (f", off-peak {c}{offpeak_rate:g}/kWh" if offpeak_rate is not None else "")
           + (f", standing charge {c}{standing:g}/day" if standing else ""), "",
           f"Total: {totals['kwh_day']:.1f} kWh/day, {totals['kwh_month']:.0f} kWh/month, {totals['kwh_year']:,.0f} kWh/year; "
           f"energy {c}{totals['energy_cost_month']:,.2f}/month, {c}{totals['energy_cost_year']:,.2f}/year"
           + (f"; with standing charge {c}{totals['total_cost_year']:,.2f}/year" if standing else ""),
           f"Standby: {totals['standby_kwh_year']:.0f} kWh/year ({totals['standby_kwh_year'] / totals['kwh_year']:.0%})" if totals["kwh_year"] else "", "",
           "| Appliance | Qty | kWh/day | kWh/month | kWh/year | Standby kWh/yr | Cost/month | Cost/year | Share |",
           "|---|---|---|---|---|---|---|---|---|"]
    for r in rows:
        out.append(f"| {r['appliance']} | {r['qty']:g} | {r['kwh_day']:.2f} | {r['kwh_month']:.1f} | {r['kwh_year']:.0f} | "
                   f"{r['standby_kwh_year']:.0f} | {r['cost_month']:.2f} | {r['cost_year']:.2f} | {r['share']:.0%} |")
    out += ["", "## Findings"] + ([f"- {f['severity']} {f['code']}: {f['message']}" for f in findings] or ["- none"])
    out += ["", f"## Savings ideas (top {min(top, len(ideas))}, estimated)"]
    for i in ideas[:top]:
        out.append(f"- {i['appliance']}: {i['idea']} -> about {c}{i['saving_year']:.2f}/year" + (f", {i['kwh_year']:.0f} kWh" if i["kwh_year"] else ""))
    if len(ideas) > top:
        out.append(f"- ... {len(ideas) - top} more with --top {len(ideas)}")
    out += ["", "Estimates from rated watts and typical use; a plug-in energy meter or the smart meter gives real numbers. Savings overlap, so do not add them all up."]
    return "\n".join(out)


def self_test():
    results = []

    def check(name, cond):
        results.append(cond)
        print(("PASS " if cond else "FAIL ") + name)

    def run(csv_text, **kw):
        return estimate(read_csv(csv_text), kw.pop("rate", 0.30), **kw)
    rows, t, f, i = run("appliance,watts,hours_per_day\nKettle,2000,0.5\n")
    check("1 kWh/day kettle", abs(rows[0]["kwh_day"] - 1.0) < 1e-9)
    check("365 kWh/year", abs(t["kwh_year"] - 365) < 1e-9)
    check("cost per year at 0.30", abs(t["energy_cost_year"] - 109.5) < 1e-6)
    check("month = year/12", abs(t["kwh_month"] - 365 / 12) < 1e-9)
    rows, t, f, i = run("appliance,watts,hours_per_day,days_per_week,quantity\nWashing machine,1000,2,3.5,1\nLED bulb,9,5,7,6\n")
    w = [r for r in rows if r["appliance"] == "Washing machine"][0]
    check("days_per_week scales", abs(w["kwh_day"] - 1.0) < 1e-9)
    b = [r for r in rows if r["appliance"] == "LED bulb"][0]
    check("quantity scales", abs(b["kwh_day"] - 0.27) < 1e-9)
    check("LED idea skipped under 25 W", not any("LED" in x["idea"] for x in i))
    rows, t, f, i = run("appliance,watts,hours_per_day,duty_cycle_pct\nFridge,150,24,40\n")
    check("duty cycle", abs(rows[0]["kwh_day"] - 1.44) < 1e-9)
    rows, t, f, i = run("appliance,watts,hours_per_day,standby_watts\nTV,100,4,10\n")
    check("standby hours = 24 - use", abs(rows[0]["standby_kwh_year"] - 10 * 20 / 1000 * 365) < 1e-9)
    codes = [x["code"] for x in f]
    check("STANDBY_DEVICE", "STANDBY_DEVICE" in codes)
    check("STANDBY_SHARE HIGH", "STANDBY_SHARE" in codes)
    rows, t, f, i = run("appliance,watts,hours_per_day,kwh_per_year,quantity\nFreezer,,,250,2\n")
    check("energy label kWh used", abs(t["kwh_year"] - 500) < 1e-9)
    rows, t, f, i = run("appliance,watts,hours_per_day,offpeak_pct\nDishwasher,1200,1,50\n", offpeak_rate=0.15)
    check("off-peak share priced", abs(rows[0]["cost_year"] - 1.2 * 365 * (0.5 * 0.30 + 0.5 * 0.15)) < 1e-6)
    check("shift idea for rest", any("off-peak" in x["idea"] for x in i))
    rows, t, f, i = run("appliance,watts,hours_per_day,months_per_year\nSpace heater,1000,4,6\n")
    check("months_per_year seasonal", abs(t["kwh_year"] - 4 * 365 / 2) < 1e-9)
    rows, t, f, i = run("appliance,watts,hours_per_day,days_per_week\nDishwasher,1000,1,7\n")
    check("dishwasher gets eco idea, not washer idea", "eco" in i[0]["idea"])
    rows, t, f, i = run("appliance,watts,hours_per_day\nHeater,2000,6\nTV,80,3\n")
    check("BIG_CONSUMER", any(x["code"] == "BIG_CONSUMER" for x in f))
    rows, t, f, i = run("appliance,watts,hours_per_day\nKettle,2000,0.5\n", bill_kwh=60)
    check("BILL_GAP HIGH", any(x["code"] == "BILL_GAP" for x in f))
    rows, t, f, i = run("appliance,watts,hours_per_day\nKettle,2000,0.5\n", bill_kwh=32)
    check("no BILL_GAP within 25%", not any(x["code"] == "BILL_GAP" for x in f))
    rows, t, f, i = run("appliance,watts,hours_per_day\nFridge,150,24\n")
    check("CHECK_DUTY_CYCLE LOW", any(x["code"] == "CHECK_DUTY_CYCLE" for x in f))
    rows, t, f, i = run("appliance,watts,hours_per_day\nAquarium pump,5000,1\n")
    check("HIGH_WATTS LOW", any(x["code"] == "HIGH_WATTS" for x in f))
    rows, t, f, i = run("appliance,watts,hours_per_day,standby_watts\nTelevision,90,4,0.5\nWater heater,2000,3,0\n", offpeak_rate=0.15)
    check("keywords: TV not shiftable, water heater gets tank idea", not any(x["appliance"] == "Television" and "off-peak" in x["idea"] for x in i)
          and any(x["appliance"] == "Water heater" and "tank" in x["idea"] for x in i))
    rows, t, f, i = run("appliance;watts;hours_per_day\nHalogen lamp;60,0;4\n")
    check("semicolon + decimal comma", abs(rows[0]["kwh_day"] - 0.24) < 1e-9 and any("LED" in x["idea"] for x in i))
    rows, t, f, i = run("appliance,watts,hours_per_day\nTumble dryer,2500,1\n", standing=0.5)
    check("standing charge separate", abs(t["standing_charge_year"] - 182.5) < 1e-9 and abs(t["total_cost_year"] - t["energy_cost_year"] - 182.5) < 1e-9)
    check("dryer idea 50%", abs(i[0]["saving_year"] - 2.5 * 365 * 0.30 * 0.5) < 1e-6)
    for bad, name in (("appliance,watts,hours_per_day\nX,100,25\n", "hours > 24 rejected"),
                      ("appliance,watts,hours_per_day\nX,abc,2\n", "non-number rejected"),
                      ("name,power\nX,100\n", "missing columns rejected"),
                      ("appliance,watts,hours_per_day\nX,-5,2\n", "negative rejected")):
        try:
            read_csv(bad)
            check(name, False)
        except DataError:
            check(name, True)
    print(f"{sum(results)}/{len(results)} passed")
    return 0 if all(results) else 1


def main():
    ap = argparse.ArgumentParser(description="Home appliance energy cost estimator")
    ap.add_argument("csv", nargs="?", help="appliances CSV")
    ap.add_argument("--rate", type=float, help="price per kWh (standard rate)")
    ap.add_argument("--offpeak-rate", type=float, help="price per kWh in off-peak hours")
    ap.add_argument("--standing-charge", type=float, default=0.0, help="fixed charge per day")
    ap.add_argument("--currency", default="", help="label, e.g. EUR, USD, TRY")
    ap.add_argument("--bill-kwh", type=float, help="actual monthly kWh from a bill, to compare")
    ap.add_argument("--top", type=int, default=8, help="savings ideas to show (default 8)")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args()
    if a.self_test:
        return self_test()
    if not a.csv or a.rate is None:
        ap.error("give a CSV and --rate, or --self-test")
    try:
        with open(a.csv, encoding="utf-8-sig") as fh:
            items = read_csv(fh.read())
        rows, totals, findings, ideas = estimate(items, a.rate, a.offpeak_rate, a.standing_charge, a.bill_kwh)
    except (OSError, DataError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    if a.json:
        print(json.dumps({"appliances": rows, "totals": totals, "findings": findings, "ideas": ideas}, indent=2))
    else:
        print(render(rows, totals, findings, ideas, a.rate, a.currency, a.offpeak_rate, a.standing_charge, a.top))
    return 1 if any(f["severity"] == "HIGH" for f in findings) else 0


if __name__ == "__main__":
sys.exit(main())Các quy ước mang tính định hướng rõ ràng để xây dựng và vận hành các dịch vụ FastAPI trên môi trường production bằng Python.
# Dịch Vụ FastAPI taste của một kỹ sư API Python
- Định nghĩa phần thân của yêu cầu (request) và phản hồi (response) bằng các mô hình Pydantic v2 và luôn thiết lập response_model để không vô tình làm rò rỉ dữ liệu ngoài ý muốn. Độ tin cậy: 0.95
- Tách riêng các lược đồ (schemas) cho các thao tác tạo mới (create), cập nhật (update) và đọc (read) thay vì tái sử dụng mô hình ORM làm cấu trúc dữ liệu trả về của API. Độ tin cậy: 0.90
- Chỉ sử dụng các endpoint khai báo với async def khi mọi lệnh gọi bên trong đều thực sự là bất đồng bộ (async); nếu không, hãy viết bằng def thông thường và để threadpool tự xử lý. Độ tin cậy: 0.85
- Tiêm (inject) các phiên kết nối cơ sở dữ liệu (database sessions), cài đặt cấu hình và người dùng hiện tại thông qua Depends, tuyệt đối không dùng các biến toàn cục ở cấp độ module. Độ tin cậy: 0.90
- Tải cấu hình bằng pydantic-settings từ các biến môi trường và cho dừng ứng dụng báo lỗi ngay lúc khởi động (fail fast) nếu thiếu bất kỳ thông tin cấu hình nào. Độ tin cậy: 0.90
- Chia nhỏ các tuyến đường (routes) thành các module APIRouter theo từng miền nghiệp vụ (domain) và giữ cho tệp main.py chỉ giới hạn ở việc khởi tạo ứng dụng và kết nối các thành phần lại với nhau. Độ tin cậy: 0.85
- Đặt logic nghiệp vụ vào trong các hàm dịch vụ (service functions) hoàn toàn tách biệt và không biết gì về giao thức HTTP, để có thể tái sử dụng chúng từ các tiến trình chạy ngầm (workers) và trong kiểm thử (tests). Độ tin cậy: 0.85
- Sử dụng cú pháp SQLAlchemy 2.0 với các phiên bất đồng bộ (async sessions) và quản lý lược đồ cơ sở dữ liệu bằng các bản di chuyển (migrations) của Alembic. Độ tin cậy: 0.80
- Sử dụng trình quản lý ngữ cảnh lifespan cho quá trình khởi động (startup) và tắt ứng dụng (shutdown) thay vì các hook on_event đã lỗi thời. Độ tin cậy: 0.85
- Chỉ phát sinh ngoại lệ HTTPException ở tầng giao tiếp ngoài cùng và ánh xạ các lỗi nghiệp vụ (domain errors) sang mã trạng thái HTTP bằng các trình xử lý ngoại lệ (exception handlers) đã đăng ký. Độ tin cậy: 0.80
- Trả về cấu trúc lỗi nhất quán gồm mã lỗi máy có thể đọc được (machine-readable code), thông báo lỗi và thông tin chi tiết tùy chọn. Độ tin cậy: 0.85
- Đánh phiên bản cho API ngay trên đường dẫn (/v1) và coi lược đồ OpenAPI được tạo ra như một bản hợp đồng giao tiếp được kiểm tra tự động trong quy trình CI. Độ tin cậy: 0.75
- Sử dụng phân trang dựa trên con trỏ (cursor-based pagination) cho các danh sách lớn và giới hạn kích thước trang tối đa ở phía máy chủ. Độ tin cậy: 0.80
- Kiểm thử bằng pytest và httpx.AsyncClient, ghi đè các phụ thuộc (overriding dependencies) thay vì dùng kỹ thuật monkey-patch vào các thành phần nội bộ. Độ tin cậy: 0.90
- Chạy các tiến trình con (workers) của uvicorn phía sau gunicorn hoặc một trình quản lý tiến trình trên môi trường production, và chỉ dùng cờ --reload trong môi trường phát triển (development). Độ tin cậy: 0.80
- Chuyển các tác vụ xử lý chậm sang một hàng đợi tác vụ (task queue) thực thụ như Celery, Arq hoặc Dramatiq; BackgroundTasks chỉ dành cho các công việc nhỏ chạy một lần rồi thôi (fire-and-forget). Độ tin cậy: 0.85
- Thêm ID yêu cầu (request IDs), nhật ký định dạng JSON có cấu trúc và middleware truy vết OpenTelemetry ngay từ ngày đầu tiên. Độ tin cậy: 0.80
- Bảo vệ các endpoint bằng OAuth2 bearer token hoặc khóa API thông qua các phụ thuộc bảo mật (security dependencies) để trang tài liệu tự động hiển thị cơ chế xác thực. Độ tin cậy: 0.80
- Cung cấp riêng biệt hai endpoint /healthz và /readyz, trong đó bước kiểm tra mức độ sẵn sàng (readiness) sẽ kiểm tra kết nối cơ sở dữ liệu và các phụ thuộc cứng khác. Độ tin cậy: 0.85
- Quản lý các thư viện phụ thuộc bằng uv kèm theo tệp khóa (lock file), đồng thời kiểm tra lỗi cú pháp (lint) và định dạng mã nguồn bằng Ruff. Độ tin cậy: 0.75
- Kiểm tra kiểu dữ liệu (type check) bằng mypy hoặc pyright ở chế độ nghiêm ngặt (strict mode) trên gói dịch vụ. Độ tin cậy: 0.70
Các quy ước mang tính định hướng rõ ràng để xây dựng các ứng dụng tích hợp LLM, hệ thống RAG và tác nhân (agents) đáng tin cậy.
# Ứng Dụng LLM taste của một kỹ sư sản phẩm AI
- Coi các prompt như mã nguồn (code): lưu trữ chúng trong các tệp được quản lý phiên bản kèm theo tên, phiên bản và người phụ trách, chứ không để dưới dạng các chuỗi ký tự viết trực tiếp (inline strings) nằm rải rác khắp nơi. Độ tin cậy: 0.90
- Xây dựng một bộ dữ liệu đánh giá (evaluation set) từ đầu vào thực tế của người dùng trước khi tinh chỉnh prompt, và chạy lại bộ đánh giá đó mỗi khi thay đổi prompt hoặc mô hình. Độ tin cậy: 0.95
- Yêu cầu đầu ra có cấu trúc bằng lược đồ JSON (JSON schema) hoặc lệnh gọi công cụ (tool calls) và xác thực nó bằng thư viện kiểm tra lược đồ trước khi đưa vào sử dụng. Độ tin cậy: 0.95
- Đặt một lớp cổng kết nối (gateway) hoặc lớp bọc (wrapper) mỏng bao quanh các nhà cung cấp mô hình để việc chuyển đổi mô hình hoặc thêm phương án dự phòng (fallbacks) chỉ đơn giản là một thay đổi trong cấu hình. Độ tin cậy: 0.85
- Ghim cố định các phiên bản mô hình chính xác trên môi trường production và chỉ nâng cấp chúng một cách có chủ đích sau khi vượt qua các bài kiểm tra đánh giá (evals). Độ tin cậy: 0.90
- Truyền phát trực tiếp (stream) phản hồi tới người dùng bất cứ khi nào đầu ra dài hơn một hoặc hai câu. Độ tin cậy: 0.85
- Bắt đầu khâu truy xuất thông tin bằng tìm kiếm kết hợp (hybrid search) đơn giản (từ khóa kết hợp với vector nhúng - embeddings) và thêm bước xếp hạng lại (reranking) trước khi tìm đến các quy trình RAG phức tạp. Độ tin cậy: 0.80
- Chia nhỏ tài liệu (chunk) theo cấu trúc tự nhiên của chúng (tiêu đề, các phần) và giữ lại siêu dữ liệu (metadata) về nguồn gốc để câu trả lời có thể trích dẫn lại. Độ tin cậy: 0.85
- Giữ cho ngữ cảnh (context) nhỏ gọn và có tính liên quan cao; việc truy xuất thêm nhiều văn bản thường làm cho câu trả lời tệ đi chứ không phải tốt hơn. Độ tin cậy: 0.80
- Cung cấp cho các tác nhân (agents) một danh sách ngắn gồm các công cụ chuyên biệt, được mô tả rõ ràng với lược đồ đầu vào nghiêm ngặt thay vì một công cụ ôm đồm làm mọi thứ. Độ tin cậy: 0.85
- Đặt các giới hạn cứng cho các vòng lặp của tác nhân: số bước tối đa, số lượng token tối đa và thời gian chờ tối đa theo đồng hồ thực tế (wall-clock timeout). Độ tin cậy: 0.90
- Yêu cầu xác nhận từ con người trước bất kỳ lệnh gọi công cụ nào thực hiện việc gửi đi, xóa bỏ, thanh toán hoặc thay đổi dữ liệu bên ngoài ứng dụng. Độ tin cậy: 0.90
- Coi tất cả các tài liệu được truy xuất, các trang web và kết quả trả về từ công cụ là đầu vào không đáng tin cậy có thể chứa mã độc tiêm nhiễm prompt (prompt injection). Độ tin cậy: 0.90
- Ghi nhật ký (log) mọi lệnh gọi mô hình kèm theo phiên bản prompt, tên mô hình, độ trễ, số lượng token và chi phí, đồng thời ẩn đi dữ liệu nhạy cảm của người dùng. Độ tin cậy: 0.85
- Lưu vào bộ nhớ đệm (cache) các lệnh gọi có tính xác định (deterministic) và sử dụng tính năng lưu đệm prompt (prompt caching) cho các prompt hệ thống dài và ít thay đổi. Độ tin cậy: 0.75
- Sử dụng mô hình nhỏ nhất vượt qua được các bài đánh giá (evals), và chỉ điều hướng những trường hợp khó sang mô hình đắt tiền. Độ tin cậy: 0.80
- Thử lại (retry) khi gặp giới hạn tần suất (rate limits) và lỗi tạm thời bằng thuật toán lùi lũy thừa có nhiễu ngẫu nhiên (exponential backoff and jitter), tuyệt đối không thử lại trong một vòng lặp khép kín khi gặp lỗi xác thực dữ liệu (validation failures). Độ tin cậy: 0.85
- Giữ tham số nhiệt độ (temperature) ở mức thấp đối với tác vụ trích xuất và phân loại, và chỉ đặt cao hơn đối với việc tạo nội dung sáng tạo. Độ tin cậy: 0.75
- Cho người dùng biết câu trả lời đến từ nguồn nào và giúp họ dễ dàng báo cáo một phản hồi chưa tốt. Độ tin cậy: 0.80
- Thu thập phản hồi thích (thumbs-up) và không thích (thumbs-down), sau đó đưa các trường hợp kết quả kém quay trở lại bộ dữ liệu đánh giá (eval set). Độ tin cậy: 0.85
- Đừng tinh chỉnh mô hình (fine-tune) cho đến khi kỹ thuật viết prompt, truy xuất thông tin và đánh giá đã thực sự chạm tới giới hạn của chúng. Độ tin cậy: 0.70
Các quy ước mang tính định hướng rõ ràng để phát hành các thay đổi một cách an toàn bằng feature flag và triển khai tăng dần theo giai đoạn.
# Triển Khai Feature Flag taste của một kỹ sư phát hành (release engineer)
- Tách biệt việc triển khai (deploy) khỏi việc phát hành (release): đẩy mã nguồn ở trạng thái ẩn phía sau một cờ (flag) và bật nó lên một cách độc lập với quá trình triển khai. Độ tin cậy: 0.95
- Sử dụng dịch vụ quản lý cờ chuyên dụng hoặc SDK tương thích với OpenFeature thay vì tự viết các câu lệnh if thủ công dựa trên biến môi trường. Độ tin cậy: 0.80
- Gán cho mỗi cờ một người phụ trách (owner), phần mô tả, phân loại (release, experiment, ops hoặc permission) và ngày dự kiến gỡ bỏ. Độ tin cậy: 0.90
- Đặt tên các cờ theo hành vi mà chúng kiểm soát, chẳng hạn như checkout-new-payment-form, chứ không đặt theo mã ticket hay tên người. Độ tin cậy: 0.85
- Mặc định mọi cờ về hành vi hiện tại, an toàn khi không thể kết nối tới dịch vụ quản lý cờ. Độ tin cậy: 0.95
- Đánh giá giá trị của các cờ một lần duy nhất cho mỗi yêu cầu (request) ngay tại điểm đầu của luồng thực thi mã nguồn và truyền kết quả xuống dưới, không đánh giá sâu bên trong các vòng lặp. Độ tin cậy: 0.80
- Triển khai tăng dần từng bước: người dùng nội bộ trước, sau đó đến 1%, 10%, 50% và 100%, đồng thời theo dõi các chỉ số đo lường ở từng bước. Độ tin cậy: 0.90
- Sử dụng cơ chế phân nhóm cố định dựa trên hàm băm (sticky, hash-based bucketing) theo ID người dùng hoặc ID tài khoản ổn định để người dùng không bị nhảy qua lại giữa các biến thể khác nhau. Độ tin cậy: 0.90
- Xác định rõ các chỉ số đánh giá thành công và chỉ số bảo vệ (guardrail metrics) trước khi bắt đầu triển khai, chứ không phải sau khi nhìn vào bảng điều khiển (dashboard). Độ tin cậy: 0.85
- Kết nối cơ chế tự động hoàn tác (rollback) với các cảnh báo về tỷ lệ lỗi và độ trễ đối với những thay đổi tiềm ẩn nhiều rủi ro. Độ tin cậy: 0.75
- Giữ một công tắc ngắt khẩn cấp (kill switch) cho mọi phụ thuộc bên ngoài hoặc tác vụ tốn kém tài nguyên để bộ phận vận hành có thể tắt ngay mà không cần triển khai lại mã nguồn. Độ tin cậy: 0.90
- Gỡ bỏ các cờ phát hành (release flags) trong vòng vài tuần sau khi đạt mức 100% và cho phép quy trình CI báo lỗi thất bại khi một cờ đã quá hạn ngày gỡ bỏ. Độ tin cậy: 0.80
- Kiểm thử cả hai luồng bật (on) và tắt (off) trong CI đối với mọi cờ đang hoạt động. Độ tin cậy: 0.85
- Tránh lồng các cờ bên trong những cờ khác; nếu hai cờ có tương tác với nhau, hãy gộp chúng lại hoặc viết tài liệu ghi rõ các tổ hợp kết hợp. Độ tin cậy: 0.80
- Ghi nhật ký (log) kết quả đánh giá cờ kèm theo biến thể (variant) vào trong các dấu vết (traces) để khi xảy ra sự cố có thể truy vết về một đợt triển khai cụ thể. Độ tin cậy: 0.80
- Giới hạn quyền của những người có thể thay đổi các cờ trên môi trường production và lưu nhật ký kiểm toán (audit log) cho mọi thay đổi kèm theo lý do. Độ tin cậy: 0.85
- Tuyệt đối không sử dụng feature flag để thay thế cho các bước kiểm tra phân quyền (authorization checks). Độ tin cậy: 0.90
- Thông báo các đợt triển khai lớn trong một kênh chung kèm theo tên cờ, kế hoạch triển khai và các bước hoàn tác (rollback). Độ tin cậy: 0.70
- Giữ các cờ phân quyền (permission) và cờ vận hành (ops) tồn tại lâu dài trong một danh sách riêng biệt để chúng không bị nhầm lẫn với các cờ phát hành đã cũ. Độ tin cậy: 0.75
- Thực hiện một buổi đánh giá ngắn sau mỗi đợt triển khai lớn và ghi nhận lại những chỉ số nào đã thực sự phát hiện ra vấn đề. Độ tin cậy: 0.65
Hướng dẫn người mới bắt đầu lần tìm cây gia phả từ những gì họ đã biết: bảng đối chiếu sự thật và giai thoại, bảng thuật ngữ phả hệ, kế hoạch phỏng vấn họ hàng, các nguồn tư liệu tại nhà, kế hoạch tra cứu hồ sơ theo từng thế hệ, kiểm chứng truyền thuyết gia đình, đánh giá mức độ tin cậy của bằng chứng, cách trích dẫn và nhật ký nghiên cứu, quyền riêng tư, kiến thức cơ bản về xét nghiệm DNA, kế hoạch sáu tuần và các chiến thuật vượt qua bế tắc.
Hãy đóng vai một Người Hướng Dẫn Nghiên Cứu Lịch Sử Gia Đình. Bạn giúp những người mới bắt đầu lần tìm cây gia phả của họ một cách cẩn trọng và thú vị, bắt đầu từ những gì họ đã biết và lần ngược lại từng thế hệ một. Bạn kiên nhẫn, ham tìm hiểu và nghiêm ngặt: bạn tách biệt các dữ kiện đã được chứng minh bằng hồ sơ khỏi những câu chuyện truyền miệng trong gia đình và sự suy đoán, bạn giải thích mọi thuật ngữ phả hệ ngay lần đầu tiên sử dụng, và bạn luôn chỉ cho tôi thấy một bằng chứng sẽ đến từ đâu và có độ tin cậy như thế nào. Bạn tuyệt đối không tự bịa ra tổ tiên, ngày tháng, địa danh hay nội dung hồ sơ; khi có điều gì chưa rõ, bạn nói thẳng là chưa biết và gợi ý cách để tìm ra nó.

Điểm xuất phát của tôi:
- Những gì tôi đã biết: my parents' and grandparents' names, birth years, and towns; my great-grandmother's first name only
- Câu chuyện gia đình tôi muốn kiểm chứng: my great-grandfather supposedly emigrated by ship around 1910 and changed his surname
- Các quốc gia và khu vực liên quan: not sure yet, possibly two countries
- Tài liệu và hình ảnh hiện có ở nhà: a few old photos with handwriting on the back, a family Bible, one marriage certificate
- Những người họ hàng còn sống mà tôi có thể hỏi: an aunt in her 80s and two older cousins
- Ngôn ngữ tôi có thể đọc được: English only
- Thời gian và ngân sách: about 3 hours a week, prefer free sources, could pay for one month of a records site
- Mục tiêu: a well-sourced tree back to my great-great-grandparents and the true story of the emigration

Trước tiên, hãy hỏi tôi trong một tin nhắn ngắn gọn về bất kỳ điều quan trọng nào còn thiếu: nên bắt đầu với nhánh gia đình nào trước (làm từng nhánh một sẽ hiệu quả nhất), liệu vấn đề quyền riêng tư có quan trọng đối với những người họ hàng còn sống hay không, liệu tôi có quan tâm đến xét nghiệm DNA hay không, và bất kỳ tên riêng nào được viết theo nhiều cách khác nhau trong gia đình.

Sau đó hãy hướng dẫn tôi qua các phần sau:

1. **Những Gì Chúng Ta Biết Hiện Nay**: một bảng liệt kê mọi người mà tôi đã đề cập kèm theo tên, mối quan hệ với tôi, các dữ kiện đã biết, nguồn gốc của từng dữ kiện (tài liệu, trí nhớ, câu chuyện gia đình), và mức độ tin cậy (đã chứng minh, có khả năng đúng, câu chuyện gia đình, chưa rõ). Chỉ ra những khoảng trống và điểm mâu thuẫn.

2. **Các Thuật Ngữ Phả Hệ Bạn Sẽ Gặp**: một bảng thuật ngữ ngắn gọn kèm giải nghĩa dễ hiểu: nguồn sơ cấp (primary source), nguồn thứ cấp (secondary source), hồ sơ gốc (original record), hồ sơ phái sinh (derivative record - mục lục hoặc bản chép lại), hồ sơ hộ tịch (vital records), điều tra dân số (census), sổ bộ giáo xứ (parish register), nhập tịch (naturalization), danh sách hành khách (passenger list), tên thời con gái (maiden name), điểm bế tắc (brick wall), trích dẫn nguồn (citation), và tiêu chuẩn chứng minh (proof standard).

3. **Kế Hoạch Phỏng Vấn Họ Hàng Còn Sống**: 15 câu hỏi mở được nhóm theo chủ đề (tên tuổi và địa danh, nhà cửa và nghề nghiệp, di cư, tôn giáo và cộng đồng, hình ảnh và kỷ vật), mẹo ghi âm khi được phép, cách hỏi han khéo léo về các chủ đề nhạy cảm, và cách ghi chép lại ai đã nói gì vào lúc nào. Hãy nhắc tôi nhớ rằng ký ức chỉ là manh mối chứ không phải bằng chứng xác thực.

4. **Danh Sách Kiểm Tra Nguồn Tư Liệu Tại Nhà**: những gì cần tìm kiếm trong các bức ảnh, thư từ, cuốn Kinh Thánh của gia đình, giấy chứng nhận, giấy tờ quân đội và cáo phó, cách đọc chữ viết tay ở mặt sau bức ảnh, cũng như cách quét (scan) và đặt nhãn cho mọi thứ bằng quy tắc đặt tên tệp nhất quán.

5. **Kế Hoạch Nghiên Cứu, Từng Thế Hệ Một**: đối với nhánh gia đình mà chúng ta chọn, hãy lập kế hoạch từng bước từ thế hệ của tôi trở về trước: câu hỏi cần trả lời cho mỗi thế hệ, các loại hồ sơ có khả năng trả lời cao nhất tại những khu vực liên quan, nơi thường lưu giữ những hồ sơ đó (cơ quan lưu trữ, nhà thờ, cơ quan đăng ký hộ tịch, cơ sở dữ liệu miễn phí và trả phí), cũng như những từ khóa tìm kiếm và các biến thể chính tả nên thử. Hãy nói rõ khi một loại hồ sơ có thể không tồn tại trong một giai đoạn hoặc địa điểm nhất định.

6. **Kiểm Chứng Câu Chuyện Gia Đình**: cách kiểm tra câu chuyện di cư và đổi họ: danh sách hành khách và hồ sơ nhập cảnh, giấy tờ nhập tịch, các mục điều tra dân số trước và sau đó, cùng lầm tưởng phổ biến rằng tên họ bị thay đổi ngay tại cảng nhập cảnh. Liệt kê những bằng chứng nào sẽ xác nhận câu chuyện, bằng chứng nào sẽ bác bỏ nó, và điều gì sẽ khiến câu chuyện vẫn còn bỏ ngỏ.

7. **Đánh Giá Bằng Chứng**: một phương pháp đơn giản để cân nhắc giá trị của từng hồ sơ (ai đã tạo ra nó, khi nào, tại sao, và liệu người cung cấp thông tin có mặt trực tiếp tại đó hay không), cách giải quyết các điểm mâu thuẫn chẳng hạn như năm sinh khác nhau, và khi nào hai người có cùng tên thực chất chỉ là một người. Bao gồm một ví dụ minh họa sử dụng chính thông tin chi tiết của tôi ở nơi có thể, được đánh dấu là giả định nếu tôi chưa cung cấp hồ sơ thực tế.

8. **Trích Dẫn Nguồn Và Nhật Ký Nghiên Cứu**: một mẫu trích dẫn mà tôi có thể tái sử dụng cho bất kỳ hồ sơ nào, và một mẫu nhật ký nghiên cứu gồm ngày tháng, câu hỏi, nguồn đã tra cứu, từ khóa tìm kiếm, kết quả (bao gồm cả "không tìm thấy gì"), và bước tiếp theo. Giải thích lý do tại sao việc ghi chép lại các lần tìm kiếm không có kết quả lại giúp tiết kiệm thời gian.

9. **Tổ Chức Cây Gia Phả**: cách ghi tên (họ thời con gái đối với phụ nữ, cách viết chính tả gốc), ngày tháng (ngày tháng năm), và địa danh (theo tên gọi vào thời điểm đó, kèm theo tên gọi hiện đại), cách đánh dấu các mối liên kết chưa được chứng minh, và cách giữ kín thông tin riêng tư của những người còn sống khỏi bất kỳ cây gia phả công khai nào.

10. **Kiến Thức Cơ Bản Về Xét Nghiệm DNA (tùy chọn)**: những gì xét nghiệm nhiễm sắc thể thường (autosomal), Y-DNA và DNA ty thể (mitochondrial) có thể và không thể cho thấy, các lưu ý về quyền riêng tư và sự đồng thuận cho tôi cũng như họ hàng của tôi, và cách DNA có thể hỗ trợ (chứ không thay thế) hồ sơ giấy tờ. Đề cập rằng kết quả xét nghiệm có thể tiết lộ những sự thật bất ngờ về gia đình.

11. **Kế Hoạch Sáu Tuần**: một bảng gồm tuần, trọng tâm, nhiệm vụ, nguồn tư liệu và tiêu chí thế nào là "hoàn thành", được điều chỉnh phù hợp với thời gian hàng tuần và ngân sách của tôi, bao gồm cả thời điểm nên sử dụng gói đăng ký trả phí một tháng để đạt được giá trị cao nhất.

12. **Bộ Công Cụ Phá Vỡ Bế Tắc (Brick Wall Toolkit)**: tám chiến thuật khi tôi gặp bế tắc: tìm kiếm thông tin về anh chị em ruột và hàng xóm, tìm kiếm các biến thể chính tả bằng ký tự đại diện (wildcard), kiểm tra bản gốc thay vì chỉ xem mục lục, tra cứu các giáo xứ lân cận, hồ sơ đất đai và thuế, báo chí cũ, các hội lịch sử địa phương, và nhờ cơ quan lưu trữ hoặc tình nguyện viên giúp đỡ.

Quy tắc: tuyệt đối không trình bày một suy đoán như một sự thật hiển nhiên; gắn nhãn cho mọi nhận định là đã chứng minh (proven), có khả năng đúng (likely), hoặc chưa được xác minh (unverified); ưu tiên hồ sơ gốc hơn các bản mục lục và cây gia phả trực tuyến sao chép từ người khác; tôn trọng quyền riêng tư của những người còn sống và sự nhạy cảm xoay quanh việc nhận con nuôi, con ngoài giá thú cũng như những lịch sử đau buồn; sử dụng ngôn ngữ giản dị, đoạn văn ngắn và bảng biểu ở những nơi hữu ích. Kết thúc bằng một việc làm duy nhất hữu ích nhất mà tôi nên thực hiện trong tuần này.

