@f
Các quy ước mang tính định hướng rõ rệt khi sử dụng Redis làm bộ nhớ đệm (cache): khóa (keys), thời gian sống (TTLs), cơ chế vô hiệu hóa (invalidation) và vận hành.
# Gu thiết kế Bộ nhớ đệm Redis (Redis Caching) của một kỹ sư backend
- Mặc định sử dụng mô hình cache-aside: đọc từ Redis, truy xuất lại từ nguồn dữ liệu gốc (source of truth) khi không tìm thấy trong cache (cache miss), sau đó nạp dữ liệu vào cache. Độ tin cậy: 0.90
- Coi bộ nhớ đệm là dữ liệu có thể loại bỏ bất cứ lúc nào; hệ thống vẫn phải hoạt động chính xác (chỉ chậm hơn) nếu toàn bộ dữ liệu Redis bị xóa sạch (flushed). Độ tin cậy: 0.95
- Thiết lập thời gian hết hạn (TTL) trên mọi khóa cache; một khóa không có thời hạn sử dụng chính là mầm mống gây rò rỉ bộ nhớ (memory leak). Độ tin cậy: 0.90
- Thêm độ lệch ngẫu nhiên (random jitter) vào các giá trị TTL để các khóa được ghi cùng lúc không bị hết hạn đồng loạt. Độ tin cậy: 0.85
- Đặt không gian tên (namespace) cho khóa theo định dạng service:entity:id:version (ví dụ: catalog:product:42:v3) và tăng số phiên bản khi có thay đổi định dạng gây phá vỡ tương thích. Độ tin cậy: 0.85
- Vô hiệu hóa cache bằng cách xóa khóa sau khi ghi dữ liệu thành công, thay vì cập nhật trực tiếp giá trị đang lưu trong cache. Độ tin cậy: 0.80
- Bảo vệ các khóa có tần suất truy cập cao (hot keys) khỏi hiện tượng quá tải đột ngột (cache stampede) bằng khóa ngắn hạn (SET key value NX PX) hoặc gộp nhóm yêu cầu (request coalescing). Độ tin cậy: 0.80
- Lưu vào cache cả các kết quả rỗng (không tìm thấy) với TTL ngắn để giảm tải các truy vấn lặp lại cho những ID không tồn tại. Độ tin cậy: 0.70
- Lưu trữ các giá trị đã tuần tự hóa (serialized) nhỏ gọn (dùng JSON để dễ gỡ lỗi, dùng MessagePack khi kích thước là yếu tố quan trọng) và giữ kích thước giá trị dưới khoảng 100 KB. Độ tin cậy: 0.75
- Sử dụng kiểu dữ liệu hash cho các đối tượng có từng trường (fields) được đọc riêng lẻ, và dùng chuỗi đơn thuần (plain strings) cho các giá trị được đọc nguyên khối. Độ tin cậy: 0.70
- Không bao giờ chạy lệnh KEYS trên môi trường thực tế (production); hãy sử dụng lệnh SCAN với con trỏ (cursor). Độ tin cậy: 0.95
- Tránh tạo các khóa quá lớn (big keys) và các tập hợp khổng lồ; hãy tách nhỏ bất kỳ dữ liệu nào có thể khiến một lệnh đơn lẻ bị chặn (block) tới vài mili-giây. Độ tin cậy: 0.85
- Sử dụng kỹ thuật pipelining hoặc lệnh MGET để đọc theo lô (batch reads) thay vì gửi từng yêu cầu mạng riêng biệt cho mỗi khóa. Độ tin cậy: 0.85
- Đưa các logic nguyên tử (atomic) gồm nhiều bước vào một kịch bản Lua (Lua script) hoặc một hàm, chứ không thực hiện kiểm tra rồi mới gán giá trị (check-then-set) ở phía client. Độ tin cậy: 0.80
- Thiết lập maxmemory kèm theo chính sách trục xuất dữ liệu (eviction policy) rõ ràng (allkeys-lru cho bộ nhớ đệm thuần túy, noeviction cho dữ liệu tuyệt đối không được mất). Độ tin cậy: 0.90
- Tách biệt bộ nhớ đệm và dữ liệu bền vững (hàng đợi, giới hạn tốc độ, phiên đăng nhập) vào các phiên bản (instances) Redis riêng với các chính sách riêng. Độ tin cậy: 0.80
- Sử dụng Redis Streams hoặc một hệ thống message broker thực thụ cho các tác vụ nền (jobs); kiểu danh sách (lists) đơn thuần sẽ làm mất tác vụ khi tiến trình xử lý (consumer) bị sập. Độ tin cậy: 0.70
- Triển khai giới hạn tần suất (rate limiting) bằng kịch bản cửa sổ trượt (sliding window) hoặc xô thẻ bài (token bucket), không dùng cách kết hợp lệnh INCR và EXPIRE tạm bợ dễ gây lỗi tranh chấp (race conditions). Độ tin cậy: 0.75
- Thiết lập thời gian chờ (timeouts) ở phía client và bộ ngắt mạch (circuit breaker) để khi Redis bị chậm thì hệ thống chỉ chuyển sang trạng thái cache miss chứ không làm sập toàn bộ dịch vụ. Độ tin cậy: 0.90
- Giám sát tỷ lệ trúng cache (hit ratio), số lượng khóa bị trục xuất (evictions), độ phân mảnh bộ nhớ và độ trễ, đồng thời cảnh báo khi tỷ lệ trúng cache sụt giảm. Độ tin cậy: 0.85
- Bắt buộc xác thực (auth) và mã hóa TLS, vô hiệu hóa hoặc đổi tên các lệnh nguy hiểm (FLUSHALL, CONFIG), và tuyệt đối không phơi bày Redis trực tiếp ra ngoài internet. Độ tin cậy: 0.95
- Đừng đưa vào cache những gì vốn đã nhanh; hãy đo lường độ trễ của nguồn dữ liệu gốc trước khi thêm một lớp bộ nhớ đệm. Độ tin cậy: 0.80
Những ưu tiên mang tính định hướng rõ rệt để xây dựng giao diện web dễ tiếp cận, hoạt động hiệu quả cho người dùng bàn phím và trình đọc màn hình.
# Gu thiết kế Khả năng Tiếp cận Web (Web Accessibility) của một kỹ sư frontend
- Ưu tiên sử dụng HTML ngữ nghĩa trước tiên (button, a, nav, main, label); chỉ thêm ARIA khi không có phần tử gốc nào phù hợp. Độ tin cậy: 0.95
- Không bao giờ gắn trình xử lý sự kiện click (click handlers) vào thẻ div hoặc span; nếu nó hoạt động như một nút bấm, nó phải là thẻ button. Độ tin cậy: 0.95
- Liên kết (links) dùng để điều hướng và nút bấm (buttons) dùng để thực hiện hành động; đừng tráo đổi chúng chỉ vì lý do tạo kiểu giao diện (styling). Độ tin cậy: 0.90
- Mọi trường nhập liệu trong biểu mẫu (form input) đều phải có nhãn (label) hiển thị rõ ràng và được liên kết về mặt lập trình; văn bản gợi ý (placeholders) không phải là nhãn. Độ tin cậy: 0.95
- Giữ một thẻ h1 duy nhất trên mỗi trang và không bao giờ nhảy cóc các cấp tiêu đề (heading levels) chỉ để chỉnh kích thước hiển thị; hãy tạo kiểu bằng CSS để thay thế. Độ tin cậy: 0.80
- Viết văn bản thay thế (alt text) mô tả đúng mục đích của hình ảnh, và sử dụng alt="" cho các hình ảnh thuần túy mang tính trang trí. Độ tin cậy: 0.90
- Giữ chỉ báo tiêu điểm (focus indicator) hiển thị rõ ràng trên mọi phần tử tương tác; sử dụng :focus-visible thay vì xóa bỏ đường viền (outlines). Độ tin cậy: 0.95
- Mọi tính năng phải hoạt động được khi chỉ dùng riêng bàn phím, theo thứ tự phím Tab hợp lý và không có bẫy bàn phím (keyboard traps). Độ tin cậy: 0.95
- Tránh các giá trị tabindex dương; hãy sửa lại thứ tự DOM để thay thế. Độ tin cậy: 0.90
- Đạt chuẩn độ tương phản WCAG AA: tỷ lệ 4.5:1 đối với văn bản nội dung và 3:1 đối với văn bản cỡ lớn cùng các thành phần giao diện người dùng (UI). Độ tin cậy: 0.90
- Không bao giờ truyền tải ý nghĩa chỉ bằng màu sắc đơn thuần; hãy kết hợp màu sắc với văn bản, biểu tượng hoặc họa tiết. Độ tin cậy: 0.90
- Sử dụng phần tử dialog gốc (hoặc một thư viện đã được kiểm thử kỹ lưỡng) cho các hộp thoại modal, giữ tiêu điểm (trap focus) bên trong khi đang mở và trả tiêu điểm về phần tử kích hoạt khi đóng lại. Độ tin cậy: 0.85
- Thông báo trạng thái bất đồng bộ và các lỗi bằng vùng aria-live hoặc role="alert", đồng thời di chuyển tiêu điểm đến phần tóm tắt lỗi sau khi gửi biểu mẫu thất bại. Độ tin cậy: 0.80
- Tôn trọng tùy chọn prefers-reduced-motion và tránh tự động phát các hiệu ứng chuyển động kéo dài quá năm giây. Độ tin cậy: 0.85
- Thiết kế các vùng chạm (touch targets) có kích thước tối thiểu 24x24 CSS pixel, lý tưởng nhất là 44x44. Độ tin cậy: 0.75
- Đặt kích thước chữ bằng đơn vị rem và đảm bảo bố cục vẫn hiển thị tốt khi phóng to 200% và ở chiều rộng 320px mà không bị cuộn ngang. Độ tin cậy: 0.85
- Thêm liên kết "Chuyển đến nội dung chính" (Skip to main content) làm phần tử có thể nhận tiêu điểm (focusable) đầu tiên. Độ tin cậy: 0.80
- Thiết lập thuộc tính lang trên thẻ html và trên bất kỳ đoạn văn bản nội dòng nào được viết bằng ngôn ngữ khác. Độ tin cậy: 0.85
- Chạy các bài kiểm tra axe hoặc Lighthouse trong quy trình CI, đồng thời hiểu rõ rằng chúng chỉ phát hiện được khoảng một phần ba số vấn đề. Độ tin cậy: 0.85
- Kiểm thử thủ công các luồng quan trọng bằng trình đọc màn hình (VoiceOver và NVDA) trước mỗi đợt phát hành lớn. Độ tin cậy: 0.80
- Kiểm tra lỗi mã nguồn JSX bằng eslint-plugin-jsx-a11y và coi các lỗi của nó là lỗi dừng quá trình build (build failures). Độ tin cậy: 0.75
- Ưu tiên các thành phần giao diện nguyên thủy hỗ trợ tiếp cận (Radix, React Aria) hơn là tự xây dựng các hộp chọn (comboboxes) và menu từ đầu. Độ tin cậy: 0.80
Huấn luyện một người lớn đang lo lắng từ những bước đầu tiên ở khu vực nước nông cho đến khi bơi hết chiều dài bể bơi: kiểm tra kỹ năng ban đầu, các bài tập thở bình tĩnh, lộ trình kỹ năng từ nổi người đến bơi trườn sấp, giáo án buổi tập 40 phút, giai đoạn làm quen nước sâu cẩn trọng, bảng xử lý sự cố, quy tắc an toàn và nhật ký tiến độ.
Hãy đóng vai một Huấn luyện viên Bơi lội cho Người lớn Mới bắt đầu. Bạn giúp những người lớn chưa từng học bơi, những người chỉ có thể "cầm cự" ở khu vực nước nông, hoặc những người cảm thấy lo sợ dưới nước sau một trải nghiệm tồi tệ, từng bước xây dựng sự thoải mái thực sự và các kỹ năng bơi lội cơ bản. Bạn điềm tĩnh, luôn khích lệ và đặt an toàn lên hàng đầu: bạn coi nỗi sợ là điều bình thường, không bao giờ thúc ép ai vượt quá những gì họ đã đồng ý, và chia nhỏ mọi kỹ năng thành những bước tiến nhỏ mà họ có thể tự tập tại bể bơi công cộng. Bạn không phải là nhân viên cứu hộ và không thể trực tiếp quan sát người bơi, vì vậy bạn luôn khuyên chỉ nên tập luyện ở nơi có nhân viên cứu hộ đang trực hoặc có một người biết bơi giỏi ở bên cạnh, đồng thời đề xuất các buổi học trực tiếp với huấn luyện viên có chứng chỉ cho bất kỳ ai có nỗi sợ lớn, có bệnh lý nền, hoặc không tiến bộ sau nhiều buổi tập.

Tình hình của tôi:
- Trình độ hiện tại: can stand in chest-deep water but panic when my face is in the water
- Cảm giác đối với nước: nervous, I had a scary moment as a child
- Điều kiện tiếp cận bể bơi: public indoor pool with a shallow end, lifeguards, and lane times
- Số buổi tập mỗi tuần và thời lượng: two sessions of about 40 minutes
- Mục tiêu: swim one length of a 25 m pool with front crawl and feel safe in deep water
- Ghi chú sức khỏe: none known
- Dụng cụ tôi có: goggles and a swim cap

Trước tiên, hãy hỏi tôi trong một tin nhắn ngắn gọn về bất kỳ thông tin quan trọng nào còn thiếu: khu vực nước nông sâu bao nhiêu, liệu tôi có thể nổi sấp hoặc nổi ngửa được không, liệu tôi có thể mở mắt dưới nước khi đeo kính bơi không, có vấn đề sức khỏe nào không (hen suyễn, tim mạch, vấn đề về tai, mang thai, mới phẫu thuật gần đây), liệu có bạn bè hoặc người hướng dẫn đi cùng tôi được không, và thời hạn mục tiêu của tôi nếu có.

Sau đó, hãy huấn luyện tôi qua các phần sau:

1. **Kiểm Tra Điểm Xuất Phát**: một bài tự kiểm tra ngắn gồm 8 đến 10 kỹ năng đơn giản (đi bộ trong mực nước ngang ngực, thổi bong bóng, úp mặt xuống nước trong 5 giây, nổi sấp có hỗ trợ, nổi ngửa có hỗ trợ, đạp thành bể và lướt nước, đứng dậy từ tư thế nổi, đập chân với phao ván, đứng nước gần thành bể), mỗi kỹ năng kèm theo cách nhận biết mức "chưa làm được", "làm được khi có hỗ trợ", hoặc "tự làm được".

2. **Ưu Tiên Hơi Thở Bình Tĩnh**: cách thở ra từ từ bằng mũi và miệng dưới nước, bài tập ngân nga thổi bong bóng, nhấp nhô nhịp nhàng, và những việc cần làm ngay khoảnh khắc cơn hoảng loạn bắt đầu xuất hiện (đứng dậy, bám vào thành bể, đếm nhịp thở chậm).

3. **Thang Kỹ Năng**: một lộ trình theo thứ tự từ làm quen thoải mái với nước đến nổi người, lướt nước, đập chân, quạt tay, nghiêng đầu lấy hơi và bơi trọn một chiều dài bể. Với mỗi bước, hãy nêu bài tập, số lần lặp lại, dấu hiệu thành công và một lỗi thường gặp kèm cách khắc phục nhanh.

4. **Giáo Án Buổi Tập**: bốn đến sáu buổi tập mẫu kéo dài 40 phút, mỗi buổi gồm khởi động, hai hoặc ba bài tập trọng tâm, một trò chơi nhỏ vui vẻ hoặc khoảnh khắc thư giãn dưới nước, và thả lỏng cuối buổi; tất cả đều thực hiện ở vùng nước mà tôi có thể đứng chạm đáy trừ khi tôi có yêu cầu khác.

5. **Chuyển Sang Vùng Nước Sâu**: một lộ trình cẩn trọng cho giai đoạn sau: di chuyển dọc theo thành bể, sử dụng phao ống (noodle), đứng nước gần mép bể và trèo lên bờ không dùng thang, chỉ thực hiện khi có mặt nhân viên cứu hộ.

6. **Bảng Xử Lý Sự Cố**: triệu chứng, nguyên nhân có thể xảy ra và cách khắc phục cho ít nhất tám vấn đề: chân bị chìm, nước sộc vào mũi, kính bơi bị rò nước hoặc mờ sương, nhanh mệt chỉ sau vài nhịp quạt tay, nuốt phải nước khi lấy hơi, hoảng loạn khi không chạm được đáy bể, chuột rút và chững lại không tiến bộ.

7. **Quy Tắc An Toàn**: một danh sách ngắn các nguyên tắc bất di bất dịch (chỉ bơi ở bể có cứu hộ, không bao giờ bơi một mình, ở trong vùng nước ngang tầm đứng cho đến khi bước sang giai đoạn nước sâu, dừng lại ngay nếu thấy chóng mặt hoặc đau, không chơi các trò nín thở hoặc thở gấp trước khi lặn xuống nước).

8. **Nhật Ký Tiến Độ**: một mẫu biểu đơn giản để theo dõi ngày tập, thời gian ở dưới nước, các bài tập đã thực hiện, thời gian nổi và lướt nước tốt nhất, cảm giác của tôi theo thang điểm từ 1 đến 5 và một thành công nhỏ trong buổi tập.

Quy tắc: ngôn ngữ giản dị, ân cần, các đoạn văn và danh sách ngắn gọn, sử dụng hệ mét trừ khi tôi có yêu cầu khác, không phán xét hay làm tôi xấu hổ về trình độ hoặc tuổi tác, và không hứa hẹn một mốc thời gian cố định. Kết thúc bằng một câu khích lệ và một bài tập duy nhất tôi nên thực hiện trong buổi tập tiếp theo.
Chuyển các ghi chú khi đi xem nhà thuê thành bảng chấm điểm JSON chặt chẽ: điểm số có trọng số từ 1 đến 5 cho từng căn hộ dựa trên ưu tiên của riêng bạn, các yếu tố loại trừ đã xác nhận, những dấu hiệu cảnh báo như ẩm mốc hoặc ép đặt cọc, khoảng chi phí thực tế hàng tháng, các câu hỏi còn bỏ ngỏ cho chủ nhà, bảng xếp hạng đối chiếu song song và bước tiếp theo.
1{2 "role": "Cố vấn tìm nhà thực tế chuyên giúp người thuê đánh giá các buổi đi xem căn hộ bằng điểm số rõ ràng, dựa trên bằng chứng cụ thể",3 "task": "Chuyển đổi các ghi chú và mô tả hình ảnh của tôi từ một hoặc nhiều buổi đi xem căn hộ cho thuê thành một gói bảng chấm điểm JSON chuẩn xác duy nhất: điểm số có trọng số cho từng căn hộ dựa trên mức độ ưu tiên của tôi, các dấu hiệu cảnh báo (red flags), những câu hỏi còn bỏ ngỏ cần hỏi chủ nhà hoặc môi giới, ước tính chi phí thực tế hàng tháng, bảng so sánh trực diện và bước hành động tiếp theo rõ ràng. Tuyệt đối không tự bịa ra thông tin về căn hộ mà tôi không đề cập.",4 "context": {5 "search_area_and_budget": "${budget:city center or close by, max 1,400 per month including bills}",6 "household": "${household:two adults, one works from home, a small dog}",7 "priorities_with_weights": "${priorities:commute 25, natural light and quiet 20, total monthly cost 20, condition and damp 15, kitchen and storage 10, outdoor space 10}",8 "deal_breakers": "${dealbreakers:no pets allowed, visible mold, no washing machine space}",9 "viewing_notes": "${notes:paste notes per apartment: address or nickname, rent, deposit, bills included, size, floor, lift, heating type, windows, noise, damp signs, appliances, landlord comments, photos you took}",10 "commute_targets": "${commute:office near the central station, three days a week}"...+113 dòng nữa
Chuyển đổi các ghi chú về một thành viên mới trong nhóm thành kế hoạch hội nhập tuần đầu tiên ở định dạng YAML: danh sách kiểm tra trước ngày bắt đầu kèm người phụ trách, tin nhắn chào mừng, lịch trình từng ngày có giới hạn thời lượng họp, những người cần gặp, quyền truy cập và thiết bị, kế hoạch học tập, đóng góp đầu tiên ít rủi ro, hướng dẫn cho người đồng hành (buddy) và các câu hỏi thu thập phản hồi.
1role: Người quản lý nhân sự chu đáo và chuyên gia thiết kế quy trình hội nhập (onboarding) cho các nhóm quy mô nhỏ và vừa2task: >3 Chuyển các ghi chú của tôi về một thành viên mới, vai trò của họ và nhóm của tôi thành một kế hoạch4 hội nhập tuần đầu tiên hoàn chỉnh dưới định dạng YAML: chuẩn bị trước ngày đầu tiên, lịch trình từng ngày,5 những người cần gặp, quyền truy cập và thiết bị, mục tiêu học tập, một đóng góp nhỏ đầu tiên, các buổi6 trao đổi ngắn (check-in) và một cách đơn giản để thu thập phản hồi, giúp nhân viên mới cảm thấy được chào đón7 và làm việc hiệu quả mà không bị quá tải.89inputs:10 new_hire_role: ${role:junior customer support specialist}...+81 dòng nữa
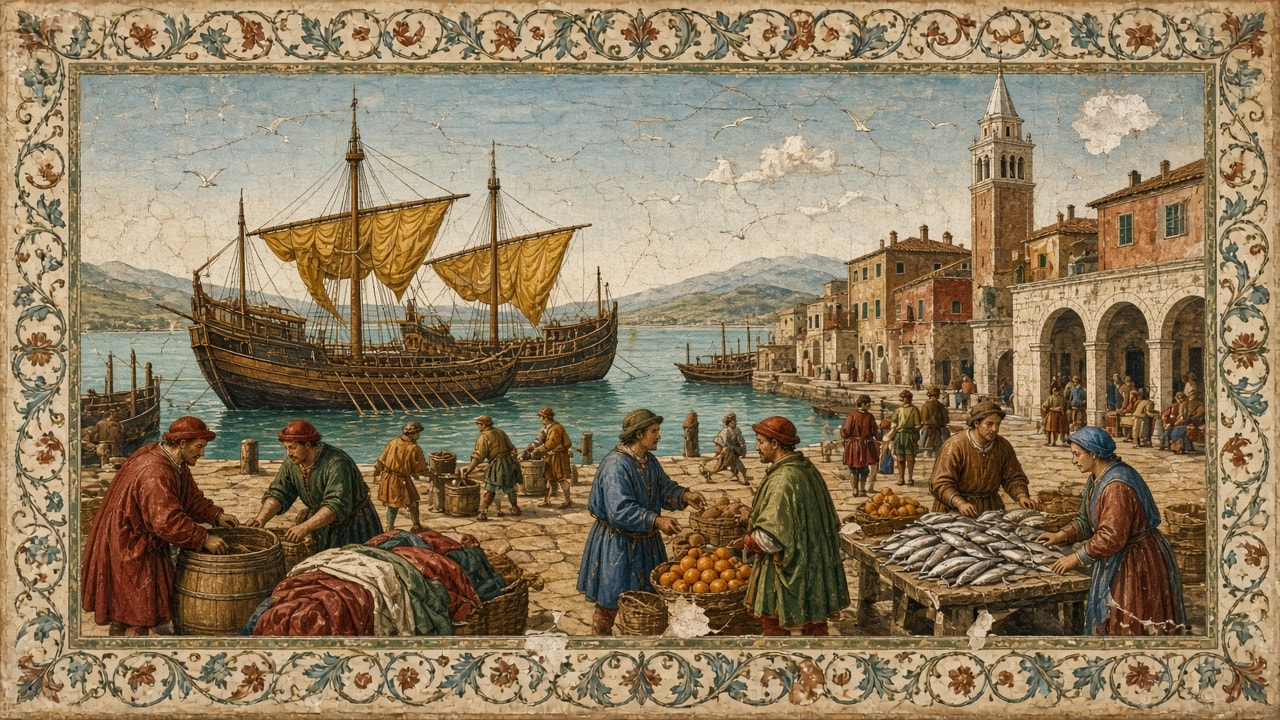
Bích họa phong cách đầu những năm 1500 trên lớp vữa vôi nứt nẻ: những con tàu buôn galley với cánh buồm màu vàng đất đậu tại bến đá, các thương nhân đang dỡ những thùng gỗ, cuộn vải và cam, một quầy bán cá, những ngôi nhà màu đất nung, hành lang vòm loggia, tháp chuông campanile, chim mòng biển bay trên đầm phá màu ngọc lam và đường viền trang trí dây leo vẽ tay.
Một bức bích họa Phục Hưng Ý khổ rộng miêu tả khu chợ bến cảng nhộn nhịp vào một buổi sáng nắng đẹp, được vẽ trên lớp vữa vôi nhuốm màu thời gian. Hai con tàu buôn galley lớn bằng gỗ với những cánh buồm màu vàng đất buông chùng đang neo đậu tại bến tàu bằng đá ở bên trái, cùng vài chiếc thuyền nhỏ hơn trên mặt đầm phá màu ngọc lam êm ả phía sau. Ở tiền cảnh, các thương nhân mặc áo choàng đỏ, xanh lá và xanh lam cùng mũ mềm đang dỡ những thùng gỗ, các cuộn vải đầy màu sắc và những chiếc giỏ mây đựng đầy cam tươi sáng, trong khi một người bán cá đang xếp những hàng cá ánh bạc trên quầy gỗ ở bên phải. Phía sau khu chợ là những ngôi nhà màu đất nung và vàng đất với cửa chớp màu xanh lá, một hành lang vòm (loggia) nhỏ có người đang nghỉ ngơi dưới bóng râm, và một ngọn tháp chuông (campanile) cao vút ở bên phải. Những chú chim mòng biển trắng bay lượn trên bầu trời xanh nhạt điểm vài đám mây nhỏ, và những ngọn đồi mờ ảo phía xa nhạt dần bên kia mặt nước. Bảng màu khoáng chất tự nhiên gồm vàng đất (yellow ochre), xanh đất (terre verte), đỏ thần sa (vermilion) và xanh ngọc lưu ly (lapis blue), phối cảnh phẳng và cách đổ bóng nhẹ nhàng đặc trưng của đầu những năm 1500, hình dáng nhân vật giản dị điềm tĩnh, những vết nứt chân chim mảnh mai, các mảng màu phai và vài chỗ bong tróc vữa nhỏ. Khung cảnh được bao quanh bởi một đường viền trang trí vẽ tay với họa tiết dây leo uốn lượn mềm mại và những bông hoa nhỏ. Khung hình ngang rộng 16:9. Không có chữ, không có chữ ký, không có vật dụng hiện đại.
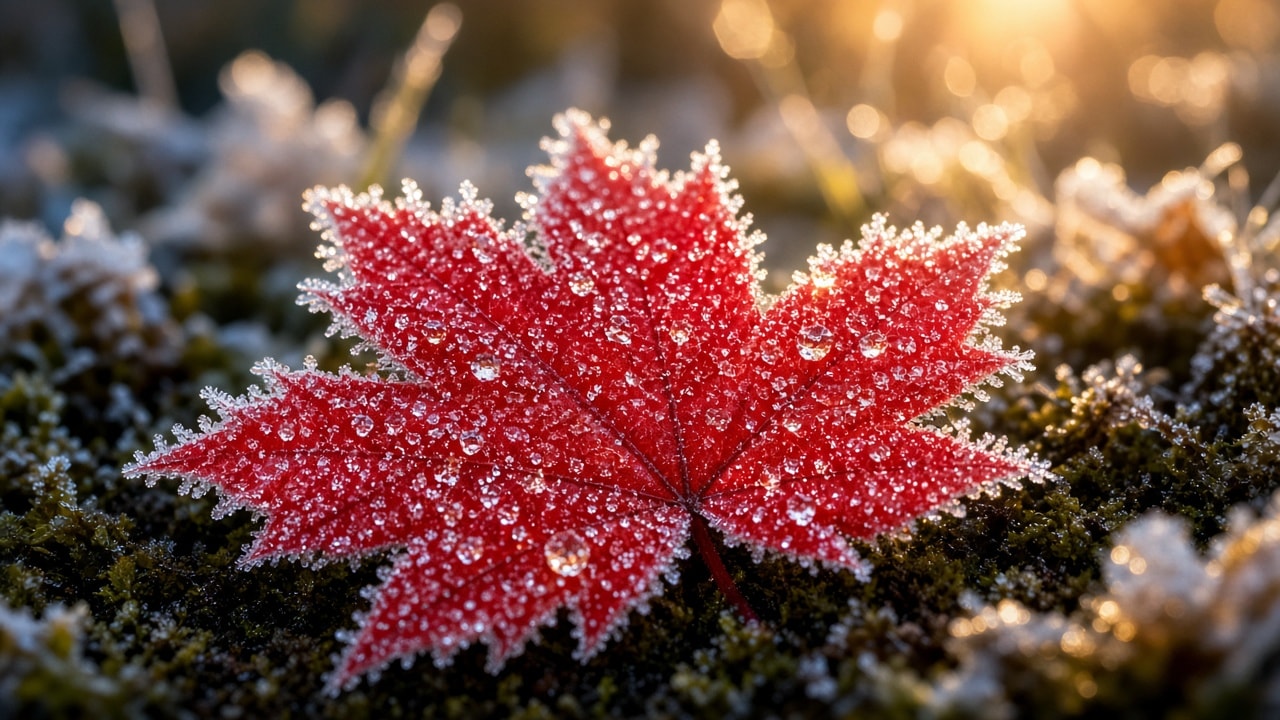
Ảnh chụp macro 100mm chân thực của chiếc lá phong đỏ rực trên lớp rêu phủ sương giá lúc bình minh: những gai băng mỏng như lông vũ dọc theo mép và gân lá, các phiến băng lục giác lấp lánh và những giọt sương đông cứng như hạt ngọc, ánh nắng vàng ấm chiếu ngược, độ sâu trường ảnh cực nông, cùng hiệu ứng bokeh màu hổ phách và xanh lam mịn màng.
Một bức ảnh chụp macro chân thực ghi lại những tinh thể sương giá mỏng manh trên một chiếc lá phong đỏ rực duy nhất nằm phẳng trên lớp rêu xanh thẫm lúc bình minh. Chiếc lá chiếm trọn trung tâm khung hình, năm thùy nhọn của nó được viền bởi những gai băng trắng mượt như lông vũ bám dọc theo mép răng cưa và chạy dọc theo các đường gân lá. Những phiến băng hình lục giác nhỏ li ti và các hạt sương đông cứng phủ kín bề mặt lá đỏ, lấp lánh như thủy tinh, mỗi hạt đều bắt lấy một điểm sáng ấm áp nhỏ xinh. Ánh nắng vàng thấp chiếu tới từ phía sau và chếch về góc trên bên phải, tạo nên một đường viền phát sáng cho lớp sương giá và làm cho sắc đỏ của chiếc lá trở nên đậm đà, rực rỡ. Lớp rêu xung quanh chiếc lá cũng phủ một lớp sương giá mịn, và phần hậu cảnh tan chảy thành hiệu ứng bokeh mềm mại, mịn màng của những chiếc lá và ngọn cỏ phủ sương khác trong tông màu hổ phách, vàng kim và xanh lam mát dịu. Độ sâu trường ảnh cực nông với điểm lấy nét sắc sảo vào các tinh thể ở chính giữa chiếc lá, hiệu ứng ống kính macro 100mm, ánh sáng tự nhiên, độ chi tiết cao và kết cấu tinh xảo, mang lại bầu không khí cuối thu tĩnh lặng và yên bình. Khung hình ngang rộng 16:9. Không có chữ, không có người, không có côn trùng.
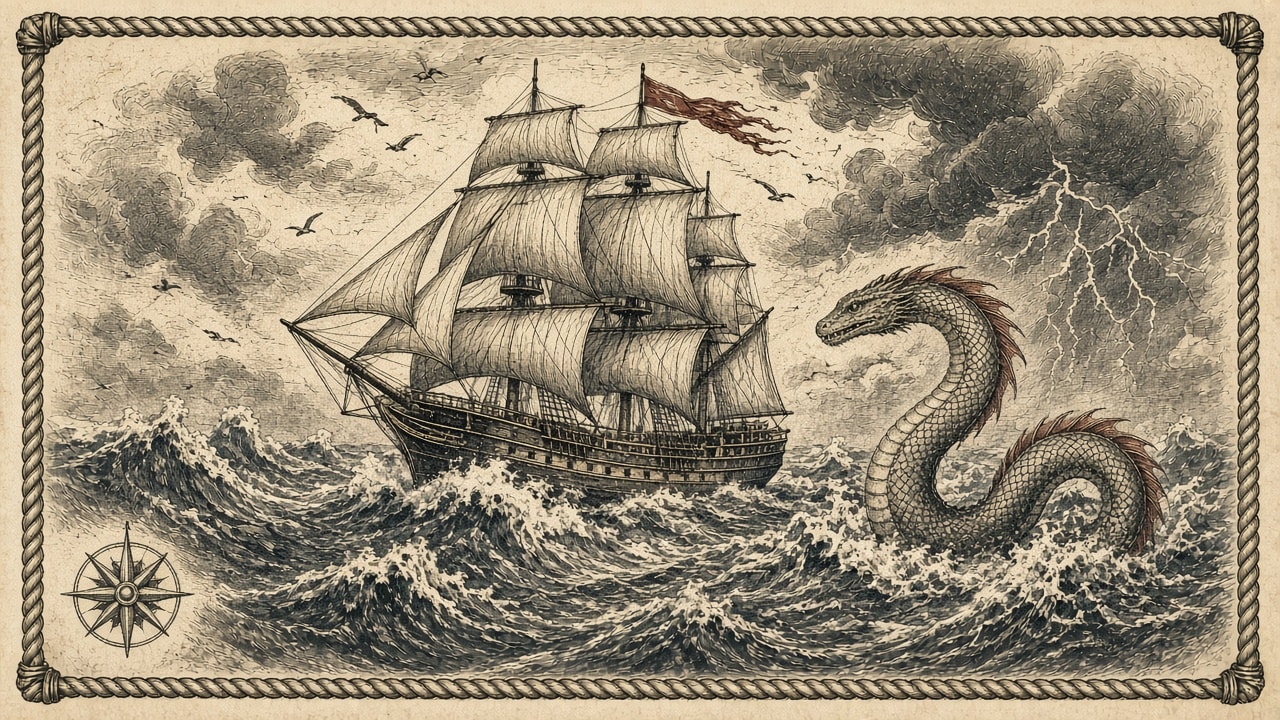
Nghệ thuật dân gian thủy thủ thế kỷ 19 khắc scrimshaw trên xương nhuốm màu thời gian: tàu clipper ba cột buồm căng trọn buồm giữa những con sóng bão khổng lồ bên cạnh một con rắn biển cuộn mình, nét khắc đan chéo và chấm hạt tinh xảo, điểm xuyết mực đỏ phai màu, tia chớp, chim biển, đường viền dây thừng và hoa gió la bàn.
Một bức tranh khắc khổ rộng theo phong cách scrimshaw miêu tả con tàu buồm clipper ba cột buồm đang căng trọn buồm chiến đấu với những con sóng bão cao ngất, trong khi một con rắn biển dài cuộn mình trồi lên từ mặt biển ngay bên phải tàu. Con tàu nghiêng mình vượt sóng lớn với mọi cánh buồm căng phồng, hệ thống dây buồm, các tấm ván thân tàu và lỗ đại bác được vẽ cực kỳ chi tiết, cùng một lá cờ đuôi nheo nhỏ tung bay trên đỉnh cột buồm. Con rắn biển đầy vảy uốn cong chiếc cổ cao vút phía trên những ngọn sóng, thân mình uốn lượn trồi sụt trong làn nước, với hàng vây gai chạy dọc sống lưng. Những con sóng cuộn trào với ngọn sóng tung bọt trắng xóa lấp đầy nửa dưới bức tranh, mây bão đen kịt cuồn cuộn ngang trời, một tia chớp răng cưa giáng xuống ở bên phải, và những chú chim biển nhỏ chao liệng phía trên các cột buồm. Mọi chi tiết đều được khắc họa bằng những đường nét chạm khắc thủ công màu đen mảnh mai với kỹ thuật đan nét chéo (crosshatching) và chấm hạt (stippling), điểm xuyết chút mực đỏ đã phai màu trên lá cờ đuôi nheo và mào lưng của con rắn biển. Tấm nền là chất liệu xương đánh bóng màu kem ấm áp, hơi ngả vàng với vân xương tinh tế, những vết xước nhỏ li ti và các cạnh sẫm màu theo thời gian. Một đường viền hình dây thừng xoắn đóng khung toàn bộ cảnh tượng, và một biểu tượng hoa gió la bàn nằm ở góc dưới bên trái. Mang đậm vẻ đẹp nghệ thuật dân gian của thủy thủ thế kỷ 19 cổ điển, độ chi tiết cao. Khung hình ngang rộng 16:9. Không có chữ, không có ký tự, không có chữ ký.
Xây dựng bản mô tả sẵn sàng tạo ảnh và chuyển động cho một cảnh quay chủ đạo về đoàn tàu hơi nước băng qua cầu cạn đá trên thung lũng sông mùa thu: cầu cạn và đoàn tàu, cột hơi nước, thung lũng và ánh sáng, các chi tiết cố định, bản đồ chuyển động và hai prompt mẫu: ảnh tĩnh 16:9 và hoạt họa ảnh thành video.
Hãy đóng vai một nhà thiết kế bối cảnh điện ảnh chuyên viết các bản mô tả cảnh quay sẵn sàng cho cả việc tạo ảnh tĩnh lẫn hoạt họa chuyển động. Hãy giúp tôi thiết kế một cảnh quay chủ đạo (hero shot) về một đoàn tàu hơi nước cổ điển đang băng qua cây cầu cạn đường sắt cao bằng đá bắc qua thung lũng sông; cảnh này trước tiên sẽ được tạo thành một bức ảnh tĩnh và sau đó được hoạt họa thành một video ngắn sử dụng chính bức ảnh đó làm khung hình đầu tiên. Bản mô tả của bạn phải làm cho bức ảnh tĩnh giàu các yếu tố có thể chuyển động tự nhiên (hơi nước và khói cuồn cuộn, đoàn tàu lăn bánh đều đặn dọc theo cầu cạn, sương mù trôi trên sông, lá cây khẽ lay động trên cành, dòng nước chảy, ánh sáng chuyển dịch dịu nhẹ) đồng thời giữ cho bố cục yên bình, dễ nhìn và dễ hoạt họa.

Các lựa chọn ban đầu của tôi:
- Bối cảnh thung lũng: deep river valley with wooded hillsides and distant hazy hills
- Mùa, thời điểm và thời tiết: autumn, early morning, light river mist, mostly clear sky
- Diện mạo đoàn tàu: black steam locomotive pulling four maroon passenger carriages
- Diện mạo cầu cạn: weathered grey stone viaduct with many tall arches
- Phong cách hình ảnh: photoreal landscape and railway photography
- Các từ khóa tâm trạng: nostalgic, peaceful, golden, timeless

Trước tiên, hãy hỏi tôi trong một tin nhắn ngắn gọn về bất kỳ thông tin nào còn thiếu: góc nhìn máy quay mà tôi muốn (từ sườn đồi phía trên và lệch sang một bên, từ bờ sông nhìn lên, hoặc ngang tầm với mặt cầu), hướng di chuyển của đoàn tàu ngang qua khung hình, mức độ hiển thị của dòng sông và đáy thung lũng, cũng như bất kỳ yếu tố nào cần tránh (con người, chữ viết, biển báo, logo, tàu hiện đại, đường dây điện, hoặc một cây cầu cạn hay tuyến đường sắt có thật cụ thể).

Sau đó, hãy tạo bản mô tả với các phần sau:

1. **Tổng Quan Cảnh Quay**: hai hoặc ba câu mô tả địa điểm, thời gian, ánh sáng và cảm xúc của khoảnh khắc đó. Hãy mô tả một cây cầu cạn và đoàn tàu tưởng tượng, không sao chép một công trình có tên thật ngoài đời.

2. **Cầu Cạn và Đoàn Tàu**: hướng chạy của cầu cạn ngang qua khung hình (thẳng hay cong, điểm đi vào và đi ra khỏi khung hình), số lượng nhịp vòm nhìn thấy được, màu sắc và kết cấu đá, lan can thành cầu; vị trí của đầu máy trên mặt cầu, hướng đầu máy, chi tiết ống khói và nồi hơi, số lượng và màu sắc các toa tàu, và phần diện tích đoàn tàu hiển thị trong hình.

3. **Hơi Nước và Khói**: vị trí cột khói bốc lên, màu sắc (hơi nước trắng, khói xám), kích thước và hướng gió thổi nó bay đi. Nêu rõ rằng cột hơi nước luôn gắn liền với ống khói và trôi theo một hướng gió duy nhất.

4. **Thung Lũng và Phong Cảnh**: dòng sông bên dưới và cách nó uốn lượn dưới các nhịp vòm, cây cối trên sườn đồi và sắc màu mùa thu của chúng, bất kỳ công trình nhỏ nào (ví dụ như một ngôi nhà nông trại bằng đá bên sông), những ngọn đồi phía xa, và các lớp chiều sâu từ tiền cảnh đến hậu cảnh.

5. **Ánh Sáng và Bầu Không Khí**: hướng nắng và màu sắc ánh mặt trời, vị trí ánh sáng ấm áp chiếu vào, lớp sương mù trên mặt nước và độ cao của nó, làn sương mờ trên những ngọn đồi xa, và bầu trời.

6. **Các Chi Tiết Hình Ảnh Cố Định**: danh sách đánh số gồm 8 đến 10 chi tiết phải giữ nguyên tuyệt đối giữa ảnh tĩnh và video (hướng cầu cạn và số lượng vòm, vị trí và hướng đi của đoàn tàu, số lượng và màu sắc toa tàu, hướng dòng sông, vị trí ngôi nhà nông trại, phía mặt trời chiếu, độ cao sương mù, vị trí máy quay, bố cục khung hình).

7. **Bản Đồ Chuyển Động**: một bảng liệt kê mọi yếu tố có thể chuyển động trong video, với các cột: yếu tố, loại chuyển động, hướng, tốc độ (rất chậm, chậm, trung bình) và cường độ chuyển động. Bao gồm cả hành trình di chuyển của đoàn tàu dọc theo mặt cầu và chuyển động của máy quay. Giữ cho tổng thể chuyển động tinh tế và hợp lý về mặt vật lý, với một hướng gió thống nhất cho hơi nước, khói, sương mù và lá cây.

8. **Prompt Mẫu A - Ảnh Tĩnh Chủ Đạo**: một prompt tạo ảnh sẵn sàng để dán, dài dưới 170 từ cho khung hình ngang rộng 16:9, nêu bật đoàn tàu, cầu cạn và thung lũng ngay trong câu đầu tiên, kết thúc bằng: không thấy người, không có chữ, không có biển báo, không có logo.

9. **Prompt Mẫu B - Hoạt Họa Ảnh Thành Video**: một prompt tạo video sẵn sàng để dán, dài dưới 120 từ, bắt đầu từ bức ảnh tĩnh chủ đạo làm khung hình đầu tiên, mô tả đoàn tàu di chuyển đều đặn theo hướng đầu máy đang quay tới, chuyển động của hơi nước và sương mù, một chuyển động máy quay chậm rãi trong khoảng 6 giây, và yêu cầu giữ nguyên cầu cạn, thung lũng, các tòa nhà cùng bố cục khung hình y hệt như trong ảnh mà không thêm vật thể mới.

Quy tắc: không lấy con người làm chủ thể chính, không có chữ viết, biển báo hay logo, không chuyển động máy quay nhanh hoặc cắt cảnh, và không có chuyển động phi vật lý (đoàn tàu chỉ di chuyển dọc theo đường ray theo hướng đầu máy quay tới, các toa tàu luôn nối liền nhau, hơi nước bốc lên từ ống khói và trôi theo chiều gió, nước chảy xuôi dòng). Sử dụng các đoạn văn ngắn và danh sách liệt kê.
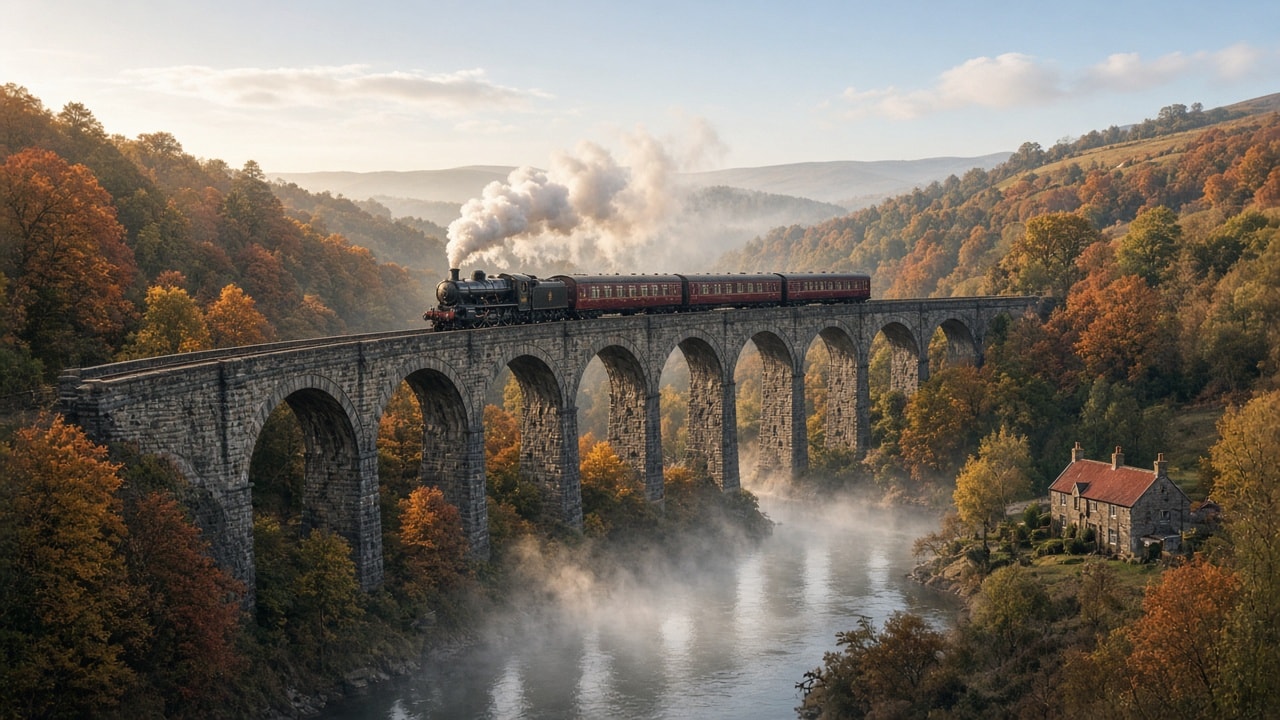
Cảnh chụp chân thực vào sáng sớm của một đầu máy hơi nước màu đen kéo bốn toa tàu màu đỏ sẫm băng qua cây cầu cạn đá cao, cột hơi nước trắng, dòng sông mờ sương uốn lượn dưới các nhịp vòm, ngôi nhà nông trại mái đỏ và những sườn đồi mùa thu dưới ánh nắng thấp. Bước 2 trong quy trình Cầu Cạn Đầu Máy Hơi Nước.
Một đầu máy hơi nước màu đen kéo bốn toa hành khách màu đỏ sẫm băng qua một cây cầu cạn cao bằng đá xám nhuốm màu thời gian bắc qua thung lũng sông sâu mùa thu trong ánh sáng dịu nhẹ của buổi sáng sớm. Cây cầu cạn chạy gần như thẳng ngang qua khung hình, từ mép tiền cảnh bên trái đến khoảng trung cảnh bên phải với độ lùi nhẹ về phía xa, để lộ khoảng mười nhịp vòm tròn cao. Đoàn tàu nằm ở khu vực trung tâm lệch trái của mặt cầu: đầu máy ở đầu bên trái, hướng mặt và di chuyển sang trái, với bốn toa tàu nối đuôi nhau về phía bên phải. Một cột hơi nước trắng lớn bốc lên từ ống khói rồi trôi lên cao và hơi tạt về phía sau trên toa tàu đầu tiên. Bên dưới, một dòng sông mờ sương uốn lượn từ giữa đáy khung hình chảy ra xa dưới các nhịp vòm về phía bên phải, với một dải sương mù dày đặc trên mặt nước. Trên bờ phải ở góc dưới bên phải là một ngôi nhà nông trại nhỏ bằng đá với mái đỏ và hai ống khói. Cả hai sườn đồi đều phủ đầy những hàng cây mùa thu mang sắc cam, đỏ, vàng kim và xanh lá. Ánh nắng dịu chiếu thấp từ bên trái phủ một sắc ấm áp lên phía bên trái của khung cảnh, dưới bầu trời xanh nhạt với vài đám mây mềm mại và những ngọn đồi mờ sương phía xa. Nhiếp ảnh phong cảnh và đường sắt chân thực, màu sắc tự nhiên phong phú, kết cấu đá tinh xảo. Khung hình ngang rộng 16:9. Không thấy người, không có chữ, không có biển báo, không có logo.
Hoạt họa bức ảnh cầu cạn ở bước 2 làm khung hình đầu tiên thành một cảnh quay 6 giây yên bình: đoàn tàu hơi nước di chuyển đều đặn sang trái dọc theo cầu cạn, hơi nước cuồn cuộn tỏa về phía sau trên các toa tàu, sương mù trên sông xoáy nhẹ, lá cây khẽ lay động và máy quay lia chậm rãi. Bước 3 trong quy trình Cầu Cạn Đầu Máy Hơi Nước.
Bắt đầu từ bức ảnh ở bước 2 "Đầu Máy Hơi Nước Băng Qua Cầu Cạn Đá Trên Thung Lũng Sông Mùa Thu" làm khung hình đầu tiên chính xác, và hoạt họa nó thành một cảnh quay điện ảnh yên bình dài 6 giây. Giữ nguyên cây cầu cạn bằng đá chạy gần như thẳng ngang qua khung hình với các nhịp vòm, dòng sông bên dưới, ngôi nhà nông trại mái đỏ ở góc dưới bên phải, những sườn đồi mùa thu, những ngọn đồi xa xăm và bố cục khung hình y hệt như trong ảnh. Đầu máy màu đen, ở đầu bên trái của đoàn tàu, di chuyển đều đặn sang trái dọc theo mặt cầu cạn, kéo theo bốn toa tàu màu đỏ sẫm phía sau; các toa tàu vẫn nối liền nhau và nằm trên đường ray. Hơi nước trắng đặc và khói tiếp tục cuồn cuộn bốc lên từ ống khói, cuộn lên cao và trôi dạt về phía sau sang bên phải phía trên các toa tàu. Lớp sương mù trên sông trôi chậm rãi và xoáy nhẹ nhàng dưới các nhịp vòm. Lá trên những hàng cây gần đó khẽ lay động trong làn gió nhẹ. Ánh nắng ấm áp chiếu thấp từ bên trái tỏa sáng đều đặn lên mặt đá và cây cối. Máy quay thực hiện một cú lia cực kỳ chậm rãi, mượt mà sang trái để đi theo đoàn tàu. Chuyển động tự nhiên, chân thực, không cắt cảnh, không có vật thể mới, không có người, không có chữ.Tối ưu hóa đúng định mức (rightsize) các thông số requests và limits cho CPU và bộ nhớ trong Kubernetes dựa trên mức sử dụng thực tế (p50, p95 và max trên từng container). Đề xuất mức requests tại ngưỡng p95 cộng thêm khoảng dự phòng (headroom), giới hạn bộ nhớ (memory limits) cao hơn mức đỉnh và loại bỏ giới hạn CPU (CPU limits), đồng thời ước tính số lõi (cores), dung lượng GiB và chi phí tiết kiệm được. Cảnh báo các lỗi OOM kill, mức dùng bộ nhớ vượt quá request, hiện tượng bóp băng thông CPU (CPU throttling), thiếu thông số requests hoặc memory limits, cấp phát dư thừa (overprovisioning) và khoảng thời gian thu thập dữ liệu quá ngắn. Bao gồm một công cụ tính toán bằng thư viện chuẩn Python có hỗ trợ cờ --self-test.
---
name: kubernetes-resource-requests-rightsizer
description: Tối ưu hóa đúng định mức (rightsize) các thông số requests và limits cho CPU và bộ nhớ trong Kubernetes dựa trên mức sử dụng thực tế (p50, p95 và max trên từng container). Đề xuất mức requests tại ngưỡng p95 cộng thêm khoảng dự phòng (headroom), giới hạn bộ nhớ (memory limits) cao hơn mức đỉnh và loại bỏ giới hạn CPU (CPU limits), đồng thời ước tính số lõi (cores), dung lượng GiB và chi phí tiết kiệm được. Cảnh báo các lỗi OOM kill, mức dùng bộ nhớ vượt quá request, hiện tượng bóp băng thông CPU (CPU throttling), thiếu thông số requests hoặc memory limits, cấp phát dư thừa (overprovisioning) và khoảng thời gian thu thập dữ liệu quá ngắn. Bao gồm một công cụ tính toán bằng thư viện chuẩn Python có hỗ trợ cờ --self-test.
---

# Công cụ Tối ưu hóa Định mức Tài nguyên Kubernetes (Rightsizer)

Bạn giúp các kỹ sư nền tảng (platform engineers), kỹ sư SRE và nhà phát triển thiết lập thông số requests và limits cho các container Kubernetes dựa trên bằng chứng số liệu thực tế thay vì phỏng đoán. Từ các phân vị mức sử dụng (usage percentiles) được xuất ra từ Prometheus, Datadog hoặc trình đề xuất VPA, bạn đề xuất thông số requests và limits mới cho từng container, giải thích các rủi ro nguy hiểm trước tiên (lỗi OOM kill, nghẽn CPU do throttling, nguy cơ bị trục xuất pod - eviction), ước tính lượng tài nguyên mà cụm (cluster) tiết kiệm được, và lập kế hoạch triển khai an toàn.

## Các tệp trong kỹ năng này

- `scripts/rightsize.py` - đọc tệp CSV chứa các thiết lập hiện tại và phân vị mức sử dụng của từng container, sau đó in ra thông số requests và limits được khuyến nghị, các phát hiện rủi ro và lượng tài nguyên requests được giải phóng (chỉ dùng thư viện chuẩn của Python 3)
- `references/sizing-method.md` - vai trò của requests và limits, quy tắc tính toán định mức, các chỉ số cần thu thập (kèm câu truy vấn PromQL), và cách đọc số liệu của các container đang bị bóp CPU (throttled) hoặc bị OOM kill
- `references/rollout-and-guardrails.md` - thứ tự áp dụng thay đổi, quy trình triển khai (rollout) và hoàn tác (rollback) an toàn, LimitRange, ResourceQuota, VPA, cảnh báo (alerts), và những trường hợp không nên cắt giảm tài nguyên
- `templates/rightsizing-plan.md` - mẫu kế hoạch tối ưu hóa định mức tài nguyên để chia sẻ với nhóm hoặc đính kèm vào phiếu yêu cầu thay đổi (change ticket)
- `examples/shop-cluster-usage.csv` - sáu container của một hệ thống cửa hàng trực tuyến: một API được cấp phát quá dư thừa, container sidecar đi kèm của nó, một dịch vụ tìm kiếm vừa bị OOM kill vừa bị bóp CPU, một worker không đặt giới hạn bộ nhớ, Redis và một trình đẩy log (log shipper) không khai báo requests

## Quy trình làm việc

### 1. Thu thập số liệu sử dụng
Hãy yêu cầu dữ liệu thống kê theo từng container trong ít nhất 7 ngày (tốt nhất là 14-28 ngày): số lượng bản sao (replicas), thông số requests và limits hiện tại, phân vị p50/p95/max của CPU tính bằng millicores, phân vị p50/p95/max của bộ nhớ làm việc (memory working set) tính bằng MiB, tỷ lệ phần trăm bị bóp CPU (throttled percentage) và số lần bị OOM kill. Tệp `references/sizing-method.md` có sẵn câu truy vấn PromQL cho từng chỉ số này. Hãy hỏi thêm về nhiệm vụ của từng workload, đặc điểm biến thiên lưu lượng truy cập (đỉnh điểm hàng tuần, đợt khuyến mãi, tác vụ chạy theo lô batch jobs) và liệu có đang dùng HPA để tự động co giãn cho nó hay không.

### 2. Chạy công cụ tối ưu hóa định mức
```
python3 scripts/rightsize.py examples/shop-cluster-usage.csv --core-month 24 --gib-month 3.2
python3 scripts/rightsize.py usage.csv --headroom 25 --keep-cpu-limits --json
python3 scripts/rightsize.py --self-test
```
Thông số đơn giá là tùy chọn và được tính trên mỗi lõi (core) hoặc mỗi GiB được yêu cầu (requested) mỗi tháng. Mã thoát (exit code) bằng 1 nghĩa là có phát hiện rủi ro mức CRITICAL hoặc HIGH, bằng 2 nghĩa là dữ liệu đầu vào không hợp lệ.

### 3. Giải thích và lập kế hoạch
Bắt đầu với các container có mức cảnh báo CRITICAL và HIGH: nêu rõ vấn đề gì đang xảy ra hiện nay, bằng chứng số liệu cụ thể và thay đổi cần áp dụng. Đối với các container đang bị bóp CPU hoặc bị OOM kill, hãy lưu ý rằng các con số sử dụng hiện tại đã bị chạm trần giới hạn và cần lên kế hoạch đo đạc lại lần thứ hai sau khi khắc phục. Tiếp theo, liệt kê các khoản tiết kiệm lớn nhất (số lượng replicas sẽ nhân bội mức tiết kiệm này lên). Kiểm tra các trường hợp ngoại lệ trong `references/rollout-and-guardrails.md` mà việc cắt giảm tài nguyên là không an toàn, đồng thời nhắc nhở việc tinh chỉnh lại ngưỡng HPA khi thay đổi thông số requests.

### 4. Bàn giao kết quả
Điền vào mẫu `templates/rightsizing-plan.md` với bảng tổng hợp, bản vá YAML (YAML patch) cho từng workload, thứ tự triển khai, các chỉ số cần theo dõi và ngày hẹn đo đạc lại.

## Ví dụ kết quả
Đối với tệp `examples/shop-cluster-usage.csv`: container shop/catalog-search/app ở mức CRITICAL (bị OOM kill 3 lần tại ngưỡng giới hạn 1536Mi, mức bộ nhớ p95 là 1180Mi vượt quá mức request 1024Mi, bị bóp CPU 31% tại ngưỡng giới hạn 500m) và được đề xuất mức requests mới là 570m / 1360Mi, giới hạn bộ nhớ 1872Mi và gỡ bỏ hoàn toàn giới hạn CPU; ops/log-shipper hoàn toàn không có thông số requests nào (mức HIGH, chạy 8 replicas); shop/image-resizer cần bổ sung giới hạn bộ nhớ và tăng thêm bộ nhớ; shop/checkout-api/app giảm từ 1000m / 2048Mi xuống còn 485m / 912Mi trên 6 replicas. Tổng cộng giải phóng được 1.76 cores và 4.06 GiB tài nguyên requests, tương đương tiết kiệm khoảng 55 mỗi tháng nếu tính theo đơn giá 24 trên mỗi core và 3.2 trên mỗi GiB.

## Quy tắc

- Luôn khắc phục các rủi ro về độ tin cậy trước khi tối ưu tiết kiệm chi phí, và tuyệt đối không bao giờ khuyến nghị gỡ bỏ giới hạn bộ nhớ (memory limit).
- Luôn nêu rõ mỗi con số đề xuất được tính từ phân vị nào, khoảng thời gian dữ liệu bao lâu và tỷ lệ dự phòng (headroom) là bao nhiêu, đồng thời lưu ý rằng các đợt tăng vọt hiếm gặp nằm ngoài khoảng thời gian thu thập dữ liệu sẽ chưa được tính tới.
- Coi mức sử dụng của các container đang bị bóp CPU (throttled) hoặc bị OOM kill chỉ là mức sàn tối thiểu (floor), chứ chưa phải nhu cầu thực tế của chúng.
- Cung cấp các thay đổi dưới dạng bản vá tệp manifest hoặc Helm values để đội ngũ kỹ thuật xem xét; không tự ý chạy các lệnh `kubectl` trực tiếp lên cụm đang hoạt động.
- Báo cáo mức tiết kiệm dưới dạng "tài nguyên requests được giải phóng" cho tới khi các máy chủ nút (nodes) thực sự được thu hồi giảm bớt.
FILE:references/sizing-method.md
# Phương pháp Tính toán Định mức (Sizing Method)

## Vai trò của requests và limits
- **CPU request:** lượng tài nguyên mà bộ lập lịch (scheduler) đặt chỗ trước trên một node và là tỷ trọng chia sẻ CPU của container đó khi node rơi vào trạng thái bận. Đặt quá thấp: pod bị xếp vào các node chật chội và chạy chậm đi khi tải cao. Đặt quá cao: các node trông có vẻ đã đầy trên sổ sách trong khi thực tế lại đang nhàn rỗi, khiến bạn phải trả tiền cho những lõi CPU bỏ không.
- **CPU limit:** mức trần cứng được thực thi bởi hạn ngạch CFS (CFS quota) theo từng chu kỳ 100 ms. Một container chạm tới ngưỡng này sẽ bị bóp băng thông (throttled), ngay cả khi node đó đang dư thừa CPU nhàn rỗi. Các dịch vụ nhạy cảm với độ trễ (API, proxy, ứng dụng JVM và chương trình Go sử dụng nhiều luồng) sẽ chịu ảnh hưởng nặng nề nhất.
- **Memory request:** lượng bộ nhớ mà bộ lập lịch đặt chỗ trước. Các pod sử dụng nhiều bộ nhớ hơn mức request của chúng sẽ là đối tượng đầu tiên bị trục xuất (evicted) khi một node cạn kiệt bộ nhớ.
- **Memory limit:** mức trần cứng; vượt quá ngưỡng này đồng nghĩa với việc bị OOM kill ngay lập tức (mã thoát 137, lý do `OOMKilled`). Bộ nhớ không thể bị làm chậm (throttled) như CPU.
- **Các hạng QoS (QoS classes):** Guaranteed (requests = limits cho mọi container trong pod), Burstable (có thiết lập một số thông số requests), BestEffort (không thiết lập gì cả, sẽ bị trục xuất đầu tiên khi thiếu tài nguyên).

## Các quy tắc được sử dụng bởi `scripts/rightsize.py`
| Thông số | Quy tắc tính | Lý do |
|---|---|---|
| CPU request | p95 x (1 + headroom), làm tròn lên theo bậc 5m, tối thiểu 10m | đáp ứng tốt các giai đoạn bận rộn thông thường; phần nhu cầu đột biến còn lại sẽ tận dụng nguồn CPU nhàn rỗi dùng chung |
| CPU limit | gỡ bỏ (hoặc nếu dùng cờ `--keep-cpu-limits`: max(max x 1.2, 2 x request)) | giới hạn CPU gây nghẽn các đợt xử lý đột biến ngay cả trên các node đang rảnh |
| Memory request | p95 x (1 + headroom), làm tròn lên theo bậc 16Mi, tối thiểu 32Mi | giữ cho pod nằm ngoài danh sách ưu tiên bị trục xuất (eviction) |
| Memory limit | max(max x 1.25, request), làm tròn lên theo bậc 16Mi | tạo khoảng trống cho các đỉnh tải; không bao giờ được gỡ bỏ vì một lỗi rò rỉ bộ nhớ (memory leak) không được phép đánh sập cả node |

Tỷ lệ dự phòng (headroom) mặc định là 15%. Hãy nâng lên mức 25-30% đối với các lưu lượng có tính chất tăng vọt đột ngột (spiky traffic), các tác vụ chạy theo lô (batch jobs) hoặc khi khoảng thời gian thu thập dữ liệu quá ngắn.

## Các chỉ số cần thu thập
Trên từng container, trong khoảng thời gian ít nhất 7 ngày (tốt nhất là 14-28 ngày để bắt được các đỉnh tải hàng tuần và cuối tháng):
- CPU tính bằng millicores: giá trị p50, p95 và max của `rate(container_cpu_usage_seconds_total[5m]) * 1000`
- Bộ nhớ tính bằng MiB: giá trị p50, p95 và max của `container_memory_working_set_bytes / 2^20` (working set chính là chỉ số mà trình OOM killer và cơ chế trục xuất eviction theo dõi, chứ không phải RSS hay cache)
- Tỷ lệ bóp CPU (Throttling): `container_cpu_cfs_throttled_periods_total / container_cpu_cfs_periods_total * 100`
- Số lần OOM kill: `kube_pod_container_status_last_terminated_reason{reason="OOMKilled"}` hoặc số lần khởi động lại (restarts) với mã thoát 137
- Thiết lập hiện tại: dùng lệnh `kubectl get deploy -o jsonpath` hoặc chỉ số `kube_pod_container_resource_requests` / `_limits`

## Cách đọc kết quả
- **Các container bị bóp CPU (Throttled containers)** sẽ báo cáo mức sử dụng bị chặn đứng tại ngưỡng limit, do đó chỉ số p95 thu được thấp hơn nhu cầu thực tế. Hãy nâng cao hoặc gỡ bỏ giới hạn CPU trước, đo đạc lại trong vài ngày, rồi mới tính toán định mức chuẩn.
- **Các lỗi OOM kill** có nghĩa là mức đỉnh thực sự vẫn chưa xác định được (vì container đã bị giết ngay khi chạm ngưỡng limit). Hãy tăng giới hạn bộ nhớ lên thêm 50% hoặc nhiều hơn, tìm nguyên nhân rò rỉ bộ nhớ hoặc truy vấn nặng gây tốn RAM, sau đó đo đạc lại.
- **Ứng dụng JVM, Node.js và Go** đọc kích thước vùng nhớ heap từ cấu hình khởi chạy: hãy thay đổi các cờ `-Xmx`, `--max-old-space-size` hoặc `GOMEMLIMIT` đồng bộ với giới hạn bộ nhớ của container (giữ vùng nhớ heap ở mức khoảng 70-75% so với memory limit).
- **Các container phụ trợ (Sidecars)** (như istio-proxy, trình đẩy log) cần được tính toán định mức riêng biệt; thông số của chúng sẽ được nhân lên theo từng bản sao (replica) của ứng dụng.
- **HPA dựa trên CPU** thực hiện co giãn dựa trên tỷ lệ giữa mức sử dụng thực tế chia cho thông số request. Việc hạ thấp thông số request sẽ khiến HPA kích hoạt nhân bản (scale out) sớm hơn, vì vậy bạn có thể cần hạ mục tiêu `averageUtilization` hoặc số lượng bản sao sẽ thay đổi. Hãy tối ưu hóa định mức tài nguyên trước, sau đó tinh chỉnh lại HPA.

## Giới hạn của phương pháp này
- Các chỉ số phân vị trong một khung thời gian sẽ bỏ sót các sự kiện hiếm gặp: tác vụ tổng hợp dữ liệu hàng tháng, đợt siêu khuyến mãi, hoặc quá trình dựng lại bộ nhớ đệm (cache rebuild) ngay sau khi triển khai bản mới.
- Mức sử dụng trên mỗi container thường được tính trung bình qua các bản sao (replicas); một phân mảnh nóng (hot shard) hoặc một pod đóng vai trò nút trưởng (leader pod) cần được tách thành một dòng dữ liệu riêng.
- Khả năng xếp khối trên node (node bin-packing), phần tài nguyên tiêu hao cho các DaemonSet và dung lượng bộ nhớ thực tế có thể cấp phát (allocatable memory) mới là yếu tố quyết định mức tiết kiệm thực sự; lượng tài nguyên requests được giải phóng chỉ thực sự chuyển hóa thành tiền tiết kiệm được khi số lượng node giảm xuống.
FILE:references/rollout-and-guardrails.md
# Triển khai và Các Rào chắn An toàn (Rollout and Guardrails)

## Thứ tự thực hiện thay đổi
1. **Khắc phục rủi ro trước tiên:** xử lý các trường hợp bị OOM kill, mức bộ nhớ p95 vượt quá request, bị bóp CPU nặng, hoặc thiếu khai báo requests. Những lỗi này trực tiếp gây ra sự cố hệ thống; việc tiết kiệm chi phí có thể đợi sau.
2. **Sau đó mới cắt giảm lãng phí:** xử lý các container bị cấp phát dư thừa (`OVERPROVISIONED`), ưu tiên những dịch vụ có số lượng bản sao (replica) lớn nhất trước vì mức tiết kiệm sẽ được nhân lên theo số bản sao.
3. **Thực hiện từng workload một,** áp dụng trên môi trường thử nghiệm (staging) trước nếu nơi đó có lưu lượng truy cập sát thực tế, sau đó mới đưa lên môi trường chính thức (production) vào khung giờ thấp điểm.

## Các bước triển khai an toàn
1. Thay đổi thông số requests và limits thông qua Git (trong tệp Helm values, bản vá Kustomize hoặc tệp manifest), tuyệt đối không dùng lệnh `kubectl edit` trực tiếp trên môi trường production.
2. Duy trì tốc độ triển khai cuốn chiếu từ từ: thiết lập `maxUnavailable: 0`, `maxSurge: 25%` kèm theo một `PodDisruptionBudget`, để các pod mới với kích thước tài nguyên mới khởi chạy thành công trước khi các pod cũ bị hủy.
3. Theo dõi sát sao trong 24-48 giờ: độ trễ p95, tỷ lệ lỗi, tỷ lệ bóp CPU (throttling), số lần OOM kill, số lần khởi động lại, số lần bị trục xuất (evictions) và số lượng bản sao do HPA điều chỉnh.
4. Hoàn tác (Rollback) = đảo ngược lại bản commit (revert commit). Việc hạ thấp thông số request không bao giờ tự giết chết các pod đang chạy, nhưng các pod sẽ được tạo lại mới trong quá trình triển khai (rollout).

## Ví dụ bản vá cấu hình (patch)
```yaml
resources:
  requests:
    cpu: 485m
    memory: 912Mi
  limits:
    memory: 1136Mi   # no cpu limit on purpose: avoid CFS throttling
```

## Các rào chắn bảo vệ cụm (Cluster guardrails)
- **LimitRange** trên từng namespace: áp đặt mức requests mặc định và giới hạn bộ nhớ mặc định, nhằm ngăn chặn sự xuất hiện của các pod thuộc hạng BestEffort.
- **ResourceQuota** trên từng namespace: khống chế tổng lượng tài nguyên requests tối đa để một nhóm đơn lẻ không thể chiếm hết toàn bộ tài nguyên của cụm.
- **Vertical Pod Autoscaler (VPA)** ở chế độ `updateMode: "Off"` giúp đưa ra các con số khuyến nghị để đối chiếu với kết quả của kỹ năng này mà không tự động khởi động lại các pod. Không được để VPA (chế độ Auto) và HPA theo dõi CPU hoặc bộ nhớ cùng lúc điều khiển chung một workload.
- **Cảnh báo (Alerts):** có sự kiện OOMKilled trong vòng một giờ qua, tỷ lệ bóp CPU vượt quá 25% kéo dài trong 15 phút, bộ nhớ làm việc (working set) vượt quá 90% ngưỡng limit, hoặc có các pod bị treo ở trạng thái Pending do thiếu tài nguyên.

## Khi nào không nên cắt giảm
- Các workload có những đợt tăng tải đột biến hiếm gặp đã biết trước nhưng chưa xuất hiện trong khoảng thời gian lấy mẫu dữ liệu (chốt sổ cuối tháng, Black Friday, chạy báo cáo quý).
- Các pod có giai đoạn khởi động tiêu tốn nhiều CPU hơn hẳn so với trạng thái chạy ổn định (ví dụ quá trình khởi động làm nóng của JVM): hãy giữ mức request cao hơn hoặc sử dụng cơ chế kiểm tra khởi động (startup probe) với độ trễ rộng rãi.
- Các hệ quản trị cơ sở dữ liệu và bộ nhớ đệm đã được cấu hình cứng kích thước bộ nhớ bên trong (như `maxmemory` của Redis, `shared_buffers` của PostgreSQL): giới hạn bộ nhớ (memory limit) của container bắt buộc phải luôn cao hơn kích thước đã cấu hình cộng với phần bộ nhớ phụ trợ (overhead).
- Các trường hợp chủ đích cần hạng chất lượng dịch vụ Guaranteed QoS (ứng dụng đòi hỏi độ trễ cực thấp, ghim cố định lõi CPU với chính sách static CPU manager): hãy giữ nguyên thông số requests bằng đúng với limits.

## Chuyển hóa lượng requests giải phóng thành tiền tiết kiệm thực tế
Lượng tài nguyên requests được giải phóng chỉ thực sự làm giảm hóa đơn chi phí khi bộ tự động co giãn cụm (cluster autoscaler hoặc Karpenter) có thể gom pod và gỡ bỏ bớt các node dư thừa. Hãy kiểm tra hiệu suất sử dụng node theo tỷ lệ requests sau khi áp dụng thay đổi và chờ khoảng một ngày để quá trình dồn nén (consolidation) diễn ra. Hãy luôn báo cáo mức tiết kiệm là "lượng requests được giải phóng" cho đến khi số lượng node thực sự giảm xuống.
FILE:templates/rightsizing-plan.md
# Kế hoạch Tối ưu hóa Định mức Tài nguyên (Rightsizing Plan) - <cluster / namespace> - <ngày>

**Nguồn dữ liệu:** <Prometheus / Datadog / khác>, từ <ngày đầu> đến <ngày cuối> (<n> ngày)  **Dự phòng (Headroom):** <15>%  **Người phụ trách:** <tên>

## Các rủi ro cần khắc phục trước tiên
| Container | Phát hiện | Bằng chứng | Thay đổi | Hạn hoàn thành |
|---|---|---|---|---|
| | | | | |

## Thông số Requests và Limits
| Container | Replicas | CPU req (hiện tại -> mới) | CPU limit | Mem req (hiện tại -> mới) | Mem limit (hiện tại -> mới) | Trạng thái |
|---|---|---|---|---|---|---|
| | | | | | | |

## Mức tiết kiệm ước tính
- Tài nguyên requests giải phóng được: <cores> cores, <GiB> GiB
- Mức tiết kiệm hàng tháng ước tính: <số tiền> (tính theo đơn giá <giá mỗi core> / <giá mỗi GiB>); chỉ thành tiền thực tế sau khi cụm thu giảm số lượng node

## Lộ trình triển khai (Rollout)
| Bước | Workload | Môi trường | Ngày | Chỉ số theo dõi | Phương án hoàn tác (Rollback) |
|---|---|---|---|---|---|
| 1 | | staging | | độ trễ, OOM, throttling | revert commit |

## Các bước theo dõi tiếp theo
- Đo đạc lại vào ngày <ngày> với số liệu phân vị mới
- Rào chắn an toàn (Guardrails): thiết lập mặc định LimitRange <...>, cảnh báo <...>
FILE:examples/shop-cluster-usage.csv
namespace,workload,container,replicas,cpu_request_m,cpu_limit_m,mem_request_mi,mem_limit_mi,cpu_p50_m,cpu_p95_m,cpu_max_m,mem_p50_mi,mem_p95_mi,mem_max_mi,throttled_pct,oom_kills,days
shop,checkout-api,app,6,1000,2000,2048,2048,180,420,1350,610,780,905,0,0,14
shop,checkout-api,istio-proxy,6,100,2000,128,1024,35,90,240,70,95,120,0,0,14
shop,catalog-search,app,4,500,500,1024,1536,310,495,500,900,1180,1490,31,3,14
shop,image-resizer,worker,3,250,1000,512,,120,380,950,340,610,1720,4,0,14
shop,cart-redis,redis,1,200,,768,1024,40,75,160,690,712,730,0,0,14
ops,log-shipper,fluent-bit,8,,,,,25,60,180,45,70,95,0,0,5
FILE:scripts/rightsize.py
#!/usr/bin/env python3
"""Kubernetes resource requests rightsizer (Python 3 standard library only).

Input: CSV with a header row, one row per container, columns
  namespace,workload,container,replicas,
  cpu_request_m,cpu_limit_m,mem_request_mi,mem_limit_mi,
  cpu_p50_m,cpu_p95_m,cpu_max_m,mem_p50_mi,mem_p95_mi,mem_max_mi,
  throttled_pct,oom_kills,days
CPU in millicores (m), memory in MiB (Mi). Empty request/limit cells mean "not set".
throttled_pct = share of CFS periods throttled (0-100); oom_kills and days may be empty (0 / unknown).

Recommendation per container (headroom default 15%, --headroom):
  cpu request  = p95 x (1 + headroom), rounded up to 5m, at least 10m
  cpu limit    = none (recommended), unless --keep-cpu-limits: max(cpu max x 1.2, 2 x request), 50m steps
  mem request  = p95 x (1 + headroom), rounded up to 16Mi, at least 32Mi
  mem limit    = max(mem max x 1.25, request), rounded up to 16Mi (never removed)
Findings (severity):
  CRITICAL OOM_RISK           OOM kills seen, or memory max >= 95% of the memory limit
  HIGH     NO_REQUESTS        cpu or memory request missing (BestEffort / poor scheduling)
  HIGH     MEM_UNDER_REQUEST  memory p95 above the memory request (eviction risk under node pressure)
  HIGH     CPU_THROTTLED      throttled_pct >= 25
  MEDIUM   CPU_THROTTLED      throttled_pct 10-25
  MEDIUM   CPU_UNDER_REQUEST  cpu p95 above 1.2 x cpu request (noisy neighbours, slow under load)
  MEDIUM   NO_MEMORY_LIMIT    memory limit missing (one leak can take the node down)
  LOW      OVERPROVISIONED    recommended cpu or memory request < 50% of current
  LOW      SHORT_WINDOW       under 7 days of data (misses weekly peaks; trust less)
Savings: (current - recommended requests) x replicas, totals in cores and GiB, and a monthly
estimate when --core-month and --gib-month prices are given.
Usage:
  python3 rightsize.py usage.csv
  python3 rightsize.py usage.csv --headroom 25 --core-month 24 --gib-month 3.2 --json
  python3 rightsize.py --self-test
Exit code: 0 no CRITICAL/HIGH, 1 CRITICAL or HIGH findings, 2 bad input.
"""
import argparse
import csv
import io
import json
import math
import sys

COLUMNS = ("namespace", "workload", "container", "replicas", "cpu_request_m", "cpu_limit_m",
           "mem_request_mi", "mem_limit_mi", "cpu_p50_m", "cpu_p95_m", "cpu_max_m",
           "mem_p50_mi", "mem_p95_mi", "mem_max_mi", "throttled_pct", "oom_kills", "days")
OPTIONAL = {"cpu_request_m", "cpu_limit_m", "mem_request_mi", "mem_limit_mi", "throttled_pct", "oom_kills", "days"}
SEV_ORDER = {"CRITICAL": 0, "HIGH": 1, "MEDIUM": 2, "LOW": 3}


class DataError(ValueError):
    pass


def up(x, step):
    return int(math.ceil(x / step - 1e-9) * step)


def num(row, col, line):
    v = row.get(col, "")
    if v == "":
        if col in OPTIONAL:
            return None
        raise DataError(f"line {line}: {col} is required")
    try:
        x = float(v)
    except ValueError:
        raise DataError(f"line {line}: {col} must be a number, got {v!r}")
    if x < 0:
        raise DataError(f"line {line}: {col} must be >= 0")
    return x


def read_rows(text):
    rd = csv.DictReader(io.StringIO(text))
    if not rd.fieldnames:
        raise DataError("empty CSV")
    missing = [c for c in COLUMNS if c not in {f.strip() for f in rd.fieldnames}]
    if missing:
        raise DataError("CSV header is missing: " + ", ".join(missing))
    rows = []
    for n, raw in enumerate(rd, start=2):
        row = {k.strip(): (v or "").strip() for k, v in raw.items() if k}
        if not any(row.values()):
            continue
        r = {c: row[c] for c in ("namespace", "workload", "container")}
        for c in COLUMNS[3:]:
            r[c] = num(row, c, n)
        if r["replicas"] < 1:
            raise DataError(f"line {n}: replicas must be >= 1")
        if r["cpu_p95_m"] > r["cpu_max_m"] or r["mem_p95_mi"] > r["mem_max_mi"]:
            raise DataError(f"line {n}: p95 cannot be above max")
        rows.append(r)
    if not rows:
        raise DataError("no data rows")
    return rows


def analyze(r, headroom=0.15, keep_cpu_limits=False):
    h = 1 + headroom
    rec = {
        "cpu_request_m": max(10, up(r["cpu_p95_m"] * h, 5)),
        "mem_request_mi": max(32, up(r["mem_p95_mi"] * h, 16)),
    }
    rec["cpu_limit_m"] = max(up(r["cpu_max_m"] * 1.2, 50), up(2 * rec["cpu_request_m"], 50)) if keep_cpu_limits else None
    rec["mem_limit_mi"] = max(rec["mem_request_mi"], up(r["mem_max_mi"] * 1.25, 16))
    findings = []

    def f(sev, code, msg):
        findings.append({"severity": sev, "code": code, "message": msg})

    cr, cl, mr, ml = r["cpu_request_m"], r["cpu_limit_m"], r["mem_request_mi"], r["mem_limit_mi"]
    oom = r["oom_kills"] or 0
    if oom > 0:
        f("CRITICAL", "OOM_RISK", f"{oom:g} OOM kill(s); memory max {r['mem_max_mi']:g}Mi vs limit {fmt(ml, 'Mi')}")
    elif ml and r["mem_max_mi"] >= 0.95 * ml:
        f("CRITICAL", "OOM_RISK", f"memory max {r['mem_max_mi']:g}Mi is {r['mem_max_mi'] / ml:.0%} of the {ml:g}Mi limit")
    if cr is None or mr is None:
        f("HIGH", "NO_REQUESTS", "missing " + " and ".join(x for x, v in (("cpu request", cr), ("memory request", mr)) if v is None))
    if mr and r["mem_p95_mi"] > mr:
        f("HIGH", "MEM_UNDER_REQUEST", f"memory p95 {r['mem_p95_mi']:g}Mi > request {mr:g}Mi")
    th = r["throttled_pct"] or 0
    if th >= 25:
        f("HIGH", "CPU_THROTTLED", f"{th:g}% of CPU periods throttled at limit {fmt(cl, 'm')}; usage is capped, so real demand is higher")
    elif th >= 10:
        f("MEDIUM", "CPU_THROTTLED", f"{th:g}% of CPU periods throttled at limit {fmt(cl, 'm')}")
    if cr and r["cpu_p95_m"] > 1.2 * cr:
        f("MEDIUM", "CPU_UNDER_REQUEST", f"cpu p95 {r['cpu_p95_m']:g}m > 1.2 x request {cr:g}m")
    if ml is None:
        f("MEDIUM", "NO_MEMORY_LIMIT", "no memory limit set")
    over = []
    if cr and rec["cpu_request_m"] < 0.5 * cr:
        over.append(f"cpu {cr:g}m -> {rec['cpu_request_m']}m")
    if mr and rec["mem_request_mi"] < 0.5 * mr:
        over.append(f"memory {mr:g}Mi -> {rec['mem_request_mi']}Mi")
    if over:
        f("LOW", "OVERPROVISIONED", "; ".join(over))
    if r["days"] is not None and r["days"] < 7:
        f("LOW", "SHORT_WINDOW", f"only {r['days']:g} days of data")
    findings.sort(key=lambda x: SEV_ORDER[x["severity"]])
    status = findings[0]["severity"] if findings and findings[0]["severity"] != "LOW" else "OK"
    n = r["replicas"]
    d_cpu = ((cr or 0) - rec["cpu_request_m"]) * n
    d_mem = ((mr or 0) - rec["mem_request_mi"]) * n
    return {"id": f"{r['namespace']}/{r['workload']}/{r['container']}", "replicas": int(n), "current": {
        "cpu_request_m": cr, "cpu_limit_m": cl, "mem_request_mi": mr, "mem_limit_mi": ml},
        "recommended": rec, "delta_cpu_m": d_cpu, "delta_mem_mi": d_mem, "status": status, "findings": findings}


def run(text, headroom=0.15, keep_cpu_limits=False, core_month=None, gib_month=None):
    res = [analyze(r, headroom, keep_cpu_limits) for r in read_rows(text)]
    res.sort(key=lambda x: (SEV_ORDER.get(x["status"], 4), x["id"]))
    tot_cpu = sum(x["delta_cpu_m"] for x in res) / 1000
    tot_mem = sum(x["delta_mem_mi"] for x in res) / 1024
    out = {"containers": res, "freed_cores": round(tot_cpu, 3), "freed_gib": round(tot_mem, 3)}
    if core_month is not None and gib_month is not None:
        out["monthly_saving"] = round(tot_cpu * core_month + tot_mem * gib_month, 2)
    return out


def fmt(v, unit):
    return "none" if v is None else f"{v:g}{unit}"


def report(out, headroom):
    L = ["# Kubernetes rightsizing report", "",
         f"Requests = p95 + {headroom:.0%} headroom; CPU limits removed unless kept; memory limit = max x 1.25.", "",
         "| Container | Replicas | Status | CPU req | CPU limit | Mem req | Mem limit |",
         "|---|---|---|---|---|---|---|"]
    for x in out["containers"]:
        c, r = x["current"], x["recommended"]
        L.append(f"| {x['id']} | {x['replicas']} | {x['status']} | {fmt(c['cpu_request_m'], 'm')} -> {r['cpu_request_m']}m"
                 f" | {fmt(c['cpu_limit_m'], 'm')} -> {fmt(r['cpu_limit_m'], 'm')}"
                 f" | {fmt(c['mem_request_mi'], 'Mi')} -> {r['mem_request_mi']}Mi"
                 f" | {fmt(c['mem_limit_mi'], 'Mi')} -> {r['mem_limit_mi']}Mi |")
    L += ["", "## Findings"]
    any_f = False
    for x in out["containers"]:
        for f in x["findings"]:
            any_f = True
            L.append(f"- {f['severity']} {f['code']} {x['id']}: {f['message']}")
    if not any_f:
        L.append("- none")
    L += ["", "## Requests freed (negative = more needed)",
          f"- CPU: {out['freed_cores']:g} cores", f"- Memory: {out['freed_gib']:g} GiB"]
    if "monthly_saving" in out:
        L.append(f"- Estimated monthly saving: {out['monthly_saving']:,.2f}")
    return "\n".join(L) + "\n"


def self_test():
    cases = []

    def ok(name, cond):
        cases.append(bool(cond))
        print(("PASS " if cond else "FAIL ") + name)

    hdr = ",".join(COLUMNS) + "\n"

    def row(**kw):
        base = dict(namespace="ns", workload="w", container="c", replicas=1, cpu_request_m=500, cpu_limit_m=1000,
                    mem_request_mi=512, mem_limit_mi=1024, cpu_p50_m=100, cpu_p95_m=200, cpu_max_m=300,
                    mem_p50_mi=200, mem_p95_mi=300, mem_max_mi=400, throttled_pct=0, oom_kills=0, days=14)
        base.update(kw)
        return ",".join("" if base[c] is None else str(base[c]) for c in COLUMNS) + "\n"

    def one(**kw):
        return run(hdr + row(**kw))["containers"][0]

    def codes(x):
        return {(f["severity"], f["code"]) for f in x["findings"]}

    x = one()
    ok("cpu request = p95 x 1.15 rounded to 5m (230)", x["recommended"]["cpu_request_m"] == 230)
    ok("mem request = 300 x 1.15 = 345 -> 352Mi", x["recommended"]["mem_request_mi"] == 352)
    ok("mem limit = 400 x 1.25 = 500 -> 512Mi", x["recommended"]["mem_limit_mi"] == 512)
    ok("cpu limit removed by default", x["recommended"]["cpu_limit_m"] is None)
    ok("healthy container is OK", x["status"] == "OK")
    ok("headroom 0.25 changes cpu request (250)", run(hdr + row(), headroom=0.25)["containers"][0]["recommended"]["cpu_request_m"] == 250)
    k = run(hdr + row(), keep_cpu_limits=True)["containers"][0]["recommended"]["cpu_limit_m"]
    ok("kept cpu limit = max(360->400, 460->500) = 500", k == 500)
    ok("minimums 10m / 32Mi", one(cpu_p50_m=0, cpu_p95_m=1, cpu_max_m=2, mem_p50_mi=1, mem_p95_mi=2, mem_max_mi=3)["recommended"]
       == {"cpu_request_m": 10, "mem_request_mi": 32, "cpu_limit_m": None, "mem_limit_mi": 32})
    ok("OOM kills -> CRITICAL", ("CRITICAL", "OOM_RISK") in codes(one(oom_kills=2)) and one(oom_kills=2)["status"] == "CRITICAL")
    ok("max at 98% of limit -> OOM_RISK", ("CRITICAL", "OOM_RISK") in codes(one(mem_max_mi=1004, mem_p95_mi=500)))
    ok("missing requests -> HIGH NO_REQUESTS", ("HIGH", "NO_REQUESTS") in codes(one(cpu_request_m=None)))
    ok("mem p95 above request -> HIGH", ("HIGH", "MEM_UNDER_REQUEST") in codes(one(mem_request_mi=256)))
    ok("throttling 30% -> HIGH", ("HIGH", "CPU_THROTTLED") in codes(one(throttled_pct=30)))
    ok("throttling 12% -> MEDIUM", ("MEDIUM", "CPU_THROTTLED") in codes(one(throttled_pct=12)))
    ok("cpu p95 > 1.2 x request -> MEDIUM", ("MEDIUM", "CPU_UNDER_REQUEST") in codes(one(cpu_request_m=150)))
    ok("no memory limit -> MEDIUM", ("MEDIUM", "NO_MEMORY_LIMIT") in codes(one(mem_limit_mi=None)))
    big = one(cpu_request_m=2000, mem_request_mi=4096)
    ok("overprovisioned flagged LOW, status stays OK", ("LOW", "OVERPROVISIONED") in codes(big) and big["status"] == "OK")
    ok("short window flagged", ("LOW", "SHORT_WINDOW") in codes(one(days=3)))
    two = run(hdr + row(replicas=3) + row(workload="b", replicas=2, cpu_request_m=100, mem_request_mi=256),
              core_month=20, gib_month=4)
    # w: (500-230)*3=810m, (512-352)*3=480Mi ; b: (100-230)*2=-260m, (256-352)*2=-192Mi
    ok("freed cores = (810-260)/1000 = 0.55", two["freed_cores"] == 0.55)
    ok("freed GiB = (480-192)/1024 = 0.281", two["freed_gib"] == 0.281)
    ok("monthly saving = 0.55 x 20 + 0.28125 x 4 = 12.125", abs(two["monthly_saving"] - 12.125) < 0.01)
    ok("sorted by severity", two["containers"][0]["id"] == "ns/b/c")
    for bad, label in (("a,b\n1,2\n", "missing columns"), (hdr, "no rows"), (hdr + row(cpu_p95_m="x"), "bad number"),
                       (hdr + row(cpu_p95_m=900), "p95 above max"), (hdr + row(replicas=0), "zero replicas"),
                       (hdr + row(cpu_p95_m=None), "missing usage")):
        try:
            run(bad)
            ok(label + " rejected", False)
        except DataError:
            ok(label + " rejected", True)
    print(f"{sum(cases)}/{len(cases)} passed")
    return 0 if all(cases) else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="Rightsize Kubernetes container requests and limits from usage percentiles.")
    ap.add_argument("file", nargs="?", help="CSV with the columns listed in the module docstring")
    ap.add_argument("--headroom", type=float, default=15, help="percent added to p95 for requests (default 15)")
    ap.add_argument("--keep-cpu-limits", action="store_true", help="recommend CPU limits instead of removing them")
    ap.add_argument("--core-month", type=float, help="price of one requested core per month")
    ap.add_argument("--gib-month", type=float, help="price of one requested GiB of memory per month")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    if not a.file:
        ap.error("give a CSV file or --self-test")
    try:
        out = run(open(a.file, encoding="utf-8").read(), a.headroom / 100, a.keep_cpu_limits, a.core_month, a.gib_month)
    except (OSError, DataError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(out, indent=2) if a.json else report(out, a.headroom / 100), end="\n" if a.json else "")
    return 1 if any(x["status"] in ("CRITICAL", "HIGH") for x in out["containers"]) else 0


if __name__ == "__main__":
sys.exit(main())Kiểm tra ngoại tuyến tệp robots.txt và XML sitemap của trang web theo đúng cách Google đọc chúng. Chọn nhóm trình thu thập dữ liệu (crawler), phân giải quy tắc Allow và Disallow có độ dài khớp lớn nhất (longest-match) kèm ký tự đại diện (wildcards), đồng thời kiểm thử các URL bắt buộc phải cho phép thu thập hoặc bị chặn. Cảnh báo lỗi chặn toàn bộ trang web, các URL trong sitemap bị robots.txt chặn, chặn tệp CSS và JS, các dòng noindex và crawl-delay không được hỗ trợ, cũng như các mục nhập sitemap nằm ngoài trang (off-site), trùng lặp hoặc không hợp lệ. Bao gồm một công cụ kiểm tra bằng thư viện chuẩn Python có hỗ trợ cờ --self-test.
---
name: robots-txt-and-sitemap-checker
description: Kiểm tra ngoại tuyến tệp robots.txt và XML sitemap của trang web theo đúng cách Google đọc chúng. Chọn nhóm trình thu thập dữ liệu (crawler), phân giải quy tắc Allow và Disallow có độ dài khớp lớn nhất (longest-match) kèm ký tự đại diện (wildcards), đồng thời kiểm thử các URL bắt buộc phải cho phép thu thập hoặc bị chặn. Cảnh báo lỗi chặn toàn bộ trang web, các URL trong sitemap bị robots.txt chặn, chặn tệp CSS và JS, các dòng noindex và crawl-delay không được hỗ trợ, cũng như các mục nhập sitemap nằm ngoài trang (off-site), trùng lặp hoặc không hợp lệ. Bao gồm một công cụ kiểm tra bằng thư viện chuẩn Python có hỗ trợ cờ --self-test.
---

# Trình Kiểm tra Robots.txt và Sitemap

Bạn giúp chủ sở hữu trang web, chuyên gia SEO và nhà phát triển web đảm bảo các công cụ tìm kiếm có thể thu thập dữ liệu (crawl) những trang quan trọng và bỏ qua những trang không cần thiết. Từ tệp robots.txt, XML sitemap và danh sách các URL quan trọng, bạn chỉ rõ quy tắc nào quyết định trạng thái của từng URL, tìm ra những mâu thuẫn giữa robots.txt và sitemap, giải thích từng vấn đề bằng ngôn ngữ dễ hiểu, đồng thời đề xuất bản robots.txt đã sửa lỗi cùng các chỉnh sửa cho sitemap.

## Các tệp trong kỹ năng này

- `scripts/crawl_check.py` - phân tích cú pháp robots.txt và một sitemap, quyết định trạng thái cho phép (allowed) hay chặn (blocked) trên từng URL giống hệt Googlebot, đồng thời in ra bảng URL cùng các phát hiện lỗi (chỉ dùng thư viện chuẩn của Python 3, không dùng mạng)
- `references/robots-txt-rules.md` - các nhóm (groups), quy tắc khớp dài nhất (longest-match) và ký tự đại diện (wildcard) kèm ví dụ, các chỉ thị được hỗ trợ, những sai lầm phổ biến và cách kiểm thử
- `references/sitemap-rules-and-fixes.md` - định dạng và giới hạn của sitemap, những gì nên liệt kê, thẻ lastmod, và cách khắc phục cho từng phát hiện lỗi
- `templates/crawl-audit-report.md` - mẫu báo cáo kiểm toán thu thập dữ liệu kèm bản đề xuất robots.txt để bàn giao cho nhà phát triển
- `examples/outdoor-shop-crawl-check.json` - một cửa hàng đồ dã ngoại sau khi ra mắt lại giao diện: phần blog và tệp JS vô tình bị chặn, có một dòng noindex, đường dẫn quản trị (admin) bị bỏ ngỏ, cùng một sitemap chứa các URL bị chặn, nằm ngoài tên miền (off-site), bị trùng lặp và ghi sai định dạng ngày tháng

## Quy trình làm việc

### 1. Thu thập các tệp
Hãy yêu cầu tệp robots.txt đang chạy thực tế (`https://<host>/robots.txt`), tệp sitemap hoặc sitemap index, địa chỉ gốc chuẩn tắc (canonical origin gồm giao thức scheme và tên miền host), cùng hai danh sách ngắn: các URL bắt buộc phải thu thập được (trang chủ, danh mục, sản phẩm hoặc bài viết hàng đầu, các gói CSS/JS) và các URL cần phải chặn (giỏ hàng, thanh toán, tìm kiếm nội bộ, bộ lọc, trang quản trị admin). Hỏi xem trình thu thập dữ liệu (crawler) nào là quan trọng nhất đối với họ (mặc định là Googlebot).

### 2. Chạy công cụ kiểm tra
```
python3 scripts/crawl_check.py examples/outdoor-shop-crawl-check.json --today 2026-10-23
python3 scripts/crawl_check.py --robots robots.txt --sitemap sitemap.xml --site https://www.example.com --allow /product/x --block /cart/
python3 scripts/crawl_check.py --self-test
```
Một tệp JSON đóng gói sẽ chứa thông tin trang web, tên crawler, các dòng trong robots.txt và sitemap cùng các danh sách URL. Mã thoát (exit code) bằng 1 nghĩa là có phát hiện lỗi mức CRITICAL hoặc HIGH, bằng 2 nghĩa là dữ liệu đầu vào không hợp lệ.

### 3. Giải thích và khắc phục
Bắt đầu với các lỗi mức CRITICAL và HIGH: chặn toàn bộ trang web, chặn các trang quan trọng, các URL có trong sitemap nhưng bị robots.txt chặn, các mục nhập trong sitemap trỏ ra ngoài tên miền (off-site). Với mỗi lỗi, hãy nêu rõ dòng quy tắc quyết định và đưa ra quy tắc đã sửa lại cho đúng. Giải thích rằng robots.txt không xóa các trang khỏi kết quả tìm kiếm và cũng không bảo vệ các trang riêng tư (`references/robots-txt-rules.md`), đồng thời chỉ dẫn tới bảng cách khắc phục trong `references/sitemap-rules-and-fixes.md`.

### 4. Bàn giao kết quả
Điền vào mẫu `templates/crawl-audit-report.md` với bảng kiểm tra URL, các phát hiện lỗi, toàn bộ nội dung tệp robots.txt hoàn chỉnh đã sửa và các thay đổi cần thiết cho bộ tạo sitemap (sitemap generator), sau đó chạy lại công cụ kiểm tra trên các tệp đã sửa để xác nhận.

## Ví dụ kết quả
Đối với tệp `examples/outdoor-shop-crawl-check.json`, trạng thái đánh giá là HIGH: chỉ thị `Disallow: /blog/` (dòng 9) đã chặn đường dẫn /blog/trail-running-shoes-review và trang /blog/spring-sale-recap đang được liệt kê trong sitemap, `Disallow: /assets/js/` chặn gói bundle của ứng dụng, và đường dẫn http://trailgear.example/backpacks/ trong sitemap bị tính là khác nguồn (off-site). Dòng `Noindex: /search/` bị Google bỏ qua, vì vậy /search/ và /admin/ vẫn có thể bị thu thập dữ liệu; ngoài ra sitemap còn có một đường dẫn /tents/ bị trùng lặp, một thẻ lastmod ghi năm 2027 và một thẻ ghi theo định dạng `18.10.2026`.

## Quy tắc

- Luôn nêu chính xác số dòng trong tệp robots.txt quyết định trạng thái của một URL, cùng với tên crawler đã được dùng để đánh giá.
- Tuyệt đối không bao giờ khuyên dùng robots.txt để ẩn các trang riêng tư hoặc nhạy cảm; hãy yêu cầu dùng cơ chế xác thực đăng nhập (authentication), và dùng thẻ `noindex` cho những trang cần loại khỏi kết quả tìm kiếm.
- Luôn cung cấp một tệp robots.txt hoàn chỉnh đã sửa lỗi chứ không chỉ đưa ra các đoạn trích rời rạc, đồng thời giữ nguyên các quy tắc mà chủ sở hữu trang web đã chủ đích thêm vào (ví dụ như chặn AhrefsBot).
- Công cụ kiểm tra không trực tiếp tải các URL qua mạng; hãy nói rõ rằng việc kiểm tra mã trạng thái HTTP (status codes), chuyển hướng (redirects), thẻ canonical và thẻ noindex cần phải thực hiện bằng trình thu thập thực tế hoặc qua Search Console.
FILE:references/robots-txt-rules.md
# Các quy tắc robots.txt (RFC 9309 và Google)

## Vị trí và bản chất
- Nằm ở thư mục gốc của từng tên miền (host) và giao thức (protocol): `https://www.example.com/robots.txt` chỉ có hiệu lực cho đúng tên miền và giao thức đó. Các biến thể `example.com`, `shop.example.com` và `http://` đều cần có tệp riêng của mình.
- Định dạng văn bản thuần túy (plain text), bảng mã UTF-8. Google chỉ đọc 500 KiB đầu tiên. Mã lỗi 404 đồng nghĩa với "cho phép thu thập mọi thứ"; mã lỗi máy chủ 5xx kéo dài có thể khiến Google ngừng thu thập dữ liệu toàn bộ trang web.
- Tệp robots.txt kiểm soát việc **thu thập dữ liệu (crawling)**, chứ không kiểm soát việc **lập chỉ mục (indexing)**. Một URL bị chặn vẫn có thể xuất hiện trên kết quả tìm kiếm (nhưng không có đoạn trích mô tả snippet) nếu có các trang khác đặt liên kết trỏ tới nó. Để giữ một trang không xuất hiện trên kết quả tìm kiếm, hãy cho phép thu thập dữ liệu và trả về chỉ thị `noindex`; để giữ trang ở chế độ riêng tư, hãy yêu cầu đăng nhập.

## Các nhóm (Groups)
```
User-agent: Googlebot
User-agent: Bingbot
Disallow: /tmp/

User-agent: *
Disallow: /cart/
```
- Các dòng `User-agent` nằm liền kề nhau sẽ dùng chung một nhóm. Các quy tắc bên dưới thuộc về nhóm ngay phía trên chúng.
- Một trình thu thập dữ liệu chỉ sử dụng **duy nhất một** nhóm: nhóm có tên khớp cụ thể nhất (`googlebot-image` được ưu tiên hơn `googlebot`), nếu không có mới dùng nhóm `*`. Các quy tắc từ nhóm `*` không được cộng gộp vào nhóm có tên cụ thể, vì vậy một lỗi rất phổ biến là tạo nhóm `Googlebot` riêng nhưng lại quên lặp lại các quy tắc chặn cơ bản đã viết trong nhóm `*`.
- Các nhóm có cùng tên sẽ được gộp lại với nhau.

## Cơ chế so khớp (Matching)
- Đường dẫn có phân biệt chữ hoa chữ thường (case-sensitive) và được so khớp tính từ đầu đường dẫn (bao gồm cả chuỗi truy vấn query string).
- Ký tự `*` khớp với bất kỳ chuỗi ký tự nào; ký tự `$` neo cố định điểm kết thúc của URL.
- Quy tắc khớp có **độ dài lớn nhất** (longest match) sẽ chiến thắng; nếu có độ dài bằng nhau thì chỉ thị `Allow` sẽ chiến thắng. Nếu không có quy tắc nào khớp thì mặc định là được phép thu thập (allowed).
- Chỉ thị `Disallow:` để trống giá trị đồng nghĩa với việc cho phép tất cả.

| Quy tắc | Chặn | Không chặn |
|---|---|---|
| `Disallow: /shop` | /shop, /shop/, /shopping | /Shop |
| `Disallow: /shop/` | /shop/shoes | /shop |
| `Disallow: /*?sort=` | /tents/?sort=price | /tents/?color=red&sort=price (cần dùng `/*sort=`) |
| `Disallow: /*.pdf$` | /docs/a.pdf | /docs/a.pdf?v=2 |
| `Disallow: /blog/` + `Allow: /blog/guides/` | /blog/news | /blog/guides/x |

## Các chỉ thị (Directives)
| Chỉ thị | Google hỗ trợ | Ghi chú |
|---|---|---|
| user-agent, allow, disallow | có | các quy tắc cốt lõi |
| sitemap | có | URL tuyệt đối, không giới hạn số lượng, đặt bên ngoài các nhóm |
| crawl-delay | không | Bing và Yandex có tuân thủ; đối với Google, hãy giảm tốc độ thu thập thông qua mã phản hồi từ máy chủ (429/503) |
| noindex, nofollow | không (đã ngừng hỗ trợ từ 2019) | hãy dùng thẻ `<meta name="robots" content="noindex">` hoặc tiêu đề HTTP `X-Robots-Tag` |
| host, clean-param | không | chỉ dành cho Yandex |

## Những sai lầm phổ biến
- Dòng `Disallow: /` còn sót lại từ môi trường thử nghiệm (staging) sau khi trang web chính thức ra mắt (khiến toàn bộ trang web biến mất khỏi luồng thu thập dữ liệu).
- Chặn các thư mục chứa CSS, JS hoặc hình ảnh: Google cần dựng hình (render) trang web và bắt buộc phải tải các tệp này; việc chặn tài nguyên có thể khiến trang web trông như bị lỗi giao diện hoặc bị đánh giá là không thân thiện với thiết bị di động.
- Chặn một trang đang gắn thẻ `noindex`: trình thu thập dữ liệu không bao giờ vào được trang để đọc thấy thẻ noindex, dẫn đến việc URL đó vẫn tiếp tục nằm lại trong chỉ mục tìm kiếm.
- Dùng robots.txt để giấu trang quản trị (admin) hoặc các trang riêng tư: tệp robots.txt hoàn toàn công khai và vô tình liệt kê chính xác vị trí của các trang nhạy cảm đó cho mọi người thấy.
- Để ngỏ các URL phân mảnh theo bộ lọc (sắp xếp, lọc thuộc tính, mã phiên session id), gây lãng phí ngân sách thu thập dữ liệu (crawl budget) vào vô số tổ hợp URL trùng lặp.
- Lỗi chính tả (ví dụ `Disalow`) sẽ bị lặng lẽ bỏ qua mà không có cảnh báo.

## Kiểm thử
- Google Search Console: báo cáo robots.txt (kiểm tra trạng thái tải tệp và các quy tắc đã phân tích) cùng công cụ Kiểm tra URL (URL Inspection - xem có bị chặn hay không).
- Trên máy cục bộ: `python3 scripts/crawl_check.py --robots robots.txt --site https://www.example.com --allow /product/x --block /cart/`.
FILE:references/sitemap-rules-and-fixes.md
# Các quy tắc và cách khắc phục lỗi XML Sitemap

## Định dạng
```xml
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://www.example.com/tents/ultralight-2p</loc>
    <lastmod>2026-10-18T09:30:00+03:00</lastmod>
  </url>
</urlset>
```
- Tối đa **50,000 URLs** và dung lượng khi chưa nén tối đa **50 MB** trên mỗi tệp. Các trang web lớn hơn cần sử dụng tệp chỉ mục sơ đồ trang web (sitemap index dùng thẻ `<sitemapindex>` chứa các mục `<sitemap><loc>`), cho phép quản lý tối đa 50,000 tệp sitemap con.
- Bảng mã UTF-8, bắt buộc mã hóa thực thể (entity-escape) cho các ký tự `&`, `<`, `>`, `'`, `"` nằm bên trong thẻ `<loc>`.
- Giá trị trong `<loc>` phải là đường dẫn tuyệt đối, sử dụng cùng giao thức (protocol) và tên miền (host) với chính tệp sitemap đó (trừ khi được gửi chéo thông qua Search Console cho một tên miền đã xác minh quyền sở hữu).

## Những gì cần đưa vào danh sách
- Chỉ liệt kê các URL chuẩn tắc (canonical), có thể lập chỉ mục và trả về mã 200: không đưa vào các đường dẫn chuyển hướng (redirects), lỗi 404, các trang gắn `noindex`, các URL bị chặn bởi robots.txt, hoặc các URL trùng lặp do tham số.
- Phải khớp chính xác dạng thức chuẩn tắc: cùng giao thức (https), cùng tên miền (có www hoặc không có www), cùng quy ước dấu gạch chéo cuối câu (trailing-slash) giống hệt như trong thẻ `rel=canonical`.
- Mỗi URL chỉ xuất hiện duy nhất một lần.

## Thẻ lastmod
- Định dạng ngày giờ theo chuẩn W3C datetime: `2026-10-18`, `2026-10-18T09:30+03:00` hoặc `2026-10-18T06:30:00Z`. Các định dạng như `18.10.2026` hay `10/18/2026` đều không hợp lệ.
- Hãy đặt giá trị này theo thời điểm có thay đổi nội dung **thực sự có ý nghĩa** lần cuối cùng, chứ không phải thời điểm chạy tiến trình xuất bản (build time). Google chỉ sử dụng `lastmod` khi thấy giá trị này chính xác một cách nhất quán; việc để ngày tháng ở tương lai hoặc cập nhật lại ngày mới cho mọi URL mỗi ngày sẽ khiến Google học cách phớt lờ hoàn toàn trường thông tin này.
- Hai thẻ `<changefreq>` và `<priority>` bị Google bỏ qua hoàn toàn; chúng không gây hại gì nhưng không đáng tốn công duy trì.

## Cách thông báo sitemap cho các trình thu thập dữ liệu
- Khai báo dòng `Sitemap: https://www.example.com/sitemap.xml` trong tệp robots.txt (dùng URL tuyệt đối).
- Gửi trực tiếp trong Google Search Console và Bing Webmaster Tools, sau đó theo dõi số lượng trang "Đã phát hiện" (Discovered) và "Đã lập chỉ mục" (Indexed) cùng các thông báo lỗi.

## Cách khắc phục theo từng mã phát hiện lỗi
| Mã phát hiện | Cách khắc phục |
|---|---|
| SITEMAP_URL_BLOCKED | Hãy quyết định rõ: nếu trang đó cần được xếp hạng tìm kiếm, hãy gỡ bỏ dòng Disallow; nếu không cần, hãy xóa nó khỏi tệp sitemap |
| SITEMAP_OFF_SITE | Viết lại giá trị `<loc>` theo đúng giao thức và tên miền chuẩn tắc; kiểm tra lại thiết lập URL gốc (base URL) trong công cụ tạo sitemap |
| SITEMAP_DUPLICATE | Khử trùng lặp ngay trong công cụ tạo sitemap (thường do cùng một trang bị xuất ra ở cả danh sách danh mục và danh sách thẻ tag) |
| LASTMOD_INVALID / LASTMOD_FUTURE | Xuất định dạng chuẩn ISO 8601 lấy từ trường thời gian cập nhật thực tế của nội dung; kiểm tra lại múi giờ và đồng hồ của máy chủ |
| SITEMAP_TOO_BIG | Chia nhỏ theo chuyên mục hoặc theo mốc thời gian thành nhiều tệp con nằm dưới một tệp sitemap index duy nhất |
| SITEMAP_PARSE_ERROR | Mã hóa ký tự `&` trong các URL, xóa ký tự BOM ở đầu tệp hoặc khắc phục lỗi máy chủ trả về trang báo lỗi HTML thay vì tệp XML, kiểm tra lại khai báo namespace |

## Những yếu tố nằm ngoài phạm vi công cụ này
Tập lệnh hoạt động ngoại tuyến trên các tệp bạn cung cấp. Bạn cần kiểm tra thêm bằng trình thu thập dữ liệu thực tế hoặc Search Console đối với: mã trạng thái HTTP thực tế của các URL trong danh sách, chuỗi chuyển hướng (redirects), thẻ canonical, thẻ noindex và các liên kết ngôn ngữ thay thế hreflang.
FILE:templates/crawl-audit-report.md
# Báo cáo Kiểm toán Thu thập Dữ liệu (Crawl Audit) - <trang web> - <ngày>

**Đã kiểm tra:** robots.txt (<tải ngày / phiên bản>), <URL của sitemap>  **Trình thu thập:** <Googlebot>  **Người đánh giá:** <tên>

## Tóm tắt
- Trạng thái: <CRITICAL / HIGH / OK>
- robots.txt: <n> nhóm, <n> quy tắc áp dụng cho <crawler>
- Sitemap: <n> URL, <n> bị chặn, <n> khác tên miền (off-site), <n> bị trùng lặp

## Các URL quan trọng
| URL | Trạng thái mong muốn | Kết quả thực tế | Quy tắc quyết định | Cách khắc phục |
|---|---|---|---|---|
| | crawlable | | | |
| | blocked | | | |

## Các phát hiện lỗi và cách khắc phục
| Mức độ nghiêm trọng | Phát hiện | Chi tiết | Cách khắc phục | Người phụ trách |
|---|---|---|---|---|
| | | | | |

## Đề xuất tệp robots.txt mới
```
User-agent: *
Disallow: ...
Allow: ...

Sitemap: https://...
```

## Các bước theo dõi tiếp theo
- Triển khai tệp robots.txt và sitemap mới vào ngày <ngày>; kiểm thử lại trong Search Console (báo cáo robots.txt, công cụ Kiểm tra URL)
- Kiểm tra lại độ phủ chỉ mục (coverage) và thống kê thu thập dữ liệu (crawl stats) vào ngày <ngày>
FILE:examples/outdoor-shop-crawl-check.json
{
  "site": "https://www.trailgear.example",
  "user_agent": "Googlebot",
  "robots_txt": [
    "# robots.txt for www.trailgear.example (after the October relaunch)",
    "User-agent: *",
    "Disallow: /cart/",
    "Disallow: /checkout/",
    "Disallow: /account/",
    "Disallow: /*?sort=",
    "Disallow: /*?sessionid=",
    "Disallow: /assets/js/",
    "Disallow: /blog/",
    "Allow: /blog/guides/",
    "Crawl-delay: 10",
    "Noindex: /search/",
    "",
    "User-agent: AhrefsBot",
    "Disallow: /",
    "",
    "Sitemap: https://www.trailgear.example/sitemap.xml"
  ],
  "sitemap_xml": [
    "<?xml version=\"1.0\" encoding=\"UTF-8\"?>",
    "<urlset xmlns=\"http://www.sitemaps.org/schemas/sitemap/0.9\">",
    "  <url><loc>https://www.trailgear.example/</loc><lastmod>2026-10-20</lastmod></url>",
    "  <url><loc>https://www.trailgear.example/tents/</loc><lastmod>2026-10-18</lastmod></url>",
    "  <url><loc>https://www.trailgear.example/tents/ultralight-2p</loc><lastmod>2026-10-18T09:30:00+03:00</lastmod></url>",
    "  <url><loc>https://www.trailgear.example/tents/</loc><lastmod>2026-10-18</lastmod></url>",
    "  <url><loc>https://www.trailgear.example/blog/spring-sale-recap</loc><lastmod>2026-04-02</lastmod></url>",
    "  <url><loc>https://www.trailgear.example/blog/guides/layering-for-hiking</loc><lastmod>2026-09-12</lastmod></url>",
    "  <url><loc>http://trailgear.example/backpacks/</loc><lastmod>2026-10-01</lastmod></url>",
    "  <url><loc>https://www.trailgear.example/sleeping-bags/</loc><lastmod>18.10.2026</lastmod></url>",
    "  <url><loc>https://www.trailgear.example/stoves/</loc><lastmod>2027-03-01</lastmod></url>",
    "</urlset>"
  ],
  "must_crawl": [
    "/tents/ultralight-2p",
    "/blog/trail-running-shoes-review",
    "/blog/guides/layering-for-hiking",
    "/assets/js/app.js",
    "/tents/?color=green"
  ],
  "must_block": [
    "/checkout/payment",
    "/tents/?sort=price",
    "/search/?q=stove",
    "/admin/"
  ]
}
FILE:scripts/crawl_check.py
#!/usr/bin/env python3
"""robots.txt and XML sitemap checker (Python 3 standard library only, works offline).

Input, either:
  a JSON bundle  {"site": "https://www.example.com", "user_agent": "Googlebot",
                  "robots_txt": [lines] or "text", "sitemap_xml": [lines] or "text",
                  "must_crawl": [urls or paths], "must_block": [urls or paths]}
  or files       --robots robots.txt [--sitemap sitemap.xml] --site https://... [--allow URL] [--block URL]
Matching follows RFC 9309 / Google: the group whose user-agent token matches the crawler name
(case-insensitive, most specific wins, else "*"), then the longest matching Allow/Disallow path
(* = any characters, $ = end of URL); on a tie Allow wins; no match = allowed.
Findings (severity):
  CRITICAL BLOCK_ALL               "Disallow: /" applies to the crawler with no Allow rules
  HIGH     MUST_CRAWL_BLOCKED      a URL that must be crawlable is disallowed
  HIGH     SITEMAP_URL_BLOCKED     a URL listed in the sitemap is disallowed
  HIGH     SITEMAP_PARSE_ERROR     sitemap is not well-formed XML or not urlset/sitemapindex
  HIGH     SITEMAP_TOO_BIG         more than 50,000 URLs in one sitemap
  HIGH     SITEMAP_OFF_SITE        a sitemap URL is on another host or scheme than the site
  MEDIUM   MUST_BLOCK_CRAWLABLE    a URL that should be blocked is crawlable (robots.txt is not access control)
  MEDIUM   ASSETS_BLOCKED          CSS, JS or image paths disallowed (pages cannot render for the crawler)
  MEDIUM   UNSUPPORTED_RULE        noindex / nofollow / host lines (ignored by Google)
  MEDIUM   SITEMAP_DUPLICATE       the same <loc> appears more than once
  MEDIUM   LASTMOD_FUTURE          <lastmod> after --today
  LOW      CRAWL_DELAY_IGNORED     crawl-delay (Googlebot ignores it; Bing and Yandex honour it)
  LOW      RULE_OUTSIDE_GROUP      allow/disallow before any user-agent line
  LOW      UNKNOWN_DIRECTIVE       unknown line or missing colon
  LOW      SITEMAP_RELATIVE        Sitemap: line is not an absolute URL
  LOW      NO_SITEMAP_LINE         robots.txt has no Sitemap: line
  LOW      LASTMOD_INVALID         <lastmod> is not W3C datetime (YYYY-MM-DD[Thh:mm[:ss]TZD])
Usage:
  python3 crawl_check.py bundle.json [--today 2026-10-23] [--json]
  python3 crawl_check.py --robots robots.txt --sitemap sitemap.xml --site https://www.example.com --allow /shop/
  python3 crawl_check.py --self-test
Exit code: 0 no CRITICAL/HIGH, 1 CRITICAL or HIGH findings, 2 bad input.
"""
import argparse
import datetime as dt
import json
import re
import sys
import urllib.parse
import xml.etree.ElementTree as ET

SEV_ORDER = {"CRITICAL": 0, "HIGH": 1, "MEDIUM": 2, "LOW": 3}
KNOWN = {"user-agent", "allow", "disallow", "sitemap", "crawl-delay", "noindex", "nofollow", "host", "clean-param"}
ASSET_RE = re.compile(r"(\.css|\.js|\.png|\.jpe?g|\.webp|\.svg|\.gif|/static/|/assets/|/_next/|/wp-includes/|/css/|/js/)", re.I)
LASTMOD_RE = re.compile(r"^\d{4}(-\d{2}(-\d{2}(T\d{2}:\d{2}(:\d{2}(\.\d+)?)?(Z|[+-]\d{2}:\d{2}))?)?)?$")
NS = "{http://www.sitemaps.org/schemas/sitemap/0.9}"


class DataError(ValueError):
    pass


def text_of(v):
    if v is None:
        return None
    return "\n".join(v) if isinstance(v, list) else str(v)


def parse_robots(text):
    """-> (groups [{agents, rules[(kind, path, line)]}], sitemaps [(url, line)], issues [(sev, code, msg)])"""
    groups, sitemaps, issues = [], [], []
    cur, last_was_agent = None, False
    for n, raw in enumerate(text.splitlines(), start=1):
        line = raw.split("#", 1)[0].strip()
        if not line:
            continue
        if ":" not in line:
            issues.append(("LOW", "UNKNOWN_DIRECTIVE", f"line {n}: no colon in {line!r}"))
            continue
        key, val = (x.strip() for x in line.split(":", 1))
        key = key.lower()
        if key == "user-agent":
            if not last_was_agent or cur is None:
                cur = {"agents": [], "rules": []}
                groups.append(cur)
            cur["agents"].append(val.lower())
            last_was_agent = True
            continue
        last_was_agent = False
        if key in ("allow", "disallow"):
            if cur is None:
                issues.append(("LOW", "RULE_OUTSIDE_GROUP", f"line {n}: {key} before any user-agent line is ignored"))
            elif val:
                cur["rules"].append((key, val, n))
        elif key == "sitemap":
            sitemaps.append((val, n))
            if not re.match(r"^https?://", val, re.I):
                issues.append(("LOW", "SITEMAP_RELATIVE", f"line {n}: Sitemap must be an absolute URL, got {val!r}"))
        elif key == "crawl-delay":
            issues.append(("LOW", "CRAWL_DELAY_IGNORED", f"line {n}: crawl-delay {val} is ignored by Googlebot"))
        elif key in ("noindex", "nofollow", "host", "clean-param"):
            issues.append(("MEDIUM", "UNSUPPORTED_RULE", f"line {n}: '{key}' in robots.txt is not supported by Google; use meta robots / X-Robots-Tag or redirects"))
        else:
            issues.append(("LOW", "UNKNOWN_DIRECTIVE", f"line {n}: unknown directive {key!r}"))
    return groups, sitemaps, issues


def pick_group(groups, agent):
    """Rules for the crawler: merge all groups with the longest matching agent token, else '*'."""
    a = agent.lower()
    best, rules = -1, []
    for g in groups:
        for tok in g["agents"]:
            if tok != "*" and tok and a.startswith(tok) and len(tok) > best:
                best, rules = len(tok), list(g["rules"])
            elif tok != "*" and tok and a.startswith(tok) and len(tok) == best:
                rules += g["rules"]
    if best >= 0:
        return rules
    return [r for g in groups if "*" in g["agents"] for r in g["rules"]]


def pattern_to_re(path):
    end = path.endswith("$")
    body = path[:-1] if end else path
    return re.compile("^" + ".*".join(re.escape(p) for p in body.split("*")) + ("$" if end else ""))


def path_of(url, site):
    u = urllib.parse.urlsplit(urllib.parse.urljoin(site + "/", url))
    return (u.path or "/") + (("?" + u.query) if u.query else "")


def decide(rules, path):
    """-> (allowed, matching rule or None)"""
    best = None
    for kind, pat, n in rules:
        if pattern_to_re(pat).match(path):
            key = (len(pat), kind == "allow")
            if best is None or key > best[0]:
                best = (key, (kind, pat, n))
    if best is None:
        return True, None
    return best[1][0] == "allow", best[1]


def parse_sitemap(text):
    try:
        root = ET.fromstring(text.strip())
    except ET.ParseError as e:
        raise DataError(f"sitemap XML error: {e}")
    tag = root.tag.replace(NS, "")
    if tag not in ("urlset", "sitemapindex"):
        raise DataError(f"sitemap root must be urlset or sitemapindex, got {tag!r}")
    child = "url" if tag == "urlset" else "sitemap"
    items = []
    for el in root.findall(NS + child) or root.findall(child):
        loc = el.findtext(NS + "loc") or el.findtext("loc") or ""
        lm = el.findtext(NS + "lastmod") or el.findtext("lastmod")
        items.append((loc.strip(), lm.strip() if lm else None))
    return tag, items


def check(bundle, today=None):
    site = (bundle.get("site") or "").rstrip("/")
    if not re.match(r"^https?://[^/]+$", site):
        raise DataError("site must be an origin like https://www.example.com")
    robots = text_of(bundle.get("robots_txt"))
    if robots is None:
        raise DataError("robots_txt is required")
    agent = bundle.get("user_agent") or "Googlebot"
    today = today or dt.date.today()
    groups, sitemaps, issues = parse_robots(robots)
    rules = pick_group(groups, agent)
    findings = [{"severity": s, "code": c, "message": m} for s, c, m in issues]

    def f(sev, code, msg):
        findings.append({"severity": sev, "code": code, "message": msg})

    if any(k == "disallow" and p == "/" for k, p, _ in rules) and not any(k == "allow" for k, _, _ in rules):
        f("CRITICAL", "BLOCK_ALL", f"'Disallow: /' blocks the whole site for {agent}")
    for k, p, n in rules:
        if k == "disallow" and ASSET_RE.search(p):
            f("MEDIUM", "ASSETS_BLOCKED", f"line {n}: Disallow {p} blocks CSS/JS/images needed to render pages")
    if not sitemaps:
        f("LOW", "NO_SITEMAP_LINE", "robots.txt has no Sitemap: line")
    url_checks = []
    for kind, key in (("crawl", "must_crawl"), ("block", "must_block")):
        for u in bundle.get(key) or []:
            p = path_of(u, site)
            allowed, rule = decide(rules, p)
            url_checks.append({"url": u, "path": p, "expect": kind, "allowed": allowed,
                               "rule": f"line {rule[2]}: {rule[0].title()}: {rule[1]}" if rule else "no rule"})
            if kind == "crawl" and not allowed:
                f("HIGH", "MUST_CRAWL_BLOCKED", f"{p} is blocked by line {rule[2]} ({rule[0].title()}: {rule[1]})")
            if kind == "block" and allowed:
                f("MEDIUM", "MUST_BLOCK_CRAWLABLE", f"{p} is crawlable ({'no rule' if not rule else 'line %d Allow: %s' % (rule[2], rule[1])}); protect private pages with auth or noindex, not robots.txt")
    sm_info = None
    sm_text = text_of(bundle.get("sitemap_xml"))
    if sm_text is not None:
        try:
            kind, items = parse_sitemap(sm_text)
        except DataError as e:
            f("HIGH", "SITEMAP_PARSE_ERROR", str(e))
            kind, items = None, []
        host = urllib.parse.urlsplit(site)
        seen, blocked, off = set(), 0, 0
        for loc, lm in items:
            u = urllib.parse.urlsplit(loc)
            if (u.scheme, u.netloc) != (host.scheme, host.netloc):
                off += 1
                f("HIGH", "SITEMAP_OFF_SITE", f"{loc} is not on {site}")
            if loc in seen:
                f("MEDIUM", "SITEMAP_DUPLICATE", f"{loc} listed more than once")
            seen.add(loc)
            if kind == "urlset":
                allowed, rule = decide(rules, path_of(loc, site))
                if not allowed:
                    blocked += 1
                    f("HIGH", "SITEMAP_URL_BLOCKED", f"{loc} is in the sitemap but blocked by line {rule[2]} ({rule[0].title()}: {rule[1]})")
            if lm is not None:
                if not LASTMOD_RE.match(lm):
                    f("LOW", "LASTMOD_INVALID", f"{loc}: lastmod {lm!r} is not W3C datetime")
                elif dt.date.fromisoformat(lm[:10] if len(lm) >= 10 else lm[:4] + "-01-01") > today:
                    f("MEDIUM", "LASTMOD_FUTURE", f"{loc}: lastmod {lm} is after {today}")
        if len(items) > 50000:
            f("HIGH", "SITEMAP_TOO_BIG", f"{len(items)} URLs; split into files of at most 50,000 URLs and use a sitemap index")
        sm_info = {"type": kind, "urls": len(items), "blocked": blocked, "off_site": off}
    findings.sort(key=lambda x: SEV_ORDER[x["severity"]])
    status = findings[0]["severity"] if findings and findings[0]["severity"] in ("CRITICAL", "HIGH") else "OK"
    return {"site": site, "user_agent": agent, "groups": len(groups), "rules_for_agent": len(rules),
            "sitemaps_declared": [s for s, _ in sitemaps], "sitemap": sm_info, "url_checks": url_checks,
            "findings": findings, "status": status}


def report(r):
    L = [f"# Crawl check for {r['site']} as {r['user_agent']}", "",
         f"robots.txt: {r['groups']} groups, {r['rules_for_agent']} rules apply to {r['user_agent']}; "
         f"Sitemap lines: {', '.join(r['sitemaps_declared']) or 'none'}"]
    if r["sitemap"]:
        s = r["sitemap"]
        L.append(f"Sitemap ({s['type']}): {s['urls']} URLs, {s['blocked']} blocked by robots.txt, {s['off_site']} off-site")
    if r["url_checks"]:
        L += ["", "| URL | Expected | Result | Deciding rule |", "|---|---|---|---|"]
        for c in r["url_checks"]:
            res = "allowed" if c["allowed"] else "blocked"
            good = (c["expect"] == "crawl") == c["allowed"]
            L.append(f"| {c['path']} | {c['expect']} | {res}{'' if good else ' (WRONG)'} | {c['rule']} |")
    L += ["", f"## Findings (status {r['status']})"]
    L += [f"- {x['severity']} {x['code']}: {x['message']}" for x in r["findings"]] or ["- none"]
    return "\n".join(L) + "\n"


def self_test():
    cases = []

    def ok(name, cond):
        cases.append(bool(cond))
        print(("PASS " if cond else "FAIL ") + name)

    def codes(r):
        return {x["code"] for x in r["findings"]}

    R = lambda t: pick_group(parse_robots(t)[0], "Googlebot")
    rules = R("User-agent: *\nDisallow: /shop/\nAllow: /shop/products/\n")
    ok("longest match wins (allow deeper path)", decide(rules, "/shop/products/a")[0] and not decide(rules, "/shop/cart")[0])
    ok("tie goes to allow", decide(R("User-agent: *\nDisallow: /p\nAllow: /p\n"), "/p")[0])
    ok("no rule = allowed", decide(rules, "/blog/")[0])
    wild = R("User-agent: *\nDisallow: /*?sort=\nDisallow: /*.pdf$\n")
    ok("* wildcard matches query", not decide(wild, "/shop/shoes?sort=price")[0])
    ok("$ anchors end", not decide(wild, "/files/a.pdf")[0] and decide(wild, "/files/a.pdf?x=1")[0])
    ok("empty Disallow allows everything", decide(R("User-agent: *\nDisallow:\n"), "/x")[0])
    spec = parse_robots("User-agent: *\nDisallow: /\n\nUser-agent: Googlebot\nDisallow: /private/\n")[0]
    ok("specific group beats *", decide(pick_group(spec, "Googlebot"), "/shop")[0] and not decide(pick_group(spec, "Bingbot"), "/shop")[0])
    ok("googlebot-image uses longest token", pick_group(parse_robots("User-agent: googlebot\nDisallow: /a\nUser-agent: googlebot-image\nDisallow: /b\n")[0], "Googlebot-Image")[0][1] == "/b")
    multi = parse_robots("User-agent: a\nUser-agent: b\nDisallow: /x\n")[0]
    ok("consecutive user-agents share a group", len(multi) == 1 and multi[0]["agents"] == ["a", "b"])
    ok("comments stripped", R("User-agent: * # all\nDisallow: /tmp/ # temp\n")[0][1] == "/tmp/")
    base = {"site": "https://www.shop.test", "robots_txt": "User-agent: *\nDisallow: /\n"}
    r = check(base, dt.date(2026, 10, 23))
    ok("block all is CRITICAL", "BLOCK_ALL" in codes(r) and r["status"] == "CRITICAL")
    r = check({**base, "robots_txt": ["User-agent: *", "Disallow: /checkout/", "Sitemap: https://www.shop.test/sitemap.xml"],
               "must_crawl": ["/checkout/thanks"], "must_block": ["/admin/"]}, dt.date(2026, 10, 23))
    ok("must_crawl blocked is HIGH", "MUST_CRAWL_BLOCKED" in codes(r) and r["status"] == "HIGH")
    ok("must_block crawlable is MEDIUM", "MUST_BLOCK_CRAWLABLE" in codes(r))
    ok("list of lines accepted, sitemap line read", r["sitemaps_declared"] == ["https://www.shop.test/sitemap.xml"])
    r = check({**base, "robots_txt": "Disallow: /x\nUser-agent: *\nNoindex: /tmp/\nCrawl-delay: 5\nDisalow: /y\nSitemap: /sitemap.xml\nDisallow: /assets/\n"}, dt.date(2026, 10, 23))
    for c in ("RULE_OUTSIDE_GROUP", "UNSUPPORTED_RULE", "CRAWL_DELAY_IGNORED", "UNKNOWN_DIRECTIVE", "SITEMAP_RELATIVE", "ASSETS_BLOCKED"):
        ok(c + " flagged", c in codes(r))
    ok("missing sitemap line flagged", "NO_SITEMAP_LINE" in codes(check({**base, "robots_txt": "User-agent: *\nDisallow:\n"})))
    sm = ('<?xml version="1.0"?><urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">'
          "<url><loc>https://www.shop.test/a</loc><lastmod>2026-10-01</lastmod></url>"
          "<url><loc>https://www.shop.test/a</loc></url>"
          "<url><loc>http://www.shop.test/b</loc><lastmod>01/10/2026</lastmod></url>"
          "<url><loc>https://www.shop.test/cart/x</loc><lastmod>2030-01-01T00:00:00+00:00</lastmod></url></urlset>")
    r = check({**base, "robots_txt": "User-agent: *\nDisallow: /cart/\nSitemap: https://www.shop.test/sitemap.xml\n", "sitemap_xml": sm}, dt.date(2026, 10, 23))
    for c in ("SITEMAP_DUPLICATE", "SITEMAP_OFF_SITE", "LASTMOD_INVALID", "LASTMOD_FUTURE", "SITEMAP_URL_BLOCKED"):
        ok(c + " flagged", c in codes(r))
    ok("sitemap counts", r["sitemap"] == {"type": "urlset", "urls": 4, "blocked": 1, "off_site": 1})
    ok("bad XML is HIGH SITEMAP_PARSE_ERROR", "SITEMAP_PARSE_ERROR" in codes(check({**base, "robots_txt": "", "sitemap_xml": "<urlset><url>"})))
    idx = '<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"><sitemap><loc>https://www.shop.test/s1.xml</loc></sitemap></sitemapindex>'
    ok("sitemap index read", check({**base, "robots_txt": "", "sitemap_xml": idx})["sitemap"]["type"] == "sitemapindex")
    for bad, label in (({"robots_txt": ""}, "missing site"), ({"site": "https://x.test/path", "robots_txt": ""}, "site with path"),
                       ({"site": "https://x.test"}, "missing robots_txt")):
        try:
            check(bad)
            ok(label + " rejected", False)
        except DataError:
            ok(label + " rejected", True)
    print(f"{sum(cases)}/{len(cases)} passed")
    return 0 if all(cases) else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="Check robots.txt rules and an XML sitemap offline.")
    ap.add_argument("bundle", nargs="?", help="JSON bundle (see module docstring)")
    ap.add_argument("--robots", help="robots.txt file (instead of a bundle)")
    ap.add_argument("--sitemap", help="sitemap.xml file")
    ap.add_argument("--site", help="site origin, e.g. https://www.example.com")
    ap.add_argument("--agent", help="crawler name (default Googlebot)")
    ap.add_argument("--allow", action="append", default=[], help="URL or path that must be crawlable (repeatable)")
    ap.add_argument("--block", action="append", default=[], help="URL or path that should be blocked (repeatable)")
    ap.add_argument("--today", help="date for the future-lastmod check (default today)")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    try:
        if a.bundle:
            b = json.load(open(a.bundle, encoding="utf-8"))
        elif a.robots:
            b = {"site": a.site, "robots_txt": open(a.robots, encoding="utf-8").read(),
                 "sitemap_xml": open(a.sitemap, encoding="utf-8").read() if a.sitemap else None,
                 "must_crawl": a.allow, "must_block": a.block}
        else:
            ap.error("give a JSON bundle, --robots FILE or --self-test")
        if a.agent:
            b["user_agent"] = a.agent
        today = dt.date.fromisoformat(a.today) if a.today else None
        r = check(b, today)
    except (OSError, ValueError, DataError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(r, indent=2) if a.json else report(r), end="\n" if a.json else "")
    return 1 if r["status"] in ("CRITICAL", "HIGH") else 0


if __name__ == "__main__":
sys.exit(main())Chuyển đổi bất kỳ công thức bánh mì nào sang tỷ lệ phần trăm thợ làm bánh (baker's percentages) thực tế và điều chỉnh định lượng theo số ổ bánh hoặc viên bột bạn muốn. Tính toán cả lượng bột và nước có trong men cái (levain) cũng như lượng nước trong sữa, trứng hoặc mật ong, sau đó báo cáo tỷ lệ ngậm nước (hydration) thực tế, muối, bột lên men trước (prefermented flour), men và ngũ cốc nguyên cám. Cảnh báo khi thiếu hoặc sai lệch lượng muối, thiếu chất gây nở, quá nhiều men hoặc levain, và tỷ lệ ngậm nước nằm ngoài ngưỡng chuẩn của kiểu bánh đó. Bao gồm một công cụ tính toán bằng thư viện chuẩn Python có hỗ trợ cờ --self-test.
---
name: bread-dough-bakers-percentage-calculator
description: Chuyển đổi bất kỳ công thức bánh mì nào sang tỷ lệ phần trăm thợ làm bánh (baker's percentages) thực tế và điều chỉnh định lượng theo số ổ bánh hoặc viên bột bạn muốn. Tính toán cả lượng bột và nước có trong men cái (levain) cũng như lượng nước trong sữa, trứng hoặc mật ong, sau đó báo cáo tỷ lệ ngậm nước (hydration) thực tế, muối, bột lên men trước (prefermented flour), men và ngũ cốc nguyên cám. Cảnh báo khi thiếu hoặc sai lệch lượng muối, thiếu chất gây nở, quá nhiều men hoặc levain, và tỷ lệ ngậm nước nằm ngoài ngưỡng chuẩn của kiểu bánh đó. Bao gồm một công cụ tính toán bằng thư viện chuẩn Python có hỗ trợ cờ --self-test.
---

# Máy tính Tỷ lệ Phần trăm Thợ làm bánh cho Bột Bánh mì

Bạn giúp những người làm bánh tại nhà hiểu rõ, tinh chỉnh và nhân chia định lượng các công thức làm bánh mì. Từ một công thức tính bằng gam (hoặc đã được quy đổi sang gam), bạn tính toán tỷ lệ phần trăm thợ làm bánh thực tế, so sánh chúng với thông số tiêu chuẩn mà kiểu bánh mì đó thường cần, giải thích tác động của từng con số lên khối bột, và đưa ra danh sách nguyên liệu đã được điều chỉnh tỷ lệ chính xác theo số lượng cũng như trọng lượng ổ bánh mì, bánh mì cuộn (rolls) hoặc viên bột pizza mà họ muốn nướng.

## Các tệp trong kỹ năng này

- `scripts/dough_calc.py` - đọc một tệp JSON công thức và in ra tổng trọng lượng, bảng tỷ lệ phần trăm thợ làm bánh, công thức đã điều chỉnh tỷ lệ cùng các phát hiện đánh giá (chỉ sử dụng thư viện chuẩn của Python 3)
- `references/bakers-math.md` - tỷ lệ phần trăm thợ làm bánh, tỷ lệ phần trăm thực tế so với tỷ lệ phần trăm trên công thức, lượng nước trong levain và các nguyên liệu phụ, các khoảng giá trị quan trọng, quy đổi các loại men, tỷ lệ ngậm nước theo từng kiểu bánh và cách nhân chia tỷ lệ
- `references/fermentation-and-troubleshooting.md` - mốc thời gian, nhiệt độ khối bột, ý nghĩa của từng phát hiện đánh giá đối với khối bột, các triệu chứng lỗi và cách khắc phục, độ chín của bánh
- `templates/bake-sheet.md` - phiếu ghi chép mẻ nướng gồm công thức, lịch trình thời gian và ghi chú cho lần nướng tiếp theo
- `examples/weekend-whole-wheat-sourdough.json` - công thức bánh mì sourdough lúa mì nguyên cám và lúa mạch đen dùng men cái (levain), một chút men nở ăn liền (instant yeast), mật ong và dầu ô liu, được điều chỉnh định lượng thành hai ổ bánh nặng 1 kg

## Quy trình làm việc

### 1. Lấy công thức tính theo gam
Hãy hỏi trọng lượng của từng nguyên liệu. Quy đổi đơn vị cốc (cups) và thìa (spoons) thật cẩn thận (1 cup bột bánh mì khoảng 125-135 g, 1 cup nước là 236 g, 1 tsp muối mịn khoảng 6 g, 1 tsp men instant khoảng 3 g) và nói rõ rằng phép quy đổi này chỉ mang tính tương đối. Hỏi thêm về tỷ lệ ngậm nước của levain, những loại bột nào là bột nguyên cám, kiểu bánh mì muốn làm, loại men sử dụng, cũng như số lượng và trọng lượng từng phần bột mà họ mong muốn.

### 2. Chạy công cụ tính toán
```
python3 scripts/dough_calc.py examples/weekend-whole-wheat-sourdough.json
python3 scripts/dough_calc.py recipe.json --pieces 6 --piece-weight 270 --json
python3 scripts/dough_calc.py --self-test
```
Các kiểu bánh (`styles`): bagel, pizza_neapolitan, sandwich_loaf, enriched_brioche, baguette, sourdough_boule, whole_wheat_loaf, ciabatta, focaccia. Mã thoát (exit code) bằng 1 nghĩa là có các phát hiện mức HIGH, bằng 2 nghĩa là dữ liệu đầu vào không hợp lệ.

### 3. Giải thích và điều chỉnh
Đưa ra các con số quan trọng trước tiên (tỷ lệ ngậm nước, muối, chất gây nở), sau đó nêu từng phát hiện đánh giá kèm theo lý do và mức thay đổi cụ thể bằng gam dựa theo `references/bakers-math.md`. Chỉ đề xuất thay đổi một hoặc hai yếu tố cho mỗi mẻ nướng để người làm bánh có thể quan sát rõ tác động của từng thay đổi. Sử dụng `references/fermentation-and-troubleshooting.md` để tư vấn về thời gian ủ và xử lý các vấn đề họ mô tả (bánh bị bẹt, ruột bánh đặc, bánh quá chua).

### 4. Bàn giao kết quả
Cung cấp công thức đã điều chỉnh tỷ lệ và điền vào mẫu `templates/bake-sheet.md` với công thức hoàn chỉnh, lịch trình thời gian phù hợp với nhiệt độ phòng bếp của họ cùng phần trống để ghi chú.

## Ví dụ kết quả
Đối với tệp `examples/weekend-whole-wheat-sourdough.json`: tổng lượng bột là 1100 g (trong đó có 100 g nằm trong levain) và tổng lượng nước là 785 g, do đó tỷ lệ ngậm nước thực tế là 71.4%, muối 1.4%, bột lên men trước 9.1%, men instant 0.27% và ngũ cốc nguyên cám 38.2%. Lượng muối đang thấp (mức MEDIUM; cần 22 g để đạt 2%) và mức 38% ngũ cốc nguyên cám sẽ cần thêm khoảng 5 điểm phần trăm nước nữa (mức LOW). Khi nhân tỷ lệ lên 2 ổ x 1000 g cộng thêm 2% hao hụt (hệ số nhân 1.047): 628 g bột bánh mì (bread flour), 314 g bột nguyên cám (whole wheat), 105 g bột lúa mạch đen (rye), 712 g nước, 15.7 g muối (nên tăng lên khoảng 23 g), 209 g levain, 3.1 g men, 31 g mật ong, 21 g dầu ô liu.

## Quy tắc

- Luôn làm việc bằng đơn vị gam; nói rõ khi nào phép quy đổi từ thể tích sang trọng lượng chỉ là xấp xỉ.
- Luôn nêu rõ tỷ lệ phần trăm đang nói tới là tỷ lệ thực tế (đã tính cả levain và nguyên liệu phụ) hay tỷ lệ phần trăm bề mặt theo công thức.
- Chỉ thay đổi một hoặc hai yếu tố mỗi lần và giải thích rõ tác động của chúng lên hương vị, kết cấu và thời gian ủ.
- Thời gian lên men phụ thuộc vào nhiệt độ và độ khỏe của men cái; hãy đưa ra khoảng thời gian ước lượng kèm các dấu hiệu nhận biết trực quan cần quan sát, thay vì ấn định số phút cứng nhắc.
FILE:references/bakers-math.md
# Toán học cho Thợ làm bánh (Baker's Math)

## Tỷ lệ phần trăm thợ làm bánh (Baker's percentages)
Mọi nguyên liệu đều được biểu diễn dưới dạng tỷ lệ phần trăm so với **tổng trọng lượng bột**, và tổng lượng bột luôn được quy ước là 100%. Một công thức gồm 1000 g bột, 700 g nước, 20 g muối và 5 g men instant sẽ có tỷ lệ là 100 / 70 / 2 / 0.5. Tỷ lệ phần trăm giúp các công thức dễ dàng được so sánh, nhân chia định lượng và điều chỉnh: chỉ cần thay đổi một con số và giữ nguyên phần còn lại.

## Tỷ lệ phần trăm thực tế so với tỷ lệ phần trăm trên công thức
Các công thức thường chỉ đưa ra tỷ lệ phần trăm tính theo lượng bột được thêm vào ở bước trộn cuối cùng. Tỷ lệ phần trăm thực tế (tổng thể) sẽ tính cả:
- lượng bột và nước nằm bên trong men cái (levain) hoặc bột cái ủ trước (preferment)
- lượng nước có sẵn bên trong các nguyên liệu phụ dạng ướt

`scripts/dough_calc.py` luôn báo cáo tỷ lệ phần trăm thực tế, vì vậy các hàng biểu thị lượng bột trộn thêm trong bảng kết quả sẽ có tổng nhỏ hơn 100% khi công thức có sử dụng levain (phần bột còn lại nằm ở trong levain).

| Tỷ lệ ngậm nước của Levain | Lượng bột trong 100 g levain | Lượng nước trong 100 g levain |
|---|---|---|
| 50% (đặc / stiff) | 66.7 g | 33.3 g |
| 75% | 57.1 g | 42.9 g |
| 100% (lỏng / liquid) | 50 g | 50 g |
| 125% | 44.4 g | 55.6 g |

Công thức tính: bột = levain / (1 + hydration / 100); nước = levain - bột.

## Hàm lượng nước trong các nguyên liệu phụ phổ biến
| Nguyên liệu | Hàm lượng nước |
|---|---|
| Sữa nguyên kem | 87% |
| Trứng nguyên quả (bỏ vỏ, ~50 g) | 75% |
| Lòng đỏ trứng | 50% |
| Bơ | 16% |
| Mật ong | 17% |
| Sữa chua | 85% |
| Khoai tây nghiền | 80% |
| Dầu ô liu, đường, các loại hạt | 0% (chất béo và đường vẫn làm mềm khối bột) |

## Các thông số quan trọng
| Chỉ số | Mức tiêu chuẩn | Ghi chú |
|---|---|---|
| Muối | 1.8-2.2% | dưới 1.6% bánh nhạt và bột nhão; trên 2.5% bánh mặn, làm chậm quá trình lên men |
| Men instant (trộn bột trực tiếp / straight dough) | 0.5-1.5% | 0.1-0.3% khi ủ lạnh qua đêm |
| Levain, tính theo tỷ lệ bột lên men trước | 10-25% | nhiều hơn = lên men nhanh hơn và chua hơn |
| Đường (bột giàu dinh dưỡng / enriched) | 5-15% | trên ~10% nên dùng men chịu áp suất thẩm thấu cao (osmotolerant yeast) hoặc tăng lượng men |
| Chất béo (bột giàu dinh dưỡng / enriched) | 3-50% | bánh brioche dùng 40-60% bơ |

Quy đổi các loại men (cùng sức nở tương đương): 1 g men instant = 1.25 g men khô kích hoạt (active dry) = khoảng 3 g men tươi (fresh yeast). Tập lệnh quy đổi toàn bộ các loại men về mức tương đương của men instant.

## Tỷ lệ ngậm nước theo kiểu bánh
| Kiểu bánh | Tỷ lệ ngậm nước (Hydration %) | Kết cấu |
|---|---|---|
| Bagel | 50-58 | đặc, dai (chewy) |
| Neapolitan pizza | 58-65 | mềm, viền bánh phồng xốp |
| Sandwich loaf | 60-68 | thớ bánh đều, khít |
| Enriched / brioche (gồm sữa và trứng) | 55-70 | mềm mại, béo ngậy |
| Baguette | 65-75 | ruột thoáng lỗ khí, vỏ giòn rụm |
| Sourdough boule | 68-80 | ruột thoáng (open crumb) |
| Whole wheat loaf | 70-85 | bột nguyên cám hút nhiều nước hơn |
| Ciabatta | 75-85 | ruột rất thoáng, nhiều lỗ khí lớn |
| Focaccia | 75-90 | xốp thoáng, đẫm dầu |

Loại bột rất quan trọng: bột bánh mì giàu protein và bột nguyên cám hút nhiều nước hơn; bột mì đa dụng ít protein hoặc nhiều loại bột châu Âu T55/Type 550 hút ít nước hơn. Hãy bắt đầu ở mức thấp hơn 3-5 điểm phần trăm khi dùng một loại bột mới và châm thêm nước từ từ trong quá trình nhào trộn (kỹ thuật bassinage).

## Nhân chia định lượng (Scaling)
1. Quyết định số lượng phần bột và trọng lượng mỗi phần (ổ bánh, bánh cuộn, viên bột pizza).
2. Cộng thêm 1-3% bù cho lượng bột hao hụt dính ở âu trộn và trên mặt bàn nhào.
3. Hệ số nhân (Factor) = trọng lượng bột mục tiêu / trọng lượng bột hiện tại; nhân mọi nguyên liệu với hệ số này.
4. Làm tròn số gam hợp lý: làm tròn đến 1 g đối với bột và nước, 0.1 g đối với muối và men (hãy dùng cân tiểu ly độ chia 0.1 g cho các định lượng nhỏ).

Bánh mì nướng khuôn (Pan loaves): trọng lượng khối bột rơi vào khoảng 0.55-0.6 g trên mỗi cm3 thể tích khuôn (một khuôn loại 900 g / 2 lb sẽ cần khoảng 850-950 g bột).
FILE:references/fermentation-and-troubleshooting.md
# Lên men và Xử lý sự cố

## Lịch trình tiêu chuẩn cho bột bánh mì cơ bản (lean dough)
| Bước | Dùng men công nghiệp (1% instant) | Dùng Sourdough (15-20% levain) |
|---|---|---|
| Trộn và nghỉ | 20-30 phút autolyse (tùy chọn) | 30-60 phút autolyse (tùy chọn) |
| Ủ lần 1 (Bulk fermentation) ở 24-26 C | 1.5-2 giờ, nở ~75-100% | 4-6 giờ, nở ~50-75% |
| Gấp bột (Folds) | 1-2 lần | 3-4 lần trong 2 giờ đầu |
| Tạo hình, ủ kết thúc (final proof) | 45-75 phút | 1-3 giờ, hoặc ủ lạnh 8-16 giờ trong tủ lạnh |
| Nướng (Bake) | 220-230 C | 240-250 C đậy nắp 20 phút, sau đó 220-230 C mở nắp |

Hãy hướng tới nhiệt độ khối bột đạt 24-26 C sau khi trộn. Điều chỉnh bằng nhiệt độ nước: nhiệt độ nước mong muốn = 3 x nhiệt độ bột mong muốn - nhiệt độ bột khô - nhiệt độ phòng - độ tăng nhiệt do ma sát (khoảng 2-6 C khi nhào tay, cao hơn nếu nhào bằng máy). Khi có dùng levain, hãy nhân với hệ số 4 và trừ đi cả nhiệt độ của levain.

## Quy tắc ngón tay cái về nhiệt độ
Thời gian lên men sẽ giảm khoảng một nửa khi nhiệt độ tăng thêm +8 C và tăng gấp đôi khi nhiệt độ giảm đi -8 C. Quá trình ủ lần 1 (bulk) của sourdough mất 5 giờ ở 24 C sẽ cần khoảng 8 giờ nếu ủ ở 20 C.

## Cách đọc các mã đánh giá từ tập lệnh
- **SALT_LOW / SALT_HIGH:** hãy chỉnh lại lượng muối trước tiên; muối làm thay đổi hương vị, độ khỏe của mạng lưới gluten và tốc độ lên men.
- **HYDRATION_HIGH:** khối bột sẽ dính và dễ bị chảy bè ra; hãy làm ướt tay khi thao tác, gấp bột nhiều lần hơn, hoặc giữ lại 5% lượng nước để châm sau.
- **HYDRATION_LOW:** ruột bánh khít đặc và khối bột khi trộn khá khô cứng; hãy châm thêm nước từng chút một.
- **YEAST_HIGH:** rút ngắn thời gian ủ lần 1, hoặc giảm bớt lượng men để khớp với lịch trình của bạn (dùng 0.2-0.5% cho quá trình ủ lạnh kéo dài).
- **LEVAIN_HIGH:** quá trình lên men diễn ra nhanh hơn, mang hương vị nồng ấm hơn nhưng dễ bị ủ quá lửa (overproof); hãy giảm lượng levain xuống mức 10-20% hoặc ủ ở nhiệt độ mát hơn.
- **WHOLE_GRAIN_THIRSTY:** thêm 5-10 điểm phần trăm nước hoặc ngâm phần bột nguyên cám trước từ 30-60 phút.

## Triệu chứng lỗi và cách khắc phục
| Vấn đề | Nguyên nhân có thể | Cách khắc phục |
|---|---|---|
| Ổ bánh bị bẹt, chảy bè ngang | ủ quá lửa (overproofed), quá nhão so với sức hút của bột, tạo hình lỏng tay | rút ngắn thời gian ủ cuối, giảm 3-5 điểm phần trăm nước, tạo hình căng mặt bột hơn, dùng rổ ủ bột (banneton) |
| Ruột bánh đặc, khít | chưa ủ tới (underproofed), quá ít nước, men cái yếu | kéo dài thời gian ủ lần 1, giữ bột ấm hơn, cho men cái ăn tới khi đạt độ nở gấp đôi trong 4-6 giờ |
| Lỗ rỗng lớn ngay dưới lớp vỏ (vỏ tách rời / flying crust) | chưa ủ tới hoặc tạo hình kém | kéo dài thời gian ủ cuối, ép khí nhẹ nhàng trong lúc tạo hình |
| Vỏ bánh nhợt nhạt | lò chưa đủ nóng, bột ủ quá lửa, thiếu hơi nước | làm nóng lò trước 45-60 phút, tạo hơi nước trong 15-20 phút đầu tiên |
| Ruột bánh bị bết dính (gummy) | cắt bánh quá sớm, nướng chưa chín tới | nướng tới khi tâm bánh đạt 96-98 C, để nguội 1-2 giờ trước khi thái lát |
| Bánh quá chua | ủ ấm quá lâu, levain đã qua đỉnh nở (past peak) | dùng levain trẻ hơn, giảm lượng levain, rút ngắn thời gian hoặc ủ lần 1 ở nhiệt độ mát hơn |
| Vị bánh nhạt nhẽo | lượng muối dưới 1.8%, lên men quá nhanh | cân muối chính xác, giảm lượng men và ủ lâu hơn ở nhiệt độ mát hơn |

## Độ chín và an toàn thực phẩm
- Nướng bánh mì cơ bản (lean bread) tới khi nhiệt độ tâm bánh đạt 93-98 C và bánh mì giàu dinh dưỡng (enriched bread) đạt 85-90 C (dùng nhiệt kế đọc kết quả tức thì).
- Bột sống có thể mang vi khuẩn: tuyệt đối không nếm thử bột sống.
- Hũ men cái xuất hiện vệt màu hồng, cam hoặc nấm mốc có lông tơ là không an toàn; hãy vứt bỏ ngay.
FILE:templates/bake-sheet.md
# Phiếu Nướng Bánh (Bake Sheet) - <tên công thức> - <ngày>

**Kiểu bánh:** <sourdough boule>  **Số lượng:** <2 x 1000 g>  **Nhiệt độ bếp:** <22 C>

## Công thức (tỷ lệ phần trăm thợ làm bánh thực tế)
| Nguyên liệu | % | Số gam (mẻ nướng này) |
|---|---|---|
| Tổng lượng bột | 100 | |
| Tổng lượng nước | | |
| Muối | | |
| Levain / men | | |
| Nguyên liệu phụ | | |

Tỷ lệ ngậm nước <..>% | muối <..>% | bột lên men trước <..>% | ngũ cốc nguyên cám <..>%

## Thay đổi so với lần trước
- <ví dụ: +15 g muối để đạt mức 2%, +50 g nước cho phần bột nguyên cám>

## Lịch trình thời gian
| Bước | Dự kiến | Thực tế | Ghi chú (nhiệt độ bột, độ nở %) |
|---|---|---|---|
| Cho levain ăn | | | |
| Trộn bột | | | |
| Kết thúc ủ lần 1 (Bulk) | | | |
| Tạo hình | | | |
| Kết thúc ủ cuối (Proof) | | | |
| Nướng bánh | | | |

## Kết quả
- Ruột bánh (Crumb): <thoáng / khít / bết dính>  - Vỏ bánh (Crust): <màu sắc, độ dày>  - Hương vị: <độ mặn, độ chua>
- Lần tới: <chỉ thay đổi một yếu tố duy nhất>
FILE:examples/weekend-whole-wheat-sourdough.json
{
  "name": "Weekend whole wheat sourdough",
  "style": "sourdough_boule",
  "flours": [
    {"name": "bread flour (12.5% protein)", "grams": 600},
    {"name": "whole wheat flour", "grams": 300, "whole_grain": true},
    {"name": "whole rye flour", "grams": 100, "whole_grain": true}
  ],
  "water_g": 680,
  "salt_g": 15,
  "levain": {"grams": 200, "hydration_pct": 100, "whole_grain_pct": 20},
  "yeast": {"type": "instant", "grams": 3},
  "extras": [
    {"name": "honey", "grams": 30, "water_pct": 17},
    {"name": "olive oil", "grams": 20, "water_pct": 0}
  ],
  "target": {"pieces": 2, "piece_weight_g": 1000},
  "loss_pct": 2
}
FILE:scripts/dough_calc.py
#!/usr/bin/env python3
"""Bread dough baker's percentage calculator (Python 3 standard library only).

Input JSON:
  {"name": "...", "style": "sourdough_boule",
   "flours": [{"name": "bread flour", "grams": 800}, {"name": "whole wheat", "grams": 200, "whole_grain": true}],
   "water_g": 700, "salt_g": 20,
   "levain": {"grams": 200, "hydration_pct": 100, "whole_grain_pct": 0},      (optional)
   "yeast": {"type": "instant|active_dry|fresh", "grams": 0},                 (optional)
   "extras": [{"name": "milk", "grams": 100, "water_pct": 87}],               (optional)
   "target": {"pieces": 3, "piece_weight_g": 900}, "loss_pct": 2}            (optional)
Totals count the flour and water inside the levain and the water inside extras (milk ~87%,
whole egg ~75%, butter ~16%), so hydration and salt are the TRUE percentages of all flour.
  hydration %  = all water / all flour x 100
  salt %       = salt / all flour x 100
  prefermented flour % = flour in the levain / all flour x 100
  yeast        = instant-yeast equivalent (active dry x 0.8, fresh x 0.33) / all flour x 100
Scaling: factor = pieces x piece weight x (1 + loss %) / current dough weight; grams rounded to 1 g,
salt and yeast to 0.1 g.
Findings (severity):
  HIGH   NO_SALT            no salt (bland, slack, fast dough) - unless salt_free is true
  HIGH   SALT_HIGH          salt above 2.5% of flour
  HIGH   NO_LEAVEN          no yeast and no levain (dough will not rise)
  HIGH   HYDRATION_FAR      hydration more than 10 points outside the style range
  MEDIUM SALT_LOW           salt below 1.6%
  MEDIUM HYDRATION_HIGH/LOW hydration outside the style range
  MEDIUM YEAST_HIGH         instant-equivalent yeast above 2% (or above 1% together with a levain)
  MEDIUM LEVAIN_HIGH        prefermented flour above 35% (overproofs, sour, slack)
  LOW    LEVAIN_LOW         levain-only dough with under 5% prefermented flour (very slow)
  LOW    WHOLE_GRAIN_THIRSTY  30%+ whole grain with hydration under 72%
  LOW    UNKNOWN_STYLE      style not in the table; no hydration check
Usage:
  python3 dough_calc.py recipe.json
  python3 dough_calc.py recipe.json --pieces 4 --piece-weight 250 --json
  python3 dough_calc.py --self-test
Exit code: 0 no HIGH findings, 1 HIGH findings, 2 bad input.
"""
import argparse
import json
import sys

STYLES = {  # typical hydration range in % (true, incl. levain and extras water)
    "bagel": (50, 58),
    "pizza_neapolitan": (58, 65),
    "sandwich_loaf": (60, 68),
    "enriched_brioche": (55, 70),
    "baguette": (65, 75),
    "sourdough_boule": (68, 80),
    "whole_wheat_loaf": (70, 85),
    "ciabatta": (75, 85),
    "focaccia": (75, 90),
}
YEAST_FACTOR = {"instant": 1.0, "active_dry": 0.8, "fresh": 0.33}
SEV_ORDER = {"HIGH": 0, "MEDIUM": 1, "LOW": 2}


class DataError(ValueError):
    pass


def g(x, what):
    try:
        v = float(x)
    except (TypeError, ValueError):
        raise DataError(f"{what} must be a number, got {x!r}")
    if v < 0:
        raise DataError(f"{what} must be >= 0")
    return v


def analyze(rec, pieces=None, piece_weight=None):
    flours = rec.get("flours") or []
    if not flours:
        raise DataError("at least one flour is required")
    lines = []  # (name, grams, kind)
    added_flour = whole = 0.0
    for i, fl in enumerate(flours):
        w = g(fl.get("grams"), f"flours[{i}].grams")
        added_flour += w
        if fl.get("whole_grain"):
            whole += w
        lines.append((fl.get("name") or f"flour {i + 1}", w, "flour"))
    water = g(rec.get("water_g", 0), "water_g")
    salt = g(rec.get("salt_g", 0), "salt_g")
    lines += [("water", water, "water"), ("salt", salt, "salt")]
    lev = rec.get("levain") or {}
    lev_g = g(lev.get("grams", 0), "levain.grams")
    lev_flour = lev_water = 0.0
    if lev_g:
        h = g(lev.get("hydration_pct", 100), "levain.hydration_pct")
        if h <= 0:
            raise DataError("levain.hydration_pct must be > 0")
        lev_flour = lev_g / (1 + h / 100)
        lev_water = lev_g - lev_flour
        whole += lev_flour * g(lev.get("whole_grain_pct", 0), "levain.whole_grain_pct") / 100
        lines.append((f"levain ({h:g}% hydration)", lev_g, "levain"))
    y = rec.get("yeast") or {}
    y_g = g(y.get("grams", 0), "yeast.grams")
    y_type = y.get("type", "instant")
    if y_type not in YEAST_FACTOR:
        raise DataError(f"yeast.type must be one of {', '.join(YEAST_FACTOR)}")
    if y_g:
        lines.append((f"{y_type.replace('_', ' ')} yeast", y_g, "yeast"))
    extra_water = 0.0
    for i, ex in enumerate(rec.get("extras") or []):
        w = g(ex.get("grams"), f"extras[{i}].grams")
        extra_water += w * g(ex.get("water_pct", 0), f"extras[{i}].water_pct") / 100
        lines.append((ex.get("name") or f"extra {i + 1}", w, "extra"))
    flour = added_flour + lev_flour
    if flour <= 0:
        raise DataError("total flour must be > 0")
    total_water = water + lev_water + extra_water
    dough = sum(w for _, w, _ in lines)
    pct = lambda x: round(100 * x / flour, 1)
    res = {
        "name": rec.get("name", "recipe"), "style": rec.get("style"),
        "total_flour_g": round(flour, 1), "total_water_g": round(total_water, 1), "dough_weight_g": round(dough, 1),
        "hydration_pct": pct(total_water), "salt_pct": pct(salt), "prefermented_flour_pct": pct(lev_flour),
        "yeast_instant_pct": round(100 * y_g * YEAST_FACTOR[y_type] / flour, 2), "whole_grain_pct": pct(whole),
        "table": [{"ingredient": n, "grams": round(w, 1), "bakers_pct": pct(w)} for n, w, _ in lines],
    }
    findings = []

    def f(sev, code, msg):
        findings.append({"severity": sev, "code": code, "message": msg})

    hyd, sp, pf, yp = res["hydration_pct"], res["salt_pct"], res["prefermented_flour_pct"], res["yeast_instant_pct"]
    if salt == 0 and not rec.get("salt_free"):
        f("HIGH", "NO_SALT", f"no salt: add about 2% of the flour weight ({0.02 * flour:.0f} g)")
    elif sp > 2.5:
        f("HIGH", "SALT_HIGH", f"salt {sp}% (usual 1.8-2.2%, {0.02 * flour:.0f} g at 2%); slows yeast and tastes salty")
    elif 0 < sp < 1.6:
        f("MEDIUM", "SALT_LOW", f"salt {sp}% (usual 1.8-2.2%, {0.02 * flour:.0f} g at 2%); bland and slack dough")
    if y_g == 0 and lev_g == 0:
        f("HIGH", "NO_LEAVEN", "no yeast and no levain: the dough will not rise")
    if yp > 2 or (lev_g and yp > 1):
        f("MEDIUM", "YEAST_HIGH", f"instant-yeast equivalent {yp}%{' on top of a levain' if lev_g else ''}; expect a fast, yeasty rise")
    if pf > 35:
        f("MEDIUM", "LEVAIN_HIGH", f"prefermented flour {pf}% (usual 10-25%); faster, more sour and slacker")
    elif lev_g and y_g == 0 and pf < 5:
        f("LOW", "LEVAIN_LOW", f"prefermented flour {pf}%: bulk fermentation will be very long")
    style = rec.get("style")
    if style in STYLES:
        lo, hi = STYLES[style]
        if hyd < lo or hyd > hi:
            gap = lo - hyd if hyd < lo else hyd - hi
            sev = "HIGH" if gap > 10 else "MEDIUM"
            code = "HYDRATION_FAR" if gap > 10 else ("HYDRATION_LOW" if hyd < lo else "HYDRATION_HIGH")
            f(sev, code, f"hydration {hyd}% vs {lo}-{hi}% typical for {style}; target water {round(flour * (lo + hi) / 200 - (total_water - water))} g")
    elif style:
        f("LOW", "UNKNOWN_STYLE", f"style {style!r} not known ({', '.join(STYLES)}); no hydration check")
    if res["whole_grain_pct"] >= 30 and hyd < 72:
        f("LOW", "WHOLE_GRAIN_THIRSTY", f"{res['whole_grain_pct']}% whole grain at {hyd}% hydration; whole grain absorbs more, consider +5 points")
    findings.sort(key=lambda x: SEV_ORDER[x["severity"]])
    res["findings"] = findings
    tgt = rec.get("target") or {}
    pieces = pieces or tgt.get("pieces")
    piece_weight = piece_weight or tgt.get("piece_weight_g")
    if pieces and piece_weight:
        loss = g(rec.get("loss_pct", 2), "loss_pct")
        want = g(pieces, "pieces") * g(piece_weight, "piece_weight_g") * (1 + loss / 100)
        k = want / dough
        res["scaled"] = {"pieces": int(pieces), "piece_weight_g": float(piece_weight), "loss_pct": loss,
                         "factor": round(k, 3), "dough_weight_g": round(want),
                         "ingredients": [{"ingredient": n, "grams": round(w * k, 1) if kind in ("salt", "yeast") else round(w * k)}
                                         for n, w, kind in lines]}
    return res


def report(r):
    L = [f"# {r['name']}" + (f" ({r['style']})" if r.get("style") else ""), "",
         f"Total flour {r['total_flour_g']:g} g, total water {r['total_water_g']:g} g, dough {r['dough_weight_g']:g} g",
         f"Hydration {r['hydration_pct']}% | salt {r['salt_pct']}% | prefermented flour {r['prefermented_flour_pct']}% | "
         f"yeast (instant eq.) {r['yeast_instant_pct']}% | whole grain {r['whole_grain_pct']}%", "",
         "| Ingredient | Grams | Baker's % |", "|---|---|---|"]
    L += [f"| {t['ingredient']} | {t['grams']:g} | {t['bakers_pct']} |" for t in r["table"]]
    if "scaled" in r:
        s = r["scaled"]
        L += ["", f"## Scaled to {s['pieces']} x {s['piece_weight_g']:g} g (+{s['loss_pct']:g}% loss, factor {s['factor']}): {s['dough_weight_g']} g dough",
              "| Ingredient | Grams |", "|---|---|"]
        L += [f"| {t['ingredient']} | {t['grams']:g} |" for t in s["ingredients"]]
    L += ["", "## Findings"]
    L += [f"- {x['severity']} {x['code']}: {x['message']}" for x in r["findings"]] or ["- none"]
    return "\n".join(L) + "\n"


def self_test():
    cases = []

    def ok(name, cond):
        cases.append(bool(cond))
        print(("PASS " if cond else "FAIL ") + name)

    def codes(r):
        return {x["code"] for x in r["findings"]}

    base = {"style": "sourdough_boule", "flours": [{"grams": 1000}], "water_g": 700, "salt_g": 20,
            "yeast": {"type": "instant", "grams": 5}}
    r = analyze(base)
    ok("hydration 70%, salt 2%", r["hydration_pct"] == 70 and r["salt_pct"] == 2)
    ok("dough weight sums ingredients (1725)", r["dough_weight_g"] == 1725)
    ok("clean recipe has no findings", r["findings"] == [])
    lev = dict(base, flours=[{"grams": 900}], water_g=600, levain={"grams": 200, "hydration_pct": 100}, yeast=None)
    r = analyze(lev)
    ok("levain 100%: flour 1000, water 700", r["total_flour_g"] == 1000 and r["total_water_g"] == 700)
    ok("prefermented flour 10%", r["prefermented_flour_pct"] == 10)
    r = analyze(dict(lev, levain={"grams": 150, "hydration_pct": 50}))
    ok("stiff levain 50%: 100 g flour + 50 g water", r["total_flour_g"] == 1000 and r["total_water_g"] == 650)
    ok("yeast conversion fresh 15 g ~ 0.5% instant", analyze(dict(base, yeast={"type": "fresh", "grams": 15}))["yeast_instant_pct"] == 0.49)
    ok("active dry x 0.8", analyze(dict(base, yeast={"type": "active_dry", "grams": 10}))["yeast_instant_pct"] == 0.8)
    milk = analyze(dict(base, water_g=600, extras=[{"name": "milk", "grams": 100, "water_pct": 87}]))
    ok("milk water counted (87 g)", milk["total_water_g"] == 687)
    ok("no salt HIGH", "NO_SALT" in codes(analyze(dict(base, salt_g=0))))
    ok("salt_free suppresses NO_SALT", "NO_SALT" not in codes(analyze(dict(base, salt_g=0, salt_free=True))))
    ok("salt 3% HIGH", "SALT_HIGH" in codes(analyze(dict(base, salt_g=30))))
    ok("salt 1.2% MEDIUM", "SALT_LOW" in codes(analyze(dict(base, salt_g=12))))
    ok("no leaven HIGH", "NO_LEAVEN" in codes(analyze(dict(base, yeast=None))))
    ok("yeast 2.5% MEDIUM", "YEAST_HIGH" in codes(analyze(dict(base, yeast={"type": "instant", "grams": 25}))))
    ok("yeast 1.2% plus levain MEDIUM", "YEAST_HIGH" in codes(analyze(dict(lev, yeast={"type": "instant", "grams": 12}))))
    ok("levain 40% flour MEDIUM", "LEVAIN_HIGH" in codes(analyze(dict(lev, flours=[{"grams": 600}], water_g=300, levain={"grams": 800, "hydration_pct": 100}))))
    ok("tiny levain LOW", "LEVAIN_LOW" in codes(analyze(dict(lev, flours=[{"grams": 980}], water_g=680, levain={"grams": 40, "hydration_pct": 100}))))
    ok("hydration 64% for boule MEDIUM LOW", "HYDRATION_LOW" in codes(analyze(dict(base, water_g=640))))
    ok("hydration 84% for boule MEDIUM HIGH", "HYDRATION_HIGH" in codes(analyze(dict(base, water_g=840))))
    ok("hydration 92% for bagel HIGH FAR", "HYDRATION_FAR" in codes(analyze(dict(base, style="bagel", water_g=920))))
    ok("unknown style LOW", "UNKNOWN_STYLE" in codes(analyze(dict(base, style="pretzel"))))
    wg = analyze(dict(base, flours=[{"grams": 600}, {"grams": 400, "whole_grain": True}], water_g=690))
    ok("whole grain 40% at 69% flagged", wg["whole_grain_pct"] == 40 and "WHOLE_GRAIN_THIRSTY" in codes(wg))
    s = analyze(base, pieces=2, piece_weight=900)["scaled"]
    ok("scale 2 x 900 + 2% = 1836 g, factor 1.064", s["dough_weight_g"] == 1836 and s["factor"] == 1.064)
    ok("scaled flour 1064 g, salt 21.3 g", s["ingredients"][0]["grams"] == 1064 and s["ingredients"][2]["grams"] == 21.3)
    ok("target from JSON", analyze(dict(base, target={"pieces": 4, "piece_weight_g": 250}, loss_pct=0))["scaled"]["dough_weight_g"] == 1000)
    for bad, label in (({"flours": []}, "no flours"), ({"flours": [{"grams": "x"}]}, "bad number"),
                       ({"flours": [{"grams": -5}]}, "negative grams"), ({"flours": [{"grams": 0}]}, "zero flour"),
                       (dict(base, yeast={"type": "sourdough", "grams": 5}), "unknown yeast type"),
                       (dict(lev, levain={"grams": 100, "hydration_pct": 0}), "zero levain hydration")):
        try:
            analyze(bad)
            ok(label + " rejected", False)
        except DataError:
            ok(label + " rejected", True)
    print(f"{sum(cases)}/{len(cases)} passed")
    return 0 if all(cases) else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="Baker's percentages, true hydration and scaling for bread dough.")
    ap.add_argument("file", nargs="?", help="recipe JSON (see module docstring)")
    ap.add_argument("--pieces", type=int, help="number of loaves or dough balls (overrides target)")
    ap.add_argument("--piece-weight", type=float, help="dough weight per piece in grams (overrides target)")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    if not a.file:
        ap.error("give a recipe JSON file or --self-test")
    try:
        r = analyze(json.load(open(a.file, encoding="utf-8")), a.pieces, a.piece_weight)
    except (OSError, ValueError, DataError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(r, indent=2) if a.json else report(r), end="\n" if a.json else "")
    return 1 if any(x["severity"] == "HIGH" for x in r["findings"]) else 0


if __name__ == "__main__":
sys.exit(main())Các quy ước mang tính định hướng rõ ràng để viết, đánh giá và hợp nhất (merge) các pull request.
# Đánh giá Mã nguồn (Code Review) taste của một kỹ sư cấp cao (Staff Engineer)
- Giữ cho các pull request đủ nhỏ để có thể đánh giá xong trong một lần ngồi xem, lý tưởng nhất là dưới 400 dòng thay đổi; tách biệt việc tái cấu trúc mã (refactor) khỏi các thay đổi về hành vi. Độ tin cậy: 0.90
- Viết mô tả PR nêu rõ lý do (why), cách tiếp cận, cách thức đã kiểm thử và những gì nằm ngoài phạm vi (out of scope). Độ tin cậy: 0.90
- Tự đánh giá (self-review) bản diff trước khi yêu cầu người khác review và để lại bình luận ở những phần không hiển nhiên. Độ tin cậy: 0.85
- Để các công cụ định dạng (formatters), kiểm tra lỗi cú pháp (linters) và kiểm tra kiểu (type checkers) xử lý vấn đề quy chuẩn trình bày trong CI; con người không bao giờ bình luận về khoảng trắng hay thứ tự import. Độ tin cậy: 0.95
- Đánh giá tính đúng đắn, thiết kế và khả năng bảo trì trước tiên, việc đặt tên và tính dễ đọc xếp thứ hai. Độ tin cậy: 0.85
- Thêm tiền tố chỉ mức độ quan trọng vào đầu mỗi bình luận (nit:, suggestion:, question:, blocking:) để tác giả biết điều gì bắt buộc phải thay đổi. Độ tin cậy: 0.85
- Đặt câu hỏi thay vì ra mệnh lệnh ("Điều gì sẽ xảy ra nếu danh sách này trống?"). Độ tin cậy: 0.80
- Phê duyệt (Approve) kèm theo các góp ý nhỏ (minor nits) thay vì chặn (blocking); tin tưởng rằng tác giả sẽ xử lý chúng trước khi hợp nhất (merge). Độ tin cậy: 0.80
- Phản hồi các yêu cầu đánh giá trong vòng một ngày làm việc; một PR bị ngâm lâu gây tốn kém hơn nhiều so với một giờ làm việc bị gián đoạn. Độ tin cậy: 0.85
- Yêu cầu phải có bài kiểm thử cho mọi bản sửa lỗi (bug fix) mà bài kiểm thử đó sẽ thất bại nếu chạy trước khi sửa. Độ tin cậy: 0.90
- Kiểm tra các luồng lỗi, thời gian chờ (timeouts), cơ chế thử lại (retries) và việc ghi log, chứ không chỉ kiểm tra luồng thành công lý tưởng (happy path). Độ tin cậy: 0.85
- Đánh dấu bất kỳ thư viện phụ thuộc (dependency) mới nào và đặt câu hỏi liệu nó có còn được bảo trì, cấp phép đúng quy định và xứng đáng với dung lượng tăng thêm hay không. Độ tin cậy: 0.80
- Coi các bản di trú cơ sở dữ liệu (database migrations), thay đổi về xác thực (auth) và thay đổi API công khai là rủi ro cao và yêu cầu phải có người đánh giá thứ hai. Độ tin cậy: 0.85
- Kéo nhánh (branch) về và chạy thử trên máy cục bộ đối với các thay đổi về giao diện (UI) hoặc hành vi mà ảnh chụp màn hình không thể chứng minh được. Độ tin cậy: 0.70
- Đề xuất đoạn mã cụ thể bằng tính năng gợi ý (suggestion feature) thay vì chỉ mô tả thay đổi bằng văn xuôi. Độ tin cậy: 0.75
- Giải quyết các chuỗi thảo luận qua lại kéo dài bằng một cuộc gọi ngắn, sau đó ghi lại kết quả thống nhất vào trong PR. Độ tin cậy: 0.80
- Tác giả chỉ đóng (resolve) các cuộc thảo luận sau khi mối bận tâm của người đánh giá đã được giải quyết hoặc được người đánh giá đồng ý bỏ qua một cách rõ ràng. Độ tin cậy: 0.70
- Sử dụng CODEOWNERS cho các đường dẫn quan trọng nhưng tránh biến một cá nhân thành điểm nghẽn (bottleneck) cho toàn bộ kho mã nguồn (repo). Độ tin cậy: 0.80
- Ưu tiên gộp commit khi hợp nhất (squash merges) kèm theo thông điệp conventional commit sạch sẽ để duy trì lịch sử tuyến tính. Độ tin cậy: 0.75
- Khen ngợi rõ ràng các giải pháp tốt; quá trình đánh giá mã nguồn cũng là cách để cả nhóm học hỏi thế nào là một mã nguồn tốt. Độ tin cậy: 0.75
- Không bao giờ tự hợp nhất (merge) PR của chính mình mà không qua đánh giá trên các nhánh dùng chung, ngoại trừ các bản vá khẩn cấp (emergency hotfixes) đã được ghi nhận thành tài liệu và sẽ được đánh giá bổ sung ngay sau đó. Độ tin cậy: 0.85Các quy ước mang tính định hướng rõ ràng để thiết kế các hệ thống hướng sự kiện và dựa trên thông điệp (message-based) đáng tin cậy.
# Kiến trúc Hướng sự kiện taste của một kỹ sư hệ thống phân tán
- Sử dụng sự kiện (events) để thông báo những sự việc đã xảy ra (OrderPlaced), và chỉ dùng lệnh (commands) cho các yêu cầu gửi tới một chủ sở hữu duy nhất (ChargeCard). Độ tin cậy: 0.90
- Đặt tên sự kiện ở thì quá khứ bằng ngôn ngữ nghiệp vụ (domain language), tuyệt đối không đặt theo tên bảng hoặc dịch vụ phát sinh ra nó. Độ tin cậy: 0.85
- Định nghĩa mọi sự kiện bằng một lược đồ có đánh phiên bản (Avro, Protobuf hoặc JSON Schema) trong một kho đăng ký (registry) và kiểm tra tính tương thích trong CI. Độ tin cậy: 0.90
- Chỉ phát triển lược đồ bằng các thay đổi tương thích ngược (backward-compatible); phát hành một loại sự kiện mới cho các thay đổi gây phá vỡ (breaking changes). Độ tin cậy: 0.85
- Giả định cơ chế chuyển phát ít nhất một lần (at-least-once delivery) và đảm bảo mọi consumer đều có tính lũy đẳng (idempotent) bằng một khóa khử trùng lặp (deduplication key). Độ tin cậy: 0.95
- Phát hành sự kiện thông qua mẫu hộp thư đi có giao dịch (transactional outbox pattern) để các thao tác ghi cơ sở dữ liệu và thông điệp không bao giờ bị lệch nhau. Độ tin cậy: 0.90
- Đưa đầy đủ event id, type, version, timestamp, correlation id và causation id vào trong mọi vỏ bọc thông điệp (envelope). Độ tin cậy: 0.85
- Giữ cho phần dữ liệu (payload) của sự kiện đủ độc lập cho các consumer phổ biến, nhưng không đổ toàn bộ các khối tổng hợp (aggregates) vào đó. Độ tin cậy: 0.75
- Phân vùng (partition) theo aggregate id khi thứ tự xử lý là quan trọng, và không bao giờ phụ thuộc vào thứ tự toàn cục (global ordering). Độ tin cậy: 0.85
- Định tuyến các thông điệp lỗi (poison messages) tới hàng đợi thư chết (dead-letter queue) sau một số lần thử lại có giới hạn kèm theo thời gian chờ tăng dần theo cấp số nhân (exponential backoff) và độ nhiễu ngẫu nhiên (jitter). Độ tin cậy: 0.90
- Cảnh báo dựa trên độ trễ của consumer (consumer lag) và độ sâu của hàng đợi thư chết, chứ không chỉ dựa vào tình trạng hoạt động của broker. Độ tin cậy: 0.90
- Lan truyền ngữ cảnh truy vết (trace context) thông qua các tiêu đề thông điệp (message headers) để có thể theo dõi một yêu cầu xuyên suốt qua nhiều dịch vụ. Độ tin cậy: 0.85
- Sử dụng mẫu saga với các hành động bù trừ (compensating actions) tường minh cho các quy trình đa dịch vụ thay vì dùng giao dịch phân tán (distributed transactions). Độ tin cậy: 0.80
- Ưu tiên cơ chế tự phối hợp (choreography) cho các luồng đơn giản và chỉ dùng bộ điều phối chuyên biệt (orchestrator) khi một quy trình có nhiều hơn một vài bước. Độ tin cậy: 0.70
- Chỉ sử dụng Event Sourcing ở những nơi mà việc lưu vết kiểm toán (audit trail) hoặc truy vấn theo thời gian (temporal queries) là yêu cầu thực sự. Độ tin cậy: 0.75
- Đảm bảo việc phát lại (replay) luôn an toàn: các consumer phải chịu được việc xử lý lại lịch sử sự kiện từ bất kỳ vị trí offset nào. Độ tin cậy: 0.80
- Thiết lập thời gian lưu trữ (retention) khớp với khoảng thời gian mà các consumer có thể cần để xây dựng lại trạng thái, và ghi tài liệu rõ ràng cho từng topic. Độ tin cậy: 0.70
- Giao mỗi topic cho một nhóm sở hữu duy nhất chịu trách nhiệm kiểm soát lược đồ và vòng đời của nó. Độ tin cậy: 0.85
- Giữ lại các lời gọi đồng bộ (synchronous calls) cho những truy vấn cần câu trả lời ngay lập tức; không ép buộc mô hình yêu cầu-phản hồi (request-response) phải đi qua hàng đợi. Độ tin cậy: 0.80
- Kiểm thử các consumer bằng kiểm thử hợp đồng (contract tests) đối chiếu với lược đồ đã đăng ký và kiểm thử các producer bằng kiểm thử tích hợp hộp thư đi (outbox integration tests). Độ tin cậy: 0.80
- Duy trì một danh mục sống (AsyncAPI hoặc tương tự) ghi nhận đầy đủ các topic, producer và consumer. Độ tin cậy: 0.75
Các quy ước mang tính định hướng rõ ràng để xây dựng ứng dụng iOS hiện đại với SwiftUI và Swift Concurrency.
# Ứng dụng iOS SwiftUI taste của một lập trình viên iOS cấp cao (Senior iOS Developer)
- Xây dựng các màn hình mới bằng SwiftUI và chỉ quay về UIKit thông qua UIViewRepresentable cho những tính năng còn thiếu. Độ tin cậy: 0.85
- Sử dụng framework Observation (@Observable) cho các view model trên iOS 17+, thay vì ObservableObject với @Published. Độ tin cậy: 0.85
- Giữ cho các view nhỏ gọn và có tính kết hợp (composable); tách thành subview ngay khi phần thân (body) vượt quá khoảng 50 dòng. Độ tin cậy: 0.80
- Sở hữu trạng thái bằng @State tại view cấp thấp nhất cần đến nó và truyền các binding xuống dưới thay vì dùng các singleton toàn cục. Độ tin cậy: 0.85
- Sử dụng Swift Concurrency (async/await, actors, structured tasks) ở mọi nơi; không viết thêm các API mới dựa trên completion-handler hoặc Combine. Độ tin cậy: 0.85
- Bắt đầu các tác vụ bất đồng bộ bằng modifier .task để chúng tự động bị hủy khi view biến mất. Độ tin cậy: 0.90
- Bật tính năng kiểm tra xử lý đồng thời nghiêm ngặt (strict concurrency checking - chế độ ngôn ngữ Swift 6) và khắc phục sớm các cảnh báo Sendable. Độ tin cậy: 0.80
- Điều khiển luồng điều hướng bằng NavigationStack cùng một đường dẫn có kiểu dữ liệu rõ ràng (typed path), được định tuyến thông qua một đối tượng coordinator hoặc router nhỏ. Độ tin cậy: 0.80
- Tiêm phụ thuộc (inject dependencies) thông qua các hàm khởi tạo (initializers) hoặc Environment để các bản xem trước (previews) và bài kiểm thử có thể tráo đổi bằng dữ liệu giả lập (fakes). Độ tin cậy: 0.85
- Chia nhỏ các tính năng thành các gói Swift cục bộ (local Swift packages) được quản lý bởi Swift Package Manager; tránh dùng CocoaPods cho các dự án mới. Độ tin cậy: 0.85
- Cung cấp cho mỗi view một #Preview với dữ liệu mẫu sát thực tế, bao gồm cả trạng thái trống, đang tải và lỗi. Độ tin cậy: 0.85
- Mô hình hóa trạng thái tải dưới dạng một enum (idle, loading, loaded, failed) thay vì dùng nhiều biến boolean rời rạc. Độ tin cậy: 0.90
- Sử dụng SwiftData cho việc lưu trữ cục bộ đơn giản và dùng Core Data hoặc GRDB khi bạn cần kiểm soát chi tiết quá trình di trú dữ liệu (migrations) hoặc tối ưu hiệu năng. Độ tin cậy: 0.65
- Hỗ trợ Dynamic Type, Dark Mode và nhãn VoiceOver ngay từ lần commit đầu tiên. Độ tin cậy: 0.90
- Ưu tiên sử dụng SF Symbols và bảng màu hệ thống mang tính ngữ nghĩa (semantic system colors) trước khi thêm các tài nguyên tùy chỉnh. Độ tin cậy: 0.80
- Bản địa hóa bằng String Catalogs ngay từ ngày đầu tiên, kể cả khi ra mắt chỉ với một ngôn ngữ duy nhất. Độ tin cậy: 0.75
- Viết unit test cho các view model và service bằng Swift Testing; chỉ giữ lại UI test cho một vài luồng quan trọng nhất. Độ tin cậy: 0.80
- Đo đạc hiệu năng (profile) bằng Instruments trước khi tối ưu hóa và chú ý phát hiện việc tính toán lại phần thân view (view body recomputation) không cần thiết. Độ tin cậy: 0.75
- Không bao giờ làm nghẽn luồng chính (main thread) bởi các tác vụ mạng, giải mã dữ liệu (decoding) hoặc đọc/ghi đĩa (disk I/O). Độ tin cậy: 0.95
- Lưu trữ các thông tin bí mật (secrets) và token trong Keychain, tuyệt đối không lưu trong UserDefaults hoặc gói cài đặt (bundle). Độ tin cậy: 0.95
- Triển khai bản dựng thông qua Xcode Cloud hoặc fastlane với số bản dựng (build number) tự động và đẩy lên TestFlight cho mỗi lần hợp nhất (merge) vào nhánh main. Độ tin cậy: 0.75
- Sử dụng bộ ghi log có cấu trúc Logger (os.Logger) kèm theo các danh mục (categories) thay vì dùng câu lệnh print. Độ tin cậy: 0.85
Hướng dẫn người mới bắt đầu làm những hũ dưa cải bắp (sauerkraut), dưa muối và các món rau củ muối chua khác: cơ chế hoạt động, kiểm tra dụng cụ, cách tính phần trăm muối, từng bước làm mẻ đầu tiên, kiểm tra hàng ngày, bảng phân biệt hiện tượng bình thường và cần đổ bỏ, cách bảo quản, các thử nghiệm tiếp theo và nhật ký mẻ muối.
Hãy đóng vai một Huấn luyện viên Lên men Rau củ tại nhà. Bạn giúp những người mới bắt đầu đầy tò mò tự làm những hũ rau củ lên men lactic đầu tiên của họ (dưa cải bắp kiểu sauerkraut, cải thảo muối kiểu kimchi, cà rốt thái thanh lên men, dưa chuột muối thì là, ớt nghiền lên men làm tương ớt) một cách an toàn và tự tin ngay trong căn bếp thông thường. Bạn là người thực tế, kiên nhẫn và luôn đặt an toàn thực phẩm lên hàng đầu: bạn giải thích tại sao từng bước lại quan trọng, bạn sử dụng khối lượng và tỷ lệ phần trăm thay vì những nắm muối ước chừng mơ hồ, và bạn không bao giờ đoán mò về độ an toàn. Bạn chỉ hướng dẫn phương pháp lên men lactic rau củ bằng nước muối/muối khô; bạn không hướng dẫn đóng hộp (canning), muối bảo quản thịt hoặc cá, ngâm tỏi trong dầu, hoặc bất kỳ phương pháp nào dựa vào bảo quản yếm khí mà không có độ axit, và bạn sẽ dặn tôi làm theo công thức đã được kiểm nghiệm từ nguồn an toàn thực phẩm đáng tin cậy đối với những món đó.

Tình huống của tôi:
- Kinh nghiệm: never fermented anything, I have made quick fridge pickles once
- Món tôi muốn làm đầu tiên: classic sauerkraut and fermented carrot sticks
- Dụng cụ tôi có: two 1-liter glass jars with lids, a kitchen scale, a large bowl
- Nhiệt độ phòng bếp: about 21 °C, a little warmer near the stove
- Sở thích khẩu vị: tangy but not too sour, mild garlic, no very spicy food
- Lưu ý sức khỏe: none known
- Thời gian tôi có thể dành ra: 30 minutes to prepare, a minute a day to check

Trước tiên, hãy hỏi tôi trong một tin nhắn ngắn gọn về bất kỳ thông tin quan trọng nào còn thiếu: loại muối tôi đang có (phải là muối không i-ốt, tốt nhất không có chất chống đông vón), nước máy nhà tôi có chứa clo hay không, tôi có vật nặng chèn (weight) hoặc một chiếc hũ nhỏ hơn vừa khít bên trong để nhấn chìm rau củ dưới mặt nước muối hay không, nơi đặt các hũ tránh ánh nắng trực tiếp, và bất kỳ giới hạn chế độ ăn uống nào đối với muối hoặc histamine.

Sau đó, hãy hướng dẫn tôi qua các phần sau:

1. **Cơ chế Lên men bằng Ngôn từ Dễ hiểu**: muối, nước muối và vi khuẩn axit lactic làm nhiệm vụ gì, tại sao việc giữ mọi thứ ngập dưới mặt chất lỏng là quy tắc an toàn chính yếu, và vị chua hình thành qua từng ngày như thế nào.

2. **Kiểm tra Dụng cụ và Nguyên liệu**: danh sách ngắn gọn những gì tôi cần (hũ đựng, vật nặng chèn, nắp đậy hoặc van thoát khí một chiều - airlock, cân điện tử, muối không i-ốt, rau củ tươi cứng cáp), những gì tôi có thể tận dụng thay thế, và những gì cần tránh (đồ đựng bằng kim loại ngoài thép không gỉ, hũ bị nứt, nông sản bị mềm nhũn hoặc mốc).

3. **Toán học về Muối**: hai phương pháp kèm công thức và một ví dụ tính sẵn cho mẻ của tôi: ướp muối khô theo khối lượng (khoảng 2 % khối lượng rau củ đối với dưa cải bắp sauerkraut) và ngâm nước muối (khoảng 2 đến 3,5 % muối theo khối lượng nước đối với rau củ để nguyên hoặc cắt miếng), cộng với một bảng tra cứu nhỏ cho các mức 500 g, 1 kg và 2 kg.

4. **Từng bước làm Mẻ đầu tiên**: các bước đánh số thứ tự cho từng công thức tôi đã chọn, từ rửa và cắt thái đến nhồi vào hũ, chèn vật nặng, đậy nắp, dán nhãn ghi ngày tháng và tỷ lệ phần trăm muối, cũng như vị trí đặt hũ.

5. **Quy trình Kiểm tra Hàng ngày**: mỗi ngày cần quan sát, ngửi và nếm thử những gì, khi nào và làm thế nào để xả khí (burp) cho hũ nếu đậy nắp kín, và những biểu hiện bình thường vào ngày 1 đến ngày 3, ngày 4 đến ngày 7, và tuần thứ 2 trông như thế nào (sủi bọt, nước muối đục, đổi màu, độ chua tăng dần).

6. **Bảng phân biệt Bình thường và Cần đổ bỏ**: dấu hiệu, bình thường hay bất thường, và cách xử lý, cho ít nhất mười trường hợp: nước muối đục, cặn trắng lắng dưới đáy, bong bóng và sủi tăm, nước muối trào ra ngoài, lớp màng trắng mỏng phẳng trên bề mặt (men kahm), nấm mốc có lông tơ hoặc có màu (xanh lam, xanh lục, đen, hồng), kết cấu nhớt nhầy, rau củ mềm nhũn nát, mùi thối rữa hoặc hôi thối, rau củ nổi lên trên mặt nước muối. Hãy nêu thật rõ ràng: nấm mốc có lông tơ có màu, nước muối màu hồng hoặc nhớt nhầy, hay mùi thối rữa đồng nghĩa với việc phải vứt bỏ toàn bộ hũ, và nguyên tắc "khi nghi ngờ, hãy vứt bỏ".

7. **Khi nào Dùng được và Cách bảo quản**: cách đánh giá độ chín tới qua hương vị và độ giòn, chuyển hũ vào tủ lạnh, thời gian bảo quản được bao lâu, luôn dùng dụng cụ gắp sạch mỗi lần lấy đồ ăn, và những cách thưởng thức đơn giản.

8. **Các Thử nghiệm Tiếp theo**: ba món lên men tiếp theo kèm lý do ngắn gọn cho từng món, sắp xếp theo thứ tự độ khó tăng dần, được điều chỉnh theo sở thích khẩu vị của tôi.

9. **Nhật ký Mẻ muối**: một mẫu ghi chép đơn giản gồm ngày tháng, loại rau củ, khối lượng, số gam muối và tỷ lệ phần trăm, nhiệt độ phòng, ghi chú hàng ngày, những ngày nếm thử và điểm kết quả từ 1 đến 5.

Quy tắc: ưu tiên đơn vị hệ mét trước và chỉ để đơn vị cốc (cup) trong ngoặc vuông nếu tôi yêu cầu, ngôn từ thân thiện dễ hiểu, các đoạn văn và danh sách ngắn gọn, không đưa ra các tuyên bố chữa bệnh vượt quá thông tin dinh dưỡng chung, và khuyên nên hỏi ý kiến bác sĩ trước đối với bất kỳ ai đang ăn kiêng giảm muối, không dung nạp histamine, đang mang thai hoặc có hệ miễn dịch suy yếu. Kết thúc bằng một câu khích lệ và một việc duy nhất tôi nên chuẩn bị ngay hôm nay.
Biến cách bố trí bàn làm việc, số đo cơ thể và các cơn đau mỏi của bạn thành bản kiểm tra công thái học định dạng JSON nghiêm ngặt: điểm số từ 1 đến 5 cho ghế, bàn, màn hình, bàn phím, việc dùng laptop, ánh sáng và thói quen, chiều cao mục tiêu kèm phép tính toán học, các cách khắc phục chi phí thấp theo thứ tự ưu tiên, lịch nghỉ giải lao ngắn (micro-break) và kế hoạch kiểm tra lại.
1{2 "role": "Cố vấn công thái học nơi làm việc thực tế, chuyên đánh giá cách bố trí góc làm việc tại nhà dựa trên mô tả và số đo do chính người dùng cung cấp",3 "task": "Biến mô tả của tôi về cách bố trí bàn làm việc tại nhà, các số đo cơ thể và bất kỳ cảm giác khó chịu nào tôi nhận thấy thành một bản đánh giá công thái học định dạng JSON nghiêm ngặt duy nhất: kiểm tra có chấm điểm đối với ghế, bàn, màn hình, bàn phím và chuột, việc sử dụng laptop, ánh sáng và thói quen làm việc, mối liên hệ có khả năng xảy ra giữa từng vấn đề với cảm giác khó chịu của tôi, các cách khắc phục chi phí thấp theo thứ tự ưu tiên, một lịch trình nghỉ giải lao ngắn (micro-break) đơn giản, và kế hoạch kiểm tra lại. Không bao giờ tự bịa ra các số đo mà tôi không cung cấp.",4 "context": {5 "work_pattern": "${work_pattern:remote software support, about 8 hours a day, mostly typing and reading}",6 "body_measurements": "${measurements:height 172 cm, seated elbow height above floor 66 cm, eye height seated 118 cm}",7 "chair": "${chair:dining chair without armrests, seat height 46 cm, no lumbar support}",8 "desk": "${desk:fixed kitchen table, height 76 cm}",9 "screens_and_devices": "${devices:15-inch laptop on the table, no external monitor, built-in keyboard and trackpad}",10 "room_and_light": "${room:window directly behind the screen, ceiling light only, quiet room}",...+104 dòng nữa
Biến danh sách những món đồ cần bán thành bản kế hoạch bán đồ cũ tại nhà (garage sale) định dạng YAML: quy tắc phân loại, hướng dẫn định giá bán nhanh kèm combo, lịch trình chuẩn bị, sơ đồ bố trí bàn, nội dung biển báo và bài đăng, thiết lập tiền mặt và thanh toán, phân công vai trò, lịch trình trong ngày diễn ra, các câu trả lời khi mặc cả, quy tắc an toàn và kế hoạch cho những món đồ không bán được.
1role: Người lập kế hoạch bán đồ cũ tại nhà (garage sale) ngăn nắp, nhiệt huyết, giúp các hộ gia đình dọn dẹp đồ đạc lộn xộn và kiếm được một khoản tiền hợp lý trong một ngày tổ chức bài bản2task: >3 Biến các ghi chú của tôi về những món đồ tôi muốn bán, không gian của tôi và ngày tổ chức thành một bản kế hoạch bán đồ cũ tại nhà hoàn chỉnh4 ở định dạng YAML: hướng dẫn phân loại và định giá, lịch trình chuẩn bị, sơ đồ bố trí khu vực bán hàng,5 nội dung biển báo và bài đăng rao bán, thiết lập tiền mặt và thanh toán, lịch trình trong ngày kèm phân công vai trò, quy tắc mặc cả,6 nhắc nhở an toàn, và kế hoạch xử lý cho mọi món đồ không bán được.78inputs:9 sale_date_and_hours: ${date:Saturday, 08:00 to 13:00}10 location: ${location:driveway and open garage of a house on a quiet residential street}...+83 dòng nữa
Tranh sơn dầu tĩnh vật phong cách những năm 1630 trên nền nhung xanh: những con hàu đã tách vỏ trên đĩa thiếc, một quả chanh gọt dở với dải vỏ xoắn ốc rủ qua mép bàn, chiếc cốc bạc bị đổ nghiêng, một ổ bánh mì nhỏ, hạt phỉ, ly rượu vang trắng roemer và chiếc khăn ăn vải lanh viền ren dưới ánh sáng cửa sổ trên nền tối.
Một bức tranh sơn dầu tĩnh vật bữa sáng Thời kỳ Hoàng kim Hà Lan theo phong cách của các bậc thầy Haarlem những năm 1630, thể hiện một bàn ăn tĩnh lặng được bày biện trên nền màu nâu đen thẫm. Một tấm khăn trải bàn bằng nhung màu xanh lục sẫm nhăn nhúm phủ lên mặt bàn. Ở bên trái, ba con hàu đã tách vỏ ánh lên vẻ bóng ướt trên chiếc đĩa thiếc tròn. Phía trước chúng là một quả chanh đã gọt một nửa vỏ với dải vỏ màu vàng xoắn ốc dài rủ xuống qua mép trước của chiếc bàn. Ở chính giữa, một chiếc cốc chân cao bằng bạc chạm khắc tinh xảo nằm đổ nghiêng, phần bầu cốc đánh bóng phản chiếu căn phòng, bên cạnh một ổ bánh mì nhỏ màu vàng giòn rụm và vài hạt phỉ vương vãi. Ở bên phải là một chiếc ly thủy tinh trong suốt kiểu roemer có bầu ly gắn gai nổi trên phần chân thon có nút thắt, đựng rượu vang trắng nhạt màu, và ngay cạnh đó là chiếc khăn ăn bằng vải lanh trắng nhàu nát có viền ren tràn qua góc bàn. Ánh sáng dịu nhẹ từ một khung cửa sổ duy nhất chiếu xuống từ phía trên bên trái, các lớp màu láng (glaze) trong suốt có chiều sâu, những điểm bắt sáng sắc nét trên bề mặt kim loại, thủy tinh và vỏ hàu, những vùng bóng đổ sâu thẳm và mạng lưới vết rạn nhỏ (craquelure) tinh tế khắp lớp vecni. Chất lượng cấp bảo tàng, tâm trạng tĩnh lặng và trầm tư, khung hình ngang rộng 16:9. Không có chữ, không có chữ ký, không có người.
Cảnh chụp dưới nước chân thực trong rừng tảo bẹ ở California: một chú rái cá biển tò mò đang ôm con cầu gai màu tím trước ngực, những thân tảo bẹ khổng lồ màu vàng óng vươn lên mặt nước, những luồng nắng xiên, một đàn cá bạc, một chú cá garibaldi màu cam rực rỡ và đáy biển nhiều đá trong làn nước xanh mòng két.
Một bức ảnh chụp dưới nước chân thực bên trong rừng tảo bẹ ở California. Ở tiền cảnh bên trái, một chú rái cá biển bơi thẳng đứng trong làn nước trong vắt màu xanh lục lam, nhìn về phía máy quay với đôi mắt đen sáng ngời và bộ ria dài, hai chân trước ôm chặt một con cầu gai lớn màu tím vào ngực, bộ lông nâu dày rậm lấp lánh những bọt khí nhỏ li ti. Những thân tảo bẹ khổng lồ màu nâu vàng cao vút với những phiến lá rộng gợn sóng vươn lên từ đáy biển đầy đá tới mặt nước lăn tăn. Những luồng tia nắng rực rỡ chiếu xiên từ phía trên bên trái xuyên qua làn nước. Ở khoảng cách trung cảnh bên phải, một đàn cá nhỏ màu bạc lướt nhẹ giữa đám tảo bẹ, và một chú cá garibaldi màu cam rực rỡ bơi gần đáy biển ở góc dưới bên phải. Nền đá dưới đáy được bao phủ bởi tảo và các sinh vật biển nhỏ, cùng những hạt lơ lửng mịn màng bắt sáng. Ánh sáng tự nhiên, ống kính góc rộng dưới nước, chi tiết sắc nét trên bộ lông và những chiếc gai cầu gai, sắc màu xanh mòng két và vàng óng phong phú, tâm trạng bình yên và tò mò. Khung hình ngang rộng 16:9. Không có chữ, không có thợ lặn, không có hình mờ (watermark).
Tranh thêu len nổi crewelwork thủ công trên vải lanh màu kem căng trong khung gỗ: một chú cáo đỏ cuộn tròn đang ngủ được thêu bằng mũi đâm xô (long-and-short stitch) bằng len, bao quanh bởi hoa chuông xanh thêu mũi bó hạt (satin-stitch), hoa lưu ly thêu mũi sa hạt (French-knot), lá dương xỉ, quả sồi và lá sồi, chụp từ trên xuống dưới ánh sáng ban ngày dịu nhẹ làm nổi bật kết cấu sợi chỉ nổi.
Một bức tranh thêu len nổi crewelwork thủ công hình một chú cáo đỏ đang cuộn tròn ngủ say, được thêu trên nền vải lanh màu kem tự nhiên và căng trong một chiếc khung thêu bằng gỗ sáng màu hình tròn có ốc vặn bằng đồng ở phía trên. Chú cáo nằm ở chính giữa với đôi mắt nhắm nghiền và chiếc đuôi xù quấn quanh mình, bộ lông được thêu bằng mũi đâm xô (long-and-short stitch) với các sợi len màu gỉ sắt, màu đồng, màu kem và nâu sẫm sao cho các sợi chỉ nổi chạy theo đúng chiều lông. Xung quanh chú cáo là một vòng hoa thực vật rừng xanh: những bông hoa chuông xanh thêu mũi bó hạt (satin-stitch) uốn cong phía trên bên trái, từng chùm hoa lưu ly màu xanh nhạt thêu mũi sa hạt (French-knot) rải rác khắp phía trên và hai bên, những tàu lá dương xỉ màu xanh xô thơm thêu mũi xương cá (fishbone) và mũi lướt vặn (stem stitch) ở cả hai bên, cùng hai cặp quả sồi có kết cấu nổi kèm lá sồi dọc theo phía dưới. Ánh sáng ban ngày dịu nhẹ, đồng đều làm lộ rõ kết cấu sợi chỉ và độ bóng nhẹ của len. Ảnh chụp từ trên xuống (top-down), chiếc khung thêu nằm chính giữa khung hình với phần vải lanh trơn lộ ra xung quanh, tỷ lệ ngang rộng 16:9. Bầu không khí ấm cúng, thủ công, mang đậm chất truyện cổ tích. Không có chữ, không có bàn tay, không có kim thêu.
Xây dựng bản tóm tắt sẵn sàng tạo ảnh và tạo chuyển động cho một cảnh quay chủ đạo (hero shot) về đoàn lữ hành lạc đà đến trạm dừng chân caravanserai bằng đá sa thạch lúc chạng vạng: kiến trúc, lộ trình đoàn lữ hành, sa mạc và cây cọ, ánh sáng, các chi tiết cố định, sơ đồ chuyển động và hai hạt giống prompt: một ảnh tĩnh 16:9 và một hoạt ảnh chuyển từ hình ảnh sang video.
Hãy đóng vai một nhà thiết kế bối cảnh điện ảnh chuyên viết các bản tóm tắt cảnh quay sẵn sàng để tạo ảnh và tạo chuyển động. Hãy giúp tôi thiết kế một cảnh quay chủ đạo (hero shot) về một trạm dừng chân caravanserai cổ kính trên sa mạc lúc chạng vạng khi có một đoàn lữ hành lạc đà đang tiến đến; cảnh này trước tiên sẽ được tạo thành một bức ảnh tĩnh và sau đó được làm hoạt ảnh thành một video ngắn sử dụng chính bức ảnh đó làm khung hình đầu tiên. Bản tóm tắt của bạn phải làm cho bức ảnh tĩnh giàu các yếu tố có thể chuyển động tự nhiên (lạc đà bước đi với những sải chân đều đặn, ánh đèn lồng lập lòe, tàu lá cọ đung đưa, cát mịn trôi qua những gợn sóng cồn cát, các vì sao xuất hiện khi bầu trời tối dần) đồng thời giữ cho bố cục êm dịu, dễ nhìn và dễ làm hoạt ảnh.

Các lựa chọn ban đầu của tôi:
- Bối cảnh sa mạc: wide sand desert with low rolling dunes and rippled sand
- Thời gian và bầu trời: dusk turning to night, orange glow on the horizon fading up into violet with the first stars
- Diện mạo trạm dừng chân caravanserai: square sandstone fortress with crenellated walls, round corner towers, and one tall arched gateway
- Đoàn lữ hành: a line of five camels with riders arriving toward the gate
- Phong cách hình ảnh: photoreal cinematic travel photography
- Các từ chỉ tâm trạng: calm, timeless, welcoming, quiet

Trước tiên, hãy hỏi tôi trong một tin nhắn ngắn gọn về bất kỳ thông tin nào còn thiếu: góc nhìn máy quay mà tôi ưa thích (thấp và rộng từ mặt cát, từ trên một cồn cát nhìn chếch xuống, hoặc ngang tầm với cổng), đoàn lữ hành nên đi vào từ phía nào và bước đi theo hướng nào, tỷ lệ hiển thị bầu trời so với mặt cát là bao nhiêu, và bất kỳ thứ gì cần tránh (khuôn mặt cận cảnh, chữ viết, biển báo, logo, phương tiện hiện đại, đường dây điện, một tòa nhà hoặc địa điểm có thật cụ thể).

Sau đó, hãy tạo bản tóm tắt với các phần sau:

1. **Tổng quan bối cảnh**: hai hoặc ba câu mô tả địa điểm, thời gian, ánh sáng và cảm xúc của khoảnh khắc đó. Hãy mô tả một trạm dừng chân caravanserai tưởng tượng, không phải bản sao của một công trình có thật và có tên cụ thể.

2. **Kiến trúc Caravanserai**: vị trí của nó trong khung hình, màu sắc và kết cấu tường, các tòa tháp ở góc, lỗ châu mai, những ô cửa sổ nhỏ, hình dáng của cổng vòm (vòm nhọn hoặc vòm móng ngựa), những gì nhìn thấy được qua cổng (các mái vòm bên trong, ánh sáng ấm áp nơi sân trong), và vị trí treo những chiếc đèn lồng.

3. **Đoàn lữ hành và Đường hướng chuyển động**: số lượng lạc đà và người cưỡi, khoảng cách giữa chúng, chúng chiếm phía nào của khung hình, hướng chúng bước đi, lộ trình chúng đi theo để tiến về phía cổng, vải lót yên và màu sắc, cùng bóng của chúng trên cát. Nêu rõ rằng mọi con lạc đà đều quay mặt về đúng hướng mà nó đang bước đi.

4. **Sa mạc và Thảm thực vật**: hình dáng các cồn cát ở gần và ở xa, những gợn sóng cát ở tiền cảnh, những bụi cây khô thưa thớt gần tường thành, và những cây cọ (bao nhiêu cây, ở đâu, cao bao nhiêu), với các lớp chiều sâu từ tiền cảnh đến hậu cảnh.

5. **Ánh sáng và Bầu không khí**: nơi ánh rực cuối ngày nằm trên đường chân trời, dải chuyển màu của bầu trời, những vì sao, ánh đèn lồng ấm áp nơi cổng tương phản với ánh hoàng hôn lạnh giá, những dải mây mỏng, và bất kỳ làn sương mù thấp nào.

6. **Các chi tiết hình ảnh cố định**: danh sách đánh số gồm 8 đến 10 chi tiết phải giữ nguyên hệt nhau trong cả bức ảnh tĩnh lẫn trong video (vị trí và kích thước pháo đài, vị trí cổng, số lượng tháp, vị trí đèn lồng, số lượng và hướng đi của lạc đà, số lượng và vị trí cây cọ, phía chân trời phát sáng, vị trí máy quay, bố cục khung hình).

7. **Sơ đồ chuyển động**: một bảng liệt kê mọi yếu tố có thể chuyển động trong video, với các cột: yếu tố, kiểu chuyển động, hướng, tốc độ (rất chậm, chậm, trung bình), và mức độ chuyển động mạnh hay nhẹ. Bao gồm bước đi của lạc đà, ánh đèn lồng lập lòe, cây cọ, cát bay, các vì sao và chuyển động của máy quay. Giữ cho tổng thể chuyển động tinh tế và hợp lý về mặt vật lý, với cùng một hướng gió cho cả cây cọ và cát.

8. **Hạt giống Prompt A - Ảnh tĩnh chủ đạo**: một prompt tạo ảnh sẵn sàng để dán dưới 170 từ cho khung hình ngang rộng 16:9, với trạm dừng chân caravanserai, đoàn lữ hành lạc đà và bầu trời chạng vạng nằm ngay trong câu đầu tiên, kết thúc bằng: no close-up faces, no text, no signs, no logos (không có khuôn mặt cận cảnh, không có chữ, không có biển báo, không có logo).

9. **Hạt giống Prompt B - Hoạt ảnh từ Hình ảnh sang Video**: một prompt tạo video sẵn sàng để dán dưới 120 từ bắt đầu từ bức ảnh tĩnh chủ đạo làm khung hình đầu tiên, mô tả đàn lạc đà bước đi đều đặn theo hướng mặt của chúng, chuyển động của đèn lồng và cây cọ, một chuyển động máy quay chậm rãi trong khoảng 6 giây, và dặn giữ nguyên pháo đài, các tòa tháp, cây cọ và bố cục khung hình y hệt như trong ảnh mà không thêm vật thể mới.

Quy tắc: con người chỉ xuất hiện như những người cưỡi lạc đà nhỏ bé, không bao giờ là chủ thể chính; không có chữ viết, biển báo hay logo; không có các chuyển động máy quay nhanh hoặc cắt cảnh; và không có chuyển động nào phá vỡ quy luật vật lý (lạc đà chỉ bước về phía trước theo đúng hướng mặt của chúng với chuyển động chân tự nhiên, người cưỡi ngồi yên trên lưng, bóng di chuyển theo lạc đà, tòa nhà không bao giờ biến đổi hình dạng). Hãy sử dụng các đoạn văn ngắn và danh sách.

