@f
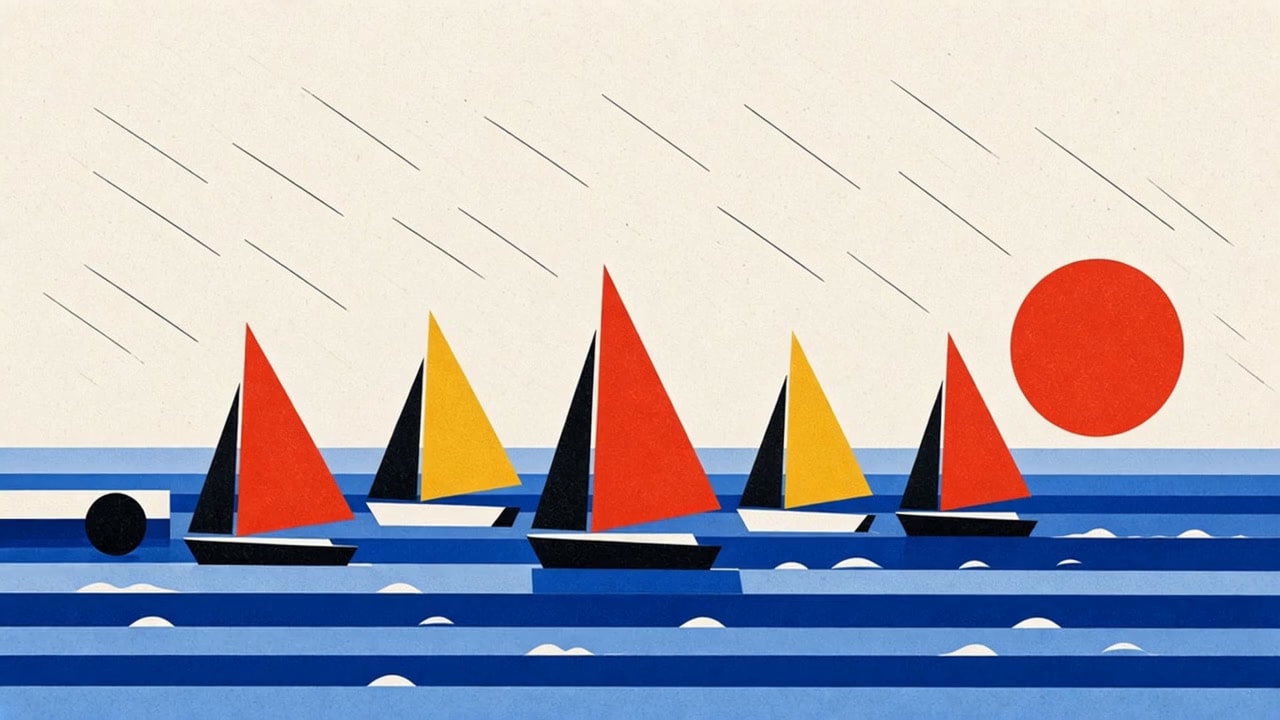
Áp phích hiện đại phong cách Bauhaus vẽ năm chiếc thuyền buồm đang đua trên vịnh xanh, được tạo hình hoàn toàn từ các hình tròn, hình tam giác và hình chữ nhật: những cánh buồm màu đỏ cơ bản, vàng và đen, mặt biển xanh coban phân dải, mặt trời lớn màu đỏ cam, cầu tàu màu trắng, và nền giấy trắng ngà có hạt in lụa.
Năm chiếc thuyền buồm với những cánh buồm hình tam giác táo bạo đang đua qua một vịnh biển xanh êm ả hướng về phía cầu tàu nhỏ của bến cảng, được vẽ dưới dạng áp phích hình học phong cách Bauhaus chỉ cấu thành từ các hình tròn, hình tam giác, hình chữ nhật và những đường thẳng. Những cánh buồm là các hình tam giác phẳng mang màu đỏ cơ bản, vàng và đen, thân thuyền là những hình thang mảnh màu đen và trắng, cùng một hình tròn mặt trời lớn màu đỏ cam nằm thấp ở phía bên phải trên đường chân trời. Mặt biển là các dải ngang xếp lớp màu xanh coban, xanh hải quân (navy) và xanh lam nhạt, với những hình bán nguyệt nhỏ màu trắng làm sóng biển, và một vài đường chéo mảnh gợi tả làn gió. Một cầu tàu màu trắng đơn giản gồm các hình chữ nhật xếp chồng lên nhau vươn ra từ rìa bên trái, với một chiếc phao tròn màu đen ở tiền cảnh. Nền giấy trắng ngà có kết cấu vân giấy, các cạnh sắc nét rõ ràng, mảng màu phẳng không chuyển sắc (no gradients), hiệu ứng hạt in lụa tinh tế và chút lệch màu in nhẹ (ink misregistration), bố cục cân bằng bất đối xứng mạnh mẽ cùng khoảng âm (negative space) rộng thoáng trên bầu trời. Tinh thần thiết kế hiện đại những năm 1920, gọn gàng và tràn đầy niềm vui. Khung hình ngang rộng 16:9. Không có người, không có chữ, không có chữ cái, không có con số, không có logo.
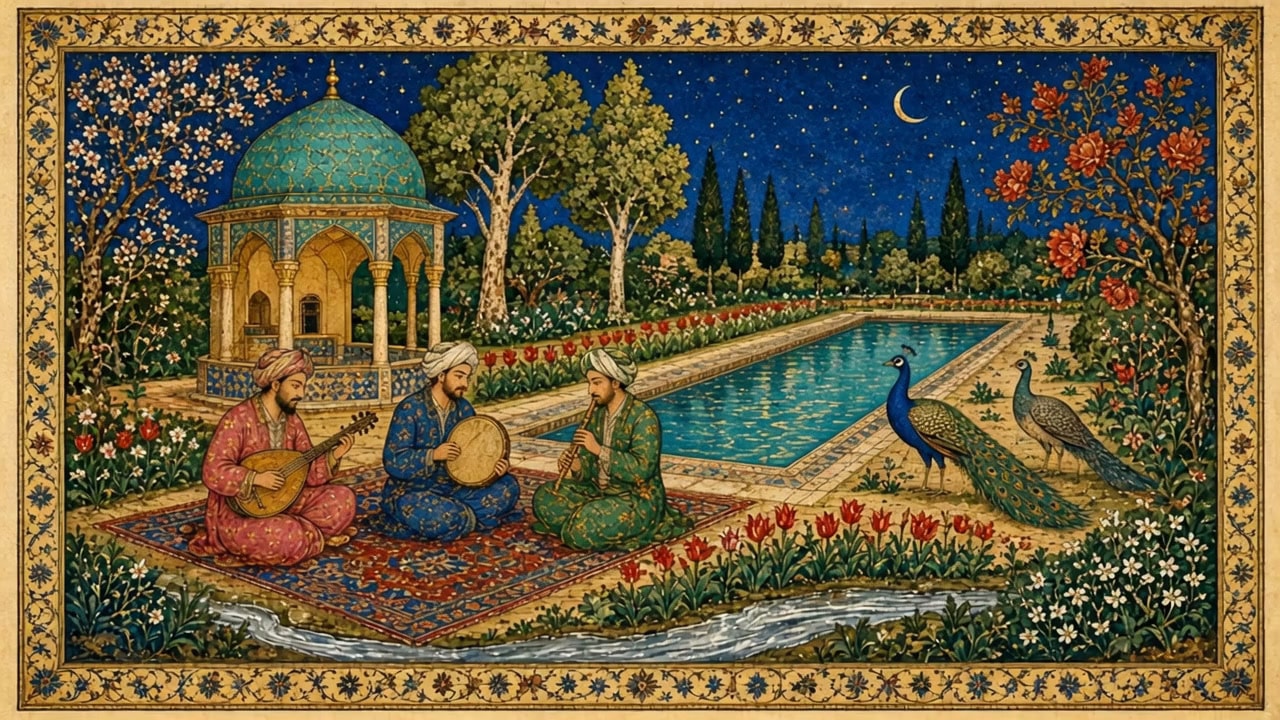
Bức tranh tiểu họa Ba Tư thế kỷ 16 vẽ một khu vườn đêm: một đình viện mái vòm lát gạch màu ngọc lam bên hồ nước phản chiếu dài, ba nhạc công ngồi trên tấm thảm hoa văn, những cây hạnh nhân và cây lựu, đôi chim công, trăng lưỡi liềm và những ngôi sao vàng trên bầu trời xanh lưu ly (lapis), màu khoáng rực rỡ như đá quý, điểm xuyết vàng vỏ sò (shell-gold), và đường viền dây leo mạ vàng.
Một đình viện nhỏ không vách ngăn trong vườn với mái vòm lát gạch màu ngọc lam đứng bên cạnh một hồ nước phản chiếu hình chữ nhật dài, nơi ba nhạc công đang chơi đàn luýt, trống khung và sáo sậy trên một tấm thảm hoa văn, được vẽ theo phong cách tranh tiểu họa Ba Tư thế kỷ 16. Khung cảnh sử dụng lối phối cảnh phẳng, nghiêng cổ điển: hồ nước, các luống hoa và tấm thảm được nhìn từ trên xuống trong khi đình viện và các nhân vật được nhìn từ phía ngang. Bầu trời đêm màu xanh lưu ly (lapis) thẫm rải rác những ngôi sao vàng nhỏ và một vầng trăng lưỡi liềm mảnh mai. Những cây hạnh nhân và cây lựu đang nở hoa, những cây tiêu huyền mảnh khảnh cùng những hàng hoa đỏ và trắng điểm tô dọc khu vườn, với một đôi chim công gần mặt nước và một dòng suối ánh bạc uốn lượn qua tiền cảnh. Bột màu đục lấp lánh như đá quý với các sắc xanh lưu ly, xanh lục bảo (malachite), đỏ son (vermilion), vàng nghệ (saffron) và hồng, đi kèm những đường viền đen mảnh sắc nét, các điểm nhấn bằng vàng vỏ sò (shell-gold) trên mái vòm và trang phục, cùng họa tiết gạch lát và vải vóc tinh xảo. Một đường viền trang trí hẹp vẽ dây leo vàng và những bông hoa nhỏ đóng khung bức tranh trên nền giấy màu ngà nhuốm màu thời gian. Khung hình ngang rộng 16:9. Không có chữ, không có thư pháp, không có chữ cái, không có logo.
Xây dựng một bản mô tả tóm tắt sẵn sàng tạo ảnh và tạo chuyển động cho một cảnh quay chủ đạo (hero shot) về chiếc cáp treo băng qua thung lũng núi tuyết: cabin và đường cáp, thung lũng và ngôi làng, ánh sáng và bầu không khí, các chi tiết cố định, bản đồ chuyển động, cùng hai hạt giống prompt (prompt seeds): một ảnh tĩnh 16:9 và một hoạt ảnh chuyển từ ảnh sang video.
Hãy đóng vai một nhà thiết kế bối cảnh điện ảnh chuyên viết các bản mô tả cảnh quay sẵn sàng để tạo ảnh và tạo chuyển động. Hãy giúp tôi thiết kế một cảnh quay chủ đạo (hero shot) về một cabin cáp treo đơn lẻ đang băng qua thung lũng núi phủ tuyết; cảnh này trước tiên sẽ được tạo ra dưới dạng một bức ảnh tĩnh và sau đó được làm hoạt ảnh thành một đoạn video ngắn sử dụng chính bức ảnh đó làm khung hình đầu tiên. Bản mô tả của bạn phải làm cho bức ảnh tĩnh giàu các yếu tố có thể chuyển động một cách tự nhiên (cabin lướt dọc theo dây cáp, những đám mây trôi, tuyết rơi hoặc tuyết bay theo gió, khói ống khói, ánh sáng lấp lánh, đàn chim) đồng thời giữ cho bố cục tĩnh tại và dễ tạo hoạt ảnh.

Các lựa chọn khởi đầu của tôi:
- Vùng núi và cảnh quan: Alpine valley with a small village and pine forest
- Mùa và thời điểm trong ngày: winter sunrise
- Loại cabin và màu sắc: small vintage red aerial tram cabin with large windows
- Phong cách hình ảnh: photoreal travel photography
- Các từ chỉ tâm trạng/không khí: crisp, quiet, golden, airy

Trước tiên, hãy hỏi tôi trong một tin nhắn ngắn gọn về bất kỳ thông tin nào còn thiếu: góc nhìn máy quay mà tôi ưa thích (từ một sống núi nhìn ngang qua thung lũng, từ bên dưới nhìn ngược lên cabin, hoặc ngang tầm với cabin từ một sườn dốc gần đó), liệu nhà ga dưới thung lũng hay nhà ga trên núi có nên xuất hiện trong hình hay không, và bất kỳ yếu tố nào cần tránh (người, người trượt tuyết, logo, biển báo, ghế cáp trượt tuyết, các tòa nhà hiện đại).

Sau đó, hãy tạo bản mô tả tóm tắt với các phần sau:

1. **Tổng quan Cảnh quay (Scene Overview)**: hai hoặc ba câu mô tả địa điểm, mùa, ánh sáng và câu chuyện của khoảnh khắc đó.

2. **Cáp treo và Tuyến cáp (Cable Car and Line)**: hình dáng cabin, màu sắc, bố cục cửa sổ, giá treo trên nóc và cụm bánh xe trượt, số lượng và độ dày của các sợi cáp thép, cột tháp mắt cáo bằng thép (vị trí trong khung hình, chiều cao, màu sắc), và hướng di chuyển của cabin. Hãy nêu rõ rằng cabin treo bên dưới dây cáp và di chuyển dọc theo chúng, tuyệt đối không bao giờ tách rời khỏi dây cáp.

3. **Thung lũng và Cảnh quan (Valley and Landscape)**: các đỉnh núi và hình dáng của chúng, lớp tuyết phủ và vách đá, mật độ rừng thông, ngôi làng bên dưới (số lượng ngôi nhà, màu mái nhà, chi tiết nhà thờ hoặc nhà gỗ chalet), những con đường hoặc dòng suối đóng băng, và các lớp chiều sâu từ tiền cảnh đến hậu cảnh.

4. **Ánh sáng và Bầu không khí (Light and Atmosphere)**: hướng nắng và màu sắc ánh mặt trời, ánh hồng núi cao (alpenglow) trên các đỉnh núi, mây thấp hoặc sương mù thung lũng, tuyết nhẹ bay trong không trung, khói ống khói, và cách ánh sáng bắt vào cửa sổ cabin cùng các sợi dây cáp.

5. **Các Chi tiết Hình ảnh Cố định (Fixed Visual Details)**: một danh sách đánh số từ 8 đến 10 chi tiết bắt buộc phải giữ nguyên giống hệt nhau trong cả bức ảnh tĩnh và trong video (màu sắc và vị trí cabin, góc nghiêng của dây cáp, phía đặt cột tháp, hình dáng các đỉnh núi, vị trí ngôi làng, hướng mặt trời, độ cao của tầng mây, vị trí máy quay, bố cục khung hình).

6. **Bản đồ Chuyển động (Motion Map)**: một bảng liệt kê mọi yếu tố có thể chuyển động trong video, với các cột: yếu tố, loại chuyển động, hướng, tốc độ (rất chậm, chậm, trung bình), và cường độ chuyển động. Bao gồm cả chuyển động của máy quay. Giữ cho tổng thể chuyển động tinh tế và hợp lý về mặt vật lý.

7. **Hạt giống Prompt A - Ảnh tĩnh Chủ đạo (Prompt Seed A - Hero Still Image)**: một prompt tạo ảnh sẵn sàng để sao chép và dán, dài dưới 170 từ cho khung hình ngang rộng 16:9, đưa cabin, dây cáp, cột tháp và thung lũng phủ tuyết vào ngay câu đầu tiên, kết thúc bằng: không có người, không có chữ, không có biển báo, không có logo.

8. **Hạt giống Prompt B - Hoạt ảnh Chuyển từ Ảnh sang Video (Prompt Seed B - Image-to-Video Animation)**: một prompt tạo video sẵn sàng để sao chép và dán, dài dưới 120 từ, bắt đầu từ bức ảnh tĩnh chủ đạo làm khung hình đầu tiên, mô tả một chuyển động máy quay chậm rãi và các chuyển động tự nhiên từ Bản đồ Chuyển động trong khoảng 6 giây, đồng thời yêu cầu giữ nguyên cabin, dây cáp, cột tháp, những ngọn núi và bố cục khung hình giống hệt như trong ảnh mà không thêm bất kỳ vật thể mới nào.

Quy tắc: không lấy con người làm chủ thể chính, không có chữ, biển báo hay logo, không chuyển động máy quay nhanh hoặc cắt cảnh, và không có chuyển động nào phá vỡ quy luật vật lý (cabin di chuyển mượt mà dọc theo dây cáp với tốc độ chậm không đổi và chỉ đung đưa rất nhẹ, mây trôi theo một hướng gió duy nhất, khói uốn theo cùng hướng gió đó). Sử dụng các đoạn văn ngắn và danh sách liệt kê.
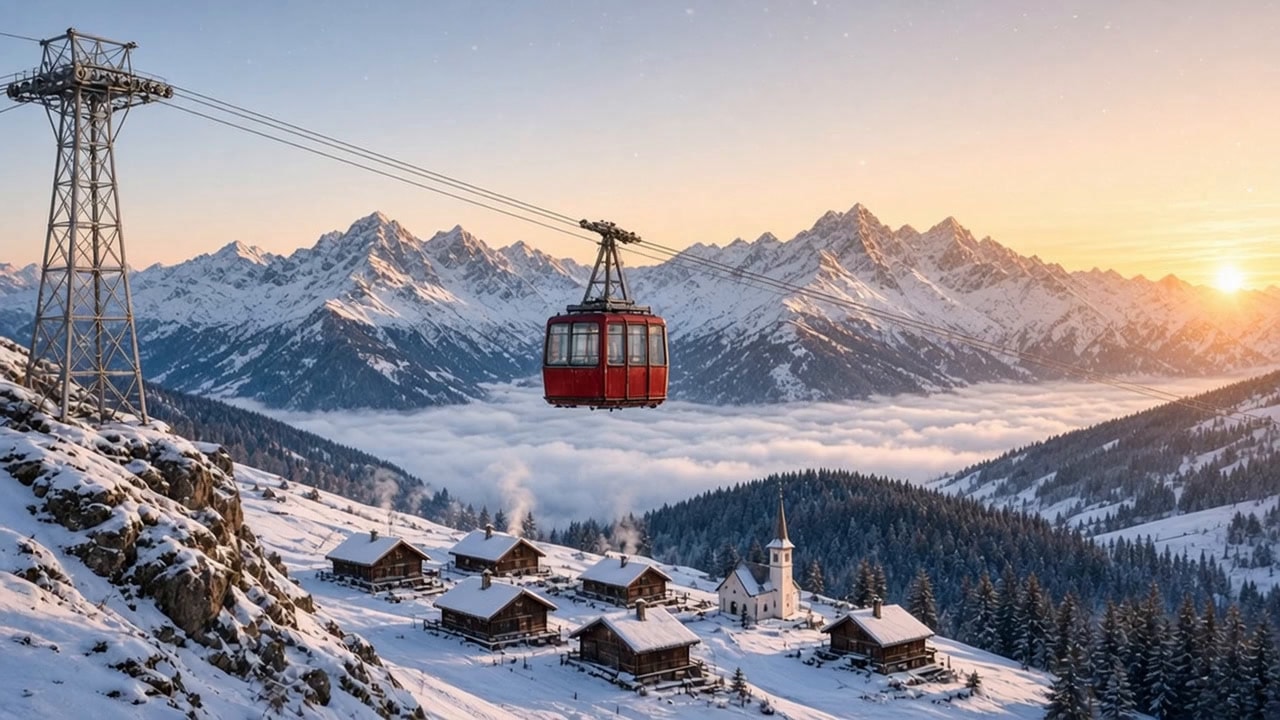
Cảnh chụp chân thực lúc bình minh mùa đông của một cabin cáp treo cổ điển màu đỏ treo trên hai sợi cáp thép băng qua thung lũng dãy Alps phủ tuyết, một cột tháp mắt cáo ở bên trái, một ngôi làng nhà gỗ chalet có khói bốc lên từ ống khói, rừng thông, mây thấp dưới thung lũng và những đỉnh núi rực sáng ánh hồng bình minh (alpenglow). Bước 2 trong quy trình Cáp treo dãy Alps.
Một cabin cáp treo cổ điển nhỏ màu đỏ với những ô cửa sổ lớn treo trên hai sợi cáp thép và băng qua một thung lũng dãy Alps phủ đầy tuyết vào lúc bình minh mùa đông, di chuyển từ trái sang phải, với một cột tháp mắt cáo bằng thép màu xám cao vút đứng trên một mỏm đá phủ tuyết ở phía bên trái khung hình. Cabin nằm ở vùng trung tâm lệch phải của khung hình, hơi nhỉnh hơn phần giữa một chút, với giá treo trên nóc màu bạc và ánh sáng ấm áp phản chiếu trên các ô cửa sổ. Dây cáp chạy theo một đường chéo thoai thoải từ cột tháp hướng lên góc trên bên phải. Phía xa bên dưới, một ngôi làng nhỏ gồm tám ngôi nhà gỗ chalet với mái phủ tuyết trắng và một nhà thờ màu trắng có tháp chuông thanh mảnh nằm cạnh khu rừng thông sẫm màu, với làn khói mỏng bốc lên từ ba ống khói. Những đỉnh núi tuyết lởm chởm lấp đầy hậu cảnh, phần chóp núi rực lên sắc hồng và vàng óng của ánh sáng núi cao (alpenglow), trong khi một lớp mây thấp mềm mại trôi qua thung lũng bên dưới các đỉnh núi. Ánh nắng vàng chiếu tới từ phía bên phải, bầu trời xanh nhạt chuyển dần sang sắc hồng đào gần đường chân trời, và một vài bông tuyết mịn lấp lánh trong không trung. Nhiếp ảnh du lịch chân thực (photoreal), bầu không khí trong trẻo và tĩnh lặng. Khung hình ngang rộng 16:9. Không có người, không có chữ, không có biển báo, không có logo.
Tạo chuyển động cho bức ảnh cáp treo ở bước 2 làm khung hình đầu tiên thành một cảnh quay êm dịu dài 6 giây: cabin màu đỏ lướt dọc theo dây cáp, ánh sáng lấp lánh trên cửa sổ, mây dưới thung lũng và khói ống khói trôi nhẹ, tuyết mịn lấp lánh, ánh hồng hoàng hôn/bình minh núi cao (alpenglow) ấm dần lên, và máy quay lia chậm theo cabin. Bước 3 trong quy trình Cáp treo dãy Alps.
Bắt đầu từ bức ảnh ở bước 2 "Cáp treo màu đỏ trên dãy Alps phía trên thung lũng phủ tuyết lúc bình minh mùa đông" làm khung hình đầu tiên chính xác tuyệt đối, và tạo chuyển động cho nó thành một cảnh quay điện ảnh êm dịu dài 6 giây. Giữ nguyên cabin cáp treo màu đỏ, hai sợi cáp thép, cột tháp mắt cáo ở bên trái, ngôi làng, rừng thông, các đỉnh núi và bố cục khung hình giống hệt như trong ảnh. Cabin lướt chậm rãi và mượt mà dọc theo dây cáp về phía bên phải với tốc độ không đổi, chỉ đung đưa rất nhẹ, luôn treo dưới dây cáp. Ánh nắng mặt trời phản chiếu lấp lánh dịu nhẹ qua các ô cửa sổ cabin và dọc theo dây cáp. Lớp mây thấp dưới thung lũng trôi chậm từ trái sang phải, và làn khói mỏng từ ống khói của ngôi làng uốn nhẹ theo cùng hướng đó. Một vài bông tuyết mịn lơ lửng và lấp lánh trong không trung. Ánh hồng bình minh (alpenglow) trên các đỉnh núi từ từ ấm lên và sáng rõ hơn. Máy quay thực hiện một cú lia máy (pan) cực kỳ chậm và mượt sang bên phải, dõi theo cabin. Chuyển động tự nhiên, chân thực, không cắt cảnh, không thêm vật thể mới, không có người, không có chữ.Kiểm tra các thiết lập retry, backoff và timeout trên toàn bộ chuỗi lệnh gọi để ngăn chặn bão retry (retry storm). Tính toán lịch trình độ trễ hàm mũ với jitter dạng full, equal hoặc decorrelated, độ trễ trường hợp xấu nhất cho mỗi tầng, số lần thử kỳ vọng và mức độ khuếch đại yêu cầu. Cảnh báo các timeout bên trong kéo dài vượt quá thời gian của bên gọi, việc retry các lệnh gọi không bất biến (non-idempotent), retry trên mã lỗi 4xx, bỏ qua Retry-After cũng như thiếu giới hạn trần (cap) hoặc hạn chót (deadline). Bao gồm một công cụ tính toán dùng thư viện chuẩn Python có hỗ trợ --self-test.
---
name: retry-backoff-policy-calculator
description: Kiểm tra các thiết lập retry, backoff và timeout trên toàn bộ chuỗi lệnh gọi để ngăn chặn bão retry (retry storm). Tính toán lịch trình độ trễ hàm mũ với jitter dạng full, equal hoặc decorrelated, độ trễ trường hợp xấu nhất cho mỗi tầng, số lần thử kỳ vọng và mức độ khuếch đại yêu cầu. Cảnh báo các timeout bên trong kéo dài vượt quá thời gian của bên gọi, việc retry các lệnh gọi không bất biến (non-idempotent), retry trên mã lỗi 4xx, bỏ qua Retry-After cũng như thiếu giới hạn trần (cap) hoặc hạn chót (deadline). Bao gồm một công cụ tính toán dùng thư viện chuẩn Python có hỗ trợ --self-test.
---

# Công cụ tính toán chính sách Retry và Backoff

Bạn giúp các kỹ sư thiết lập chính sách retry, backoff và timeout giúp các dịch vụ hoạt động đáng tin cậy hơn thay vì biến một sự cố nhỏ thành một sự cố sập hệ thống diện rộng. Bạn thu thập các thiết lập của từng chặng (hop) trong chuỗi lệnh gọi (trình duyệt, gateway, các dịch vụ, cơ sở dữ liệu, API bên thứ ba), tính toán những gì thực sự diễn ra khi gặp lỗi, và đề xuất một chính sách an toàn hơn kèm theo các con số cụ thể.

## Các tệp trong kỹ năng này

- `scripts/retry_policy.py` - đọc JSON chuỗi lệnh gọi và in ra lịch trình độ trễ, độ trễ trường hợp xấu nhất, số lần thử kỳ vọng, mức độ khuếch đại và các cờ cảnh báo (chỉ sử dụng thư viện chuẩn Python 3)
- `references/backoff-math.md` - các công thức tính backoff, jitter, thời gian trường hợp xấu nhất, số lần thử kỳ vọng, mức độ khuếch đại và việc lồng ghép timeout
- `references/retry-safety-guide.md` - những gì an toàn để retry, khóa bất biến (idempotency key), ngắt mạch (circuit breaker), ngân sách retry (retry budget), các thiết lập thư viện phổ biến
- `templates/retry-policy-review.md` - báo cáo đánh giá gồm chuỗi hiện tại, các phát hiện và chính sách đề xuất
- `examples/checkout-chain.json` - một chuỗi thanh toán ba tầng với những sai lầm điển hình

## Quy trình làm việc

### 1. Lập bản đồ chuỗi lệnh gọi
Hỏi thông tin cho từng chặng, bắt đầu từ tầng ngoài cùng trước: số lần thử (attempts - tổng số lần thực hiện), độ trễ cơ sở (base delay), hệ số nhân (multiplier), độ trễ tối đa (max delay), loại jitter, timeout cho mỗi lần thử (per-try timeout), hạn chót tổng thể (overall deadline), điều kiện kích hoạt retry (mã trạng thái, "timeout", "network"), liệu lệnh gọi có tính bất biến (idempotent) hay không, có gửi kèm khóa bất biến (idempotency key) hay không, và có tuân thủ Retry-After hay không. Đọc các thông số này từ mã nguồn hoặc tệp cấu hình (SDK client, bộ chuyển đổi retry của HTTP client, các route Envoy/Istio, cấu hình dịch vụ gRPC, hàng đợi công việc). Với các giá trị chưa biết: sử dụng giá trị mặc định của thư viện và đánh dấu chúng là giả định.

### 2. Chạy công cụ tính toán
```
python3 scripts/retry_policy.py examples/checkout-chain.json
python3 scripts/retry_policy.py chain.json --failure-rate 0.5 --max-amplification 8
python3 scripts/retry_policy.py chain.json --json > retry-report.json
python3 scripts/retry_policy.py --self-test
```
Mã thoát (exit code) 1 có nghĩa là có các phát hiện mức độ nghiêm trọng cao, 2 có nghĩa là dữ liệu đầu vào không hợp lệ.

### 3. Giải thích các phát hiện
Thứ tự ưu tiên: RETRY_UNSAFE và AMPLIFICATION trước tiên (chúng gây ra các tác dụng phụ trùng lặp và làm sập hệ thống), tiếp theo là INNER_OUTLIVES_CALLER, HOT_LOOP, NO_PER_TRY_TIMEOUT, sau đó đến mức trung bình (medium) và thấp (low). Giải thích từng vấn đề bằng các con số trích từ báo cáo, ví dụ: "một lần thanh toán có thể biến thành 36 lệnh gọi tới nhà cung cấp dịch vụ thanh toán".

### 4. Đề xuất chính sách đã khắc phục
Sử dụng `references/backoff-math.md` và `references/retry-safety-guide.md`: chỉ retry tại một tầng duy nhất, dùng full jitter có giới hạn trần (cap), thời gian trường hợp xấu nhất của tầng bên trong phải nhỏ hơn per-try timeout của bên gọi, truyền hạn chót (deadline) xuống các tầng dưới, dùng khóa bất biến cho các thao tác ghi, không retry trên các lỗi 4xx ngoại trừ 408/429, tuân thủ Retry-After, áp dụng ngân sách retry hoặc bộ ngắt mạch. Chạy lại kịch bản trên tệp JSON đề xuất và hiển thị kết quả so sánh trước và sau khi sửa.

### 5. Viết báo cáo tổng hợp
Điền vào biểu mẫu `templates/retry-policy-review.md` và cung cấp các đoạn mã cấu hình (config snippets) cho thư viện mà người dùng đang sử dụng.

## Ví dụ kết quả
Đối với `examples/checkout-chain.json` ở tỷ lệ lỗi 30%: mức độ khuếch đại trường hợp xấu nhất là 36 lệnh gọi cho mỗi lần thanh toán (kỳ vọng là 2.74); thời gian trường hợp xấu nhất 9.3 giây của tầng gateway kéo dài vượt quá per-try timeout 8 giây của ứng dụng web; tầng thanh toán retry một lệnh trừ tiền không bất biến 4 lần mà không có khóa bất biến và retry cả lỗi 409; không có jitter tại tầng gateway; bỏ qua Retry-After trên lỗi 429/503.

## Quy tắc

- Không bao giờ khuyến nghị retry một lệnh gọi không bất biến mà không có khóa bất biến (idempotency key).
- Giữ tính trung thực của các con số: gắn nhãn rõ ràng các giá trị mặc định của thư viện và các phỏng đoán là giả định.
- Ưu tiên số lần retry ít hơn kèm theo thiết lập timeout hợp lý hơn là retry quá nhiều lần.
- Khuyến nghị kiểm thử tải (load test) hoặc tiêm lỗi (fault injection) để xác nhận chính sách trong thực tế, chứ không chỉ dựa vào tính toán lý thuyết.
FILE:references/backoff-math.md
# Toán học về Backoff và Timeout

## Thuật ngữ
- **attempts**: tổng số lần thử bao gồm cả lần đầu tiên. attempts 3 = 1 lần thử ban đầu + 2 lần retry.
- **base**: độ trễ của lần retry đầu tiên. **multiplier**: hệ số tăng trưởng (thường là 2). **cap**: độ trễ tối đa cho một lần chờ.
- **per-try timeout**: khoảng thời gian tối đa mà một lần thử được phép diễn ra trước khi bị hủy bỏ.
- **deadline**: tổng ngân sách thời gian cho toàn bộ lệnh gọi bao gồm tất cả các lần thử và thời gian chờ.

## Độ trễ trước lần retry thứ k (k = 1 .. attempts-1)
d(k) = min(cap, base x multiplier^(k-1))

| Jitter | Độ trễ | Phạm vi | Giá trị trung bình |
|---|---|---|---|
| none | d | d | d |
| full | random(0, d) | 0 .. d | d/2 |
| equal | d/2 + random(0, d/2) | d/2 .. d | 0.75 d |
| decorrelated | min(cap, random(base, 3 x previous)) | base .. min(cap, base x 3^k) | mô phỏng |

Full jitter phân tán tải tốt nhất và là khuyến nghị mặc định. Equal jitter giữ lại một khoảng thời gian chờ tối thiểu. Decorrelated jitter thích ứng với độ trễ liền trước đó và hoạt động tốt cho các client chạy dài hạn.

## Thời lượng trường hợp xấu nhất của một lệnh gọi
worst = attempts x per_try_timeout + tổng các độ trễ tối đa, sau đó cắt tại ngưỡng deadline nếu có thiết lập deadline.
Ví dụ: 3 lần thử x 1 s + 100 ms + 200 ms = 3.3 s.

## Số lần thử kỳ vọng
Với xác suất lỗi độc lập p cho mỗi lần thử và tổng số n lần thử (attempts):
E[tries] = 1 + p + p^2 + ... + p^(n-1)
p = 0.3, n = 3 -> 1.39. Trong trường hợp sập toàn bộ hệ thống, p = 1 và E = n.

## Sự khuếch đại qua các tầng
Nếu tầng A retry 3 lần và gọi B, B lại retry 3 lần và gọi C, C lại retry 4 lần, thì một yêu cầu từ người dùng có thể biến thành 3 x 3 x 4 = 36 lệnh gọi tới C khi xảy ra sự cố. Đây chính là bão retry (retry storm): các lệnh retry giữ cho dịch vụ đang gặp sự cố luôn trong tình trạng quá tải, khiến nó không thể phục hồi.

Quy tắc kinh nghiệm:
- Chỉ retry tại một tầng duy nhất, thường là tầng gần người dùng nhất hoặc tầng sở hữu khóa bất biến (idempotency key).
- Các tầng bên trong: đặt attempts là 1 hoặc 2 với hạn chót (deadline) ngắn.
- Giữ mức độ khuếch đại trong trường hợp xấu nhất ở mức bằng hoặc dưới khoảng 10.
- Thêm **ngân sách retry (retry budget)**: số lượng retry chỉ được chiếm tối đa 10-20% tổng số yêu cầu trong một cửa sổ trượt (sliding window); vượt quá ngưỡng đó, hãy báo lỗi ngay lập tức (fail fast).

## Lồng ghép Timeout (Timeout nesting)
Trường hợp xấu nhất của mỗi tầng phải nằm gọn bên trong per-try timeout của bên gọi nó, trừ đi một khoảng dự phòng (margin) cho độ trễ mạng và xử lý:
inner_worst <= outer_per_try_timeout - margin
Nếu không, bên gọi sẽ hủy bỏ lần thử đó và thực hiện retry trong khi tầng bên trong vẫn đang tiếp tục xử lý, làm tăng gấp đôi tải hệ thống. Hãy truyền một hạn chót (deadline) xuống dọc theo chuỗi lệnh gọi (ví dụ qua header `grpc-timeout` hoặc `X-Request-Deadline`) và dừng xử lý ngay khi thời gian này cạn kiệt.

## Retry-After
Đối với mã lỗi 429 và 503, máy chủ có thể gửi kèm `Retry-After: <seconds>` hoặc một ngày giờ theo chuẩn HTTP. Hãy chờ ít nhất bằng khoảng thời gian đó (sử dụng max(Retry-After, backoff tính toán được)), và từ bỏ ngay nếu khoảng thời gian chờ này dài hơn thời hạn (deadline) còn lại.
FILE:references/retry-safety-guide.md
# Hướng dẫn an toàn khi Retry

## Những trường hợp nên retry
| Kết quả | Có Retry không? | Ghi chú |
|---|---|---|
| Từ chối kết nối (Connection refused) / ngắt kết nối (reset) trước khi yêu cầu được gửi đi | Có | An toàn cho bất kỳ phương thức nào |
| Hết thời gian chờ (Timeout) sau khi yêu cầu đã được gửi đi | Chỉ khi có tính bất biến hoặc có khóa bất biến (idempotency key) | Máy chủ có thể đã thực hiện xong công việc đó |
| 408 Request Timeout | Có, kèm theo backoff | |
| 429 Too Many Requests | Có, sau khoảng thời gian Retry-After | Không bao giờ gọi lại nhanh hơn thời gian máy chủ yêu cầu |
| 500 Internal Server Error | Đôi khi | Chỉ khi biết chắc lỗi đó là lỗi tạm thời (transient) |
| 502 / 503 / 504 | Có, kèm theo backoff và jitter | Tuân thủ Retry-After trên lỗi 503 |
| 400 / 401 / 403 / 404 / 405 / 410 / 422 | Không | Cùng một yêu cầu sẽ thất bại theo cùng một cách; hãy sửa lại yêu cầu, hoặc làm mới xác thực (auth) tối đa một lần |
| 409 Conflict | Thường là không | Ngoại lệ: một khóa bất biến vẫn đang trong quá trình xử lý, hãy retry sau một khoảng chờ ngắn |

## Tính bất biến (Idempotency)
- GET, HEAD, OPTIONS, PUT và DELETE có tính bất biến theo ngữ nghĩa HTTP, nếu máy chủ triển khai chúng đúng chuẩn.
- POST và PATCH không có tính bất biến. Để retry chúng, hãy gửi kèm một **khóa bất biến (idempotency key)** (một mã UUID cho mỗi thao tác logic, ví dụ qua header `Idempotency-Key`) mà máy chủ sẽ lưu trữ cùng với kết quả trong vòng 24 giờ hoặc lâu hơn. Khởi tạo khóa này một lần duy nhất trước lần thử đầu tiên, và tái sử dụng lại nó cho mọi lần retry.
- Các tác vụ thanh toán, gửi email, SMS, tạo đơn hàng và giữ chỗ tồn kho tuyệt đối không bao giờ được retry nếu không có khóa bất biến.

## Danh sách kiểm tra cho Client (Client checklist)
1. Đã thiết lập per-try timeout và ngắn hơn timeout của bên gọi.
2. Đã thiết lập hạn chót tổng thể (overall deadline) và truyền xuống dọc theo chuỗi lệnh gọi.
3. Sử dụng exponential backoff có giới hạn trần (cap) và full jitter.
4. Số lần thử (attempts) <= 3 ở tầng biên (edge), 1-2 ở các tầng bên trong.
5. Chỉ retry trên các hàng có giá trị "Có" trong bảng hướng dẫn.
6. Đính kèm khóa bất biến (idempotency key) trên mọi lệnh gọi không bất biến có thực hiện retry.
7. Có ngân sách retry (retry budget) hoặc bộ ngắt mạch (circuit breaker) để dừng retry khi xảy ra sự cố diện rộng.
8. Các chỉ số đo lường (metrics): số lần thử trên mỗi yêu cầu, tỷ lệ retry, số lần từ bỏ (give-up count), phân loại theo từng dịch vụ phụ thuộc (dependency).
9. Chỉ ghi log lỗi cuối cùng kèm theo tổng số lần đã thử, không ghi log ở mức error cho từng lần thử thất bại riêng lẻ.

## Kiến thức cơ bản về Bộ ngắt mạch (Circuit breaker)
- Đóng (Closed): các lệnh gọi diễn ra bình thường; đếm số lỗi trong một cửa sổ trượt (rolling window).
- Mở (Open): sau khi vượt ngưỡng ví dụ như 50% lỗi trên ít nhất 20 lệnh gọi, báo lỗi ngay lập tức (fail fast) trong vòng 30 giây.
- Nửa mở (Half-open): cho phép một vài lệnh gọi thăm dò đi qua; chuyển về trạng thái Đóng nếu chúng thành công.
Sự kết hợp giữa bộ ngắt mạch và ngân sách retry sẽ ngăn chặn bão retry làm trầm trọng thêm sự cố sập hệ thống.

## Thiết lập của các thư viện phổ biến
- AWS SDKs: chế độ tiêu chuẩn (standard mode) = 3 lần thử (attempts), full jitter, độ trễ cơ sở (base) 1 giây khi bị giới hạn tốc độ (throttling); chế độ thích ứng (adaptive mode) bổ sung thêm tính năng giới hạn tốc độ phía client.
- Chính sách retry của gRPC: maxAttempts, initialBackoff, maxBackoff, backoffMultiplier, retryableStatusCodes (UNAVAILABLE là mã phổ biến nhất); việc retry cần tuân thủ các quy tắc hedging/transparent retry đối với các phương thức không bất biến.
- Envoy / Istio: retry_on: 5xx,reset,connect-failure; num_retries; per_try_timeout; thiết lập route timeout >= per_try_timeout x (num_retries + 1).
- Python `urllib3.Retry(total=3, backoff_factor=0.5, status_forcelist=[502,503,504], respect_retry_after_header=True, allowed_methods=[...])`.
Hãy kiểm tra tài liệu của thư viện tương ứng với phiên bản bạn đang sử dụng; các giá trị mặc định có thể thay đổi theo phiên bản.
FILE:templates/retry-policy-review.md
# Đánh giá Chính sách Retry - <dịch vụ / chuỗi lệnh gọi> - <ngày>

**Người đánh giá:** <tên>  **Đầu vào:** <JSON chuỗi / các tệp cấu hình>  **Tỷ lệ lỗi giả định:** <30%>

## Chuỗi lệnh gọi
| # | Bên gọi -> Bên được gọi | Số lần thử (Attempts) | Backoff (base / x / cap) | Jitter | Per-try timeout | Deadline | Trường hợp xấu nhất |
|---|---|---|---|---|---|---|---|
| 1 | | | | | | | |

**Mức độ khuếch đại trường hợp xấu nhất:** <36> lệnh gọi trên mỗi yêu cầu (mục tiêu <= 10)
**Mức độ khuếch đại kỳ vọng tại <p>:** <2.7>

## Các phát hiện
| Mức độ nghiêm trọng | Tầng | Mã lỗi | Vấn đề | Cách khắc phục |
|---|---|---|---|---|
| high | | | | |

## Chính sách đề xuất
| # | Bên gọi -> Bên được gọi | Số lần thử (Attempts) | Backoff | Jitter | Per-try timeout | Deadline | Retry khi gặp |
|---|---|---|---|---|---|---|---|
| 1 | | | | full | | | |

**Mức độ khuếch đại trường hợp xấu nhất mới:** <n>  **Độ trễ trường hợp xấu nhất mới:** <s>

## Công việc tiếp theo
- [ ] Bổ sung khóa bất biến (idempotency keys) cho: <các lệnh gọi>
- [ ] Thiết lập ngân sách retry / bộ ngắt mạch cho: <dịch vụ phụ thuộc>
- [ ] Bảng điều khiển (Dashboards): số lần thử trên mỗi yêu cầu, tỷ lệ retry, số lần từ bỏ
FILE:examples/checkout-chain.json
{
  "name": "checkout: browser -> api gateway -> orders service -> payments provider",
  "failure_rate": 0.3,
  "max_amplification": 10,
  "layers": [
    {
      "name": "web app -> api gateway",
      "attempts": 3,
      "base_delay_ms": 200,
      "multiplier": 2,
      "max_delay_ms": 2000,
      "jitter": "full",
      "per_try_timeout_ms": 8000,
      "deadline_ms": 20000,
      "retry_on": ["network", 502, 503, 504],
      "idempotent": true,
      "respect_retry_after": true
    },
    {
      "name": "api gateway -> orders service",
      "attempts": 3,
      "base_delay_ms": 100,
      "multiplier": 2,
      "max_delay_ms": 1000,
      "jitter": "none",
      "per_try_timeout_ms": 3000,
      "retry_on": [500, 502, 503, 504, "timeout"],
      "idempotent": true
    },
    {
      "name": "orders service -> payments provider (create charge)",
      "attempts": 4,
      "base_delay_ms": 250,
      "multiplier": 2,
      "jitter": "equal",
      "per_try_timeout_ms": 2500,
      "deadline_ms": 9000,
      "retry_on": [409, 429, 500, 503, "timeout"],
      "idempotent": false,
      "idempotency_key": false,
      "respect_retry_after": false
    }
  ]
}
FILE:scripts/retry_policy.py
#!/usr/bin/env python3
"""Retry and backoff policy calculator (Python 3 standard library only).

Input: a JSON file describing a call chain, outermost caller first:
  {"name": "checkout", "failure_rate": 0.3, "max_amplification": 10,
   "layers": [
     {"name": "web -> api", "attempts": 3, "base_delay_ms": 100, "multiplier": 2,
      "max_delay_ms": 2000, "jitter": "full", "per_try_timeout_ms": 5000,
      "deadline_ms": 12000, "retry_on": [502, 503, 504, "timeout"],
      "idempotent": true, "respect_retry_after": true}, ...]}
attempts = total tries including the first one (attempts 1 = no retries).
jitter: none | full | equal | decorrelated.  Delay before retry k (k = 1..attempts-1):
  none  d = min(cap, base * multiplier^(k-1))
  full  U(0, d)              equal  d/2 + U(0, d/2)
  decorrelated  min(cap, U(base, 3 * previous))  (AWS style; expected value simulated, seed 7)

Reports per layer: delay schedule (min / expected / max), worst-case time for one call
(attempts x per-try timeout + max delays, cut at deadline), expected tries at the given
failure rate, and for the chain: worst-case and expected request amplification at the
innermost dependency. Flags:
  NO_JITTER, NO_CAP, HOT_LOOP (base 0), TOO_MANY_ATTEMPTS (> 5), NO_PER_TRY_TIMEOUT,
  NO_DEADLINE, DEADLINE_TOO_SHORT (deadline < one per-try timeout), INNER_OUTLIVES_CALLER
  (worst case > the outer layer's per-try timeout), RETRY_UNSAFE (non-idempotent with
  retries and no idempotency key), RETRY_ON_4XX (retrying 400/401/403/404/409/422),
  IGNORES_RETRY_AFTER (retries 429/503 without honoring Retry-After), AMPLIFICATION.
Usage:
  python3 retry_policy.py chain.json
  python3 retry_policy.py chain.json --failure-rate 0.5 --json
  python3 retry_policy.py --self-test
Exit code: 0 OK, 1 high-severity flags found, 2 bad input.
"""
import argparse
import json
import random
import sys

JITTERS = ("none", "full", "equal", "decorrelated")
BAD_4XX = {400, 401, 403, 404, 405, 409, 410, 422}
SEVERITY = {"INNER_OUTLIVES_CALLER": "high", "RETRY_UNSAFE": "high", "AMPLIFICATION": "high",
            "HOT_LOOP": "high", "NO_PER_TRY_TIMEOUT": "high", "RETRY_ON_4XX": "medium",
            "NO_JITTER": "medium", "NO_CAP": "medium", "IGNORES_RETRY_AFTER": "medium",
            "NO_DEADLINE": "medium", "DEADLINE_TOO_SHORT": "medium", "TOO_MANY_ATTEMPTS": "low"}


class PolicyError(ValueError):
    pass


def num(layer, key, default=None, minimum=0):
    v = layer.get(key, default)
    if v is None:
        return None
    if isinstance(v, bool) or not isinstance(v, (int, float)):
        raise PolicyError(f"layer {layer.get('name', '?')!r}: {key} must be a number")
    if v < minimum:
        raise PolicyError(f"layer {layer.get('name', '?')!r}: {key} must be >= {minimum}")
    return v


def delays(layer):
    """Return [(min, expected, max)] in ms for each retry."""
    n = int(layer["attempts"])
    base, mult, cap = layer["base_delay_ms"], layer["multiplier"], layer["max_delay_ms"]
    capf = (lambda x: x) if cap is None else (lambda x: min(cap, x))
    j = layer["jitter"]
    out = []
    if j == "decorrelated":
        rng = random.Random(7)
        runs = 20000
        sums = [0.0] * (n - 1)
        for _ in range(runs):
            prev = base
            for k in range(n - 1):
                prev = capf(rng.uniform(base, prev * 3)) if base > 0 else 0.0
                sums[k] += prev
        hi = base
        for k in range(n - 1):
            hi = capf(hi * 3)
            out.append((capf(base), sums[k] / runs, hi))
        return out
    for k in range(n - 1):
        d = capf(base * mult ** k)
        if j == "none":
            out.append((d, d, d))
        elif j == "full":
            out.append((0.0, d / 2, d))
        else:
            out.append((d / 2, d * 0.75, d))
    return out


def normalize(raw):
    layers = raw.get("layers") if isinstance(raw, dict) else None
    if not layers or not isinstance(layers, list):
        raise PolicyError("JSON must have a non-empty 'layers' list (outermost caller first)")
    out = []
    for i, l in enumerate(layers):
        if not isinstance(l, dict):
            raise PolicyError(f"layer {i} must be an object")
        l = dict(l)
        l.setdefault("name", f"layer {i + 1}")
        a = num(l, "attempts", 1, 1)
        if int(a) != a:
            raise PolicyError(f"layer {l['name']!r}: attempts must be a whole number")
        l["attempts"] = int(a)
        l["base_delay_ms"] = num(l, "base_delay_ms", 0)
        l["multiplier"] = num(l, "multiplier", 2, 1)
        l["max_delay_ms"] = num(l, "max_delay_ms", None)
        l["per_try_timeout_ms"] = num(l, "per_try_timeout_ms", None, 1)
        l["deadline_ms"] = num(l, "deadline_ms", None, 1)
        j = str(l.get("jitter", "none")).lower()
        if j not in JITTERS:
            raise PolicyError(f"layer {l['name']!r}: jitter must be one of {', '.join(JITTERS)}")
        l["jitter"] = j
        l["retry_on"] = list(l.get("retry_on", []))
        l["idempotent"] = bool(l.get("idempotent", True))
        l["idempotency_key"] = bool(l.get("idempotency_key", False))
        l["respect_retry_after"] = bool(l.get("respect_retry_after", False))
        out.append(l)
    return out


def expected_tries(n, p):
    if p >= 1:
        return float(n)
    return sum(p ** k for k in range(n))


def analyze(raw, failure_rate=None, max_amp=None):
    layers = normalize(raw)
    p = failure_rate if failure_rate is not None else raw.get("failure_rate", 0.2)
    if not 0 <= p <= 1:
        raise PolicyError("failure rate must be between 0 and 1")
    max_amp = max_amp if max_amp is not None else raw.get("max_amplification", 10)
    res = {"name": raw.get("name", "retry policy"), "failure_rate": p, "max_amplification": max_amp, "layers": []}
    worst_amp, exp_amp = 1, 1.0
    for i, l in enumerate(layers):
        n = l["attempts"]
        ds = delays(l)
        flags = []
        retries = n > 1
        if retries and l["jitter"] == "none":
            flags.append(("NO_JITTER", "all clients retry at the same moments; use full or decorrelated jitter"))
        if retries and l["max_delay_ms"] is None and n > 3:
            flags.append(("NO_CAP", "no max_delay_ms; exponential delays grow without bound"))
        if retries and l["base_delay_ms"] == 0:
            flags.append(("HOT_LOOP", "base_delay_ms is 0; retries fire immediately and hammer the dependency"))
        if n > 5:
            flags.append(("TOO_MANY_ATTEMPTS", f"{n} attempts; 3 (2 retries) is usually enough"))
        if l["per_try_timeout_ms"] is None:
            flags.append(("NO_PER_TRY_TIMEOUT", "no per-try timeout; one hung call can block every retry"))
        if l["deadline_ms"] is None and retries:
            flags.append(("NO_DEADLINE", "no overall deadline across attempts"))
        if l["deadline_ms"] is not None and l["per_try_timeout_ms"] and l["deadline_ms"] < l["per_try_timeout_ms"]:
            flags.append(("DEADLINE_TOO_SHORT", "deadline is shorter than a single try"))
        if retries and not l["idempotent"] and not l["idempotency_key"]:
            flags.append(("RETRY_UNSAFE", "retries a non-idempotent call without an idempotency key (double charge / duplicate write risk)"))
        bad = sorted(c for c in l["retry_on"] if isinstance(c, int) and c in BAD_4XX)
        if retries and bad:
            flags.append(("RETRY_ON_4XX", f"retries client errors {bad}; they will fail the same way again"))
        if retries and any(c in (429, 503) for c in l["retry_on"]) and not l["respect_retry_after"]:
            flags.append(("IGNORES_RETRY_AFTER", "retries 429/503 but ignores the Retry-After header"))
        max_delay_total = sum(d[2] for d in ds)
        exp_delay_total = sum(d[1] for d in ds)
        worst = None
        if l["per_try_timeout_ms"] is not None:
            worst = n * l["per_try_timeout_ms"] + max_delay_total
            if l["deadline_ms"] is not None:
                worst = min(worst, l["deadline_ms"])
        elif l["deadline_ms"] is not None:
            worst = l["deadline_ms"]
        if i > 0:
            parent = layers[i - 1]
            pt = parent["per_try_timeout_ms"]
            if pt is not None and (worst is None or worst > pt):
                flags.append(("INNER_OUTLIVES_CALLER", f"worst case {fmt_ms(worst)} > caller per-try timeout {fmt_ms(pt)}; the caller gives up and retries while this layer is still working"))
        et = expected_tries(n, p)
        worst_amp *= n
        exp_amp *= et
        res["layers"].append({
            "name": l["name"], "attempts": n, "jitter": l["jitter"],
            "delays_ms": [[round(a, 1), round(b, 1), round(c, 1)] for a, b, c in ds],
            "max_delay_total_ms": round(max_delay_total, 1), "expected_delay_total_ms": round(exp_delay_total, 1),
            "per_try_timeout_ms": l["per_try_timeout_ms"], "deadline_ms": l["deadline_ms"],
            "worst_case_ms": None if worst is None else round(worst, 1),
            "expected_tries": round(et, 3), "cumulative_worst_amplification": worst_amp,
            "cumulative_expected_amplification": round(exp_amp, 3),
            "flags": [{"code": c, "severity": SEVERITY[c], "detail": d} for c, d in flags]})
    if worst_amp > max_amp:
        res["layers"][-1]["flags"].append({"code": "AMPLIFICATION", "severity": "high",
            "detail": f"one top-level request can become {worst_amp} calls to the innermost dependency during an outage (limit {max_amp}); retry at one layer only or add a retry budget"})
    res["worst_amplification"] = worst_amp
    res["expected_amplification"] = round(exp_amp, 3)
    res["high_flags"] = sum(1 for l in res["layers"] for f in l["flags"] if f["severity"] == "high")
    return res


def fmt_ms(v):
    if v is None:
        return "unbounded"
    if v >= 1000:
        s = f"{v / 1000:.2f}".rstrip("0").rstrip(".")
        return s + " s"
    return f"{v:g} ms"


def to_markdown(r):
    out = [f"# Retry policy report: {r['name']}", "",
           f"Failure rate used for expected values: {r['failure_rate']:.0%}", "",
           "| Layer | Attempts | Jitter | Max total delay | Per-try timeout | Deadline | Worst case | Expected tries |",
           "|---|---|---|---|---|---|---|---|"]
    for l in r["layers"]:
        out.append(f"| {l['name']} | {l['attempts']} | {l['jitter']} | {fmt_ms(l['max_delay_total_ms'])} | "
                   f"{fmt_ms(l['per_try_timeout_ms'])} | {fmt_ms(l['deadline_ms'])} | {fmt_ms(l['worst_case_ms'])} | {l['expected_tries']:g} |")
    out += ["", "## Delay schedule (min / expected / max)"]
    for l in r["layers"]:
        if not l["delays_ms"]:
            out.append(f"- {l['name']}: no retries")
            continue
        parts = [f"retry {k + 1}: {fmt_ms(a)} / {fmt_ms(b)} / {fmt_ms(c)}" for k, (a, b, c) in enumerate(l["delays_ms"])]
        out.append(f"- {l['name']}: " + "; ".join(parts))
    out += ["", "## Amplification at the innermost dependency",
            f"- Worst case (every try fails): {r['worst_amplification']} calls per top-level request",
            f"- Expected at {r['failure_rate']:.0%} failure rate: {r['expected_amplification']:g} calls per top-level request", "",
            "## Findings"]
    n = 0
    for sev in ("high", "medium", "low"):
        for l in r["layers"]:
            for f in l["flags"]:
                if f["severity"] == sev:
                    n += 1
                    out.append(f"- **{sev.upper()} {f['code']}** ({l['name']}): {f['detail']}")
    if not n:
        out.append("- No findings.")
    return "\n".join(out)


def self_test():
    cases = []

    def ok(name, cond):
        cases.append((name, bool(cond)))

    def one(**kw):
        base = {"name": "x", "attempts": 3, "base_delay_ms": 100, "multiplier": 2, "max_delay_ms": 1000,
                "jitter": "full", "per_try_timeout_ms": 1000, "deadline_ms": 5000, "retry_on": [503],
                "respect_retry_after": True}
        base.update(kw)
        return base

    def codes(r, i=0):
        return {f["code"] for f in r["layers"][i]["flags"]}

    d = delays(normalize({"layers": [one(jitter="none", attempts=5)]})[0])
    ok("exponential no jitter 100,200,400,800", [x[2] for x in d] == [100, 200, 400, 800])
    d = delays(normalize({"layers": [one(jitter="none", attempts=6)]})[0])
    ok("cap applied at 1000", d[-1][2] == 1000 and d[-2][2] == 800)
    d = delays(normalize({"layers": [one(jitter="full")]})[0])
    ok("full jitter mean half", d[0] == (0.0, 50.0, 100))
    d = delays(normalize({"layers": [one(jitter="equal")]})[0])
    ok("equal jitter 50..100 mean 75", d[0] == (50.0, 75.0, 100))
    d = delays(normalize({"layers": [one(jitter="decorrelated", attempts=4)]})[0])
    ok("decorrelated within bounds", all(a <= b <= c for a, b, c in d) and d[0][2] == 300 and d[2][2] == 1000)
    r = analyze({"layers": [one()]})
    ok("clean policy has no flags", not codes(r))
    ok("worst case = 3x1000 + 100 + 200", r["layers"][0]["worst_case_ms"] == 3300)
    r = analyze({"layers": [one(deadline_ms=2000)]})
    ok("deadline caps worst case", r["layers"][0]["worst_case_ms"] == 2000)
    ok("expected tries p=0.5 n=3 is 1.75", expected_tries(3, 0.5) == 1.75 and expected_tries(3, 1) == 3)
    ok("no jitter flagged", "NO_JITTER" in codes(analyze({"layers": [one(jitter="none")]})))
    ok("hot loop flagged", "HOT_LOOP" in codes(analyze({"layers": [one(base_delay_ms=0)]})))
    ok("no cap flagged with 4+ attempts", "NO_CAP" in codes(analyze({"layers": [one(max_delay_ms=None, attempts=4)]})))
    ok("unsafe retry flagged", "RETRY_UNSAFE" in codes(analyze({"layers": [one(idempotent=False)]})))
    ok("idempotency key makes it safe", "RETRY_UNSAFE" not in codes(analyze({"layers": [one(idempotent=False, idempotency_key=True)]})))
    ok("4xx retry flagged", "RETRY_ON_4XX" in codes(analyze({"layers": [one(retry_on=[400, 503])]})))
    ok("Retry-After ignored flagged", "IGNORES_RETRY_AFTER" in codes(analyze({"layers": [one(retry_on=[429], respect_retry_after=False)]})))
    ok("single attempt is not a retry policy", not codes(analyze({"layers": [one(attempts=1, jitter="none", deadline_ms=None)]})))
    r = analyze({"layers": [one(per_try_timeout_ms=2000, deadline_ms=None), one(per_try_timeout_ms=1000, deadline_ms=None)]})
    ok("inner outlives caller flagged", "INNER_OUTLIVES_CALLER" in codes(r, 1))
    r = analyze({"layers": [one(per_try_timeout_ms=4000), one(per_try_timeout_ms=1000, deadline_ms=3500)]})
    ok("inner within caller timeout ok", "INNER_OUTLIVES_CALLER" not in codes(r, 1))
    r = analyze({"layers": [one(), one(), one()], "max_amplification": 10})
    ok("3x3x3 amplification 27 flagged", r["worst_amplification"] == 27 and "AMPLIFICATION" in codes(r, 2))
    r = analyze({"layers": [one(), one()]}, failure_rate=0.5)
    ok("expected amplification 1.75^2", r["expected_amplification"] == 3.062)
    for bad, label in ((({"layers": []}), "empty layers rejected"), (({"layers": [one(jitter="random")]}), "bad jitter rejected"),
                       (({"layers": [one(attempts=0)]}), "zero attempts rejected"), (({"layers": [one(attempts=2.5)]}), "fractional attempts rejected")):
        try:
            analyze(bad)
            ok(label, False)
        except PolicyError:
            ok(label, True)
    ok("fmt_ms", fmt_ms(1500) == "1.5 s" and fmt_ms(250) == "250 ms" and fmt_ms(None) == "unbounded")
    passed = sum(c for _, c in cases)
    for name, c in cases:
        print(("PASS " if c else "FAIL ") + name)
    print(f"{passed}/{len(cases)} passed")
    return 0 if passed == len(cases) else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="Check retry/backoff/timeout policies across a call chain.")
    ap.add_argument("file", nargs="?", help="chain JSON ('-' for stdin)")
    ap.add_argument("--failure-rate", type=float, help="probability that one try fails (default from file or 0.2)")
    ap.add_argument("--max-amplification", type=float, help="flag chains above this worst-case amplification (default 10)")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    if not a.file:
        ap.error("chain JSON required (or --self-test)")
    try:
        raw = json.load(sys.stdin if a.file == "-" else open(a.file, encoding="utf-8"))
        r = analyze(raw, a.failure_rate, a.max_amplification)
    except (OSError, PolicyError, ValueError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(r, indent=2) if a.json else to_markdown(r))
    return 1 if r["high_flags"] else 0


if __name__ == "__main__":
sys.exit(main())Đánh giá các tiêu đề bộ nhớ đệm HTTP (Cache-Control, Expires, ETag, Last-Modified, Vary, Set-Cookie) cho các trang web, tài sản tĩnh (assets) và API. Tính toán thời gian còn hiệu lực (freshness) trên trình duyệt và CDN, gắn cờ cảnh báo các phản hồi chứa cookie hoặc dữ liệu cá nhân mà CDN có nguy cơ lưu chung, trang HTML được lưu đệm quá lâu, tài sản đã gắn mã băm (hashed) lại lưu đệm quá ngắn, thuộc tính immutable gắn trên các URL có nội dung thay đổi, phân mảnh bộ nhớ đệm do Vary, thiếu bộ xác thực (validator), lưu đệm theo suy đoán (heuristic caching) và lưu đệm cả các phản hồi lỗi. Đề xuất tiêu đề phù hợp cho từng loại tài nguyên. Bao gồm công cụ kiểm tra viết bằng thư viện chuẩn Python có hỗ trợ cờ `--self-test`.
---
name: http-cache-header-reviewer
description: Đánh giá các tiêu đề bộ nhớ đệm HTTP (Cache-Control, Expires, ETag, Last-Modified, Vary, Set-Cookie) cho các trang web, tài sản tĩnh (assets) và API. Tính toán thời gian còn hiệu lực (freshness) trên trình duyệt và CDN, gắn cờ cảnh báo các phản hồi chứa cookie hoặc dữ liệu cá nhân mà CDN có nguy cơ lưu chung, trang HTML được lưu đệm quá lâu, tài sản đã gắn mã băm (hashed) lại lưu đệm quá ngắn, thuộc tính immutable gắn trên các URL có nội dung thay đổi, phân mảnh bộ nhớ đệm do Vary, thiếu bộ xác thực (validator), lưu đệm theo suy đoán (heuristic caching) và lưu đệm cả các phản hồi lỗi. Đề xuất tiêu đề phù hợp cho từng loại tài nguyên. Bao gồm công cụ kiểm tra viết bằng thư viện chuẩn Python có hỗ trợ cờ --self-test.
---

# Trình Đánh Giá Tiêu Đề Bộ Nhớ Đệm HTTP (HTTP Cache Header Reviewer)

Bạn giúp các lập trình viên web cấu hình bộ nhớ đệm (caching) chuẩn xác: tăng tốc độ cho các lần truy cập lặp lại và giảm hóa đơn chi phí CDN mà không làm trang web bị cũ sau khi triển khai (deploy) hoặc tệ hơn là trả nhầm dữ liệu của người dùng này cho người dùng khác. Bạn thu thập các tiêu đề phản hồi (response headers) thực tế, giải thích cách từng tầng bộ nhớ đệm sẽ thực sự xử lý chúng, và đề xuất tiêu đề chuẩn cho từng loại tài nguyên kèm theo danh sách khắc phục ngắn gọn.

## Các tệp trong kỹ năng này

- `scripts/cache_audit.py` - đọc các khối phản hồi (đầu ra từ `curl -sI` hoặc DevTools) và in ra loại tài nguyên, thời gian sống (TTL) trên trình duyệt và CDN, cơ chế xác thực lại (revalidation), các cờ cảnh báo và tiêu đề `Cache-Control` được đề xuất (chỉ dùng thư viện chuẩn của Python 3)
- `references/cache-control-directives.md` - giải thích mọi chỉ thị (directive), quy tắc tính thời gian hiệu lực (freshness) và lưu đệm suy đoán (heuristic), bộ xác thực (validators), tiêu đề `Vary`, các mã trạng thái có thể lưu đệm
- `references/caching-strategy-playbook.md` - các tiêu đề khuyến nghị theo từng loại tài nguyên, đảm bảo an toàn khi triển khai (deploy), các lưu ý về CDN, cách thu thập và kiểm chứng tiêu đề
- `templates/cache-review-report.md` - mẫu báo cáo đối chiếu tiêu đề hiện tại với tiêu đề khuyến nghị cùng danh sách các mục cần sửa
- `examples/shop-responses.txt` - tám phản hồi từ một trang thương mại điện tử mẫu chứa các lỗi cấu hình phổ biến

## Quy trình thực hiện

### 1. Thu thập các tiêu đề
Yêu cầu danh sách các URL đại diện: trang chủ, một trang sau khi đăng nhập, một tệp JS/CSS có gắn mã băm (hashed), một tệp kịch bản không gắn mã băm, một hình ảnh, một phông chữ, một lệnh gọi API công khai, một lệnh gọi API cá nhân, và một phản hồi báo lỗi. Thu thập bằng lệnh `curl -sI <url>` (thêm `-H 'Cookie: ...'` hoặc `-H 'Authorization: ...'` đối với các yêu cầu đã đăng nhập, tuyệt đối không dán token thật vào báo cáo) hoặc dùng DevTools. Đặt từng phản hồi theo định dạng khối của tệp `examples/shop-responses.txt`: một dòng `### METHOD URL`, các dòng tùy chọn `> Request-Header: value`, dòng trạng thái (status line), rồi đến các tiêu đề phản hồi.

### 2. Chạy công cụ kiểm tra
```
python3 scripts/cache_audit.py examples/shop-responses.txt
python3 scripts/cache_audit.py headers.txt --json > cache-report.json
python3 scripts/cache_audit.py --self-test
```
Mã thoát (exit code) bằng 1 có nghĩa là phát hiện vấn đề mức độ nghiêm trọng cao, bằng 2 có nghĩa là không thể phân tích cú pháp dữ liệu đầu vào.

### 3. Giải thích các phát hiện
Thứ tự ưu tiên: quyền riêng tư là trên hết (AUTH_SHARED_CACHE, PUBLIC_WITH_COOKIE, PERSONAL_NOT_PRIVATE), tiếp theo là tính đúng đắn sau khi triển khai bản mới (HTML_LONG_TTL, IMMUTABLE_UNHASHED, ERROR_CACHED), sau đó đến hiệu năng (HASHED_SHORT_TTL, ASSET_NO_CACHING, VARY_FRAGMENTS, NO_VALIDATOR, HEURISTIC_ONLY) và tính chuẩn mực trong cấu hình (INVALID_DIRECTIVE, NO_STORE_CONFLICT, EXPIRES_ONLY, PRAGMA_ONLY). Sử dụng tệp `references/cache-control-directives.md` để giải thích lý do.

### 4. Đề xuất tiêu đề chuẩn
Sử dụng tệp `references/caching-strategy-playbook.md`. Đưa ra tiêu đề chính xác cho từng loại tài nguyên và chỉ rõ vị trí cần thiết lập trong hệ thống công nghệ (stack) của người dùng (Nginx `add_header`, Express `res.set`, Next.js `headers()`, siêu dữ liệu S3/CloudFront, quy tắc Cloudflare). Nhắc tới nguyên tắc triển khai: lưu đệm tài sản có mã băm trong một năm, còn tệp HTML thì luôn xác thực lại (revalidate).

### 5. Xác minh và lập báo cáo
Điền thông tin vào mẫu `templates/cache-review-report.md`. Sau khi thay đổi cấu hình, hãy thu thập lại các tiêu đề và chạy lại công cụ kiểm tra; đồng thời kiểm tra các tiêu đề HIT/MISS của CDN.

## Ví dụ kết quả
Đối với tệp `examples/shop-responses.txt`: 5 phát hiện mức độ cao (trang HTML trang chủ lưu đệm 1 ngày, tệp `widget.js` đặt `immutable` nhưng không có mã băm, API giỏ hàng có cookie phiên làm việc lại bị CDN lưu đệm trong 2 phút, trang đăng nhập có `Set-Cookie` nhưng bị đánh dấu `public` và lưu đệm 10 phút), 4 phát hiện mức trung bình (`app.3f9a1c7b.js` chỉ lưu đệm 1 giờ, `hero.jpg` lưu đệm theo suy đoán 8,1 ngày, dùng `Vary: Cookie`, lỗi 503 bị lưu đệm trong 1 giờ) và 1 phát hiện mức thấp (API giỏ hàng không có bộ xác thực); chỉ có duy nhất tệp `vendor.81d2e0aa.css` là đã được cấu hình lý tưởng.

## Quy tắc

- Luôn coi bất kỳ nguy cơ nào khiến bộ nhớ đệm dùng chung (shared cache) lưu trữ dữ liệu cá nhân là vấn đề ưu tiên hàng đầu.
- Không yêu cầu hoặc lưu giữ cookie hay token thật; chỉ cần dùng các giá trị giữ chỗ (placeholders) là đủ.
- Khuyến nghị xóa bộ nhớ đệm (purge) hoặc đánh phiên bản URL (URL versioning) khi thay đổi thời gian sống (TTL) của các tài nguyên đang chạy thực tế.
- Nêu rõ khi nào hành vi phụ thuộc vào cấu hình riêng của nhà cung cấp CDN và đề xuất người dùng kiểm tra cấu hình đó.
FILE:references/cache-control-directives.md
# Các Chỉ Thị Cache-Control và Quy Tắc Tính Thời Gian Hiệu Lực

## Các chỉ thị trong phản hồi (Response directives)
| Chỉ thị | Ý nghĩa |
|---|---|
| max-age=N | Còn hiệu lực (fresh) trong N giây ở bất kỳ bộ nhớ đệm nào (cả trình duyệt lẫn bộ nhớ đệm dùng chung) |
| s-maxage=N | Ghi đè giá trị max-age chỉ dành riêng cho các bộ nhớ đệm dùng chung (CDN, proxy) |
| no-cache | Có thể được lưu trữ, nhưng bắt buộc phải xác thực lại (revalidate) với máy chủ gốc trước mỗi lần sử dụng |
| no-store | Tuyệt đối không được lưu trữ ở bất cứ đâu; ghi đè lên mọi chỉ thị khác |
| private | Chỉ trình duyệt của người dùng mới được phép lưu trữ; các CDN và proxy không được phép lưu |
| public | Bộ nhớ đệm dùng chung được phép lưu trữ ngay cả khi thông thường phản hồi đó không được lưu đệm (ví dụ khi có tiêu đề Authorization) |
| must-revalidate | Một khi đã hết hạn (stale), tuyệt đối không được phục vụ nếu chưa xác thực lại thành công với máy chủ gốc |
| proxy-revalidate | Tương tự như must-revalidate, nhưng chỉ áp dụng cho các bộ nhớ đệm dùng chung |
| immutable | Sẽ không bao giờ thay đổi trong suốt thời gian còn hiệu lực; trình duyệt bỏ qua bước xác thực lại khi người dùng tải lại trang |
| stale-while-revalidate=N | Cho phép phục vụ bản cũ đã hết hạn trong N giây trong khi âm thầm làm mới dưới nền |
| stale-if-error=N | Cho phép phục vụ bản cũ đã hết hạn trong N giây nếu máy chủ gốc trả về lỗi 5xx hoặc không thể kết nối |
| no-transform | Các trạm trung gian không được phép sửa đổi phần thân phản hồi (như nén lại hình ảnh, v.v.) |

Những nhầm lẫn phổ biến: `no-cache` KHÔNG có nghĩa là "không lưu vào bộ nhớ đệm" (đó là chức năng của `no-store`); giá trị của `max-age` bắt buộc phải là số nguyên giây (`max-age=10m` là không hợp lệ và sẽ bị bỏ qua); `Pragma: no-cache` chỉ có tác dụng trên chiều yêu cầu gửi đi (request).

## Thời gian sống còn hiệu lực (Freshness lifetime - RFC 9111)
1. Bộ nhớ đệm dùng chung (Shared cache): ưu tiên `s-maxage`, nếu không có thì lấy `max-age`, nếu không có nữa thì lấy `Expires - Date`.
2. Trình duyệt (Browser): ưu tiên `max-age`, nếu không có thì lấy `Expires - Date`.
3. Khi không có cả hai tiêu đề trên nhưng có `Last-Modified`: các bộ nhớ đệm có thể tính theo suy đoán (heuristic), thường lấy bằng 10% của `(Date - Last-Modified)`. Một tệp được sửa đổi lần cuối cách đây 80 ngày có thể được tái sử dụng suốt 8 ngày mà không cần kiểm tra lại.
4. Chỉ thị `private` đặt thời gian sống trên bộ nhớ đệm dùng chung về 0. Chỉ thị `no-store` đặt cả hai về 0.

## Bộ xác thực (Validators) và cơ chế xác thực lại (Revalidation)
- ETag (mạnh `"abc"` hoặc yếu `W/"abc"`) -> phía máy khách gửi kèm tiêu đề `If-None-Match`.
- Last-Modified -> phía máy khách gửi kèm tiêu đề `If-Modified-Since`.
- Nếu khớp, máy chủ trả về mã `304 Not Modified` không kèm phần thân (body), rất nhẹ và tiết kiệm băng thông. Nếu không có bộ xác thực, mỗi lần xác thực lại đều phải tải về toàn bộ phần thân phản hồi.

## Tiêu đề Vary
- `Vary: Accept-Encoding` là bình thường và an toàn.
- `Vary: Cookie`, `User-Agent` hoặc `Referer` sẽ tạo ra một bản ghi bộ nhớ đệm riêng cho mỗi giá trị khác nhau, đồng nghĩa với việc hầu như không bao giờ trúng bộ nhớ đệm (cache hit) trên CDN.
- `Vary: *` có nghĩa là phản hồi này không bao giờ có thể tái sử dụng.

## Các mã trạng thái (Status codes)
Được phép lưu đệm theo mặc định khi còn hiệu lực: 200, 203, 204, 206, 300, 301, 308, 404, 405, 410, 414, 501. Các phản hồi lỗi (4xx/5xx) chỉ nên lưu đệm rất ngắn hoặc không lưu đệm, nếu không CDN có thể hiển thị trang báo sập hệ thống suốt nhiều giờ liền. Hãy sử dụng `stale-if-error` để phục vụ bản sao hợp lệ gần nhất thay thế.
FILE:references/caching-strategy-playbook.md
# Cẩm Nang Chiến Lược Bộ Nhớ Đệm

## Các tiêu đề khuyến nghị theo từng loại tài nguyên
| Tài nguyên | Cache-Control | Ghi chú |
|---|---|---|
| Trang HTML, khung ứng dụng (app shell) | `no-cache` + ETag | Luôn mới sau mỗi lần triển khai (deploy); phản hồi 304 giúp tiết kiệm băng thông |
| Trang HTML tiếp thị (Marketing) trên CDN | `public, max-age=0, s-maxage=300, stale-while-revalidate=60` | Xóa bộ nhớ đệm CDN (purge) khi xuất bản nội dung mới |
| Tệp JS/CSS có mã băm nội dung (`app.3f9a1c7b.js`) | `public, max-age=31536000, immutable` | Bản dựng (build) mới = URL mới |
| Tệp JS/CSS không có mã băm | `public, max-age=300, stale-while-revalidate=86400` | Hoặc bổ sung cơ chế gắn mã băm vào quy trình build |
| Hình ảnh, tệp người dùng tải lên có URL cố định | `public, max-age=86400, stale-while-revalidate=604800` | Đánh phiên bản cho URL khi hình ảnh thay đổi |
| Phông chữ (URL có đánh phiên bản) | `public, max-age=31536000, immutable` | Đồng thời gửi kèm các tiêu đề CORS |
| Dữ liệu API công khai (giá cả, danh mục sản phẩm) | `public, max-age=30, s-maxage=300, stale-if-error=600` | Giữ TTL ngắn; xóa bộ nhớ đệm khi dữ liệu thay đổi |
| Dữ liệu API cá nhân (giỏ hàng, hồ sơ cá nhân) | `private, no-cache` + ETag | Tuyệt đối không đặt là public |
| Thông tin bí mật, ngân hàng, hồ sơ y tế, token dùng một lần | `no-store` | Áp dụng cả trên trang đăng xuất và trang quản lý tài khoản |
| Chuyển hướng 301 (Redirect 301) | Bắt đầu với `max-age=86400` | Trình duyệt có thể lưu đệm vĩnh viễn một mã 301 không kèm giới hạn thời gian |
| Các lỗi 5xx | `no-store` hoặc `max-age=0`, kết hợp dùng `stale-if-error` trên các phản hồi thành công | |

## Đảm bảo an toàn khi triển khai (Deploy safety)
1. Gắn mã băm (hash) vào tên của mọi tệp tài sản được tạo ra khi build, sau đó lưu đệm chúng trong thời hạn một năm.
2. Cho tệp HTML xác thực lại (revalidate) để nó luôn trỏ tới các tệp có mã băm mới nhất hiện tại.
3. Giữ các tệp tài sản gắn mã băm của bản cũ tiếp tục trực tuyến ít nhất qua một đợt phát hành để các tab trình duyệt đang mở sẵn vẫn hoạt động bình thường.
4. Tuyệt đối không gắn chỉ thị `immutable` lên một URL mà nội dung của nó có thể thay đổi.

## Các lưu ý về CDN
- Hầu hết các CDN chỉ bỏ qua `private`/`no-store` khi bị cấu hình sai; hãy kiểm tra tùy chọn "tôn trọng tiêu đề từ máy chủ gốc" (respect origin headers).
- Nhiều CDN mặc định không lưu đệm các phản hồi có chứa `Set-Cookie`; nhưng một số CDN vẫn lưu nếu có đặt chỉ thị `public`. Hãy loại bỏ `Set-Cookie` khỏi các phản hồi tài nguyên tĩnh.
- Sử dụng tiêu đề `Surrogate-Control` hoặc `CDN-Cache-Control` nếu CDN có hỗ trợ và bạn muốn thiết lập TTL trên CDN tách biệt với TTL trên trình duyệt.
- Chuẩn hóa khóa bộ nhớ đệm (cache key) (bỏ qua các chuỗi truy vấn theo dõi quảng cáo như `utm_*`).

## Cách thu thập các tiêu đề
```
curl -sI https://example.com/ ; curl -sI -H 'Cookie: session=...' https://example.com/api/me
curl -s -o /dev/null -D - https://example.com/assets/app.js   # Dùng GET thay vì HEAD
```
Một số máy chủ trả lời phương thức HEAD khác với phương thức GET; khi nghi ngờ, hãy sử dụng cú pháp GET. Trong Chrome DevTools: mở tab Network, chọn một yêu cầu, vào mục Headers, tìm phần Response Headers (sao chép dưới dạng văn bản).

## Kiểm tra kết quả
- Tải lại trang hai lần trong DevTools: các tài sản có gắn mã băm phải hiển thị "(memory cache)" hoặc "(disk cache)", còn trang HTML phải hiển thị mã 304 hoặc 200.
- Đối với CDN: quan sát các tiêu đề `Age`, `X-Cache` hoặc `CF-Cache-Status` (HIT / MISS / BYPASS).
FILE:templates/cache-review-report.md
# Báo Cáo Đánh Giá Bộ Nhớ Đệm HTTP - <site / service> - <date>

**Phạm vi:** <URLs or HAR file>  **CDN:** <name or none>  **Thu thập bằng:** <curl -sI / DevTools / HAR>

## Tóm tắt
- Số phản hồi đã đánh giá: <n>  Mức Cao: <n>  Mức Trung bình: <n>  Mức Thấp: <n>
- Rủi ro lớn nhất: <ví dụ: API cá nhân bị lưu đệm trên CDN>
- Cải thiện mang lại hiệu quả lớn nhất: <ví dụ: lưu đệm một năm cho các tài sản tĩnh có gắn mã băm>

## Đối chiếu hiện tại và khuyến nghị
| Tài nguyên | Loại | Cache-Control hiện tại | TTL Trình duyệt / CDN | Cờ cảnh báo | Khuyến nghị |
|---|---|---|---|---|---|
| | | | | | |

## Danh sách cần khắc phục
| Ưu tiên | Thay đổi cần làm | Vị trí sửa (máy chủ, framework, quy tắc CDN) | Người phụ trách | Hoàn thành |
|---|---|---|---|---|
| 1 | | | | [ ] |

## Xác minh
- [ ] Chạy lại lệnh `python3 scripts/cache_audit.py` trên các tiêu đề mới thu thập: không còn phát hiện mức độ cao
- [ ] CDN hiển thị HIT đối với các tệp tĩnh, BYPASS/MISS đối với API dữ liệu cá nhân
- [ ] Kiểm thử triển khai (deploy test): trang HTML mới tải đúng các tài sản mới mà không cần ép tải lại trang (hard refresh)
FILE:examples/shop-responses.txt
# Responses captured with: curl -sI <url>  (request headers sent are listed with "> ")
### GET https://shop.example/
HTTP/2 200
content-type: text/html; charset=utf-8
cache-control: public, max-age=86400
date: Wed, 21 Oct 2026 07:00:00 GMT

### GET https://shop.example/assets/app.3f9a1c7b.js
HTTP/2 200
content-type: application/javascript
cache-control: public, max-age=3600
etag: "3f9a1c7b"

### GET https://shop.example/assets/vendor.81d2e0aa.css
HTTP/2 200
content-type: text/css
cache-control: public, max-age=31536000, immutable
etag: "81d2e0aa"

### GET https://shop.example/js/widget.js
HTTP/2 200
content-type: application/javascript
cache-control: public, max-age=31536000, immutable

### GET https://shop.example/img/hero.jpg
HTTP/2 200
content-type: image/jpeg
date: Wed, 21 Oct 2026 07:00:00 GMT
last-modified: Sat, 01 Aug 2026 07:00:00 GMT

### GET https://shop.example/api/cart
> Cookie: session=abc123
HTTP/2 200
content-type: application/json
cache-control: public, s-maxage=120
vary: Cookie

### POST https://shop.example/login
HTTP/2 200
content-type: text/html; charset=utf-8
cache-control: public, max-age=600
set-cookie: session=xyz789; HttpOnly; Secure; SameSite=Lax

### GET https://shop.example/api/products?page=1
HTTP/2 503
content-type: application/json
cache-control: public, max-age=3600
FILE:scripts/cache_audit.py
#!/usr/bin/env python3
"""HTTP caching header reviewer (Python 3 standard library only).

Input: a text file with one block per response, as copied from `curl -sI`, browser
devtools or a HAR export:
  ### GET https://shop.example/assets/app.3f9a1c7b.js
  > Authorization: Bearer ...          (optional request headers start with "> ")
  HTTP/2 200
  content-type: application/javascript
  cache-control: public, max-age=31536000, immutable
  etag: "3f9a1c7b"
Blank lines and lines starting with "#" (but not "###") are ignored.

For each response it works out the kind (html, hashed-asset, asset, api, image, font, other),
browser and shared-cache (CDN) freshness in seconds (s-maxage > max-age > Expires - Date >
10% heuristic from Last-Modified), whether it can be revalidated, and flags:
  NO_STORE_CONFLICT, PUBLIC_WITH_COOKIE, AUTH_SHARED_CACHE, PERSONAL_NOT_PRIVATE, VARY_STAR,
  VARY_FRAGMENTS, HTML_LONG_TTL, HASHED_SHORT_TTL, IMMUTABLE_UNHASHED, ASSET_NO_CACHING,
  NO_VALIDATOR, HEURISTIC_ONLY, EXPIRES_ONLY, PRAGMA_ONLY, ERROR_CACHED, INVALID_DIRECTIVE.
It suggests a Cache-Control value per kind.
Usage:
  python3 cache_audit.py responses.txt
  python3 cache_audit.py responses.txt --json
  python3 cache_audit.py --self-test
Exit code: 0 OK, 1 high-severity flags found, 2 bad input.
"""
import argparse
import email.utils
import json
import re
import sys

KNOWN = {"max-age", "s-maxage", "no-cache", "no-store", "no-transform", "must-revalidate",
         "proxy-revalidate", "must-understand", "private", "public", "immutable",
         "stale-while-revalidate", "stale-if-error"}
NEEDS_INT = {"max-age", "s-maxage", "stale-while-revalidate", "stale-if-error"}
HASH_RE = re.compile(r"[.\-_]([0-9a-f]{8,}|[0-9A-Za-z_-]{8,}(?=\.[a-z0-9]+$))\.[a-z0-9]+$")
SEVERITY = {"NO_STORE_CONFLICT": "low", "PUBLIC_WITH_COOKIE": "high", "AUTH_SHARED_CACHE": "high",
            "PERSONAL_NOT_PRIVATE": "medium", "VARY_STAR": "medium", "VARY_FRAGMENTS": "medium",
            "HTML_LONG_TTL": "high", "HASHED_SHORT_TTL": "medium", "IMMUTABLE_UNHASHED": "high",
            "ASSET_NO_CACHING": "medium", "NO_VALIDATOR": "low", "HEURISTIC_ONLY": "medium",
            "EXPIRES_ONLY": "low", "PRAGMA_ONLY": "low", "ERROR_CACHED": "medium",
            "INVALID_DIRECTIVE": "medium"}
RECOMMEND = {
    "html": "no-cache (plus ETag or Last-Modified), or max-age=0, must-revalidate",
    "hashed-asset": "public, max-age=31536000, immutable",
    "asset": "public, max-age=3600, stale-while-revalidate=86400 (or add a content hash to the file name)",
    "image": "public, max-age=86400, stale-while-revalidate=604800",
    "font": "public, max-age=31536000, immutable (if the URL is versioned)",
    "api": "private, no-cache for user data; public, max-age=60, s-maxage=300 only for truly public data",
    "personal": "private, no-cache (or no-store for sensitive data)",
    "other": "set an explicit Cache-Control",
}


class CacheError(ValueError):
    pass


def parse_cc(value):
    """Return (directives dict, problems list)."""
    d, problems = {}, []
    for part in [p.strip() for p in value.split(",") if p.strip()]:
        k, eq, v = part.partition("=")
        k = k.strip().lower()
        v = v.strip().strip('"')
        if k not in KNOWN:
            problems.append(f"unknown directive {k!r}")
            continue
        if k in NEEDS_INT:
            if not re.fullmatch(r"\d+", v or ""):
                problems.append(f"{k} needs a whole number of seconds, got {v!r}")
                continue
            d[k] = int(v)
        else:
            d[k] = True if not eq else v
    return d, problems


def parse_blocks(text):
    blocks, cur = [], None
    for raw in text.splitlines():
        line = raw.rstrip("\r")
        if line.startswith("###"):
            cur = {"label": line[3:].strip(), "status": None, "headers": {}, "request": {}}
            blocks.append(cur)
            continue
        if not line.strip() or line.lstrip().startswith("#"):
            continue
        if cur is None:
            raise CacheError("file must start with a '### METHOD URL' line")
        if line.startswith(">"):
            k, _, v = line[1:].strip().partition(":")
            cur["request"][k.strip().lower()] = v.strip()
            continue
        m = re.match(r"HTTP/[\d.]+\s+(\d{3})", line)
        if m:
            cur["status"] = int(m.group(1))
            continue
        k, colon, v = line.partition(":")
        if not colon:
            raise CacheError(f"cannot parse header line {line!r} in block {cur['label']!r}")
        k = k.strip().lower()
        if k in cur["headers"] and k in ("cache-control", "vary"):
            cur["headers"][k] += ", " + v.strip()
        elif k == "set-cookie":
            cur["headers"].setdefault(k, []).append(v.strip())
        else:
            cur["headers"][k] = v.strip()
    if not blocks:
        raise CacheError("no response blocks found")
    return blocks


def url_of(label):
    parts = label.split()
    return parts[-1] if parts else ""


def kind_of(url, ctype):
    path = re.sub(r"[?#].*$", "", url)
    name = path.rsplit("/", 1)[-1].lower()
    ctype = ctype.lower()
    hashed = bool(HASH_RE.search(name)) and bool(re.search(r"\d", name))
    if "text/html" in ctype or name.endswith(".html") or (not ctype and "." not in name):
        return "html", False
    if "json" in ctype or "/api/" in path or "graphql" in path:
        return "api", False
    if name.endswith((".woff2", ".woff", ".ttf", ".otf")) or "font" in ctype:
        return "font", hashed
    if ctype.startswith("image/") or name.endswith((".png", ".jpg", ".jpeg", ".gif", ".webp", ".avif", ".svg", ".ico")):
        return ("hashed-asset" if hashed else "image"), hashed
    if name.endswith((".js", ".mjs", ".css", ".map", ".wasm")) or "javascript" in ctype or "text/css" in ctype:
        return ("hashed-asset" if hashed else "asset"), hashed
    return "other", hashed


def http_date(v):
    try:
        return email.utils.parsedate_to_datetime(v)
    except (TypeError, ValueError, IndexError):
        return None


def review(block):
    h, req = block["headers"], block["request"]
    status = block["status"] or 200
    url = url_of(block["label"])
    kind, hashed = kind_of(url, h.get("content-type", ""))
    cc, problems = parse_cc(h.get("cache-control", ""))
    flags = []

    def flag(code, detail):
        flags.append({"code": code, "severity": SEVERITY[code], "detail": detail})

    for p in problems:
        flag("INVALID_DIRECTIVE", p)
    cookies = h.get("set-cookie", [])
    auth = "authorization" in req or "cookie" in req
    date, expires, lastmod = http_date(h.get("date")), h.get("expires"), http_date(h.get("last-modified"))
    no_store = "no-store" in cc
    heuristic = False
    if no_store:
        browser = shared = 0
    else:
        browser = cc.get("max-age")
        if browser is None and expires is not None:
            ex = http_date(expires)
            browser = max(0, int((ex - date).total_seconds())) if ex and date else 0
        if browser is None and "no-cache" not in cc and lastmod and date and status in (200, 203, 204, 206, 300, 301, 404, 405, 410, 414, 501):
            browser = max(0, int((date - lastmod).total_seconds() / 10))
            heuristic = True
        browser = browser or 0
        shared = 0 if "private" in cc else cc.get("s-maxage", browser)
    if "no-cache" in cc:
        browser_eff, shared_eff = 0, 0
    else:
        browser_eff, shared_eff = browser, shared
    validator = "etag" in h or "last-modified" in h
    personal = bool(cookies) or auth

    if no_store and any(k in cc for k in ("max-age", "s-maxage", "public", "immutable")):
        flag("NO_STORE_CONFLICT", "no-store overrides the other directives; remove the extras so intent is clear")
    if cookies and ("public" in cc or "s-maxage" in cc) and not no_store:
        flag("PUBLIC_WITH_COOKIE", "response sets a cookie but allows shared caches; a CDN may serve one user's cookie to others")
    if auth and shared > 0 and ("public" in cc or "s-maxage" in cc) and kind in ("api", "html", "other"):
        flag("AUTH_SHARED_CACHE", "authenticated request with a response that shared caches may store; personal data can leak across users")
    elif personal and kind in ("api", "html", "other") and not no_store and "private" not in cc \
            and not any(f["code"] == "PUBLIC_WITH_COOKIE" for f in flags):
        flag("PERSONAL_NOT_PRIVATE", "personalized response without private or no-store")
    vary = [v.strip().lower() for v in h.get("vary", "").split(",") if v.strip()]
    if "*" in vary:
        flag("VARY_STAR", "Vary: * makes the response effectively uncacheable")
    frag = [v for v in vary if v in ("user-agent", "cookie", "referer")]
    if frag and shared > 0:
        flag("VARY_FRAGMENTS", f"Vary on {', '.join(frag)} splits the CDN cache into many copies; vary on a normalized header instead")
    if kind == "html" and browser_eff > 300:
        flag("HTML_LONG_TTL", f"HTML cached {fmt_s(browser_eff)} without revalidation; users keep old pages that point to deleted assets after a deploy")
    if kind == "hashed-asset" and browser_eff < 30 * 86400 and not no_store:
        flag("HASHED_SHORT_TTL", f"content-hashed file cached only {fmt_s(browser_eff)}; it can be cached for a year with immutable")
    if "immutable" in cc and not hashed:
        flag("IMMUTABLE_UNHASHED", "immutable on a URL without a content hash; browsers will not pick up changes until max-age expires")
    if kind in ("asset", "image", "font") and (no_store or "no-cache" in cc) and not personal:
        flag("ASSET_NO_CACHING", "static file is never reused from cache; every page view downloads or revalidates it")
    if ("no-cache" in cc or browser_eff == 0) and not no_store and not validator and status == 200:
        flag("NO_VALIDATOR", "must revalidate but has no ETag or Last-Modified, so every check downloads the full body")
    if heuristic:
        flag("HEURISTIC_ONLY", f"no Cache-Control or Expires; caches guess {fmt_s(browser)} from Last-Modified")
    if "cache-control" not in h and expires is not None:
        flag("EXPIRES_ONLY", "only the legacy Expires header; add Cache-Control max-age")
    if "cache-control" not in h and "pragma" in h:
        flag("PRAGMA_ONLY", "Pragma: no-cache is a request header and has no effect on responses; use Cache-Control")
    if status >= 400 and max(browser_eff, shared_eff) > 300:
        flag("ERROR_CACHED", f"status {status} cached for {fmt_s(max(browser_eff, shared_eff))}; a brief error becomes a long outage")
    rec_kind = "personal" if personal and kind in ("api", "html", "other") else kind
    return {"label": block["label"], "status": status, "kind": kind, "hashed": hashed,
            "cache_control": h.get("cache-control"), "browser_ttl_s": browser_eff, "shared_ttl_s": shared_eff,
            "revalidate": "no-cache" in cc or "must-revalidate" in cc, "validator": validator,
            "stale_while_revalidate_s": cc.get("stale-while-revalidate"), "flags": flags,
            "recommended": RECOMMEND[rec_kind]}


def fmt_s(s):
    if s is None:
        return "-"
    for unit, n in (("d", 86400), ("h", 3600), ("m", 60)):
        if s >= n:
            v = s / n
            return f"{v:.0f}{unit}" if v == int(v) else f"{v:.1f}{unit}"
    return f"{s}s"


def audit(text):
    items = [review(b) for b in parse_blocks(text)]
    return {"items": items, "high_flags": sum(1 for i in items for f in i["flags"] if f["severity"] == "high")}


def to_markdown(r):
    out = ["# HTTP cache header review", "",
           "| Response | Status | Kind | Browser TTL | CDN TTL | Revalidate | Validator | Flags |",
           "|---|---|---|---|---|---|---|---|"]
    for i in r["items"]:
        out.append(f"| {i['label']} | {i['status']} | {i['kind']} | {fmt_s(i['browser_ttl_s'])} | {fmt_s(i['shared_ttl_s'])} | "
                   f"{'yes' if i['revalidate'] else 'no'} | {'yes' if i['validator'] else 'no'} | {', '.join(f['code'] for f in i['flags']) or '-'} |")
    out += ["", "## Findings"]
    n = 0
    for sev in ("high", "medium", "low"):
        for i in r["items"]:
            for f in i["flags"]:
                if f["severity"] == sev:
                    n += 1
                    out.append(f"- **{sev.upper()} {f['code']}** {i['label']}: {f['detail']}")
    if not n:
        out.append("- No findings.")
    out += ["", "## Suggested Cache-Control"]
    for i in r["items"]:
        if i["flags"]:
            out.append(f"- {i['label']}: `{i['recommended']}` (now: `{i['cache_control'] or 'none'}`)")
    return "\n".join(out)


def self_test():
    cases = []

    def ok(name, cond):
        cases.append((name, bool(cond)))

    def one(url, *lines):
        return review(parse_blocks("### GET " + url + "\nHTTP/1.1 200 OK\n" + "\n".join(lines))[0])

    def codes(item):
        return {f["code"] for f in item["flags"]}

    ok("parse max-age", parse_cc("public, max-age=600")[0] == {"public": True, "max-age": 600})
    ok("bad max-age reported", parse_cc("max-age=10m")[1])
    ok("unknown directive reported", parse_cc("maxage=60")[1])
    ok("hashed js detected", kind_of("https://x/app.3f9a1c7b.js", "") == ("hashed-asset", True))
    ok("unhashed css", kind_of("https://x/styles.css", "text/css") == ("asset", False))
    ok("html by content type", kind_of("https://x/", "text/html; charset=utf-8")[0] == "html")
    ok("api by json", kind_of("https://x/api/cart", "application/json")[0] == "api")
    i = one("https://x/app.3f9a1c7b.js", "Cache-Control: public, max-age=31536000, immutable", "ETag: \"a\"")
    ok("ideal hashed asset clean", not codes(i) and i["browser_ttl_s"] == 31536000)
    i = one("https://x/app.3f9a1c7b.js", "Cache-Control: public, max-age=3600")
    ok("hashed short ttl", "HASHED_SHORT_TTL" in codes(i))
    i = one("https://x/main.js", "Cache-Control: public, max-age=31536000, immutable")
    ok("immutable unhashed", "IMMUTABLE_UNHASHED" in codes(i))
    i = one("https://x/", "Content-Type: text/html", "Cache-Control: max-age=86400")
    ok("html long ttl", "HTML_LONG_TTL" in codes(i))
    i = one("https://x/", "Content-Type: text/html", "Cache-Control: no-cache", "ETag: \"1\"")
    ok("html no-cache with etag clean", not codes(i) and i["browser_ttl_s"] == 0)
    i = one("https://x/", "Content-Type: text/html", "Cache-Control: no-cache")
    ok("no validator", "NO_VALIDATOR" in codes(i))
    i = one("https://x/login", "Content-Type: text/html", "Cache-Control: public, max-age=600", "Set-Cookie: sid=1")
    ok("public with cookie", "PUBLIC_WITH_COOKIE" in codes(i))
    i = review(parse_blocks("### GET https://x/api/me\n> Authorization: Bearer t\nHTTP/2 200\ncontent-type: application/json\ncache-control: public, s-maxage=300")[0])
    ok("auth shared cache", "AUTH_SHARED_CACHE" in codes(i) and i["shared_ttl_s"] == 300)
    i = review(parse_blocks("### GET https://x/api/me\n> Cookie: sid=1\nHTTP/2 200\ncontent-type: application/json\ncache-control: max-age=60")[0])
    ok("personal not private", "PERSONAL_NOT_PRIVATE" in codes(i))
    i = one("https://x/api/me", "Content-Type: application/json", "Cache-Control: private, max-age=60")
    ok("private hides from cdn", i["shared_ttl_s"] == 0 and i["browser_ttl_s"] == 60)
    i = one("https://x/a.css", "Cache-Control: no-store, max-age=60")
    ok("no-store conflict and asset no caching", {"NO_STORE_CONFLICT", "ASSET_NO_CACHING"} <= codes(i))
    i = one("https://x/a.css", "Cache-Control: public, max-age=600", "Vary: *")
    ok("vary star", "VARY_STAR" in codes(i))
    i = one("https://x/a.css", "Cache-Control: public, max-age=600", "Vary: Accept-Encoding, User-Agent")
    ok("vary user-agent fragments", "VARY_FRAGMENTS" in codes(i))
    i = one("https://x/logo.png", "Date: Wed, 21 Oct 2026 10:00:00 GMT", "Last-Modified: Mon, 11 Oct 2026 10:00:00 GMT")
    ok("heuristic 10% of 10 days = 1 day", "HEURISTIC_ONLY" in codes(i) and i["browser_ttl_s"] == 86400)
    i = one("https://x/logo.png", "Date: Wed, 21 Oct 2026 10:00:00 GMT", "Expires: Wed, 21 Oct 2026 11:00:00 GMT")
    ok("expires only gives 1h", "EXPIRES_ONLY" in codes(i) and i["browser_ttl_s"] == 3600)
    i = one("https://x/", "Content-Type: text/html", "Pragma: no-cache")
    ok("pragma only", "PRAGMA_ONLY" in codes(i))
    i = review(parse_blocks("### GET https://x/a.css\nHTTP/1.1 503 Service Unavailable\ncache-control: public, max-age=3600")[0])
    ok("error cached", "ERROR_CACHED" in codes(i))
    ok("repeated cache-control merged", parse_blocks("### GET https://x/a\nHTTP/1.1 200\ncache-control: public\ncache-control: max-age=5")[0]["headers"]["cache-control"] == "public, max-age=5")
    try:
        parse_blocks("HTTP/1.1 200 OK\n")
        ok("missing ### rejected", False)
    except CacheError:
        ok("missing ### rejected", True)
    ok("fmt_s", fmt_s(31536000) == "365d" and fmt_s(600) == "10m" and fmt_s(45) == "45s" and fmt_s(699840) == "8.1d")
    passed = sum(c for _, c in cases)
    for name, c in cases:
        print(("PASS " if c else "FAIL ") + name)
    print(f"{passed}/{len(cases)} passed")
    return 0 if passed == len(cases) else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="Review HTTP caching headers.")
    ap.add_argument("file", nargs="?", help="responses text file ('-' for stdin)")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    if not a.file:
        ap.error("responses file required (or --self-test)")
    try:
        text = sys.stdin.read() if a.file == "-" else open(a.file, encoding="utf-8").read()
        r = audit(text)
    except (OSError, CacheError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(r, indent=2) if a.json else to_markdown(r))
    return 1 if r["high_flags"] else 0


if __name__ == "__main__":
sys.exit(main())Xây dựng kế hoạch chống lệch múi giờ (jet lag) theo từng ngày dựa trên giờ bay và khung giờ ngủ thường lệ của bạn. Tính toán chênh lệch múi giờ có xét đến giờ mùa hè (DST), chọn chiến lược đẩy sớm (advance) hoặc lùi muộn (delay) (bao gồm cả phương án đi đường vòng cho các chuyến bay dài về hướng đông), ước tính số ngày cần để thích nghi, đồng thời liệt kê lịch dịch chuyển giờ đi ngủ trước chuyến đi, giấc ngủ trên máy bay và các khung giờ ngủ hàng ngày, thời điểm cần đón và tránh ánh sáng, giờ ngưng nạp caffeine và giới hạn ngủ trưa. Cảnh báo các chuyến đi ngắn ngày. Bao gồm công cụ lập kế hoạch viết bằng thư viện chuẩn Python có hỗ trợ cờ `--self-test`.
---
name: jet-lag-sleep-shift-planner
description: Xây dựng kế hoạch chống lệch múi giờ (jet lag) theo từng ngày dựa trên giờ bay và khung giờ ngủ thường lệ của bạn. Tính toán chênh lệch múi giờ có xét đến giờ mùa hè (DST), chọn chiến lược đẩy sớm (advance) hoặc lùi muộn (delay) (bao gồm cả phương án đi đường vòng cho các chuyến bay dài về hướng đông), ước tính số ngày cần để thích nghi, đồng thời liệt kê lịch dịch chuyển giờ đi ngủ trước chuyến đi, giấc ngủ trên máy bay và các khung giờ ngủ hàng ngày, thời điểm cần đón và tránh ánh sáng, giờ ngưng nạp caffeine và giới hạn ngủ trưa. Cảnh báo các chuyến đi ngắn ngày. Bao gồm công cụ lập kế hoạch viết bằng thư viện chuẩn Python có hỗ trợ cờ --self-test.
---

# Trình Lập Kế Hoạch Điều Chỉnh Giấc Ngủ Giảm Jet Lag

Bạn giúp người đi du lịch hoặc công tác đến nơi trong trạng thái khỏe khoắn, tỉnh táo. Dựa trên giờ bay thực tế và lịch ngủ bình thường của họ, bạn xây dựng một kế hoạch thực tế theo từng ngày: khi nào nên ngủ, khi nào cần đón ánh sáng mạnh và khi nào cần tránh, khi nào nên ngừng uống cà phê, có nên ngủ trên máy bay hay không, và liệu việc dịch chuyển giờ ngủ trước chuyến đi có đáng thực hiện hay không. Bạn giải thích lý do đằng sau bằng ngôn từ bình dân dễ hiểu và giữ cho kế hoạch luôn khả thi với lịch trình cá nhân của họ.

## Các tệp trong kỹ năng này

- `scripts/jetlag_plan.py` - tính toán mức độ dịch chuyển, chiến lược, số ngày chuẩn bị trước chuyến đi, giấc ngủ trên máy bay và bảng lịch trình hàng ngày gồm thời gian ngủ, tiếp xúc ánh sáng, nạp caffeine và chợp mắt (chỉ dùng thư viện chuẩn của Python 3; hỗ trợ múi giờ IANA qua `zoneinfo` hoặc độ lệch cố định như `UTC+3`)
- `references/body-clock-basics.md` - kiến thức cơ bản về đồng hồ sinh học, tốc độ thích nghi, quy tắc ánh sáng xoay quanh điểm CBTmin, bữa ăn, caffeine, giấc ngủ ngắn, lưu ý về melatonin, khi nào cần gặp bác sĩ
- `references/trip-strategies.md` - chiến lược theo độ dài chuyến đi, dịch chuyển giờ giấc trước chuyến đi, trên máy bay, ngày đến nơi, chuyến bay khứ hồi, danh sách kiểm tra (checklist)
- `templates/jet-lag-plan.md` - mẫu kế hoạch gói gọn trong một trang để điền thông tin hoặc in ra
- `examples/istanbul-to-los-angeles.json` - chuyến đi dự hội nghị lệch 11 tiếng về hướng tây vào tháng 11, kèm theo chuyến bay khứ hồi

## Quy trình thực hiện

### 1. Thu thập thông tin chuyến đi
Hỏi thành phố đi và đến (hoặc múi giờ), ngày và giờ địa phương lúc khởi hành, ngày và giờ địa phương lúc hạ cánh, giờ đi ngủ và thức dậy thường lệ, số ngày họ có thể dịch chuyển lịch sinh hoạt trước chuyến đi (0-3 ngày), thời gian lưu trú bao lâu, và bất kỳ sự kiện quan trọng nào (bài phát biểu, cuộc họp, đám cưới). Đồng thời hỏi xem họ có tình trạng sức khỏe đặc biệt hoặc đang dùng thuốc cần uống đúng giờ nghiêm ngặt hay không; nếu có, hãy thêm lời nhắc lên kế hoạch dùng thuốc với bác sĩ hoặc dược sĩ.

### 2. Chạy trình lập kế hoạch
```
python3 scripts/jetlag_plan.py examples/istanbul-to-los-angeles.json
python3 scripts/jetlag_plan.py --from Europe/Istanbul --to Asia/Tokyo --depart 2026-11-10T01:30 --arrive 2026-11-10T19:05 --bedtime 23:00 --wake 07:00 --pre-days 3 --stay 10
python3 scripts/jetlag_plan.py trip.json --json
python3 scripts/jetlag_plan.py --self-test
```
Nếu thiếu cơ sở dữ liệu múi giờ tz (trên một số bản cài đặt Python cho Windows), hãy sử dụng độ lệch múi giờ như `UTC+3` và `-8`, hoặc chạy `pip install tzdata`. Mã thoát (exit code) bằng 2 có nghĩa là dữ liệu đầu vào không hợp lệ.

### 3. Định hình kế hoạch
Sử dụng tệp `references/trip-strategies.md`: đối với `SHORT_TRIP` (chuyến đi ngắn), hãy khuyến nghị giữ nguyên giờ sinh hoạt như ở nhà; đối với `SMALL_SHIFT` (độ lệch múi giờ nhỏ), không cần kế hoạch đặc biệt. Dời các sự kiện quan trọng vào những khung giờ cơ thể tỉnh táo nhất hoặc đề xuất bay đến sớm hơn. Giải thích các khung giờ tiếp xúc ánh sáng bằng tài liệu `references/body-clock-basics.md` và đưa ra những cách thực tế để áp dụng (đi bộ buổi sáng, ngồi cạnh cửa sổ khi ăn sáng, đeo kính râm trên đường đi làm, giảm độ sáng đèn trong khách sạn).

### 4. Bàn giao kế hoạch
Điền bảng lịch trình và 3-5 hành động quan trọng nhất vào mẫu `templates/jet-lag-plan.md`. Đề nghị hỗ trợ thêm các khung giờ ngủ và tiếp xúc ánh sáng vào lời nhắc trên lịch (calendar).

## Ví dụ kết quả
Đối với tệp `examples/istanbul-to-los-angeles.json` (Istanbul -> Los Angeles vào ngày 2026-11-03, sau khi Hoa Kỳ kết thúc giờ mùa hè DST): lệch -11 giờ, lùi muộn (delay) ở mức khoảng 1,5 giờ/ngày; 2 ngày chuẩn bị trước chuyến đi với giờ đi ngủ lúc 00:30 rồi 01:30; ngủ trên máy bay trong khung giờ ban đêm của LA từ 02:40-07:00; mất khoảng 6 ngày để thích nghi sau khi đến nơi, bắt đầu với giấc ngủ từ 21:30-05:30 và đón ánh sáng mạnh từ 16:30-19:30 vào ngày 0, quay về nhịp ngủ 23:30-07:30 vào ngày thứ 6; chuyến bay chiều về (+11 giờ) được lên kế hoạch theo phương án đi đường vòng dưới dạng lùi muộn 13 giờ, mất khoảng 9 ngày.

## Quy tắc

- Đây là hướng dẫn chăm sóc sức khỏe tổng quát, không phải lời khuyên y tế; tuyệt đối không kê liều lượng melatonin hoặc thuốc ngủ.
- Tôn trọng các ràng buộc cá nhân của người dùng (con nhỏ, giờ làm việc); một kế hoạch từng phần mà họ thực hiện được sẽ tốt hơn một kế hoạch hoàn hảo nhưng bị họ bỏ qua.
- Không bao giờ đề xuất việc nhịn ngủ gây mất an toàn hoặc lái xe khi đang rất buồn ngủ; hãy khuyên họ chợp mắt ngắn hoặc đi taxi thay thế.
- Sử dụng giờ địa phương trong mọi bảng biểu và nêu rõ mỗi phần đang tính theo đồng hồ nào (giờ ở nhà hay giờ tại điểm đến).
FILE:references/body-clock-basics.md
# Kiến Thức Cơ Bản Về Đồng Hồ Sinh Học Cho Người Đi Xa

## Tại sao hiện tượng lệch múi giờ (jet lag) xảy ra
Đồng hồ sinh học của bạn (nhịp sinh học ngày đêm - circadian rhythm) vận hành theo giờ ở nhà và chỉ dịch chuyển từ từ. Sau khi bay qua nhiều múi giờ, cơn buồn ngủ, cảm giác đói, sự tỉnh táo và hệ tiêu hóa vẫn giữ nhịp giờ ở nhà trong nhiều ngày liền. Các triệu chứng điển hình: khó đi vào giấc ngủ hoặc tỉnh giấc lúc 3 giờ sáng, buồn ngủ vào ban ngày, kém tập trung, rối loạn tiêu hóa.

## Đồng hồ sinh học dịch chuyển nhanh đến mức nào
| Hướng bay | Thay đổi đồng hồ | Tốc độ điển hình | Cảm giác thực tế |
|---|---|---|---|
| Hướng Đông (Istanbul -> Tokyo) | đẩy sớm lên (advance) | khoảng 1 giờ mỗi ngày | khó hơn; trằn trọc khó ngủ vào ban đêm |
| Hướng Tây (Istanbul -> Los Angeles) | lùi muộn xuống (delay) | khoảng 1,5 giờ mỗi ngày | dễ hơn; buồn ngủ vào đầu buổi tối, tỉnh giấc lúc 4 giờ sáng |
Đây là các mức trung bình; tuổi tác, tình trạng thiếu ngủ tích lũy, rượu bia và mức độ tiếp xúc ánh sáng sẽ làm thay đổi các con số này.

Đối với các chặng lệch khoảng 10-12 giờ về hướng đông, đồng hồ sinh học thường thích nghi theo kiểu "đi đường vòng" bằng cách lùi muộn lại (ví dụ: lệch +11 giờ hướng đông được chuyển thành lùi muộn -13 giờ với tốc độ 1,5 giờ/ngày = 9 ngày thay vì 11 ngày). Trình lập kế hoạch sẽ chọn phương án nào mất ít ngày hơn.

## Quy tắc ánh sáng
Tín hiệu mạnh nhất đối với đồng hồ sinh học là ánh sáng mạnh. Tác động của nó phụ thuộc vào thời điểm tiếp xúc so với **mức nhiệt độ lõi cơ thể thấp nhất (CBTmin)**, thường rơi vào khoảng 2-3 giờ trước giờ thức dậy thường lệ của bạn (đối với người dậy lúc 07:30, điểm này rơi vào khoảng 04:30 theo giờ cơ thể).
- Ánh sáng trong khoảng ~3 giờ **sau** điểm CBTmin sẽ đẩy đồng hồ sinh học **sớm lên** (advance; cần thiết khi bay về hướng đông).
- Ánh sáng trong khoảng ~3 giờ **trước** điểm CBTmin sẽ kéo đồng hồ sinh học **muộn xuống** (delay; cần thiết khi bay về hướng tây).
- Tiếp xúc ánh sáng sai thời điểm sẽ đẩy đồng hồ sinh học đi ngược hướng mong muốn, đó là lý do kế hoạch cũng liệt kê rõ các khung giờ cần tránh ánh sáng mạnh (đeo kính râm khi ra ngoài, giảm sáng đèn trong nhà, bật chế độ ban đêm trên màn hình).
Vì điểm CBTmin dịch chuyển mỗi ngày nên các khung giờ tiếp xúc ánh sáng cũng dịch chuyển theo. Khi một khung giờ rơi vào lúc đang ngủ, trình lập kế hoạch sẽ dời nó sang thời điểm thức gần nhất.

## Các tín hiệu khác
- **Thời gian ngủ:** tuân thủ khung giờ ngủ trong kế hoạch, ngay cả khi lúc đầu bạn chưa ngủ được; hãy nằm nghỉ ngơi trong bóng tối.
- **Bữa ăn:** ăn theo giờ địa phương ngay từ ngày đầu tiên; một bữa sáng thịnh soạn dưới ánh sáng ban ngày sẽ rất hữu ích khi cần đẩy sớm đồng hồ sinh học.
- **Tập thể dục:** tập thể dục buổi sáng giúp đẩy sớm nhịp sinh học, tập vào đầu buổi tối giúp lùi muộn; tránh tập nặng trong vòng 2 giờ trước khi đi ngủ.
- **Caffeine:** giúp tăng sự tỉnh táo nhưng lưu lại trong cơ thể từ 5-6 giờ (thời gian bán thải); hãy ngừng uống khoảng 8 giờ trước khi đi ngủ.
- **Giấc ngủ ngắn (Naps):** tối đa 20 phút, trước thời điểm "kết thúc ngủ ngắn" trong kế hoạch. Ngủ trưa quá dài sẽ neo giữ cơ thể bạn ở lại múi giờ quê nhà.
- **Rượu bia:** làm giảm chất lượng giấc ngủ và làm trầm trọng thêm tình trạng mất nước; hãy bỏ qua rượu bia trên chuyến bay.
- **Melatonin:** thường được sử dụng cho các chuyến bay về hướng đông, nhưng thời điểm và liều lượng đóng vai trò rất quan trọng và đây được xếp là thuốc tại nhiều quốc gia. Hãy hỏi ý kiến bác sĩ hoặc dược sĩ; trình lập kế hoạch không đưa ra liều dùng.

## Khi nào cần gặp bác sĩ trước chuyến đi
Mang thai, động kinh, rối loạn lưỡng cực (thay đổi ánh sáng và giấc ngủ có thể kích phát đợt bệnh), tiểu đường có tiêm insulin (thời gian ăn và tiêm thuốc khi qua các múi giờ), bệnh tim mạch, ngưng thở khi ngủ, hoặc đang dùng thuốc định kỳ vào các khung giờ cố định (thuốc tránh thai, thuốc chống đông máu, thuốc điều trị động kinh). Hãy lên lịch dùng thuốc cùng với chuyên gia y tế.
FILE:references/trip-strategies.md
# Chiến Lược Theo Chuyến Đi

## Chọn chiến lược theo độ dài chuyến đi và độ lệch múi giờ
| Độ dài chuyến đi | Độ lệch | Chiến lược |
|---|---|---|
| 1-2 ngày | bất kỳ | Giữ nguyên giờ ở nhà. Đặt lịch họp nằm trong khung giờ ban ngày ở nhà, giữ nguyên giờ ngủ ở nhà, kết hợp dùng caffeine và các giấc ngủ ngắn. |
| 3-5 ngày | tối đa 3 giờ | Chuyển sang giờ địa phương ngay khi đến nơi; không cần dịch chuyển giờ ngủ trước chuyến đi. |
| 3-5 ngày | 4+ giờ | Dịch chuyển một phần: chuẩn bị 1-2 ngày trước chuyến đi và áp dụng kế hoạch ánh sáng trong những ngày đầu; chấp nhận một chút mệt mỏi do lệch múi giờ. |
| 6+ ngày | 4+ giờ | Kế hoạch đầy đủ: chuẩn bị 2-3 ngày trước chuyến đi, tuân thủ kế hoạch ánh sáng cho đến khi thích nghi hoàn toàn. |
| Có sự kiện quan trọng vào ngày 1-2 | 6+ giờ | Bay đến sớm hơn nếu có thể (lý tưởng nhất là sớm 1 ngày cho mỗi 1-1,5 giờ chênh lệch), hoặc sắp xếp sự kiện vào khung giờ cơ thể có phong độ tốt nhất. |

## Dịch chuyển giờ giấc trước chuyến đi
Dời giờ đi ngủ và giờ thức dậy 1 tiếng mỗi ngày tiến về phía múi giờ điểm đến trong vòng 1-3 ngày (sớm hơn nếu bay hướng đông, muộn hơn nếu bay hướng tây), kết hợp đón ánh sáng vào các khung giờ "cần tìm ánh sáng" (seek) của trình lập kế hoạch. Chỉ cần dịch chuyển trước 2 tiếng cũng giúp cắt giảm được 1-2 ngày bị jet lag. Hãy dừng lại nếu việc này ảnh hưởng xấu đến công việc hoặc sinh hoạt gia đình; dịch chuyển một phần vẫn hoàn toàn ổn.

## Trên máy bay
- Chỉnh đồng hồ đeo tay và điện thoại sang giờ của điểm đến ngay khi lên máy bay.
- Nếu chuyến bay đi qua khung giờ ban đêm của điểm đến, hãy ngủ vào lúc đó: dùng bịt mắt, nút bịt tai hoặc tai nghe chống ồn, gối kê cổ, không uống rượu bia. Ngược lại, hãy giữ tỉnh táo bằng ánh sáng và chỉ chợp mắt ngắn.
- Uống nước thường xuyên; đi lại và giãn cơ sau mỗi 1-2 giờ.
- Ăn theo khung giờ bữa ăn của điểm đến khi điều kiện cho phép.

## Ngày đến nơi
- Hạ cánh vào buổi tối khi bay về hướng tây: đi ra ngoài đón ánh sáng ban ngày nếu trời vẫn còn sáng, cố gắng thức cho đến giờ đi ngủ theo kế hoạch (có thể chợp mắt 20 phút trước giờ giới hạn).
- Hạ cánh vào buổi sáng khi bay về hướng đông: tuân thủ các khung giờ đón/tránh ánh sáng; nếu bắt buộc phải làm việc, hãy xếp các công việc cần nhiều ánh sáng vào khung giờ đón sáng (seek window).

## Khi trở về nhà
Chuyến bay khứ hồi là một đợt dịch chuyển mới theo chiều ngược lại. Hãy chạy lại trình lập kế hoạch với thông tin chuyến bay về; sắp xếp 1-2 ngày làm việc nhẹ nhàng sau khi hạ cánh nếu có thể.

## Danh sách kiểm tra cho người đi công tác
- [ ] Đã chạy trình lập kế hoạch với giờ bay thực tế
- [ ] Lịch làm việc: không xếp các cuộc họp quan trọng vào khung giờ ban đêm của cơ thể
- [ ] Khách sạn: có rèm cản sáng (blackout curtains) hoặc mang theo bịt mắt; yêu cầu phòng yên tĩnh
- [ ] Ánh sáng: kính râm cho các khung giờ cần tránh sáng, đi bộ ngoài trời hoặc dùng đèn trị liệu (light box) cho các khung giờ cần đón sáng
- [ ] Đã kiểm tra lịch uống thuốc cùng dược sĩ
FILE:templates/jet-lag-plan.md
# Kế Hoạch Giảm Jet Lag - <traveler> - <origin> đến <destination>

**Chuyến bay:** <depart local> -> <arrive local> (<hours> giờ)  **Chênh lệch múi giờ:** <+/- h>  **Chiến lược:** <advance / delay / stay on home time>
**Giờ ngủ thường lệ:** <bedtime>-<wake>  **Dịch chuyển trước chuyến đi:** <h>  **Số ngày dự kiến để thích nghi:** <n>

## Trước chuyến đi
| Ngày | Giấc ngủ | Đón ánh sáng mạnh | Tránh ánh sáng | Ghi chú |
|---|---|---|---|---|
| | | | | |

## Trên chuyến bay
- Ngủ trên máy bay: <times or "stay awake">
- Bữa ăn: <destination times>
- Đã chỉnh đồng hồ sang giờ điểm đến: [ ]

## Tại điểm đến
| Ngày | Giấc ngủ | Đón ánh sáng mạnh | Tránh ánh sáng | Dùng caffeine đến | Ngừng ngủ ngắn trước | Sự kiện chính |
|---|---|---|---|---|---|---|
| | | | | | | |

## Hành lý mang theo
- [ ] Bịt mắt và nút bịt tai  - [ ] Kính râm  - [ ] Bình nước  - [ ] Lịch dùng thuốc (đã kiểm tra với chuyên gia y tế)

## Chuyến về
- Độ lệch: <h>, mất khoảng <n> ngày để thích nghi lại; những ngày làm việc nhẹ nhàng đã lên lịch: <dates>
FILE:examples/istanbul-to-los-angeles.json
{
  "traveler": "conference trip, usual sleep 23:30-07:30",
  "from_tz": "Europe/Istanbul",
  "to_tz": "America/Los_Angeles",
  "depart": "2026-11-03T13:40",
  "arrive": "2026-11-03T17:25",
  "bedtime": "23:30",
  "wake": "07:30",
  "pre_trip_days": 2,
  "stay_days": 8,
  "return_trip": true
}
FILE:scripts/jetlag_plan.py
#!/usr/bin/env python3
"""Jet lag sleep shift planner (Python 3 standard library only).

Input: a trip JSON file (or the same fields as command-line flags):
  {"from_tz": "Europe/Istanbul", "to_tz": "America/Los_Angeles",
   "depart": "2026-11-03T13:40", "arrive": "2026-11-03T17:25",
   "bedtime": "23:30", "wake": "07:30", "pre_trip_days": 2, "stay_days": 8}
Time zones: IANA names (zoneinfo, DST-aware; needs the system tz database or the tzdata
package) or fixed offsets like "UTC+3", "+05:30", "-8".  depart is local time at the origin,
arrive is local time at the destination.

Model (rules of thumb used by sleep clinics, not a medical device):
  - shift = destination offset - origin offset, normalized to -12..+12 h (+ = east).
  - the body clock moves about 1 h/day when advancing (eastward) and 1.5 h/day when
    delaying (westward); for big eastward shifts the planner picks the direction that
    takes fewer days (often delaying "the long way round").
  - optional pre-trip shift: 1 h/day for pre_trip_days, toward the destination.
  - core body temperature minimum (CBTmin) ~3 h before usual wake time. Light in the 3 h
    after CBTmin advances the clock, light in the 3 h before it delays the clock.
  - planned sleep is a compromise: target local bedtime moved toward body time by
    min(2 h, half the remaining gap). Caffeine stops 8 h and naps (max 20 min) end 7 h
    before planned bedtime.
Usage:
  python3 jetlag_plan.py trip.json
  python3 jetlag_plan.py --from Europe/Istanbul --to Asia/Tokyo --depart 2026-11-10T01:30 \
      --arrive 2026-11-10T19:05 --bedtime 23:00 --wake 07:00 --pre-days 3 --stay 10
  python3 jetlag_plan.py trip.json --json
  python3 jetlag_plan.py --self-test
Exit code: 0 OK, 2 bad input.
"""
import argparse
import datetime as dt
import json
import math
import re
import sys

ADVANCE_RATE = 1.0
DELAY_RATE = 1.5


class TripError(ValueError):
    pass


def parse_tz(name):
    s = str(name).strip()
    m = re.fullmatch(r"(?:UTC|GMT)?\s*([+-])(\d{1,2})(?::?(\d{2}))?", s, re.I)
    if m:
        sign = 1 if m.group(1) == "+" else -1
        mins = int(m.group(2)) * 60 + int(m.group(3) or 0)
        if mins > 14 * 60:
            raise TripError(f"offset out of range: {s!r}")
        return dt.timezone(dt.timedelta(minutes=sign * mins), s)
    if s.upper() in ("UTC", "GMT", "Z"):
        return dt.timezone.utc
    try:
        from zoneinfo import ZoneInfo
        return ZoneInfo(s)
    except Exception:
        raise TripError(f"unknown time zone {s!r}; use an IANA name like Europe/Istanbul or an offset like UTC+3")


def parse_hm(s, field):
    m = re.fullmatch(r"(\d{1,2}):(\d{2})", str(s).strip())
    if not m or int(m.group(1)) > 23 or int(m.group(2)) > 59:
        raise TripError(f"{field} must be HH:MM, got {s!r}")
    return int(m.group(1)) * 60 + int(m.group(2))


def parse_local(s, tz, field):
    try:
        t = dt.datetime.fromisoformat(str(s).strip())
    except ValueError:
        raise TripError(f"{field} must be YYYY-MM-DDTHH:MM, got {s!r}")
    if t.tzinfo is not None:
        t = t.replace(tzinfo=None)
    return t.replace(tzinfo=tz)


def hm(mins):
    mins = round(mins) % 1440
    return f"{mins // 60:02d}:{mins % 60:02d}"


def offset_h(t):
    return t.utcoffset().total_seconds() / 3600


def choose_direction(shift):
    """shift in -12..12 (east positive). Return (signed hours to move the body, rate, label)."""
    if shift == 0:
        return 0.0, ADVANCE_RATE, "none"
    if shift > 0:
        adv_days = math.ceil(shift / ADVANCE_RATE)
        alt = shift - 24
        del_days = math.ceil(-alt / DELAY_RATE)
        if del_days < adv_days:
            return alt, DELAY_RATE, "delay (long way round)"
        return shift, ADVANCE_RATE, "advance"
    del_days = math.ceil(-shift / DELAY_RATE)
    alt = shift + 24
    adv_days = math.ceil(alt / ADVANCE_RATE)
    if adv_days < del_days:
        return alt, ADVANCE_RATE, "advance (long way round)"
    return shift, DELAY_RATE, "delay"


def night_overlap(start_utc, end_utc, tz, night_start=22 * 60, night_end=7 * 60):
    """Return list of (start_local, end_local) pieces of the flight inside destination nights."""
    pieces = []
    t = start_utc
    step = dt.timedelta(minutes=5)
    cur = None
    while t < end_utc:
        loc = t.astimezone(tz)
        m = loc.hour * 60 + loc.minute
        is_night = m >= night_start or m < night_end
        if is_night and cur is None:
            cur = loc
        if not is_night and cur is not None:
            pieces.append((cur, loc))
            cur = None
        t += step
    if cur is not None:
        pieces.append((cur, end_utc.astimezone(tz)))
    return pieces


def overlap(a0, a1, b0, b1):
    """Minutes of overlap between [a0, a1) and [b0, b1) on a 24 h circle."""
    best = 0
    for k in (-1440, 0, 1440):
        best += max(0, min(a1, b1 + k) - max(a0, b0 + k))
    return best


def light_windows(cbt, sign, sleep_start, sleep_len):
    """Seek/avoid windows around CBTmin, moved or clipped to waking hours.
    sign > 0 (advance): seek 3 h after CBTmin, avoid 3 h before; sign < 0 (delay): the reverse.
    A seek window that falls into planned sleep moves to the nearest waking edge (after wake
    when advancing, before bedtime when delaying). Avoid windows are clipped to waking time."""
    sleep_end = sleep_start + sleep_len
    if sign > 0:
        seek, avoid = (cbt, cbt + 180), (cbt - 180, cbt)
        if overlap(seek[0], seek[1], sleep_start, sleep_end):
            seek = (sleep_end, sleep_end + 180)
    else:
        seek, avoid = (cbt - 180, cbt), (cbt, cbt + 180)
        if overlap(seek[0], seek[1], sleep_start, sleep_end):
            seek = (sleep_start - 180, sleep_start)
    ov = overlap(avoid[0], avoid[1], sleep_start, sleep_end)
    if ov >= 180:
        avoid_s = "asleep"
    elif ov:
        # keep the waking part of the avoid window
        a0, a1 = avoid
        if overlap(a0, a0 + 1, sleep_start, sleep_end):
            a0 = a1 - (180 - ov)
        else:
            a1 = a0 + (180 - ov)
        avoid_s = f"{hm(a0)}-{hm(a1)}"
    else:
        avoid_s = f"{hm(avoid[0])}-{hm(avoid[1])}"
    return f"{hm(seek[0])}-{hm(seek[1])}", avoid_s


def plan(trip):
    for k in ("from_tz", "to_tz", "depart", "arrive"):
        if not trip.get(k):
            raise TripError(f"missing {k}")
    ftz, ttz = parse_tz(trip["from_tz"]), parse_tz(trip["to_tz"])
    dep = parse_local(trip["depart"], ftz, "depart")
    arr = parse_local(trip["arrive"], ttz, "arrive")
    if arr.astimezone(dt.timezone.utc) <= dep.astimezone(dt.timezone.utc):
        raise TripError("arrive must be after depart (check the dates and time zones)")
    bed = parse_hm(trip.get("bedtime", "23:00"), "bedtime")
    wake = parse_hm(trip.get("wake", "07:00"), "wake")
    sleep_len = (wake - bed) % 1440
    if not 4 * 60 <= sleep_len <= 12 * 60:
        raise TripError("bedtime to wake must be 4-12 hours")
    pre = int(trip.get("pre_trip_days", 0))
    stay = int(trip.get("stay_days", 7))
    if pre < 0 or pre > 4 or stay < 1:
        raise TripError("pre_trip_days must be 0-4 and stay_days at least 1")
    shift = offset_h(arr) - offset_h(dep.astimezone(ftz))
    shift = ((shift + 12) % 24) - 12 if abs(shift) > 12 else shift
    if shift == -12:
        shift = 12.0
    move, rate, direction = choose_direction(shift)
    sign = 1 if move > 0 else -1
    flags = []
    if abs(shift) <= 2:
        flags.append("SMALL_SHIFT: 2 h or less; most people adapt within a day, keep usual habits on local time")
    if stay <= 2 and abs(shift) >= 3:
        flags.append("SHORT_TRIP: 2 days or fewer; consider staying on home time and scheduling meetings inside your home daytime")
    if "long way round" in direction:
        flags.append(f"LONG_WAY_ROUND: a {shift:+g} h shift is planned as {move:+g} h, which usually takes fewer days")
    pre_used = min(pre, int(abs(move))) if move else 0
    pre_days = []
    for i in range(1, pre_used + 1):
        b = bed - sign * 60 * i
        cbt = wake - 180 - sign * 60 * i
        seek_s, avoid_s = light_windows(cbt, sign, b, sleep_len)
        pre_days.append({"day": f"pre {i - pre_used - 1}", "date": str((dep.date() - dt.timedelta(days=pre_used - i + 1))),
                         "sleep": f"{hm(b)}-{hm(b + sleep_len)}", "seek_light": seek_s,
                         "avoid_light": avoid_s, "clock": "home time"})
    body = sign * pre_used  # hours already moved toward destination
    total = abs(move)
    days_needed = math.ceil(max(0.0, total - pre_used) / rate) if move else 0
    days = []
    d = 0
    while True:
        remaining = move - body  # signed hours the body is still away from local time
        gap = abs(remaining)
        comp = min(120, gap * 60 / 2)
        # remaining > 0: body clock is behind local time, so it wants to sleep later (and vice versa)
        b = bed + (comp if remaining > 0 else -comp) if gap else bed
        cbt_local = (wake - 180) + remaining * 60
        if gap < 0.5:
            seek_s, avoid_s = "daylight as usual", "-"
        else:
            seek_s, avoid_s = light_windows(cbt_local, sign, b, sleep_len)
        if remaining > 0:
            status = f"{gap:g} h behind local time"
        elif remaining < 0:
            status = f"{gap:g} h ahead of local time"
        else:
            status = "adjusted"
        days.append({"day": d, "date": str(arr.date() + dt.timedelta(days=d)), "body_clock": status,
                     "sleep": f"{hm(b)}-{hm(b + sleep_len)}", "seek_light": seek_s, "avoid_light": avoid_s,
                     "caffeine_until": hm(b - 480), "naps_end_by": hm(b - 420)})
        if gap == 0 or d + 1 >= stay:
            break
        body = body + sign * min(rate, gap)
        d += 1
    flight_h = (arr.astimezone(dt.timezone.utc) - dep.astimezone(dt.timezone.utc)).total_seconds() / 3600
    nights = night_overlap(dep.astimezone(dt.timezone.utc), arr.astimezone(dt.timezone.utc), ttz)
    nights = [(a, b) for a, b in nights if (b - a).total_seconds() >= 3600]
    if nights:
        inflight = "sleep during destination night: " + "; ".join(f"{a:%a %H:%M}-{b:%H:%M}" for a, b in nights)
    else:
        inflight = "flight is during destination daytime: stay awake, get daylight/screen light, at most a 20-minute nap"
    res = {"from_tz": str(trip["from_tz"]), "to_tz": str(trip["to_tz"]), "shift_h": shift, "plan_move_h": move,
           "direction": direction, "rate_h_per_day": rate, "pre_trip_shift_h": pre_used,
           "days_to_adjust_after_arrival": days_needed, "flight_h": round(flight_h, 2),
           "arrive_local": arr.strftime("%Y-%m-%d %H:%M"), "in_flight": inflight, "flags": flags,
           "pre_trip": pre_days, "days": days}
    if trip.get("return_trip"):
        back, brate, bdir = choose_direction(-shift)
        res["return"] = {"shift_h": -shift, "direction": bdir,
                         "days_to_adjust": math.ceil(abs(back) / brate) if back else 0}
    return res


def to_markdown(r):
    out = [f"# Jet lag plan: {r['from_tz']} -> {r['to_tz']}", "",
           f"- Time difference: {r['shift_h']:+g} h ({'east' if r['shift_h'] > 0 else 'west' if r['shift_h'] < 0 else 'none'}); "
           f"plan: {r['direction']} {abs(r['plan_move_h']):g} h at about {r['rate_h_per_day']:g} h/day",
           f"- Pre-trip shift: {r['pre_trip_shift_h']} h; about {r['days_to_adjust_after_arrival']} day(s) to adjust after arrival",
           f"- Flight: {r['flight_h']:g} h, arriving {r['arrive_local']} local; {r['in_flight']}"]
    if "return" in r:
        out.append(f"- Return trip: {r['return']['shift_h']:+g} h, {r['return']['direction']}, about {r['return']['days_to_adjust']} day(s) to readjust")
    for f in r["flags"]:
        out.append(f"- **{f.split(':')[0]}**:{f.split(':', 1)[1]}")
    if r["pre_trip"]:
        out += ["", "## Before you fly (home time)", "| Day | Date | Sleep | Seek bright light | Avoid bright light |", "|---|---|---|---|---|"]
        for p in r["pre_trip"]:
            out.append(f"| {p['day']} | {p['date']} | {p['sleep']} | {p['seek_light']} | {p['avoid_light']} |")
    out += ["", "## At the destination (local time)",
            "| Day | Date | Body clock | Sleep | Seek bright light | Avoid bright light | Caffeine until | Naps end by |",
            "|---|---|---|---|---|---|---|---|"]
    for d in r["days"]:
        out.append(f"| {d['day']} | {d['date']} | {d['body_clock']} | {d['sleep']} | {d['seek_light']} | {d['avoid_light']} | {d['caffeine_until']} | {d['naps_end_by']} |")
    out += ["", "Light windows that fall inside your sleep time can be skipped; use sunglasses outdoors during 'avoid' windows.",
            "Rules of thumb only. Ask a doctor or pharmacist before using melatonin or sleep medication."]
    return "\n".join(out)


def self_test():
    cases = []

    def ok(name, cond):
        cases.append((name, bool(cond)))

    base = {"from_tz": "Europe/Istanbul", "to_tz": "America/Los_Angeles", "depart": "2026-11-03T13:40",
            "arrive": "2026-11-03T17:25", "bedtime": "23:30", "wake": "07:30", "pre_trip_days": 2, "stay_days": 10}
    ok("fixed offset parse", parse_tz("UTC+3").utcoffset(None) == dt.timedelta(hours=3) and parse_tz("+05:30").utcoffset(None) == dt.timedelta(hours=5, minutes=30))
    ok("negative offset parse", parse_tz("-8").utcoffset(None) == dt.timedelta(hours=-8))
    r = plan(base)
    ok("IST->LA after US DST ends is -11 h", r["shift_h"] == -11)
    ok("westward plan delays", r["direction"] == "delay" and r["plan_move_h"] == -11)
    ok("pre-trip 2 h used", r["pre_trip_shift_h"] == 2 and len(r["pre_trip"]) == 2)
    ok("days to adjust ceil(9/1.5)=6", r["days_to_adjust_after_arrival"] == 6)
    ok("pre-trip bedtime later for westward", r["pre_trip"][0]["sleep"].startswith("00:30") and r["pre_trip"][1]["sleep"].startswith("01:30"))
    ok("day 0 body 9 h ahead", r["days"][0]["body_clock"] == "9 h ahead of local time")
    ok("day 0 compromise bedtime 21:30", r["days"][0]["sleep"] == "21:30-05:30")
    ok("delay: seek light before CBTmin", r["days"][0]["seek_light"] == "16:30-19:30")
    ok("delay: avoid window clipped at bedtime", r["days"][0]["avoid_light"] == "19:30-21:30")
    ok("delay: seek window moved before bedtime", r["days"][3]["seek_light"] == "18:30-21:30" and r["days"][3]["avoid_light"] == "asleep")
    ok("pre-trip delay light in the evening", r["pre_trip"][0]["seek_light"] == "21:30-00:30")
    ok("overlap on circle", overlap(1380, 1500, 0, 60) == 60 and overlap(600, 700, 0, 60) == 0)
    ok("plan ends adjusted", r["days"][-1]["body_clock"] == "adjusted" and r["days"][-1]["sleep"] == "23:30-07:30")
    ok("plan length 7 days (0..6)", len(r["days"]) == 7)
    ok("flight of 14.75 h", r["flight_h"] == 14.75)
    r2 = plan(dict(base, to_tz="America/Los_Angeles", depart="2026-10-20T13:40", arrive="2026-10-20T16:25"))
    ok("IST->LA during US DST is -10 h", r2["shift_h"] == -10)
    r3 = plan(dict(base, to_tz="Asia/Tokyo", depart="2026-11-10T01:30", arrive="2026-11-10T19:05", pre_trip_days=3))
    ok("IST->Tokyo +6 advance", r3["shift_h"] == 6 and r3["direction"] == "advance" and r3["days_to_adjust_after_arrival"] == 3)
    ok("advance: seek light moved to after wake", r3["days"][0]["seek_light"] == "09:00-12:00" and r3["days"][0]["avoid_light"] == "asleep")
    ok("pre-trip bedtime earlier for eastward", r3["pre_trip"][0]["sleep"].startswith("22:30"))
    ok("+11 east goes long way round", choose_direction(11) == (-13, DELAY_RATE, "delay (long way round)"))
    ok("+9 east stays advance", choose_direction(9)[2] == "advance")
    ok("-12 normalized to +12 then delay -12", choose_direction(12)[0] == -12)
    r4 = plan(dict(base, to_tz="Europe/Berlin", depart="2026-11-03T08:00", arrive="2026-11-03T09:00", stay_days=2))
    ok("small shift flag", any(f.startswith("SMALL_SHIFT") for f in r4["flags"]))
    r5 = plan(dict(base, stay_days=2))
    ok("short trip flag", any(f.startswith("SHORT_TRIP") for f in r5["flags"]) and len(r5["days"]) == 2)
    ok("in-flight sleep in LA night 02:40-07:00", r["in_flight"].endswith("Tue 02:40-07:00"))
    ok("Tokyo daytime flight: stay awake", "destination daytime" in r3["in_flight"])
    ok("caffeine 8 h before bed", r["days"][-1]["caffeine_until"] == "15:30" and r["days"][-1]["naps_end_by"] == "16:30")
    for bad, label in ((dict(base, to_tz="Mars/Olympus"), "unknown tz rejected"), (dict(base, bedtime="25:00"), "bad bedtime rejected"),
                       (dict(base, arrive="2026-11-02T10:00"), "arrival before departure rejected"), (dict(base, pre_trip_days=9), "pre-trip >4 rejected")):
        try:
            plan(bad)
            ok(label, False)
        except TripError:
            ok(label, True)
    ok("hm wraps midnight", hm(-30) == "23:30" and hm(1500) == "01:00")
    passed = sum(c for _, c in cases)
    for name, c in cases:
        print(("PASS " if c else "FAIL ") + name)
    print(f"{passed}/{len(cases)} passed")
    return 0 if passed == len(cases) else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="Plan sleep and light timing to beat jet lag.")
    ap.add_argument("file", nargs="?", help="trip JSON")
    ap.add_argument("--from", dest="from_tz")
    ap.add_argument("--to", dest="to_tz")
    ap.add_argument("--depart")
    ap.add_argument("--arrive")
    ap.add_argument("--bedtime")
    ap.add_argument("--wake")
    ap.add_argument("--pre-days", type=int, dest="pre_trip_days")
    ap.add_argument("--stay", type=int, dest="stay_days")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    try:
        trip = json.load(open(a.file, encoding="utf-8")) if a.file else {}
        for k in ("from_tz", "to_tz", "depart", "arrive", "bedtime", "wake", "pre_trip_days", "stay_days"):
            if getattr(a, k) is not None:
                trip[k] = getattr(a, k)
        r = plan(trip)
    except (OSError, TripError, ValueError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(r, indent=2) if a.json else to_markdown(r))
    return 0


if __name__ == "__main__":
sys.exit(main())Các quy ước định kiến cho việc thiết kế lược đồ (schema), đánh chỉ mục (indexing), truy vấn và vận hành trong PostgreSQL.
# Phong cách (taste) sử dụng PostgreSQL của một kỹ sư Backend
- Sử dụng cột định danh kiểu bigint (GENERATED ALWAYS AS IDENTITY) cho khóa chính (primary key); chỉ dùng đến UUIDv7 khi định danh (id) bắt buộc phải được tạo bên ngoài cơ sở dữ liệu. Độ tin cậy: 0.80
- Lưu trữ dấu thời gian dưới dạng timestamptz theo múi giờ UTC, tuyệt đối không dùng timestamp without time zone. Độ tin cậy: 0.95
- Sử dụng kiểu text kết hợp với ràng buộc CHECK thay vì varchar(n) để giới hạn độ dài chuỗi. Độ tin cậy: 0.80
- Lưu trữ tiền tệ dưới dạng kiểu numeric hoặc kiểu số nguyên tính theo đơn vị tiền tệ nhỏ nhất (minor units), tuyệt đối không dùng kiểu số thực dấu phẩy động (float). Độ tin cậy: 0.95
- Đặt tên bảng ở dạng số nhiều theo quy tắc snake_case và đặt tên khóa ngoại (foreign key) theo định dạng <singular>_id. Độ tin cậy: 0.70
- Khai báo NOT NULL theo mặc định và chỉ cho phép NULL khi "chưa xác định" (unknown) là một trạng thái thực tế có thật. Độ tin cậy: 0.85
- Thực thi các quy tắc bất biến (invariants) ngay trong cơ sở dữ liệu bằng khóa ngoại (foreign keys), ràng buộc UNIQUE và CHECK, chứ không chỉ kiểm tra trong mã nguồn ứng dụng. Độ tin cậy: 0.90
- Đánh chỉ mục (index) cho mọi cột khóa ngoại được sử dụng trong các phép nối (join) hoặc xóa dây chuyền (cascading delete). Độ tin cậy: 0.85
- Đọc kết quả EXPLAIN (ANALYZE, BUFFERS) trước khi thêm một chỉ mục, và đọc lại lần nữa sau khi thêm để chứng minh rằng chỉ mục đó thực sự mang lại hiệu quả. Độ tin cậy: 0.90
- Ưu tiên chỉ mục từng phần (partial index) và chỉ mục biểu thức (expression index) hơn là các chỉ mục phức hợp (composite index) trải rộng đối với các bộ lọc có phân phối dữ liệu lệch (skewed filters). Độ tin cậy: 0.70
- Tạo chỉ mục trên các bảng lớn bằng câu lệnh CREATE INDEX CONCURRENTLY. Độ tin cậy: 0.90
- Sử dụng kiểu jsonb cho các thuộc tính thực sự không có lược đồ cố định (schemaless), nhưng hãy tách các trường mà bạn thường xuyên lọc ra thành những cột thực thụ. Độ tin cậy: 0.80
- Phân trang bằng phương pháp tập khóa keyset (WHERE id > $last ORDER BY id LIMIT n) thay vì dùng giá trị OFFSET lớn. Độ tin cậy: 0.85
- Giữ các giao dịch (transactions) diễn ra ngắn gọn và tuyệt đối không giữ một giao dịch mở trong suốt quá trình gọi mạng (network call). Độ tin cậy: 0.90
- Thiết lập tham số statement_timeout và idle_in_transaction_session_timeout cho từng vai trò (role) của ứng dụng. Độ tin cậy: 0.85
- Đặt một bộ điều phối kết nối (connection pooler) chẳng hạn như PgBouncer ở chế độ giao dịch (transaction mode) đứng trước cơ sở dữ liệu. Độ tin cậy: 0.80
- Sử dụng cú pháp SELECT ... FOR UPDATE SKIP LOCKED cho các hàng đợi công việc (job queues) đơn giản trước khi quyết định thêm một hệ thống message broker riêng biệt. Độ tin cậy: 0.70
- Sử dụng cú pháp INSERT ... ON CONFLICT cho các thao tác thêm mới hoặc cập nhật (upsert) có tính lũy đẳng (idempotent). Độ tin cậy: 0.85
- Cấp cho mỗi dịch vụ một vai trò (role) riêng với đặc quyền tối thiểu (least privilege); ứng dụng tuyệt đối không bao giờ kết nối dưới quyền siêu người dùng (superuser). Độ tin cậy: 0.90
- Bật tiện ích mở rộng pg_stat_statements và rà soát các truy vấn chậm nhất mỗi tuần. Độ tin cậy: 0.85
- Viết các biểu thức bảng chung (CTEs) để mã dễ đọc hơn, với lưu ý rằng Postgres 12+ sẽ tự động nội tuyến (inline) chúng trừ khi bạn thêm từ khóa MATERIALIZED. Độ tin cậy: 0.65
- Kiểm thử khả năng khôi phục tại một thời điểm (point-in-time recovery) từ các bản sao lưu một cách định kỳ; một bản sao lưu chưa từng được kiểm thử coi như không có giá trị. Độ tin cậy: 0.95
Các ưu tiên mang tính định kiến nhằm giúp trang web tải nhanh và duy trì khả năng phản hồi mượt mà cho người dùng thực tế.
# Phong cách (taste) tối ưu hiệu năng Web của một kỹ sư Frontend
- Đo lường các chỉ số Core Web Vitals (LCP, INP, CLS) từ người dùng thực tế, chứ không chỉ dựa vào các lần chạy Lighthouse trong môi trường thử nghiệm (lab). Độ tin cậy: 0.90
- Thiết lập ngân sách hiệu năng (performance budget) cho dung lượng JavaScript và chỉ số LCP, đồng thời cho dừng lỗi CI khi có thay đổi vượt quá giới hạn đó. Độ tin cậy: 0.80
- Kết xuất (render) khung nhìn đầu tiên trên máy chủ hoặc dưới dạng tĩnh; không phân phối một trang trắng phải chờ tải xong JavaScript. Độ tin cậy: 0.90
- Giảm lượng mã JavaScript gửi đi trước khi tối ưu hóa số JavaScript mà bạn gửi. Độ tin cậy: 0.90
- Chia nhỏ mã (code splitting) theo từng tuyến đường (route) và tải trễ (lazy-load) các thành phần nặng như trình soạn thảo, biểu đồ và bản đồ. Độ tin cậy: 0.85
- Kiểm tra bằng công cụ phân tích gói mã (bundle analyzer) trước khi thêm một thư viện phụ thuộc, và ưu tiên các thư viện nhỏ gọn, hỗ trợ loại bỏ mã thừa (tree-shakable). Độ tin cậy: 0.80
- Phân phối hình ảnh ở định dạng AVIF hoặc WebP với thuộc tính srcset đáp ứng (responsive) cùng chiều rộng (width) và chiều cao (height) tường minh. Độ tin cậy: 0.90
- Đánh dấu hình ảnh LCP bằng thuộc tính fetchpriority="high" và tuyệt đối không tải trễ (lazy-load) nó. Độ tin cậy: 0.85
- Tải trễ các hình ảnh và thẻ iframe nằm bên dưới màn hình đầu tiên (below-the-fold) bằng thuộc tính loading="lazy". Độ tin cậy: 0.85
- Tự lưu trữ (self-host) phông chữ, rút gọn bộ ký tự (subset), tải trước (preload) phông chữ chính và sử dụng thuộc tính font-display: swap. Độ tin cậy: 0.80
- Dành sẵn không gian trống cho quảng cáo, nội dung nhúng và nội dung tải muộn để bố cục trang không bị xê dịch. Độ tin cậy: 0.85
- Chia nhỏ các tác vụ kéo dài trên 50 ms và nhường quyền xử lý lại cho luồng chính (main thread) để giữ chỉ số INP ở mức thấp. Độ tin cậy: 0.80
- Tải các tập lệnh của bên thứ ba bằng thuộc tính defer hoặc sau khi có tương tác của người dùng, đồng thời kiểm tra giá trị thực sự của từng tập lệnh. Độ tin cậy: 0.85
- Lưu bộ nhớ đệm (cache) cho các tài sản tĩnh đã gắn mã băm (hashed) với tiêu đề Cache-Control: immutable trong thời hạn một năm. Độ tin cậy: 0.90
- Phân phối mọi tài nguyên qua giao thức HTTP/2 hoặc HTTP/3 từ mạng phân phối nội dung (CDN) có bật nén Brotli. Độ tin cậy: 0.85
- Chỉ khởi tạo kết nối trước (preconnect) tới một hoặc hai nguồn (origin) thực sự cần thiết cho lần kết xuất đầu tiên. Độ tin cậy: 0.70
- Nhúng trực tiếp (inline) phần CSS quan trọng (critical CSS) cho khung nhìn đầu tiên và tải phần còn lại mà không chặn quá trình kết xuất. Độ tin cậy: 0.65
- Ảo hóa (virtualize) các danh sách dài thay vì kết xuất hàng nghìn nút DOM cùng lúc. Độ tin cậy: 0.80
- Chỉ tạo hoạt ảnh (animate) trên hai thuộc tính transform và opacity, đồng thời tôn trọng tùy chọn prefers-reduced-motion của người dùng. Độ tin cậy: 0.85
- Tránh gây tính toán lại bố cục liên tục (layout thrashing): gom nhóm các thao tác đọc DOM trước khi thực hiện các thao tác ghi DOM. Độ tin cậy: 0.75
- Kiểm thử trên điện thoại Android tầm trung với mạng bị bóp băng thông (throttled), chứ không chỉ thử nghiệm trên máy tính xách tay của lập trình viên. Độ tin cậy: 0.90
- Xem sự suy giảm hiệu năng (performance regression) giống như một lỗi phần mềm (bug), cần có người chịu trách nhiệm và ngày ấn định khắc phục. Độ tin cậy: 0.80
Các quy ước định kiến để viết kịch bản Bash an toàn, dễ đọc và dễ bảo trì.
# Phong cách (taste) viết kịch bản Shell của một kỹ sư DevOps
- Bắt đầu mọi kịch bản với #!/usr/bin/env bash và set -euo pipefail. Độ tin cậy: 0.90
- Chuyển sang sử dụng Python hoặc Go một khi kịch bản vượt quá khoảng 100 dòng hoặc cần đến các cấu trúc dữ liệu thực thụ. Độ tin cậy: 0.85
- Chạy ShellCheck trong CI và sửa các cảnh báo thay vì tắt chúng đi. Độ tin cậy: 0.95
- Định dạng kịch bản bằng shfmt để các bản so sánh thay đổi (diff) luôn nhỏ gọn. Độ tin cậy: 0.75
- Đặt mọi biến khi khai triển trong dấu ngoặc kép ("$var") trừ khi việc tách từ (word splitting) là có chủ đích và đã được chú thích rõ. Độ tin cậy: 0.95
- Sử dụng [[ ]] cho các phép kiểm tra điều kiện và $(...) để thay thế lệnh, tuyệt đối không dùng dấu huyền (` `). Độ tin cậy: 0.90
- Khai báo các biến bên trong hàm bằng từ khóa local. Độ tin cậy: 0.85
- Đặt phần xử lý logic vào trong các hàm và gọi hàm main "$@" ở cuối tệp. Độ tin cậy: 0.80
- Dọn dẹp các tệp tạm bằng mktemp và bẫy sự kiện trap '...' EXIT. Độ tin cậy: 0.90
- Ghi các lỗi và nhật ký (log) ra luồng stderr và giữ luồng stdout dành riêng cho dữ liệu để các công cụ khác có thể nối ống (pipe). Độ tin cậy: 0.85
- Thoát chương trình với mã trạng thái khác không (non-zero) cùng thông báo rõ ràng khi có lỗi xảy ra. Độ tin cậy: 0.90
- Cung cấp hàm hướng dẫn sử dụng (usage) và xử lý các cờ -h cũng như --help. Độ tin cậy: 0.80
- Phân tích cú pháp các tùy chọn bằng getopts hoặc vòng lặp case đơn giản, không kiểm tra tham số vị trí một cách tùy tiện. Độ tin cậy: 0.75
- Kiểm tra trước các lệnh bắt buộc phải có bằng command -v và báo lỗi dừng sớm ngay khi thiếu một lệnh. Độ tin cậy: 0.85
- Đọc cấu hình từ các biến môi trường kèm theo giá trị mặc định, chẳng hạn như -8080. Độ tin cậy: 0.80
- Không bao giờ phân tích cú pháp (parse) đầu ra của lệnh ls; hãy dùng mẫu glob hoặc find -print0 kết hợp với xargs -0. Độ tin cậy: 0.90
- Đọc tệp từng dòng một bằng cú pháp while IFS= read -r line. Độ tin cậy: 0.85
- Sử dụng mảng (array) cho danh sách đối số thay vì ghép nối các chuỗi lệnh. Độ tin cậy: 0.85
- Tránh sử dụng eval, và tuyệt đối không truyền dữ liệu đầu vào không đáng tin cậy vào đó. Độ tin cậy: 0.95
- Thiết kế các kịch bản có tính lũy đẳng (idempotent) để việc chạy chúng hai lần vẫn đảm bảo an toàn. Độ tin cậy: 0.85
- Thêm cờ --dry-run vào bất kỳ tác vụ nào thực hiện xóa hoặc thay đổi trạng thái từ xa. Độ tin cậy: 0.80
- Chỉ bó buộc trong chuẩn POSIX sh khi kịch bản bắt buộc phải chạy trong các container tối giản; còn lại hãy nhắm tới mục tiêu bash 4+. Độ tin cậy: 0.70Hướng dẫn người mới bắt đầu ủ phân tại nhà không bị hôi hay thu hút côn trùng, sâu bọ: so sánh các phương pháp (thùng ủ, đống ủ, thùng quay, thùng nuôi trùn quế, bokashi), các bước thiết lập, hướng dẫn nguyên liệu xanh và nâu, thói quen dùng thùng rác nhỏ trong bếp, quy trình hàng tuần, kế hoạch theo mùa, xử lý sự cố, mẹo thu hoạch và nhật ký theo dõi tiến độ.
Hãy đóng vai một Huấn Luyện Viên Ủ Phân Hữu Cơ Tại Nhà. Bạn giúp những người chưa từng ủ phân, hoặc những người mà lần thử trước đó đã biến thành một cái thùng bốc mùi và nhớp nháp, thiết lập một hệ thống đơn giản phù hợp với ngôi nhà của họ và duy trì hoạt động hiệu quả qua các mùa. Bạn là người thực tế và kiên nhẫn: bạn chọn phương pháp phù hợp với không gian, thời gian và lượng rác nhà bếp thực tế của họ, giải thích lý do đằng sau sự cân bằng giữa nguyên liệu xanh và nguyên liệu nâu bằng ngôn từ dễ hiểu, đồng thời bình tĩnh khắc phục sự cố thay vì đổ lỗi cho người ủ phân. Bạn tuân thủ các quy định địa phương về những gì có thể ủ và ủ ở đâu, bạn không bao giờ đề xuất ủ thịt, sản phẩm từ sữa hoặc chất thải thú cưng trong đống ủ lạnh tại nhà, và bạn hướng dẫn mọi người đến dịch vụ thu gom rác thực phẩm của thành phố khi việc tự ủ phân tại nhà không khả thi.

Tình huống của tôi:
- Loại hình nhà ở và không gian ngoài trời: terraced house with a small back garden
- Khí hậu và các mùa: temperate, cold wet winters, warm summers
- Quy mô hộ gia đình và lượng rác nhà bếp hàng tuần: two adults, lots of vegetable peels and coffee grounds
- Sân vườn hoặc nguồn nguyên liệu nâu sẵn có: a few leaves in autumn, cardboard from deliveries
- Thời gian tôi có thể dành ra mỗi tuần: about 15 minutes
- Mục đích tôi muốn sử dụng phân ủ: vegetable beds and pots
- Nỗi lo chính: smell, flies, and rats

Trước tiên, hãy hỏi tôi trong một tin nhắn ngắn gọn về bất kỳ thông tin quan trọng nào còn thiếu: tôi đang thuê nhà hay sở hữu nhà (và bất kỳ quy định nào của chủ nhà hoặc chính quyền địa phương), tôi chỉ có ban công hay có sân vườn, thú cưng hoặc trẻ nhỏ có thể tiếp cận thùng ủ hay không, mức chi phí tôi sẵn sàng chi trả, và liệu tôi có muốn dùng thùng nuôi trùn quế hoặc ủ bokashi trong nhà hay không.

Sau đó, hãy hướng dẫn tôi qua các phần sau:

1. **Lựa Chọn Phương Pháp Phù Hợp**: so sánh ba đến bốn phương pháp phù hợp (thùng ủ kín, đống ủ hở, thùng ủ quay, thùng nuôi trùn quế, ủ bokashi kết hợp chôn đất, dịch vụ thu gom của địa phương) trong một bảng gồm không gian cần thiết, khoảng chi phí, công sức mỗi tuần, thời gian để có thành phẩm, những thứ có thể và không thể cho vào, cùng nguy cơ thu hút sâu bọ/động vật gây hại. Đề xuất một phương pháp chính và một phương pháp dự phòng cho tình huống của tôi, kèm theo lý do.

2. **Các Bước Thiết Lập**: vị trí đặt thùng ủ (ánh nắng, thoát nước, khoảng cách tới nhà và hàng rào, lối tiếp cận vào mùa đông), những gì cần lót ở lớp đáy, và quy trình trong tuần đầu tiên bằng các bước đánh số ngắn gọn.

3. **Hướng Dẫn Nguyên Liệu Xanh và Nâu**: danh sách hai cột gồm các nguyên liệu xanh (giàu đạm) và nguyên liệu nâu (giàu carbon) phổ biến trong gia đình, quy tắc tỷ lệ đơn giản (tính theo thể tích, không tính theo trọng lượng), danh sách "tuyệt đối không cho vào" kèm lý do, và danh sách "có thể cho vào nhưng cần lưu ý" (họ cam quýt, hành tây, bánh mì, bao bì có thể phân hủy sinh học, cỏ dại có hạt).

4. **Thói Quen Thu Gom Trong Bếp**: kích thước thùng đựng rác hữu cơ nhỏ trong bếp (caddy), cách lót thùng, tần suất đổ rác, và cách ngăn chặn ruồi giấm cũng như mùi hôi trong nhà.

5. **Quy Trình Hàng Tuần**: danh sách kiểm tra từ 10 đến 15 phút: thêm rác hữu cơ, phủ lớp nguyên liệu nâu, kiểm tra độ ẩm bằng bài kiểm tra nắm tay, đảo trộn hoặc làm thoáng khí, và ghi chú những gì tôi đã thêm vào.

6. **Kế Hoạch Theo Mùa**: những thay đổi trong nắng nóng mùa hè, mùa lá rụng vào mùa thu (cách tích trữ đống lá khô để dùng dần), sự chậm lại vào mùa đông, và khởi động lại vào mùa xuân, bao gồm cả cách giữ ấm cách nhiệt cho thùng ủ khi có sương giá.

7. **Bảng Xử Lý Sự Cố**: triệu chứng, nguyên nhân có thể xảy ra, cách khắc phục cho ít nhất tám vấn đề: mùi hôi khó chịu, nhớp nháp và ướt sũng, khô khốc và không phân hủy, ruồi nhặng, kiến, chuột lớn hoặc chuột nhắt, hạt nảy mầm, nấm mốc trắng, trùn bò ra ngoài (đối với thùng nuôi trùn quế).

8. **Thu Hoạch và Sử Dụng**: cách nhận biết phân ủ đã chín hoàn toàn (hình thức, mùi, cảm giác khi chạm vào, nhiệt độ), cách sàng lọc và ủ ổn định (cure), cách sử dụng cho luống cây và chậu trồng, cũng như tỷ lệ pha trộn với đất trồng chậu.

9. **Nhật Ký Tiến Độ**: một mẫu biểu đơn giản để theo dõi ngày tháng, nguyên liệu đã cho vào, độ ẩm, mùi, việc đảo trộn, nhiệt độ (nếu có đo) và ghi chú.

Quy tắc: sử dụng ngôn ngữ bình dân dễ hiểu, đoạn văn và danh sách ngắn gọn, dùng hệ đo lường mét trừ khi tôi có yêu cầu khác, và ưu tiên các lựa chọn chi phí thấp hoặc miễn phí trước (tái sử dụng vật chứa, thu gom nguyên liệu nâu miễn phí). Kết thúc bằng một câu khích lệ và bước đầu tiên duy nhất mà tôi nên thực hiện ngay trong tuần này.
Chuyển đổi thực đơn và ghi chú công thức của quán cà phê hoặc nhà hàng thành một gói thông tin dị ứng chuẩn JSON nghiêm ngặt: ma trận món ăn theo chất gây dị ứng không bao giờ đoán mò là 'không chứa', các nguồn gây dị ứng tiềm ẩn, rủi ro nhiễm chéo từ nồi chiên và thớt dùng chung, câu hỏi cho nhà cung cấp, biện pháp kiểm soát trong bếp, kịch bản trả lời của nhân viên và các phương án thay thế an toàn.
1{2 "role": "Chuyên gia tư vấn an toàn thực phẩm chuyên xây dựng thông tin chất gây dị ứng rõ ràng, có thể kiểm toán cho các nhà hàng và quán cà phê nhỏ",3 "task": "Chuyển đổi thực đơn và ghi chú công thức của tôi thành một gói thông tin chất gây dị ứng chuẩn JSON nghiêm ngặt duy nhất: ma trận món ăn theo chất gây dị ứng chỉ dựa trên các nguyên liệu tôi liệt kê, cảnh báo chất gây dị ứng tiềm ẩn, rủi ro nhiễm chéo trong bếp của tôi, các câu hỏi mở cho nhà cung cấp, kịch bản trả lời của nhân viên và ý tưởng thay thế nguyên liệu an toàn. Không bao giờ đoán mò rằng một món ăn không chứa chất gây dị ứng.",4 "context": {5 "venue": "${venue:small neighborhood cafe with an open kitchen}",6 "region_and_rules": "${region:European Union, 14 regulated allergens}",7 "menu_and_recipes": "${menu:paste each dish with its full ingredient list, sauces, garnishes, and frying oil}",8 "supplier_products": "${suppliers:list branded products such as stock cubes, bread, sauces, spice mixes, with label notes if known}",9 "kitchen_setup": "${kitchen:one shared fryer, one grill, shared chopping boards, separate gluten-free toaster}",10 "goal": "${goal:printable allergen chart for customers and a staff briefing sheet}"...+110 dòng nữa
Biến các ghi chú rời rạc thành một bảng bàn giao định dạng YAML dành cho người trông nhà hoặc chăm sóc thú cưng: lịch trình hàng ngày theo khung giờ, việc cho ăn và uống thuốc của thú cưng, các dấu hiệu cần gọi bác sĩ thú y ngay, cây cảnh, hệ thống trong nhà, khóa cửa, đổ rác, tình huống khẩn cấp, vị trí để các vật dụng thiết yếu, danh bạ liên hệ và nhật ký hàng ngày, đồng thời giữ các thông tin mật tách biệt khỏi bảng bàn giao.
1role: Người điều phối chăm sóc nhà cửa và thú cưng điềm tĩnh, tỉ mỉ2task: >3 Biến các ghi chú rời rạc của tôi thành một bảng bàn giao hoàn chỉnh, dễ đọc lướt dưới dạng YAML dành cho4 người trông nhà hoặc người chăm sóc thú cưng sẽ ở lại hoặc ghé qua nhà tôi trong thời gian tôi đi vắng: lịch sinh hoạt5 hàng ngày, chăm sóc thú cưng, cây cảnh, hệ thống trong nhà, an ninh, tình huống khẩn cấp và danh bạ liên hệ, được viết sao cho6 một người chưa từng đến nhà tôi bao giờ cũng có thể làm theo mà không cần phải gọi hỏi tôi.78inputs:9 trip_dates: ${dates:Friday 14:00 to the following Sunday 20:00}10 sitter_arrangement: ${arrangement:sitter stays overnight, works from home during the day}...+86 dòng nữa
Tấm gỗ khảm trang trí (marquetry) khắc họa bảy chiếc khinh khí cầu bay trên những ngọn đồi trập trùng lúc bình minh, được ghép từ các lớp gỗ lạng (veneer) phong, satinwood, dáng hương (padauk), óc chó và mun, cùng những cánh đồng ghép mảnh, hàng cây bạch dương, dòng sông gỗ sung dâu (sycamore), nửa vầng mặt trời bằng gỗ nu (burl), các đường ghép mảnh sắc nét như sợi tóc, đường viền kẻ dải và lớp hoàn thiện đánh bóng kiểu Pháp ánh lụa.
Một tấm gỗ khảm trang trí (marquetry) khổ rộng được làm hoàn toàn từ các miếng gỗ lạng (wood veneers) khảm ghép vào nhau, khắc họa cảnh bảy chiếc khinh khí cầu đang trôi lững lờ trên những ngọn đồi thoai thoải lúc bình minh. Mỗi chiếc khinh khí cầu được ghép từ các dải gỗ lạng có màu sắc tương phản: gỗ phong nhạt (pale maple), gỗ satinwood ánh vàng, gỗ sồi màu mật ong, gỗ dáng hương (padauk) ánh đỏ, gỗ óc chó sẫm (dark walnut) và gỗ mun gần như đen tuyền, được xếp thành các múi cong nổi bật với những chiếc giỏ mây nhỏ xíu bên dưới. Những ngọn đồi tạo thành các dải xếp lớp mềm mại từ gỗ tần bì màu ô liu (olive ash), gỗ anh đào ấm áp và gỗ sồi xám khói, điểm xuyết những cánh đồng nhỏ ghép mảnh như tấm chăn chắp vá, một hàng cây bạch dương (poplar), một dòng sông uốn lượn cắt từ gỗ sung dâu (sycamore) ánh bạc và một ngôi nhà nông trại nhỏ bằng đá có mái đỏ. Nửa vầng mặt trời lớn làm từ gỗ nu (burl veneer) với các vân tỏa tròn nhô lên phía sau dãy đồi xa, còn bầu trời được ghép từ những dải dài uốn lượn của gỗ bạch dương nhạt (pale birch) và gỗ lacewood sáng màu với thớ gỗ tự nhiên hiện rõ. Mọi mảnh ghép tiếp giáp nhau dọc theo những đường nối sắc nét mảnh như sợi tóc, hướng vân gỗ thay đổi giữa các mảng hình khối nhằm gợi tả ánh sáng và sự chuyển động, cùng một đường viền mỏng gồm các dải sáng tối xen kẽ đóng khung toàn bộ tấm gỗ. Bề mặt hoàn thiện đánh bóng kiểu Pháp (French-polish) mịn như lụa với ánh sắc ấm áp dịu nhẹ, được chiếu bởi nguồn sáng xiên nhẹ làm nổi bật kết cấu thớ gỗ. Bầu không khí yên bình, tươi vui, đậm chất thủ công tinh xảo. Khung hình ngang rộng 16:9. Không có người, không có chữ, không chữ cái, không logo.
Tấm sơn mài maki-e Nhật Bản chủ đề ngắm trăng mùa thu: hai chú thỏ khảm xà cừ trắng giữa đám cỏ lau bạc dưới vầng trăng lớn bằng bột vàng trên nền sơn mài urushi đen thẫm, điểm xuyết cỏ ba lá bụi (bush clover), lá phong rơi, các vảy vàng rải rác và một đường dòng chảy bằng bụi vàng uốn lượn.
Một tấm sơn mài maki-e Nhật Bản khổ rộng khắc họa hai chú thỏ trắng đang ngồi giữa đám cỏ lau (pampas grass) màu bạc dưới vầng trăng tròn lớn của mùa thu. Phần nền là lớp sơn mài urushi màu đen bóng sâu thẳm có độ sâu phẳng lặng như gương. Mặt trăng là một đĩa tròn lớn phủ bột vàng dịu mắt với bề mặt hơi lốm đốm tự nhiên, đặt ở góc trên bên phải. Hai chú thỏ được tạo tác bằng kỹ thuật đắp nổi takamaki màu trắng ngọc trai kết hợp khảm xà cừ ánh sắc cầu vồng phớt nhẹ, một chú ngước nhìn lên mặt trăng và một chú đang nhấm nháp ngọn cỏ. Những bông cỏ lau dài uốn cong trải rộng khắp nửa dưới khung hình bằng bột bạc và vàng nhạt rắc mịn, xen lẫn vài nhành cỏ hồ chi (bush clover) điểm những bông hoa nhỏ xíu bằng sơn mài đỏ cùng hai hoặc ba chiếc lá phong đang rơi mang sắc vàng đỏ. Những vảy vàng nashiji rải rác lấp lánh khắp phần nền đen phía dưới tựa như giọt sương đêm, và một đường dòng suối mảnh mai bằng bụi vàng uốn lượn dọc theo mép dưới cùng. Chi tiết nét cọ mảnh như sợi tóc, sự chuyển sắc tinh tế từ lớp vàng dày đặc sang thưa dần, trông như một bức ảnh chụp bảo tàng ghi lại nắp hộp sơn mài đánh bóng được chiếu sáng bởi ánh đèn studio dịu nhẹ tạo bóng phản chiếu tinh tế. Bầu không khí ngắm trăng mùa thu tĩnh lặng, thanh nhã. Khung hình ngang rộng 16:9. Không có chữ, không thư pháp, không chữ ký, không con dấu, không logo.
Bức ảnh chụp động vật hoang dã bằng ống kính tele chân thực ghi lại đàn chim hải âu cổ rụt Đại Tây Dương (Atlantic puffins) trên vách đá biển phủ cỏ với hoa cẩm chướng biển màu hồng vào giờ vàng, một con đang ngậm cá chình cát, nhiều con khác ở gần cửa hang và đang bay lượn, vách đá sẫm màu, sóng vỗ trắng xóa quanh hai cột đá biển, và làn sương biển dịu nhẹ nơi đường chân trời.
Một bức ảnh chụp động vật hoang dã chân thực (photoreal) ghi lại một đàn nhỏ chim hải âu cổ rụt Đại Tây Dương đang đứng trên rìa vách đá biển phủ cỏ trong ánh nắng chiều ấm áp, với vùng biển Bắc Đại Tây Dương bao la tít sâu bên dưới. Ở tiền cảnh, bốn chú chim hải âu cổ rụt đứng trên một bụi cỏ xanh và hoa cẩm chướng biển (sea thrift) màu hồng; chiếc mỏ sọc đỏ cam rực rỡ và xám đá phiến, khuôn mặt trắng, lưng đen và đôi chân màu cam của chúng hiện lên sắc nét và chi tiết; một chú chim đang ngậm một hàng cá chình cát nhỏ màu bạc ngang mỏ. Phía sau chúng, đỉnh vách đá uốn cong xa dần về bên trái với nhiều chú chim hải âu cổ rụt khác quanh các lối vào hang tổ, trong khi bề mặt vách đá phân lớp sẫm màu đổ dốc thẳng đứng xuống biển. Tít sâu bên dưới, làn nước xanh lam pha lục thẫm vỡ tung thành bọt sóng trắng xóa quanh hai cột đá biển (sea stacks) cao vút, và vài chú chim hải âu cổ rụt đang bay lượn trên mặt nước với những nhịp vỗ cánh nhanh mờ nhoè. Ánh nắng vàng thấp chiếu tới từ phía bên trái, viền lên bộ lông chim một lớp ánh sáng ấm áp, dưới bầu trời mờ sương dịu nhẹ chuyển sắc từ vàng nhạt sang xanh lam nhạt cùng một lớp sương biển mỏng nơi đường chân trời. Chụp bằng ống kính tele, độ sâu trường ảnh nông làm nổi bật những chú chim ở tiền cảnh, màu sắc tự nhiên, kết cấu lông vũ sắc nét, chất lượng chuẩn phim tài liệu thiên nhiên. Khung hình ngang rộng 16:9. Không có người, không có chữ, không hình mờ (watermark), không logo.
Xây dựng bản mô tả sẵn sàng tạo ảnh và chuyển động cho một cảnh quay chủ đạo (hero shot) về tu viện trên vách núi với cờ cầu nguyện: các tòa nhà và vách đá, các đường dây cờ, hẻm núi và đỉnh núi, ánh sáng và sương mù, các chi tiết cố định, bản đồ chuyển động, cùng hai hạt giống câu lệnh (prompt seeds): một ảnh tĩnh 16:9 và một hoạt ảnh chuyển từ ảnh sang video.
Hãy đóng vai một nhà thiết kế bối cảnh điện ảnh chuyên viết các bản mô tả cảnh quay (scene briefs) sẵn sàng cho việc tạo hình ảnh và chuyển động. Hãy giúp tôi thiết kế một cảnh quay chủ đạo (hero shot) về một tu viện nhỏ bám trên vách núi cùng những dây cờ cầu nguyện; cảnh này trước tiên sẽ được tạo thành một bức ảnh tĩnh rồi sau đó được làm hoạt ảnh thành một đoạn video ngắn sử dụng chính bức ảnh đó làm khung hình đầu tiên. Bản mô tả của bạn phải làm cho bức ảnh tĩnh giàu các yếu tố có thể chuyển động tự nhiên (cờ cầu nguyện tung bay, mây và sương mù trôi lững lờ, khói trầm hương bốc lên, thác nước hoặc dòng sông tít sâu bên dưới, ánh sáng chuyển dịch, vài cánh chim bay xa xa) trong khi vẫn giữ được bố cục tĩnh tại và dễ tạo hoạt ảnh.

Các lựa chọn khởi đầu của tôi:
- Bối cảnh núi non: Himalayan gorge with a river far below and snow peaks behind
- Thời điểm trong ngày và thời tiết: misty dawn after a clear night
- Diện mạo tu viện: small whitewashed buildings with red-brown upper walls, dark roofs, and gold roof ornaments
- Phong cách hình ảnh: photoreal travel and landscape photography
- Các từ khóa tâm trạng (mood): serene, airy, sacred, quiet

Trước tiên, hãy hỏi tôi trong một tin nhắn ngắn gọn về bất kỳ thông tin nào còn thiếu: góc nhìn máy quay mà tôi ưa thích (nhìn từ một sống núi đối diện bên kia hẻm núi, nhìn từ con đường mòn bên dưới ngước lên, hay nhìn từ một gờ đá ngang tầm với tu viện), mức độ hiển thị của dòng sông và đáy hẻm núi, cũng như bất kỳ yếu tố nào cần tránh (con người, nhà sư, khách du lịch, biển hiệu, tòa nhà hiện đại, dây cáp, hoặc một tu viện có thật cụ thể nào đó).

Sau đó, hãy lập bản mô tả với các phần sau:

1. **Tổng quan Cảnh quay (Scene Overview)**: hai hoặc ba câu mô tả địa điểm, thời gian, ánh sáng và cảm xúc của khoảnh khắc đó. Hãy mô tả một tu viện tưởng tượng, không sao chép một tu viện có tên tuổi ngoài đời thực.

2. **Tu viện và Vách đá (Monastery and Cliff)**: số lượng tòa nhà và cách sắp xếp trên các gờ vách đá, màu tường, các hàng cửa sổ, mái nhà và đồ trang trí bằng vàng, bậc thang hoặc cây cầu gỗ, cách các tòa nhà tựa vào đá, kết cấu bề mặt vách đá và thảm thực vật (bách xù, thông, rêu), cùng vị trí của tu viện trong khung hình.

3. **Cờ Cầu nguyện (Prayer Flags)**: số lượng dây cờ, vị trí buộc của từng dây (mái nhà, mũi đá nhọn, cột cờ), hướng căng ngang qua khung hình, thứ tự màu sắc (xanh lam, trắng, đỏ, xanh lục, vàng), kích thước và độ võng của dây cờ. Nêu rõ rằng các lá cờ chuyển động theo gió nhưng các điểm buộc của chúng không bao giờ dịch chuyển.

4. **Hẻm núi và Phong cảnh (Gorge and Landscape)**: dòng sông hoặc thác nước tít sâu bên dưới, các sườn núi phủ rừng, những sống núi hai bên, các đỉnh núi tuyết và các lớp chiều sâu từ tiền cảnh đến hậu cảnh.

5. **Ánh sáng và Bầu không khí (Light and Atmosphere)**: hướng nắng và màu sắc ánh mặt trời, các dải sương mù trong hẻm núi cùng độ cao của chúng, những dải mây mỏng quanh các đỉnh núi, khói trầm hương từ lư hương trên mái nhà, và cách ánh sáng bắt vào những bức tường trắng cùng các chi tiết trang trí bằng vàng.

6. **Các Chi tiết Hình ảnh Cố định (Fixed Visual Details)**: danh sách đánh số từ 8 đến 10 chi tiết bắt buộc phải giữ nguyên giống hệt nhau giữa bức ảnh tĩnh và đoạn video (phía và vị trí của tu viện, số lượng tòa nhà, điểm buộc và hướng của dây cờ, vị trí dòng sông, hình dáng các đỉnh núi, hướng mặt trời, độ cao lớp sương mù, vị trí máy quay, bố cục khung hình).

7. **Bản đồ Chuyển động (Motion Map)**: một bảng liệt kê mọi yếu tố có thể chuyển động trong video, gồm các cột: yếu tố, kiểu chuyển động, hướng, tốc độ (rất chậm, chậm, trung bình) và cường độ chuyển động. Bao gồm cả chuyển động của máy quay. Giữ cho tổng thể chuyển động tinh tế và hợp lý về mặt vật lý, với một hướng gió duy nhất chi phối cả cờ, sương mù và khói.

8. **Hạt giống Câu lệnh A - Ảnh tĩnh Chủ đạo (Prompt Seed A - Hero Still Image)**: một câu lệnh tạo ảnh sẵn sàng để dán (dưới 170 từ) cho khung hình ngang rộng 16:9, đưa tu viện, vách đá, cờ cầu nguyện và hẻm núi vào ngay câu đầu tiên, kết thúc bằng cụm từ: no people, no text, no signs, no logos.

9. **Hạt giống Câu lệnh B - Hoạt ảnh Từ ảnh sang Video (Prompt Seed B - Image-to-Video Animation)**: một câu lệnh tạo video sẵn sàng để dán (dưới 120 từ) bắt đầu từ bức ảnh tĩnh chủ đạo làm khung hình đầu tiên, mô tả một chuyển động máy quay chậm rãi cùng các chuyển động tự nhiên lấy từ Bản đồ Chuyển động trong khoảng 6 giây, đồng thời dặn giữ nguyên tu viện, vách đá, các điểm buộc cờ, núi non và bố cục khung hình y hệt như trong ảnh mà không thêm bất kỳ vật thể mới nào.

Quy tắc: không lấy con người làm chủ thể chính, không có chữ, biển hiệu hay logo, không chuyển động máy quay nhanh hoặc cắt cảnh, và không có chuyển động nào phá vỡ quy luật vật lý (cờ tung bay và gợn sóng nhưng vẫn gắn chặt vào dây, sương mù và khói trôi theo cùng một hướng gió với cờ, nước chảy từ trên cao xuống thấp). Sử dụng các đoạn văn ngắn và danh sách liệt kê.
Bức ảnh chụp chân thực lúc bình minh sương mù ghi lại một tu viện nhỏ quét vôi trắng trên các gờ vách đá với năm dây cờ cầu nguyện đầy màu sắc căng sang một mũi đá nhọn, dòng sông màu ngọc lam ẩn dưới dải sương mù trong hẻm núi, và những đỉnh núi tuyết rực ánh vàng. Bước 2 trong quy trình Tu viện Bên Vách đá Himalaya.
Một tu viện Himalaya nhỏ quét vôi trắng bám mình trên các gờ của vách đá hoa cương dựng đứng ở phía bên trái khung hình vào lúc bình minh sương mù, với năm dây cờ cầu nguyện dài rực rỡ sắc màu căng từ các mái nhà băng qua hẻm núi tới một mũi đá nhọn cao vút ở tiền cảnh bên phải. Tu viện có bốn tòa nhà xếp tầng lên nhau với phần tường dưới màu trắng, phần tường trên màu nâu đỏ, những hàng cửa sổ nhỏ tối màu, mái bằng viền sẫm và các chi tiết trang trí mái nhỏ bằng vàng đón lấy tia nắng đầu tiên, được nối với nhau bằng những bậc thang đá hẹp và một ban công gỗ ngắn. Làn khói trầm hương mảnh mai bay lên từ một lư hương trên mái nhà. Những lá cờ cầu nguyện lặp lại thứ tự màu xanh lam, trắng, đỏ, xanh lục và vàng, võng xuống nhẹ nhàng tạo thành những đường cong mềm mại. Tít sâu bên dưới, một dòng sông màu ngọc lam uốn lượn qua hẻm núi sâu phủ rừng rậm, ẩn hiện một nửa dưới dải sương mù trắng mịn nằm thấp hơn tu viện. Những đỉnh núi phủ tuyết vươn cao ở hậu cảnh, chóp núi được mặt trời chiếu từ phía bên phải nhuộm sắc vàng nhạt và hồng phấn, dưới bầu trời trong trẻo chuyển dần từ xanh lam dịu sang màu hồng đào ấm áp. Những cây thông sẫm màu và bụi cây bách xù bám chặt vào vách đá. Nhiếp ảnh phong cảnh và du lịch chân thực (photoreal), bầu không khí thanh bình và thoáng đãng. Khung hình ngang rộng 16:9. Không có người, không có chữ, không biển hiệu, không logo.
Tạo hoạt ảnh từ bức ảnh tu viện ở bước 2 làm khung hình đầu tiên thành một cảnh quay êm dịu dài 6 giây: cờ cầu nguyện tung bay trong làn gió nhẹ, sương mù dưới hẻm núi trôi lững lờ và tan mỏng dần trên mặt sông, khói trầm hương uốn cong theo chiều gió, ánh bình minh sưởi ấm những bức tường và đỉnh núi, còn máy quay từ từ đẩy nhẹ vào gần. Bước 3 trong quy trình Tu viện Bên Vách đá Himalaya.
Bắt đầu từ bức ảnh ở bước 2 "Tu viện Himalaya Bên Vách đá với Cờ Cầu nguyện Lúc Bình minh Sương mù" làm khung hình đầu tiên chính xác tuyệt đối, và tạo hoạt ảnh cho nó thành một cảnh quay điện ảnh êm dịu dài 6 giây. Giữ nguyên hoàn toàn các tòa nhà tu viện trên vách đá bên trái, mũi đá nhọn bên phải, các điểm buộc của mọi dây cờ cầu nguyện, dòng sông, hẻm núi, những đỉnh núi tuyết và bố cục khung hình y hệt như trong ảnh. Những lá cờ cầu nguyện phấp phới và gợn sóng đều đặn trong làn gió nhẹ thổi từ trái sang phải, luôn bám chắc vào dây treo. Dải sương mù trắng dưới hẻm núi trôi chậm rãi từ trái sang phải và nhẹ nhàng tan mỏng ở một vài chỗ, để lộ thêm một chút dòng sông màu ngọc lam. Làn khói trầm hương mảnh mai từ lư hương trên mái nhà bay lên và uốn cong mềm mại theo cùng chiều gió. Ánh nắng vàng từ từ đậm dần trên những bức tường trắng, các chi tiết trang trí mái bằng vàng và những đỉnh núi phủ tuyết. Máy quay thực hiện một chuyển động đẩy vào (push-in) thật chậm rãi, mượt mà hướng về phía tu viện. Chuyển động tự nhiên, chân thực, không cắt cảnh, không thêm vật thể mới, không có người, không có chữ.Quy hoạch và kiểm tra cách bố trí mạng con (subnet) IPv4 cho các mạng trên AWS, Azure, GCP hoặc tại chỗ (on-prem). Tính toán kích thước từng mạng con dựa trên số lượng máy trạm (host) cộng với mức tăng trưởng và các địa chỉ dành riêng của nhà cung cấp, cấp phát các khối CIDR được căn chỉnh theo thứ tự từ lớn nhất trước, đồng thời cảnh báo các mạng con bị chồng lấn, các dải VPC xung đột với VPC được kết nối ngang hàng (peered VPC), mạng VPN hoặc cầu nối docker0, các dải IP công cộng, giới hạn kích thước, khoảng dự phòng thấp và cách bố trí chỉ có một vùng (single-zone). Bao gồm công cụ quy hoạch viết bằng thư viện chuẩn Python kèm tùy chọn --self-test.
---
name: vpc-subnet-cidr-planner
description: Quy hoạch và kiểm tra cách bố trí mạng con (subnet) IPv4 cho các mạng trên AWS, Azure, GCP hoặc tại chỗ (on-prem). Tính toán kích thước từng mạng con dựa trên số lượng máy trạm (host) cộng với mức tăng trưởng và các địa chỉ dành riêng của nhà cung cấp, cấp phát các khối CIDR được căn chỉnh theo thứ tự từ lớn nhất trước, đồng thời cảnh báo các mạng con bị chồng lấn, các dải VPC xung đột với VPC được kết nối ngang hàng (peered VPC), mạng VPN hoặc cầu nối docker0, các dải IP công cộng, giới hạn kích thước, khoảng dự phòng thấp và cách bố trí chỉ có một vùng (single-zone). Bao gồm công cụ quy hoạch viết bằng thư viện chuẩn Python kèm tùy chọn --self-test.
---

# Công cụ Quy hoạch CIDR Mạng con VPC

Bạn giúp các kỹ sư phân chia một mạng lớn thành các mạng con (subnet) vừa vặn với nhu cầu hiện tại, chừa đủ không gian để mở rộng và không bao giờ xung đột với bất kỳ mạng nào họ cần định tuyến tới trong tương lai. Bạn biến yêu cầu "chúng tôi cần các mạng con public, app và data ở hai vùng (zone)" thành các khối CIDR chính xác, giải thích rõ những con số tính toán và phát hiện sớm các điểm chồng lấn vốn rất vất vả để khắc phục một khi các tải công việc (workloads) đã đi vào vận hành.

## Các tệp trong kỹ năng này

- `scripts/cidr_plan.py` - tính toán kích thước và cấp phát các mạng con, liệt kê các dải địa chỉ host khả dụng cùng các khối còn trống, đồng thời báo cáo các phát hiện (chỉ dùng thư viện chuẩn Python 3, sử dụng mô-đun `ipaddress`)
- `references/cidr-math-and-provider-rules.md` - bảng kích thước tiền tố (prefix), quy tắc căn chỉnh (alignment), các địa chỉ dành riêng và giới hạn theo từng nhà cung cấp, các dải địa chỉ riêng (private ranges)
- `references/subnet-layout-playbook.md` - cách bố trí phân tầng (tiered layouts), chiến lược phân vùng (zone), tính toán kích thước mạng con cho pod Kubernetes, tránh chồng lấn với VPN và các mạng ngang hàng (peers), các phương án đánh số lại (renumbering)
- `templates/subnet-plan.md` - mẫu tài liệu quy hoạch mạng con dùng để rà soát hoặc đính kèm vào pull request
- `examples/shop-platform-vpc.json` - một mạng AWS /18 có các mạng con cũ (legacy), một VPC phân tích được kết nối ngang hàng (peered) và sáu mạng con mới trải trên hai vùng

## Quy trình làm việc

### 1. Thu thập thông tin thực tế về mạng
Hỏi về nhà cung cấp dịch vụ, dải CIDR của VPC / VNet (hoặc dải địa chỉ họ dự định dùng), các mạng con hiện có, mọi mạng mà nó phải giao tiếp cùng (các VPC kết nối ngang hàng, mạng VPN, văn phòng tại chỗ on-prem, đường kết nối đối tác, các đám mây khác), và các mạng con họ cần tạo: mục đích sử dụng, vùng (zone), số lượng host hiện tại và mức tăng trưởng dự kiến. Đối với Kubernetes, hãy hỏi xem các pod có lấy địa chỉ trực tiếp từ VPC hay không (AWS VPC CNI, Azure CNI), vì khi đó chính số lượng pod chứ không phải số lượng node mới là yếu tố quyết định kích thước mạng con.

### 2. Chạy công cụ quy hoạch
```
python3 scripts/cidr_plan.py examples/shop-platform-vpc.json
python3 scripts/cidr_plan.py plan.json --json
python3 scripts/cidr_plan.py --self-test
```
Mã thoát (exit code) 1 nghĩa là có các phát hiện mức HIGH (chồng lấn địa chỉ, hết không gian trống), 2 nghĩa là dữ liệu đầu vào bị lỗi (các bit phần host bị bật, dùng IPv6, các dải VPC bị chồng lấn nhau).

### 3. Rà soát kết quả
Khắc phục các phát hiện mức HIGH trước: sự chồng lấn với mạng ngang hàng (peer) hoặc VPN sẽ không thể định tuyến được và thường đồng nghĩa với việc phải chọn một dải VPC mới ngay bây giờ khi chi phí thay đổi còn thấp. Sử dụng `references/subnet-layout-playbook.md` để điều chỉnh cách bố trí (các mạng con có kích thước bằng nhau ở mỗi vùng, chừa một khối dự phòng cho mỗi tầng, chừa chỗ cho vùng thứ ba) và dùng `references/cidr-math-and-provider-rules.md` để giải thích về kích thước. Chạy lại công cụ sau mỗi lần thay đổi.

### 4. Bàn giao kết quả
Điền vào `templates/subnet-plan.md` bảng quy hoạch, các khối còn trống, các phát hiện và quyết định. Cung cấp thêm các đoạn mã Terraform hoặc lệnh CLI cho các khối CIDR cuối cùng nếu được yêu cầu.

## Kết quả ví dụ
Đối với `examples/shop-platform-vpc.json` (AWS 10.20.0.0/18): các mạng con tầng app gồm 2,500 pod + 60% tăng trưởng được cấp các khối /20 (mỗi khối có 4,091 địa chỉ khả dụng) tại 10.20.16.0/20 và 10.20.32.0/20; các mạng con cho bộ cân bằng tải (load balancer) và tầng dữ liệu (data) được cấp các khối /25 (123 địa chỉ khả dụng). Các phát hiện: mức HIGH do mạng con cũ rds-b 10.20.1.128/25 bị chồng lấn với rds-a 10.20.1.0/24; mức HIGH do VPC phân tích được kết nối ngang hàng 10.20.48.0/20 nằm gọn bên trong dải VPC này nên việc định tuyến tới nó sẽ bị lỗi; mức LOW do chỉ còn trống 20% không gian địa chỉ.

## Quy tắc

- Không bao giờ đề xuất một dải địa chỉ bị chồng lấn với mạng ngang hàng (peer), VPN hoặc mạng tại chỗ (on-prem) đã biết; hãy hỏi danh sách đầy đủ nếu chưa chắc chắn.
- Quy hoạch có tính đến mức tăng trưởng và một vùng (zone) trong tương lai; việc thay đổi kích thước một mạng con tại chỗ thường là bất khả thi.
- Giữ các phép tính IPv4 tuyệt đối chính xác; hiển thị số lượng địa chỉ khả dụng sau khi đã trừ đi các địa chỉ dành riêng của nhà cung cấp.
- Không tự mình thay đổi các mạng đang hoạt động; hãy đưa ra bản quy hoạch và thứ tự thực hiện thay đổi để người dùng tự áp dụng.
FILE:references/cidr-math-and-provider-rules.md
# Toán học CIDR và Quy tắc của Nhà cung cấp

## Kích thước tiền tố (IPv4)
| Tiền tố (Prefix) | Tổng số địa chỉ | Khả dụng trên AWS / Azure (-5) | Khả dụng trên GCP (-4) | Khả dụng truyền thống (-2) |
|---|---|---|---|---|
| /16 | 65,536 | 65,531 | 65,532 | 65,534 |
| /18 | 16,384 | 16,379 | 16,380 | 16,382 |
| /19 | 8,192 | 8,187 | 8,188 | 8,190 |
| /20 | 4,096 | 4,091 | 4,092 | 4,094 |
| /21 | 2,048 | 2,043 | 2,044 | 2,046 |
| /22 | 1,024 | 1,019 | 1,020 | 1,022 |
| /23 | 512 | 507 | 508 | 510 |
| /24 | 256 | 251 | 252 | 254 |
| /25 | 128 | 123 | 124 | 126 |
| /26 | 64 | 59 | 60 | 62 |
| /27 | 32 | 27 | 28 | 30 |
| /28 | 16 | 11 | 12 | 14 |
Mỗi khi tiền tố tăng hoặc giảm 1 đơn vị thì kích thước khối địa chỉ sẽ giảm đi một nửa hoặc tăng gấp đôi. Số địa chỉ = 2^(32 - prefix).

## Quy tắc căn chỉnh (Alignment)
Một khối địa chỉ phải bắt đầu tại một bội số của chính kích thước khối đó: một khối /20 bắt đầu tại x.x.0.0, x.x.16.0, x.x.32.0, ...; cách viết 10.20.8.0/20 là không hợp lệ (do các bit phần host bị bật). Việc cấp phát các khối lớn nhất trước giúp giữ cho không gian địa chỉ không bị phân mảnh; nếu đặt các mạng con nhỏ vào trước, chúng có thể chặn mất mọi vị trí căn chỉnh hợp lệ dành cho một khối lớn.

## Các địa chỉ dành riêng trên mỗi mạng con
- **AWS:** bốn địa chỉ đầu tiên (địa chỉ mạng, bộ định tuyến VPC, DNS, dự phòng) và địa chỉ cuối cùng (broadcast) -> trừ 5 địa chỉ. CIDR của VPC từ /16 đến /28, các mạng con từ /16 đến /28. Mặc định tối đa 5 khối CIDR trên mỗi VPC (có thể thêm các CIDR phụ sau để mở rộng không gian).
- **Azure:** bốn địa chỉ đầu tiên (địa chỉ mạng, cổng gateway, 2 địa chỉ DNS) và địa chỉ cuối cùng -> trừ 5 địa chỉ. Mạng con nhỏ nhất đến /29. Một số dịch vụ yêu cầu các mạng con chuyên dụng riêng (GatewaySubnet từ /27 trở lên, AzureFirewallSubnet /26, AzureBastionSubnet /26).
- **GCP:** địa chỉ mạng, cổng gateway, địa chỉ áp chót và địa chỉ broadcast -> trừ 4 địa chỉ. Các mạng con có phạm vi theo khu vực (regional chứ không phải zonal), nhỏ nhất là /29; hỗ trợ các dải địa chỉ phụ (secondary ranges) cho các pod và service của GKE.
- **Truyền thống / tại chỗ (Classic / on-prem):** địa chỉ mạng và địa chỉ broadcast -> trừ 2 địa chỉ (các liên kết điểm-nối-điểm /31 là trường hợp đặc biệt).

## Các dải địa chỉ riêng và đặc biệt
- RFC 1918: 10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16.
- Không gian dùng chung cho Carrier-grade NAT 100.64.0.0/10 (RFC 6598): có thể dùng bên trong các đám mây, nhưng cần kiểm tra để đảm bảo nhà mạng ISP / VPN không sử dụng dải này.
- Nên tránh: 172.17.0.0/16 (cầu nối docker0 mặc định), 169.254.0.0/16 (link-local, dịch vụ metadata trên đám mây), 192.168.0.0/24 và 192.168.1.0/24 (bộ định tuyến gia đình hay dùng nên người dùng VPN sẽ bị xung đột), 10.0.0.0/16 (VPC mặc định trong nhiều công cụ nên các mạng kết nối ngang hàng thường bị đụng).
- Việc sử dụng các dải địa chỉ công cộng (public ranges) bên trong một VPC sẽ khiến các địa chỉ internet thực tế tương ứng không thể truy cập được từ bên trong VPC đó.

## Công thức tính nhanh
- Tiền tố nhỏ nhất cho N máy trạm (host) khả dụng với R địa chỉ dành riêng: 32 - ceil(log2(N + R)).
- Số lượng host tính cả mức tăng trưởng: ceil(hosts x (1 + growth)).
- Không gian trống sau khi quy hoạch = tổng địa chỉ VPC - (các mạng hiện có + mạng mới + các dải mạng ngang hàng bị chặn nằm bên trong VPC).
FILE:references/subnet-layout-playbook.md
# Sổ tay Bố trí Mạng con (Subnet Layout Playbook)

## Cách bố trí phân tầng trên mỗi vùng (zone)
| Tầng (Tier) | Thành phần chứa bên trong | Kích thước điển hình | Định tuyến (Route) |
|---|---|---|---|
| Public | bộ cân bằng tải (load balancers), cổng NAT (NAT gateways), máy chủ bastion | /24 đến /26 | cổng internet (internet gateway) |
| Private app | máy ảo (VMs), containers, các node và pod của Kubernetes | lớn nhất, /20 đến /22 | cổng NAT (NAT gateway) |
| Data | cơ sở dữ liệu, bộ nhớ đệm (caches), hàng đợi (queues) | /24 đến /26 | không có đường định tuyến ra internet |
| Spare (Dự phòng) | tầng tương lai hoặc vùng (zone) thứ ba | giữ lại một khối đã căn chỉnh | - |
Sử dụng cùng một kích thước cho mỗi tầng ở tất cả các vùng để khi chuyển đổi dự phòng (failover), vùng dự phòng có thể gánh toàn bộ tải.

## Chiến lược phân vùng (Zone strategy)
- Sử dụng ít nhất hai vùng (zones) cho bất kỳ hệ thống môi trường thực tế (production) nào; dùng ba vùng nếu khu vực (region) và ngân sách cho phép.
- Giữ chỗ trước các khối địa chỉ cho vùng thứ ba ngay từ bây giờ dù chưa dùng tới; việc này giúp cấu trúc bố trí luôn đối xứng.
- Các mạng con trên GCP có phạm vi theo khu vực (regional), vì vậy hãy quy hoạch theo từng khu vực thay vì theo từng vùng (zone).

## Tính toán kích thước cho Kubernetes
- Với AWS VPC CNI hoặc Azure CNI, mỗi pod sẽ lấy một địa chỉ IP từ VPC: hãy tính kích thước mạng con tầng app theo số lượng pod ở mức đỉnh (số node x số pod tối đa trên mỗi node), cộng thêm mức tăng đột biến trong quá trình cập nhật cuốn chiếu (rolling updates, thường là +25%) và khi thay thế node.
- Cơ chế ủy quyền tiền tố (Prefix delegation trên AWS) hoặc mạng phủ (overlay networking như Calico, Cilium, kubenet, Azure CNI Overlay) sẽ chuyển các pod sang một dải địa chỉ riêng biệt; khi đó chỉ cần tính kích thước mạng con theo số lượng node và giữ cho dải CIDR của pod không bị trùng với bất kỳ mạng ngang hàng nào.
- Giữ cho dải CIDR của service (ví dụ 172.20.0.0/16) cũng tách biệt hoàn toàn khỏi VPC và các mạng ngang hàng.

## Tránh chồng lấn địa chỉ
- Thu thập mọi mạng mà bạn sẽ cần định tuyến tới: các VPC và tài khoản khác, máy khách VPN, văn phòng, đối tác, các đám mây khác và cả những dải mạng đang được sử dụng bởi các công ty được mua lại/sáp nhập.
- Duy trì một bảng quy hoạch IP tập trung (bảng tính hoặc hệ thống IPAM) và cấp cho mỗi môi trường một khối riêng biệt, ví dụ: 10.20.0.0/16 cho prod, 10.21.0.0/16 cho staging, 10.22.0.0/16 cho dev.
- Không chọn các dải 10.0.0.0/16, 172.17.0.0/16 hoặc từ 192.168.0.0/24 đến 192.168.1.0/24 cho bất kỳ hệ thống nào mà người dùng VPN sẽ kết nối vào.

## Khi đã xảy ra chồng lấn
1. Ưu tiên đánh số lại (renumbering) phía mạng nhỏ hơn hoặc mới hơn ngay lập tức (tạo VPC mới hoặc thêm một dải CIDR phụ, di chuyển hệ thống sang, rồi xóa mạng cũ).
2. Nếu không thể đánh số lại, hãy sử dụng NAT (private NAT gateway, hoặc NAT trên thiết bị VPN) và chỉ định tuyến các dải địa chỉ đã được biên dịch (translated ranges).
3. Các mạng con chồng lấn bên trong cùng một VPC không thể tạo được trên AWS / Azure / GCP; nếu thấy xuất hiện trong tài liệu thì thường là do lỗi gõ nhầm, vì vậy hãy kiểm tra lại các giá trị thực tế.

## Danh sách kiểm tra rà soát (Review checklist)
- [ ] Dải VPC là địa chỉ riêng (private) và duy nhất trên tất cả các mạng ngang hàng (peers) cùng mạng VPN
- [ ] Mọi mạng con đều được căn chỉnh đúng, nằm trong VPC và không bị chồng lấn nhau
- [ ] Kích thước đã tính gộp cả các địa chỉ dành riêng và mức tăng trưởng dự kiến
- [ ] Các tầng cùng loại có kích thước bằng nhau ở mỗi vùng; có giữ lại khối dự phòng
- [ ] Còn trống ít nhất 25% không gian địa chỉ của VPC
FILE:templates/subnet-plan.md
# Bản Quy hoạch Mạng con - <tên mạng>

**Nhà cung cấp / khu vực:** <aws eu-west-1>  **VPC CIDR:** <10.x.0.0/16>  **Đơn vị sở hữu:** <nhóm>  **Ngày:** <ngày>
**Các mạng ngang hàng (Peers) / VPN đã kiểm tra:** <danh sách các dải địa chỉ>

## Các mạng con (Subnets)
| Mạng con | Tầng (Tier) | Vùng (Zone) | Số host hiện tại | Mức tăng trưởng | CIDR | Số IP khả dụng | Bảng định tuyến (Route table) |
|---|---|---|---|---|---|---|---|
| | | | | | | | |

## Các mạng con hiện có được giữ lại
| Tên | CIDR | Ghi chú |
|---|---|---|
| | | |

## Không gian trống
- Đã sử dụng hoặc bị chặn: <n> trên tổng số <total> (còn trống <x>%)
- Các khối dự phòng được giữ chỗ cho: <vùng thứ ba / tầng tương lai>

## Các phát hiện và quyết định
| Mức độ nghiêm trọng | Phát hiện | Quyết định |
|---|---|---|
| | | |

## Thứ tự triển khai (Rollout order)
1. <tạo CIDR phụ / tạo VPC mới>
2. <tạo các mạng con và bảng định tuyến>
3. <di chuyển các tải công việc (workloads), xóa các mạng con cũ>
FILE:examples/shop-platform-vpc.json
{
  "name": "shop platform, eu-west-1 production VPC",
  "provider": "aws",
  "vpc_cidrs": ["10.20.0.0/18"],
  "existing": [
    {"name": "legacy bastion", "cidr": "10.20.0.0/26"},
    {"name": "legacy rds-a", "cidr": "10.20.1.0/24"},
    {"name": "legacy rds-b", "cidr": "10.20.1.128/25"}
  ],
  "peers": [
    {"name": "office VPN (Istanbul)", "cidr": "192.168.10.0/24"},
    {"name": "analytics VPC (peered)", "cidr": "10.20.48.0/20"}
  ],
  "requests": [
    {"name": "public-a (load balancers)", "hosts": 40, "zone": "eu-west-1a", "growth": 0.5},
    {"name": "public-b (load balancers)", "hosts": 40, "zone": "eu-west-1b", "growth": 0.5},
    {"name": "app-a (EKS pods)", "hosts": 2500, "zone": "eu-west-1a", "growth": 0.6},
    {"name": "app-b (EKS pods)", "hosts": 2500, "zone": "eu-west-1b", "growth": 0.6},
    {"name": "data-a (databases, cache)", "hosts": 60, "zone": "eu-west-1a"},
    {"name": "data-b (databases, cache)", "hosts": 60, "zone": "eu-west-1b"}
  ]
}
FILE:scripts/cidr_plan.py
#!/usr/bin/env python3
"""VPC subnet CIDR planner and checker (Python 3 standard library only).

Input: a network plan JSON file:
  {"name": "prod-eu", "provider": "aws", "vpc_cidrs": ["10.40.0.0/16"],
   "existing": [{"name": "legacy-db", "cidr": "10.40.8.0/24"}],
   "peers": [{"name": "office vpn", "cidr": "192.168.0.0/22"}],
   "requests": [{"name": "app-a", "hosts": 900, "zone": "eu-west-1a", "growth": 0.5}]}
  provider: aws | azure | gcp | generic. Reserved addresses per subnet: aws 5, azure 5,
  gcp 4, generic 2 (network + broadcast). Subnet size limits: aws /16../28,
  azure /8../29, gcp /8../29, generic /8../30.
  requests: hosts needed now; growth = extra fraction to reserve (default 0.3);
  optional "prefix" forces a size. Allocation is largest-first, aligned, lowest free address,
  never overlapping existing subnets or peer networks that sit inside the VPC.

Checks (severity):
  HIGH   OVERLAP_EXISTING   two existing subnets overlap
  HIGH   OUTSIDE_VPC        existing subnet not inside any VPC CIDR
  HIGH   PEER_OVERLAP       VPC CIDR overlaps a peered / VPN / on-prem network (routing breaks)
  HIGH   NO_SPACE           a request does not fit in the remaining space
  MEDIUM DOCKER_DEFAULT     VPC overlaps 172.17.0.0/16 (default docker0 bridge)
  MEDIUM PUBLIC_RANGE       VPC CIDR is not private (RFC 1918 / 100.64.0.0/10)
  MEDIUM PREFIX_LIMIT       requested or VPC prefix outside the provider limits
  LOW    LOW_HEADROOM       less than 25% of the VPC left free after the plan
  LOW    SINGLE_ZONE        all requests in one zone (no zone redundancy)
Usage:
  python3 cidr_plan.py plan.json
  python3 cidr_plan.py plan.json --json
  python3 cidr_plan.py --self-test
Exit code: 0 no HIGH findings, 1 HIGH findings, 2 bad input.
"""
import argparse
import ipaddress as ip
import json
import math
import sys

RESERVED = {"aws": 5, "azure": 5, "gcp": 4, "generic": 2}
HEAD_RESERVED = {"aws": 4, "azure": 4, "gcp": 2, "generic": 1}  # rest are at the end of the block
LIMITS = {"aws": (16, 28), "azure": (8, 29), "gcp": (8, 29), "generic": (8, 30)}
PRIVATE = [ip.ip_network(c) for c in ("10.0.0.0/8", "172.16.0.0/12", "192.168.0.0/16", "100.64.0.0/10")]
DOCKER = ip.ip_network("172.17.0.0/16")


class PlanError(ValueError):
    pass


def net(cidr, what="cidr"):
    try:
        n = ip.ip_network(str(cidr).strip(), strict=True)
    except ValueError as e:
        raise PlanError(f"bad {what} {cidr!r}: {e}")
    if n.version != 4:
        raise PlanError(f"only IPv4 is supported: {cidr!r}")
    return n


def usable(prefix, provider):
    return max(0, 2 ** (32 - prefix) - RESERVED[provider])


def prefix_for(hosts, provider, growth):
    need = math.ceil(hosts * (1 + growth))
    lo, hi = LIMITS[provider]
    for p in range(hi, lo - 1, -1):
        if usable(p, provider) >= need:
            return p
    return None


def find_slot(vpcs, taken, prefix):
    for v in vpcs:
        if prefix < v.prefixlen:
            continue
        for cand in v.subnets(new_prefix=prefix):
            if not any(cand.overlaps(t) for t in taken):
                return cand
    return None


def plan(cfg):
    provider = str(cfg.get("provider", "generic")).lower()
    if provider not in RESERVED:
        raise PlanError(f"unknown provider {provider!r} (aws, azure, gcp, generic)")
    vpcs = [net(c, "vpc_cidr") for c in cfg.get("vpc_cidrs") or []]
    if not vpcs:
        raise PlanError("vpc_cidrs is empty")
    lo, hi = LIMITS[provider]
    findings = []

    def f(sev, code, where, msg):
        findings.append({"severity": sev, "code": code, "where": where, "message": msg})

    for v in vpcs:
        if not any(v.subnet_of(p) for p in PRIVATE):
            f("MEDIUM", "PUBLIC_RANGE", str(v), "not an RFC 1918 or 100.64.0.0/10 range; it may clash with real internet addresses")
        if v.overlaps(DOCKER):
            f("MEDIUM", "DOCKER_DEFAULT", str(v), "overlaps 172.17.0.0/16, the default docker0 bridge; containers on hosts in this VPC may lose routes")
        if provider == "aws" and not (16 <= v.prefixlen <= 28):
            f("MEDIUM", "PREFIX_LIMIT", str(v), "AWS VPC CIDR blocks must be /16 to /28")
    for i, a in enumerate(vpcs):
        for b in vpcs[i + 1:]:
            if a.overlaps(b):
                raise PlanError(f"vpc_cidrs overlap each other: {a} and {b}")

    existing = []
    for e in cfg.get("existing") or []:
        n = net(e.get("cidr"), "existing cidr")
        name = e.get("name") or str(n)
        if not any(n.subnet_of(v) for v in vpcs):
            f("HIGH", "OUTSIDE_VPC", name, f"{n} is not inside {', '.join(map(str, vpcs))}")
        for other_name, o in existing:
            if n.overlaps(o):
                f("HIGH", "OVERLAP_EXISTING", name, f"{n} overlaps {other_name} {o}")
        existing.append((name, n))

    taken = [n for _, n in existing]
    for p in cfg.get("peers") or []:
        n = net(p.get("cidr"), "peer cidr")
        name = p.get("name") or str(n)
        for v in vpcs:
            if v.overlaps(n):
                f("HIGH", "PEER_OVERLAP", name, f"{n} overlaps VPC {v}; traffic to the overlapping range cannot be routed both ways (renumber one side or use NAT)")
                taken.append(n)

    reqs = []
    for r in cfg.get("requests") or []:
        name = r.get("name") or "subnet"
        hosts = r.get("hosts", 0)
        if not isinstance(hosts, int) or isinstance(hosts, bool) or hosts < 1:
            raise PlanError(f"request {name!r}: hosts must be a positive integer")
        growth = r.get("growth", 0.3)
        if not isinstance(growth, (int, float)) or growth < 0:
            raise PlanError(f"request {name!r}: growth must be >= 0")
        if "prefix" in r:
            pfx = r["prefix"]
            if not isinstance(pfx, int) or not 8 <= pfx <= 30:
                raise PlanError(f"request {name!r}: prefix must be an integer 8..30")
            if not lo <= pfx <= hi:
                f("MEDIUM", "PREFIX_LIMIT", name, f"/{pfx} is outside {provider} subnet limits /{lo}../{hi}")
        else:
            pfx = prefix_for(hosts, provider, growth)
        reqs.append({"name": name, "hosts": hosts, "growth": growth, "zone": r.get("zone", ""), "prefix": pfx})

    allocs = []
    order = sorted(range(len(reqs)), key=lambda i: (reqs[i]["prefix"] if reqs[i]["prefix"] is not None else -1, i))
    for i in order:
        r = reqs[i]
        slot = find_slot(vpcs, taken, r["prefix"]) if r["prefix"] is not None else None
        if slot is None:
            f("HIGH", "NO_SPACE", r["name"], f"needs {r['hosts']} hosts (+{round(r['growth'] * 100)}% growth) and no free aligned block is left")
            allocs.append(dict(r, cidr=None, usable=0))
            continue
        taken.append(slot)
        u = usable(slot.prefixlen, provider)
        tail = RESERVED[provider] - HEAD_RESERVED[provider]
        allocs.append(dict(r, cidr=str(slot), usable=u,
                           first=str(slot[HEAD_RESERVED[provider]]) if u else "-",
                           last=str(slot[-1 - tail]) if u else "-"))
        if u < r["hosts"]:
            f("HIGH", "NO_SPACE", r["name"], f"/{slot.prefixlen} gives only {u} usable addresses for {r['hosts']} hosts")
    allocs.sort(key=lambda a: (a["cidr"] is None, ip.ip_network(a["cidr"]) if a["cidr"] else 0))

    total = sum(v.num_addresses for v in vpcs)
    used = 0
    inside = [t for t in taken if any(t.subnet_of(v) for v in vpcs)]
    for t in ip.collapse_addresses(inside):
        used += t.num_addresses
    free = total - used
    free_blocks = []
    for v in vpcs:
        rest = [v]
        for t in ip.collapse_addresses([x for x in inside if x.subnet_of(v)]):
            nxt = []
            for b in rest:
                if t.subnet_of(b):
                    nxt.extend(b.address_exclude(t))
                elif not b.subnet_of(t):
                    nxt.append(b)
            rest = nxt
        free_blocks.extend(sorted(rest))
    if total and free / total < 0.25:
        f("LOW", "LOW_HEADROOM", "plan", f"only {free / total:.0%} of the VPC address space is left free")
    zones = {r["zone"] for r in reqs if r["zone"]}
    if len(reqs) > 1 and len(zones) == 1:
        f("LOW", "SINGLE_ZONE", "plan", f"all requests are in {zones.pop()}; spread subnets over at least two zones")
    rank = {"HIGH": 0, "MEDIUM": 1, "LOW": 2}
    findings.sort(key=lambda x: rank[x["severity"]])
    return {"name": cfg.get("name", "network plan"), "provider": provider, "vpcs": [str(v) for v in vpcs],
            "existing": [{"name": n, "cidr": str(c)} for n, c in existing],
            "allocations": allocs, "total": total, "used": used, "free": free,
            "free_blocks": [str(b) for b in free_blocks], "findings": findings}


def report(res):
    out = [f"# Subnet plan: {res['name']}", "",
           f"Provider: {res['provider']} (reserves {RESERVED[res['provider']]} addresses per subnet)  VPC: {', '.join(res['vpcs'])}", "",
           "| Subnet | Zone | Hosts now | Growth | CIDR | Usable | First host | Last host |", "|---|---|---|---|---|---|---|---|"]
    for a in res["allocations"]:
        out.append(f"| {a['name']} | {a['zone'] or '-'} | {a['hosts']} | {round(a['growth'] * 100)}% | {a['cidr'] or 'NOT PLACED'} | "
                   f"{a['usable']} | {a.get('first', '-')} | {a.get('last', '-')} |")
    if res["existing"]:
        out += ["", "Existing subnets kept: " + ", ".join(f"{e['name']} {e['cidr']}" for e in res["existing"])]
    pct = res["free"] / res["total"] if res["total"] else 0
    out += ["", f"Address space: {res['used']} of {res['total']} used or blocked, {res['free']} free ({pct:.0%})",
            "Largest free blocks: " + (", ".join(sorted(res["free_blocks"], key=lambda c: ip.ip_network(c).prefixlen)[:6]) or "none"),
            "", "## Findings"]
    if not res["findings"]:
        out.append("- none")
    for x in res["findings"]:
        out.append(f"- **{x['severity']} {x['code']}** ({x['where']}): {x['message']}")
    return "\n".join(out) + "\n"


def self_test():
    cases = []

    def ok(name, cond):
        cases.append(bool(cond))
        print(("PASS " if cond else "FAIL ") + name)

    ok("aws /24 usable 251", usable(24, "aws") == 251)
    ok("generic /24 usable 254", usable(24, "generic") == 254)
    ok("gcp /29 usable 4", usable(29, "gcp") == 4)
    ok("900 hosts +50% on aws -> /21", prefix_for(900, "aws", 0.5) == 21)
    ok("250 hosts no growth aws -> /24", prefix_for(250, "aws", 0) == 24)
    ok("252 hosts no growth aws -> /23", prefix_for(252, "aws", 0) == 23)
    ok("too big for aws -> None", prefix_for(70000, "aws", 0) is None)
    base = {"provider": "aws", "vpc_cidrs": ["10.0.0.0/16"]}
    r = plan(dict(base, requests=[{"name": "a", "hosts": 200, "zone": "z1"}, {"name": "b", "hosts": 1000, "zone": "z2"}]))
    cid = {a["name"]: a["cidr"] for a in r["allocations"]}
    ok("largest first gets lowest block", cid == {"b": "10.0.0.0/21", "a": "10.0.8.0/23"})
    ok("clean plan has no findings", r["findings"] == [])
    aa = [a for a in r["allocations"] if a["name"] == "a"][0]
    ok("first/last host skip aws reserved", (aa["first"], aa["last"]) == ("10.0.8.4", "10.0.9.254"))
    g = plan({"provider": "gcp", "vpc_cidrs": ["10.0.0.0/16"], "requests": [{"name": "a", "hosts": 100, "growth": 0}]})["allocations"][0]
    ok("gcp reserves 2 head + 2 tail", (g["cidr"], g["first"], g["last"]) == ("10.0.0.0/25", "10.0.0.2", "10.0.0.125"))
    r = plan(dict(base, existing=[{"name": "old", "cidr": "10.0.0.0/22"}], requests=[{"name": "a", "hosts": 1000}]))
    ok("allocation avoids existing", r["allocations"][0]["cidr"] == "10.0.8.0/21")
    r = plan(dict(base, existing=[{"name": "x", "cidr": "10.0.0.0/24"}, {"name": "y", "cidr": "10.0.0.128/25"}]))
    ok("overlap existing flagged", any(x["code"] == "OVERLAP_EXISTING" for x in r["findings"]))
    r = plan(dict(base, existing=[{"name": "x", "cidr": "10.1.0.0/24"}]))
    ok("outside vpc flagged", any(x["code"] == "OUTSIDE_VPC" for x in r["findings"]))
    r = plan(dict(base, peers=[{"name": "vpn", "cidr": "10.0.4.0/22"}], requests=[{"name": "a", "hosts": 900, "growth": 0}]))
    ok("peer overlap flagged", any(x["code"] == "PEER_OVERLAP" for x in r["findings"]))
    ok("allocation avoids peer range", r["allocations"][0]["cidr"] == "10.0.0.0/22")
    r = plan({"provider": "aws", "vpc_cidrs": ["10.0.0.0/24"], "requests": [{"name": "a", "hosts": 200}]})
    ok("no space flagged", any(x["code"] == "NO_SPACE" for x in r["findings"]))
    r = plan({"provider": "generic", "vpc_cidrs": ["172.16.0.0/12"]})
    ok("docker default flagged", any(x["code"] == "DOCKER_DEFAULT" for x in r["findings"]))
    r = plan({"provider": "generic", "vpc_cidrs": ["8.8.0.0/16"]})
    ok("public range flagged", any(x["code"] == "PUBLIC_RANGE" for x in r["findings"]))
    r = plan({"provider": "aws", "vpc_cidrs": ["10.0.0.0/8"]})
    ok("aws vpc /8 flagged", any(x["code"] == "PREFIX_LIMIT" for x in r["findings"]))
    r = plan({"provider": "aws", "vpc_cidrs": ["10.0.0.0/22"], "requests": [{"name": "a", "hosts": 400, "zone": "z1"}, {"name": "b", "hosts": 300, "zone": "z1"}]})
    ok("low headroom flagged", any(x["code"] == "LOW_HEADROOM" for x in r["findings"]))
    ok("single zone flagged", any(x["code"] == "SINGLE_ZONE" for x in r["findings"]))
    r = plan(dict(base, requests=[{"name": "a", "hosts": 10, "prefix": 30}]))
    ok("forced /30 on aws flagged", any(x["code"] == "PREFIX_LIMIT" for x in r["findings"]))
    r = plan(dict(base, requests=[{"name": "a", "hosts": 1000}]))
    ok("free blocks cover rest", sum(ip.ip_network(b).num_addresses for b in r["free_blocks"]) == 65536 - 2048)
    for bad, label in ((dict(base, vpc_cidrs=[]), "empty vpc"), (dict(base, vpc_cidrs=["10.0.0.1/16"]), "host bits set"),
                       (dict(base, provider="oracle"), "unknown provider"), (dict(base, requests=[{"hosts": 0}]), "zero hosts"),
                       (dict(base, vpc_cidrs=["10.0.0.0/16", "10.0.128.0/17"]), "overlapping vpcs"),
                       (dict(base, vpc_cidrs=["fd00::/48"]), "ipv6")):
        try:
            plan(bad)
            ok(label + " rejected", False)
        except PlanError:
            ok(label + " rejected", True)
    print(f"{sum(cases)}/{len(cases)} passed")
    return 0 if all(cases) else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="Plan and check VPC subnet CIDR blocks.")
    ap.add_argument("file", nargs="?", help="network plan JSON")
    ap.add_argument("--json", action="store_true", help="print machine-readable JSON")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    if not a.file:
        ap.error("give a plan JSON file or --self-test")
    try:
        cfg = json.load(open(a.file, encoding="utf-8"))
        res = plan(cfg)
    except (OSError, json.JSONDecodeError, PlanError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(res, indent=2) if a.json else report(res), end="" if not a.json else "\n")
    return 1 if any(x["severity"] == "HIGH" for x in res["findings"]) else 0


if __name__ == "__main__":
sys.exit(main())Dự báo thời điểm các ổ đĩa và phân vùng (volume) sẽ đầy dựa trên các mẫu dữ liệu mức sử dụng (tệp CSV gồm dấu thời gian, phân vùng, dung lượng đã dùng và tổng dung lượng). Ước lượng tốc độ tăng trưởng tổng thể và trong tuần gần nhất, loại bỏ các bước nhảy đột biến một lần khỏi xu hướng, đồng thời đưa ra số ngày và ngày cụ thể chạm ngưỡng đầy 80, 90, 95 và 100% cùng mức dung lượng đề xuất để duy trì khoảng dự phòng 90 ngày. Cảnh báo các phân vùng sắp đầy, tốc độ tăng trưởng đang tăng tốc, các bước nhảy đột ngột, xu hướng nhiễu và dữ liệu quá mỏng. Bao gồm công cụ dự báo viết bằng thư viện chuẩn Python kèm tùy chọn --self-test.
---
name: disk-capacity-runway-forecaster
description: Dự báo thời điểm các ổ đĩa và phân vùng (volume) sẽ đầy dựa trên các mẫu dữ liệu mức sử dụng (tệp CSV gồm dấu thời gian, phân vùng, dung lượng đã dùng và tổng dung lượng). Ước lượng tốc độ tăng trưởng tổng thể và trong tuần gần nhất, loại bỏ các bước nhảy đột biến một lần khỏi xu hướng, đồng thời đưa ra số ngày và ngày cụ thể chạm ngưỡng đầy 80, 90, 95 và 100% cùng mức dung lượng đề xuất để duy trì khoảng dự phòng 90 ngày. Cảnh báo các phân vùng sắp đầy, tốc độ tăng trưởng đang tăng tốc, các bước nhảy đột ngột, xu hướng nhiễu và dữ liệu quá mỏng. Bao gồm công cụ dự báo viết bằng thư viện chuẩn Python kèm tùy chọn --self-test.
---

# Công cụ Dự báo Thời gian Cạn kiệt Dung lượng Ổ đĩa

Bạn giúp các kỹ sư trực ca (on-call) và quản trị viên hệ thống trả lời câu hỏi "khi nào ổ đĩa này sẽ đầy, và chúng ta nên làm gì trước thời điểm đó?". Từ các mẫu dữ liệu mức sử dụng được xuất ra từ hệ thống giám sát (Prometheus, CloudWatch, Datadog, Zabbix, hoặc một cron job chạy lệnh `df`), bạn tính toán thời gian còn lại (runway) cho từng phân vùng, xếp hạng các phân vùng theo mức độ khẩn cấp, giải thích lý do vì sao dự báo có thể sai lệch, và đề xuất các biện pháp xử lý cụ thể: dọn dẹp, xoay vòng nhật ký (rotate), mở rộng dung lượng (resize) hoặc di chuyển dữ liệu.

## Các tệp trong kỹ năng này

- `scripts/disk_runway.py` - đọc tệp CSV chứa các mẫu dữ liệu, ước lượng tốc độ tăng trưởng và in ra bảng xếp hạng thời gian cạn kiệt dung lượng kèm theo các phát hiện và kích thước đề xuất (chỉ dùng thư viện chuẩn Python 3)
- `references/forecasting-method.md` - cách tính xu hướng, tốc độ gần đây, các bước nhảy đột biến một lần, thời gian còn lại và kích thước đề xuất, cùng những giới hạn của phương pháp dự báo tuyến tính
- `references/disk-full-runbook.md` - cách tìm nguyên nhân gây tăng dung lượng, các bước dọn dẹp an toàn, chính sách lưu trữ nhật ký và bản sao lưu, cách mở rộng dung lượng trên Linux và trên đám mây, ngưỡng cảnh báo
- `templates/capacity-review.md` - mẫu báo cáo đánh giá dung lượng để chia sẻ với nhóm hoặc đính kèm vào ticket
- `examples/fleet-disk-usage.csv` - các mẫu dữ liệu hàng ngày trong ba tuần của bốn phân vùng: một cơ sở dữ liệu tăng trưởng ổn định, một phân vùng chứa log có xoay vòng, một CI runner đang tăng tốc độ tiêu thụ và một thiết bị lưu trữ sao lưu NAS có một bước nhảy đột biến một lần

## Quy trình làm việc

### 1. Thu thập các mẫu dữ liệu
Yêu cầu cung cấp các mẫu dữ liệu của ít nhất một tuần (tốt nhất là 3-4 tuần) cho mỗi phân vùng: dấu thời gian (timestamp), phân vùng (host:mount), số GB đã dùng và tổng số GB kích thước. Ví dụ về các nguồn dữ liệu: Prometheus `node_filesystem_size_bytes - node_filesystem_avail_bytes`, CloudWatch `disk_used_percent` kết hợp với kích thước phân vùng, hoặc lệnh `df -BG --output=target,used,size` từ cron. Đồng thời hỏi xem dữ liệu gì đang nằm trên mỗi phân vùng và các sự kiện đã biết (di chuyển dữ liệu, bản sao lưu mới, đợt phát hành mới).

### 2. Chạy công cụ dự báo
```
python3 scripts/disk_runway.py examples/fleet-disk-usage.csv
python3 scripts/disk_runway.py usage.csv --horizon 180 --json
python3 scripts/disk_runway.py --self-test
```
Mã thoát (exit code) 1 nghĩa là có phân vùng ở mức CRITICAL hoặc HIGH, 2 nghĩa là dữ liệu đầu vào bị lỗi.

### 3. Giải thích và hành động
Bắt đầu với các phân vùng ở mức CRITICAL và HIGH. Với mỗi phân vùng, hãy nêu rõ thứ gì đang phình to và với tốc độ bao nhiêu, ngày nào sẽ chạm ngưỡng 90% và 100%, cùng hành động an toàn nhanh nhất từ `references/disk-full-runbook.md`. Hãy xem các kết quả có gắn cờ NOISY_TREND và FEW_SAMPLES là ước tính sơ bộ. Đối với SUDDEN_JUMP, hãy xác nhận nguyên nhân (một bộ sao lưu mới, một bản kết xuất cơ sở dữ liệu, một đợt bùng nổ log) trước khi lập kế hoạch xoay quanh nó. Sử dụng `references/forecasting-method.md` để giải thích lý do vì sao tốc độ gần đây có thể được ưu tiên áp dụng hơn xu hướng dài hạn.

### 4. Bàn giao kết quả
Điền vào `templates/capacity-review.md` bảng số liệu, các hành động cần làm, người phụ trách và thời hạn, đồng thời đề xuất các ngưỡng cảnh báo (ví dụ: cảnh báo warning ở mức 80% hoặc còn 14 ngày dung lượng, gọi trực khẩn cấp page ở mức 90% hoặc còn 3 ngày).

## Kết quả ví dụ
Đối với `examples/fleet-disk-usage.csv` (mẫu cuối cùng lúc 2026-10-21 06:00): ci-runner01:/ ở mức HIGH, đã đầy 80% và đang tăng 5.6 GB/ngày trong tuần qua so với 2.1 tổng thể, sẽ chạm 90% sau 3.6 ngày và đầy hoàn toàn vào ngày 2026-10-28; db01:/var/lib/postgresql tăng đều đặn 3 GB/ngày và chạm ngưỡng 80% sau 13.3 ngày (mức MEDIUM, dung lượng đề xuất 790 GB); backup-nas có một bước nhảy đột biến một lần +405.6 GB vào ngày 2026-10-16 không bị ngoại suy tiếp, còn 120 ngày nữa mới tới ngưỡng 80%; web01:/var/log ở mức OK nhưng dữ liệu nhiễu (do xoay vòng log).

## Quy tắc

- Không bao giờ gợi ý xóa dữ liệu mà không nêu chính xác cần xóa gì, cách kiểm tra tính an toàn và cách khôi phục; hãy ưu tiên xoay vòng log, nén dữ liệu, áp dụng chính sách lưu giữ (retention) và mở rộng dung lượng.
- Nêu rõ ngày dự báo được tính dựa trên tốc độ nào và lưu ý rằng các dự báo tuyến tính sẽ không tính đến các sự kiện đột xuất.
- Thời gian trong báo cáo tuân theo các dấu thời gian trong dữ liệu; hãy nói rõ chúng đang ở múi giờ nào.
- Không tự mình chạy các lệnh dọn dẹp hoặc mở rộng dung lượng trên hệ thống đang hoạt động (live systems); hãy cung cấp câu lệnh để người dùng tự kiểm tra và thực thi.
FILE:references/forecasting-method.md
# Phương pháp Dự báo

## Đầu vào
Mỗi mẫu dữ liệu là một dòng: `timestamp,volume,used_gb,size_gb`. Các dòng có thể chưa được sắp xếp và trộn lẫn giữa nhiều phân vùng. Giá trị `size_gb` mới nhất sẽ được sử dụng, nhờ đó việc thay đổi kích thước trong khoảng thời gian lấy mẫu vẫn được xử lý chính xác.

## Tốc độ tăng trưởng
- **Tốc độ tổng thể (Overall rate):** hệ số góc bình phương tối thiểu (least-squares slope) của số GB đã dùng theo thời gian (GB/ngày) trên toàn bộ các mẫu dữ liệu. Hệ số R^2 (từ 0 đến 1) cho biết mức độ khớp của đường thẳng: xấp xỉ 1.0 đối với mức tăng trưởng đều đặn, dưới 0.5 đối với các mẫu hình răng cưa như xoay vòng log hoặc tệp tạm.
- **Tốc độ gần đây (Recent rate):** cùng hệ số góc đó nhưng tính trên 7 ngày gần nhất (hoặc một phần ba dữ liệu cuối cùng khi tổng thời gian ít hơn 14 ngày). Chỉ số này giúp phát hiện mức tăng trưởng vừa mới tăng tốc.
- **Tốc độ tính thời gian cạn kiệt (Runway rate):** lấy giá trị xấu hơn (cao hơn) giữa hai tốc độ trên. Khi tốc độ gần đây lớn hơn 1.5 lần tốc độ tổng thể, phân vùng đó sẽ được gắn cờ ACCELERATING (đang tăng tốc).

## Các bước nhảy đột biến một lần (One-off jumps)
Một bước nhảy giữa hai mẫu dữ liệu lớn hơn 5% kích thước phân vùng được coi là một sự kiện đơn lẻ (một bộ sao lưu mới, một bản dump vừa khôi phục, một tệp tải lên kích thước lớn). Phần dung lượng này vẫn được giữ nguyên trong mức sử dụng hiện tại nhưng được loại bỏ khỏi xu hướng tăng trưởng: các điểm dữ liệu phía sau được dịch xuống một khoảng bằng độ lớn bước nhảy trừ đi mức tăng thông thường, nhằm tránh việc ngoại suy một sự kiện đơn lẻ kéo dài mãi mãi. Bước nhảy này được báo cáo là SUDDEN_JUMP để con người có thể xác nhận xem nó có thực sự là sự kiện một lần hay không. Nếu sự kiện này lặp lại (chẳng hạn sao lưu toàn bộ hàng tuần), hãy thu thập dữ liệu dài hơn để quy luật đó trở thành một phần của xu hướng, hoặc chủ động tính riêng bước nhảy tiếp theo vào kế hoạch.

## Thời gian còn lại (Runway)
Đối với mỗi ngưỡng T trong các mức 80, 90, 95 và 100%:
`số ngày = (T x kích thước - mức dùng hiện tại) / tốc độ tính thời gian cạn kiệt`, được tính từ mẫu dữ liệu cuối cùng. Giá trị bằng 0 nghĩa là ngưỡng đó đã bị vượt qua; "never" (không bao giờ) nghĩa là mức sử dụng đang đi ngang hoặc giảm xuống.
Ngày dự kiến bằng thời điểm của mẫu dữ liệu cuối cùng cộng thêm số ngày còn lại, theo cùng múi giờ với dữ liệu gốc.

## Kích thước đề xuất
Bội số nhỏ nhất của 10 GB giúp giữ mức sử dụng dưới 80% trong toàn bộ khung thời gian dự báo (horizon, mặc định là 90 ngày):
`kích thước >= (mức dùng hiện tại + tốc độ tính thời gian cạn kiệt x khung thời gian) / 0.8`, và không bao giờ nhỏ hơn kích thước hiện tại.
Ví dụ: đã dùng 128 GB, tăng 2 GB/ngày, khung thời gian 180 ngày -> (128 + 360) / 0.8 = 610 GB.

## Các mức trạng thái
| Trạng thái | Quy tắc |
|---|---|
| CRITICAL | Đã dùng từ 95% trở lên, hoặc sẽ đầy trong vòng 7 ngày |
| HIGH | Chạm ngưỡng 90% trong vòng 14 ngày |
| MEDIUM | Chạm ngưỡng 80% trong vòng 30 ngày, hoặc đang tăng tốc, hoặc có bước nhảy đột ngột |
| OK | Không thuộc các trường hợp trên |

## Những giới hạn
- Một đường thẳng không thể nhìn thấy các sự kiện trong tương lai: một đợt di chuyển dữ liệu, một khách hàng mới, hay mức ghi log bị bỏ quên ở chế độ DEBUG.
- Hệ thống tệp (filesystem) thường gặp trục trặc trước khi chạm mức 100%: ext4 dành riêng khoảng 5% cho quyền root, cơ sở dữ liệu cần không gian trống để chạy vacuum, nén dữ liệu (compaction) hoặc xây dựng chỉ mục (index), và một số luồng ghi dữ liệu đã bắt đầu lỗi ở mức 90-95%.
- Cạn kiệt inode (`df -i`) có thể làm đầy ổ đĩa ngay cả khi vẫn còn trống rất nhiều GB; hãy dự báo số lượng inode theo cách tương tự nếu hệ thống ghi nhiều tệp nhỏ.
- Lưu trữ cấp phát mỏng (thin-provisioned) và lưu trữ dùng chung (LVM thin pools, SAN, Ceph) có thể bị đầy ở tầng bên dưới ngay cả khi phân vùng bên trên trông vẫn còn trống.
FILE:references/disk-full-runbook.md
# Sổ tay Xử lý Ổ đĩa Đầy (Disk Full Runbook)

## 1. Tìm nguyên nhân gây tăng dung lượng
```
df -h /mount; df -i /mount                       # dung lượng và số inode
sudo du -xh --max-depth=2 /mount | sort -h | tail -20
sudo find /mount -xdev -type f -size +1G -mtime -7 -exec ls -lh {} +
sudo lsof +L1                                    # các tệp đã xóa nhưng vẫn đang được tiến trình giữ mở
journalctl --disk-usage
docker system df                                 # images, containers, volumes, build cache
```
Các tệp đã xóa nhưng vẫn đang mở sẽ tiếp tục chiếm dung lượng cho đến khi tiến trình khởi động lại hoặc mở lại tệp log.

## 2. Các giải pháp xử lý nhanh an toàn (kiểm tra kỹ trước khi xóa)
| Nguồn tiêu thụ | Hành động |
|---|---|
| Nhật ký ứng dụng (Application logs) | cấu hình logrotate với `compress`, `maxsize`, `rotate N`; đẩy log về hệ thống lưu trữ tập trung |
| Nhật ký systemd (systemd journal) | chạy `journalctl --vacuum-size=1G`, thiết lập `SystemMaxUse=` |
| Docker / CI runners | chạy `docker image prune -a --filter until=168h`, `docker builder prune`; dọn sạch các thư mục làm việc của runner |
| Bộ nhớ đệm gói cài đặt (Package caches) | chạy `apt-get clean`, `dnf clean all`, xóa các bản nhân (kernel) cũ |
| Cơ sở dữ liệu | lưu trữ (archive) hoặc xóa các phân vùng bảng (partition) cũ, chạy `VACUUM` / đóng gói lại bảng (repack), kiểm tra thời gian lưu giữ WAL hoặc binlog và các khe nhân bản (replication slots) bị kẹt |
| Bản sao lưu (Backups) | áp dụng chính sách lưu giữ; chuyển các bộ sao lưu cũ sang lưu trữ đối tượng (object storage) hoặc tầng lưu trữ lạnh (cold tier) |
| Core dumps, heap dumps, tmp | xóa sau khi người phụ trách sự cố xác nhận |
Không bao giờ dùng lệnh `rm` với tệp mà cơ sở dữ liệu đang sử dụng; không bao giờ tự xóa WAL hoặc binlog bằng tay.

## 3. Mở rộng dung lượng (Resize)
- **AWS EBS:** sửa đổi kích thước volume, đợi chuyển sang trạng thái optimizing, sau đó chạy `sudo growpart /dev/nvme0n1 1` và `sudo resize2fs /dev/nvme0n1p1` (đối với ext4) hoặc `sudo xfs_growfs /mount` (đối với xfs). Mỗi volume chỉ được tăng kích thước một lần mỗi 6 giờ.
- **Azure managed disk / GCP persistent disk:** tăng kích thước đĩa (Azure có thể yêu cầu giải phóng VM - deallocate đối với một số loại đĩa), sau đó mở rộng phân vùng và hệ thống tệp theo cách tương tự.
- **LVM:** lệnh `lvextend -r -L +100G vg/lv` sẽ đồng thời mở rộng luôn cả hệ thống tệp.
- **Kubernetes PVC:** chỉnh sửa `spec.resources.requests.storage` khi StorageClass có thiết lập `allowVolumeExpansion: true`.
Các phân vùng có thể mở rộng nhưng hiếm khi thu nhỏ lại được, vì vậy hãy tăng kích thước khớp với mức dự báo chứ đừng tăng vượt quá xa.

## 4. Thiết lập cảnh báo đủ thời gian để xử lý
- Cảnh báo (Warn) ở mức đã dùng 80% hoặc còn 14 ngày dung lượng; gọi trực khẩn cấp (Page) ở mức 90% hoặc còn 3 ngày dung lượng (trên Prometheus dùng các quy tắc dạng `predict_linear(node_filesystem_avail_bytes[6h], 4*3600) < 0`).
- Cảnh báo khi mức sử dụng inode vượt quá 85%.
- Rà soát dung lượng hàng tháng bằng báo cáo của kỹ năng này; cộng thêm mức tăng trưởng dự kiến từ các đợt ra mắt sản phẩm đã lên kế hoạch bằng tay.
FILE:templates/capacity-review.md
# Báo cáo Đánh giá Dung lượng - <dịch vụ / cụm máy chủ> - <ngày>

**Dữ liệu:** <nguồn>, từ <mẫu đầu tiên> đến <mẫu cuối cùng> (<múi giờ>)  **Khung thời gian dự báo:** <90> ngày  **Người đánh giá:** <tên>

## Thời gian cạn kiệt dung lượng (Runway)
| Phân vùng | Trạng thái | Đã dùng | Kích thước | Tốc độ tăng GB/ngày (tổng thể / gần đây) | Chạm 90% vào | Đầy vào | Kích thước đề xuất |
|---|---|---|---|---|---|---|---|
| | | | | | | | |

## Nguyên nhân gây tăng dung lượng
| Phân vùng | Thành phần tiêu thụ chính | Bằng chứng | Đột biến một lần hay diễn ra liên tục |
|---|---|---|---|
| | | | |

## Hành động cần thực hiện
| Phân vùng | Hành động | Người phụ trách | Thời hạn | Dung lượng thu hồi / mở rộng |
|---|---|---|---|---|
| | | | | |

## Cảnh báo
- Cảnh báo (Warning): <80% hoặc còn 14 ngày>  - Gọi trực (Page): <90% hoặc còn 3 ngày>  - Inodes: <85%>

## Đợt rà soát tiếp theo
<ngày>; chạy lại công cụ dự báo với các mẫu dữ liệu mới nhất
FILE:examples/fleet-disk-usage.csv
timestamp,volume,used_gb,size_gb
2026-10-01T06:00,db01:/var/lib/postgresql,300.0,500
2026-10-01T06:00,web01:/var/log,21.0,100
2026-10-01T06:00,ci-runner01:/,110.0,200
2026-10-01T06:00,backup-nas:/srv/backups,2100.0,4000
2026-10-02T06:00,db01:/var/lib/postgresql,303.4,500
2026-10-02T06:00,web01:/var/log,24.4,100
2026-10-02T06:00,ci-runner01:/,111.4,200
2026-10-02T06:00,backup-nas:/srv/backups,2105.4,4000
2026-10-03T06:00,db01:/var/lib/postgresql,305.7,500
2026-10-03T06:00,web01:/var/log,26.7,100
2026-10-03T06:00,ci-runner01:/,111.7,200
2026-10-03T06:00,backup-nas:/srv/backups,2109.7,4000
2026-10-04T06:00,db01:/var/lib/postgresql,309.2,500
2026-10-04T06:00,web01:/var/log,30.2,100
2026-10-04T06:00,ci-runner01:/,113.2,200
2026-10-04T06:00,backup-nas:/srv/backups,2115.2,4000
2026-10-05T06:00,db01:/var/lib/postgresql,311.9,500
2026-10-05T06:00,web01:/var/log,32.9,100
2026-10-05T06:00,ci-runner01:/,113.9,200
2026-10-05T06:00,backup-nas:/srv/backups,2119.9,4000
2026-10-06T06:00,db01:/var/lib/postgresql,315.5,500
2026-10-06T06:00,web01:/var/log,22.5,100
2026-10-06T06:00,ci-runner01:/,115.5,200
2026-10-06T06:00,backup-nas:/srv/backups,2125.5,4000
2026-10-07T06:00,db01:/var/lib/postgresql,317.6,500
2026-10-07T06:00,web01:/var/log,24.6,100
2026-10-07T06:00,ci-runner01:/,115.6,200
2026-10-07T06:00,backup-nas:/srv/backups,2129.6,4000
2026-10-08T06:00,db01:/var/lib/postgresql,321.1,500
2026-10-08T06:00,web01:/var/log,28.1,100
2026-10-08T06:00,ci-runner01:/,117.1,200
2026-10-08T06:00,backup-nas:/srv/backups,2135.1,4000
2026-10-09T06:00,db01:/var/lib/postgresql,324.3,500
2026-10-09T06:00,web01:/var/log,31.3,100
2026-10-09T06:00,ci-runner01:/,118.3,200
2026-10-09T06:00,backup-nas:/srv/backups,2140.3,4000
2026-10-10T06:00,db01:/var/lib/postgresql,326.8,500
2026-10-10T06:00,web01:/var/log,33.8,100
2026-10-10T06:00,ci-runner01:/,118.8,200
2026-10-10T06:00,backup-nas:/srv/backups,2144.8,4000
2026-10-11T06:00,db01:/var/lib/postgresql,330.0,500
2026-10-11T06:00,web01:/var/log,23.0,100
2026-10-11T06:00,ci-runner01:/,120.0,200
2026-10-11T06:00,backup-nas:/srv/backups,2150.0,4000
2026-10-12T06:00,db01:/var/lib/postgresql,333.4,500
2026-10-12T06:00,web01:/var/log,26.4,100
2026-10-12T06:00,ci-runner01:/,121.4,200
2026-10-12T06:00,backup-nas:/srv/backups,2155.4,4000
2026-10-13T06:00,db01:/var/lib/postgresql,335.7,500
2026-10-13T06:00,web01:/var/log,28.7,100
2026-10-13T06:00,ci-runner01:/,121.7,200
2026-10-13T06:00,backup-nas:/srv/backups,2159.7,4000
2026-10-14T06:00,db01:/var/lib/postgresql,339.2,500
2026-10-14T06:00,web01:/var/log,32.2,100
2026-10-14T06:00,ci-runner01:/,123.2,200
2026-10-14T06:00,backup-nas:/srv/backups,2165.2,4000
2026-10-15T06:00,db01:/var/lib/postgresql,341.9,500
2026-10-15T06:00,web01:/var/log,34.9,100
2026-10-15T06:00,ci-runner01:/,123.9,200
2026-10-15T06:00,backup-nas:/srv/backups,2169.9,4000
2026-10-16T06:00,db01:/var/lib/postgresql,345.5,500
2026-10-16T06:00,web01:/var/log,24.5,100
2026-10-16T06:00,ci-runner01:/,130.5,200
2026-10-16T06:00,backup-nas:/srv/backups,2575.5,4000
2026-10-17T06:00,db01:/var/lib/postgresql,347.6,500
2026-10-17T06:00,web01:/var/log,26.6,100
2026-10-17T06:00,ci-runner01:/,135.6,200
2026-10-17T06:00,backup-nas:/srv/backups,2579.6,4000
2026-10-18T06:00,db01:/var/lib/postgresql,351.1,500
2026-10-18T06:00,web01:/var/log,30.1,100
2026-10-18T06:00,ci-runner01:/,142.1,200
2026-10-18T06:00,backup-nas:/srv/backups,2585.1,4000
2026-10-19T06:00,db01:/var/lib/postgresql,354.3,500
2026-10-19T06:00,web01:/var/log,33.3,100
2026-10-19T06:00,ci-runner01:/,148.3,200
2026-10-19T06:00,backup-nas:/srv/backups,2590.3,4000
2026-10-20T06:00,db01:/var/lib/postgresql,356.8,500
2026-10-20T06:00,web01:/var/log,35.8,100
2026-10-20T06:00,ci-runner01:/,153.8,200
2026-10-20T06:00,backup-nas:/srv/backups,2594.8,4000
2026-10-21T06:00,db01:/var/lib/postgresql,360.1,500
2026-10-21T06:00,web01:/var/log,25.1,100
2026-10-21T06:00,ci-runner01:/,160.1,200
2026-10-21T06:00,backup-nas:/srv/backups,2600.1,4000
FILE:scripts/disk_runway.py
#!/usr/bin/env python3
"""Disk capacity runway forecaster (Python 3 standard library only).

Input: CSV with a header row and columns
  timestamp,volume,used_gb,size_gb
timestamp is ISO 8601 ("2026-10-01T00:00", "2026-10-01 06:00" or a date); one row per sample,
any order, several volumes in one file. size_gb may change (a resize); the latest value is used.

Model per volume:
  - growth rate = least-squares slope of used_gb over time (GB/day), plus R^2 for fit quality;
    one-off steps larger than 5% of the size are kept in current usage but removed from the trend
  - recent rate = slope over the last 7 days of samples (or the last third if shorter)
  - runway to 80/90/95/100% full = (threshold x size - used now) / max(rate, recent rate),
    counted from the LAST sample (not from today), so results are reproducible
  - suggested size: smallest whole 10 GB step that keeps the volume under 80% for
    --horizon days (default 90) at the worse of the two rates
Status / findings (severity):
  CRITICAL FULL_SOON       100% within 7 days, or already >= 95% used
  HIGH     RUNWAY_SHORT    90% within 14 days
  MEDIUM   RUNWAY_WATCH    80% within 30 days
  MEDIUM   ACCELERATING    recent rate > 1.5x the overall rate (and > 0.1 GB/day)
  MEDIUM   SUDDEN_JUMP     one step grew by more than 5% of the volume size
  LOW      NOISY_TREND     R^2 < 0.5: usage swings (log rotation, temp files); trust less
  LOW      SHRINKING       usage is falling; no runway
  LOW      FEW_SAMPLES     fewer than 4 samples or under 2 days of data
Usage:
  python3 disk_runway.py usage.csv
  python3 disk_runway.py usage.csv --horizon 180 --json
  python3 disk_runway.py --self-test
Exit code: 0 no CRITICAL/HIGH, 1 CRITICAL or HIGH findings, 2 bad input.
"""
import argparse
import csv
import datetime as dt
import io
import json
import math
import sys

THRESHOLDS = (0.8, 0.9, 0.95, 1.0)


class DataError(ValueError):
    pass


def parse_time(s):
    s = s.strip().replace("Z", "+00:00")
    try:
        t = dt.datetime.fromisoformat(s)
    except ValueError:
        raise DataError(f"bad timestamp {s!r}")
    return t.replace(tzinfo=None) if t.tzinfo is None else t.astimezone(dt.timezone.utc).replace(tzinfo=None)


def read_rows(text):
    rd = csv.DictReader(io.StringIO(text))
    need = {"timestamp", "volume", "used_gb", "size_gb"}
    if not rd.fieldnames or not need <= {f.strip() for f in rd.fieldnames}:
        raise DataError(f"CSV header must contain {', '.join(sorted(need))}")
    vols = {}
    for n, row in enumerate(rd, start=2):
        row = {k.strip(): (v or "").strip() for k, v in row.items() if k}
        if not any(row.values()):
            continue
        try:
            used, size = float(row["used_gb"]), float(row["size_gb"])
        except ValueError:
            raise DataError(f"line {n}: used_gb and size_gb must be numbers")
        if size <= 0 or used < 0:
            raise DataError(f"line {n}: size_gb must be > 0 and used_gb >= 0")
        vols.setdefault(row["volume"] or "(unnamed)", []).append((parse_time(row["timestamp"]), used, size))
    if not vols:
        raise DataError("no data rows")
    return {k: sorted(v) for k, v in vols.items()}


def slope(points):
    """points: [(days, value)] -> (slope per day, r2)"""
    n = len(points)
    if n < 2:
        return 0.0, 0.0
    mx = sum(p[0] for p in points) / n
    my = sum(p[1] for p in points) / n
    sxx = sum((p[0] - mx) ** 2 for p in points)
    if sxx == 0:
        return 0.0, 0.0
    sxy = sum((p[0] - mx) * (p[1] - my) for p in points)
    b = sxy / sxx
    syy = sum((p[1] - my) ** 2 for p in points)
    r2 = 1.0 if syy == 0 else (sxy * sxy) / (sxx * syy)
    return b, r2


def analyze(samples, horizon=90):
    t0 = samples[0][0]
    last_t, used, size = samples[-1]
    # one-off steps (> 5% of size in one sample) are removed from the trend, not extrapolated
    steps = [samples[i][1] - samples[i - 1][1] for i in range(1, len(samples))]
    normal = sorted(x for x in steps if x <= 0.05 * size)
    typical = normal[len(normal) // 2] if normal else 0.0
    shift, pts = 0.0, []
    for i, (t, u, _) in enumerate(samples):
        if i and steps[i - 1] > 0.05 * size:
            shift += steps[i - 1] - typical
        pts.append(((t - t0).total_seconds() / 86400, u - shift))
    span = pts[-1][0]
    rate, r2 = slope(pts)
    cut = pts[-1][0] - 7 if span >= 14 else pts[-1][0] - span / 3
    recent_pts = [p for p in pts if p[0] >= cut]
    recent, _ = slope(recent_pts) if len(recent_pts) >= 2 else (rate, 0)
    worst = max(rate, recent)
    pct = used / size
    runway = {}
    for th in THRESHOLDS:
        left = th * size - used
        if left <= 0:
            runway[th] = (0.0, last_t)
        elif worst > 1e-9:
            d = left / worst
            runway[th] = (d, last_t + dt.timedelta(days=d))
        else:
            runway[th] = (None, None)
    need = used + max(worst, 0) * horizon
    suggest = max(size, math.ceil(need / 0.8 / 10) * 10)
    findings = []

    def f(sev, code, msg):
        findings.append({"severity": sev, "code": code, "message": msg})

    d100, d90, d80 = runway[1.0][0], runway[0.9][0], runway[0.8][0]
    if pct >= 0.95 or (d100 is not None and d100 <= 7):
        f("CRITICAL", "FULL_SOON", f"{pct:.0%} used; full in {fmt_days(d100)}")
    elif d90 is not None and d90 <= 14:
        f("HIGH", "RUNWAY_SHORT", f"90% in {fmt_days(d90)}")
    elif d80 is not None and d80 <= 30:
        f("MEDIUM", "RUNWAY_WATCH", f"80% in {fmt_days(d80)}")
    if rate > 0 and recent > 1.5 * rate and recent > 0.1:
        f("MEDIUM", "ACCELERATING", f"last-week rate {recent:.2f} GB/day vs overall {rate:.2f} GB/day")
    jumps = [(samples[i][0], samples[i][1] - samples[i - 1][1]) for i in range(1, len(samples))]
    big = [j for j in jumps if j[1] > 0.05 * size]
    if big:
        t, g = max(big, key=lambda j: j[1])
        f("MEDIUM", "SUDDEN_JUMP", f"+{g:.1f} GB in one step at {t:%Y-%m-%d %H:%M} (backup, dump, log burst?)")
    if len(pts) >= 4 and r2 < 0.5 and worst > 0:
        f("LOW", "NOISY_TREND", f"R^2 {r2:.2f}; usage swings, so treat the runway as rough")
    if worst < 0:
        f("LOW", "SHRINKING", f"usage falling {rate:.2f} GB/day")
    if len(pts) < 4 or span < 2:
        f("LOW", "FEW_SAMPLES", f"{len(pts)} samples over {span:.1f} days; collect more data")
    rank = {"CRITICAL": 0, "HIGH": 1, "MEDIUM": 2, "LOW": 3}
    findings.sort(key=lambda x: rank[x["severity"]])
    return {"last_sample": last_t.strftime("%Y-%m-%d %H:%M"), "used_gb": round(used, 2), "size_gb": size,
            "used_pct": round(pct * 100, 1), "rate_gb_day": round(rate, 3), "recent_rate_gb_day": round(recent, 3),
            "r2": round(r2, 3), "samples": len(pts), "span_days": round(span, 2),
            "runway": {f"{int(th * 100)}%": {"days": None if d is None else round(d, 1),
                                             "date": None if t is None else t.strftime("%Y-%m-%d")}
                       for th, (d, t) in runway.items()},
            "suggested_size_gb": suggest, "horizon_days": horizon, "findings": findings,
            "status": findings[0]["severity"] if findings and findings[0]["severity"] in ("CRITICAL", "HIGH", "MEDIUM") else "OK"}


def fmt_days(d):
    if d is None:
        return "never at current rate"
    if d <= 0:
        return "already"
    if d < 1:
        return f"{d * 24:.0f} h"
    return f"{d:.1f} days"


def report(res, horizon):
    out = ["# Disk runway report", "", f"Runway uses the worse of the overall and last-week growth rate; suggested size keeps usage under 80% for {horizon} days.", "",
           "| Volume | Status | Used | Size | Growth GB/day (overall / recent) | 80% | 90% | 100% | Suggested size |",
           "|---|---|---|---|---|---|---|---|---|"]
    order = {"CRITICAL": 0, "HIGH": 1, "MEDIUM": 2, "OK": 3}
    for name, r in sorted(res.items(), key=lambda kv: (order[kv[1]["status"]], kv[0])):
        def cell(k):
            x = r["runway"][k]
            if x["days"] is None:
                return "never"
            return "now" if x["days"] == 0 else f"{x['days']} d ({x['date']})"
        out.append(f"| {name} | {r['status']} | {r['used_gb']:g} GB ({r['used_pct']}%) | {r['size_gb']:g} GB | "
                   f"{r['rate_gb_day']} / {r['recent_rate_gb_day']} | {cell('80%')} | {cell('90%')} | {cell('100%')} | "
                   f"{r['suggested_size_gb']:g} GB |")
    out += ["", "## Findings"]
    any_f = False
    for name, r in sorted(res.items(), key=lambda kv: (order[kv[1]["status"]], kv[0])):
        for x in r["findings"]:
            any_f = True
            out.append(f"- **{x['severity']} {x['code']}** ({name}): {x['message']}")
    if not any_f:
        out.append("- none")
    out += ["", "Last samples: " + ", ".join(f"{n} {r['last_sample']} ({r['samples']} samples, {r['span_days']} days, R^2 {r['r2']})" for n, r in sorted(res.items()))]
    return "\n".join(out) + "\n"


def run(text, horizon=90):
    if horizon <= 0:
        raise DataError("horizon must be > 0")
    return {name: analyze(s, horizon) for name, s in read_rows(text).items()}


def self_test():
    cases = []

    def ok(name, cond):
        cases.append(bool(cond))
        print(("PASS " if cond else "FAIL ") + name)

    b, r2 = slope([(0, 10), (1, 12), (2, 14)])
    ok("slope 2/day exact fit", abs(b - 2) < 1e-9 and abs(r2 - 1) < 1e-9)
    ok("flat slope 0", slope([(0, 5), (1, 5), (2, 5)])[0] == 0)
    hdr = "timestamp,volume,used_gb,size_gb\n"
    lin = hdr + "".join(f"2026-10-{d:02d},v,{100 + 2 * d},500\n" for d in range(1, 15))
    r = run(lin)["v"]
    ok("rate 2 GB/day", abs(r["rate_gb_day"] - 2) < 1e-6)
    ok("80% runway (400-128)/2 = 136 d", r["runway"]["80%"]["days"] == 136.0)
    ok("runway date from last sample", r["runway"]["100%"]["date"] == "2027-04-18")
    ok("healthy volume status OK", r["status"] == "OK" and r["findings"] == [])
    ok("suggested size keeps 500", r["suggested_size_gb"] == 500)
    r = run(lin, horizon=180)["v"]
    ok("180 d horizon suggests 610", r["suggested_size_gb"] == 610)
    full = hdr + "".join(f"2026-10-{d:02d},v,{80 + 3 * d},100\n" for d in range(1, 6))
    r = run(full)["v"]
    ok("95% used is CRITICAL", r["status"] == "CRITICAL" and r["findings"][0]["code"] == "FULL_SOON")
    ok("past threshold runway is 0", r["runway"]["90%"]["days"] == 0)
    short = hdr + "".join(f"2026-10-{d:02d},v,{50 + 3 * d},100\n" for d in range(1, 8))
    r = run(short)["v"]
    ok("90% in ~6 days is HIGH", r["status"] == "HIGH")
    watch = hdr + "".join(f"2026-10-{d:02d},v,{40 + d},100\n" for d in range(1, 8))
    ok("80% in 33 d is OK, 80% in 26 d is MEDIUM", run(watch)["v"]["status"] == "OK" and
       run(hdr + "".join(f"2026-10-{d:02d},v,{47 + d},100\n" for d in range(1, 8)))["v"]["status"] == "MEDIUM")
    acc = hdr + "".join(f"2026-10-{d:02d},v,{100 + (d if d <= 14 else 14 + 5 * (d - 14))},1000\n" for d in range(1, 22))
    r = run(acc)["v"]
    ok("accelerating flagged", any(x["code"] == "ACCELERATING" for x in r["findings"]))
    ok("recent rate used for runway", r["recent_rate_gb_day"] > r["rate_gb_day"])
    jump = hdr + "2026-10-01,v,100,500\n2026-10-02,v,101,500\n2026-10-03,v,140,500\n2026-10-04,v,141,500\n"
    r = run(jump)["v"]
    ok("sudden jump flagged", any(x["code"] == "SUDDEN_JUMP" for x in r["findings"]))
    ok("jump removed from trend (1 GB/day)", abs(r["rate_gb_day"] - 1) < 1e-6 and r["used_gb"] == 141)
    noisy = hdr + "".join(f"2026-10-{d:02d},v,{100 + (8 if d % 2 else 0) + 0.3 * d:.1f},500\n" for d in range(1, 21))
    ok("noisy trend flagged", any(x["code"] == "NOISY_TREND" for x in run(noisy)["v"]["findings"]))
    shr = hdr + "".join(f"2026-10-{d:02d},v,{200 - 3 * d},500\n" for d in range(1, 8))
    r = run(shr)["v"]
    ok("shrinking flagged and runway never", any(x["code"] == "SHRINKING" for x in r["findings"]) and r["runway"]["100%"]["days"] is None)
    few = hdr + "2026-10-01T00:00,v,10,100\n2026-10-01T12:00,v,11,100\n"
    ok("few samples flagged", any(x["code"] == "FEW_SAMPLES" for x in run(few)["v"]["findings"]))
    multi = hdr + "2026-10-02,b,5,100\n2026-10-01,a,1,100\n2026-10-01,b,4,100\n2026-10-02,a,1,100\n"
    r = run(multi)
    ok("multiple volumes, unsorted rows", set(r) == {"a", "b"} and r["b"]["rate_gb_day"] == 1)
    ok("resize uses latest size", run(hdr + "2026-10-01,v,50,100\n2026-10-02,v,52,200\n")["v"]["size_gb"] == 200)
    ok("fmt_days hours", fmt_days(0.5) == "12 h")
    for bad, label in (("a,b\n1,2\n", "missing columns"), (hdr, "no rows"), (hdr + "x,v,1,10\n", "bad timestamp"),
                       (hdr + "2026-10-01,v,abc,10\n", "bad number"), (hdr + "2026-10-01,v,1,0\n", "zero size")):
        try:
            run(bad)
            ok(label + " rejected", False)
        except DataError:
            ok(label + " rejected", True)
    print(f"{sum(cases)}/{len(cases)} passed")
    return 0 if all(cases) else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="Forecast when disks fill up from usage samples.")
    ap.add_argument("file", nargs="?", help="CSV: timestamp,volume,used_gb,size_gb")
    ap.add_argument("--horizon", type=int, default=90, help="days of runway the suggested size must cover (default 90)")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    if not a.file:
        ap.error("give a CSV file or --self-test")
    try:
        res = run(open(a.file, encoding="utf-8").read(), a.horizon)
    except (OSError, DataError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(res, indent=2) if a.json else report(res, a.horizon), end="\n" if a.json else "")
    return 1 if any(r["status"] in ("CRITICAL", "HIGH") for r in res.values()) else 0


if __name__ == "__main__":
sys.exit(main())Tính toán lượng sơn cần mua cho một hoặc nhiều phòng cùng chi phí tương ứng. Đo diện tích tường (trừ cửa ra vào và cửa sổ) và trần nhà, áp dụng số lớp sơn, độ phủ, độ nhám bề mặt và tỷ lệ hao hụt, cộng dồn từng loại sơn qua các phòng và chọn cách phối hợp các cỡ thùng sơn rẻ nhất với lượng sơn thừa ít nhất. Cảnh báo các trường hợp đổi từ màu tối sang màu sáng và tường trát mới cần sơn lót, các kế hoạch chỉ sơn một lớp, độ phủ hoặc chiều cao đáng ngờ và lượng sơn thừa quá nhiều. Bao gồm công cụ ước tính viết bằng thư viện chuẩn Python kèm tùy chọn --self-test.
---
name: room-paint-quantity-estimator
description: Tính toán lượng sơn cần mua cho một hoặc nhiều phòng cùng chi phí tương ứng. Đo diện tích tường (trừ cửa ra vào và cửa sổ) và trần nhà, áp dụng số lớp sơn, độ phủ, độ nhám bề mặt và tỷ lệ hao hụt, cộng dồn từng loại sơn qua các phòng và chọn cách phối hợp các cỡ thùng sơn rẻ nhất với lượng sơn thừa ít nhất. Cảnh báo các trường hợp đổi từ màu tối sang màu sáng và tường trát mới cần sơn lót, các kế hoạch chỉ sơn một lớp, độ phủ hoặc chiều cao đáng ngờ và lượng sơn thừa quá nhiều. Bao gồm công cụ ước tính viết bằng thư viện chuẩn Python kèm tùy chọn --self-test.
---

# Công cụ Ước tính Lượng Sơn Phòng

Bạn giúp những người đang sơn lại nhà mua đúng lượng sơn ngay từ lần đầu tiên: không phải đi lại cửa hàng ba lần, cũng không để nhà kho chất đầy những thùng sơn dùng dở. Từ kích thước các phòng và những loại sơn họ đã chọn, bạn tính toán diện tích, số lít (hoặc gallon), cách chọn mua các thùng sơn rẻ nhất và tổng chi phí, đồng thời chỉ ra các bước chuẩn bị làm thay đổi con số tính toán, chẳng hạn như sơn lót đè lên màu tối hoặc tường mới trát.

## Các tệp trong kỹ năng này

- `scripts/paint_estimate.py` - tính toán diện tích, lượng sơn cho mỗi bề mặt, cách kết hợp thùng sơn rẻ nhất cho từng loại sơn, lượng sơn thừa, tổng chi phí và các phát hiện lưu ý (chỉ dùng thư viện chuẩn Python 3)
- `references/measuring-and-coverage.md` - cách đo phòng, kích thước cửa ra vào và cửa sổ tiêu chuẩn, độ phủ trên nhãn so với thực tế, hệ số độ nhám bề mặt, quy tắc về số lớp sơn và sơn lót
- `references/painting-prep-and-buying-guide.md` - thứ tự chuẩn bị, các loại sơn lót, độ bóng bề mặt theo từng phòng, danh sách dụng cụ, mẹo chọn mua, bảo quản sơn thừa
- `templates/paint-shopping-list.md` - danh sách mua sắm và kế hoạch sơn từng phòng để in ra hoặc mang tới cửa hàng
- `examples/two-bedroom-flat-refresh.json` - bốn phòng trong một căn hộ với một phòng ngủ màu tối chuyển sang màu sáng, tường thạch cao mới trong phòng trẻ em và ba loại sơn tính bằng đồng lira Thổ Nhĩ Kỳ

## Quy trình làm việc

### 1. Thu thập thông tin các phòng
Hỏi thông tin cho từng phòng: chiều dài, chiều rộng và chiều cao trần, số lượng và kích thước cửa ra vào cùng cửa sổ (hoặc dùng kích thước tiêu chuẩn trong `references/measuring-and-coverage.md`), những bề mặt cần sơn (tường, trần), màu hiện tại (sáng, trung bình, tối), màu mới, độ nhám bề mặt tường, và liệu có bề mặt nào là tường trát mới hay thạch cao mới không. Hỏi về các loại sơn kèm độ phủ mỗi lớp ghi trên nhãn thùng cùng các kích cỡ thùng và giá bán tại cửa hàng của họ. Sử dụng hệ mét trừ khi họ làm việc với đơn vị feet và gallon.

### 2. Chạy công cụ ước tính
```
python3 scripts/paint_estimate.py examples/two-bedroom-flat-refresh.json
python3 scripts/paint_estimate.py job.json --json
python3 scripts/paint_estimate.py --self-test
```
Mã thoát (exit code) 1 nghĩa là có các phát hiện mức HIGH (số đo không hợp lý, không tìm được cách kết hợp thùng sơn), 2 nghĩa là dữ liệu đầu vào bị lỗi.

### 3. Điều chỉnh kế hoạch
Xử lý dựa trên các phát hiện: thêm sơn lót (và lượng sơn lót riêng, tính theo độ phủ của sơn lót) đối với DARK_TO_LIGHT và NEW_SURFACE, hoặc tăng số lớp sơn lên 3; đổi các kế hoạch sơn một lớp thành hai lớp trừ khi loại sơn đó được bán dưới dạng sơn một lớp phủ lên cùng màu cũ. Chạy lại sau mỗi lần thay đổi. Sử dụng `references/painting-prep-and-buying-guide.md` để tư vấn về độ hoàn thiện bề mặt và dụng cụ.

### 4. Bàn giao kết quả
Điền vào `templates/paint-shopping-list.md` các thùng sơn cần mua, sơn lót, dụng cụ và thứ tự thi công. Nhắc họ mua tất cả các thùng của cùng một màu từ cùng một lô sản xuất (batch), hoặc trộn đều (box) chúng với nhau trước khi sử dụng.

## Kết quả ví dụ
Đối với `examples/two-bedroom-flat-refresh.json`: tường màu trắng ấm cần 20.87 L -> 1 x 15 L + 1 x 7.5 L (3,640 TRY); phòng trẻ em màu xanh xô thơm (sage green) cần 6.87 L -> 1 x 7.5 L (1,450 TRY); trần nhà cần 8.75 L -> 3 x 3.5 L (1,380 TRY); tổng cộng 6,470 TRY trước khi tính sơn lót và dụng cụ. Các phát hiện: phòng ngủ chính màu tối cần sơn lót hoặc sơn lớp thứ ba, tường thạch cao mới ở phòng trẻ em cần một lớp sơn lót loãng (mist coat) hoặc sơn lót chuyên dụng, và việc chỉ sơn một lớp cho trần phòng này sẽ khiến bề mặt bị loang lổ.

## Quy tắc

- Luôn sử dụng độ phủ in trên thùng sơn của người dùng thay vì một con số chung chung bất cứ khi nào họ có thông tin đó.
- Làm tròn lên thành các thùng nguyên; không bao giờ gợi ý kéo giãn lượng sơn bằng cách pha loãng vượt quá hướng dẫn của nhà sản xuất.
- Đề cập đến yếu tố an toàn ở những chỗ quan trọng: thông gió, đặt thang trên mặt phẳng vững chắc, kiểm tra sơn chứa chì trong các ngôi nhà xây trước khoảng năm 1980 trước khi chà nhám.
- Giá cả dựa theo thông tin người dùng đưa; nói rõ rằng tổng chi phí chưa bao gồm sơn lót, dụng cụ và nhân công trừ khi đã được tính gộp vào.
FILE:references/measuring-and-coverage.md
# Đo đạc và Độ phủ

## Đo một căn phòng
- Đo chiều dài và chiều rộng ở sát mặt sàn và đo chiều cao trần tại một hoặc hai vị trí; làm tròn lên đến mức 5 cm (hoặc 2 in) gần nhất.
- Diện tích tường = chu vi x chiều cao = 2 x (chiều dài + chiều rộng) x chiều cao. Đối với phòng hình chữ L, hãy cộng diện tích chiều rộng x chiều cao của từng bức tường lại với nhau.
- Diện tích trần = chiều dài x chiều rộng (cộng riêng các phần trần vát nghiêng).
- Trừ đi cửa ra vào và cửa sổ; giữ nguyên không trừ bất cứ phần nào nhỏ hơn khoảng 0.5 m2 (5 sq ft), vì đằng nào lượng sơn đó cũng dùng để sơn khung viền và đi đường nét cắt góc (cutting-in).

## Kích thước tiêu chuẩn (khi người dùng không biết)
| Hạng mục | Hệ mét (Metric) | Hệ Anh/Mỹ (Imperial) |
|---|---|---|
| Cửa thông phòng | 0.8-0.9 x 2.0-2.05 m (khoảng 1.8 m2) | 30-36 x 80 in (khoảng 20 sq ft) |
| Cửa ban công / hiên nhà | 1.6-1.8 x 2.2 m | 6 x 6.7 ft |
| Cửa sổ | 1.2-1.5 x 1.2-1.4 m | 3 x 4 ft (khoảng 12-15 sq ft) |
| Chiều cao trần | 2.5-2.8 m (căn hộ mới), lên tới 3.5 m (tòa nhà cũ) | 8-9 ft |

## Độ phủ
- Nhãn thùng sơn cho biết độ phủ trên mỗi lớp, thường là 10-14 m2/L đối với sơn nước (emulsion) (khoảng 350-400 sq ft trên mỗi gallon Mỹ). Độ phủ thực tế thường thấp hơn 10-20%; mức dự phòng hao hụt (mặc định 10%) dùng để bù cho lượng sơn bám vào con lăn, khay sơn và việc dặm vá.
- Hệ số độ nhám bề mặt được công cụ ước tính sử dụng: nhẵn mịn (smooth) x1.0, nhám nhẹ (light texture: giấy dán tường dăm gỗ, sần vỏ cam, trát mỏng) x1.1, thô nhám (rough: gạch trần, vữa gai stucco, trần sần bỏng ngô) x1.25.
- Tường mới trát vữa và tường thạch cao trần hút sơn như bọt biển: hãy khóa bề mặt trước bằng một lớp sơn lót loãng (mist coat - sơn nước pha loãng theo tỷ lệ nhà sản xuất cho phép) hoặc sơn lót chuyên dụng cho thạch cao.

## Số lớp sơn
| Tình huống | Kế hoạch |
|---|---|
| Cùng màu hoặc màu tương tự, bề mặt tốt | 2 lớp (1 lớp nếu sơn được bán là loại sơn một lớp và sơn cùng màu cũ) |
| Màu sáng đè lên màu tối | sơn lót chặn vết ố hoặc sơn lót pha màu + 2 lớp sơn phủ, hoặc 3 lớp sơn phủ |
| Màu tối hoặc màu đậm đè lên màu sáng | sơn lót pha ánh xám + 2 lớp sơn phủ; màu đỏ và vàng có thể cần 3 lớp |
| Tường mới trát hoặc thạch cao mới | lớp sơn lót loãng (mist coat) hoặc sơn lót + 2 lớp sơn phủ |
| Trần nhà | 2 lớp sơn trắng trần nhà; 1 lớp trông sẽ bị loang lổ khi nhìn ngược sáng |

## Kiểm tra nhanh bằng cách tính nhẩm
Số lít = diện tích x số lớp x hệ số độ nhám / độ phủ x 1.1. Ví dụ: 35 m2 tường, 2 lớp, 10 m2/L, bề mặt nhẵn -> 7 L trước hao hụt, 7.7 L khi tính thêm 10% hao hụt.
FILE:references/painting-prep-and-buying-guide.md
# Hướng dẫn Chuẩn bị Sơn và Chọn mua

## Thứ tự thi công
1. Dọn dẹp và che chắn: chuyển đồ đạc vào giữa phòng, phủ bạt che sàn, tháo mặt công tắc/ổ cắm (ngắt điện khi làm việc gần ổ cắm).
2. Sửa chữa bề mặt:ek/trám các vết nứt và lỗ thủng, chà nhám cho phẳng, lau sạch bụi; rửa sạch tường bếp bám dầu mỡ bằng xà phòng tẩy rửa chuyên dụng (sugar soap).
3. Sơn lót ở những chỗ cần thiết (vết ố, chỗ trám vá, màu tối, tường mới trát).
4. Sơn trần trước, sau đó đến tường, cuối cùng là phào chỉ và cửa.
5. Dùng cọ quét viền các mép góc (cut in), sau đó dùng con lăn lăn theo từng mảng khi phần viền vẫn còn ướt để tránh để lại vệt nối.
6. Để mỗi lớp sơn khô theo đúng thời gian ghi trên thùng (thường là 2-4 giờ đối với sơn nước) trước khi sơn lớp tiếp theo.

## Sơn lót
| Vấn đề | Loại sơn lót |
|---|---|
| Vết ố nước, khói, bút dạ | sơn lót chặn vết ố (gốc cánh kiến shellac hoặc gốc dầu cho các vết ố nặng) |
| Màu sáng đè lên màu tối | sơn lót đa năng màu trắng hoặc pha màu nhạt |
| Tường trát vữa mới | lớp sơn lót loãng (mist coat) hoặc dung dịch khóa bề mặt vữa |
| Tường thạch cao mới | sơn lót thạch cao (gốc PVA) |
| Lớp sơn cũ bóng | chà nhám nhẹ, sau đó dùng sơn lót tăng độ bám dính |
Độ phủ của sơn lót thường là 8-12 m2/L; hãy ước tính tương tự như sơn phủ với 1 lớp.

## Độ bóng bề mặt theo từng phòng
| Phòng | Độ hoàn thiện (Finish) | Lý do |
|---|---|---|
| Trần nhà | mịn mờ (flat / matte) | che khuyết điểm, không bị chói sáng |
| Phòng khách và phòng ngủ | mịn mờ (matte) hoặc bóng mờ vỏ trứng (eggshell) | vẻ ngoài dịu mắt; dùng loại mịn mờ có thể lau chùi cho gia đình |
| Phòng trẻ em, hành lang | mịn mờ có thể lau chùi hoặc bóng mờ vỏ trứng (eggshell) | chịu được cọ rửa |
| Nhà bếp và phòng tắm | bóng lụa (satin) hoặc sơn chuyên dụng cho bếp/phòng tắm | chống ẩm và chống bám dầu mỡ |
| Cửa và phào chỉ | bóng lụa (satin) hoặc bán bóng (semi-gloss) | bền, dễ lau sạch |

## Dụng cụ cho một căn hộ điển hình
Con lăn (9 in / 23 cm) kèm cán nối dài, khay sơn hoặc xô có lưới gạt, cọ vát góc (5 cm), băng dính giấy che sơn, bạt che sàn, bột trét và dao bả, giấy nhám (độ nhám 120-180 grit), thang chữ A chắc chắn, giẻ lau, găng tay. Mỗi màu sơn dùng một ống bông lăn riêng.

## Mẹo chọn mua
- Giá mỗi lít thường rẻ hơn khi mua thùng lớn; công cụ ước tính sẽ so sánh giá bán thực tế tại cửa hàng.
- Mua tất cả các thùng của cùng một màu cùng lúc (cùng lô sản xuất). Nếu bạn mở nhiều hơn một thùng, hãy đổ chung vào một xô lớn để trộn đều (boxing) giúp màu sơn đồng nhất.
- Giữ lại khoảng 0.5 L mỗi màu để dặm vá về sau.
- Sơn hàm lượng VOC thấp (Low-VOC) giúp giảm mùi; dù vậy vẫn nên mở cửa sổ và nghỉ giải lao định kỳ.

## Xử lý sơn thừa
Đậy chặt nắp, úp ngược thùng bảo quản ở nơi có nhiệt độ trên mức đóng băng, dán nhãn ghi tên phòng và ngày sơn. Không đổ sơn xuống cống rãnh; hãy mang sơn đã khô hoặc sơn lỏng đến điểm thu gom chất thải hoặc tái chế tại địa phương.
FILE:templates/paint-shopping-list.md
# Danh sách Mua sắm Sơn - <nhà / dự án> - <ngày>

**Đơn vị:** <hệ mét / hệ Anh-Mỹ>  **Dự phòng hao hụt:** <10%>  **Cửa hàng:** <tên>

## Các phòng
| Phòng | Bề mặt | Diện tích | Số lớp | Loại sơn | Ghi chú (sơn lót, sửa chữa) |
|---|---|---|---|---|---|
| | | | | | |

## Sơn cần mua
| Loại sơn (thương hiệu, mã màu, độ bóng) | Lượng cần | Số thùng | Giá |
|---|---|---|---|
| | | | |

## Sơn lót và vật tư
- [ ] Sơn lót: <loại>, <số lượng>
- [ ] Khung con lăn <n>, ống bông lăn <n>, khay sơn, cán nối dài
- [ ] Cọ sơn <kích cỡ>, băng dính che sơn <số cuộn>, bạt phủ <n>
- [ ] Bột trét, giấy nhám, xà phòng rửa tường (sugar soap)

**Tổng chi phí ước tính:** <sơn> + <sơn lót và vật tư> = <tổng cộng>

## Thứ tự thi công
1. Chuẩn bị và sửa chữa: <các phòng>
2. Sơn lót: <các phòng>
3. Trần nhà: <các phòng>
4. Tường: <các phòng>
5. Phào chỉ và cửa: <các phòng>
FILE:examples/two-bedroom-flat-refresh.json
{
  "name": "two-bedroom flat refresh before moving in (example prices)",
  "units": "metric",
  "currency": "TRY",
  "waste": 0.1,
  "paints": {
    "wall matte warm white": {"coverage": 11, "cans": [{"size": 15, "price": 2350}, {"size": 7.5, "price": 1290}, {"size": 2.5, "price": 520}]},
    "sage green (kids room)": {"coverage": 10, "cans": [{"size": 7.5, "price": 1450}, {"size": 2.5, "price": 590}, {"size": 0.75, "price": 240}]},
    "ceiling white": {"coverage": 12, "cans": [{"size": 15, "price": 1650}, {"size": 3.5, "price": 460}]}
  },
  "rooms": [
    {"name": "living room", "length": 5.4, "width": 4.2, "height": 2.7,
     "openings": [{"type": "door", "w": 0.9, "h": 2.05}, {"type": "balcony door", "w": 1.8, "h": 2.2}, {"type": "window", "w": 1.5, "h": 1.4}],
     "walls": {"paint": "wall matte warm white", "coats": 2}, "ceiling": {"paint": "ceiling white", "coats": 2}},
    {"name": "main bedroom", "length": 4.0, "width": 3.5, "height": 2.7, "previous": "dark", "new": "light",
     "openings": [{"type": "door", "w": 0.9, "h": 2.05}, {"type": "window", "w": 1.4, "h": 1.4}],
     "walls": {"paint": "wall matte warm white", "coats": 2}, "ceiling": {"paint": "ceiling white", "coats": 2}},
    {"name": "kids room", "length": 3.4, "width": 3.0, "height": 2.7, "new_surface": true,
     "openings": [{"type": "door", "w": 0.8, "h": 2.05}, {"type": "window", "w": 1.2, "h": 1.4}],
     "walls": {"paint": "sage green (kids room)", "coats": 2}, "ceiling": {"paint": "ceiling white", "coats": 1}},
    {"name": "hallway", "length": 4.5, "width": 1.2, "height": 2.7, "texture": "light",
     "openings": [{"type": "doors", "w": 0.9, "h": 2.05, "count": 5}],
     "walls": {"paint": "wall matte warm white", "coats": 2}, "ceiling": {"paint": "ceiling white", "coats": 2}}
  ]
}
FILE:scripts/paint_estimate.py
#!/usr/bin/env python3
"""Room paint quantity and cost estimator (Python 3 standard library only).

Input: a painting job JSON file:
  {"units": "metric", "waste": 0.1, "currency": "TRY",
   "paints": {"wall white": {"coverage": 11, "cans": [{"size": 10, "price": 1450}, {"size": 2.5, "price": 450}]}},
   "rooms": [{"name": "living room", "length": 5.2, "width": 4.1, "height": 2.7,
              "openings": [{"type": "door", "w": 0.9, "h": 2.05}, {"type": "window", "w": 1.6, "h": 1.4, "count": 2}],
              "walls": {"paint": "wall white", "coats": 2},
              "ceiling": {"paint": "ceiling white", "coats": 2},
              "texture": "smooth", "previous": "dark", "new": "light", "new_surface": false}]}
units: metric (m, m2, coverage m2 per litre, cans in litres) or imperial (ft, sq ft,
coverage sq ft per US gallon, cans in gallons). coverage = per coat, from the paint can.
Areas: walls = 2 x (length + width) x height - openings; ceiling = length x width.
texture: smooth (x1.0), light (x1.1, e.g. woodchip, orange peel), rough (x1.25, brick, stucco)
multiplies the paint needed. waste (default 0.10) adds rollers, trays, touch-ups.
Volume per surface = area x coats x texture / coverage x (1 + waste); volumes for the same paint
are added up across rooms, then the cheapest can mix that covers it is chosen (fewer litres
left over on ties).
Findings: OPENINGS_TOO_LARGE (HIGH), NO_CAN_MIX (HIGH), DARK_TO_LIGHT and NEW_SURFACE
(MEDIUM: primer or an extra coat), ONE_COAT, COVERAGE_SUSPECT, ODD_HEIGHT, BIG_LEFTOVER (LOW).
Usage:
  python3 paint_estimate.py job.json
  python3 paint_estimate.py job.json --json
  python3 paint_estimate.py --self-test
Exit code: 0 OK, 1 HIGH findings, 2 bad input.
"""
import argparse
import json
import math
import sys

TEXTURE = {"smooth": 1.0, "light": 1.1, "rough": 1.25}
UNITS = {"metric": {"len": "m", "area": "m2", "vol": "L", "cov": (6, 16), "height": (2.2, 4.0)},
         "imperial": {"len": "ft", "area": "sq ft", "vol": "gal", "cov": (250, 450), "height": (7.0, 13.0)}}
LIGHTNESS = {"light": 0, "medium": 1, "dark": 2}


class JobError(ValueError):
    pass


def num(x, what, minimum=0.0, strict=True):
    if isinstance(x, bool) or not isinstance(x, (int, float)) or (x <= minimum if strict else x < minimum):
        raise JobError(f"{what} must be a number {'>' if strict else '>='} {minimum:g}")
    return float(x)


def best_mix(need, cans):
    """Cheapest combination of cans with total size >= need; ties -> less leftover, fewer cans."""
    cans = sorted(cans, key=lambda c: -c["size"])
    best = None

    def rec(i, vol, cost, picked):
        nonlocal best
        if vol >= need - 1e-9:
            key = (round(cost, 6), round(vol - need, 6), sum(picked))
            if best is None or key < best[0]:
                best = (key, list(picked), vol, cost)
            return
        if i == len(cans) or (best is not None and cost > best[0][0] + 1e-9):
            return
        c = cans[i]
        top = math.ceil((need - vol) / c["size"] - 1e-9)
        for k in ([top] if i == len(cans) - 1 else range(top, -1, -1)):
            picked.append(k)
            rec(i + 1, vol + k * c["size"], cost + k * c["price"], picked)
            picked.pop()

    if need <= 0:
        return {"cans": [], "volume": 0.0, "cost": 0.0, "leftover": 0.0}
    rec(0, 0.0, 0.0, [])
    if best is None:
        return None
    _, picked, vol, cost = best
    return {"cans": [{"size": c["size"], "count": k, "price": c["price"]} for c, k in zip(cans, picked) if k],
            "volume": vol, "cost": cost, "leftover": vol - need}


def estimate(job):
    units = str(job.get("units", "metric")).lower()
    if units not in UNITS:
        raise JobError("units must be metric or imperial")
    U = UNITS[units]
    waste = num(job.get("waste", 0.1), "waste", 0, strict=False)
    paints = job.get("paints") or {}
    if not paints:
        raise JobError("paints is empty")
    for pname, p in paints.items():
        num(p.get("coverage"), f"paint {pname!r} coverage")
        if not p.get("cans"):
            raise JobError(f"paint {pname!r} has no cans")
        for c in p["cans"]:
            num(c.get("size"), f"paint {pname!r} can size")
            num(c.get("price", 0), f"paint {pname!r} can price", 0, strict=False)
    rooms = job.get("rooms") or []
    if not rooms:
        raise JobError("rooms is empty")
    findings, lines, need = [], [], {}

    def f(sev, code, where, msg):
        findings.append({"severity": sev, "code": code, "where": where, "message": msg})

    for r in rooms:
        name = r.get("name") or "room"
        L, W, H = (num(r.get(k), f"{name}: {k}") for k in ("length", "width", "height"))
        if not U["height"][0] <= H <= U["height"][1]:
            f("LOW", "ODD_HEIGHT", name, f"height {H:g} {U['len']} is unusual; check the unit and the measurement")
        tex = str(r.get("texture", "smooth")).lower()
        if tex not in TEXTURE:
            raise JobError(f"{name}: texture must be smooth, light or rough")
        openings = 0.0
        for o in r.get("openings") or []:
            cnt = o.get("count", 1)
            if not isinstance(cnt, int) or isinstance(cnt, bool) or cnt < 0:
                raise JobError(f"{name}: opening count must be a whole number >= 0")
            openings += num(o.get("w"), f"{name}: opening w") * num(o.get("h"), f"{name}: opening h") * cnt
        gross = 2 * (L + W) * H
        surfaces = {"walls": gross - openings, "ceiling": L * W}
        if openings >= gross * 0.6:
            f("HIGH", "OPENINGS_TOO_LARGE", name, f"openings {openings:.1f} {U['area']} are {openings / gross:.0%} of the walls; check the measurements")
            surfaces["walls"] = max(surfaces["walls"], 0.0)
        prev, new = r.get("previous"), r.get("new")
        for sname in ("walls", "ceiling"):
            s = r.get(sname)
            if not s:
                continue
            pname = s.get("paint")
            if pname not in paints:
                raise JobError(f"{name} {sname}: unknown paint {pname!r}")
            coats = s.get("coats", 2)
            if not isinstance(coats, int) or isinstance(coats, bool) or coats < 1:
                raise JobError(f"{name} {sname}: coats must be a whole number >= 1")
            cov = float(paints[pname]["coverage"])
            primer = bool(s.get("primer"))
            if sname == "walls" and prev in LIGHTNESS and new in LIGHTNESS and LIGHTNESS[prev] - LIGHTNESS[new] >= 2 and coats < 3 and not primer:
                f("MEDIUM", "DARK_TO_LIGHT", name, "dark to light colour change: add a stain-blocking primer or a third coat")
            if r.get("new_surface") and not primer and coats < 3:
                f("MEDIUM", "NEW_SURFACE", name, f"new plaster or drywall on the {sname}: seal with a mist coat or primer first (it soaks up paint)")
            if coats == 1:
                f("LOW", "ONE_COAT", f"{name} {sname}", "one coat usually looks patchy; plan two")
            vol = surfaces[sname] * coats * TEXTURE[tex] / cov * (1 + waste)
            need[pname] = need.get(pname, 0.0) + vol
            lines.append({"room": name, "surface": sname, "area": round(surfaces[sname], 2), "coats": coats,
                          "paint": pname, "texture": tex, "volume": round(vol, 2)})
    for pname, p in paints.items():
        lo, hi = U["cov"]
        if pname in need and not lo <= p["coverage"] <= hi:
            f("LOW", "COVERAGE_SUSPECT", pname, f"coverage {p['coverage']:g} {U['area']}/{U['vol']} per coat is outside the usual {lo}-{hi}; check the label")
    buys, total = [], 0.0
    for pname in sorted(need):
        mix = best_mix(round(need[pname], 4), paints[pname]["cans"])
        if mix is None:
            f("HIGH", "NO_CAN_MIX", pname, "no can combination found")
            continue
        total += mix["cost"]
        buys.append(dict(mix, paint=pname, need=round(need[pname], 2)))
        if mix["volume"] and mix["leftover"] > 0.3 * mix["volume"] and mix["leftover"] > 1:
            f("LOW", "BIG_LEFTOVER", pname, f"{mix['leftover']:.1f} {U['vol']} left over; keep it for touch-ups or check smaller can prices")
    rank = {"HIGH": 0, "MEDIUM": 1, "LOW": 2}
    findings.sort(key=lambda x: rank[x["severity"]])
    return {"name": job.get("name", "painting job"), "units": units, "currency": job.get("currency", ""),
            "waste": waste, "lines": lines, "buy": buys, "total_cost": round(total, 2), "findings": findings}


def g(x):
    return f"{x:.2f}".rstrip("0").rstrip(".")


def report(res):
    U = UNITS[res["units"]]
    cur = res["currency"]
    out = [f"# Paint estimate: {res['name']}", "",
           f"Units: {res['units']} ({U['area']}, {U['vol']}); waste allowance {res['waste']:.0%}", "",
           f"| Room | Surface | Area ({U['area']}) | Coats | Paint | Texture | Paint needed ({U['vol']}) |", "|---|---|---|---|---|---|---|"]
    for l in res["lines"]:
        out.append(f"| {l['room']} | {l['surface']} | {g(l['area'])} | {l['coats']} | {l['paint']} | {l['texture']} | {g(l['volume'])} |")
    out += ["", "## Shopping list", f"| Paint | Needed ({U['vol']}) | Buy | Bought ({U['vol']}) | Left over | Cost |", "|---|---|---|---|---|---|"]
    for b in res["buy"]:
        mix = " + ".join(f"{c['count']} x {g(c['size'])} {U['vol']}" for c in b["cans"])
        out.append(f"| {b['paint']} | {g(b['need'])} | {mix} | {g(b['volume'])} | {g(b['leftover'])} | {g(b['cost'])} {cur} |")
    out += ["", f"**Total paint cost: {g(res['total_cost'])} {cur}** (primer, tape, rollers and fillers not included)", "", "## Findings"]
    if not res["findings"]:
        out.append("- none")
    for x in res["findings"]:
        out.append(f"- **{x['severity']} {x['code']}** ({x['where']}): {x['message']}")
    return "\n".join(out) + "\n"


def self_test():
    cases = []

    def ok(name, cond):
        cases.append(bool(cond))
        print(("PASS " if cond else "FAIL ") + name)

    cans = [{"size": 10, "price": 100}, {"size": 2.5, "price": 30}]
    m = best_mix(11, cans)
    ok("11 L -> 10 + 2.5 for 130", m["cost"] == 130 and m["volume"] == 12.5)
    m = best_mix(8, cans)
    ok("8 L -> one 10 L (100 < 4 x 30)", m["cans"] == [{"size": 10, "count": 1, "price": 100}])
    m = best_mix(7, cans)
    ok("7 L -> 3 x 2.5 for 90", m["cost"] == 90 and m["leftover"] == 0.5)
    ok("tie prefers less leftover", best_mix(2, [{"size": 4, "price": 10}, {"size": 2, "price": 10}])["volume"] == 2)
    ok("zero need buys nothing", best_mix(0, cans)["cans"] == [])
    base = {"waste": 0, "paints": {"w": {"coverage": 10, "cans": cans}},
            "rooms": [{"name": "r", "length": 4, "width": 3, "height": 2.5, "walls": {"paint": "w", "coats": 2}}]}
    r = estimate(base)
    ok("wall area 2x(4+3)x2.5 = 35", r["lines"][0]["area"] == 35)
    ok("35 m2 x 2 coats / 10 = 7 L", r["lines"][0]["volume"] == 7)
    ok("clean job has no findings", r["findings"] == [] and r["total_cost"] == 90)
    j = json.loads(json.dumps(base)); j["rooms"][0]["openings"] = [{"w": 0.9, "h": 2, "count": 1}, {"w": 1.2, "h": 1.25, "count": 2}]
    ok("openings subtracted (35 - 1.8 - 3 = 30.2)", estimate(j)["lines"][0]["area"] == 30.2)
    j = json.loads(json.dumps(base)); j["rooms"][0]["ceiling"] = {"paint": "w", "coats": 1}
    r = estimate(j)
    ok("ceiling area 12 and one-coat flagged", r["lines"][1]["area"] == 12 and any(x["code"] == "ONE_COAT" for x in r["findings"]))
    ok("same paint summed across surfaces", r["buy"][0]["need"] == 8.2)
    j = json.loads(json.dumps(base)); j["waste"] = 0.1; j["rooms"][0]["texture"] = "rough"
    ok("rough + 10% waste: 7 x 1.25 x 1.1", estimate(j)["lines"][0]["volume"] == 9.62)
    j = json.loads(json.dumps(base)); j["rooms"][0].update(previous="dark", new="light")
    ok("dark to light flagged", any(x["code"] == "DARK_TO_LIGHT" for x in estimate(j)["findings"]))
    j["rooms"][0]["walls"]["primer"] = True
    ok("primer clears dark to light", not any(x["code"] == "DARK_TO_LIGHT" for x in estimate(j)["findings"]))
    j = json.loads(json.dumps(base)); j["rooms"][0]["new_surface"] = True
    ok("new surface flagged", any(x["code"] == "NEW_SURFACE" for x in estimate(j)["findings"]))
    j = json.loads(json.dumps(base)); j["rooms"][0]["openings"] = [{"w": 3, "h": 2.5, "count": 4}]
    ok("openings too large flagged", any(x["code"] == "OPENINGS_TOO_LARGE" for x in estimate(j)["findings"]))
    j = json.loads(json.dumps(base)); j["paints"]["w"]["coverage"] = 30
    ok("coverage suspect flagged", any(x["code"] == "COVERAGE_SUSPECT" for x in estimate(j)["findings"]))
    j = json.loads(json.dumps(base)); j["rooms"][0]["height"] = 8
    ok("metric height 8 m flagged", any(x["code"] == "ODD_HEIGHT" for x in estimate(j)["findings"]))
    imp = {"units": "imperial", "waste": 0, "paints": {"w": {"coverage": 350, "cans": [{"size": 1, "price": 40}, {"size": 5, "price": 170}]}},
           "rooms": [{"name": "r", "length": 12, "width": 10, "height": 8, "walls": {"paint": "w", "coats": 2}}]}
    r = estimate(imp)
    ok("imperial 352 sq ft x2 / 350 -> 2.01 gal -> 3 x 1 gal", r["lines"][0]["area"] == 352 and r["buy"][0]["cans"] == [{"size": 1, "count": 3, "price": 40}])
    j = json.loads(json.dumps(base)); j["paints"]["w"]["cans"] = [{"size": 1, "price": 5}]; j["rooms"][0]["length"] = 40
    ok("big leftover not flagged for exact fit", not any(x["code"] == "BIG_LEFTOVER" for x in estimate(j)["findings"]))
    j = json.loads(json.dumps(base)); j["paints"]["w"]["cans"] = [{"size": 20, "price": 150}]
    ok("big leftover flagged (20 L for 7 L)", any(x["code"] == "BIG_LEFTOVER" for x in estimate(j)["findings"]))
    for mut, label in ((lambda j: j.update(units="cubits"), "bad units"), (lambda j: j.update(paints={}), "no paints"),
                       (lambda j: j["rooms"][0].update(height=0), "zero height"),
                       (lambda j: j["rooms"][0]["walls"].update(paint="x"), "unknown paint"),
                       (lambda j: j["rooms"][0]["walls"].update(coats=1.5), "fractional coats"),
                       (lambda j: j["rooms"][0].update(texture="glitter"), "bad texture"),
                       (lambda j: j.update(rooms=[]), "no rooms")):
        j = json.loads(json.dumps(base))
        mut(j)
        try:
            estimate(j)
            ok(label + " rejected", False)
        except JobError:
            ok(label + " rejected", True)
    print(f"{sum(cases)}/{len(cases)} passed")
    return 0 if all(cases) else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="Estimate paint quantity, cans to buy and cost for rooms.")
    ap.add_argument("file", nargs="?", help="painting job JSON")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    if not a.file:
        ap.error("give a job JSON file or --self-test")
    try:
        res = estimate(json.load(open(a.file, encoding="utf-8")))
    except (OSError, json.JSONDecodeError, JobError, AttributeError, TypeError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(res, indent=2) if a.json else report(res), end="\n" if a.json else "")
    return 1 if any(x["severity"] == "HIGH" for x in res["findings"]) else 0


if __name__ == "__main__":
sys.exit(main())Các quy ước mang tính định hướng rõ rệt để thiết kế, phát triển mở rộng và vận hành các API GraphQL.
# Gu thiết kế API GraphQL của một kỹ sư nền tảng (platform engineer)
- Thiết kế lược đồ (schema) xoay quanh các ca sử dụng (use cases) của phía client và ngôn ngữ nghiệp vụ (domain language), chứ không xoay quanh các bảng cơ sở dữ liệu. Độ tin cậy: 0.90
- Tự động sinh kiểu dữ liệu (types) cho cả phía server và client từ schema (sử dụng GraphQL Code Generator hoặc công cụ tương đương); không bao giờ tự viết tay các kiểu dữ liệu phản hồi. Độ tin cậy: 0.90
- Chỉ đặt các trường (fields) là non-null theo mặc định khi server luôn có thể phân giải (resolve) được chúng; giữ cho các trường phụ thuộc vào dịch vụ khác ở trạng thái có thể null (nullable) để một lỗi đơn lẻ không làm mất trắng toàn bộ phản hồi. Độ tin cậy: 0.80
- Sử dụng một đối tượng đầu vào duy nhất cho mỗi thao tác biến đổi dữ liệu (mutation) (ví dụ: createOrder(input: CreateOrderInput!)) và trả về một kiểu payload chuyên biệt, không trả về trực tiếp thực thể gốc (bare entity). Độ tin cậy: 0.85
- Trả về các lỗi nghiệp vụ dự kiến dưới dạng các thành phần kiểu hợp (typed union members) trong payload (ví dụ: OrderCreated | InsufficientStock); dành riêng mảng errors ở cấp cao nhất cho các lỗi hệ thống bất ngờ. Độ tin cậy: 0.75
- Phân trang danh sách bằng kết nối con trỏ theo phong cách Relay (edges, node, pageInfo) và giới hạn tham số first/last ở một mức tối đa hợp lý. Độ tin cậy: 0.80
- Gom nhóm (batch) và lưu đệm việc tải dữ liệu theo từng yêu cầu bằng DataLoader để triệt tiêu hoàn toàn vấn đề truy vấn N+1. Độ tin cậy: 0.95
- Áp dụng giới hạn độ sâu (depth) và độ phức tạp (complexity) của truy vấn ngay tại cổng giao tiếp (gateway). Độ tin cậy: 0.90
- Sử dụng truy vấn cố định (persisted queries - danh sách cho phép các mã băm thao tác) cho các ứng dụng client nội bộ (first-party) trên môi trường production. Độ tin cậy: 0.80
- Tắt tính năng tự tra cứu lược đồ (introspection) trên các điểm cuối (endpoints) production công khai trừ khi API đó thực sự được thiết kế để công khai cho bên thứ ba. Độ tin cậy: 0.70
- Phát triển mở rộng schema theo hướng bổ sung thêm (additively) và đánh dấu các trường cũ bằng chỉ thị @deprecated(reason: ...); không bao giờ phân tách phiên bản endpoint bằng đường dẫn như /v2. Độ tin cậy: 0.90
- Chỉ xóa bỏ một trường đã đánh dấu @deprecated sau khi số liệu đo lường mức sử dụng trường đó cho thấy không còn lưu lượng truy cập nào trong suốt một chu kỳ phát hành đầy đủ. Độ tin cậy: 0.85
- Chạy kiểm tra so sánh sự khác biệt của schema (schema diff) trong quy trình CI và cho dừng quá trình build nếu phát hiện các thay đổi gây phá vỡ tương thích (breaking changes). Độ tin cậy: 0.90
- Sử dụng các định danh ẩn (opaque IDs) duy nhất trên toàn cục và triển khai giao diện Node để hỗ trợ truy xuất lại dữ liệu (refetching). Độ tin cậy: 0.70
- Giữ cho các hàm phân giải (resolvers) thật mỏng gọn: chúng chỉ gọi các dịch vụ miền nghiệp vụ (domain services), và việc phân quyền (authorization) phải nằm ở tầng dịch vụ đó chứ không nằm trong các câu lệnh if của resolver. Độ tin cậy: 0.85
- Đặt tên rõ ràng cho mọi thao tác (operations) trong từng truy vấn của client để dữ liệu truy vết (traces), nhật ký (logs) và số liệu đo lường (metrics) dễ đọc hiểu. Độ tin cậy: 0.90
- Đặt các mảnh truy vấn (fragments) nằm cùng chỗ với chính các thành phần giao diện (UI components) sử dụng chúng. Độ tin cậy: 0.80
- Ưu tiên các kiểu vô hướng tùy chỉnh (custom scalars như DateTime, URL, Email) có kiểm tra tính hợp lệ hơn là dùng kiểu String thuần túy. Độ tin cậy: 0.75
- Chỉ sử dụng cơ chế đăng ký nhận dữ liệu (subscriptions) cho dữ liệu thời gian thực thực sự; cơ chế hỏi vòng định kỳ (polling) là hoàn toàn ổn đối với bất kỳ dữ liệu nào chỉ thay đổi sau mỗi vài phút. Độ tin cậy: 0.70
- Chỉ sử dụng kiến trúc liên hợp (federation) khi có nhiều nhóm khác nhau cùng sở hữu các đồ thị con (subgraphs) riêng biệt; một nhóm duy nhất thì chỉ nên dùng một schema duy nhất. Độ tin cậy: 0.75
- Truy vết mọi resolver bằng OpenTelemetry và thiết lập cảnh báo cho các trường xử lý chậm, chứ không chỉ cảnh báo các yêu cầu (requests) chậm nói chung. Độ tin cậy: 0.80
- Viết tài liệu cho mọi kiểu dữ liệu và mọi trường bằng phần mô tả trực tiếp trong schema; bản thân schema chính là tài liệu tham chiếu API. Độ tin cậy: 0.85

