@f
Các quy ước giàu tính định hướng để xây dựng những hàm serverless đáng tin cậy, tối ưu chi phí trên đám mây.
# Gu thiết kế (taste) Hàm Serverless của một kỹ sư backend đám mây
- Giữ cho mỗi hàm nhỏ gọn và tập trung vào một tác nhân kích hoạt (trigger) duy nhất, nhưng hãy gom các route HTTP có liên quan mật thiết vào chung một handler để cắt giảm tình trạng khởi động lạnh (cold starts). Độ tin cậy: 0.80
- Khởi tạo các SDK client và nhóm kết nối cơ sở dữ liệu (database pools) bên ngoài hàm handler để các lần gọi ấm (warm invocations) có thể tái sử dụng chúng. Độ tin cậy: 0.95
- Sử dụng bộ quản lý nhóm kết nối (connection pooler) hoặc trình điều khiển cơ sở dữ liệu dựa trên HTTP, vì hàng nghìn hàm chạy đồng thời sẽ làm cạn kiệt các kết nối Postgres trực tiếp. Độ tin cậy: 0.90
- Thiết lập thời gian chờ (timeout) và dung lượng bộ nhớ tường minh cho từng hàm thay vì chấp nhận các giá trị mặc định của nền tảng. Độ tin cậy: 0.85
- Giữ kích thước gói mã (bundle) nhỏ gọn bằng kỹ thuật loại bỏ mã thừa (tree-shaking) và nạp trễ (lazy imports), đồng thời đo lường thời gian khởi động lạnh sau mỗi thay đổi thư viện phụ thuộc lớn. Độ tin cậy: 0.85
- Đảm bảo mọi hàm xử lý sự kiện đều có tính lũy đẳng (idempotent), bởi vì các hàng đợi và nguồn phát sự kiện luôn phân phối theo cơ chế ít nhất một lần (at-least-once). Độ tin cậy: 0.95
- Chuyển các tác vụ chạy chậm hoặc cần thử lại sang hàng đợi (queue) và trả kết quả về nhanh chóng từ các hàm HTTP. Độ tin cậy: 0.90
- Đẩy các sự kiện bất đồng bộ bị lỗi vào hàng đợi thư chết (dead letter queue - DLQ) kèm theo cảnh báo dựa trên độ sâu (số lượng tồn đọng) của hàng đợi đó. Độ tin cậy: 0.90
- Định nghĩa các hàm, quyền hạn và tác nhân kích hoạt dưới dạng mã (Infrastructure as Code) bằng SST, Serverless Framework, SAM hoặc Terraform, tuyệt đối không bấm chọn thủ công trên giao diện điều khiển (console). Độ tin cậy: 0.90
- Cấp cho mỗi hàm một vai trò (role) riêng theo nguyên tắc đặc quyền tối thiểu, giới hạn phạm vi chính xác vào những tài nguyên mà hàm đó chạm tới. Độ tin cậy: 0.95
- Nạp các thông tin bí mật (secrets) từ trình quản lý bí mật (secrets manager) hoặc biến môi trường được mã hóa của nền tảng, tuyệt đối không lấy từ kho mã nguồn (repo). Độ tin cậy: 0.95
- Ghi nhật ký (logs) định dạng JSON có cấu trúc kèm theo request ID và correlation ID trên mọi dòng. Độ tin cậy: 0.90
- Truy vết (trace) các yêu cầu xuyên qua các hàm và hàng đợi bằng OpenTelemetry hoặc công cụ truy vết có sẵn của nền tảng. Độ tin cậy: 0.80
- Giữ logic nghiệp vụ trong các module thuần túy và chỉ để hàm handler đóng vai trò một lớp chuyển đổi (adapter) mỏng, nhờ đó có thể kiểm thử đơn vị (unit test) mà không cần tới môi trường đám mây. Độ tin cậy: 0.90
- Chạy kiểm thử tích hợp (integration tests) trên một môi trường triển khai (stage) thực tế cho mỗi pull request thay vì đặt niềm tin vào các trình giả lập cục bộ. Độ tin cậy: 0.80
- Thiết lập mức độ đồng thời dành riêng hoặc tối đa (reserved or maximum concurrency) trên các hàm gọi tới những dịch vụ hạ nguồn mỏng manh, dễ quá tải. Độ tin cậy: 0.85
- Chỉ sử dụng mức độ đồng thời được cấp phát sẵn (provisioned concurrency) cho các luồng xử lý nhạy cảm về độ trễ nơi mà quá trình khởi động lạnh đã được đo đạc và chứng minh là gây ảnh hưởng xấu. Độ tin cậy: 0.75
- Ưu tiên môi trường thực thi arm64 khi các thư viện phụ thuộc hỗ trợ để đạt tỷ lệ hiệu năng trên giá thành tốt hơn. Độ tin cậy: 0.70
- Thiết lập cảnh báo hóa đơn thanh toán và bảng theo dõi chi phí theo từng hàm trước khi ra mắt, chứ không phải đợi đến sau tờ hóa đơn gây sốc đầu tiên. Độ tin cậy: 0.85
- Tránh nối chuỗi các hàm gọi nhau một cách đồng bộ; thay vào đó hãy dùng sự kiện hoặc một bộ điều phối luồng công việc (workflow engine) như Step Functions. Độ tin cậy: 0.85
- Lựa chọn container hoặc các dịch vụ chạy liên tục dài hạn cho các khối lượng công việc có thông lượng cao và ổn định, nơi mà mô hình serverless trở nên đắt đỏ hơn. Độ tin cậy: 0.75
Các quy ước giàu tính định hướng để xây dựng những tính năng thời gian thực bảo mật, có khả năng mở rộng bằng WebSockets.
# Gu thiết kế (taste) WebSocket Thời gian thực của một kỹ sư hệ thống thời gian thực
- Sử dụng WebSockets thuần hoặc một thư viện mỏng nhẹ như ws cho các trường hợp đơn giản, và chỉ tìm đến Socket.IO khi bạn thực sự cần cơ chế dự phòng (fallbacks) và quản lý phòng (rooms) của nó. Độ tin cậy: 0.75
- Ưu tiên dùng Server-Sent Events (SSE) khi dữ liệu cập nhật chỉ chảy một chiều từ máy chủ xuống máy khách. Độ tin cậy: 0.85
- Xác thực ngay trong quá trình bắt tay (handshake) bằng một token có thời hạn ngắn, tuyệt đối không bao giờ tin tưởng vào user ID được gửi kèm trong một bản tin sau đó. Độ tin cậy: 0.95
- Kiểm tra header Origin trên các yêu cầu nâng cấp kết nối (upgrade requests) để chặn tấn công chiếm quyền điều khiển WebSocket liên trang (cross-site WebSocket hijacking). Độ tin cậy: 0.90
- Định nghĩa mọi bản tin dưới dạng một gói bọc có kiểu tường minh (typed envelope) gồm loại bản tin (type), phiên bản (version) và dữ liệu tải (payload), được xác thực bằng schema ở cả hai đầu. Độ tin cậy: 0.90
- Gửi tín hiệu nhịp tim (heartbeats) bằng ping và pong và đóng các kết nối bỏ lỡ chúng, vì các máy chủ proxy thường âm thầm ngắt những socket nhàn rỗi. Độ tin cậy: 0.90
- Kết nối lại ở phía máy khách theo cơ chế lùi lũy thừa kèm độ lệch ngẫu nhiên (exponential backoff and jitter) để việc khởi động lại máy chủ không gây ra hiệu ứng đàn thú chạy loạn (thundering herd). Độ tin cậy: 0.95
- Gắn cho mỗi bản tin một số thứ tự (sequence number) để máy khách có thể tiếp tục nhận từ bản tin cuối cùng mà chúng nhìn thấy sau khi kết nối lại. Độ tin cậy: 0.85
- Coi socket như một kênh thông báo và giữ cơ sở dữ liệu làm nguồn chân lý chuẩn xác (source of truth) mà máy khách có thể truy vấn lại. Độ tin cậy: 0.85
- Phân phối bản tin (fan out) qua nhiều thực thể máy chủ bằng Redis pub/sub, NATS hoặc một dịch vụ được quản lý thay vì phát quảng bá trong bộ nhớ (in-memory broadcast). Độ tin cậy: 0.90
- Giữ cho các máy chủ kết nối ở trạng thái phi trạng thái (stateless) ngoại trừ các socket đang mở, để bất kỳ thực thể nào cũng có thể được rút cạn kết nối (drain) và thay thế. Độ tin cậy: 0.80
- Rút cạn kết nối một cách êm thấm (drain gracefully) khi triển khai bản mới bằng cách báo cho máy khách chủ động kết nối lại trước khi tắt máy chủ. Độ tin cậy: 0.85
- Áp dụng cơ chế chống tràn ngược (backpressure): theo dõi bộ đệm gửi (send buffer) và loại bỏ hoặc gộp các bản cập nhật đối với những máy khách xử lý chậm thay vì tích trữ vào bộ đệm mãi mãi. Độ tin cậy: 0.85
- Giới hạn tần suất (rate limit) các bản tin gửi đến trên mỗi kết nối và giới hạn kích thước tối đa của bản tin. Độ tin cậy: 0.90
- Phân quyền cho mọi yêu cầu đăng ký (subscription) vào một phòng hoặc kênh ở phía máy chủ, chứ không chỉ kiểm tra ở lần kết nối ban đầu. Độ tin cậy: 0.95
- Gom nhóm (batch) hoặc tiết lưu (throttle) các cập nhật tần suất cao như vị trí con trỏ chuột theo một nhịp xung (tick rate) cố định. Độ tin cậy: 0.80
- Cấu hình thời gian chờ nhàn rỗi (idle timeouts) của bộ cân bằng tải và phiên kết dính (sticky sessions) một cách có chủ đích khi tầng truyền tải cần đến chúng. Độ tin cậy: 0.80
- Theo dõi số lượng kết nối đang mở, số bản tin mỗi giây, tỷ lệ kết nối lại và độ trễ chuyển phát như những chỉ số đo lường (metrics) hạng nhất. Độ tin cậy: 0.85
- Sử dụng các cấu trúc CRDT như Yjs hoặc Automerge cho tính năng chỉnh sửa cộng tác thay vì tự phát minh ra cơ chế giải quyết xung đột của riêng bạn. Độ tin cậy: 0.80
- Kiểm thử tải (load test) với số lượng kết nối sát thực tế bằng k6 hoặc Artillery trước khi ra mắt. Độ tin cậy: 0.80
Một bộ phim ngắn kinh dị Halloween bốn cảnh chân thực như ảnh chụp: một cô gái trẻ chạy trốn mụ phù thủy ở trạm xe buýt đầy sương mù và tìm thấy nơi trú ẩn у nhà một cụ bà tốt bụng trong căn biệt thự kiến trúc Victoria lung linh ánh nến, cho đến khi bức chân dung 40 năm trước với cùng chiếc mặt dây chuyền bằng bạc hé lộ cú ngoặt rùng rợn, đi kèm thiết kế âm thanh, quy tắc đồng nhất nhân vật và negative prompt. Thịnh hành trên X, được chia sẻ gốc bởi @Romi2656: https://x.com/Romi2656/status/2114718376107098143
CẢNH 1 — TRẠM XE BUÝT (0–10 giây)

Vào đêm Halloween ngày 31 tháng 10, một cô gái trẻ đứng một mình tại trạm xe buýt vắng vẻ bao quanh bởi sương mù dày đặc, những hàng cây khô trụi lá và những quả bí ngô Halloween màu cam lập lòe. Đột nhiên, một mụ phù thủy đáng sợ xuất hiện phía sau cô, với mái tóc xám rối bù, đôi mắt phát sáng và một chiếc mặt dây chuyền có nắp mở (locket) bằng bạc cổ đeo quanh cổ.

Mụ phù thủy thì thào: “Ngươi không nên ở một mình vào đêm Halloween đâu!” Cô gái quay lại, hét lên thất thanh và chạy bán sống bán chết vào làn sương mù.

CẢNH 2 — BIỆT THỰ CỔ (10–23 giây)

Cô gái phát hiện ra một căn biệt thự cổ kiến trúc Victoria và gõ cửa. Một cụ bà mở cửa với thái độ niềm nở ấm áp và mời cô vào trong. Căn phòng thắp nến ấm cúng với đồ trang trí Halloween, những quả bí ngô chạm khắc và một lò sưởi cổ.

Cụ bà dọn cho cô súp nóng và bánh mì, dịu dàng nói: “Vào đi cháu. Đêm nay cháu an toàn ở đây rồi.”

Cô gái đang hoảng sợ bắt đầu thả lỏng khi tiếng sấm rền vang bên ngoài.

CẢNH 3 — PHÁT HIỆN GÂY SỐC (23–38 giây)

Trong lúc đang ăn, cô gái để ý thấy một bức chân dung cổ treo trên tường. Bức tranh vẽ một người phụ nữ trẻ xinh đẹp đang đeo chiếc mặt dây chuyền bạc giống hệt của mụ phù thủy đáng sợ ở trạm xe buýt.

Cô từ từ tiến lại gần bức chân dung, nhìn chằm chằm vào khuôn mặt quen thuộc và sợi dây chuyền giống hệt nhau. Bên dưới bức tranh có dòng chữ khắc: “31 THÁNG 10 — 40 NĂM TRƯỚC.”

Mặt cô tái nhợt đi. Cô chợt nhận ra người phụ nữ trong bức chân dung chính là mụ phù thủy mà cô đã chạm trán bên ngoài.

Cô từ từ quay đầu lại nhìn cụ bà đang đứng phía sau mình.

CẢNH 4 — MÀN HÙ DỌA CUỐI CÙNG

Cụ bà nhìn chằm chằm vào cô với một nụ cười nham hiểm, khác thường. Đôi mắt bà ta đột nhiên rực sáng màu vàng, khuôn mặt biến dạng thành khuôn mặt của mụ phù thủy kinh hoàng, rồi bà ta phá lên cười điên dại, lạnh sống lưng.

Máy quay lao nhanh về phía khuôn mặt ghê rợn của mụ phù thủy đúng lúc tia chớp lóe sáng qua khung cửa sổ.

CẮT ĐỘT NGỘT SANG MÀN HÌNH ĐEN (SMASH CUT TO BLACK).

Tiếng cười độc ác của mụ phù thủy vang vọng một lần trong bóng tối.

KẾT THÚC.

PHONG CÁCH HÌNH ẢNH: Phim kinh dị người đóng (live-action) chân thực như ảnh chụp, biệt thự Victoria đậm chất điện ảnh, sương mù và mưa chân thực, ánh nến lung linh chập chờn, biểu cảm khuôn mặt chi tiết, hiệu ứng biến hình siêu nhiên thực tế, đổ bóng kịch tính và bầu không khí Halloween căng thẳng tột độ.

THIẾT KẾ ÂM THANH: Tiếng gió hú, tiếng sấm rền từ xa, tiếng bước chân, tiếng cửa kẽo kẹt, tiếng thì thầm rợn người, âm thanh biến hình đột ngột và tiếng cười phù thủy kinh hoàng.

TÍNH NHẤT QUÁN CỦA NHÂN VẬT: Giữ nguyên cùng một cô gái trẻ, cùng một cụ bà và chiếc mặt dây chuyền bạc giống hệt nhau xuyên suốt từ đầu đến cuối. Ngoại hình của mụ phù thủy phải khớp với người phụ nữ trẻ trong bức chân dung trước khi biến hình.

NEGATIVE PROMPT: Không hoạt hình (cartoon), không anime, không kỹ xảo CGI rẻ tiền, không khuôn mặt thiếu nhất quán, không tự ý đổi trang phục, không phụ đề, không logo, không hình mờ (watermark) và không có cảnh nào thêm sau màn hình đen cuối cùng.
Một bộ phim ngắn kinh dị Halloween chân thực dài 30 giây, tỷ lệ 16:9 chia làm năm nhịp thời gian: trên hiên nhà ướt đẫm mưa, một người đàn ông nhận thấy quả bí ngô jack-o'-lantern của mình đang phập phồng thở, soi đèn pin điện thoại phát hiện đôi mắt người bên trong, chứng kiến nó tự xoay về phía mình và thấy một dấu bàn tay nhỏ xíu hiện lên trước khi màn hình cắt phụt sang màu đen, kèm theo ghi chú sản xuất, thiết kế âm thanh và negative prompt. Thịnh hành trên X, được chia sẻ gốc bởi @nawalsehar: https://x.com/nawalsehar/status/2115022630004851185
30 giây | 16:9 | 4K Ultra HD | 30 FPS | Phim ngắn kinh dị Halloween người đóng (live-action) siêu chân thực.

Một đêm Halloween kinh hoàng diễn ra trên hiên nhà bằng gỗ ướt đẫm nước mưa, nơi một người đàn ông trưởng thành ngoài đời thực phát hiện quả bí ngô jack-o'-lantern đã chạm khắc của mình đang có biểu hiện kỳ lạ. Với diễn viên người thật, hiệu ứng thực tế tại hiện trường (practical effects), ánh sáng điện ảnh và bầu không khí kinh dị chân thực, một món đồ trang trí Halloween bình thường bỗng trở thành một thứ thực sự rùng rợn.

0–5 giây: Hiên nhà bằng gỗ ướt đẫm mưa lấp lánh dưới ánh sáng ban đêm lờ mờ. Một quả bí ngô jack-o'-lantern lập lòe ánh sáng đặt cạnh cửa trước. Một người đàn ông mặc áo sơ mi flannel tối màu và quần jean bước vào, tay bê đồ trang trí Halloween. Đột nhiên, anh nhận thấy quả bí ngô đang từ từ phồng lên và xẹp xuống như thể nó đang thở.

5–12 giây: Máy quay từ từ đẩy sát về phía quả bí ngô. Nụ cười chạm khắc răng cưa của nó khẽ ngoác rộng ra trước khi trở lại bình thường. Ngọn nến bên trong chập chờn đồng bộ với chuyển động đó. Người đàn ông thận trọng quỳ xuống khi một tiếng thở ướt át, yếu ớt phát ra từ bên trong.

12–21 giây: Ánh sáng bên trong quả bí ngô đột ngột vụt tắt. Sự im lặng bao trùm hoàn toàn. Người đàn ông bật đèn pin điện thoại lên, làm lộ ra đôi mắt người chân thực sâu bên trong quả bí ngô tối đen đang nhìn thẳng vào anh. Hoảng sợ tột độ, anh giật lùi lại và đánh rơi chiếc điện thoại xuống sàn gỗ ướt, để chùm sáng đèn pin chếch nghiêng chiếu về phía quả bí ngô.

21–27 giây: Người đàn ông từ từ đưa tay về phía quả bí ngô lần nữa. Trước khi anh kịp chạm vào nó, quả bí ngô jack-o'-lantern tự xoay vài inch hướng về phía anh. Nụ cười chạm khắc của nó vẫn đứng yên bất động. Chết lặng vì không tin vào mắt mình, anh từ từ lùi về phía cánh cửa.

27–30 giây: Góc cận cảnh đặc tả (extreme close-up) quả bí ngô. Ánh sáng bên trong nó đột ngột bật sáng trở lại. Một dấu bàn tay nhỏ xíu, mới tinh dần dần hiện lên trên lớp hơi nước ngưng tụ bên ngoài vỏ bí. Trước khi người xem kịp hiểu chuyện gì vừa xảy ra, màn hình lập tức cắt phụt sang màu đen.

Sản xuất: Hình ảnh người đóng (live-action) chân thực như ảnh chụp, diễn viên người thật, nhân dạng nhân vật nhất quán, chuyển động thực tế của quả bí ngô, hơi nước ngưng tụ chân thực, mưa tự nhiên, đổ bóng thuyết phục, kỹ thuật quay cầm tay (handheld) tinh tế, độ sâu trường ảnh nông, ánh sáng kinh dị đậm chất điện ảnh và chỉnh màu tiết chế. Thiết kế âm thanh bao gồm tiếng mưa rơi, tiếng gió rít từ xa, tiếng bước chân trên sàn gỗ, tiếng thở khẽ, tiếng sột soạt nhẹ của vải quần áo, tiếng nhạc nền trầm hồi hộp dâng cao dần và sự im lặng đột ngột trước cảnh hé lộ cuối cùng.

Negative prompt: Không hoạt hình, hình ảnh kiểu hoạt họa (cartoon), nhân vật trông giả tạo kiểu CGI, môi trường nhân tạo, khuôn mặt bị biến đổi, trang phục thiếu nhất quán, giải phẫu cơ thể méo mó, chuyển động bí ngô phi thực tế, màn hù dọa (jump scare) phóng đại quá lố, cảnh máu me rùng rợn (gore), lời thoại, lời dẫn chuyện, phụ đề, chữ viết, logo, hình mờ (watermark), viền đen khung hình, hoặc chuyển cảnh đột ngột trước cú cắt cuối cùng.
Prompt chuyển văn bản thành video ngắn mang màu sắc mộng mơ về một con phố ngoại ô dịp lễ Halloween huyền ảo lúc chập tối: những quả bí ngô jack-o'-lantern phát sáng trên bậc thềm hiên nhà, lá thu sắc cam và vàng rơi nhẹ, dây đèn tím và vàng ấm áp, cùng những cú máy cận cảnh mượt mà lướt qua đèn lồng cổ điển, bát kẹo đầy màu sắc và bong bóng xà phòng trôi lơ lửng trong bầu không khí cổ tích siêu thực. Thịnh hành trên X, được chia sẻ gốc bởi @laviniavelle: https://x.com/laviniavelle/status/2114571917747523930
Một con phố khu dân cư đêm Halloween huyền ảo, đậm chất điện ảnh được trang hoàng cho lễ hội mùa thu. Những quả bí ngô Jack-o'-lantern chạm khắc phát sáng xếp dọc theo lối đi và bậc thềm của những ngôi nhà ngoại ô ấm cúng. Những chiếc lá mùa thu rực rỡ sắc cam và vàng ánh kim đang nhẹ nhàng rơi trong không trung. Những dây đèn lấp lánh ánh tím và vàng ấm áp treo trên cây và hiên nhà, tạo nên ánh sáng buổi tối kỳ diệu. Các góc máy cận cảnh chuyển tiếp mượt mà sang những chiếc đèn lồng cổ điển, những bát kẹo đầy màu sắc và những bong bóng xà phòng bay lơ lửng ngang qua hiên nhà. Bầu không khí cổ tích mộng mơ, siêu thực, độ phân giải 4K, chuyển động máy quay mượt mà, ánh sáng huyền ảo.
Nuôi men tự nhiên (sourdough starter) khỏe mạnh chỉ từ bột và nước rồi nướng ổ bánh đầu tiên của bạn: men sourdough là gì, bảng thuật ngữ cho người mới, bảng hướng dẫn thiết lập 14 ngày tính bằng gram, lịch cho men ăn phù hợp với ngày đi làm, cách đọc dấu hiệu sẵn sàng và mùi hương, bảng xử lý sự cố, quy tắc nhận biết nấm mốc và an toàn thực phẩm, kế hoạch bảo quản tủ lạnh và khi đi xa, hướng dẫn chi tiết nướng ổ bánh đầu tiên, ý tưởng tận dụng men thừa, và lộ trình học 3 tuần.
Hãy đóng vai một Huấn luyện viên Nuôi men Sourdough cho Người mới bắt đầu. Bạn giúp những người hoàn toàn mới tạo ra một hũ men tự nhiên (sourdough starter) khỏe mạnh chỉ từ bột và nước, duy trì sự sống cho men và nướng ổ bánh đơn giản đầu tiên bằng chính căn bếp, loại bột và lịch trình thực tế mà họ có. Bạn suy nghĩ như một người làm bánh tại nhà kiên nhẫn đứng lớp dạy làm bánh cho cộng đồng nhỏ: giải thích những gì đang diễn ra bên trong hũ men bằng ngôn ngữ bình dân, gắn mọi hướng dẫn với nhiệt độ phòng, loại bột và thói quen sinh hoạt hàng ngày của tôi, đưa ra định lượng tính bằng gram cùng tỷ lệ đơn giản, và thẳng thắn chia sẻ rằng một đến hai tuần đầu tiên thường sẽ bừa bộn và chậm chạp. Bạn không bao giờ hứa hẹn một ngày cố định nào mà men sẽ "sẵn sàng"; thay vào đó, bạn dạy tôi cách đọc các dấu hiệu.

Tình hình của tôi:
- Nhiệt độ bếp: around 20 C during the day, cooler at night
- Loại bột tôi có thể mua: supermarket all-purpose flour and a small bag of whole wheat flour
- Nước: tap water, slightly chlorinated
- Dụng cụ hiện có: a kitchen scale, a large glass jar with a loose lid, a spatula, and a regular home oven
- Lịch trình hàng ngày: I work from 9 to 6, I can feed it in the morning and the evening
- Những gì tôi đã thử: nothing yet, this is my first starter
- Loại bánh tôi muốn nướng đầu tiên: a simple crusty loaf, later pancakes and pizza with the discard
- Tần suất tôi muốn nướng bánh: once a week on weekends
- Những điều tôi muốn tránh: wasting a lot of flour, complicated schedules

Trước tiên, trong một tin nhắn ngắn gọn, hãy hỏi tôi bất kỳ thông tin quan trọng nào còn thiếu: liệu bếp của tôi có nóng hơn hay lạnh hơn nhiều vào ban đêm không, liệu tôi có một góc ấm áp nào không (lò nướng chỉ bật đèn, nóc tủ lạnh), liệu tôi có nồi gang có nắp đậy hoặc đá nướng bánh cho lò nướng không, liệu trong nhà có ai bị dị ứng gluten hoặc lúa mì không, và liệu tôi có đi vắng ngày nào trong hai tuần tới không. Sau đó, hãy hướng dẫn tôi qua các phần sau:

1. **Men Sourdough Thực Sự Là Gì**: lời giải thích ngắn gọn, thân thiện về nấm men tự nhiên và vi khuẩn axit lactic, tại sao chỉ cần bột và nước là đủ, tại sao những ngày đầu men có thể sủi bọt mạnh rồi lại im lìm, cũng như ý nghĩa của từ "hoạt động" (active) và "trưởng thành" (mature).

2. **Các Thuật Ngữ Về Men Bạn Sẽ Gặp**: bảng thuật ngữ ngắn gọn gồm tên thuật ngữ và giải nghĩa dễ hiểu: men cái (starter), men cái làm bánh (levain), men thừa bỏ đi (discard), cho men ăn (feeding), tỷ lệ (ví dụ 1:1:1), độ ẩm/tỷ lệ nước (hydration), đạt đỉnh (peak), xẹp xuống (collapse), lớp nước rượu trên bề mặt (hooch), thử nghiệm nổi (float test), ủ bột giai đoạn đầu (bulk fermentation), ủ bột định hình (proofing) và tỷ lệ phần trăm của thợ làm bánh (baker's percentage).

3. **Kế Hoạch Thiết Lập Từng Ngày**: một bảng cho 14 ngày đầu tiên với các cột: ngày, việc cần làm, khối lượng tính bằng gram, những gì tôi có thể sẽ thấy, và điều gì là bình thường so với điều gì cần điều chỉnh. Hãy bắt đầu bằng bột nguyên cám hoặc hỗn hợp bột nguyên cám và bột mì đa dụng, sau đó chuyển sang loại bột chính của tôi, đồng thời giữ tổng lượng bột ở mức nhỏ để tránh lãng phí.

4. **Lịch Cho Men Ăn Phù Hợp Với Lịch Trình Của Tôi**: quy trình buổi sáng và buổi tối vừa vặn với ngày đi làm của tôi, cách bỏ bớt men thừa và cho men ăn trong chưa đầy năm phút, tỷ lệ nào nên dùng ở mức nhiệt độ phòng của tôi, và cách thay đổi tỷ lệ nếu men đạt đỉnh quá sớm hoặc quá muộn.

5. **Đọc Các Dấu Hiệu**: cách nhận biết men đã sẵn sàng để đem đi nướng bánh: men nở gấp đôi trong một khoảng thời gian có thể dự đoán được sau khi ăn, bề mặt phồng hình vòm, có nhiều bọt khí, mùi chua dịu dễ chịu, và vượt qua (hoặc không cần đến) bài kiểm tra thả nổi. Hãy giải thích ý nghĩa của từng mùi: mùi men rượu, mùi sữa chua, mùi giấm, mùi nước tẩy sơn móng tay, và khi nào thì men chỉ đơn giản là đang đói cần được cho ăn.

6. **Bảng Xử Lý Sự Cố**: các cột gồm: vấn đề, nguyên nhân có thể xảy ra, việc cần làm. Bao gồm các trường hợp: không có bọt khí sau 3 ngày, nở vọt lên vào ngày thứ 2 rồi im lìm, có lớp chất lỏng trên bề mặt, men nở chậm chạp, quá chua, kết cấu lỏng lẻo, ruồi giấm, và hũ men bốc mùi axeton nồng nặc.

7. **Nấm Mốc và An Toàn Thực Phẩm**: cách phân biệt lớp nước rượu (hooch) vô hại hoặc lớp vỏ bột khô với nấm mốc, tại sao các đốm màu hồng, cam hoặc có lông tơ đồng nghĩa với việc phải vứt bỏ toàn bộ và làm lại từ đầu, cách giữ hũ men sạch sẽ và vệ sinh nhà bếp cơ bản. Tuyệt đối không bao giờ gợi ý hớt bỏ phần mốc rồi tiếp tục dùng.

8. **Kế Hoạch Bảo Quản Tủ Lạnh và Khi Đi Xa**: cách chuyển sang chế độ cho men ăn hàng tuần trong tủ lạnh khi men đã khỏe, cách đánh thức men dậy hai ngày trước ngày nướng bánh, và cách giữ men sống nếu tôi đi du lịch một hoặc hai tuần (nuôi men đặc hơn, sấy khô thành vảy mỏng để dự phòng).

9. **Hướng Dẫn Chi Tiết Nướng Ổ Bánh Đầu Tiên**: kế hoạch đơn giản làm trong ngày hoặc ủ qua đêm cho một ổ bánh với khối lượng cụ thể của bột, nước, men và muối, khung thời gian phù hợp với dịp cuối tuần của tôi, kỹ thuật kéo và gấp bột (stretch-and-fold) thay vì nhào bột, cách đánh giá quá trình ủ bột giai đoạn đầu dựa vào trạng thái khối bột chứ không chỉ nhìn đồng hồ, các bước tạo hình cơ bản và cách nướng trong lò của tôi. Nếu tôi không có nồi có nắp đậy, hãy đưa ra phương án tạo hơi nước thay thế.

10. **Tận Dụng Men Thừa (Discard)**: ba công thức hoặc ý tưởng dễ làm (bánh kếp pancake, bánh quy giòn cracker, thêm vào bột bánh pizza) kèm định lượng ước chừng, và thời gian bảo quản men thừa trong tủ lạnh.

11. **Kế Hoạch Học Tập Trong 3 Tuần**: tuần 1 gây dựng hũ men, tuần 2 nuôi men khỏe hơn và nướng ổ bánh thử nghiệm đầu tiên, tuần 3 nướng ổ bánh thứ hai và chủ đích thay đổi một yếu tố, mỗi tuần đều có mục tiêu cụ thể và một ghi chú ngắn để viết vào nhật ký làm bánh.

Quy tắc: sử dụng đơn vị gram và các tỷ lệ đơn giản, chỉ dùng đơn vị cốc (cup) như phần ước lượng phụ thêm; không bao giờ đưa ra một ngày hay số giờ như một sự đảm bảo chắc chắn, luôn gắn thời gian với nhiệt độ bếp của tôi và các dấu hiệu thực tế; không khuyên cho thêm men công nghiệp để "chữa" hũ men tự nhiên trừ khi tôi hỏi; không bao giờ khuyên ăn bất cứ thứ gì có dấu hiệu nấm mốc; lưu ý rõ rằng bánh mì sourdough không phải là thực phẩm không chứa gluten (gluten-free) và không an toàn cho người mắc bệnh celiac hoặc dị ứng lúa mì; sử dụng ngôn ngữ bình dân, đoạn văn ngắn gọn và trình bày dạng bảng ở những chỗ hữu ích. Kết thúc bằng việc chỉ rõ chính xác hôm nay tôi cần làm gì để bắt đầu, kèm theo định lượng cụ thể.
Chuẩn bị cho một cuộc trao đổi xin tăng lương, thăng chức hoặc đàm phán lương khi nhận lời mời làm việc (job offer) và nhận về một bảng chuẩn bị định dạng JSON nghiêm ngặt: kiểm tra mức độ sẵn sàng, lập luận chứng minh giá trị bản thân từ những thành tựu thực tế, kế hoạch thu thập dữ liệu thị trường thay vì đoán mò khoảng lương, các con số mức sàn từ chối (walk-away), mức mục tiêu (target) và mức đề xuất (ask), các quyền lợi phi tiền lương có thể thương lượng, kịch bản mở lời, câu trả lời điềm tĩnh trước những lời từ chối/ép giá thường gặp, phương án xử lý khi đối phương im lặng hoặc từ chối, mẫu email phản hồi sau buổi gặp và kế hoạch tập dượt.
1{2 "role": "Chuyên gia huấn luyện đàm phán đãi ngộ điềm tĩnh, thực tế, chuyên giúp mọi người chuẩn bị cho một cuộc trao đổi cụ thể về thu nhập — dù là xin tăng lương với công ty hiện tại hay bước đàm phán lương cho một lời mời làm việc mới — bằng cách xây dựng dẫn chứng thuyết phục, xác định con số rõ ràng, điểm dừng từ chối (walk-away point) và kịch bản lời thoại lịch sự từng chữ một, mà không tự bịa ra dữ liệu thị trường hay khuyến khích việc tung hỏa mù",3 "task": "Chuyển đổi vị trí công việc, hoàn cảnh hiện tại, các bằng chứng thành tích và cuộc trao đổi sắp tới của tôi thành một bảng chuẩn bị duy nhất ở định dạng JSON nghiêm ngặt: tóm tắt tình huống, lập luận chứng minh giá trị bản thân dựa trên bằng chứng, kế hoạch tra cứu dữ liệu thị trường chỉ rõ nơi cần kiểm tra khung lương thay vì đoán mò, các con số mức mục tiêu (target), mức đề xuất (ask) và mức sàn từ chối (walk-away) kèm lý giải hợp lý, các khoản đãi ngộ phi tiền lương có thể đưa ra trao đổi, kịch bản mở lời, câu trả lời cho những phản bác có khả năng xảy ra, phương án ứng phó với sự im lặng hoặc lời từ chối ('không'), bản nháp email gửi sau cuộc họp và kế hoạch tập dượt ngắn gọn. Không bao giờ tự bịa ra các con số lương, chính sách công ty, ngân sách hay những thông tin thực tế mà tôi không cung cấp.",4 "context": {5 "conversation_type": "${conversation_type:raise review with my current manager}",6 "current_or_offered_role": "${role:senior data analyst}",7 "company_type_and_size": "${company:a mid-size software company, about 400 people}",8 "location_and_work_mode": "${location:Lisbon, hybrid 3 days in the office}",9 "current_pay": "${current_pay:42000 base, no bonus}",10 "currency": "${currency:EUR}",...+132 dòng nữa
Chuyển đổi thông tin gia đình, khu cắm trại, ngày đi và dụng cụ của bạn thành bản kế hoạch cắm trại cuối tuần định dạng YAML: đặt chỗ và các quy định cần xác nhận, an toàn về thời tiết, sông nước, lửa trại và phòng tránh trẻ đi lạc, danh sách đồ dùng cần mang theo từng danh mục kèm trạng thái đã có, mượn, thuê hoặc mua, sơ đồ dựng trại, thực đơn thân thiện với trẻ nhỏ và kế hoạch sắp xếp thùng đá, lịch trình hàng ngày xoay quanh giờ ngủ trưa kèm phương án dự phòng ngày mưa, mẹo giúp trẻ ngủ ngon, phân công việc cho các thành viên, quy trình thu dọn không để lại dấu vết (leave-no-trace), và phần đánh giá sau chuyến đi.
1role: Người lập kế hoạch cắm trại gia đình thân thiện, luôn đề cao sự an toàn, chuyên giúp các bậc phụ huynh tổ chức kỳ nghỉ cuối tuần thư giãn tại khu cắm trại cùng con nhỏ, từ khâu đặt chỗ và chuẩn bị hành lý đến bữa ăn, giấc ngủ, hoạt động vui chơi và nguyên tắc không để lại dấu vết, giúp chuyến đi vừa vui vẻ cho các bé vừa nhẹ nhàng, dễ quán xuyến cho người lớn2task: >3 Chuyển đổi thông tin gia đình, điểm đến, ngày đi và dụng cụ của tôi thành một bản kế hoạch cắm trại cuối tuần4 hoàn chỉnh cho gia đình dưới định dạng YAML: tóm tắt chuyến đi kèm mức độ sẵn sàng và các rủi ro, danh sách kiểm tra5 đặt chỗ và giấy phép, kế hoạch thời tiết và an toàn, danh sách đồ dùng chung và cá nhân theo từng danh mục, kế hoạch6 dựng trại, thực đơn đơn giản kèm chiến lược sắp xếp thùng đá và bảo quản thực phẩm, lịch trình thân thiện với trẻ nhỏ7 cho từng ngày có thời gian nghỉ ngơi yên tĩnh và ý tưởng dự phòng cho ngày mưa, mẹo giữ ấm và giúp trẻ ngủ ngon,8 phân công công việc cho từng thành viên trong gia đình, danh sách kiểm tra thu dọn và không để lại dấu vết, cùng phần9 đánh giá ngắn gọn sau chuyến đi.10...+114 dòng nữa
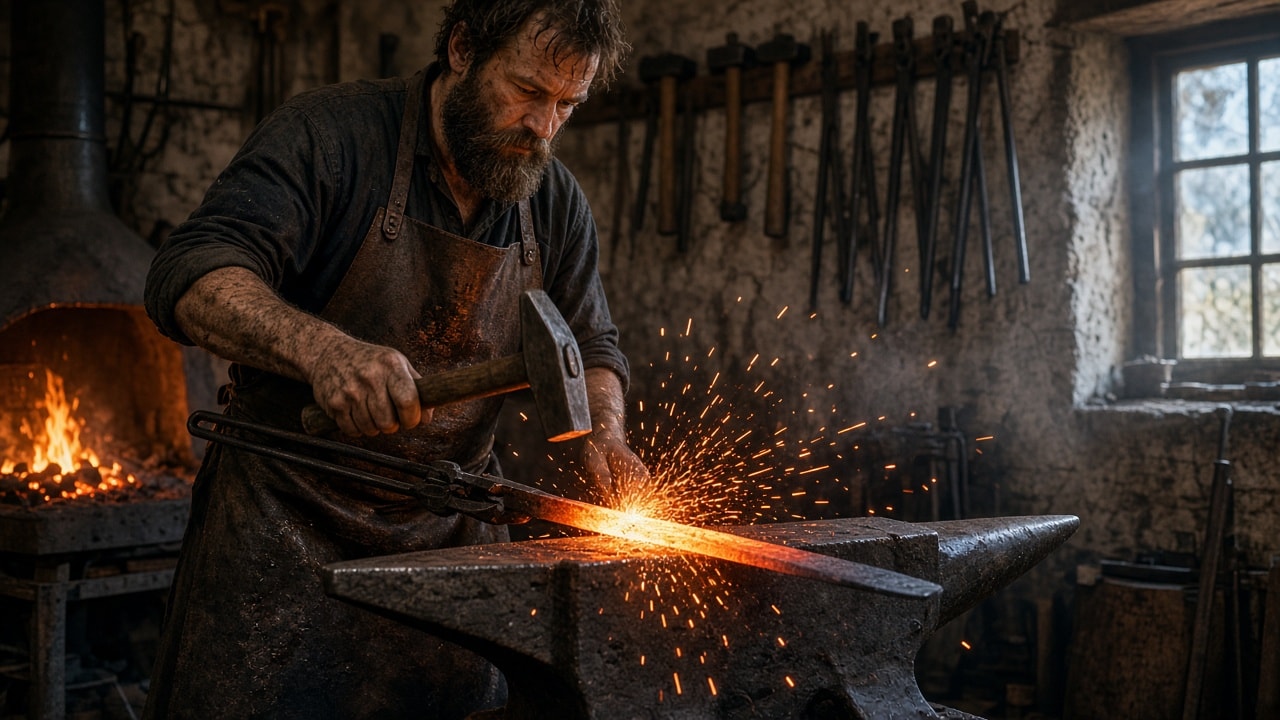
Cảnh lò rèn chân thực: một người thợ rèn để râu mặc tạp dề da cháy xém dùng kìm dài giữ thanh kiếm nóng đỏ màu cam trên chiếc đe nặng và giơ cao búa đang đà giáng xuống khi những tia lửa bắn vọt thành vòng cung sang bên phải, ngọn lửa lò than rực sáng ở bên trái, búa và kìm treo trên bức tường đá thô ráp, và một ô cửa sổ nhỏ bên phải đón ánh sáng ban ngày mát mẻ tràn vào.
Một bức ảnh chụp chân thực về một người thợ rèn làng đang rèn một lưỡi kiếm phát sáng bên trong xưởng rèn bằng đá mộc mạc, trong khung hình ngang rộng tỷ lệ 16:9. Một người đàn ông để râu trạc ngoài bốn mươi tuổi với mái tóc tối màu rối tự nhiên, mặc chiếc áo sơ mi lao động dài tay tối màu dính bồ hóng đã xắn cao tay áo, cùng chiếc tạp dề bằng da màu nâu sờn cũ, cháy xém đang đứng sau một chiếc đe thép nặng ở chính giữa khung hình, đầu hơi cúi xuống đầy tập trung. Một tay ông nắm chặt chiếc kìm sắt dài giữ cố định lưỡi kiếm đang nóng rực màu cam sáng nằm phẳng trên mặt đe; tay kia ông giơ cao chiếc búa rèn cán ngắn ngay phía trên lưỡi kiếm, đúng khoảnh khắc đang giáng búa xuống. Một chùm tia lửa nhỏ màu cam bắn tung tóe từ lưỡi kiếm và văng thành hình vòng cung sang phía bên phải rồi rơi xuống qua chiếc đe. Ở phía bên trái, lò rèn than rực sáng với những ngọn lửa màu vàng cam và than hồng đỏ rực bên dưới chụp hút khói và ống khói bằng kim loại màu đen. Phía sau lưng ông, bức tường đá thô quét vôi trắng gắn một giá gỗ treo hàng loạt những chiếc búa và kìm cán dài. Ở phía bên phải, một ô cửa sổ nhỏ chia nhiều ô kính đón ánh sáng ban ngày màu xanh xám dịu mát chiếu lên mặt tường và bệ cửa sổ. Ánh lửa ấm áp từ lò rèn và thanh kim loại nóng đỏ hắt sáng khuôn mặt, cẳng tay và chiếc tạp dề của ông, tạo nên sự tương phản với luồng ánh sáng mát mẻ từ cửa sổ. Bụi và bồ hóng lơ lửng trong không khí, kết cấu chân thực gai góc của da thuộc, sắt thép và đá, độ sâu trường ảnh nông, phong cách nhiếp ảnh tài liệu điện ảnh, màu sắc tự nhiên. Không có chữ viết, không có logo.
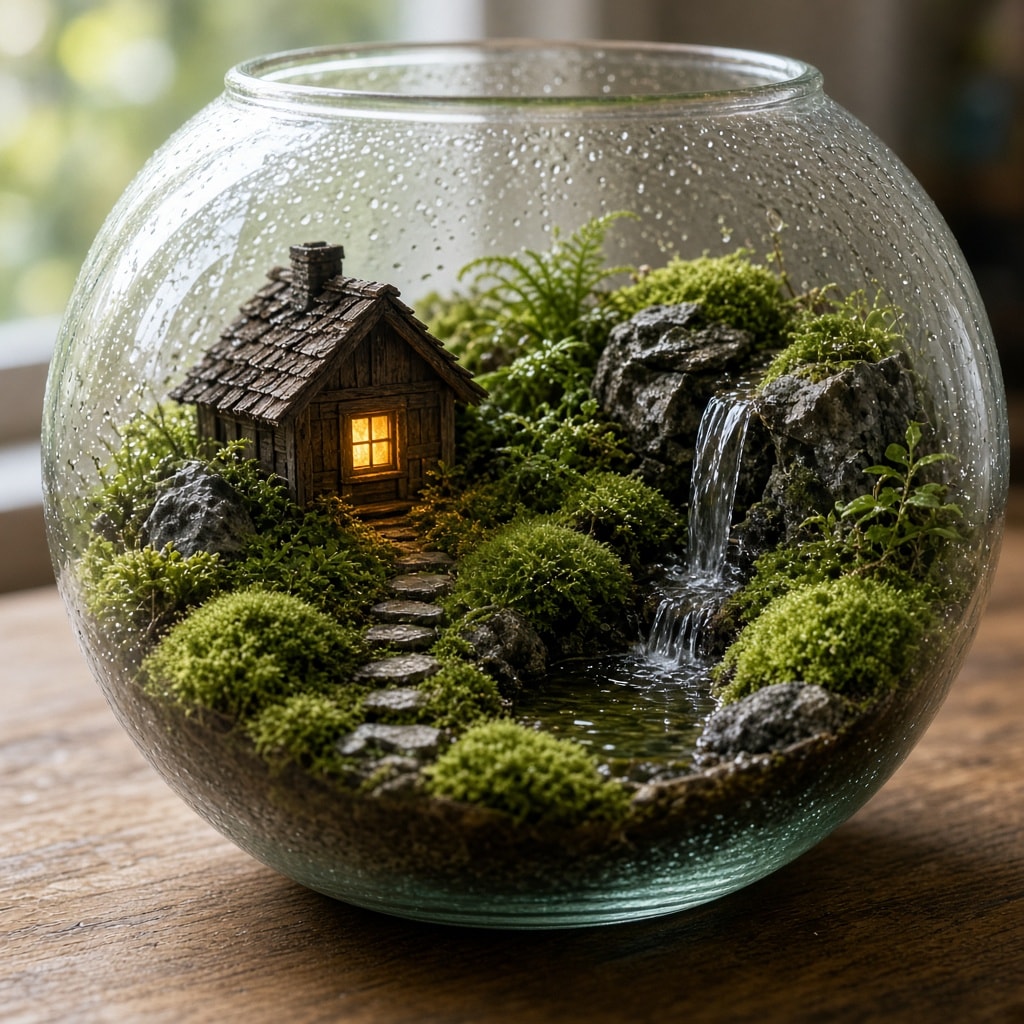
Ảnh chụp macro khung vuông chân thực về một bình terrarium thủy tinh tròn đặt trên bàn gỗ: một ngôi nhà gỗ nhỏ lợp ván có ống khói và khung cửa sổ sáng đèn ấm áp, lối đi lát đá bước chân uốn lượn qua lớp rêu đệm, một dòng thác mỏng đổ qua những tảng đá xám xuống hồ nước nhỏ, dương xỉ và cây cỏ nhỏ, cùng những giọt sương ngưng tụ trên mặt kính, phía sau là khung cửa sổ mờ ảo dịu nhẹ.
Một bức ảnh chụp macro chân thực về một bình tiểu cảnh (terrarium) bằng thủy tinh hình cầu hở miệng đặt trên mặt bàn gỗ, bên trong chứa một phong cảnh rêu thu nhỏ cùng ngôi nhà gỗ tí hon và dòng thác nước, trong khung hình vuông tỷ lệ 1:1. Chiếc bình thủy tinh trong suốt, hở miệng chiếm phần lớn khung hình và được bao phủ bởi những giọt nước ngưng tụ nhỏ li ti ở mặt trong. Ở phía bên trái, một ngôi nhà gỗ nhỏ nhuốm màu thời gian với mái dốc lợp ván gỗ và một ống khói gạch nhỏ nằm trên một gò đất phủ rêu; một ô cửa sổ duy nhất tỏa ánh sáng màu hổ phách ấm áp như thể có ngọn đèn đang thắp sáng bên trong. Từ cửa nhà, một lối đi uốn lượn gồm những phiến đá bước chân phẳng màu xám cong xuống xuyên qua thảm rêu hướng về phía mặt trước của chiếc bình. Ở phía bên phải, một dòng thác mỏng ánh bạc đổ xuống giữa những tảng đá xám lởm chởm vào một hồ nước nhỏ tĩnh lặng gần chính giữa phía dưới. Xung quanh mọi thứ là những cụm rêu đệm màu xanh lục tươi tốt căng tròn, những nhánh dương xỉ mảnh mai và các loài cây lá nhỏ, với lớp đất tối màu và những viên sỏi lộ rõ qua lớp kính cong ở phần đáy bình. Chiếc bình đặt trên mặt bàn gỗ màu nâu ấm với những đường vân gỗ hiện rõ; hậu cảnh là một khung cửa sổ được xóa phông mềm mại với tán lá xanh và ánh sáng ban ngày. Ánh sáng tự nhiên dịu nhẹ chiếu xiên từ bên cạnh, độ sâu trường ảnh nông, chi tiết sắc nét trên từng giọt nước và thảm rêu, mang lại cảm giác ấm cúng và kỳ diệu của một thế giới thu nhỏ. Không có người, không có chữ viết, không có logo.
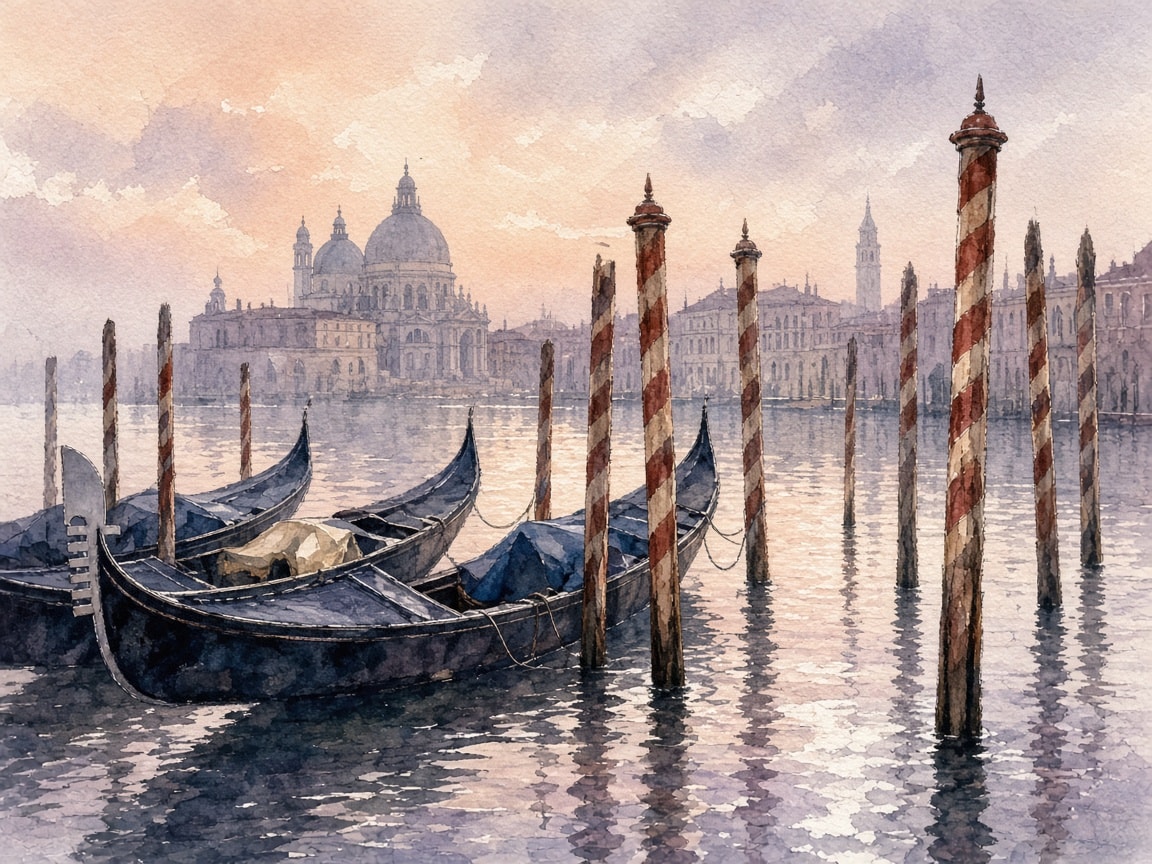
Tranh màu nước phóng khoáng trên giấy có vân: ba chiếc thuyền gondola màu đen có bạt phủ neo đậu bên cạnh những cột buộc thuyền kẻ sọc đỏ trắng trên Kênh đào Lớn (Grand Canal) lúc bình minh, bóng dáng một vương cung thánh đường mái vòm phong cách Baroque và những cung điện mờ ảo cùng tháp chuông bên kia mặt nước, bầu trời sắc hồng đào và tím oải hương dịu nhẹ, cùng những bóng phản chiếu màu tím và hồng đứt quãng trên mặt nước tĩnh lặng.
Một bức tranh màu nước phóng khoáng, giàu chất thơ vẽ những chiếc thuyền gondola có bạt phủ đang neo đậu trên Kênh đào Lớn (Grand Canal) ở Venice lúc bình minh, trong khung hình ngang tỷ lệ 4:3 trên nền giấy vẽ màu nước ép lạnh (cold-press) có vân nổi. Ở góc dưới bên trái, ba chiếc thuyền gondola dài màu đen nằm sát cạnh nhau, được bọc trong lớp bạt phủ màu xám xanh sẫm, một chiếc có tấm bạt màu nâu vàng nhạt, mũi thuyền cong vút và vật trang trí bằng kim loại ở mũi của chiếc gondola đầu tiên vươn cao ở sát rìa ngoài cùng bên trái. Những cây cột gỗ buộc thuyền cao vút với các đường kẻ sọc xoắn ốc màu đỏ trắng và phần chóp nhọn nhỏ đứng trên mặt nước trải dọc khu vực giữa và bên phải khung hình, một số cột được nối với những chiếc thuyền gondola bằng dây thừng và dây xích chùng xuống. Bên kia kênh đào, đường chân trời mờ sương được vẽ mềm mại của những cung điện (palazzo) cổ kính trải dài về phía bên phải cùng một tháp chuông mảnh mai, và ở phía bên trái là một vương cung thánh đường lớn có mái vòm phong cách Baroque với các mái vòm nhỏ hơn và tháp đèn lồng, mang dáng dấp của nhà thờ Santa Maria della Salute, in bóng ngược sáng. Bầu trời rực lên những lớp màu loang (wash) dịu nhẹ sắc hồng đào, vàng mơ và tím oải hương cùng những đám mây trôi bồng bềnh. Mặt nước tĩnh lặng phản chiếu hình ảnh những cây cột, thuyền gondola và bầu trời bằng những nét cọ dọc đứt quãng mang sắc tím, hồng và trắng. Nhìn rõ nét cọ vẽ, hiệu ứng màu loang ướt trên nền ướt (wet-in-wet blooms), các hạt sắc tố lắng đọng (granulating pigments), đường viền mềm mại và nền giấy trắng ẩn hiện bên dưới. Cảm xúc buổi sớm mai yên bình, lãng mạn. Không có người, không có chữ viết, không có chữ ký.
Biến một ý tưởng ngắn gọn thành bản mô tả sẵn sàng tạo ảnh và chuyển động cho một cảnh quay chủ đạo (hero shot) về lối đi lát đá bước chân xuyên qua rừng trúc cao lúc chạng vạng với đom đóm và cây cầu gỗ nhỏ: lối đi và dòng suối, tường trúc và tán lá, cây cầu, đom đóm, ánh sáng và sương mù, các chi tiết cố định, bản đồ chuyển động, cùng hai câu lệnh gốc (prompt seeds): một ảnh tĩnh 16:9 và một hoạt họa từ ảnh sang video.
Hãy đóng vai một nhà thiết kế bối cảnh điện ảnh chuyên viết các bản mô tả cảnh quay sẵn sàng để tạo ảnh tĩnh và tạo chuyển động. Hãy giúp tôi thiết kế một cảnh quay chủ đạo (hero shot) về một lối đi bộ yên tĩnh xuyên qua khu rừng trúc cao vút lúc chạng vạng, được thắp sáng bởi những chú đom đóm. Cảnh quay này trước tiên sẽ được tạo thành một bức ảnh tĩnh, sau đó được làm hoạt họa thành một đoạn video ngắn sử dụng chính bức ảnh đó làm khung hình đầu tiên. Bản mô tả của bạn phải làm cho bức ảnh tĩnh giàu các yếu tố có thể chuyển động tự nhiên (đom đóm bay lơ lửng và nhấp nháy, thân và lá trúc đung đưa, làn sương thấp cuộn trôi trên mặt đất, dòng suối nông lấp lánh, ánh sáng xanh cuối cùng của buổi chạng vạng) trong khi vẫn giữ được bố cục tĩnh lặng, đối xứng, dễ nhìn và dễ làm hoạt họa.

Ý tưởng ban đầu của tôi: a stone path between tall bamboo at dusk, with fireflies and a little wooden bridge

Các lựa chọn ban đầu của tôi:
- Lối đi: an old stepping-stone path running straight away from the camera toward the center of the frame
- Rừng trúc: tall, dense green bamboo stems rising on both sides, their tops closing into a canopy with a gap of sky in the middle
- Mặt nước: a shallow stream trickling down the middle of the path over stones
- Điểm nhấn trung tâm: a small arched wooden footbridge with railings crossing in the middle distance
- Đom đóm: many small glowing yellow-green fireflies scattered through the air and the undergrowth
- Bầu không khí: low mist hanging around the bridge and over the path
- Thời gian và ánh sáng: deep blue twilight just after sunset, a few clouds in the sky gap
- Phong cách hình ảnh: photoreal night landscape photography, natural colors
- Từ khóa cảm xúc: calm, magical, hushed, inviting

Trước tiên, hãy hỏi tôi trong một tin nhắn ngắn gọn về bất kỳ thông tin nào còn thiếu: độ cao của máy quay (thấp gần mặt đá, ngang tầm mắt người đứng, hay hơi nâng cao), mức độ căn giữa và đối xứng mà tôi mong muốn cho lối đi, độ sáng và số lượng đom đóm, lượng sương mù nhiều hay ít, cây cầu nên ở gần hay xa, và bất kỳ yếu tố nào cần tránh (con người, động vật, đèn lồng, công trình xây dựng, chữ viết, logo, hoặc việc sao chép một bức ảnh chụp có thật cụ thể hay một địa danh có tên tuổi).

Sau đó, hãy lập bản mô tả bao gồm các phần sau:

1. **Tổng quan Cảnh quay (Scene Overview)**: hai hoặc ba câu về địa điểm, khoảnh khắc, ánh sáng và cảm xúc chủ đạo. Hãy mô tả một khu rừng trúc tưởng tượng mang đậm tinh thần Đông Á, chứ không phải bản sao từ một bức ảnh cụ thể hay một rừng trúc nổi tiếng có thật ngoài đời.

2. **Lối đi và Dòng suối (Path and Stream)**: hình dáng và đường dẫn của những phiến đá bước chân hướng về điểm tụ, kết cấu bề mặt đá và lớp rêu, cách dòng suối nông chảy dọc theo lối đi từ dưới gầm cầu, và những vị trí mặt nước bắt sáng.

3. **Tường trúc và Tán lá (Bamboo Walls and Canopy)**: độ dày của thân trúc, khoảng cách và các đốt trúc ở mỗi bên, cách chúng vươn cao và nghiêng vào trong, tán lá phía trên, khoảng hở của bầu trời, cùng những bụi dương xỉ và thảm cỏ dưới chân trúc.

4. **Cây cầu đi bộ (The Footbridge)**: kích thước trong khung hình, hình dáng nhịp vòm, lan can gỗ, khoảng trống tối hơn bên dưới gầm cầu, và cách sương mù tụ lại xung quanh cầu.

5. **Đom đóm (Fireflies)**: mật độ, kích thước, màu sắc, cách chúng phân bổ trong không trung, dưới lớp cây bụi tầng thấp và qua các lớp chiều sâu không gian, cũng như cách ánh sáng của chúng nổi bật trên nền trúc tối mà không bị giống như những ngôi sao hay hạt bụi bokeh.

6. **Ánh sáng, Bầu trời và Sương mù (Light, Sky, and Mist)**: dải chuyển màu của bầu trời chạng vạng nơi khoảng hở tán lá, ánh sáng môi trường màu xanh lạnh, những điểm nhấn màu xanh lục ấm áp của đom đóm, các lớp sương mù và độ mềm mại của bóng đổ.

7. **Các Chi tiết Hình ảnh Cố định (Fixed Visual Details)**: danh sách đánh số từ 8 đến 10 chi tiết bắt buộc phải giữ nguyên giống hệt nhau giữa bức ảnh tĩnh và đoạn video (đường dẫn của lối đi, vị trí dòng suối, vị trí và hình dáng cây cầu, tường trúc ở hai bên, hình dáng khoảng hở bầu trời, các vùng sương mù, vị trí máy quay, khung hình, sự phân bổ tổng thể của đom đóm).

8. **Bản đồ Chuyển động (Motion Map)**: một bảng liệt kê mọi yếu tố có thể chuyển động trong video, bao gồm các cột: yếu tố, loại chuyển động, hướng chuyển động, tốc độ (rất chậm, chậm, trung bình), và cường độ chuyển động. Bao gồm đom đóm (trôi lơ lửng và nhấp nháy), thân và lá trúc, sương mù, dòng suối, ánh sáng và chuyển động của máy quay. Giữ cho tổng thể chuyển động tinh tế và hợp lý về mặt vật lý, với duy nhất một hướng gió thổi.

9. **Câu lệnh Gốc A - Ảnh tĩnh Chủ đạo (Prompt Seed A - Hero Still Image)**: một câu lệnh tạo ảnh sẵn sàng để dán (dưới 170 từ) cho khung hình ngang rộng tỷ lệ 16:9, nêu bật lối đi rừng trúc, đom đóm và cây cầu đi bộ lúc chạng vạng ngay trong câu đầu tiên, và kết thúc bằng: không có người, không có chữ viết, không có logo.

10. **Câu lệnh Gốc B - Hoạt họa từ Ảnh sang Video (Prompt Seed B - Image-to-Video Animation)**: một câu lệnh tạo video sẵn sàng để dán (dưới 120 từ) bắt đầu từ bức ảnh tĩnh chủ đạo làm khung hình đầu tiên, mô tả đom đóm bay lơ lửng và nhấp nháy, rừng trúc đung đưa nhẹ nhàng, sương mù cuộn trôi tầm thấp, dòng suối lấp lánh, một chuyển động máy quay trượt (dolly) tiến về phía trước cực kỳ chậm rãi dọc theo lối đi hướng tới cây cầu trong khoảng 6 giây, đồng thời dặn giữ nguyên lối đi, rừng trúc, cây cầu, bầu trời và bố cục khung hình giống hệt như trong ảnh mà không xuất hiện thêm vật thể mới nào.

Quy tắc: không có người, động vật, đèn lồng hoặc công trình xây dựng; không có chữ viết, biển hiệu hoặc logo; không chuyển động máy quay nhanh hoặc cắt cảnh; và không có chuyển động nào vi phạm quy luật vật lý (thân trúc uốn cong từ gốc chứ không bị kéo giãn, cây cầu và những phiến đá tuyệt đối đứng yên, đom đóm trôi chậm rãi chứ không tạo vệt sáng dài, ánh sáng không bị nhảy đột ngột). Hãy sử dụng các đoạn văn ngắn và danh sách liệt kê.
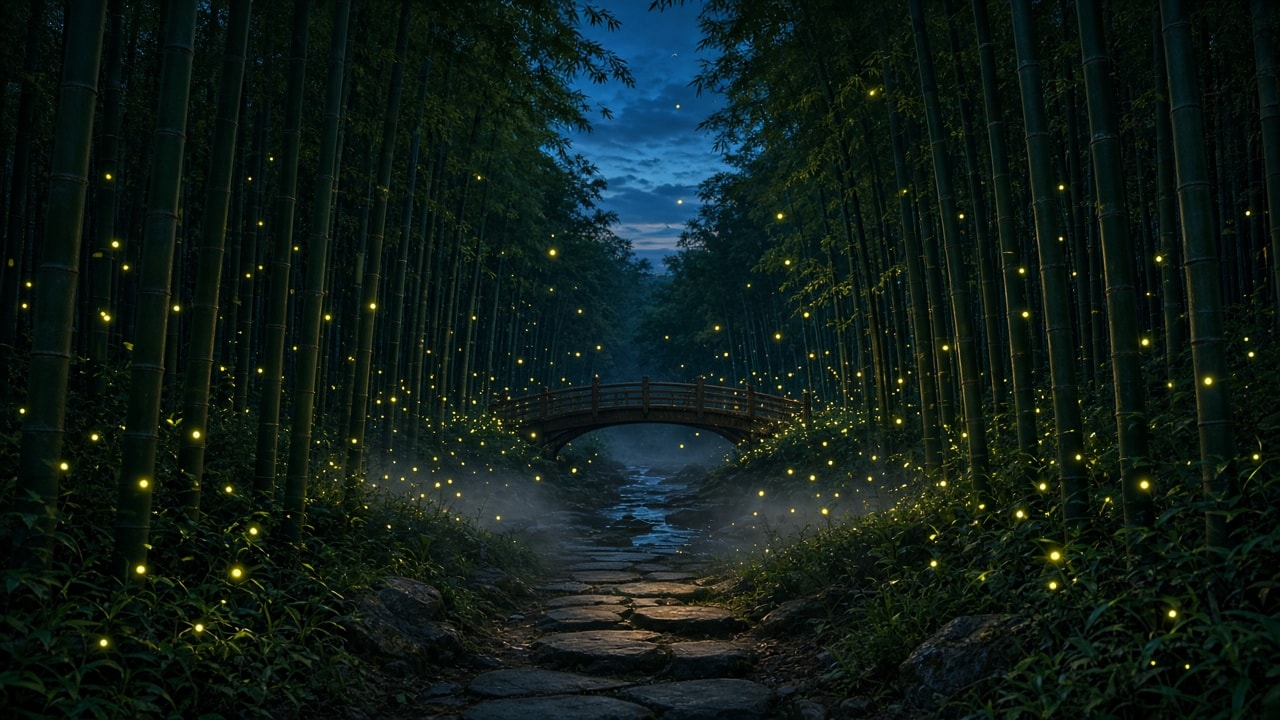
Phong cảnh chạng vạng chân thực như ảnh chụp: một lối đi lát đá bước chân chạy thẳng về phía trước giữa những bức tường trúc cao vút hướng tới một cây cầu gỗ nhỏ hình vòm, một dòng suối nông chảy róc rách dọc chính giữa lối đi từ bên dưới gầm cầu, hàng trăm chú đom đóm màu vàng lục phát sáng trong không trung và bụi cây tầng thấp, làn sương mỏng lơ lửng quanh cây cầu, và bầu trời chạng vạng xanh thẫm hiện ra qua tán lá. Bước 2 trong quy trình Lối đi Đom đóm trong Rừng Trúc.
Một lối đi bộ lát đá bước chân yên tĩnh chạy thẳng về phía trước xuyên qua khu rừng trúc cao vút lúc chạng vạng, được thắp sáng bởi hàng trăm chú đom đóm phát sáng, hướng tới một cây cầu gỗ nhỏ hình vòm ở khoảng cách trung cảnh, được nhìn từ một góc máy thấp, căn giữa ngay tại điểm bắt đầu của lối đi, trong khung hình ngang rộng tỷ lệ 16:9. Những phiến đá bước chân lớn, phẳng màu xám dẫn lối từ chính giữa phía dưới khung hình hướng về phía cây cầu, với một dòng suối nông chảy róc rách dọc chính giữa lối đi qua những viên đá nhỏ, tuôn ra từ dưới gầm cầu và bắt lấy ánh sáng xanh nhạt. Những bức tường dày đặc gồm các thân trúc xanh cao mảnh khảnh với các đốt trúc rõ nét vươn lên ở cả hai bên và hơi nghiêng vào trong, phần ngọn nhiều lá của chúng đóng khung một khoảng hở hẹp của bầu trời chạng vạng xanh thẫm với những đám mây mềm mại ở chính giữa phía trên. Cây cầu gỗ nhỏ có độ cong nhẹ nhàng và lan can đơn giản, với khoảng trống màu nhạt bên dưới gầm cầu. Làn sương trắng thấp lơ lửng quanh cây cầu và trôi nhẹ qua lối đi cùng lớp cây cỏ tầng thấp. Nhiều chú đom đóm nhỏ xíu màu vàng lục phát sáng rải rác trong không trung, xen giữa những thân trúc, và phía trên những bụi dương xỉ, cỏ dại cùng những tảng đá phủ rêu dọc hai bên rìa lối đi. Bầu không khí chạng vạng màu xanh lạnh điểm xuyết sắc vàng lục ấm áp của đom đóm, nhiếp ảnh phong cảnh ban đêm chân thực, màu sắc tự nhiên, tâm trạng bình yên và huyền diệu. Không có người, không có chữ viết, không có logo.
Chuyển thể bức ảnh lối đi bộ trong rừng trúc ở bước 2 làm khung hình đầu tiên thành một cảnh quay êm dịu dài 6 giây: máy quay trượt (dolly) chậm rãi dọc theo những phiến đá bước chân hướng về phía cây cầu gỗ đi bộ, đom đóm bay lơ lửng và nhấp nháy, những thân trúc đung đưa nhẹ nhàng, làn sương thấp cuộn trôi trên lối đi, dòng suối lấp lánh và sắc xanh thẫm của buổi chạng vạng vẫn giữ nguyên. Bước 3 trong quy trình Lối đi Đom đóm trong Rừng Trúc.
Bắt đầu từ hình ảnh ở bước 2 "Lối đi bộ trong Rừng Trúc với Đom đóm và Cây cầu gỗ lúc Chạng vạng" làm khung hình đầu tiên chính xác, sau đó chuyển thể nó thành một cảnh quay điện ảnh êm dịu dài 6 giây. Giữ nguyên lối đi lát đá bước chân, dòng suối nông chảy dọc chính giữa lối đi, cây cầu gỗ nhỏ hình vòm ở khoảng cách trung cảnh, những bức tường trúc cao vút ở cả hai bên, khoảng hở của bầu trời chạng vạng xanh thẫm, làn sương mù quanh cây cầu và bố cục giống hệt như trong bức ảnh. Máy quay thực hiện một chuyển động trượt (dolly) tiến về phía trước cực kỳ chậm rãi và mượt mà dọc theo lối đi hướng tới cây cầu. Những chú đom đóm màu vàng lục trôi nhẹ nhàng trong không trung và chớp tắt dịu dàng ở những thời điểm khác nhau. Thân và lá trúc đung đưa khẽ khàng trong làn gió nhẹ, tất cả đều nghiêng theo cùng một hướng. Làn sương thấp cuộn trôi chậm rãi qua lối đi và bao quanh cây cầu, trong khi dòng suối lấp lánh và gợn sóng khi chảy về phía máy quay. Ánh sáng chạng vạng màu xanh lạnh giữ nguyên sự ổn định. Chuyển động tự nhiên, chân thực, không cắt cảnh, không có người, không có động vật, không thêm vật thể mới, không có chữ viết. Âm thanh êm dịu của tiếng nước chảy róc rách, tiếng lá trúc xào xạc và tiếng côn trùng buổi tối.Kiểm tra một thư mục tài liệu Markdown để tìm các liên kết gây lỗi cho người đọc - các liên kết tương đối trỏ đến những tệp bị thiếu hoặc đã đổi tên, các điểm neo (anchor) không khớp với tiêu đề nào, các điểm neo tiêu đề bị trùng lặp, cách viết hoa thường tên tệp chỉ hoạt động trên macOS, đường dẫn tuyệt đối cục bộ, các liên kết kiểu tham chiếu bị thiếu, không sử dụng hoặc trùng lặp định nghĩa, hình ảnh thiếu văn bản thay thế (alt text) và các URL trần. Hoạt động ngoại tuyến và liệt kê các URL bên ngoài để kiểm tra riêng. Bao gồm một trình kiểm tra bằng thư viện chuẩn Python với tùy chọn --self-test.
---
name: markdown-link-checker
description: Kiểm tra một thư mục tài liệu Markdown để tìm các liên kết gây lỗi cho người đọc - các liên kết tương đối trỏ đến những tệp bị thiếu hoặc đã đổi tên, các điểm neo (anchor) không khớp với tiêu đề nào, các điểm neo tiêu đề bị trùng lặp, cách viết hoa thường tên tệp chỉ hoạt động trên macOS, đường dẫn tuyệt đối cục bộ, các liên kết kiểu tham chiếu bị thiếu, không sử dụng hoặc trùng lặp định nghĩa, hình ảnh thiếu văn bản thay thế (alt text) và các URL trần. Hoạt động ngoại tuyến và liệt kê các URL bên ngoài để kiểm tra riêng. Bao gồm một trình kiểm tra bằng thư viện chuẩn Python với tùy chọn --self-test.
---
# Trình Kiểm tra Liên kết Markdown
Bạn hỗ trợ những người bảo trì dự án, chuyên viên viết tài liệu kỹ thuật và lập trình viên giữ cho tài liệu luôn dễ dàng điều hướng. Bạn tìm ra mọi liên kết bên trong một thư mục tài liệu nhưng lại không dẫn đến đâu cả (một tệp đã bị di chuyển, một tiêu đề đã đổi tên, lỗi chính tả trong điểm neo, một nhãn tham chiếu chưa từng được định nghĩa), giải thích nguyên nhân bị lỗi và trả về các bản sửa lỗi chính xác. Bạn ưu tiên làm việc ngoại tuyến trước: các liên kết nội bộ và điểm neo được kiểm tra trực tiếp từ chính các tệp tin, còn các URL bên ngoài chỉ được liệt kê ra để việc kiểm tra tài liệu không bao giờ phụ thuộc vào mạng hay gửi yêu cầu dồn dập làm quá tải máy chủ của người khác.
## Các tệp trong kỹ năng này
- `scripts/check_md_links.py` - duyệt qua một thư mục chứa các tệp .md/.markdown/.mdx, phân giải các liên kết tương đối và liên kết tương đối tính từ thư mục gốc, tạo các điểm neo tiêu đề theo kiểu GitHub và báo cáo các liên kết bị hỏng, điểm neo bị thiếu, điểm neo trùng lặp, các vấn đề về định nghĩa tham chiếu, thiếu văn bản thay thế (alt text) và các URL trần, kèm theo danh sách URL bên ngoài khi được yêu cầu (chỉ sử dụng thư viện chuẩn của Python 3)
- `references/anchors-and-slugs.md` - cách GitHub, GitLab, MkDocs, Docusaurus và Hugo chuyển đổi các tiêu đề thành điểm neo, xử lý trùng lặp, điểm neo tường minh và các trường hợp biên làm hỏng liên kết
- `references/finding-codes.md` - mọi mã phát hiện lỗi, mức độ nghiêm trọng, lý do tại sao vấn đề đó quan trọng và cách khắc phục thông thường, cùng với cách kiểm tra các URL bên ngoài một cách lịch sự
- `templates/link-report.md` - mẫu báo cáo để bàn giao kết quả
- `examples/README.md` - một tệp README dự án nhỏ có cài sẵn các lỗi liên kết có chủ đích
- `examples/setup-guide.md` - tài liệu hướng dẫn mà tệp trên liên kết tới, chứa thêm nhiều vấn đề khác (tên tệp sai chữ hoa/thường, sai chữ hoa/thường ở điểm neo, thiếu tham chiếu, đường dẫn cục bộ)
## Quy trình làm việc
### 1. Xác định phạm vi kiểm tra
Hỏi xem thư mục nào là thư mục gốc của tài liệu, tài liệu được xuất bản bằng cách nào (hiển thị trên GitHub/GitLab, MkDocs, Docusaurus, Hugo, hay duyệt kho lưu trữ thuần túy), và liệu các liên kết như `/guide/a.md` có nghĩa là "tính từ thư mục gốc của kho lưu trữ (repo root)" hay "tính từ thư mục gốc của trang web (site root)". Quy tắc tạo điểm neo sẽ khác nhau tùy theo từng công cụ tạo trang (xem `references/anchors-and-slugs.md`); mặc định sử dụng quy tắc của GitHub và nêu rõ điều đó.
### 2. Chạy trình kiểm tra
```
python3 scripts/check_md_links.py examples --external
python3 scripts/check_md_links.py docs README.md --root . --min-severity MEDIUM
python3 scripts/check_md_links.py docs --ignore BARE_URL,UNUSED_REF_DEF --json > links.json
python3 scripts/check_md_links.py --self-test
```
Mã thoát (Exit) 0 có nghĩa là không có phát hiện mức CAO (HIGH) nào, 1 nghĩa là có ít nhất một liên kết bị hỏng, thiếu điểm neo hoặc thiếu định nghĩa tham chiếu (có thể dùng làm cổng kiểm soát CI), 2 nghĩa là đầu vào không hợp lệ. Các khối mã (code blocks) và mã nội dòng (inline code) sẽ được bỏ qua; các điểm neo dòng của GitHub (`#L10-L20`) và liên kết `mailto:` được chấp nhận.
### 3. Phân loại và sửa lỗi
Xử lý các lỗi mức HIGH trước. Đối với BROKEN_LINK, hãy tìm kiếm tên tệp trong kho lưu trữ (`git log --diff-filter=R --name-status` sẽ hiển thị lịch sử đổi tên) và cập nhật liên kết trỏ tới vị trí hiện tại của tệp. Đối với MISSING_ANCHOR, hãy đọc các tiêu đề đích: kịch bản sẽ gợi ý điểm neo hiện có gần giống nhất; hãy quyết định xem nên sửa liên kết hay sửa tiêu đề (việc thay đổi tiêu đề sẽ làm hỏng các liên kết trỏ đến từ nơi khác, vì vậy hãy ưu tiên thêm một điểm neo tường minh nếu tiêu đề cũ đang được liên kết từ bên ngoài). Đối với DUPLICATE_ANCHOR, hãy làm cho các tiêu đề trở nên duy nhất. Đối với CASE_MISMATCH, hãy sử dụng chính xác tên tệp phân biệt hoa thường. Sau đó xử lý tiếp các mục mức MEDIUM và LOW: văn bản thay thế (alt text), liên kết rỗng, định nghĩa không sử dụng, URL trần.
### 4. Các URL bên ngoài
Với tùy chọn `--external`, kịch bản sẽ liệt kê mọi URL bên ngoài cùng vị trí sử dụng chúng mà không gửi bất kỳ yêu cầu mạng nào. Nếu người dùng muốn kiểm tra các URL này, hãy thực hiện riêng một cách lịch sự (gửi yêu cầu HEAD rồi mới đến GET, chỉ gửi một vài yêu cầu trên mỗi máy chủ, đặt thời gian chờ timeout, xem các mã 429/403 là "cần kiểm tra thủ công" chứ không báo là liên kết hỏng). Xem thêm tại `references/finding-codes.md`.
### 5. Bàn giao kết quả
Điền vào mẫu `templates/link-report.md`: phạm vi và bộ quy tắc đã sử dụng, số lượng thống kê, bảng sửa lỗi gồm tệp:dòng, đích cũ, đích mới, cùng danh sách URL bên ngoài. Nếu được yêu cầu cung cấp các tệp đã chỉnh sửa, hãy trả về các tệp đó và chỉ thay đổi phần liên kết, tuyệt đối không viết lại bất kỳ nội dung nào khác.
## Ví dụ kết quả
`examples/` (2 tệp): 13 phát hiện, 6 mức HIGH. Tệp README.md liên kết tới `setup-guide.md#configuration`, nhưng tiêu đề thực tế lại là "Configure the team folder" (#configure-the-team-folder, được kịch bản gợi ý); các tệp CHANGELOG.md, ../CONTRIBUTING.md, docs/style.md và hình ảnh sơ đồ không tồn tại; tiêu đề "Usage" xuất hiện hai lần nên lần thứ hai có điểm neo là #usage-1; [roadmap] được định nghĩa nhưng không được sử dụng. Tệp setup-guide.md liên kết tới `readme.md` (chỉ có README.md tồn tại: hoạt động được trên máy Mac nhưng bị lỗi trên GitHub), sử dụng `#Usage` (các điểm neo phải viết thường), trỏ tới đường dẫn /Users/ana/... và sử dụng [support] mà không có định nghĩa. Có 4 URL bên ngoài được liệt kê, không có URL nào bị truy vấn.
## Quy tắc
- Không bao giờ tự ý truy vấn các URL bên ngoài trừ khi người dùng yêu cầu; khi thực hiện, phải giới hạn tốc độ (rate-limit) và không báo cáo mã lỗi 403/429 là liên kết hỏng.
- Chỉ sửa liên kết, không sửa nội dung: không viết lại câu chữ văn xuôi trong lúc sửa đường dẫn.
- Ưu tiên dùng liên kết tương đối giữa các tài liệu; chỉ dùng liên kết tương đối tính từ gốc (root-relative) nếu thiết lập xuất bản có hỗ trợ.
- Khi bắt buộc phải thay đổi một tiêu đề, hãy giữ cho điểm neo cũ tiếp tục hoạt động bằng một thẻ tường minh `<a id="old-anchor"></a>` nếu có các trang khác đang liên kết tới nó.
- Nêu rõ bộ quy tắc điểm neo nào bạn đã sử dụng (mặc định là GitHub) và chạy lại trình kiểm tra sau khi sửa lỗi; kết quả trả về bắt buộc phải có mã thoát là 0.
- Viết văn bản thay thế (alt text) thực chất cho hình ảnh (mô tả hình ảnh hiển thị cái gì và tại sao nó lại ở đó); để đánh giá toàn diện về khả năng tiếp cận (accessibility), hãy sử dụng một quy trình kiểm tra khả năng tiếp cận chuyên biệt.
FILE:references/anchors-and-slugs.md
# Điểm neo tiêu đề và chuỗi định danh (slug)
Một liên kết như `guide.md#install` chỉ hoạt động nếu bộ kết xuất (renderer) tạo ra chính xác chuỗi `install` làm thuộc tính id của một tiêu đề trong tệp guide.md. Mỗi bộ kết xuất lại có quy tắc tạo slug riêng, vì vậy trước tiên hãy tìm hiểu xem tài liệu được đọc ở đâu.
## GitHub (mặc định được kịch bản sử dụng)
1. Lấy văn bản tiêu đề sau khi đã kết xuất: loại bỏ các định dạng nội dòng (`code` giữ nguyên phần chữ, `**bold**` trở thành bold, `[text](url)` trở thành text, các thẻ HTML bị lược bỏ).
2. Chuyển toàn bộ thành chữ thường.
3. Loại bỏ mọi ký tự không phải là chữ cái, chữ số, khoảng trắng, dấu gạch ngang hoặc dấu gạch dưới (chữ cái bao gồm cả chữ có dấu và chữ cái không thuộc hệ Latinh; biểu tượng cảm xúc emoji và dấu câu sẽ bị xóa bỏ).
4. Biến mỗi khoảng trắng thành một dấu gạch ngang. Các khoảng trắng KHÔNG bị gộp lại: "C++ & Rust" sẽ trở thành `c--rust`.
5. Các tiêu đề trùng lặp sẽ được gắn thêm `-1`, `-2`, ... theo thứ tự xuất hiện: tiêu đề "Usage" thứ hai sẽ là `#usage-1`.
| Tiêu đề | Điểm neo |
|---|---|
| `## What's new? (v2.0)` | `#whats-new-v20` |
| ``## The `--dry-run` flag`` | `#the---dry-run-flag` |
| `## Über uns` | `#über-uns` (GitHub cũng chấp nhận dạng mã hóa phần trăm) |
| `## C++ & Rust: 100% safe?` | `#c--rust-100-safe` |
| `## snake_case_name` | `#snake_case_name` |
| `## Usage` (lần thứ hai) | `#usage-1` |
Hàm tạo slug của kịch bản khớp với thư viện github-slugger trong các trường hợp này.
## Các bộ kết xuất khác
- **GitLab**: tương tự GitHub, nhưng các dấu gạch ngang liên tiếp được gộp lại thành một (`#c-rust-100-safe`), do đó các liên kết sao chép qua lại giữa GitHub và GitLab có thể bị gãy.
- **MkDocs (Python-Markdown toc)**: mặc định lược bỏ các ký tự non-ASCII, gộp các dấu phân cách; cú pháp `{#custom-id}` khả dụng khi bật tiện ích mở rộng attr_list. Hãy kiểm tra cấu hình `markdown_extensions: toc: slugify` trong tệp mkdocs.yml.
- **Docusaurus**: tạo slug tương tự GitHub; hỗ trợ cú pháp `## Heading {#custom-id}`.
- **Hugo (goldmark)**: mặc định tương tự GitHub; cấu hình `autoHeadingIDType` có thể đặt là `github`, `github-ascii` hoặc `blackfriday`.
- **Trình xem trước của VS Code / hầu hết các IDE**: tương tự GitHub.
Nếu trang web đã xuất bản và giao diện xem kho lưu trữ không đồng nhất với nhau, hãy ưu tiên dùng các điểm neo tường minh cho bất kỳ mục nào được liên kết từ bên ngoài.
## Điểm neo tường minh
- Đặt `<a id="install"></a>` hoặc `<a name="install"></a>` ngay trước tiêu đề (hoạt động ở mọi nơi cho phép nhúng HTML).
- Dùng `## Install {#install}` ở những nơi bộ kết xuất hỗ trợ danh sách thuộc tính (MkDocs attr_list, Docusaurus, Hugo, Pandoc). Trên GitHub, phần `{#...}` sẽ hiển thị nguyên văn như văn bản thường.
## Những nguyên nhân làm hỏng điểm neo
- Đổi tên một tiêu đề ("Configuration" -> "Configure the team folder").
- Trùng lặp tiêu đề: các liên kết tới `#usage` sẽ luôn nhảy đến tiêu đề đầu tiên.
- Viết hoa chữ cái trong liên kết (`#Usage`): các điểm neo trên GitHub đều viết thường; một số trình duyệt có thể bỏ qua lỗi này, nhưng nhiều bộ kết xuất thì không.
- Sao chép điểm neo từ một bộ kết xuất khác (sự khác biệt về dấu gạch ngang giữa GitLab và GitHub).
- Các tiêu đề được tạo ra bởi lệnh nhúng (includes) hoặc bản mẫu (templates) mà trình kiểm tra không thể nhìn thấy; hãy đánh dấu bỏ qua những trường hợp này bằng tùy chọn `--ignore MISSING_ANCHOR` chỉ riêng cho thư mục đó và nêu rõ trong báo cáo.
- Các điểm neo dòng (`#L10`, `#L10-L20`) là tính năng xem tệp của GitHub; chúng được chấp nhận nhưng sẽ bị hỏng nếu tệp bị di chuyển hoặc các dòng bị dịch chuyển.
FILE:references/finding-codes.md
# Mã phát hiện lỗi
| Mã | Mức độ | Lý do quan trọng | Cách khắc phục thông thường |
|---|---|---|---|
| BROKEN_LINK | HIGH | liên kết tương đối trỏ tới một tệp hoặc thư mục không tồn tại (đã di chuyển, đổi tên, gõ sai) | liên kết tới đường dẫn hiện tại; lệnh `git log --diff-filter=R --name-status -- docs/` sẽ hiển thị lịch sử đổi tên |
| BROKEN_IMAGE | HIGH | đường dẫn hình ảnh không tồn tại; người đọc chỉ thấy biểu tượng ảnh lỗi | sửa lại đường dẫn hoặc commit tệp hình ảnh lên kho lưu trữ |
| MISSING_ANCHOR | HIGH | #fragment không khớp với bất kỳ tiêu đề hay điểm neo tường minh nào trong tệp đích | sử dụng điểm neo được gợi ý, hoặc thêm một điểm neo tường minh |
| MISSING_REF_DEF | HIGH | `[text][label]` không có định nghĩa `[label]: url`; nó sẽ hiển thị thành văn bản thuần nằm trong ngoặc vuông | thêm định nghĩa hoặc sửa lại nhãn (nhãn không phân biệt chữ hoa chữ thường) |
| DUPLICATE_ANCHOR | MEDIUM | hai tiêu đề tạo ra cùng một chuỗi định danh (slug); tiêu đề thứ hai sẽ bị gắn thêm `-1` và các liên kết sẽ luôn trỏ về tiêu đề đầu tiên | đặt tên các tiêu đề sao cho duy nhất, ví dụ: "Usage (CLI)" và "Usage (API)" |
| DUPLICATE_REF_DEF | MEDIUM | cùng một nhãn được định nghĩa hai lần; chỉ có định nghĩa đầu tiên có hiệu lực | xóa hoặc đổi tên một trong hai định nghĩa |
| CASE_MISMATCH | MEDIUM | tệp tồn tại nhưng khác cách viết hoa/thường; chạy tốt trên macOS/Windows nhưng bị lỗi trên Linux, GitHub Pages và hầu hết hệ thống CI | sử dụng chính xác tên tệp gốc |
| ANCHOR_CASE | MEDIUM | điểm neo chỉ khớp khi được chuyển thành chữ thường | viết các điểm neo bằng chữ thường |
| LOCAL_ABSOLUTE_PATH | MEDIUM | liên kết trỏ tới /Users/..., /home/..., C:\ hoặc file:// chỉ hoạt động trên máy tính của tác giả | đổi sang đường dẫn tương đối, hoặc xóa bỏ |
| EMPTY_LINK | MEDIUM | `[text]()` hoặc thuộc tính href rỗng | điền đường dẫn vào hoặc xóa bỏ liên kết |
| EMPTY_LINK_TEXT | MEDIUM | `[](url)`: không có chữ gì để nhấp chuột hoặc để trình đọc màn hình đọc lên | thêm văn bản hiển thị cho liên kết |
| MISSING_ALT | MEDIUM | hình ảnh không có văn bản thay thế (alt text); trình đọc màn hình sẽ chỉ đọc là "image" hoặc đọc tên tệp | mô tả nội dung hình ảnh hiển thị và mục đích của nó |
| UNUSED_REF_DEF | LOW | định nghĩa tham chiếu không bao giờ được sử dụng; thường là phần dư thừa còn sót lại sau khi chỉnh sửa | xóa bỏ, hoặc gắn liên kết vào nếu liên kết đó vô tình bị mất |
| BARE_URL | LOW | URL thô nằm trực tiếp trong văn bản; không thể nhấp chuột ở một số bộ kết xuất và bị trình đọc màn hình đọc từng ký tự một | chuyển thành `[văn bản mô tả](url)` hoặc `<url>` |
| OUTSIDE_ROOT | LOW | liên kết tương đối vượt ra ngoài thư mục gốc của tài liệu; sẽ bị lỗi nếu thư mục tài liệu được xuất bản độc lập | liên kết trực tiếp tới URL đã xuất bản |
Mã thoát (Exit codes): 0 = không có lỗi HIGH, 1 = có lỗi HIGH, 2 = đầu vào không hợp lệ. Sử dụng `--min-severity` và `--ignore` để tinh chỉnh cổng kiểm soát CI, đồng thời ghi nhận lại mọi cấu hình bỏ qua (ignore) trong kho lưu trữ kèm theo lý do rõ ràng.
## Các dạng liên kết mà kịch bản hiểu được
- Nội dòng (Inline): `[text](path.md#anchor "title")`, `[text](<path with spaces.md>)`, `[text](my%20notes.md)`
- Hình ảnh: ``, `<img src="img.png" alt="...">`
- Tham chiếu (Reference): `[text][label]`, `[label][]`, `[label]` kèm định nghĩa `[label]: url "title"` ở bất kỳ đâu trong cùng một tệp
- Liên kết tự động `<https://...>`, thẻ HTML `<a href="...">`, điểm neo tường minh `<a id>`, `<a name>`, `{#id}`
- Đường dẫn tương đối tính từ gốc `/guide/a.md` được phân giải từ tham số `--root` (mặc định: đối số thư mục đầu tiên)
- Được bỏ qua: các khối mã có hàng rào (fenced) và thụt lề (indented), mã nội dòng, liên kết `mailto:`/`tel:`, điểm neo dòng của GitHub, các ô danh sách công việc `[ ]` `[x]`
## Kiểm tra các URL bên ngoài (chỉ thực hiện khi được yêu cầu)
- Khử trùng lặp trước tiên: tùy chọn `--external` sẽ liệt kê mỗi URL một lần kèm theo mọi vị trí mà URL đó được sử dụng.
- Sử dụng phương thức HEAD, chuyển sang phương thức GET khi máy chủ từ chối HEAD (mã 405) hoặc trả về kết quả không trung thực.
- Chỉ gửi một hoặc hai yêu cầu đồng thời trên mỗi máy chủ đích, đặt thời gian chờ (timeout) 10 giây và khai báo User-Agent rõ ràng.
- Mã 200-299 là OK; mã 301/308 thì cập nhật liên kết sang địa chỉ mới; mã 404/410 là liên kết hỏng; mã 403, 429 và hết thời gian chờ (timeout) được xếp vào nhóm "cần kiểm tra thủ công" (do cơ chế chống bot hoặc giới hạn tần suất truy cập).
- Các điểm neo trên những trang web bên ngoài không thể kiểm tra một cách đáng tin cậy khi ngoại tuyến; hãy ghi chú lại chứ không tự suy đoán.
- Ưu tiên liên kết tới các trang ổn định, có gắn phiên bản cụ thể (tài liệu theo thẻ phiên bản, liên kết cố định permalink) thay vì trỏ tới bản "latest" (mới nhất).
FILE:templates/link-report.md
# Kiểm tra liên kết tài liệu: <kho lưu trữ hoặc thư mục>, <ngày>
**Phạm vi:** <docs/ và README.md, 42 tệp> **Quy tắc điểm neo:** <GitHub> **Thư mục gốc cho /links:** <thư mục gốc của repo>
**Lệnh chạy:** `python3 scripts/check_md_links.py <docs README.md --root . --external>`
**Kết quả:** <13 phát hiện: HIGH 6, MEDIUM 5, LOW 2 -> sau khi sửa: mã thoát 0>
## Bắt buộc sửa (HIGH)
| # | Tệp:Dòng | Mã lỗi | Liên kết đã viết | Vấn đề | Cách sửa (đích mới) |
|---|---|---|---|---|---|
| 1 | <README.md:11> | <MISSING_ANCHOR> | <setup-guide.md#configuration> | <tiêu đề đã bị đổi tên thành "Configure the team folder"> | <setup-guide.md#configure-the-team-folder> |
## Nên sửa (MEDIUM)
| # | Tệp:Dòng | Mã lỗi | Vấn đề | Cách sửa |
|---|---|---|---|---|
| 1 | <setup-guide.md:25> | <CASE_MISMATCH> | <readme.md so với README.md> | <README.md#contents> |
## Dọn dẹp (LOW)
- <định nghĩa [roadmap] không được sử dụng tại README.md:42 - xóa bỏ hoặc gắn liên kết tới nó>
- <URL trần tại README.md:21 -> [Tài liệu Tidepool](https://docs.example.com/tidepool)>
## Hình ảnh và văn bản thay thế (alt text)
| Tệp:Dòng | Hình ảnh | Văn bản thay thế nên dùng |
|---|---|---|
| <README.md:5> | <images/sync-diagram.png (bị thiếu)> | <"Sơ đồ: ứng dụng điện thoại gửi ghi chú tới máy chủ đồng bộ để ghi vào thư mục chung của nhóm"> |
## Các URL bên ngoài (chưa truy vấn)
| URL | Được dùng tại | Trạng thái (nếu đã kiểm tra) |
|---|---|---|
| <https://docs.example.com/tidepool> | <README.md:21> | <chưa kiểm tra> |
## Phòng ngừa cho lần sau
- <chạy trình kiểm tra trong quy trình CI mỗi khi có thay đổi về tài liệu (mã thoát 1 sẽ làm bản dựng thất bại)>
- <khi đổi tên một tiêu đề mà nơi khác đang liên kết tới, hãy giữ lại một điểm neo tường minh mang id cũ>
FILE:examples/README.md
# Tidepool
Tidepool đồng bộ các ghi chú hiện trường từ điện thoại sang một thư mục dùng chung của nhóm.

## Mục lục
- [Bắt đầu nhanh](#quick-start)
- [Cài đặt](setup-guide.md#install)
- [Cấu hình](setup-guide.md#configuration)
- [Xử lý sự cố](setup-guide.md#troubleshooting)
- [Câu hỏi thường gặp](#faq)
## Bắt đầu nhanh
1. Cài đặt ứng dụng (xem [hướng dẫn thiết lập][setup]).
2. Đăng nhập và chọn một thư mục nhóm.
3. Đọc [ghi chú phát hành](CHANGELOG.md) trước khi nâng cấp.
Tài liệu đầy đủ được đặt tại https://docs.example.com/tidepool và tài liệu tham chiếu
API nằm tại <https://api.example.com/tidepool/v2>.
## Cách sử dụng
Chạy lệnh `tidepool sync` để đẩy các ghi chú mới lên. Các liên kết nằm bên trong khối mã sẽ không bị kiểm tra:
```
[not a link](missing.md)
```
## Cách sử dụng
Xem [Đóng góp](../CONTRIBUTING.md) và [hướng dẫn văn phong][style].
## Câu hỏi thường gặp
**Tôi có thể đồng bộ khi ngoại tuyến không?** Các ghi chú sẽ được xếp vào hàng đợi cho đến khi điện thoại có kết nối mạng trở lại.
[setup]: setup-guide.md
[style]: docs/style.md
[roadmap]: https://example.com/tidepool/roadmap
FILE:examples/setup-guide.md
# Hướng dẫn thiết lập
## Cài đặt
Tải xuống trình cài đặt từ [trang phát hành](https://github.com/example/tidepool/releases)
hoặc tự biên dịch từ mã nguồn (xem phần [Biên dịch](#building-from-source)).

## Cấu hình thư mục nhóm
Mở **Settings > Team folder** và dán liên kết thư mục vào. Thư mục này phải
được chia sẻ trước với bạn (xem phần [Chia sẻ](./README.md#Usage)).
## Biên dịch từ mã nguồn
Sao chép (clone) kho lưu trữ và chạy lệnh `make build`, sau đó tiếp tục với phần
[Bắt đầu nhanh](README.md#quick-start).
## Xử lý sự cố
Nếu quá trình đồng bộ bị treo, hãy kiểm tra tệp nhật ký tại [/Users/ana/tidepool/logs/sync.log](/Users/ana/tidepool/logs/sync.log)
hoặc đặt câu hỏi trong [kênh hỗ trợ][support].
Quay lại [README](readme.md#contents).
FILE:scripts/check_md_links.py
#!/usr/bin/env python3
"""Markdown link checker (Python 3 standard library only, fully offline).
Scans a docs folder (or single files) and reports link problems that break readers
before anyone clicks: relative links to files that do not exist, #anchors that match
no heading in the target file, duplicate heading anchors, file-name case mismatches
that only work on macOS/Windows, links to absolute local paths, empty links,
reference-style links whose definition is missing, unused or duplicate reference
definitions, images without alt text and bare URLs. It never touches the network;
use --external to list every external URL (with where it is used) so you can check
them separately.
Anchors follow GitHub's slug rules: heading text with inline markup removed,
lower-cased, punctuation dropped (letters, digits, spaces, "-" and "_" kept), each
space turned into "-", duplicates suffixed -1, -2, ... Explicit anchors from
<a name="x">, <a id="x">, id="x" on HTML tags and {#x} heading attributes count too.
Usage:
python3 check_md_links.py PATH [PATH ...] [--root DIR] [--min-severity LOW|MEDIUM|HIGH]
[--ignore CODE,CODE] [--external] [--json]
python3 check_md_links.py --self-test
Exit codes: 0 = no HIGH findings, 1 = HIGH findings (broken links, missing anchors or
reference definitions), 2 = bad input (path not found, no Markdown files).
"""
import argparse, json, os, re, sys, tempfile, unicodedata
from urllib.parse import unquote
SEV_ORDER = {"HIGH": 0, "MEDIUM": 1, "LOW": 2}
MD_EXT = (".md", ".markdown", ".mdx")
SKIP_DIRS = {".git", "node_modules", ".venv", "venv", "__pycache__", "_site", "site", "build", "dist"}
FENCE_RE = re.compile(r"^ {0,3}(`{3,}|~{3,})")
ATX_RE = re.compile(r"^ {0,3}(#{1,6})[ \t]+(.*?)[ \t]*#*[ \t]*$")
SETEXT_RE = re.compile(r"^ {0,3}(=+|-+)[ \t]*$")
REFDEF_RE = re.compile(r"^ {0,3}\[([^\]]+)\]:[ \t]*(<[^>]*>|\S+)(?:[ \t]+(\"[^\"]*\"|'[^']*'|\([^)]*\)))?[ \t]*$")
INLINE_RE = re.compile(r"(!?)\[((?:[^\[\]\\]|\\.|\[[^\]]*\])*)\]\(\s*(<[^>]*>|[^\s()]*(?:\([^\s()]*\)[^\s()]*)*)(?:\s+(\"[^\"]*\"|'[^']*'|\([^)]*\)))?\s*\)")
REFLINK_RE = re.compile(r"(!?)\[((?:[^\[\]\\]|\\.)*)\]\[([^\]]*)\]")
SHORTCUT_RE = re.compile(r"(?<![\]\\!])\[([^\[\]]+)\](?![\[(:])")
AUTOLINK_RE = re.compile(r"<((?:https?|ftp)://[^>\s]+|mailto:[^>\s]+)>")
BARE_URL_RE = re.compile(r"(?<![<(\"'=\w/])(https?://[^\s<>)\]\"']+)")
HTML_ANCHOR_RE = re.compile(r"<[a-zA-Z][^>]*?\b(?:id|name)\s*=\s*[\"']([^\"']+)[\"']")
HTML_HREF_RE = re.compile(r"<a\b[^>]*?\bhref\s*=\s*[\"']([^\"']*)[\"']", re.I)
HTML_IMG_RE = re.compile(r"<img\b([^>]*)>", re.I)
ATTR_ID_RE = re.compile(r"\s*\{#([\w\-:.]+)[^}]*\}\s*$")
SCHEME_RE = re.compile(r"^[a-zA-Z][a-zA-Z0-9+.\-]*:")
WIN_ABS_RE = re.compile(r"^[a-zA-Z]:[\\/]")
def finding(sev, code, path, line, snippet, problem, fix):
return {"severity": sev, "code": code, "file": path, "line": line,
"snippet": snippet.strip()[:120], "problem": problem, "fix": fix}
def strip_inline_markup(text):
t = re.sub(r"`([^`]*)`", r"\1", text)
t = re.sub(r"!\[([^\]]*)\]\([^)]*\)", r"\1", t)
t = re.sub(r"\[([^\]]*)\]\([^)]*\)", r"\1", t)
t = re.sub(r"\[([^\]]*)\]\[[^\]]*\]", r"\1", t)
t = re.sub(r"<[^>]+>", "", t)
t = re.sub(r"(\*\*|\*|~~)(?=\S)(.+?)(?<=\S)\1", r"\2", t)
t = re.sub(r"(?<!\w)(__|_)(?=\S)(.+?)(?<=\S)\1(?!\w)", r"\2", t) # _x_ only at word edges
return t
def github_slug(text):
t = strip_inline_markup(text).strip().lower()
out = []
for ch in t:
cat = unicodedata.category(ch)
if ch in "-_ " or cat[0] in "LN" or cat == "Mn":
out.append("-" if ch == " " else ch)
return "".join(out)
def mask_code(lines):
"""Return (block-masked lines, fully masked lines): fenced/indented code blocks blanked;
the second list also masks inline code spans (headings keep their code text)."""
out, fence = [], None
prev_blank = True
for line in lines:
m = FENCE_RE.match(line)
if fence:
if m and m.group(1)[0] == fence[0] and len(m.group(1)) >= len(fence) and not line.strip()[len(m.group(1)):].strip():
fence = None
out.append("")
continue
if m:
fence = m.group(1)
out.append("")
continue
if prev_blank and (line.startswith(" ") or line.startswith("\t")) and line.strip():
out.append("")
continue
prev_blank = not line.strip()
out.append(line)
inline = [re.sub(r"(`+)(.+?)\1", lambda mm: mm.group(1) + "x" * len(mm.group(2)) + mm.group(1), l) for l in out]
return out, inline
def parse_file(text):
"""Return dict with anchors (slug->line), duplicates, headings, links, refdefs, images, bare urls."""
raw = text.splitlines()
blocks, lines = mask_code(raw)
anchors, dups, counts = {}, [], {}
refdefs, links, bare, html_imgs = {}, [], [], []
dup_defs = []
for i, line in enumerate(lines, 1):
heading = None
m = ATX_RE.match(blocks[i - 1])
if m:
heading = m.group(2)
elif i >= 2 and SETEXT_RE.match(line) and blocks[i - 2].strip() and not ATX_RE.match(blocks[i - 2]) \
and not blocks[i - 2].lstrip().startswith(("-", "*", ">", "|")) and not REFDEF_RE.match(blocks[i - 2]):
if line.strip().startswith("=") or (i >= 3 and not blocks[i - 3].strip()) or i == 2:
heading = blocks[i - 2].strip()
if heading is not None:
am = ATTR_ID_RE.search(heading)
if am:
anchors.setdefault(am.group(1), i)
heading = heading[:am.start()]
base = github_slug(heading)
n = counts.get(base, 0)
counts[base] = n + 1
slug = base if n == 0 else f"{base}-{n}"
if n > 0:
dups.append((i, heading.strip(), base, slug))
anchors.setdefault(slug, i)
for am in HTML_ANCHOR_RE.finditer(blocks[i - 1]):
anchors.setdefault(am.group(1), i)
d = REFDEF_RE.match(line)
if d:
label = norm_label(d.group(1))
target = d.group(2).strip("<>")
if label in refdefs:
dup_defs.append((i, d.group(1), refdefs[label][1]))
else:
refdefs[label] = (target, i, d.group(1))
continue
spans = []
for lm in INLINE_RE.finditer(line):
target = lm.group(3).strip()
if target.startswith("<") and target.endswith(">"):
target = target[1:-1]
links.append({"kind": "image" if lm.group(1) else "link", "text": lm.group(2), "target": target,
"line": i, "snippet": lm.group(0), "ref": None})
spans.append(lm.span())
for rm in REFLINK_RE.finditer(line):
if any(a <= rm.start() < b for a, b in spans):
continue
label = rm.group(3) or rm.group(2)
links.append({"kind": "image" if rm.group(1) else "link", "text": rm.group(2), "target": None,
"line": i, "snippet": rm.group(0), "ref": norm_label(label), "explicit": True})
spans.append(rm.span())
for sm in SHORTCUT_RE.finditer(line):
if any(a <= sm.start() < b for a, b in spans):
continue
if re.match(r"^[ xX]$", sm.group(1)) or line[sm.end():sm.end() + 1] == "]":
continue # task list box or nested
links.append({"kind": "image" if sm.start() > 0 and line[sm.start() - 1] == "!" else "link",
"text": sm.group(1), "target": None, "line": i, "snippet": sm.group(0),
"ref": norm_label(sm.group(1)), "explicit": False})
spans.append(sm.span())
for hm in HTML_HREF_RE.finditer(line):
links.append({"kind": "link", "text": "", "target": hm.group(1), "line": i, "snippet": hm.group(0), "ref": None, "html": True})
for im in HTML_IMG_RE.finditer(line):
attrs = im.group(1)
src = re.search(r"\bsrc\s*=\s*[\"']([^\"']*)[\"']", attrs, re.I)
alt = re.search(r"\balt\s*=\s*[\"']([^\"']*)[\"']", attrs, re.I)
links.append({"kind": "image", "text": alt.group(1) if alt else None, "target": src.group(1) if src else "",
"line": i, "snippet": im.group(0), "ref": None, "html": True})
cleaned = AUTOLINK_RE.sub(" ", line)
cleaned = INLINE_RE.sub(" ", cleaned)
cleaned = re.sub(r"<[^>]+>", " ", cleaned)
for bm in BARE_URL_RE.finditer(cleaned):
bare.append((i, bm.group(1).rstrip(".,;:!?")))
for am in AUTOLINK_RE.finditer(line):
links.append({"kind": "autolink", "text": am.group(1), "target": am.group(1), "line": i, "snippet": am.group(0), "ref": None})
return {"anchors": anchors, "dups": dups, "refdefs": refdefs, "dup_defs": dup_defs, "links": links, "bare": bare}
def norm_label(s):
return re.sub(r"\s+", " ", s.strip()).casefold()
def is_external(target):
return bool(SCHEME_RE.match(target)) and not WIN_ABS_RE.match(target)
def exists_exact_case(path):
"""True/False for exact-case existence, plus the real name if only a case-insensitive match exists."""
if os.path.exists(path):
head, tail = os.path.split(os.path.abspath(path))
try:
names = os.listdir(head or ".")
except OSError:
return True, None
if tail in names or not tail:
return True, None
for n in names:
if n.lower() == tail.lower():
return False, n
return True, None
head, tail = os.path.split(os.path.abspath(path))
try:
for n in os.listdir(head):
if n.lower() == tail.lower():
return False, n
except OSError:
pass
return False, None
class Checker:
def __init__(self, root, ignore=()):
self.root = os.path.abspath(root)
self.ignore = set(ignore)
self.cache = {}
self.findings = []
self.external = {}
def parsed(self, path):
path = os.path.abspath(path)
if path not in self.cache:
with open(path, encoding="utf-8", errors="replace") as fh:
self.cache[path] = parse_file(fh.read())
return self.cache[path]
def add(self, *a):
f = finding(*a)
if f["code"] not in self.ignore:
self.findings.append(f)
def rel(self, p):
return os.path.relpath(p, self.root)
def check_file(self, path):
info = self.parsed(path)
rp = self.rel(path)
for line, heading, base, slug in info["dups"]:
self.add("MEDIUM", "DUPLICATE_ANCHOR", rp, line, heading,
f"heading '{heading}' repeats an earlier anchor #{base}; this one becomes #{slug}, so links to #{base} land on the first one",
"make the heading unique (add context) or add an explicit anchor")
for line, label, first in info["dup_defs"]:
self.add("MEDIUM", "DUPLICATE_REF_DEF", rp, line, f"[{label}]:",
f"reference [{label}] is defined again (first definition on line {first}); only the first one is used",
"delete or rename the duplicate definition")
used = set()
for ln in info["links"]:
if ln["ref"] is not None:
d = info["refdefs"].get(ln["ref"])
if d is None:
if ln.get("explicit"):
self.add("HIGH", "MISSING_REF_DEF", rp, ln["line"], ln["snippet"],
f"reference-style link uses [{ln['ref']}] but no '[{ln['ref']}]: URL' definition exists, so it renders as plain text",
"add the definition at the bottom of the file or fix the label")
continue
used.add(ln["ref"])
target = d[0]
else:
target = ln["target"]
self.check_link(path, rp, ln, target)
for label, (target, line, orig) in info["refdefs"].items():
if label not in used:
self.add("LOW", "UNUSED_REF_DEF", rp, line, f"[{orig}]: {target}",
f"reference definition [{orig}] is never used", "delete it or link to it")
for line, url in info["bare"]:
self.add("LOW", "BARE_URL", rp, line, url,
"bare URL: not clickable in some renderers and read out character by character by screen readers",
f"use [descriptive text]({url}) or <{url}>")
self.external.setdefault(url, []).append(f"{rp}:{line}")
def check_link(self, path, rp, ln, target):
kind = ln["kind"]
if kind == "image":
alt = ln["text"]
if alt is None or not alt.strip():
self.add("MEDIUM", "MISSING_ALT", rp, ln["line"], ln["snippet"],
"image has no alt text", "describe what the image shows or why it is there (alt=\"\" only for purely decorative images in HTML)")
if target is None:
return
if not target.strip():
self.add("MEDIUM", "EMPTY_LINK", rp, ln["line"], ln["snippet"], f"{kind} has an empty target", "add the URL or path, or remove the brackets")
return
if kind == "link" and not ln.get("html") and not strip_inline_markup(ln["text"]).strip():
self.add("MEDIUM", "EMPTY_LINK_TEXT", rp, ln["line"], ln["snippet"], "link has no visible text", "put words inside the [ ]")
if target.startswith("mailto:") or target.startswith("tel:"):
return
if target.startswith("file:") or WIN_ABS_RE.match(target) or re.match(r"^/(home|Users|tmp|var|mnt|opt)/", target):
self.add("MEDIUM", "LOCAL_ABSOLUTE_PATH", rp, ln["line"], ln["snippet"],
f"'{target}' points at a path on the author's machine; it is broken for everyone else",
"use a path relative to this file")
return
if is_external(target):
if target.startswith(("http://", "https://", "ftp://")):
self.external.setdefault(target, []).append(f"{rp}:{ln['line']}")
return
target_path, _, frag = target.partition("#")
target_path = unquote(target_path.split("?")[0])
frag = unquote(frag)
if target_path:
if target_path.startswith("/"):
full = os.path.normpath(os.path.join(self.root, target_path.lstrip("/")))
else:
full = os.path.normpath(os.path.join(os.path.dirname(path), target_path))
ok, real = exists_exact_case(full)
if not ok and real:
self.add("MEDIUM", "CASE_MISMATCH", rp, ln["line"], ln["snippet"],
f"'{target_path}' only matches '{real}' with different letter case; works on macOS/Windows, breaks on Linux and GitHub Pages",
f"use the exact name '{real}'")
full = os.path.join(os.path.dirname(full), real)
elif not ok:
code = "BROKEN_IMAGE" if kind == "image" else "BROKEN_LINK"
self.add("HIGH", code, rp, ln["line"], ln["snippet"],
f"'{target_path}' does not exist" + (f" (resolved to {self.rel(full)})" if self.rel(full) != os.path.normpath(target_path) else ""),
"fix the path (moved or renamed file?) or remove the link")
return
if not os.path.abspath(full).startswith(self.root + os.sep) and os.path.abspath(full) != self.root:
self.add("LOW", "OUTSIDE_ROOT", rp, ln["line"], ln["snippet"],
f"'{target_path}' leaves the docs root; it breaks if the docs are published on their own",
"link to the published URL or copy the file into the docs")
else:
full = path
if frag:
if os.path.isdir(full) or not full.lower().endswith(MD_EXT):
return
info = self.parsed(full)
if frag in info["anchors"]:
return
if frag.lower() in info["anchors"]:
self.add("MEDIUM", "ANCHOR_CASE", rp, ln["line"], ln["snippet"],
f"#{frag} only matches #{frag.lower()} case-insensitively; GitHub anchors are lower-case",
f"use #{frag.lower()}")
return
if re.match(r"^L\d+(-L\d+)?$", frag):
return # GitHub line anchors
key = frag.lower().replace("-", "")
close = [a for a in info["anchors"] if a.replace("-", "") == key] or \
[a for a in info["anchors"] if len(key) >= 5 and key[:6] in a.replace("-", "")]
hint = f" Did you mean #{close[0]}?" if close else ""
self.add("HIGH", "MISSING_ANCHOR", rp, ln["line"], ln["snippet"],
f"#{frag} matches no heading or anchor in {self.rel(full)}.{hint}",
"link to an existing heading slug, or add the heading / an explicit anchor")
def collect(paths):
files = []
for p in paths:
if os.path.isdir(p):
for dirpath, dirnames, filenames in os.walk(p):
dirnames[:] = sorted(d for d in dirnames if d not in SKIP_DIRS and not d.startswith("."))
files += [os.path.join(dirpath, f) for f in sorted(filenames) if f.lower().endswith(MD_EXT)]
elif os.path.isfile(p):
files.append(p)
else:
raise FileNotFoundError(p)
return files
def run(paths, root=None, ignore=(), min_sev="LOW"):
files = collect(paths)
if root is None:
root = paths[0] if os.path.isdir(paths[0]) else os.path.dirname(os.path.abspath(paths[0]))
ck = Checker(root, ignore)
for f in files:
ck.check_file(os.path.abspath(f))
lim = SEV_ORDER[min_sev]
found = [f for f in ck.findings if SEV_ORDER[f["severity"]] <= lim]
found.sort(key=lambda f: (f["file"], f["line"], SEV_ORDER[f["severity"]]))
return files, found, ck.external
def report(files, found, external, show_external, roots):
counts = {s: sum(1 for f in found if f["severity"] == s) for s in SEV_ORDER}
out = [f"# Markdown link check: {', '.join(roots)}", "",
f"Files: {len(files)} Findings: {len(found)} (HIGH {counts['HIGH']}, MEDIUM {counts['MEDIUM']}, LOW {counts['LOW']}) External URLs: {len(external)} (not checked, offline)", ""]
if not found:
out.append("No findings.")
else:
out += ["| Sev | Code | File:Line | Problem | Fix |", "|---|---|---|---|---|"]
for f in found:
out.append(f"| {f['severity']} | {f['code']} | {f['file']}:{f['line']} | {f['problem'].replace('|', '/')} | {f['fix'].replace('|', '/')} |")
if show_external and external:
out += ["", "## External URLs to check (no network calls were made)", "", "| URL | Used at |", "|---|---|"]
for url in sorted(external):
out.append(f"| {url} | {', '.join(external[url])} |")
return "\n".join(out)
def self_test():
cases = []
def case(name, files, expect, absent=(), target="README.md"):
cases.append((name, files, expect, absent, target))
case("clean file", {"README.md": "# Title\n\nSee [setup](setup.md#install).\n", "setup.md": "# Setup\n\n## Install\n"}, [], ["BROKEN_LINK", "MISSING_ANCHOR"])
case("broken relative link", {"README.md": "[x](docs/missing.md)\n"}, ["BROKEN_LINK"])
case("broken image", {"README.md": "\n"}, ["BROKEN_IMAGE"])
case("missing anchor other file", {"README.md": "[x](a.md#nope)\n", "a.md": "# Yes\n"}, ["MISSING_ANCHOR"])
case("missing anchor same file", {"README.md": "# Intro\n[x](#usage)\n"}, ["MISSING_ANCHOR"])
case("anchor with punctuation", {"README.md": "## What's new? (v2.0)\n[x](#whats-new-v20)\n"}, [], ["MISSING_ANCHOR"])
case("anchor with inline code", {"README.md": "## The `--dry-run` flag\n[x](#the---dry-run-flag)\n"}, [], ["MISSING_ANCHOR"])
case("underscores inside words kept", {"README.md": "## snake_case_name and _emphasis_\n[x](#snake_case_name-and-emphasis)\n"}, [], ["MISSING_ANCHOR"])
case("unicode heading anchor", {"README.md": "## Über uns\n[x](#über-uns)\n"}, [], ["MISSING_ANCHOR"])
case("duplicate heading", {"README.md": "## Usage\n## Usage\n[x](#usage-1)\n"}, ["DUPLICATE_ANCHOR"], ["MISSING_ANCHOR"])
case("setext heading", {"README.md": "Install\n=======\n[x](#install)\n"}, [], ["MISSING_ANCHOR"])
case("explicit html anchor", {"README.md": '<a id="faq"></a>\n[x](#faq)\n'}, [], ["MISSING_ANCHOR"])
case("attribute id anchor", {"README.md": "## Setup {#custom-setup}\n[x](#custom-setup)\n"}, [], ["MISSING_ANCHOR"])
case("anchor case", {"README.md": "## Usage\n[x](#Usage)\n"}, ["ANCHOR_CASE"], ["MISSING_ANCHOR"])
case("near-miss hint", {"README.md": "## Getting Started\n[x](#gettingstarted)\n"}, ["MISSING_ANCHOR"])
case("missing ref def", {"README.md": "See [the guide][guide].\n"}, ["MISSING_REF_DEF"])
case("unused ref def", {"README.md": "Text.\n\n[old]: https://example.com\n"}, ["UNUSED_REF_DEF"])
case("used ref def shortcut", {"README.md": "See [guide].\n\n[guide]: setup.md\n", "setup.md": "# S\n"}, [], ["UNUSED_REF_DEF", "BROKEN_LINK"])
case("ref def case-insensitive", {"README.md": "See [Guide][G].\n\n[g]: setup.md\n", "setup.md": "# S\n"}, [], ["MISSING_REF_DEF", "UNUSED_REF_DEF"])
case("ref def broken target", {"README.md": "See [g][].\n\n[g]: nope.md\n"}, ["BROKEN_LINK"])
case("duplicate ref def", {"README.md": "[a][x]\n\n[x]: https://a.example\n[x]: https://b.example\n"}, ["DUPLICATE_REF_DEF"])
case("image without alt", {"README.md": "\n", "shot.png": "png"}, ["MISSING_ALT"], ["BROKEN_IMAGE"])
case("html img without alt", {"README.md": '<img src="shot.png" width="300">\n', "shot.png": "png"}, ["MISSING_ALT"])
case("bare url", {"README.md": "Docs at https://example.com/docs today.\n"}, ["BARE_URL"])
case("autolink is not bare", {"README.md": "Docs at <https://example.com/docs>.\n"}, [], ["BARE_URL"])
case("code block ignored", {"README.md": "```\n[x](missing.md) https://x.example\n```\n"}, [], ["BROKEN_LINK", "BARE_URL"])
case("inline code ignored", {"README.md": "Use `[x](missing.md)` syntax.\n"}, [], ["BROKEN_LINK"])
case("case mismatch", {"README.md": "[c](CONTRIBUTING.MD)\n", "CONTRIBUTING.md": "# C\n"}, ["CASE_MISMATCH"], ["BROKEN_LINK"])
case("local absolute path", {"README.md": "[x](/Users/ana/repo/docs/a.md)\n"}, ["LOCAL_ABSOLUTE_PATH"])
case("empty target", {"README.md": "[todo]()\n"}, ["EMPTY_LINK"])
case("url-encoded path", {"README.md": "[x](my%20notes.md)\n", "my notes.md": "# N\n"}, [], ["BROKEN_LINK"])
case("angle-bracket path with spaces", {"README.md": "[x](<my notes.md>)\n", "my notes.md": "# N\n"}, [], ["BROKEN_LINK"])
case("directory link ok", {"README.md": "[api](api/)\n", "api/index.md": "# API\n"}, [], ["BROKEN_LINK"])
case("root-relative link", {"README.md": "[x](/guide/a.md)\n", "guide/a.md": "# A\n"}, [], ["BROKEN_LINK"])
case("github line anchor", {"README.md": "[x](setup.md#L10)\n", "setup.md": "# S\n"}, [], ["MISSING_ANCHOR"])
case("task list not a link", {"README.md": "- [ ] write docs\n- [x] done\n"}, [], ["MISSING_REF_DEF"])
case("mailto ignored", {"README.md": "[mail](mailto:team@example.com)\n"}, [], ["BROKEN_LINK"])
case("nested subdir relative", {"README.md": "x", "guide/a.md": "[b](../b.md#top)\n", "b.md": "# Top\n"}, [], ["BROKEN_LINK", "MISSING_ANCHOR"], "guide/a.md")
passed = 0
for name, files, expect, absent, target in cases:
with tempfile.TemporaryDirectory() as d:
for rel, body in files.items():
p = os.path.join(d, rel)
os.makedirs(os.path.dirname(p), exist_ok=True)
with open(p, "w", encoding="utf-8") as fh:
fh.write(body)
_, found, _ = run([d], root=d)
codes = {f["code"] for f in found if f["file"] == target}
ok = all(c in codes for c in expect) and not any(c in codes for c in absent)
if name == "clean file":
ok = ok and not found
if name == "near-miss hint":
ok = ok and any("Did you mean #getting-started" in f["problem"] for f in found)
passed += ok
print(("PASS " if ok else "FAIL ") + name + ("" if ok else f" -> got {sorted(codes)}"))
# external URL listing and report rendering
with tempfile.TemporaryDirectory() as d:
with open(os.path.join(d, "a.md"), "w") as fh:
fh.write("[x](https://example.com/a) and [y](https://example.com/a)\n")
files, found, ext = run([d])
ok = list(ext) == ["https://example.com/a"] and len(ext["https://example.com/a"]) == 2
text = report(files, found, ext, True, [d])
ok = ok and "External URLs to check" in text and "No findings." in text
passed += ok
print(("PASS " if ok else "FAIL ") + "external URLs listed once with locations, no network")
total = len(cases) + 1
print(f"{passed}/{total} passed")
return 0 if passed == total else 1
def main(argv=None):
ap = argparse.ArgumentParser(description="Offline Markdown link and anchor checker")
ap.add_argument("paths", nargs="*")
ap.add_argument("--root", help="docs root for /absolute links and the OUTSIDE_ROOT check (default: first folder)")
ap.add_argument("--min-severity", default="LOW", choices=list(SEV_ORDER))
ap.add_argument("--ignore", default="", help="comma-separated finding codes to skip")
ap.add_argument("--external", action="store_true", help="list external URLs to check separately")
ap.add_argument("--json", action="store_true")
ap.add_argument("--self-test", action="store_true")
a = ap.parse_args(argv)
if a.self_test:
return self_test()
if not a.paths:
ap.print_usage(sys.stderr)
return 2
try:
files, found, ext = run(a.paths, a.root, [c.strip() for c in a.ignore.split(",") if c.strip()], a.min_severity)
except FileNotFoundError as e:
print(f"error: path not found: {e}", file=sys.stderr)
return 2
if not files:
print("error: no Markdown files found", file=sys.stderr)
return 2
if a.json:
print(json.dumps({"files": len(files), "findings": found, "external": ext if a.external else {}}, indent=2, ensure_ascii=False))
else:
print(report(files, found, ext, a.external, a.paths))
return 1 if any(f["severity"] == "HIGH" for f in found) else 0
if __name__ == "__main__":
sys.exit(main())Đánh giá các bảng PostgreSQL và MySQL (tệp schema.sql, bản dump hoặc lệnh CREATE TABLE trong pull request) để tìm ra các lỗi thiết kế có thể sửa dễ dàng và ít tốn kém trước khi có dữ liệu thực tế - thiếu khóa chính, lưu tiền tệ bằng cột số thực (float), khóa ngoại lệch kiểu dữ liệu hoặc thiếu chỉ mục (index), ID 32-bit, dấu thời gian (timestamp) không kèm múi giờ, các cờ (flags) cho phép NULL, trạng thái dạng văn bản tự do, đặt tên trùng từ khóa dành riêng và email duy nhất (unique) nhưng phân biệt chữ hoa chữ thường. Trả về mã DDL đã được hiệu chỉnh. Bao gồm một công cụ linter viết bằng thư viện chuẩn Python có hỗ trợ cờ --self-test.
---
name: sql-schema-design-reviewer
description: Đánh giá các bảng PostgreSQL và MySQL (tệp schema.sql, bản dump hoặc lệnh CREATE TABLE trong pull request) để tìm ra các lỗi thiết kế có thể sửa dễ dàng và ít tốn kém trước khi có dữ liệu thực tế - thiếu khóa chính, lưu tiền tệ bằng cột số thực (float), khóa ngoại lệch kiểu dữ liệu hoặc thiếu chỉ mục (index), ID 32-bit, dấu thời gian (timestamp) không kèm múi giờ, các cờ (flags) cho phép NULL, trạng thái dạng văn bản tự do, đặt tên trùng từ khóa dành riêng và email duy nhất (unique) nhưng phân biệt chữ hoa chữ thường. Trả về mã DDL đã được hiệu chỉnh. Bao gồm một công cụ linter viết bằng thư viện chuẩn Python có hỗ trợ cờ --self-test.
---

# Trình Đánh Giá Thiết Kế Lược Đồ SQL (SQL Schema Design Reviewer)

Bạn đánh giá các lược đồ cơ sở dữ liệu (database schemas) theo đúng cách mà một chuyên gia mô hình hóa dữ liệu giàu kinh nghiệm sẽ làm ở giai đoạn thiết kế: ngay trước khi dòng dữ liệu đầu tiên được ghi vào, khi việc thay đổi một kiểu dữ liệu hay một khóa chỉ là sửa một dòng mã thay vì phải chạy migration vất vả suốt cả dịp cuối tuần. Bạn xem xét cấu trúc hình thái của dữ liệu (khóa, kiểu dữ liệu, ràng buộc, cách đặt tên, chỉ mục), giải thích rõ sự cố thực tế mà từng vấn đề sẽ gây ra, và trả lại mã DDL đã được sửa chuẩn chỉnh.

Kỹ năng này tập trung đánh giá thiết kế của các bảng. Nó không bàn về việc triển khai thay đổi lên một cơ sở dữ liệu đang chạy thực tế (khóa bảng, điền dữ liệu ngược - backfill, triển khai mở rộng/thu hẹp - expand/contract); đối với nhu cầu đó, hãy sử dụng quy trình đánh giá độ an toàn của migration.

## Các tệp trong kỹ năng này

- `scripts/schema_lint.py` - phân tích cú pháp các câu lệnh `CREATE TABLE`, `CREATE INDEX` và `ALTER TABLE ... ADD`, đồng thời báo cáo các vấn đề về khóa, kiểu dữ liệu, ràng buộc, cách đặt tên và chỉ mục kèm theo mức độ nghiêm trọng và cách khắc phục; tự động nhận diện PostgreSQL hoặc MySQL (chỉ sử dụng thư viện chuẩn Python 3, không cần kết nối cơ sở dữ liệu)
- `references/design-rules.md` - toàn bộ mã lỗi phát hiện (finding codes) kèm theo sự cố mà nó gây ra, trường hợp nào có thể chấp nhận giữ nguyên và cách khắc phục
- `references/type-choices.md` - hướng dẫn chọn kiểu dữ liệu nào cho ID, tiền tệ, thời gian, văn bản, cờ (flags), trạng thái và JSON trong PostgreSQL và MySQL
- `templates/schema-review.md` - mẫu báo cáo đánh giá để bàn giao lại
- `examples/shop-schema.sql` - một lược đồ cửa hàng trực tuyến nhỏ chứa các lỗi thiết kế được cài cắm có chủ đích
- `examples/shop-schema-fixed.sql` - cùng lược đồ đó sau khi được đánh giá và sửa lỗi; vượt qua kiểm tra lint hoàn toàn sạch sẽ

## Quy trình làm việc

### 1. Thu thập lược đồ và ngữ cảnh
Yêu cầu cung cấp mã DDL (`schema.sql`, `pg_dump --schema-only`, `mysqldump --no-data`, hoặc câu lệnh `CREATE TABLE` từ pull request), hệ quản trị cơ sở dữ liệu (engine) và phiên bản, số lượng dòng dự kiến của mỗi bảng trong một năm, và cách dữ liệu được sử dụng (ứng dụng OLTP, báo cáo, đa tổ chức - multi-tenant, sao chép dữ liệu - replicated, hay truy xuất thông qua ORM). Hãy hỏi xem nhóm đã có sẵn những quy tắc nội bộ nào chưa (dùng UUID hay `bigint` cho ID, xóa mềm - soft deletes, quy tắc đặt tên).

### 2. Chạy công cụ linter
```
python3 scripts/schema_lint.py examples/shop-schema.sql
python3 scripts/schema_lint.py schema.sql --dialect mysql --min-severity MEDIUM
python3 scripts/schema_lint.py db/*.sql --ignore NO_CREATED_AT --json > schema-review.json
python3 scripts/schema_lint.py --self-test
```
Mã thoát (exit code) 0 có nghĩa là không có phát hiện mức HIGH nào, 1 có nghĩa là có ít nhất một lỗi mức HIGH (dùng làm cổng chặn CI trên các tệp schema), 2 có nghĩa là dữ liệu đầu vào không hợp lệ. Công cụ linter hoạt động theo hướng suy nghiệm (heuristic): nó đọc tên cột (ví dụ cột `price` dùng kiểu float, cột `order_id` không có khóa ngoại), vì vậy hãy đối chiếu xác nhận từng phát hiện với ý đồ thực sự của người dùng.

### 3. Đánh giá những điểm mà script không thể nhìn thấy
Sau đó, hãy tự đọc kỹ lược đồ (xem thêm `references/design-rules.md`):
- Mỗi bảng có mang một ý nghĩa rõ ràng duy nhất và có một khóa tự nhiên duy nhất (natural unique key) bên cạnh ID tự tăng (surrogate id) hay không (ví dụ: `sku`, `email`, `provider + provider_id`)?
- Các mối quan hệ đã chuẩn xác chưa: quan hệ một-nhiều (one-to-many) so với nhiều-nhiều (many-to-many), hành vi `ON DELETE` (`RESTRICT` làm mặc định; chỉ dùng `CASCADE` cho các bảng con phụ thuộc hoàn toàn), khóa ngoại chỉ cho phép `NULL` ở những nơi mối quan hệ thực sự là tùy chọn (optional)?
- Các bất biến dữ liệu (invariants) có được đặt trong ràng buộc `CHECK` (`quantity > 0`, `ends_at > starts_at`) thay vì chỉ kiểm tra trong mã nguồn ứng dụng hay không?
- Đa tổ chức (Multi-tenant): mọi bảng thuộc sở hữu của tenant có mang cột `tenant_id` không, cột đó có nằm trong các khóa duy nhất (unique keys) và đứng ở vị trí cột đầu tiên của chỉ mục (leading index column) không?
- Xóa mềm (Soft deletes): các ràng buộc duy nhất có phải là ràng buộc cục bộ có điều kiện (`WHERE deleted_at IS NULL`) không?
- Dữ liệu cá nhân: những cột nào chứa thông tin định danh cá nhân (PII), và chúng có cần quy tắc kiểm soát truy cập hoặc thời hạn lưu trữ riêng biệt không?

### 4. Bàn giao kết quả
Điền vào mẫu `templates/schema-review.md`: kết luận tổng quan (verdict), các phát hiện được xếp hạng theo mức độ ảnh hưởng kèm theo sự cố thực tế mà từng lỗi gây ra, tiếp theo là mã DDL đã được hiệu chỉnh (xem `examples/shop-schema-fixed.sql`) và danh sách các quyết định dành quyền tự chọn cho nhóm. Nếu các bảng đã chứa dữ liệu thực tế, hãy chỉ rõ những sửa đổi nào hiện cần viết kịch bản di chuyển dữ liệu (migration) và gắn cờ chuyển sang bước đánh giá an toàn migration thay vì viết lại trực tiếp các bảng đang chạy.

## Ví dụ kết quả
`examples/shop-schema.sql` (PostgreSQL, 5 bảng): 20 phát hiện, 4 lỗi mức HIGH. Bảng `order_items` không có khóa chính (có thể bị trùng lặp dòng); `products.price` dùng kiểu `double precision` và `payments.amount` dùng kiểu `real` (gây sai lệch từng xu khi tính toán); `payments.order_id` là `integer` nhưng lại tham chiếu tới `"order".id` (`bigserial`). Mức MEDIUM: dùng ID kiểu `serial` trên bảng `customers` và `products`, dùng `timestamp without time zone` trên `customers.created_at` và `placed_at`, đặt tên bảng là `"order"` (trùng từ khóa dành riêng của SQL), khóa ngoại trên `"order".customer_id` và `order_items.order_id` không có chỉ mục (index). Mức LOW: email duy nhất (unique) nhưng phân biệt chữ hoa chữ thường, thói quen dùng `varchar(255)`, cột cờ `is_verified` cho phép NULL, cột `status` lưu văn bản tự do, `product_id` không có ràng buộc khóa ngoại, dư thừa một chỉ mục trên bảng `payments`, lưu dữ liệu JSON trong cột kiểu `text`. Tệp `examples/shop-schema-fixed.sql` khắc phục toàn bộ các lỗi trên (đổi tên thành `orders`, dùng `bigint identity`, `numeric(12,2)`, `timestamptz`, `citext`, ràng buộc `CHECK` trên cột `status`, khóa chính tổ hợp trên `order_items`) và vượt qua kiểm tra lint hoàn toàn sạch sẽ.

## Quy tắc

- Giải thích từng phát hiện dưới góc độ sự cố thực tế mà nó gây ra (sai lệch tổng tiền, bản ghi mồ côi, đăng ký trùng lặp tài khoản, sập hệ thống khi chạm ngưỡng 2,1 tỷ ID), chứ không phải như một quy tắc bắt bẻ về mặt hình thức.
- Giữ nguyên các quy ước của người dùng (dùng UUID làm ID, quy tắc đặt tên) trừ khi chúng gây ra vấn đề thực sự; hãy nói rõ khi nào một phát hiện chỉ mang tính chất cân nhắc đánh đổi (judgement call).
- Ưu tiên đặt các ràng buộc (constraints) ngay trong cơ sở dữ liệu hơn là chỉ kiểm tra trong tầng ứng dụng; cơ sở dữ liệu là tuyến phòng thủ cuối cùng.
- Tiền tệ phải chính xác tuyệt đối: dùng `numeric`/`DECIMAL` hoặc số nguyên biểu thị đơn vị tiền tệ nhỏ nhất (như xu/cents), không bao giờ dùng `float`, và phải lưu kèm loại tiền tệ (currency).
- Thời gian là một thời điểm xác định (instant): dùng `timestamptz` trong PostgreSQL, và lưu theo giờ chuẩn UTC ở mọi nơi trong MySQL.
- Không đề xuất sửa đổi trực tiếp các bảng đã chứa dữ liệu trên môi trường production mà không chỉ rõ rằng mỗi thay đổi đó đều đòi hỏi một quy trình migration với những rủi ro riêng.
FILE:references/design-rules.md
# Quy tắc thiết kế và mã lỗi phát hiện (finding codes)

| Mã lỗi | Mức độ | Sự cố xảy ra là gì | Chấp nhận được khi nào | Cách khắc phục |
|---|---|---|---|---|
| NO_PRIMARY_KEY | HIGH | không thể phân biệt các dòng trùng lặp hoặc xóa từng dòng một; sao chép logic (logical replication) và CDC cần có khóa; các ORM hoạt động sai lệch | không bao giờ chấp nhận cho các bảng OLTP (có thể tạm chấp nhận cho bảng tạm staging chỉ nạp vào rồi xóa ngay trong một job) | thêm khóa đại diện `id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY` hoặc khóa tự nhiên tổ hợp (`order_id`, `product_id`) |
| FLOAT_MONEY | HIGH | `0.1 + 0.2 = 0.30000000000000004`; tổng tiền và tiền hoàn trả bị lệch từng xu, báo cáo đối soát không khớp | không bao giờ dùng cho tiền tệ; kiểu float chỉ phù hợp cho các số liệu đo đạc vật lý | dùng `numeric(12,2)` / `DECIMAL(12,2)` hoặc số nguyên `bigint` tính theo đơn vị nhỏ nhất (`amount_cents`) kèm theo cột loại tiền tệ (`currency`) |
| FK_TYPE_MISMATCH | HIGH | cột `integer` tham chiếu tới khóa `bigint`: các phép JOIN phải ép kiểu, và lệnh INSERT sẽ lỗi ngay khi ID vượt quá 2.147.483.647 | không bao giờ | dùng cùng một kiểu dữ liệu ở cả hai phía |
| MYISAM_ENGINE | HIGH | không hỗ trợ giao dịch (transactions), không có khóa ngoại, khóa toàn bảng (table locks), hỏng dữ liệu khi sập nguồn | hiếm khi dùng, họa chăng chỉ cho các bảng lưu trữ chỉ đọc (read-only archives) | `ENGINE=InnoDB` |
| INT32_PRIMARY_KEY | MEDIUM | cạn kiệt ID ở ngưỡng khoảng 2,1 tỷ (các sequence cũng bị nhảy số khi rollback); cách sửa lúc đó là phải viết lại toàn bộ bảng trên bảng lớn nhất | các bảng tra cứu nhỏ (danh mục trạng thái, quốc gia) | `bigint` identity / `BIGINT UNSIGNED AUTO_INCREMENT` |
| TIMESTAMP_WITHOUT_TZ | MEDIUM | giá trị được lưu mang ý nghĩa thời điểm khác nhau tùy thuộc vào múi giờ của tiến trình ghi; việc đổi giờ mùa hè (DST) và chuyển máy chủ sẽ làm hỏng thứ tự thời gian | các giá trị giờ đồng hồ treo tường tại địa phương không đại diện cho một thời điểm tuyệt đối (giờ mở cửa cửa hàng, giờ sinh nhật) | `timestamptz` |
| MONEY_TYPE | MEDIUM | kiểu `money` của Postgres phụ thuộc vào cài đặt `lc_monetary`, chỉ hỗ trợ một loại tiền tệ, làm tròn số khi chia | không bao giờ dùng trong các lược đồ mới | `numeric(12,2)` + cột tiền tệ (`currency`) |
| NULLABLE_AUDIT_COLUMN | MEDIUM | các dòng không có `created_at` làm hỏng các báo cáo "7 ngày qua" và gây lỗi khi chạy backfill | không bao giờ | `NOT NULL DEFAULT now()` |
| FK_WITHOUT_INDEX | MEDIUM | (PostgreSQL) việc xóa hoặc cập nhật bản ghi cha sẽ quét toàn bộ bảng con kèm theo giữ khóa (lock); phép JOIN từ bảng cha sang bảng con bị chậm. MySQL InnoDB tự động tạo chỉ mục này | bảng con cực nhỏ, bản ghi cha không bao giờ bị xóa | tạo chỉ mục (index) có các cột đầu tiên (leading columns) là các cột khóa ngoại |
| RESERVED_WORD_NAME | MEDIUM | `order`, `user`, `group` phải được đặt trong dấu ngoặc kép ở mọi truy vấn, ORM, công cụ BI và phiên psql đột xuất | không bao giờ dùng trong các schema mới | dùng tên số nhiều hoặc có tiền tố định danh: orders, app_users, user_groups, sort_order |
| MYSQL_UTF8MB3 | MEDIUM | `utf8` chỉ dài 3-byte: emoji và một số ký tự CJK sẽ bị lỗi hoặc bị cắt cụt | không bao giờ dùng trong các schema mới | `utf8mb4` + `utf8mb4_0900_ai_ci` |
| NULLABLE_BOOLEAN | LOW | logic ba giá trị: `WHERE NOT is_verified` sẽ bỏ qua các dòng có giá trị NULL | khi "chưa rõ" là một trạng thái thực tế (khi đó nên ưu tiên dùng một cột trạng thái tường minh) | `NOT NULL DEFAULT false` |
| UNCHECKED_STATUS | LOW | 'Shipped', 'shipped ', 'shiped' đều có thể xuất hiện; làm báo cáo bị phân mảnh | các trạng thái thuộc sở hữu của một hệ thống khác mà bạn chỉ sao chép lại | `CHECK (status IN (...))`, kiểu enum hoặc khóa ngoại (FK) trỏ tới bảng tra cứu |
| MISSING_FOREIGN_KEY | LOW | dữ liệu mồ côi sau khi xóa, gõ sai id, không có mối quan hệ được ghi nhận | tham chiếu liên cơ sở dữ liệu hoặc theo hướng sự kiện (event-sourced); hãy ghi tài liệu cho chúng | `REFERENCES parent(id)` + chỉ mục (index) |
| CASE_SENSITIVE_UNIQUE_EMAIL | LOW | Ana@x.com và ana@x.com thành hai tài khoản khác nhau; email đặt lại mật khẩu bị gửi nhầm chỗ | không bao giờ dùng cho email đăng nhập | `citext` hoặc `UNIQUE INDEX ON t (lower(email))` và chuẩn hóa khi ghi dữ liệu |
| VARCHAR_255_HABIT | LOW | trong Postgres, 255 là giới hạn tùy tiện từ thời MySQL; thiếu các quy tắc thực sự và những giá trị hợp lệ dài hơn lại bị từ chối | khi 255 thực sự là quy tắc nghiệp vụ | `text` + `CHECK (char_length(x) <= n)` cho các giới hạn thực tế |
| REDUNDANT_INDEX | LOW | một chỉ mục là tiền tố của chỉ mục khác (hoặc của khóa chính PK) gây tốn chi phí ghi và bộ nhớ vô ích | chỉ mục ngắn hơn có kích thước nhỏ hơn nhiều và được truy vấn cực kỳ thường xuyên | xóa bỏ nó |
| JSON_IN_TEXT | LOW | không có kiểm tra hợp lệ, không có toán tử truy vấn, không có chỉ mục GIN | chuỗi văn bản đó không thực sự là JSON | `jsonb` / `JSON` |
| NO_CREATED_AT | LOW | việc gỡ lỗi, kiểm toán và nạp bù dữ liệu (backfill) cần biết thời điểm các dòng dữ liệu xuất hiện | các bảng nối (join tables) thuần túy | `created_at timestamptz NOT NULL DEFAULT now()` |
| MIXED_CASE_NAME | LOW | tên đặt trong ngoặc kép "OrderItems" sẽ phải đặt trong ngoặc kép mãi mãi trong Postgres | không bao giờ | snake_case |
| DATETIME_NO_ZONE | LOW | (MySQL) DATETIME không có múi giờ; nhiều tiến trình ghi khác nhau sẽ lưu các múi giờ lẫn lộn | khi mọi kết nối đều thiết lập time_zone='+00:00' | bắt buộc dùng UTC |

## Những điều công cụ linter không thể đánh giá (cần rà soát thủ công)
- **Các khóa (Keys)**: có khóa duy nhất tự nhiên (natural unique key) nào ngoài id tự tăng (surrogate id) không? Thiếu `UNIQUE (provider, provider_id)` chính là nguyên nhân khiến các khoản thanh toán bị ghi nhận hai lần.
- **ON DELETE**: mặc định dùng RESTRICT/NO ACTION; chỉ dùng CASCADE cho các dòng con thực sự (order_items của một order), không bao giờ dùng từ bảng customers sang bảng payments.
- **Ràng buộc CHECK cho các bất biến (invariants)**: `quantity > 0`, `ends_at > starts_at`, `discount <= total`.
- **Đa thuê bao (Multi-tenancy)**: phải có tenant_id trên mọi bảng thuộc phạm vi thuê bao, đặt ở vị trí đầu tiên trong các khóa duy nhất và chỉ mục, cũng như trong mọi khóa ngoại FK (khóa ngoại phức hợp giúp ngăn chặn việc tham chiếu chéo giữa các thuê bao).
- **Xóa mềm (Soft deletes)**: sử dụng chỉ mục duy nhất từng phần (partial unique index) `WHERE deleted_at IS NULL`, nếu không địa chỉ email đó sẽ không bao giờ có thể được tái sử dụng.
- **Tổng giá trị phi chuẩn hóa (Denormalized totals)**: nếu lưu trữ cột orders.total, hãy nêu rõ cơ chế đảm bảo giá trị của nó luôn bằng tổng của order_items.
- **Dữ liệu định danh cá nhân (PII)**: liệt kê các cột chứa dữ liệu cá nhân; cân nhắc tách ra một bảng riêng với quyền truy cập và chính sách lưu trữ nghiêm ngặt hơn.
FILE:references/type-choices.md
# Lựa chọn kiểu dữ liệu (PostgreSQL / MySQL 8)

| Dữ liệu | PostgreSQL | MySQL 8 | Nên tránh |
|---|---|---|---|
| ID tự tăng (Surrogate id) | `bigint GENERATED ALWAYS AS IDENTITY` | `BIGINT UNSIGNED AUTO_INCREMENT` | `serial`/`int` trên các bảng đang tăng trưởng |
| ID công khai / phân tán | `uuid` (UUIDv7 để tối ưu tính cục bộ của chỉ mục, `gen_random_uuid()` cho v4) | `BINARY(16)` kết hợp với UUID_TO_BIN(x, 1) | UUID dạng `varchar(36)` (lớn gấp 3 lần, chậm hơn) |
| Tiền tệ | `numeric(12,2)` (hoặc (19,4) cho tỷ giá) + `currency char(3)` | `DECIMAL(12,2)` + `CHAR(3)` | `float`, `double`, `real`, kiểu `money` của Postgres |
| Tiền tệ dạng số nguyên | `bigint amount_cents` (lưu ý các loại tiền tệ có 0 hoặc 3 chữ số thập phân) | `BIGINT` | số xu dạng `int` (bị tràn số ở mức 21 triệu) |
| Thời điểm (sự kiện đã xảy ra) | `timestamptz` | `DATETIME(6)` theo chuẩn UTC, hoặc `TIMESTAMP` (giới hạn năm 2038, được chuyển đổi theo múi giờ của phiên) | `timestamp` không kèm múi giờ |
| Ngày lịch | `date` | `DATE` | dấu thời gian (timestamps) đặt ở nửa đêm |
| Giờ đồng hồ / lịch trình | `time` + một cột múi giờ chuẩn IANA | `TIME` + cột múi giờ | `timetz` |
| Thời lượng | `interval` hoặc số giây dạng số nguyên | số giây dạng `INT` | chuỗi văn bản như "1h30" |
| Văn bản | `text` (+ CHECK cho các giới hạn thực tế) | `VARCHAR(n)` với số n thực tế; `TEXT` cho nội dung dài | dùng `varchar(255)` theo thói quen; đệm khoảng trắng với `char(n)` |
| Văn bản không phân biệt hoa thường (email, username) | `citext` hoặc chỉ mục duy nhất dùng hàm `lower()` | bảng mã đối chiếu `_ci` không phân biệt hoa thường (mặc định) | ràng buộc unique thuần túy trên kiểu text trong Postgres |
| Cờ (Flag) | `boolean NOT NULL DEFAULT false` | `BOOLEAN` (TINYINT(1)) `NOT NULL DEFAULT 0` | kiểu boolean cho phép null, chuỗi 'Y'/'N' |
| Trạng thái | `text` + `CHECK (... IN (...))`, kiểu enum, hoặc bảng tra cứu | `ENUM(...)` hoặc bảng tra cứu | kiểu text không có ràng buộc |
| JSON | `jsonb` (dùng chỉ mục GIN cho truy vấn bao hàm) | `JSON` (dùng các cột sinh tự động để đánh chỉ mục) | lưu JSON trong cột text |
| Địa chỉ IP | `inet` / `cidr` | `VARBINARY(16)` kết hợp với INET6_ATON | kiểu text |
| Dữ liệu nhị phân lớn | lưu trữ đối tượng (object storage) + lưu khóa (key) trong cột `text` | tương tự | lưu các BLOB lớn trong những bảng truy cập thường xuyên |

## Lưu ý
- Việc thay đổi kiểu dữ liệu của cột về sau sẽ buộc phải ghi lại toàn bộ bảng trên cả hai hệ quản trị cơ sở dữ liệu (với một vài ngoại lệ như mở rộng độ dài varchar trong Postgres). Hãy thiết kế chuẩn xác các cột id và tiền tệ ngay từ đầu.
- Kiểu enum trong Postgres: thêm một giá trị mới thì nhẹ nhàng, nhưng xóa hoặc đổi tên một giá trị lại rất phức tạp. Bảng tra cứu (lookup tables) dễ nâng cấp hơn và có thể chứa thêm nhãn hiển thị cùng thứ tự sắp xếp.
- Sử dụng `NOT NULL` kèm giá trị mặc định hợp lý là quy chuẩn chung; chỉ nên cho phép null khi mang ý nghĩa "thực sự chưa biết hoặc không áp dụng".
- Luôn lưu mã tiền tệ ngay cạnh mọi khoản tiền, ngay cả khi hiện tại hệ thống chỉ mới dùng một loại tiền tệ duy nhất.
- Đặt tên nhất quán ở mọi nơi: dùng `customer_id` trong mọi bảng tham chiếu đến bảng customers, hậu tố `_at` cho thời điểm, `_on` hoặc `_date` cho ngày tháng, tiền tố `is_`/`has_` cho kiểu boolean.
FILE:templates/schema-review.md
# Đánh giá schema: <tệp dự án / schema>, <ngày>

**Hệ quản trị:** <PostgreSQL 16>   **Phạm vi:** <5 bảng: customers, products, orders, order_items, payments>
**Bối cảnh:** <Backend cửa hàng OLTP, ~2 triệu đơn hàng/năm, Prisma ORM, chưa có dữ liệu>
**Lệnh chạy:** `python3 scripts/schema_lint.py <shop-schema.sql>`
**Kết luận:** <CẦN THAY ĐỔI trước bản phát hành đầu tiên: 4 CAO (HIGH), 8 TRUNG BÌNH (MEDIUM), 8 THẤP (LOW)>

## Bắt buộc sửa (HIGH)
| # | Bảng.cột | Phát hiện | Vấn đề xảy ra | Cách khắc phục |
|---|---|---|---|---|
| 1 | <products.price> | <FLOAT_MONEY> | <0.1 + 0.2 != 0.3; tổng tiền đơn hàng bị lệch từng xu> | <numeric(12,2) NOT NULL CHECK (price >= 0)> |

## Nên sửa (MEDIUM)
| # | Bảng.cột | Phát hiện | Vấn đề xảy ra | Cách khắc phục |
|---|---|---|---|---|
| 1 | <"order"> | <RESERVED_WORD_NAME> | <phải đặt trong dấu ngoặc kép ở mọi truy vấn và công cụ BI> | <đổi tên thành orders> |

## Cân nhắc (LOW / tùy thuộc đánh giá)
- <customers.email: dùng citext để Ana@x.com và ana@x.com được tính là cùng một tài khoản>

## Phát hiện qua đọc hiểu (không phải từ công cụ linter)
- <payments: thêm UNIQUE (provider, provider_id) để khi webhook thử lại (retry) không thể ghi nhận một khoản thanh toán hai lần>
- <ON DELETE: giữ RESTRICT trên mối quan hệ payments -> orders; chỉ dùng CASCADE cho order_items -> orders>

## DDL đã hiệu chỉnh
```sql
<full corrected schema, lints clean>
```

## Các quyết định dành cho nhóm phát triển
- <chọn bigint identity hay UUIDv7 cho các id công khai>
- <lưu trực tiếp cột orders.total hay tính toán từ bảng order_items?>

## Nếu các bảng đã chứa dữ liệu
- <mỗi thay đổi ở trên là một bản di trú dữ liệu (migration); hãy liệt kê chúng và thực hiện rà soát an toàn migration trước khi triển khai>
FILE:examples/shop-schema.sql
-- Small online shop schema (PostgreSQL), first draft for review.
-- The problems are deliberate: this is what the skill is meant to catch.

CREATE TABLE customers (
    id          serial PRIMARY KEY,
    email       varchar(255) NOT NULL UNIQUE,
    full_name   varchar(255),
    phone       varchar(255),
    is_verified boolean,
    created_at  timestamp
);

CREATE TABLE products (
    id         serial PRIMARY KEY,
    sku        varchar(64) NOT NULL UNIQUE,
    title      text NOT NULL,
    price      double precision NOT NULL,
    attributes text,
    created_at timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE "order" (
    id          bigserial PRIMARY KEY,
    customer_id integer NOT NULL REFERENCES customers (id),
    status      varchar(20) NOT NULL DEFAULT 'pending',
    total       numeric(12,2) NOT NULL,
    placed_at   timestamp NOT NULL DEFAULT now(),
    created_at  timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE order_items (
    order_id   bigint NOT NULL REFERENCES "order" (id),
    product_id bigint NOT NULL,
    quantity   integer NOT NULL,
    unit_price numeric(12,2) NOT NULL
);

CREATE TABLE payments (
    id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    order_id    integer NOT NULL REFERENCES "order" (id),
    amount      real NOT NULL,
    provider    text NOT NULL,
    provider_id text,
    created_at  timestamptz NOT NULL DEFAULT now()
);

CREATE INDEX payments_order_idx ON payments (order_id);
CREATE INDEX payments_order_created_idx ON payments (order_id, created_at);
FILE:examples/shop-schema-fixed.sql
-- Small online shop schema (PostgreSQL), after review.
-- Every change is explained in templates/schema-review.md style in the review.

CREATE EXTENSION IF NOT EXISTS citext;

CREATE TABLE customers (
    id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    email       citext NOT NULL UNIQUE,
    full_name   text,
    phone       text CHECK (char_length(phone) <= 32),
    is_verified boolean NOT NULL DEFAULT false,
    created_at  timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE products (
    id         bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    sku        text NOT NULL UNIQUE,
    title      text NOT NULL,
    price      numeric(12,2) NOT NULL CHECK (price >= 0),
    attributes jsonb NOT NULL DEFAULT '{}',
    created_at timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE orders (
    id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id bigint NOT NULL REFERENCES customers (id),
    status      text NOT NULL DEFAULT 'pending'
                CHECK (status IN ('pending', 'paid', 'shipped', 'cancelled', 'refunded')),
    total       numeric(12,2) NOT NULL CHECK (total >= 0),
    placed_at   timestamptz NOT NULL DEFAULT now(),
    created_at  timestamptz NOT NULL DEFAULT now()
);
CREATE INDEX orders_customer_idx ON orders (customer_id);

CREATE TABLE order_items (
    order_id   bigint NOT NULL REFERENCES orders (id),
    product_id bigint NOT NULL REFERENCES products (id),
    quantity   integer NOT NULL CHECK (quantity > 0),
    unit_price numeric(12,2) NOT NULL CHECK (unit_price >= 0),
    created_at timestamptz NOT NULL DEFAULT now(),
    PRIMARY KEY (order_id, product_id)
);
CREATE INDEX order_items_product_idx ON order_items (product_id);

CREATE TABLE payments (
    id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    order_id    bigint NOT NULL REFERENCES orders (id),
    amount      numeric(12,2) NOT NULL,
    provider    text NOT NULL,
    provider_id text,
    created_at  timestamptz NOT NULL DEFAULT now(),
    UNIQUE (provider, provider_id)
);
CREATE INDEX payments_order_created_idx ON payments (order_id, created_at);
FILE:scripts/schema_lint.py
#!/usr/bin/env python3
"""SQL schema design linter for PostgreSQL and MySQL DDL (Python 3 standard library only).

Reads CREATE TABLE / CREATE INDEX / ALTER TABLE ... ADD statements (a schema dump,
schema.sql, or the DDL of new tables in a pull request) and reports design problems
that are cheap to fix before data exists and expensive after: tables without a
primary key, money stored in floating point, foreign keys whose type differs from the
referenced key or that have no supporting index (PostgreSQL), *_id columns without a
foreign key, 32-bit primary keys, timestamps without time zone, nullable audit
columns and booleans, unchecked status columns, reserved-word and mixed-case names,
case-sensitive unique emails, redundant indexes, JSON kept in text columns, and MySQL
tables using MyISAM or 3-byte utf8.

It does not connect to a database and does not judge migration safety (locks,
backfills); it reviews the shape of the schema itself.

Usage:
  python3 schema_lint.py FILE.sql [FILE.sql ...] [--dialect auto|postgres|mysql]
        [--min-severity LOW|MEDIUM|HIGH] [--ignore CODE,CODE] [--json]
  python3 schema_lint.py --self-test
Exit codes: 0 = no HIGH findings, 1 = HIGH findings, 2 = bad input (unreadable file,
no CREATE TABLE found).
"""
import argparse, json, re, sys

SEV_ORDER = {"HIGH": 0, "MEDIUM": 1, "LOW": 2}
MONEY_RE = re.compile(r"(^|_)(price|amount|total|subtotal|cost|balance|fee|fees|tax|salary|refund|discount|paid|payment|revenue|credit|debit|charge)(_|$)", re.I)
RESERVED = {"user", "order", "group", "select", "table", "column", "desc", "asc", "check", "default", "from",
            "where", "limit", "offset", "references", "primary", "key", "range", "rank", "window", "all", "both",
            "end", "grant", "to", "type", "values", "constraint", "index", "match", "condition", "interval", "read", "row"}
RESERVED_PG_ONLY_SAFE = {"key", "range", "rank", "type", "values", "match", "condition", "interval", "read", "row", "index"}  # fine unquoted in Postgres
RESERVED_MY_ONLY_SAFE = {"offset", "user", "end", "type", "values", "row"}  # fine unquoted in MySQL 8
STATUS_RE = re.compile(r"^(status|state|kind|role|type|.*_status|.*_state|.*_type)$", re.I)
JSONISH_RE = re.compile(r"(^|_)(json|payload|metadata|meta|attributes|settings|extra|data)$", re.I)
INT32 = {"int", "integer", "int4", "serial", "serial4", "mediumint", "smallint", "int2", "smallserial", "tinyint"}
INT64 = {"bigint", "int8", "bigserial", "serial8"}


def finding(sev, code, table, column, problem, fix, line=0):
    return {"severity": sev, "code": code, "table": table, "column": column, "line": line, "problem": problem, "fix": fix}


def strip_comments(sql):
    out, i, n = [], 0, len(sql)
    while i < n:
        c = sql[i]
        if c in "'\"`":
            j = i + 1
            while j < n and sql[j] != c:
                j += 2 if sql[j] == "\\" and c == "'" else 1
            out.append(sql[i:j + 1]); i = j + 1
        elif sql.startswith("--", i) or c == "#" and (i == 0 or sql[i - 1] in "\n \t"):
            j = sql.find("\n", i); j = n if j < 0 else j
            out.append(" " * (j - i)); i = j
        elif sql.startswith("/*", i):
            j = sql.find("*/", i + 2); j = n if j < 0 else j + 2
            out.append(re.sub(r"[^\n]", " ", sql[i:j])); i = j
        else:
            out.append(c); i += 1
    return "".join(out)


def split_top(s, sep=","):
    parts, depth, cur, q = [], 0, [], None
    for ch in s:
        if q:
            cur.append(ch)
            if ch == q:
                q = None
            continue
        if ch in "'\"`":
            q = ch
        elif ch == "(":
            depth += 1
        elif ch == ")":
            depth -= 1
        if ch == sep and depth == 0:
            parts.append("".join(cur)); cur = []
        else:
            cur.append(ch)
    if "".join(cur).strip():
        parts.append("".join(cur))
    return parts


def statements(sql):
    clean = strip_comments(sql)
    pos = 0
    for part in split_top(clean, ";"):
        line = clean.count("\n", 0, pos + len(part) - len(part.lstrip())) + 1
        pos += len(part) + 1
        if part.strip():
            yield line, part.strip()


def ident(s):
    s = s.strip()
    quoted = s[:1] in "\"`"
    name = s.split(".")[-1].strip().strip("\"`")
    return name, quoted


def cols_list(s):
    return [ident(re.sub(r"\s+(ASC|DESC|NULLS\s+(FIRST|LAST)).*$", "", c.strip(), flags=re.I))[0].lower() if not c.strip().startswith("(") and "(" not in c else c.strip().lower()
            for c in split_top(s)]


class Schema:
    def __init__(self):
        self.tables, self.indexes, self.fks, self.enums = {}, [], [], set()
        self.dialect_hints = {"mysql": 0, "postgres": 0}


def parse(sql):
    sc = Schema()
    if re.search(r"AUTO_INCREMENT|ENGINE\s*=|`|UNSIGNED|DATETIME|TINYINT\(", sql, re.I):
        sc.dialect_hints["mysql"] += 1
    if re.search(r"\bSERIAL\b|BIGSERIAL|TIMESTAMPTZ|JSONB|GENERATED\s+(ALWAYS|BY DEFAULT)\s+AS\s+IDENTITY|::|CREATE\s+TYPE|CITEXT|CONCURRENTLY|\bTEXT\[\]", sql, re.I):
        sc.dialect_hints["postgres"] += 1
    for line, st in statements(sql):
        m = re.match(r"CREATE\s+(?:TEMP(?:ORARY)?\s+|UNLOGGED\s+)?TABLE\s+(?:IF\s+NOT\s+EXISTS\s+)?([\w\".`]+)\s*\((.*)\)\s*(.*)$", st, re.I | re.S)
        if m:
            name, quoted = ident(m.group(1))
            t = {"name": name, "quoted": quoted, "line": line, "cols": {}, "order": [], "pk": [], "uniques": [],
                 "checks": " ".join([]), "options": m.group(3), "raw": st}
            checks = []
            for item in split_top(m.group(2)):
                parse_item(item.strip(), t, sc, checks)
            t["checks"] = " ".join(checks).lower()
            sc.tables[name.lower()] = t
            continue
        m = re.match(r"CREATE\s+(UNIQUE\s+)?INDEX\s+(?:CONCURRENTLY\s+)?(?:IF\s+NOT\s+EXISTS\s+)?([\w\".`]*)\s*ON\s+(?:ONLY\s+)?([\w\".`]+)\s*(?:USING\s+\w+\s*)?\((.*)\)\s*(.*)$", st, re.I | re.S)
        if m:
            sc.indexes.append({"table": ident(m.group(3))[0].lower(), "cols": cols_list(m.group(4)), "unique": bool(m.group(1)),
                               "name": ident(m.group(2))[0] if m.group(2) else "", "partial": "where" in m.group(5).lower(), "line": line})
            continue
        m = re.match(r"ALTER\s+TABLE\s+(?:ONLY\s+)?(?:IF\s+EXISTS\s+)?([\w\".`]+)\s+(.*)$", st, re.I | re.S)
        if m:
            tname = ident(m.group(1))[0].lower()
            for action in split_top(m.group(2)):
                a = action.strip()
                am = re.match(r"ADD\s+(?:COLUMN\s+)(?:IF\s+NOT\s+EXISTS\s+)?(.*)$", a, re.I | re.S)
                if am and tname in sc.tables:
                    parse_item(am.group(1), sc.tables[tname], sc, [])
                    continue
                am = re.match(r"ADD\s+(.*)$", a, re.I | re.S)
                if am and tname in sc.tables:
                    chk = []
                    parse_item(am.group(1), sc.tables[tname], sc, chk)
                    sc.tables[tname]["checks"] += " " + " ".join(chk).lower()
            continue
        m = re.match(r"CREATE\s+TYPE\s+([\w\".]+)\s+AS\s+ENUM", st, re.I)
        if m:
            sc.enums.add(ident(m.group(1))[0].lower())
        m = re.match(r"CREATE\s+(?:DOMAIN|EXTENSION)\s+(?:IF\s+NOT\s+EXISTS\s+)?([\w\".]+)", st, re.I)
        if m:
            sc.enums.add(ident(m.group(1))[0].lower())
    return sc


def parse_item(item, t, sc, checks):
    u = item.upper()
    m = re.match(r"CONSTRAINT\s+[\w\"`]+\s+(.*)$", item, re.I | re.S)
    if m:
        item, u = m.group(1).strip(), m.group(1).strip().upper()
    if u.startswith("PRIMARY KEY"):
        t["pk"] = cols_list(re.search(r"\((.*)\)", item, re.S).group(1)); return
    if re.match(r"UNIQUE\b", u):
        cm = re.search(r"\((.*?)\)", item, re.S)
        if cm:
            cols = cols_list(cm.group(1))
            t["uniques"].append(cols)
            sc.indexes.append({"table": t["name"].lower(), "cols": cols, "unique": True, "name": "", "partial": False, "line": t["line"]})
        return
    if u.startswith("FOREIGN KEY"):
        fm = re.match(r"FOREIGN\s+KEY\s*\((.*?)\)\s*REFERENCES\s+([\w\".`]+)\s*(?:\((.*?)\))?", item, re.I | re.S)
        if fm:
            sc.fks.append({"table": t["name"].lower(), "cols": cols_list(fm.group(1)), "ref": ident(fm.group(2))[0].lower(),
                           "ref_cols": cols_list(fm.group(3)) if fm.group(3) else None})
        return
    if u.startswith("CHECK"):
        checks.append(item); return
    if re.match(r"(UNIQUE\s+)?(KEY|INDEX)\b", u) or re.match(r"(FULLTEXT|SPATIAL)\b", u):
        cm = re.search(r"\((.*)\)", item, re.S)
        if cm:
            sc.indexes.append({"table": t["name"].lower(), "cols": cols_list(cm.group(1)), "unique": u.startswith("UNIQUE"),
                               "name": "", "partial": False, "line": t["line"]})
        return
    if u.startswith(("EXCLUDE", "LIKE", "PERIOD")):
        return
    cm = re.match(r"([\"`][^\"`]+[\"`]|[\w$]+)\s+(.*)$", item, re.S)
    if not cm:
        return
    name, quoted = ident(cm.group(1))
    rest = cm.group(2)
    tm = re.match(r"((?:double\s+precision|character\s+varying|bit\s+varying|timestamp(?:\s*\(\d+\))?(?:\s+with(?:out)?\s+time\s+zone)?(?!\w)|time(?:\s+with(?:out)?\s+time\s+zone)?(?!\w)|[\w.]+)(?:\s*\([^)]*\))?(?:\s+unsigned)?(?:\s*\[\])?)", rest, re.I)
    ctype = re.sub(r"\s+", " ", tm.group(1).lower()) if tm else ""
    ru = rest.upper()
    col = {"name": name, "quoted": quoted, "type": ctype, "not_null": "NOT NULL" in ru or "PRIMARY KEY" in ru,
           "default": "DEFAULT" in ru or "IDENTITY" in ru or "AUTO_INCREMENT" in ru or ctype.endswith("serial"),
           "check": "CHECK" in ru}
    t["cols"][name.lower()] = col
    t["order"].append(name.lower())
    if "PRIMARY KEY" in ru:
        t["pk"] = [name.lower()]
    if re.search(r"\bUNIQUE\b", ru):
        t["uniques"].append([name.lower()])
        sc.indexes.append({"table": t["name"].lower(), "cols": [name.lower()], "unique": True, "name": "", "partial": False, "line": t["line"]})
    rm = re.search(r"REFERENCES\s+([\w\".`]+)\s*(?:\((.*?)\))?", rest, re.I)
    if rm:
        sc.fks.append({"table": t["name"].lower(), "cols": [name.lower()], "ref": ident(rm.group(1))[0].lower(),
                       "ref_cols": cols_list(rm.group(2)) if rm.group(2) else None})
    if col["check"]:
        checks.append(f"check ({name})")


def qi(name):
    return f'"{name}"' if name.lower() in RESERVED or name != name.lower() else name


def base_type(ctype):
    t = re.sub(r"\(.*?\)|\s+unsigned|\[\]", "", ctype).strip()
    return {"int4": "integer", "int": "integer", "serial": "integer", "serial4": "integer", "int8": "bigint",
            "bigserial": "bigint", "serial8": "bigint", "int2": "smallint", "smallserial": "smallint"}.get(t, t)


def lint(sql, dialect="auto", ignore=()):
    sc = parse(sql)
    if dialect == "auto":
        dialect = "mysql" if sc.dialect_hints["mysql"] > sc.dialect_hints["postgres"] else "postgres"
    out = []

    def add(*a, **k):
        f = finding(*a, **k)
        if f["code"] not in ignore:
            out.append(f)

    table_names = set(sc.tables)
    for key, t in sc.tables.items():
        tn = t["name"]
        ln = t["line"]
        if not t["pk"]:
            add("HIGH", "NO_PRIMARY_KEY", tn, "", "table has no primary key: duplicate rows cannot be told apart, updates and replication (logical replication, MySQL row-based, CDC) suffer",
                "add a bigint identity (or UUID) primary key, or a composite key on the natural unique columns", line=ln)
        elif len(t["pk"]) == 1 and t["pk"][0] in t["cols"]:
            c = t["cols"][t["pk"][0]]
            bt = base_type(c["type"])
            if bt in {"integer", "smallint", "mediumint", "tinyint"} and not re.search(r"(^|_)(type|status|kind|country|currency|lookup)s?$", tn, re.I):
                add("MEDIUM", "INT32_PRIMARY_KEY", tn, c["name"], f"primary key {c['name']} is {c['type']} (max about 2.1 billion, less for smaller types); running out means an emergency type change on the biggest table",
                    "use bigint GENERATED ALWAYS AS IDENTITY (Postgres) or BIGINT UNSIGNED AUTO_INCREMENT (MySQL)", line=ln)
        if dialect == "postgres" and t["quoted"] and t["name"] != t["name"].lower():
            add("LOW", "MIXED_CASE_NAME", tn, "", f'table "{tn}" is quoted mixed case: every query must quote it forever', "use snake_case lower-case names", line=ln)
        if tn.lower() in RESERVED and not (dialect == "postgres" and tn.lower() in RESERVED_PG_ONLY_SAFE) and not (dialect == "mysql" and tn.lower() in RESERVED_MY_ONLY_SAFE):
            add("MEDIUM", "RESERVED_WORD_NAME", tn, "", f"table name '{tn}' is a reserved word and must be quoted in every query and ORM", "rename (e.g. users, orders, user_groups)", line=ln)
        if dialect == "mysql":
            opts = t["options"].lower()
            if re.search(r"engine\s*=\s*myisam", opts):
                add("HIGH", "MYISAM_ENGINE", tn, "", "ENGINE=MyISAM has no transactions, no foreign keys and table-level locks; crashes can corrupt it", "use ENGINE=InnoDB", line=ln)
            if re.search(r"charset\s*=\s*utf8(mb3)?\b(?!mb4)", opts):
                add("MEDIUM", "MYSQL_UTF8MB3", tn, "", "utf8 in MySQL is 3-byte utf8mb3: emoji and some CJK characters fail to insert or get mangled", "use DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci", line=ln)
        if not any(re.match(r"^(created_at|created|created_on|inserted_at|date_created|creation_date)$", c) for c in t["cols"]):
            add("LOW", "NO_CREATED_AT", tn, "", "no created_at column: hard to debug, audit or backfill later", "add created_at timestamptz NOT NULL DEFAULT now()", line=ln)
        v255 = [c["name"] for c in t["cols"].values() if re.match(r"(varchar|character varying)\s*\(255\)", c["type"])]
        if dialect == "postgres" and len(v255) >= 3:
            add("LOW", "VARCHAR_255_HABIT", tn, ", ".join(v255), f"{len(v255)} columns are varchar(255): in Postgres the limit costs nothing to drop but 255 is rarely the real rule",
                "use text, with a CHECK (char_length(x) <= n) where a real limit exists", line=ln)
        for cname in t["order"]:
            c = t["cols"][cname]
            ct, bt = c["type"], base_type(c["type"])
            cn = c["name"]
            if MONEY_RE.search(cn) and bt in {"float", "real", "double", "double precision", "float4", "float8"}:
                add("HIGH", "FLOAT_MONEY", tn, cn, f"{cn} is {ct}: binary floating point cannot store 0.10 exactly, sums drift by cents",
                    "use numeric(12,2) / DECIMAL(12,2), or bigint minor units (amount_cents)", line=ln)
            if bt == "money" and dialect == "postgres":
                add("MEDIUM", "MONEY_TYPE", tn, cn, "Postgres money type depends on lc_monetary, has one fixed currency and rounds", "use numeric(12,2) plus a currency column", line=ln)
            if dialect == "postgres" and (re.match(r"^timestamp(\s*\(\d+\))?$", ct) or "without time zone" in ct):
                add("MEDIUM", "TIMESTAMP_WITHOUT_TZ", tn, cn, f"{cn} is timestamp without time zone: the instant depends on whatever zone the writer assumed", "use timestamptz (stores an absolute instant, displays in the session zone)", line=ln)
            if dialect == "mysql" and bt == "datetime" and re.search(r"_at$", cn):
                add("LOW", "DATETIME_NO_ZONE", tn, cn, f"{cn} is DATETIME (no zone): make sure every writer stores UTC", "document and enforce UTC (time_zone='+00:00' on connections) or use TIMESTAMP within its 2038 range", line=ln)
            if re.match(r"^(created_at|updated_at|inserted_at)$", cn, re.I) and not c["not_null"]:
                add("MEDIUM", "NULLABLE_AUDIT_COLUMN", tn, cn, f"{cn} is nullable{'' if c['default'] else ' and has no default'}: rows without it will appear", f"{cn} timestamptz NOT NULL DEFAULT now()", line=ln)
            if bt in {"boolean", "bool"} and not c["not_null"]:
                add("LOW", "NULLABLE_BOOLEAN", tn, cn, f"{cn} is a nullable boolean: three states (true, false, unknown) and NULL-unsafe WHERE clauses", f"{cn} boolean NOT NULL DEFAULT false", line=ln)
            if STATUS_RE.match(cn) and re.match(r"^(text|varchar|character varying|char|character)", bt) and not c["check"] \
                    and cn.lower() not in t["checks"] and not any(f["table"] == key and cname in f["cols"] for f in sc.fks):
                add("LOW", "UNCHECKED_STATUS", tn, cn, f"{cn} is free text: typos like 'Shipped ' and 'shiped' will end up in the data", "add CHECK (status IN (...)), an enum type, or a FK to a lookup table", line=ln)
            if bt in {"text", "longtext", "mediumtext"} and JSONISH_RE.search(cn):
                add("LOW", "JSON_IN_TEXT", tn, cn, f"{cn} looks like JSON stored as {ct}: no validation, no indexing", "use jsonb (Postgres) or JSON (MySQL) if it really is JSON", line=ln)
            if cn.lower() in RESERVED and not (dialect == "postgres" and cn.lower() in RESERVED_PG_ONLY_SAFE) and not (dialect == "mysql" and cn.lower() in RESERVED_MY_ONLY_SAFE) and cn.lower() not in {"type"}:
                add("MEDIUM", "RESERVED_WORD_NAME", tn, cn, f"column name '{cn}' is a reserved word and needs quoting everywhere", "rename it (e.g. sort_order, user_id, group_name, ends_at)", line=ln)
            if dialect == "postgres" and c["quoted"] and cn != cn.lower():
                add("LOW", "MIXED_CASE_NAME", tn, cn, f'column "{cn}" is quoted mixed case: every query must quote it', "use snake_case", line=ln)
            if cn.lower().endswith("_id") and cname not in t["pk"] and not any(f["table"] == key and cname in f["cols"] for f in sc.fks):
                stem = cn.lower()[:-3]
                cands = [x for x in (stem, stem + "s", stem + "es", stem[:-1] + "ies" if stem.endswith("y") else None) if x and x in table_names]
                if cands:
                    add("LOW", "MISSING_FOREIGN_KEY", tn, cn, f"{cn} looks like a reference to {cands[0]} but has no foreign key: orphans and typos are possible", f"add REFERENCES {cands[0]}(id) (with an index)", line=ln)
            if re.search(r"(^|_)email$", cn, re.I) and [cname] in t["uniques"] and dialect == "postgres" and bt != "citext":
                if not any(i["table"] == key and any("lower(" in c2 for c2 in i["cols"]) for i in sc.indexes):
                    add("LOW", "CASE_SENSITIVE_UNIQUE_EMAIL", tn, cn, "UNIQUE on email is case-sensitive in Postgres: Ana@x.com and ana@x.com can both sign up", "CREATE UNIQUE INDEX ... ON t (lower(email)) or use citext", line=ln)
    # foreign keys: types and indexes
    for f in sc.fks:
        t = sc.tables.get(f["table"])
        r = sc.tables.get(f["ref"])
        if not t:
            continue
        ref_cols = f["ref_cols"] or (r["pk"] if r else None)
        if r and ref_cols and len(ref_cols) == len(f["cols"]):
            for c, rc in zip(f["cols"], ref_cols):
                a, b = t["cols"].get(c), r["cols"].get(rc)
                if a and b and base_type(a["type"]) != base_type(b["type"]) and not ({base_type(a["type"]), base_type(b["type"])} <= {"uuid"}):
                    add("HIGH", "FK_TYPE_MISMATCH", t["name"], a["name"], f"{a['name']} is {a['type']} but references {r['name']}.{b['name']} ({b['type']}): joins need casts and the FK fails once ids pass the smaller range",
                        f"make {a['name']} the same type as {r['name']}.{b['name']}", line=t["line"])
        if dialect == "postgres":
            covered = any(idx["table"] == f["table"] and not idx["partial"] and idx["cols"][:len(f["cols"])] == f["cols"] for idx in sc.indexes) \
                or t["pk"][:len(f["cols"])] == f["cols"] or any(u[:len(f["cols"])] == f["cols"] for u in t["uniques"])
            if not covered:
                add("MEDIUM", "FK_WITHOUT_INDEX", t["name"], ", ".join(f["cols"]), f"foreign key ({', '.join(f['cols'])}) -> {f['ref']} has no index starting with it: deletes/updates on {f['ref']} scan {t['name']}, and joins are slow",
                    f"CREATE INDEX CONCURRENTLY ON {qi(t['name'])} ({', '.join(f['cols'])})", line=t["line"])
    # redundant indexes
    for i, a in enumerate(sc.indexes):
        t = sc.tables.get(a["table"])
        if not t or a["partial"] or any("(" in c for c in a["cols"]):
            continue
        others = [b for j, b in enumerate(sc.indexes) if j != i and b["table"] == a["table"] and not b["partial"]]
        if t["pk"] and a["cols"] == t["pk"][:len(a["cols"])] and not a["unique"]:
            add("LOW", "REDUNDANT_INDEX", t["name"], ", ".join(a["cols"]), f"index on ({', '.join(a['cols'])}) duplicates the primary key's leading columns", "drop it", line=a["line"])
            continue
        for b in others:
            if len(b["cols"]) > len(a["cols"]) and b["cols"][:len(a["cols"])] == a["cols"] and not a["unique"]:
                add("LOW", "REDUNDANT_INDEX", t["name"], ", ".join(a["cols"]), f"index on ({', '.join(a['cols'])}) is a prefix of the index on ({', '.join(b['cols'])})", "drop the shorter one unless it is much smaller and hot", line=a["line"])
                break
            if b["cols"] == a["cols"] and j_before(sc.indexes, b, a) and a["unique"] == b["unique"]:
                add("LOW", "REDUNDANT_INDEX", t["name"], ", ".join(a["cols"]), f"two indexes on ({', '.join(a['cols'])})", "drop one", line=a["line"])
                break
    out.sort(key=lambda f: (SEV_ORDER[f["severity"]], f["table"], f["column"], f["code"]))
    return dialect, sc, out


def j_before(lst, b, a):
    return lst.index(b) < lst.index(a)


def report(path, dialect, sc, found):
    counts = {s: sum(1 for f in found if f["severity"] == s) for s in SEV_ORDER}
    out = [f"# Schema review: {path} ({dialect})", "",
           f"Tables: {len(sc.tables)}   Indexes: {len(sc.indexes)}   Foreign keys: {len(sc.fks)}   Findings: {len(found)} (HIGH {counts['HIGH']}, MEDIUM {counts['MEDIUM']}, LOW {counts['LOW']})", ""]
    if not found:
        out.append("No findings.")
        return "\n".join(out)
    out += ["| Sev | Code | Table.Column | Problem | Fix |", "|---|---|---|---|---|"]
    for f in found:
        loc = f["table"] + ("." + f["column"] if f["column"] else "")
        out.append(f"| {f['severity']} | {f['code']} | {loc} | {f['problem'].replace('|', '/')} | {f['fix'].replace('|', '/')} |")
    return "\n".join(out)


def self_test():
    ok_pk = "CREATE TABLE t (id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY, created_at timestamptz NOT NULL DEFAULT now()"
    cases = [
        ("clean postgres table", ok_pk + ", name text NOT NULL);", "postgres", [], ["NO_PRIMARY_KEY", "INT32_PRIMARY_KEY", "NO_CREATED_AT"]),
        ("no primary key", "CREATE TABLE logs (msg text, created_at timestamptz NOT NULL);", "auto", ["NO_PRIMARY_KEY"], []),
        ("table-level composite pk", "CREATE TABLE m (a bigint, b bigint, created_at timestamptz NOT NULL, PRIMARY KEY (a, b));", "auto", [], ["NO_PRIMARY_KEY"]),
        ("named pk constraint", "CREATE TABLE m (id bigint, created_at timestamptz NOT NULL, CONSTRAINT m_pk PRIMARY KEY (id));", "auto", [], ["NO_PRIMARY_KEY"]),
        ("pk added by alter", "CREATE TABLE m (id bigint NOT NULL, created_at timestamptz NOT NULL); ALTER TABLE m ADD CONSTRAINT m_pkey PRIMARY KEY (id);", "auto", [], ["NO_PRIMARY_KEY"]),
        ("serial pk is int32", "CREATE TABLE orders (id serial PRIMARY KEY, created_at timestamptz NOT NULL);", "auto", ["INT32_PRIMARY_KEY"], []),
        ("small lookup table int pk ok", "CREATE TABLE order_status (id smallint PRIMARY KEY, created_at timestamptz NOT NULL);", "auto", [], ["INT32_PRIMARY_KEY"]),
        ("float money", ok_pk + ", total_price double precision);", "postgres", ["FLOAT_MONEY"], []),
        ("numeric money ok", ok_pk + ", amount numeric(12,2) NOT NULL);", "postgres", [], ["FLOAT_MONEY"]),
        ("float non-money ok", ok_pk + ", latitude double precision);", "postgres", [], ["FLOAT_MONEY"]),
        ("money type", ok_pk + ", balance money);", "postgres", ["MONEY_TYPE"], []),
        ("timestamp without tz", ok_pk + ", shipped_at timestamp);", "postgres", ["TIMESTAMP_WITHOUT_TZ"], []),
        ("timestamp(3) without time zone", ok_pk + ", shipped_at timestamp(3) without time zone);", "postgres", ["TIMESTAMP_WITHOUT_TZ"], []),
        ("timestamptz ok", ok_pk + ", shipped_at timestamp with time zone);", "postgres", [], ["TIMESTAMP_WITHOUT_TZ"]),
        ("nullable created_at", "CREATE TABLE t (id bigint PRIMARY KEY, created_at timestamptz);", "postgres", ["NULLABLE_AUDIT_COLUMN"], []),
        ("no created_at", "CREATE TABLE t (id bigint PRIMARY KEY, name text);", "postgres", ["NO_CREATED_AT"], []),
        ("nullable boolean", ok_pk + ", is_active boolean);", "postgres", ["NULLABLE_BOOLEAN"], []),
        ("boolean not null ok", ok_pk + ", is_active boolean NOT NULL DEFAULT true);", "postgres", [], ["NULLABLE_BOOLEAN"]),
        ("unchecked status", ok_pk + ", status varchar(20) NOT NULL);", "postgres", ["UNCHECKED_STATUS"], []),
        ("status with check ok", ok_pk + ", status text NOT NULL CHECK (status IN ('a','b')));", "postgres", [], ["UNCHECKED_STATUS"]),
        ("status table check ok", ok_pk + ", status text NOT NULL, CONSTRAINT st CHECK (status IN ('a')));", "postgres", [], ["UNCHECKED_STATUS"]),
        ("reserved table name", "CREATE TABLE \"user\" (id bigint PRIMARY KEY, created_at timestamptz NOT NULL);", "postgres", ["RESERVED_WORD_NAME"], []),
        ("reserved column order", ok_pk + ", \"order\" int);", "postgres", ["RESERVED_WORD_NAME"], []),
        ("mixed case quoted", "CREATE TABLE \"OrderItems\" (id bigint PRIMARY KEY, created_at timestamptz NOT NULL);", "postgres", ["MIXED_CASE_NAME"], []),
        ("fk without index", "CREATE TABLE a (id bigint PRIMARY KEY, created_at timestamptz NOT NULL); CREATE TABLE b (id bigint PRIMARY KEY, created_at timestamptz NOT NULL, a_id bigint NOT NULL REFERENCES a(id));", "postgres", ["FK_WITHOUT_INDEX"], ["FK_TYPE_MISMATCH"]),
        ("fk with index ok", "CREATE TABLE a (id bigint PRIMARY KEY, created_at timestamptz NOT NULL); CREATE TABLE b (id bigint PRIMARY KEY, created_at timestamptz NOT NULL, a_id bigint REFERENCES a); CREATE INDEX ON b (a_id, id);", "postgres", [], ["FK_WITHOUT_INDEX"]),
        ("fk covered by composite pk", "CREATE TABLE a (id bigint PRIMARY KEY, created_at timestamptz NOT NULL); CREATE TABLE ab (a_id bigint REFERENCES a(id), x bigint, created_at timestamptz NOT NULL, PRIMARY KEY (a_id, x));", "postgres", [], ["FK_WITHOUT_INDEX"]),
        ("fk type mismatch", "CREATE TABLE a (id bigint PRIMARY KEY, created_at timestamptz NOT NULL); CREATE TABLE b (id bigint PRIMARY KEY, created_at timestamptz NOT NULL, a_id integer, FOREIGN KEY (a_id) REFERENCES a (id));", "postgres", ["FK_TYPE_MISMATCH"], []),
        ("missing fk on _id", "CREATE TABLE customers (id bigint PRIMARY KEY, created_at timestamptz NOT NULL); CREATE TABLE orders (id bigint PRIMARY KEY, created_at timestamptz NOT NULL, customer_id bigint NOT NULL);", "postgres", ["MISSING_FOREIGN_KEY"], []),
        ("external _id without table ok", ok_pk + ", stripe_id text);", "postgres", [], ["MISSING_FOREIGN_KEY"]),
        ("case-sensitive unique email", ok_pk + ", email text NOT NULL UNIQUE);", "postgres", ["CASE_SENSITIVE_UNIQUE_EMAIL"], []),
        ("lower(email) index ok", ok_pk + ", email text NOT NULL UNIQUE); CREATE UNIQUE INDEX t_email ON t (lower(email));", "postgres", [], ["CASE_SENSITIVE_UNIQUE_EMAIL"]),
        ("redundant prefix index", ok_pk + ", a bigint, b bigint); CREATE INDEX i1 ON t (a); CREATE INDEX i2 ON t (a, b);", "postgres", ["REDUNDANT_INDEX"], []),
        ("json in text", ok_pk + ", payload text);", "postgres", ["JSON_IN_TEXT"], []),
        ("varchar 255 habit", ok_pk + ", a varchar(255), b varchar(255), c varchar(255));", "postgres", ["VARCHAR_255_HABIT"], []),
        ("mysql myisam and utf8", "CREATE TABLE `t` (`id` int unsigned NOT NULL AUTO_INCREMENT, `created_at` datetime NOT NULL, PRIMARY KEY (`id`)) ENGINE=MyISAM DEFAULT CHARSET=utf8;", "auto", ["MYISAM_ENGINE", "MYSQL_UTF8MB3", "INT32_PRIMARY_KEY", "DATETIME_NO_ZONE"], ["TIMESTAMP_WITHOUT_TZ"]),
        ("mysql utf8mb4 innodb ok", "CREATE TABLE `t` (`id` bigint unsigned NOT NULL AUTO_INCREMENT, `created_at` datetime NOT NULL, PRIMARY KEY (`id`)) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;", "auto", [], ["MYISAM_ENGINE", "MYSQL_UTF8MB3", "INT32_PRIMARY_KEY"]),
        ("mysql fk needs no extra index", "CREATE TABLE a (id bigint PRIMARY KEY, created_at datetime NOT NULL) ENGINE=InnoDB; CREATE TABLE b (id bigint PRIMARY KEY, created_at datetime NOT NULL, a_id bigint, FOREIGN KEY (a_id) REFERENCES a(id)) ENGINE=InnoDB;", "mysql", [], ["FK_WITHOUT_INDEX"]),
        ("comments and strings ignored", "-- CREATE TABLE x (a int);\n/* CREATE TABLE y (b int); */\n" + ok_pk + ", note text DEFAULT 'a;b -- c');", "postgres", [], ["NO_PRIMARY_KEY"]),
        ("alter add column parsed", ok_pk + "); ALTER TABLE t ADD COLUMN total_amount float;", "postgres", ["FLOAT_MONEY"], []),
    ]
    passed = 0
    for name, sql, dialect, expect, absent in cases:
        d, sc, found = lint(sql, dialect)
        codes = {f["code"] for f in found}
        ok = all(c in codes for c in expect) and not any(c in codes for c in absent)
        if name == "clean postgres table":
            ok = ok and not found
        if name == "comments and strings ignored":
            ok = ok and len(sc.tables) == 1
        if name.startswith("mysql myisam"):
            ok = ok and d == "mysql"
        passed += ok
        print(("PASS " if ok else "FAIL ") + name + ("" if ok else f" -> got {sorted(codes)}"))
    d, sc, found = lint("", "auto")
    ok = report("x.sql", d, sc, found).endswith("No findings.")
    passed += ok
    print(("PASS " if ok else "FAIL ") + "empty report")
    total = len(cases) + 1
    print(f"{passed}/{total} passed")
    return 0 if passed == total else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="SQL schema design linter (Postgres/MySQL DDL)")
    ap.add_argument("files", nargs="*")
    ap.add_argument("--dialect", default="auto", choices=["auto", "postgres", "mysql"])
    ap.add_argument("--min-severity", default="LOW", choices=list(SEV_ORDER))
    ap.add_argument("--ignore", default="")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    if not a.files:
        ap.print_usage(sys.stderr)
        return 2
    ignore = {c.strip() for c in a.ignore.split(",") if c.strip()}
    sql_all = []
    for p in a.files:
        try:
            with open(p, encoding="utf-8") as fh:
                sql_all.append(fh.read())
        except OSError as e:
            print(f"error: cannot read {p}: {e}", file=sys.stderr)
            return 2
    dialect, sc, found = lint("\n;\n".join(sql_all), a.dialect, ignore)
    if not sc.tables:
        print("error: no CREATE TABLE statements found", file=sys.stderr)
        return 2
    found = [f for f in found if SEV_ORDER[f["severity"]] <= SEV_ORDER[a.min_severity]]
    if a.json:
        print(json.dumps({"dialect": dialect, "tables": len(sc.tables), "findings": found}, indent=2))
    else:
        print(report(", ".join(a.files), dialect, sc, found))
    return 1 if any(f["severity"] == "HIGH" for f in found) else 0


if __name__ == "__main__":
sys.exit(main())Tìm khung giờ họp công bằng cho các nhóm làm việc phân tán. Tiếp nhận múi giờ IANA, ngày và giờ làm việc, mức độ sẵn sàng linh hoạt thêm giờ, ngày nghỉ lễ và thời gian bận của từng người tham gia, sau đó liệt kê mọi khung giờ trong một khoảng thời gian theo giờ địa phương của từng người, xử lý việc chuyển đổi giờ mùa hè (DST) diễn ra vào các ngày cuối tuần khác nhau và chọn một chuỗi lịch họp luân phiên để cùng một nhóm người không phải lúc nào cũng chịu cảnh họp quá sớm hoặc quá muộn. Bao gồm một script Python sử dụng thư viện chuẩn zoneinfo có hỗ trợ cờ --self-test.
---
name: time-zone-meeting-slot-finder
description: Tìm khung giờ họp công bằng cho các nhóm làm việc phân tán. Tiếp nhận múi giờ IANA, ngày và giờ làm việc, mức độ sẵn sàng linh hoạt thêm giờ, ngày nghỉ lễ và thời gian bận của từng người tham gia, sau đó liệt kê mọi khung giờ trong một khoảng thời gian theo giờ địa phương của từng người, xử lý việc chuyển đổi giờ mùa hè (DST) diễn ra vào các ngày cuối tuần khác nhau và chọn một chuỗi lịch họp luân phiên để cùng một nhóm người không phải lúc nào cũng chịu cảnh họp quá sớm hoặc quá muộn. Bao gồm một script Python sử dụng thư viện chuẩn zoneinfo có hỗ trợ cờ --self-test.
---

# Công cụ Tìm Khung Giờ Họp Đa Múi Giờ (Time Zone Meeting Slot Finder)

Bạn giúp các nhóm làm việc phân tán chọn ra những khung giờ họp khả thi cho tất cả những người bắt buộc tham gia và đảm bảo tính công bằng theo thời gian. Bạn tính toán dựa trên giờ địa phương của từng người vào đúng những ngày thực tế (không bao giờ dùng các quy tắc ước chừng kiểu "LA chậm hơn Berlin 9 tiếng", vốn sẽ bị sai lệch suốt nhiều tuần vào mỗi dịp xuân và thu), trình bày minh bạch các sự đánh đổi và luân phiên những khung giờ bất tiện thay vì luôn dồn phần thiệt thòi cho cùng một số người.

## Các tệp trong kỹ năng này

- `scripts/slot_finder.py` - đọc tệp CSV danh sách nhóm và tệp CSV thời gian bận (tùy chọn), đánh giá từng khung giờ trên lưới thời gian trong khoảng ngày đã chọn theo giờ địa phương của mỗi người tham gia (dùng `zoneinfo` của Python), xếp hạng các khung giờ theo số người vắng mặt và mức độ phải dãn giờ làm việc (stretch) của họ, báo cáo các thay đổi giờ mùa hè (DST) trong khoảng thời gian đó, và có thể chọn một chuỗi lịch họp luân phiên công bằng (chỉ dùng thư viện chuẩn của Python 3.9+)
- `references/dst-and-time-zone-pitfalls.md` - ngày áp dụng DST theo khu vực, các múi giờ không đổi giờ, các múi giờ lệch nửa tiếng, những ngày cuối tuần không phải Thứ Bảy - Chủ Nhật, các chữ viết tắt cần tránh và cách lời mời lịch (calendar invites) hoạt động khi đi qua thời điểm đổi giờ
- `references/fairness-and-rotation.md` - mô hình tính điểm bất tiện (pain-point model), cách thuật toán luân phiên lựa chọn, khi nào nên tách cuộc họp hoặc chuyển sang làm việc bất đồng bộ (async), và cách giải thích lựa chọn đó cho cả nhóm
- `templates/slot-proposal.md` - bản đề xuất khung giờ họp để gửi cho nhóm
- `examples/team.csv` - năm thành viên ở Los Angeles, New York, Berlin, Istanbul và Kolkata (một người không bắt buộc)
- `examples/blocked.csv` - một ngày nghỉ lễ quốc gia, một lịch khám nha khoa, một buổi họp hội đồng và một ngày nghỉ phép

## Quy trình làm việc

### 1. Thu thập thông tin thực tế
Đối với mỗi người tham gia: tên, múi giờ IANA (theo thành phố, ví dụ `America/Los_Angeles`, không bao giờ dùng "PST"), các ngày làm việc (Thứ Hai - Thứ Sáu, hoặc Chủ Nhật - Thứ Năm ở phần lớn khu vực Trung Đông), giờ làm việc, số giờ họ sẵn sàng bắt đầu sớm hơn hoặc kết thúc muộn hơn, và việc họ có bắt buộc phải tham gia hay không. Ngoài ra cần có khoảng ngày dự kiến, thời lượng cuộc họp, tần suất lặp lại, các ngày nghỉ lễ đã biết và các khoảng thời gian bận (tính theo giờ địa phương của chính người đó). Hãy hỏi trực tiếp thay vì tự đoán múi giờ từ tên một quốc gia/khu vực có nhiều múi giờ (ví dụ: một thành viên nhóm ở "Mexico").

### 2. Chạy công cụ tìm kiếm
```
python3 scripts/slot_finder.py --team examples/team.csv --blocked examples/blocked.csv --start 2026-10-26 --end 2026-11-20 --days Tue,Wed,Thu --series 4
python3 scripts/slot_finder.py --team team.csv --start 2026-11-02 --end 2026-11-06 --duration 30 --step 15 --top 5
python3 scripts/slot_finder.py --team team.csv --start 2026-11-02 --end 2026-11-27 --series 8 --every day --ref-zone Europe/Berlin --json
python3 scripts/slot_finder.py --self-test
```
Các ngày (`--start`, `--end`, `--days`) được hiểu theo múi giờ tham chiếu `--ref-zone` (mặc định là UTC). Mã thoát (exit code) 0 có nghĩa là đã tìm thấy khung giờ, 1 có nghĩa là không có khung giờ nào phù hợp cho tất cả những người bắt buộc, 2 có nghĩa là dữ liệu đầu vào không hợp lệ (múi giờ không xác định, sai định dạng giờ, thiếu cột).

### 3. Đọc kết quả
- **Thay đổi DST trong khoảng thời gian** được hiển thị đầu tiên: nếu bất kỳ múi giờ nào có sự chuyển đổi giờ mùa hè trong khoảng thời gian đã chọn, cùng một giờ UTC sẽ rơi vào sớm hơn hoặc muộn hơn một tiếng đối với những người ở múi giờ đó sau ngày chuyển đổi. Hãy đề xuất các khung giờ theo từng giai đoạn, chứ không dùng một giờ UTC cố định cho toàn bộ khoảng thời gian.
- **Các khung giờ tốt nhất** được xếp hạng theo: số người không bắt buộc bị vắng mặt, tiếp theo là mức độ dãn giờ (stretch) tệ nhất của một cá nhân bất kỳ, rồi đến tổng số giờ phải dãn của cả nhóm.
- **Chuỗi luân phiên (Rotating series)** chọn một cuộc họp mỗi tuần (hoặc mỗi ngày) sao cho tổng mức độ bất tiện tích lũy cao nhất của bất kỳ ai cũng được giữ ở mức thấp nhất có thể, đồng thời phân bổ đều sự bất tiện đó. Bảng tóm tắt sẽ cho biết tần suất mỗi người được họp trong giờ hành chính, phải dãn giờ hay bị lỡ buổi họp.
- Nếu không tìm được khung giờ nào, hãy nêu rõ lý do (ai xung đột lịch với ai) và đưa ra các phương án: xin người tình nguyện dãn thêm giờ, rút ngắn thời lượng cuộc họp, chuyển một số người sang diện không bắt buộc (optional), tách thành hai cuộc họp theo khu vực hoặc cập nhật bất đồng bộ (async).

### 4. Bàn giao đề xuất
Điền vào mẫu `templates/slot-proposal.md`: phương án khuyến nghị kèm theo giờ địa phương và thứ trong tuần của từng người, ghi chú về DST, bảng luân phiên, các phương án thay thế và các câu hỏi còn bỏ ngỏ. Hãy gửi lời mời lịch từ một bộ lịch gắn với múi giờ thực tế (múi giờ IANA của người tổ chức), không để "UTC" trừ khi cả nhóm đã thống nhất, và nêu rõ múi giờ nào được dùng làm mốc neo (anchor) cho chuỗi lịch hẹn.

## Ví dụ kết quả
Năm người, từ 2026-10-26 đến 2026-11-20, Thứ Ba - Thứ Năm, 60 phút, chuỗi 4 cuộc họp hàng tuần. Châu Âu kết thúc giờ mùa hè vào ngày 25 tháng 10 còn Mỹ kết thúc vào ngày 1 tháng 11, vì vậy trong tuần lễ bắt đầu từ ngày 26 tháng 10, New York chỉ chậm hơn Berlin 5 tiếng thay vì 6 tiếng. Tuần 1: 13:30 UTC (Ana 06:30 tại Los Angeles, phải dãn giờ; Priya 19:00 tại Kolkata, phải dãn giờ; những người còn lại đều trong giờ làm việc). Sau khi Mỹ đổi giờ, có hai tuần họp lúc 16:00 UTC (Ana 08:00 trong giờ làm việc, Eva 17:00-18:00 phải dãn giờ, Bilal 19:00-20:00 phải dãn giờ) và một tuần lúc 14:30 UTC (Ana lại phải dãn giờ). Bilal bận vào ngày 29 tháng 10 (Ngày Quốc khánh Thổ Nhĩ Kỳ). Priya (không bắt buộc, +05:30) chỉ có thể tham gia trước đợt đổi giờ của Mỹ; bản đề xuất bổ sung bản ghi tóm tắt cho cô ấy và gợi ý tổ chức một khung giờ thân thiện với khu vực Châu Á mỗi tháng một lần.

## Quy tắc

- Luôn sử dụng tên múi giờ chuẩn IANA và tính toán giờ địa phương theo từng ngày cụ thể; không bao giờ áp dụng độ lệch giờ cố định (fixed offsets) băng qua ranh giới chuyển đổi giờ mùa hè (DST).
- Hiển thị giờ địa phương và thứ trong tuần của mọi người tham gia cho từng phương án đề xuất, vì ngày có thể khác nhau giữa các nơi (buổi tối ở Kolkata là buổi sáng ở Los Angeles).
- Không ai bị xếp lịch nằm ngoài khung giờ dãn (stretch) mà họ đã đồng ý; hãy hỏi ý kiến trước khi mặc định rằng ai đó sẽ nhận cuộc gọi lúc 06:00 sáng hoặc 22:00 đêm.
- Luân phiên sự bất tiện và hiển thị bảng thống kê điểm; nếu một người luôn chịu thiệt, hãy chỉ rõ điều đó và đề xuất giải pháp mang tính cấu trúc (tách cuộc họp, chuyển sang async, xoay vòng người chủ trì cuộc họp).
- Tôn trọng ngày nghỉ cuối tuần, ngày lễ quốc gia và thời gian bận trên lịch và múi giờ riêng của từng người.
- Giữ phần khuyến nghị ngắn gọn; đưa bảng dữ liệu đầy đủ vào phần phụ lục.
FILE:references/dst-and-time-zone-pitfalls.md
# Những cạm bẫy về giờ mùa hè (DST) và múi giờ

## Sử dụng tên múi giờ chuẩn IANA
- `America/New_York`, `Europe/Berlin`, `Asia/Kolkata`, `Australia/Sydney`. Chúng chứa toàn bộ lịch sử và các quy tắc tương lai của khu vực đó.
- Tránh dùng các chữ viết tắt: "EST", "CST", "IST" và "BST" rất mơ hồ (IST = Ấn Độ, Ireland hoặc Israel; CST = Miền Trung nước Mỹ, Trung Quốc hoặc Cuba) và các mục zoneinfo có tên EST hoặc MST chỉ là các độ lệch cố định không có DST. Script sẽ cảnh báo đối với những tên không chứa dấu "/".
- Tránh gắn độ lệch cố định như UTC+1 cho con người: độ lệch giờ thay đổi hai lần một năm ở rất nhiều nơi.
- Chọn thành phố có cùng quy tắc giờ với người đó: bang Arizona (`America/Phoenix`) không áp dụng DST; phần lớn Mexico đã bỏ DST vào năm 2022; `America/Sao_Paulo` đã bỏ DST vào năm 2019.
- Luôn cập nhật cơ sở dữ liệu múi giờ (`tzdata`); chính phủ các nước có thể thay đổi quy tắc chỉ với thông báo trước vài tuần.

## Ngày chuyển đổi DST (năm 2026, cần kiểm tra lại mỗi năm)
| Khu vực | Bắt đầu giờ mùa hè | Kết thúc | Ghi chú |
|---|---|---|---|
| Mỹ và Canada (phần lớn) | Chủ Nhật thứ 2 của tháng 3 (2026-03-08) | Chủ Nhật đầu tiên của tháng 11 (2026-11-01) | 02:00 giờ địa phương |
| EU, Vương quốc Anh | Chủ Nhật cuối cùng của tháng 3 (2026-03-29) | Chủ Nhật cuối cùng của tháng 10 (2026-10-25) | 01:00 UTC, đổi đồng loạt |
| Úc (đông nam), New Zealand | Chủ Nhật đầu tiên của tháng 10 / Chủ Nhật cuối cùng của tháng 9 | Chủ Nhật đầu tiên của tháng 4 | Nam bán cầu: ngược mùa |
| Không có DST | Thổ Nhĩ Kỳ (UTC+3), Ấn Độ (+05:30), Trung Quốc, Nhật Bản, Singapore, UAE, phần lớn Châu Phi, Arizona | | |

Vì vậy, mỗi năm có hai giai đoạn "lệch pha" khi chênh lệch múi giờ giữa Mỹ và Châu Âu nhỏ hơn bình thường 1 tiếng: khoảng 3 tuần vào tháng 3 và 1 tuần vào cuối tháng 10 / đầu tháng 11. Các cuộc họp định kỳ được neo theo một khu vực sẽ bị dịch chuyển 1 tiếng đối với khu vực kia trong những tuần này.

## Các độ lệch múi giờ không tròn giờ
- Ấn Độ +05:30, Iran +03:30, Nepal +05:45, Newfoundland -03:30 (-02:30 vào mùa hè), Nam Úc +09:30/+10:30, Quần đảo Chatham +12:45. Một khung lưới tính theo giờ chẵn UTC sẽ rơi vào phút :30 hoặc :45 đối với những người này; script đánh giá theo từng bước 5 phút nên kết quả luôn chính xác tuyệt đối.

## Ngày cuối tuần và ngày làm việc
- Tuần làm việc từ Chủ Nhật đến Thứ Năm: ví dụ như Israel; nghỉ cuối tuần Thứ Sáu - Thứ Bảy ở một số quốc gia vùng Vịnh, trong khi UAE đã chuyển sang làm việc Thứ Hai - Thứ Sáu (với nửa ngày Thứ Sáu) vào năm 2022. Hãy hỏi rõ từng người.
- Ngày nghỉ lễ quốc gia khác nhau tùy theo từng nước và từng vùng (bang Bavaria so với Berlin, các tiểu bang của Mỹ). Hãy thêm chúng vào tệp thời gian bận (`blocked.csv`) theo ngày địa phương.
- Khung giờ 08:00 sáng Thứ Hai ở Los Angeles là tối Thứ Hai ở Ấn Độ nhưng đã là sáng Thứ Ba ở Sydney hoặc Auckland. Luôn hiển thị rõ thứ trong tuần cho từng người.

## DST ngay trong ngày chuyển đổi giờ
- Chỉnh đồng hồ tiến lên vào mùa xuân (Spring forward): khoảng thời gian địa phương từ 02:00 đến 03:00 (ở Mỹ) không tồn tại; chỉnh lùi lại vào mùa thu (Autumn back): khoảng 01:00-02:00 lặp lại hai lần. Tránh xếp lịch vào những giờ đó trong ngày đổi giờ; script hoạt động dựa trên các mốc thời gian UTC nên không bao giờ tạo ra thời gian không hợp lệ, nhưng con người khi đọc thấy "01:30" vào ngày hôm đó rất dễ bị nhầm lẫn.

## Lời mời lịch (Calendar invites) đi qua thời điểm đổi giờ
- Một lời mời họp định kỳ được neo vào múi giờ của người tổ chức. Cuộc họp hàng tuần lúc 10:00 sáng theo giờ New York sẽ giữ nguyên ở mức 10:00 tại New York và bị dịch chuyển giờ đối với Berlin trong các tuần lệch pha.
- Nếu chuỗi cuộc họp cần giữ sự công bằng cho cả hai phía, hãy chủ động neo lịch theo giờ UTC và thông báo cho mọi người biết, hoặc lên kế hoạch riêng cho các tuần lệch pha một cách rõ ràng.
- Kiểm tra lại múi giờ của lời mời sau khi tạo (một số công cụ mặc định lấy múi giờ của thiết bị hoặc giờ "trôi nổi" - floating time).
FILE:references/fairness-and-rotation.md
# Tính công bằng và cơ chế luân phiên

## Mô hình tính điểm bất tiện (Pain-point model) được script sử dụng
| Tình huống của một người trong một cuộc họp | Điểm |
|---|---|
| Hoàn toàn nằm trong khung giờ làm việc chuẩn của họ | 0 |
| Nằm một phần hoặc toàn bộ trong khung giờ dãn (stretch window - trước hoặc sau giờ làm, trong phạm vi họ đã đồng ý) | 2 điểm cho mỗi giờ dãn, tính theo tỷ lệ (30 phút = 1 điểm) |
| Nằm ngoài khung giờ dãn, rơi vào ngày nghỉ, hoặc trùng vào thời gian bận đã chặn | không thể tham dự (khung giờ bị loại nếu đây là người bắt buộc tham gia) |
| Người không bắt buộc (optional) không thể tham dự (chỉ tính vào bảng điểm luân phiên) | 3 |

Cách xếp hạng các khung giờ đơn lẻ: ít người không bắt buộc bị vắng mặt nhất, tiếp theo là điểm số của người chịu thiệt thòi nặng nhất ở mức thấp nhất, sau đó là tổng điểm thấp nhất.

Luân phiên (`--series N`): thuật toán tham lam (greedy) thêm từng cuộc họp một, tối đa một cuộc họp mỗi tuần chuẩn ISO (`--every week`, mặc định) hoặc mỗi ngày (`--every day`), ưu tiên chọn khung giờ giúp giữ tổng điểm tích lũy cao nhất ở mức thấp nhất, sau đó đến tổng bình phương các điểm tích lũy (giúp san sẻ sự bất tiện thay vì dồn vào một người), rồi đến số người vắng mặt ít hơn. Bảng tóm tắt hiển thị cho từng người: số buổi họp trong giờ làm việc, số buổi phải dãn giờ, số buổi vắng mặt và tổng điểm.

Trọng số chỉ là một mô hình ước lượng, không phải chân lý tuyệt đối. Hãy điều chỉnh chúng cùng với nhóm: việc bắt đầu họp sớm có thể gây khó khăn cho người có con nhỏ nhiều hơn là họp kết thúc muộn, một cuộc gọi lúc 22:00 đêm gây mệt mỏi hơn nhiều so với 18:30 tối. Hãy thay đổi khung giờ dãn (stretch window) cho từng người để phản ánh đúng mức độ họ thực sự chấp nhận được.

## Làm rõ các sự đánh đổi
- Hiển thị giờ địa phương và thứ trong tuần của từng người đối với mỗi phương án.
- Hiển thị bảng thống kê luân phiên, để việc "Bilal phải dãn giờ 3 trên 4 lần" là một quyết định nhìn thấy rõ ràng chứ không phải sự vô tình.
- Yêu cầu mọi người tự đặt khung giờ dãn của riêng mình; đừng bao giờ mặc định rằng ai đó sẽ nhận cuộc gọi lúc 06:30 sáng chỉ vì họ đã từng làm vậy một lần.

## Khi không tồn tại khung giờ công bằng nào
- Rút ngắn thời lượng cuộc họp: cuộc họp 30 phút thường dễ xếp vừa khung giờ hơn nhiều so với 60 phút.
- Chuyển một số người sang diện không bắt buộc (optional) và ghi hình lại cuộc họp kèm theo biên bản ghi chú và nhật ký quyết định (decision log).
- Tách cuộc họp theo khu vực (Châu Mỹ + Châu Âu, Châu Âu + Châu Á) với một người đóng vai trò cầu nối, và luân phiên người làm cầu nối này.
- Luân phiên hai khung giờ cố định theo từng tuần (ví dụ: 14:00 UTC và 07:00 UTC) để mỗi bên đều được hưởng khung giờ thuận tiện trong một nửa thời gian.
- Chuyển sang làm việc bất đồng bộ (async): cập nhật bằng văn bản, quay video demo sẵn, đưa ra quyết định trong tài liệu chung kèm hạn chót (deadline) tính theo giờ địa phương của mọi người.

## Danh sách kiểm tra (Checklist) trước khi gửi lời mời
- Mọi thành viên bắt buộc đều nằm trong giờ làm việc hoặc trong khung giờ dãn đã đồng ý đối với tất cả các buổi họp trong chuỗi.
- Ngày nghỉ lễ và ngày nghỉ phép ở từng quốc gia đã được đưa vào tệp chặn lịch (`blocked.csv`).
- Các đợt thay đổi giờ mùa hè (DST) trong khoảng thời gian đã được nêu tên rõ ràng và chuỗi lịch họp đã tính đến chúng.
- Lời mời được tạo ở múi giờ neo đã thống nhất; thời gian trong tin nhắn thông báo được ghi rõ theo giờ của từng người.
- Có ấn định ngày rà soát lại (ví dụ: sau đợt đổi giờ DST tiếp theo) để tiếp tục điều chỉnh luân phiên.
FILE:templates/slot-proposal.md
# Đề xuất thời gian họp: <tên cuộc họp>

**Thành phần:** <Ana (Los Angeles), Dana (New York), Eva (Berlin), Bilal (Istanbul), Priya (Kolkata, không bắt buộc)>
**Thời lượng / tần suất:** <60 phút hàng tuần, Thứ Ba - Thứ Năm>   **Khoảng thời gian đã kiểm tra:** <2026-10-26 đến 2026-11-20>
**Múi giờ neo cho lời mời lịch:** <UTC / múi giờ của người tổ chức>

## Khuyến nghị
| Tuần | Bắt đầu (UTC) | Ana | Dana | Eva | Bilal | Priya |
|---|---|---|---|---|---|---|
| <26 Th10> | <Thứ Ba 13:30> | <Thứ Ba 06:30 (dãn giờ)> | <09:30> | <14:30> | <16:30> | <19:00 (dãn giờ)> |
| <2 Th11> | <Thứ Tư 16:00> | <08:00> | <11:00> | <17:00 (dãn giờ)> | <19:00 (dãn giờ)> | <không thể tham gia (21:30)> |

## Giờ mùa hè (Daylight saving)
- <Châu Âu kết thúc giờ mùa hè vào 25 Th10, Mỹ vào 1 Th11: trong tuần lễ từ 26 Th10 New York chậm hơn Berlin 5 tiếng thay vì 6 tiếng, do đó khung giờ họp dịch chuyển 1 tiếng kể từ ngày 2 Th11>

## Mức độ công bằng trong toàn bộ chuỗi họp
| Tên | Trong giờ chuẩn | Dãn giờ | Vắng mặt | Điểm |
|---|---|---|---|---|
| <Ana> | <2> | <2> | <0> | <4> |

<Một câu nhận xét về việc ai đang phải gánh nhiều sự bất tiện nhất và giải pháp bù đắp của chúng ta (ví dụ: Priya: gửi bản ghi tóm tắt + tổ chức một khung giờ thân thiện với Châu Á mỗi tháng một lần).>

## Các phương án thay thế
1. <Phiên bản họp 30 phút lúc 15:00 UTC: tất cả mọi người đều trong giờ làm việc ngoại trừ ...>
2. <Luân phiên hai khung giờ cố định theo từng tuần>

## Các ngày bận đã được tính đến
- <29 Th10: Ngày Quốc khánh, Thổ Nhĩ Kỳ (Bilal)>

## Vui lòng xác nhận
- <khung giờ dãn (stretch window) của bạn vẫn chính xác>
- <các ngày nghỉ lễ hoặc nghỉ phép trong khoảng thời gian này mà chúng tôi còn bỏ sót>
FILE:examples/team.csv
name,zone,work_start,work_end,days,flex_before,flex_after,required
Ana,America/Los_Angeles,08:00,16:30,Mon-Fri,1.5,1,yes
Dana,America/New_York,08:30,17:00,Mon-Fri,1,1,yes
Eva,Europe/Berlin,09:00,17:30,Mon-Fri,1,1.5,yes
Bilal,Europe/Istanbul,09:00,18:00,Mon-Fri,0,2,yes
Priya,Asia/Kolkata,10:00,18:30,Mon-Fri,0,2,no
FILE:examples/blocked.csv
name,date,start,end,reason
Bilal,2026-10-29,,,Republic Day (public holiday in Turkey)
Dana,2026-11-03,10:00,11:30,dentist
Eva,2026-11-05,15:30,17:30,quarterly board review
Priya,2026-11-06,,,leave
FILE:scripts/slot_finder.py
#!/usr/bin/env python3
"""Time zone meeting slot finder (Python 3.9+ standard library: zoneinfo).

Given participants with IANA time zones, working days and hours (plus how far each one
is willing to stretch before or after work), finds meeting slots over a date range,
ranks them by fairness, and can pick a rotating series so the same people do not take
the early or late call every time. Each slot is evaluated in every participant's own
local time on that date, so daylight-saving transitions inside the range (Europe and
the US switch on different weekends) are handled automatically and reported.

Pain points per participant and meeting: 0 inside working hours, 2 per hour inside the
stretch ("flex") window before or after work, unavailable beyond that, on non-working
days or during blocked time. Missing an optional participant counts as 3 pain points
for them in the rotation tally.

Usage:
  python3 slot_finder.py --team team.csv --start 2026-10-26 --end 2026-11-06
        [--duration 60] [--step 30] [--blocked blocked.csv] [--days Tue,Wed,Thu]
        [--ref-zone UTC] [--top 10] [--series N [--every week|day]] [--json]
  python3 slot_finder.py --self-test
team.csv columns: name, zone, work_start, work_end, days (Mon-Fri or Sun-Thu or
Mon,Wed,Fri), flex_before, flex_after (hours, optional), required (yes/no, optional).
work_end earlier than work_start means a shift that runs past midnight.
blocked.csv columns: name, date (participant's local date), start, end (empty = all day), reason.
Exit codes: 0 = slots found, 1 = no slot where all required participants can attend,
2 = bad input (unknown time zone, bad time, missing file or column).
"""
import argparse, csv, datetime as dt, io, json, sys
from zoneinfo import ZoneInfo, ZoneInfoNotFoundError

DAY_NAMES = ["Mon", "Tue", "Wed", "Thu", "Fri", "Sat", "Sun"]
CHUNK = 5  # minutes; fine enough for +05:30 and +05:45 zones
FLEX_PAIN_PER_HOUR = 2
MISSED_PAIN = 3


class InputError(Exception):
    pass


def parse_days(s):
    s = (s or "Mon-Fri").strip()
    out = set()
    for part in s.replace(" ", "").split(","):
        if not part:
            continue
        if "-" in part:
            a, b = part.split("-", 1)
            i, j = day_index(a), day_index(b)
            k = i
            while True:
                out.add(k)
                if k == j:
                    break
                k = (k + 1) % 7
        else:
            out.add(day_index(part))
    return out


def day_index(name):
    n = name.strip()[:3].title()
    if n not in DAY_NAMES:
        raise InputError(f"unknown day '{name}' (use Mon..Sun)")
    return DAY_NAMES.index(n)


def parse_hm(s, what):
    try:
        h, m = s.strip().split(":")
        h, m = int(h), int(m)
        if not (0 <= h <= 24 and 0 <= m < 60) or (h == 24 and m):
            raise ValueError
        return h * 60 + m
    except (ValueError, AttributeError):
        raise InputError(f"bad time '{s}' for {what} (use HH:MM, 24-hour)")


def load_zone(name, who, warnings):
    name = (name or "").strip()
    try:
        z = ZoneInfo(name)
    except (ZoneInfoNotFoundError, ValueError):
        raise InputError(f"unknown time zone '{name}' for {who}: use an IANA name such as America/New_York, Europe/Berlin, Asia/Kolkata (pip install tzdata if the system has no zone database)")
    if "/" not in name and name not in ("UTC", "Etc/UTC"):
        warnings.append(f"{who}: '{name}' is an abbreviation or legacy zone with fixed rules; use the city-based IANA name (e.g. America/New_York, not EST) so daylight saving is right")
    return z


def read_team(text, warnings):
    rows = list(csv.DictReader(io.StringIO(text.lstrip("\ufeff"))))
    if not rows:
        raise InputError("team file has no rows")
    for col in ("name", "zone", "work_start", "work_end"):
        if col not in rows[0]:
            raise InputError(f"team file is missing column '{col}'")
    team = []
    for r in rows:
        who = (r.get("name") or "").strip()
        if not who:
            continue
        p = {"name": who, "zone_name": r["zone"].strip(), "zone": load_zone(r["zone"], who, warnings),
             "start": parse_hm(r["work_start"], who + " work_start"), "end": parse_hm(r["work_end"], who + " work_end"),
             "days": parse_days(r.get("days")),
             "flex_before": int(round(float(r.get("flex_before") or 0) * 60)),
             "flex_after": int(round(float(r.get("flex_after") or 0) * 60)),
             "required": (r.get("required") or "yes").strip().lower() not in ("no", "n", "false", "0", "optional"),
             "blocked": []}
        if p["start"] == p["end"]:
            raise InputError(f"{who}: work_start equals work_end")
        team.append(p)
    names = [p["name"] for p in team]
    if len(set(names)) != len(names):
        raise InputError("duplicate participant names in team file")
    return team


def read_blocked(text, team):
    byname = {p["name"].lower(): p for p in team}
    for r in csv.DictReader(io.StringIO(text.lstrip("\ufeff"))):
        who = (r.get("name") or "").strip()
        if not who:
            continue
        p = byname.get(who.lower())
        if not p:
            raise InputError(f"blocked time for unknown participant '{who}'")
        try:
            d = dt.date.fromisoformat(r["date"].strip())
        except (ValueError, KeyError):
            raise InputError(f"bad date in blocked file for {who}: {r.get('date')}")
        s, e = (r.get("start") or "").strip(), (r.get("end") or "").strip()
        a = dt.datetime.combine(d, dt.time()) + dt.timedelta(minutes=parse_hm(s, who + " blocked start") if s else 0)
        b = dt.datetime.combine(d, dt.time()) + dt.timedelta(minutes=parse_hm(e, who + " blocked end") if e else 1440)
        p["blocked"].append((a, b, (r.get("reason") or "").strip()))


def classify(p, local):
    """local: naive local datetime. Return 'core', 'flex' or None (unavailable)."""
    best = None
    for back in (0, 1):
        d = local.date() - dt.timedelta(days=back)
        if d.weekday() not in p["days"]:
            continue
        base = dt.datetime.combine(d, dt.time())
        cs = base + dt.timedelta(minutes=p["start"])
        ce = base + dt.timedelta(minutes=p["end"] + (1440 if p["end"] <= p["start"] else 0))
        if cs <= local < ce:
            return "core"
        if cs - dt.timedelta(minutes=p["flex_before"]) <= local < ce + dt.timedelta(minutes=p["flex_after"]):
            best = "flex"
    return best


def evaluate(p, start_utc, minutes):
    """Return (status, pain, local_start, local_end, reason). status in core, flex, out."""
    flex_min = 0
    reason = ""
    for k in range(0, minutes, CHUNK):
        t = (start_utc + dt.timedelta(minutes=k)).astimezone(p["zone"]).replace(tzinfo=None)
        c = classify(p, t)
        if c is None:
            reason = "outside hours" if t.date().weekday() in p["days"] or classify_day_any(p, t) else "day off"
            return "out", 0.0, *local_span(p, start_utc, minutes), reason
        for a, b, why in p["blocked"]:
            if a <= t < b:
                return "out", 0.0, *local_span(p, start_utc, minutes), f"blocked: {why}" if why else "blocked"
        if c == "flex":
            flex_min += CHUNK
    pain = round(flex_min / 60 * FLEX_PAIN_PER_HOUR, 2)
    return ("flex" if flex_min else "core"), pain, *local_span(p, start_utc, minutes), ""


def classify_day_any(p, t):
    return (t.date() - dt.timedelta(days=1)).weekday() in p["days"] and p["end"] <= p["start"]


def local_span(p, start_utc, minutes):
    a = start_utc.astimezone(p["zone"])
    b = (start_utc + dt.timedelta(minutes=minutes)).astimezone(p["zone"])
    return a, b


def dst_changes(team, start, end):
    out = []
    seen = set()
    for p in team:
        if p["zone_name"] in seen:
            continue
        seen.add(p["zone_name"])
        z = p["zone"]
        t = dt.datetime.combine(start - dt.timedelta(days=1), dt.time(), tzinfo=dt.timezone.utc)
        stop = dt.datetime.combine(end + dt.timedelta(days=2), dt.time(), tzinfo=dt.timezone.utc)
        prev = t.astimezone(z).utcoffset()
        while t < stop:
            t2 = t + dt.timedelta(minutes=30)
            off = t2.astimezone(z).utcoffset()
            if off != prev:
                loc = t2.astimezone(z)
                out.append({"zone": p["zone_name"], "utc": t2.strftime("%Y-%m-%d %H:%M UTC"),
                            "local": loc.strftime("%Y-%m-%d %H:%M %Z"), "from": fmt_off(prev), "to": fmt_off(off)})
                prev = off
            t = t2
    return out


def fmt_off(td):
    m = int(td.total_seconds() // 60)
    s = "+" if m >= 0 else "-"
    m = abs(m)
    return f"UTC{s}{m // 60:02d}:{m % 60:02d}"


def find_slots(team, start, end, duration, step, ref_zone, only_days=None):
    """start/end: dates in ref_zone (inclusive). Returns list of slot dicts."""
    slots = []
    t = dt.datetime.combine(start, dt.time(), tzinfo=ref_zone).astimezone(dt.timezone.utc)
    stop = dt.datetime.combine(end + dt.timedelta(days=1), dt.time(), tzinfo=ref_zone).astimezone(dt.timezone.utc)
    t = t.replace(minute=(t.minute // step) * step if step < 60 else 0, second=0, microsecond=0)
    while t + dt.timedelta(minutes=duration) <= stop:
        ref_local = t.astimezone(ref_zone)
        if only_days is None or ref_local.weekday() in only_days:
            per, ok = {}, True
            for p in team:
                st, pain, a, b, why = evaluate(p, t, duration)
                per[p["name"]] = {"status": st, "pain": pain, "local_start": a, "local_end": b, "reason": why}
                if st == "out" and p["required"]:
                    ok = False
                    break
            if ok:
                missing = [p["name"] for p in team if per[p["name"]]["status"] == "out"]
                pains = [per[p["name"]]["pain"] for p in team]
                slots.append({"utc": t, "per": per, "missing": missing, "total_pain": round(sum(pains), 2),
                              "max_pain": max(pains)})
        t += dt.timedelta(minutes=step)
    return slots


def rank(slots):
    return sorted(slots, key=lambda s: (len(s["missing"]), s["max_pain"], s["total_pain"], s["utc"]))


def period_key(s, ref_zone, every):
    d = s["utc"].astimezone(ref_zone).date()
    return d.isocalendar()[:2] if every == "week" else d


def pick_series(slots, team, n, ref_zone, every="week"):
    """Greedy fair rotation: n slots, at most one per ref-zone ISO week (every="week") or
    per date (every="day"), minimising the worst cumulative pain, then the sum of squared
    cumulative pain, then missed people."""
    cum = {p["name"]: 0.0 for p in team}
    chosen, used_dates = [], set()
    for _ in range(n):
        best, best_key = None, None
        for s in slots:
            d = period_key(s, ref_zone, every)
            if d in used_dates:
                continue
            new = {k: cum[k] + (MISSED_PAIN if s["per"][k]["status"] == "out" else s["per"][k]["pain"]) for k in cum}
            key = (round(max(new.values()), 2), round(sum(v * v for v in new.values()), 2), len(s["missing"]), s["total_pain"], s["utc"])
            if best_key is None or key < best_key:
                best, best_key = s, key
        if best is None:
            break
        chosen.append(best)
        used_dates.add(period_key(best, ref_zone, every))
        for k in cum:
            cum[k] += MISSED_PAIN if best["per"][k]["status"] == "out" else best["per"][k]["pain"]
    chosen.sort(key=lambda s: s["utc"])
    return chosen, cum


def cell(info):
    a, b = info["local_start"], info["local_end"]
    txt = f"{DAY_NAMES[a.weekday()]} {a:%H:%M}-{b:%H:%M}"
    if info["status"] == "flex":
        txt += f" (stretch, {info['pain']:g})"
    elif info["status"] == "out":
        txt += f" (cannot: {info['reason']})"
    return txt


def table(slots, team, ref_zone):
    head = ["#", f"Start ({ref_zone.key})"] + [f"{p['name']} ({p['zone_name']})" for p in team] + ["Pain total/max", "Missing"]
    out = ["| " + " | ".join(head) + " |", "|" + "---|" * len(head)]
    for i, s in enumerate(slots, 1):
        r = s["utc"].astimezone(ref_zone)
        row = [str(i), f"{DAY_NAMES[r.weekday()]} {r:%Y-%m-%d %H:%M}"] + [cell(s["per"][p["name"]]) for p in team] + \
              [f"{s['total_pain']:g}/{s['max_pain']:g}", ", ".join(s["missing"]) or "-"]
        out.append("| " + " | ".join(row) + " |")
    return out


def report(team, slots, args, ref_zone, warnings, changes, series=None, cum=None):
    out = [f"# Meeting slots {args['start']} to {args['end']} ({args['duration']} min, dates in {ref_zone.key})", ""]
    for w in warnings:
        out.append(f"> WARNING: {w}")
    if warnings:
        out.append("")
    out.append("## Participants")
    out.append("| Name | Zone | Hours (local) | Days | Stretch before/after | Required |")
    out.append("|---|---|---|---|---|---|")
    for p in team:
        days = ",".join(DAY_NAMES[d] for d in sorted(p["days"]))
        out.append(f"| {p['name']} | {p['zone_name']} | {p['start'] // 60:02d}:{p['start'] % 60:02d}-{p['end'] // 60:02d}:{p['end'] % 60:02d} | {days} | {p['flex_before'] / 60:g}h / {p['flex_after'] / 60:g}h | {'yes' if p['required'] else 'no'} |")
    out += ["", "## Daylight saving changes in range"]
    if changes:
        for c in changes:
            out.append(f"- {c['zone']}: {c['from']} -> {c['to']} at {c['local']} ({c['utc']}); the same UTC time moves by an hour locally after this")
    else:
        out.append("- none")
    out.append("")
    if not slots:
        out.append("No slot found where every required participant is available. Options: allow more stretch hours, make someone optional, shorten the meeting, split into two regional meetings, or go async.")
        return "\n".join(out)
    if series:
        out += [f"## Rotating series ({len(series)} meetings, fairest combination found by greedy rotation)", ""] + table(series, team, ref_zone)
        out += ["", "| Name | In hours | Stretch | Missed | Pain total |", "|---|---|---|---|---|"]
        for p in team:
            st = [s["per"][p["name"]]["status"] for s in series]
            out.append(f"| {p['name']} | {st.count('core')} | {st.count('flex')} | {st.count('out')} | {cum[p['name']]:g} |")
        out.append("")
    top = rank(slots)[:args["top"]]
    out += [f"## Best {len(top)} of {len(slots)} possible slots", ""] + table(top, team, ref_zone)
    out += ["", f"Pain: 0 inside working hours, {FLEX_PAIN_PER_HOUR} per hour of stretch, {MISSED_PAIN} for an optional person who cannot attend (rotation only)."]
    return "\n".join(out)


def to_json(team, slots, series, cum, changes, warnings, ref_zone, top):
    def enc(s):
        return {"start_utc": s["utc"].strftime("%Y-%m-%dT%H:%MZ"), "start_ref": s["utc"].astimezone(ref_zone).isoformat(),
                "total_pain": s["total_pain"], "max_pain": s["max_pain"], "missing": s["missing"],
                "participants": {k: {"status": v["status"], "pain": v["pain"], "local_start": v["local_start"].isoformat(),
                                     "local_end": v["local_end"].isoformat(), "reason": v["reason"]} for k, v in s["per"].items()}}
    return {"warnings": warnings, "dst_changes": changes, "slot_count": len(slots),
            "best": [enc(s) for s in rank(slots)[:top]], "series": [enc(s) for s in series or []], "series_pain": cum or {}}


def run(team_text, start, end, duration=60, step=30, blocked_text=None, ref="UTC", top=10, series=0, only_days=None, every="week"):
    warnings = []
    team = read_team(team_text, warnings)
    if blocked_text:
        read_blocked(blocked_text, team)
    ref_zone = load_zone(ref, "--ref-zone", warnings)
    if end < start:
        raise InputError("--end is before --start")
    if duration % CHUNK or step % CHUNK or duration <= 0 or step <= 0:
        raise InputError(f"--duration and --step must be positive multiples of {CHUNK} minutes")
    slots = find_slots(team, start, end, duration, step, ref_zone, only_days)
    chosen, cum = pick_series(slots, team, series, ref_zone, every) if series else (None, None)
    changes = dst_changes(team, start, end)
    return team, slots, chosen, cum, changes, warnings, ref_zone


def self_test():
    T = "name,zone,work_start,work_end,days,flex_before,flex_after,required\n"
    D = dt.date
    passed, total = 0, 0

    def check(name, cond):
        nonlocal passed, total
        total += 1
        passed += bool(cond)
        print(("PASS " if cond else "FAIL ") + name)

    team, slots, *_ = run(T + "A,Europe/Berlin,09:00,17:00,Mon-Fri,0,0,yes\nB,Europe/London,09:00,17:00,Mon-Fri,0,0,yes\n", D(2026, 11, 2), D(2026, 11, 2))
    check("Berlin+London overlap is 09:00-16:00 UTC (13 one-hour starts on the 30-min grid)", len(slots) == 13 and slots[0]["utc"].hour == 9 and slots[-1]["utc"].hour == 15)
    check("all in-hours slots have zero pain", all(s["total_pain"] == 0 for s in slots))
    team, slots, *_ = run(T + "A,America/Los_Angeles,09:00,17:00,Mon-Fri,0,0,yes\nB,Asia/Kolkata,09:00,18:00,Mon-Fri,0,0,yes\n", D(2026, 11, 2), D(2026, 11, 6))
    check("LA and Kolkata without stretch: no slot", not slots)
    team, slots, *_ = run(T + "A,America/Los_Angeles,09:00,17:00,Mon-Fri,2,0,yes\nB,Asia/Kolkata,09:00,18:00,Mon-Fri,0,3,yes\n", D(2026, 11, 2), D(2026, 11, 6), duration=30)
    check("with 2h/3h stretch: only 30-min slots (15:00 UTC) exist and all carry pain", slots and all(s["total_pain"] > 0 for s in slots))
    s0 = rank(slots)[0]
    check("half-hour zone: Kolkata local minutes end in :30", s0["per"]["B"]["local_start"].minute == 30)
    team, slots, *_ = run(T + "A,Europe/Berlin,09:00,17:00,Mon-Fri,0,0,yes\nB,America/New_York,09:00,17:00,Mon-Fri,0,0,yes\n", D(2026, 10, 26), D(2026, 10, 26))
    first = slots[0]["utc"]
    check("Berlin-NY in the gap week (EU back on CET, US still EDT): overlap 13:00-16:00 UTC", first.hour == 13 and slots[-1]["utc"].hour == 15)
    team, slots2, *_ = run(T + "A,Europe/Berlin,09:00,17:00,Mon-Fri,0,0,yes\nB,America/New_York,09:00,17:00,Mon-Fri,0,0,yes\n", D(2026, 11, 2), D(2026, 11, 2))
    check("after US DST end: overlap starts 14:00 UTC", slots2[0]["utc"].hour == 14)
    *_, changes, w, rz = run(T + "A,Europe/Berlin,09:00,17:00,Mon-Fri,0,0,yes\nB,America/New_York,09:00,17:00,Mon-Fri,0,0,yes\n", D(2026, 10, 24), D(2026, 11, 3))
    zones = {c["zone"]: c for c in changes}
    check("DST changes found: Berlin 2026-10-25 and New York 2026-11-01", "2026-10-25" in zones.get("Europe/Berlin", {}).get("local", "") and "2026-11-01" in zones.get("America/New_York", {}).get("local", ""))
    team, slots, *_ = run(T + "A,Asia/Dubai,09:00,17:00,Sun-Thu,0,0,yes\nB,Europe/London,09:00,17:00,Mon-Fri,0,0,yes\n", D(2026, 11, 6), D(2026, 11, 8))
    check("Sun-Thu vs Mon-Fri: no Fri/Sat/Sun slot", not slots)
    team, slots, *_ = run(T + "A,Asia/Dubai,09:00,17:00,Sun-Thu,0,0,yes\nB,Europe/London,09:00,17:00,Mon-Fri,0,0,yes\n", D(2026, 11, 9), D(2026, 11, 9))
    check("Sun-Thu vs Mon-Fri: Monday works", bool(slots))
    team, slots, *_ = run(T + "A,Europe/Berlin,09:00,17:00,Mon-Fri,0,0,yes\nB,Europe/Paris,09:00,17:00,Mon-Fri,0,0,no\n", D(2026, 11, 2), D(2026, 11, 2),
                          blocked_text="name,date,start,end,reason\nB,2026-11-02,,,holiday\n")
    check("optional person blocked all day: slots still found, B missing", slots and all(s["missing"] == ["B"] for s in slots))
    check("blocked reason shown", slots and "holiday" in slots[0]["per"]["B"]["reason"])
    team, slots, *_ = run(T + "A,Europe/Berlin,09:00,17:00,Mon-Fri,0,0,yes\nB,Europe/Paris,09:00,17:00,Mon-Fri,0,0,yes\n", D(2026, 11, 2), D(2026, 11, 2),
                          blocked_text="name,date,start,end,reason\nB,2026-11-02,10:00,12:00,dentist\n")
    check("required person blocked 10-12 local: no slot overlaps 09:00-11:00 UTC", slots and not any(dt.time(8, 30) < s["utc"].time() < dt.time(11, 0) for s in slots))
    team, slots, *_ = run(T + "N,Europe/Berlin,22:00,06:00,Mon-Fri,0,0,yes\n", D(2026, 11, 3), D(2026, 11, 3))
    hours = sorted({s["utc"].hour for s in slots})
    check("overnight shift 22:00-06:00 Berlin (UTC+1): starts 00:00-04:00 and 21:00-23:00 UTC", hours == [0, 1, 2, 3, 4, 21, 22, 23])
    w = []
    load_zone("EST", "X", w)
    check("abbreviation zone gives a warning", w and "abbreviation" in w[0])
    try:
        load_zone("Mars/Olympus", "X", [])
        ok = False
    except InputError as e:
        ok = "unknown time zone" in str(e)
    check("unknown zone is an input error", ok)
    try:
        parse_hm("9am", "x")
        ok = False
    except InputError:
        ok = True
    check("bad time is an input error", ok)
    check("day ranges wrap: Fri-Mon", parse_days("Fri-Mon") == {4, 5, 6, 0})
    team3 = T + "A,America/Los_Angeles,09:00,17:00,Mon-Fri,2,0,yes\nB,Europe/Istanbul,09:00,18:00,Mon-Fri,0,2,yes\n"
    team, slots, chosen, cum, *_ = run(team3, D(2026, 11, 2), D(2026, 11, 6), series=4, every="day")
    st = {k: sum(1 for s in chosen if s["per"][k]["status"] == "flex") for k in ("A", "B")}
    check("series of 4 on 4 different dates", len(chosen) == 4 and len({s["utc"].date() for s in chosen}) == 4)
    check("rotation shares the stretch: both A and B stretch at least once", st["A"] >= 1 and st["B"] >= 1)
    check("rotation pain is balanced (difference <= 2 points)", abs(cum["A"] - cum["B"]) <= 2)
    team, slots, chosen, cum, *_ = run(team3, D(2026, 10, 26), D(2026, 11, 20), series=4)
    check("weekly series: one meeting in each of 4 ISO weeks", len({s["utc"].isocalendar()[1] for s in chosen}) == 4)
    team, slots, *_ = run(T + "A,Europe/Berlin,09:00,17:00,Mon-Fri,0,0,yes\n", D(2026, 11, 2), D(2026, 11, 6), only_days={1, 3})
    check("--days Tue,Thu filters candidate days", slots and {s["utc"].weekday() for s in slots} == {1, 3})
    team, slots, ch, cum, changes, w, rz = run(T + "A,Europe/Berlin,09:00,17:00,Mon-Fri,0,0,yes\n", D(2026, 11, 2), D(2026, 11, 2))
    text = report(team, slots, {"start": "2026-11-02", "end": "2026-11-02", "duration": 60, "top": 3}, rz, w, changes)
    check("report renders table", "| 1 | Mon 2026-11-02 08:00 |" in text and "Daylight saving" in text)
    j = to_json(team, slots, None, None, changes, w, rz, 3)
    check("json output has best slots", len(j["best"]) == 3 and j["best"][0]["start_utc"] == "2026-11-02T08:00Z")
    print(f"{passed}/{total} passed")
    return 0 if passed == total else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="Find fair meeting slots across time zones")
    ap.add_argument("--team")
    ap.add_argument("--blocked")
    ap.add_argument("--start")
    ap.add_argument("--end")
    ap.add_argument("--duration", type=int, default=60)
    ap.add_argument("--step", type=int, default=30)
    ap.add_argument("--days", help="only these weekdays in --ref-zone, e.g. Tue,Wed,Thu")
    ap.add_argument("--ref-zone", default="UTC")
    ap.add_argument("--top", type=int, default=10)
    ap.add_argument("--series", type=int, default=0, help="pick N meetings with rotating inconvenience")
    ap.add_argument("--every", default="week", choices=["week", "day"], help="series spacing: one meeting per ISO week (default) or per day")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    if not (a.team and a.start and a.end):
        ap.print_usage(sys.stderr)
        print("error: --team, --start and --end are required", file=sys.stderr)
        return 2
    try:
        start, end = dt.date.fromisoformat(a.start), dt.date.fromisoformat(a.end)
        team_text = open(a.team, encoding="utf-8").read()
        blocked_text = open(a.blocked, encoding="utf-8").read() if a.blocked else None
        only = parse_days(a.days) if a.days else None
        team, slots, chosen, cum, changes, warnings, rz = run(team_text, start, end, a.duration, a.step, blocked_text, a.ref_zone, a.top, a.series, only, a.every)
    except (InputError, OSError, ValueError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    if a.json:
        print(json.dumps(to_json(team, slots, chosen, cum, changes, warnings, rz, a.top), indent=2))
    else:
        print(report(team, slots, {"start": a.start, "end": a.end, "duration": a.duration, "top": a.top}, rz, warnings, changes, chosen, cum))
    return 0 if slots else 1


if __name__ == "__main__":
sys.exit(main())Các quy ước mang tính định hướng rõ ràng để xây dựng luồng đăng nhập, phiên làm việc, xác thực đa yếu tố (MFA) và OAuth bảo mật trong các ứng dụng web.
# Gu xây dựng hệ thống Xác thực (Authentication) của một kỹ sư backend chú trọng bảo mật
- Sử dụng một thư viện hoặc nhà cung cấp dịch vụ xác thực được bảo trì tốt thay vì tự viết thủ công luồng đăng nhập, quản lý phiên và xử lý token. Độ tin cậy: 0.95
- Băm (hash) mật khẩu bằng Argon2id, hoặc bcrypt với hệ số chi phí (cost) tối thiểu là 12, và không bao giờ dùng hàm băm nhanh thông thường như SHA-256. Độ tin cậy: 0.95
- Ưu tiên phiên làm việc phía máy chủ (server-side sessions) lưu trong cookie có cờ `HttpOnly`, `Secure`, `SameSite=Lax` cho các ứng dụng web bên thứ nhất (first-party) thay vì lưu JWT trong `localStorage`. Độ tin cậy: 0.90
- Sử dụng access token có thời hạn ngắn kết hợp với refresh token xoay vòng (rotating refresh tokens) khi bạn thực sự cần token phi trạng thái (stateless) cho các API hoặc ứng dụng di động. Độ tin cậy: 0.85
- Phát hiện hành vi tái sử dụng refresh token và thu hồi (revoke) toàn bộ họ token (token family) ngay khi điều đó xảy ra. Độ tin cậy: 0.85
- Tạo lại (regenerate) ID phiên làm việc khi đăng nhập, đăng xuất và khi thay đổi quyền hạn để ngăn chặn tấn công ấn định phiên (session fixation). Độ tin cậy: 0.95
- Cung cấp khóa truy cập (passkeys / WebAuthn) như một phương thức đăng nhập hạng nhất (first-class), chứ không chỉ làm yếu tố xác thực thứ hai. Độ tin cậy: 0.80
- Hỗ trợ TOTP hoặc passkey cho xác thực đa yếu tố (MFA) và chỉ coi mã SMS là phương án dự phòng cuối cùng. Độ tin cậy: 0.85
- Giới hạn tần suất (rate limit) đăng nhập, đăng ký và đặt lại mật khẩu theo từng tài khoản và từng địa chỉ IP, sử dụng thời gian chờ tăng dần theo cấp số nhân (exponential backoff) thay vì khóa cứng tài khoản vĩnh viễn. Độ tin cậy: 0.90
- Trả về cùng một thông báo chung cho cả trường hợp email không tồn tại và sai mật khẩu để kẻ tấn công không thể dò quét danh sách tài khoản (account enumeration). Độ tin cậy: 0.90
- Đảm bảo các token đặt lại mật khẩu và magic link chỉ sử dụng một lần, sinh ngẫu nhiên, được băm khi lưu trữ (hashed at rest) và hết hạn trong vòng 15 đến 60 phút. Độ tin cậy: 0.95
- Kiểm tra mật khẩu đối chiếu với danh sách các mật khẩu đã bị lộ lọt và loại bỏ các quy tắc đặt mật khẩu tùy tiện như "bắt buộc phải có một ký tự đặc biệt". Độ tin cậy: 0.85
- Sử dụng luồng OAuth 2.1 Authorization Code kết hợp PKCE cho mọi ứng dụng khách (client), và không bao giờ sử dụng luồng implicit (implicit flow). Độ tin cậy: 0.95
- Xác thực tham số `state` và `nonce` trên mọi lệnh gọi lại (callback) của OAuth và OIDC. Độ tin cậy: 0.95
- Chỉ liên kết đăng nhập mạng xã hội (social logins) với các tài khoản hiện có sau khi nhà cung cấp trả về một địa chỉ email đã được xác minh. Độ tin cậy: 0.90
- Tách biệt rõ ràng giữa xác thực (authentication - bạn là ai) và phân quyền (authorization - bạn được làm gì), đồng thời kiểm tra quyền hạn trên máy chủ đối với mọi yêu cầu (request). Độ tin cậy: 0.95
- Yêu cầu nhập lại thông tin đăng nhập hoặc xác thực lại bằng passkey trước khi thực hiện các hành động nhạy cảm như thay đổi email, mật khẩu hoặc thông tin nhận thanh toán. Độ tin cậy: 0.85
- Thông báo cho người dùng qua email khi có lượt đăng nhập từ thiết bị mới, khi thay đổi mật khẩu và khi thay đổi cài đặt MFA. Độ tin cậy: 0.80
- Cho phép người dùng xem và thu hồi các phiên làm việc đang hoạt động của họ ngay trong phần cài đặt tài khoản. Độ tin cậy: 0.80
- Ghi nhật ký (log) các sự kiện xác thực kèm theo ID người dùng, địa chỉ IP và user agent, nhưng không bao giờ ghi log mật khẩu, token hoặc đường dẫn đặt lại mật khẩu. Độ tin cậy: 0.95
- Bảo vệ các yêu cầu làm thay đổi trạng thái dựa trên cookie bằng cookie `SameSite` kết hợp với CSRF token hoặc kiểm tra header `Origin`. Độ tin cậy: 0.90
- Lưu trữ các khóa ký (signing keys) trong trình quản lý bí mật (secrets manager) và hỗ trợ xoay vòng khóa (key rotation) với header `kid` ngay từ ngày đầu tiên. Độ tin cậy: 0.85
- Viết các bài kiểm thử tích hợp (integration tests) cho các kịch bản lỗi (unhappy paths): token hết hạn, phiên bị thu hồi, đường dẫn bị phát lại (replayed links) và sai định danh tổ chức (wrong tenants). Độ tin cậy: 0.85
Các quy ước mang tính định hướng rõ ràng để xây dựng ứng dụng Ruby on Rails dễ bảo trì với Hotwire và các thiết lập mặc định hiện đại của Rails.
# Gu phát triển Ứng dụng Rails của một lập trình viên Ruby on Rails thực dụng
- Bắt đầu các ứng dụng mới trên phiên bản Rails mới nhất cùng với PostgreSQL, và gắn bó với các thiết lập mặc định trừ khi có lý do rõ ràng để thay thế một thành phần nào đó. Độ tin cậy: 0.90
- Giữ cho các controller mỏng (thin) và tuân thủ chuẩn RESTful, thêm các tài nguyên mới như `SessionsController` hoặc `ArchivesController` thay vì tạo các action tùy chỉnh. Độ tin cậy: 0.90
- Đặt logic nghiệp vụ (domain logic) trong các model và các đối tượng Ruby thuần túy (PORO) dưới thư mục `app/models`, và chỉ dùng đến các service object khi một luồng công việc trải rộng qua nhiều model. Độ tin cậy: 0.75
- Sử dụng `concerns` một cách tiết chế và chỉ dành cho những hành vi thực sự được chia sẻ chung, chứ không phải để che giấu một model phình to. Độ tin cậy: 0.75
- Ưu tiên dùng Hotwire với Turbo và Stimulus cho các tính năng tương tác trước khi quyết định thêm một ứng dụng JavaScript SPA tách biệt. Độ tin cậy: 0.85
- Xác thực (validate) dữ liệu trong model và củng cố thêm bằng các ràng buộc cơ sở dữ liệu như `NOT NULL`, chỉ mục duy nhất (unique indexes) và khóa ngoại (foreign keys). Độ tin cậy: 0.95
- Viết các bản di chuyển dữ liệu (migrations) có khả năng đảo ngược (reversible), thêm chỉ mục đồng thời (`concurrently`) trên các bảng lớn, và không bao giờ chỉnh sửa một migration đã chạy trên môi trường production. Độ tin cậy: 0.90
- Giữ các callback cho việc chuẩn hóa dữ liệu đơn giản và chuyển các tác vụ phụ (side effects) như gửi email và gọi API vào các công việc chạy nền (jobs) tường minh. Độ tin cậy: 0.85
- Chạy các tác vụ nền bằng Active Job trên Solid Queue hoặc Sidekiq, và giữ cho mọi job có tính lũy đẳng (idempotent) và an toàn khi thử lại (retry). Độ tin cậy: 0.90
- Truyền ID của bản ghi vào các job thay vì truyền toàn bộ đối tượng, và nạp lại (reload) bản ghi đó bên trong job. Độ tin cậy: 0.85
- Phát hiện các truy vấn N+1 bằng `strict_loading` hoặc gem Bullet, và khắc phục chúng bằng `includes` hoặc `preload`. Độ tin cậy: 0.90
- Sử dụng strong parameters ở mọi nơi và không bao giờ truyền trực tiếp `params` vào hàm `update` hoặc `create`. Độ tin cậy: 0.95
- Lưu trữ thông tin bí mật (secrets) trong chứng chỉ mã hóa (encrypted credentials) hoặc biến môi trường, không bao giờ lưu trong các tệp YAML được commit lên kho mã nguồn. Độ tin cậy: 0.95
- Kiểm thử bằng Minitest hoặc RSpec, tập trung vào kiểm thử model và request, kết hợp với một vài kiểm thử hệ thống (system tests) cho các luồng quan trọng. Độ tin cậy: 0.80
- Sử dụng fixtures hoặc các factory gọn nhẹ, tránh tạo các chuỗi factory lồng nhau quá sâu làm khởi tạo tới nửa cơ sở dữ liệu cho mỗi bài kiểm thử. Độ tin cậy: 0.75
- Kiểm tra quy chuẩn mã nguồn (lint) bằng RuboCop sử dụng cấu hình `rubocop-rails-omakase` hoặc một bộ quy tắc nhỏ đã thống nhất, được thực thi bắt buộc trong CI. Độ tin cậy: 0.80
- Quét các lỗ hổng bảo mật bằng Brakeman và `bundler-audit` trên mỗi pull request. Độ tin cậy: 0.90
- Lưu vào bộ nhớ đệm (cache) các giao diện (views) tốn nhiều tài nguyên bằng kỹ thuật fragment caching và khóa cache dựa trên `updated_at`, sử dụng Solid Cache hoặc Redis. Độ tin cậy: 0.80
- Sử dụng các scope và đối tượng truy vấn (query objects) cho các truy vấn tái sử dụng thay vì viết các chuỗi phương thức dài lặp đi lặp lại khắp các controller. Độ tin cậy: 0.80
- Giữ số lượng gem ít và được bảo trì tốt, đồng thời nâng cấp Rails từng phiên bản phụ (minor version) một sau khi đã sửa hết các cảnh báo ngừng hỗ trợ (deprecation warnings). Độ tin cậy: 0.85
- Triển khai bằng Kamal hoặc một nền tảng được quản lý (managed platform) sử dụng Docker image được đóng gói trong CI, và chạy migrations như một bước phát hành (release step) tách biệt. Độ tin cậy: 0.80
- Sử dụng tính năng mã hóa của Active Record (Active Record encryption) cho các cột dữ liệu nhạy cảm như token và dữ liệu cá nhân. Độ tin cậy: 0.80
Các quy ước mang tính định hướng rõ ràng để xây dựng tiện ích mở rộng (extension) đa trình duyệt bảo mật theo chuẩn Manifest V3 với TypeScript.
# Gu phát triển Tiện ích mở rộng trình duyệt (Browser Extension) của một lập trình viên tiện ích mở rộng đa trình duyệt
- Xây dựng trên nền tảng Manifest V3 và lên kế hoạch xoay quanh các service worker có thể bị dừng bất cứ lúc nào. Độ tin cậy: 0.95
- Sử dụng một framework như WXT hoặc Plasmo kết hợp với TypeScript và Vite để xử lý việc đóng gói (build), tải lại (reload) và tạo tệp manifest đa trình duyệt. Độ tin cậy: 0.80
- Yêu cầu ít quyền (permissions) nhất có thể, và ưu tiên `activeTab` cùng `optional_permissions` thay vì quyền truy cập host diện rộng. Độ tin cậy: 0.95
- Không bao giờ yêu cầu quyền host `all_urls` trừ khi tính năng cốt lõi thực sự cần hoạt động trên mọi trang web. Độ tin cậy: 0.90
- Không lưu giữ trạng thái quan trọng nào trong biến toàn cục (globals) của service worker mà hãy lưu trữ bền vững bằng `chrome.storage`. Độ tin cậy: 0.95
- Sử dụng `chrome.storage.session` cho các thông tin bí mật tạm thời và `chrome.storage.local` hoặc `sync` cho cài đặt người dùng, đi kèm một lớp bọc có định kiểu (typed wrapper) và giá trị mặc định. Độ tin cậy: 0.85
- Sử dụng `chrome.alarms` cho các tác vụ định kỳ thay vì dùng `setInterval` ở chế độ chạy nền (background). Độ tin cậy: 0.90
- Đăng ký tất cả các trình lắng nghe sự kiện (event listeners) ở cấp cao nhất (top level) của service worker để chúng không bị mất khi khởi động lại. Độ tin cậy: 0.90
- Giữ cho các content script nhỏ gọn và nhúng (inject) chúng bằng mã lệnh thông qua `chrome.scripting` bất cứ khi nào có thể. Độ tin cậy: 0.85
- Cô lập giao diện người dùng (UI) được nhúng bên trong một Shadow DOM để CSS của trang web và CSS của tiện ích mở rộng không thể xung đột với nhau. Độ tin cậy: 0.90
- Coi mọi thông điệp (message) gửi từ content script và các trang web là không đáng tin cậy và phải xác thực (validate) chúng bằng một lược đồ (schema). Độ tin cậy: 0.95
- Định nghĩa các kiểu thông điệp (message types) trong một module dùng chung duy nhất và sử dụng các hàm hỗ trợ request/response có định kiểu cho việc truyền thông điệp lúc chạy (runtime messaging). Độ tin cậy: 0.85
- Không bao giờ nhúng mã nguồn từ xa (remote code) hoặc sử dụng `eval`, đồng thời duy trì Chính sách Bảo mật Nội dung (Content Security Policy - CSP) nghiêm ngặt. Độ tin cậy: 0.95
- Sử dụng `declarativeNetRequest` để chặn hoặc sửa đổi các yêu cầu mạng thay vì cố gắng chặn bắt chúng bằng mã lệnh. Độ tin cậy: 0.85
- Sử dụng `webextension-polyfill` hoặc lớp trừu tượng của framework để cùng một mã nguồn có thể chạy được trên Chrome, Firefox, Edge và Safari. Độ tin cậy: 0.80
- Thu thập ít dữ liệu người dùng nhất có thể và giải thích rõ ràng trên trang thông tin cửa hàng (store listing) về những gì được lưu trữ và lý do lưu trữ. Độ tin cậy: 0.90
- Xử lý các sự kiện cài đặt mới (`install`) và cập nhật (`update`) để di chuyển (migrate) các cài đặt đã lưu giữa các phiên bản. Độ tin cậy: 0.85
- Kiểm thử trang popup và trang tùy chọn (options) như giao diện web thông thường, và chạy kiểm thử đầu-cuối (end-to-end) bằng Playwright với tiện ích mở rộng được nạp ở dạng chưa đóng gói (unpacked). Độ tin cậy: 0.80
- Tự động hóa quá trình build, tăng số phiên bản (version bump) và tải lên cửa hàng trong CI, với một gói tệp zip đầu ra riêng cho từng trình duyệt. Độ tin cậy: 0.80
- Giữ cho cửa sổ popup phản hồi nhanh bằng cách tải trễ (lazy load) các dữ liệu nặng và hiển thị trạng thái đã lưu trong bộ nhớ đệm (cached state) trước. Độ tin cậy: 0.80
- Viết một đoạn giải trình quyền truy cập ngắn gọn cho từng quyền trước khi gửi xét duyệt lên cửa hàng. Độ tin cậy: 0.85
Một bộ phim hài đời thường (slice-of-life) Hàn Quốc siêu thực 5 cảnh ở tỷ lệ 16:9: một cô gái trẻ để tóc bob đen ngắn cùng chú mèo mướp xám đội mũ sọc hổ được buộc vào quả bóng bay màu vàng, cùng trải qua một sự cố dở khóc dở cười ở sân chơi, khoảnh khắc giờ vàng ngoài sân khu chung cư và bữa tối hài hước tại nhà, đi kèm chỉ đạo máy quay, tâm trạng và quy tắc giữ tính nhất quán cho nhân vật. Đang thịnh hành trên X, được chia sẻ gốc bởi @AizaAi12: https://x.com/AizaAi12/status/2115273090129400014
Hãy tạo một video ngắn mang phong cách Hàn Quốc siêu thực, đậm chất điện ảnh với nhân vật chính là một phụ nữ trẻ Đông Á để kiểu tóc bob ngắn màu đen có mái thưa, mặc áo hoodie màu nâu sẫm và quần thường ngày. Video kết hợp những khoảnh khắc thú cưng đáng yêu, yếu tố hài hước bất ngờ và cuộc sống đời thường ấm cúng, với vật lý chân thực, nhân vật giàu biểu cảm và kỹ thuật quay phim điện ảnh chuyên nghiệp.

Cảnh 1 – Một Ngày Hài Hước Ở Sân Chơi:
Tại sân chơi của một khu căn hộ chung cư hiện đại, một cô gái trẻ đứng bên cạnh chú mèo mướp xám dễ thương đang đội chiếc mũ thú sọc hổ vô cùng đáng yêu. Một quả bóng bay khí heli lớn màu vàng lơ lửng phía trên chú mèo, tạo nên một tình huống hài hước và bất ngờ. Cô gái cầm chiếc điện thoại thông minh áp gần tai trong khi xoay xở với tình huống đó. Hãy ghi lại những biểu cảm tò mò của chú mèo và phản ứng tự nhiên của cô gái dưới ánh sáng ban ngày dịu nhẹ, chi tiết bộ lông chân thực và độ sâu trường ảnh nông mang tính điện ảnh.

Cảnh 2 – Tai Nạn Bất Ngờ:
Cô gái bước đi gần sân chơi trong khi chú mèo và sợi dây dắt quấn quanh chân cô. Trong một khoảnh khắc bất ngờ và hài hước, cô mất thăng bằng và ngã xuống nền cát mềm. Chú mèo vẫn giữ vẻ bình tĩnh và tò mò đáng ngạc nhiên, tạo nên sự tương phản đầy tính giải trí. Hãy sử dụng các góc máy năng động, chuyển động cơ thể tự nhiên, vật lý chân thực và chuyển cảnh điện ảnh mượt mà.

Cảnh 3 – Cuộc Phiêu Lưu Của Chú Mèo:
Quay cảnh chú mèo mướp đáng yêu đội chiếc mũ hổ tí hon đang dạo bước quanh sân chơi. Quả bóng bay màu vàng và sợi dây dắt tạo nên những khoảnh khắc thị giác vui nhộn. Hãy bắt trọn các góc cận cảnh khuôn mặt, ria mép, bàn chân và bộ lông sọc bông xù của chú mèo. Bao gồm cả các góc quay rộng toàn cảnh sân chơi, các tòa nhà chung cư, ghế dài và cây xanh xung quanh.

Cảnh 4 – Buổi Tối Ấm Cúng:
Chuyển cảnh sang khuôn viên sân chung cư yên bình vào giờ vàng (golden hour) buổi chiều tối. Ánh đèn ấm áp tỏa sáng qua các ô cửa sổ căn hộ khi máy quay ghi lại khoảnh khắc ngoài trời tĩnh lặng với một chú chó nhỏ lông xù đeo dải ruy băng màu xanh dương. Sử dụng hiệu ứng bokeh hậu cảnh mềm mại, chi tiết môi trường tự nhiên và bầu không khí điện ảnh ấm áp.

Cảnh 5 – Bữa Tối Hài Hước Tại Nhà:
Bên trong căn bếp hiện đại ấm cúng với ánh đèn dịu ấm, vẫn cô gái trẻ đó đang ngồi bên chiếc bàn ăn bằng gỗ bày đầy các món cơm nhà kiểu Hàn Quốc, bát cơm và những đĩa thức ăn kèm (banchan) nhỏ. Cô dùng đũa gắp thức ăn trong khi chú mèo nhỏ đáng yêu, vẫn đội chiếc mũ sọc hổ, ngồi ngay cạnh cô trên bàn. Chú mèo có những cử chỉ dễ thương, giàu biểu cảm và chăm chú nhìn đồ ăn đầy tò mò. Cô gái chợt nhận ra một điều gì đó bất ngờ và quay sang nhìn chú mèo với vẻ mặt ngạc nhiên xen lẫn bối rối. Kết thúc bằng một khoảnh khắc hài hước duyên dáng làm nổi bật mối quan hệ tinh nghịch giữa hai cô trò.

Phong cách Hình ảnh: Nhiếp ảnh điện ảnh siêu thực, thẩm mỹ đời thường (slice-of-life) Hàn Quốc, độ phân giải 4K, kết cấu làn da tự nhiên, bộ lông động vật cực kỳ chi tiết, phản ứng gương mặt giàu biểu cảm, ánh sáng chân thực, chuyển động máy quay mượt mà, độ sâu trường ảnh nông, ánh sáng ban ngày dịu nhẹ, tông màu buổi tối ấm áp và chỉnh màu (color grading) chuẩn phim điện ảnh chuyên nghiệp.

Chỉ đạo Máy quay: Kết hợp các góc trung cảnh (medium shots), góc toàn cảnh thiết lập bối cảnh (wide establishing shots), góc máy thấp ngang tầm mắt động vật, góc cận cảnh chi tiết, chuyển động máy quay đi theo (tracking) nhẹ nhàng và chuyển cảnh điện ảnh mượt mà.

Tâm trạng (Mood): Dễ thương, hài hước, ấm áp, hơi hỗn loạn một chút và lành mạnh (wholesome).

Quy tắc Nhất quán Quan trọng: Giữ cho ngoại hình khuôn mặt của cô gái, kiểu tóc bob đen ngắn, tóc mái và bộ trang phục màu nâu nhất quán xuyên suốt video. Duy trì đúng chú mèo mướp xám và chiếc mũ sọc hổ của nó trong mọi cảnh quay mà chú xuất hiện. Đảm bảo giải phẫu động vật chân thực, chuyển động tự nhiên, ngoại hình nhân vật nhất quán và tương tác đáng tin cậy giữa các nhân vật.

Đầu ra: Một bộ phim ngắn điện ảnh chất lượng cao ở tỷ lệ khung hình 16:9, với chuyển động chân thực, môi trường chi tiết, cách kể chuyện giàu biểu cảm và không có hiệu ứng hoạt hình trông giả tạo.
Một bảng tiền kỳ (pre-production board) anime gói gọn trong một hình ảnh duy nhất cho bộ phim ngắn nguyên bản dài 15 giây: bảng thiết kế nhân vật (các góc xoay, biểu cảm, tư thế) của một cô bé cùng chiếc xe đạp màu xanh bạc hà, kết hợp với trang bảng phân cảnh (storyboard) điện ảnh 8 khung hình về chuyến đạp xe mùa hè băng qua những cánh đồng lúa Nhật Bản tới bờ sông và ngắm đoàn tàu đi qua, sẵn sàng để đưa vào mô hình tạo video. Đang thịnh hành trên X, được chia sẻ gốc bởi @HeyAbhishek: https://x.com/HeyAbhishek/status/2115429393967550598
Hãy tạo một bảng phát triển (development board) anime khổ dọc cho bộ phim ngắn nguyên bản dài 15 giây có tựa đề "The Summer Detour".

Đầu ra phải là một hình ảnh tổng hợp duy nhất gồm 2 phần:

Bảng thiết kế nhân vật (Character design sheet)

Trang bảng phân cảnh điện ảnh (Cinematic storyboard page)

PHONG CÁCH:

Anime 2D hoài niệm tuyệt đẹp, phông nền đồng quê vẽ tay, nét vẽ anime sạch sẽ, đổ bóng cel-shading mềm mại, khung cảnh thiên nhiên xanh mướt, ánh nắng chiều hè ấm áp, bóng đổ dịu nhẹ và bầu trời xanh trong với những đám mây trắng xốp.

Bảng sản xuất anime chuyên nghiệp với viền khung storyboard màu đỏ, mũi tên chỉ hướng máy quay màu xanh dương, các ghi chú máy quay viết tay nhỏ gọn và các khung hình chính (keyframes) được minh họa tuyệt đẹp.

PHẦN A: THIẾT KẾ NHÂN VẬT

Cô bé nhân vật chính: Một cô bé người Nhật 13 tuổi nguyên bản với mái tóc nâu sẫm dài ngang vai, đôi mắt nâu dịu dàng và biểu cảm hiền hòa, tươi tắn.

Trang phục: áo kiểu ngắn tay màu kem, chân váy xanh navy bạc màu, tất trắng, giày nâu và một chiếc túi đeo vai nhỏ bằng vải bố (canvas).

Tính cách: điềm tĩnh, tò mò, giàu suy tư và có niềm vui lặng lẽ.

Hiển thị các góc nhìn chính diện, nhìn nghiêng, góc 3/4 và nhìn từ phía sau, cùng với các biểu cảm mỉm cười, trầm tư, thư giãn và ngạc nhiên.

Bao gồm các tư thế đang đạp xe, đang ngồi và đang phóng tầm mắt nhìn về phía chân trời.

XE ĐẠP:

Chiếc xe đạp thành phố cổ điển màu xanh bạc hà (mint-green) với ghi-đông màu bạc, yên xe màu nâu, giỏ lưới sắt nhỏ phía trước và lốp xe màu đen đơn giản. Một chai soda chanh bằng thủy tinh trong suốt nằm gọn gàng bên trong giỏ xe.

Giữ thiết kế của chiếc xe đạp nhất quán trong mọi khung hình.

PHẦN B: BẢNG PHÂN CẢNH (STORYBOARD)

Tạo 8 khung hình storyboard trong một bố cục lưới gọn gàng, mỗi khung hình sử dụng tỷ lệ khung hình điện ảnh 16:9.

Giữ cho cô bé, chiếc xe đạp, khung cảnh đồng quê và ánh sáng nhất quán.

Các nhịp truyện (Story beats):

Cảnh mở đầu góc rộng quay cô bé đang đạp xe dọc theo con đường đồng quê yên bình được bao quanh bởi những cánh đồng lúa xanh.

Cảnh cận tuyệt đẹp quay bánh xe đạp đang lăn bên cạnh đám cỏ đung đưa, ánh nắng lấp lánh xuyên qua các nan hoa.

Cú máy đi ngang (side-tracking shot) khi cô bé đạp xe qua những cánh đồng lúa mênh mông dưới những đám mây mùa hè trắng xốp khổng lồ.

Cô bé đi ngang qua một ngôi nhà truyền thống nhỏ có treo những chiếc chuông gió đang khẽ đung đưa trong làn gió.

Cô bé đến một bờ sông phủ cỏ yên tĩnh, dừng lại và đỗ chiếc xe đạp bên cạnh một cái cây.

Ngồi trên bãi cỏ, cô bé mở chai soda chanh mát lạnh và uống một ngụm sảng khoái.

Một đoàn tàu địa phương nhỏ màu kem và cam đi qua cây cầu phía xa bắc ngang dòng sông. Cô bé ngắm nhìn đoàn tàu với nụ cười dịu dàng.

Cảnh kết góc rộng ngoạn mục: máy quay bay lên cao để lộ ra dòng sông uốn lượn, những cánh đồng xanh bất tận, những ngọn núi xa xôi, đoàn tàu đang đi qua và cô bé đang nghỉ ngơi bên chiếc xe đạp dưới bầu trời mùa hè tráng lệ.

MÔI TRƯỜNG BỐI CẢNH:

Vùng nông thôn Nhật Bản thanh bình, cánh đồng lúa rực rỡ sức sống, những con đường nhựa nhỏ hẹp, nhà gỗ truyền thống, chuông gió, hoa dại, dòng sông nước trong vắt, cây cầu đường sắt cổ kính, những ngọn núi xanh phía xa và những đám mây mùa hè tuyệt đẹp.

Ánh nắng chiều muộn tươi sáng xuyên suốt toàn bộ tác phẩm.

MỤC TIÊU CUỐI CÙNG:

Tạo ra một bảng phát triển phim anime hoài niệm tuyệt đẹp với phong cảnh đồng quê êm dịu, những khoảnh khắc đời thường chân thực, chuyển động điện ảnh tự nhiên, thiết kế nhân vật nhất quán và một cái kết bình yên đẹp đến nghẹt thở.
Một prompt anime vẽ tay dài 15 giây, tỷ lệ 16:9 theo từng cảnh quay (shot-by-shot) giúp chuyển thể bảng phân cảnh (storyboard) 8 khung hình thành hoạt ảnh: một cô bé đạp xe qua những cánh đồng lúa mùa hè, đi ngang qua chiếc chuông gió để tới bờ sông, nhấp ngụm soda chanh và ngắm đoàn tàu địa phương băng qua cầu trước khi máy quay bay lên cao mở ra toàn cảnh, đi kèm thời lượng từng cảnh, thiết kế âm thanh thuần đồng quê, đường cong năng lượng và các quy tắc giữ tính nhất quán. Đang thịnh hành trên X, được chia sẻ gốc bởi @HeyAbhishek: https://x.com/HeyAbhishek/status/2115429393967550598
TIÊU ĐỀ

THE SUMMER DETOUR (LỐI RẼ MÙA HÈ)

Hãy tạo một đoạn hoạt hình anime điện ảnh mang phong cách hoài niệm dài 15 giây ở định dạng ngang 16:9.

THAM CHIẾU

Sử dụng bảng phân cảnh (storyboard) được tải lên làm tài liệu tham chiếu hình ảnh chính. Tuân thủ đúng 8 cảnh quay theo thứ tự.

Giữ cho cô bé, chiếc xe đạp, trang phục, chai soda, cánh đồng lúa, dòng sông, đoàn tàu và ánh nắng mặt trời nhất quán xuyên suốt từ đầu đến cuối.

Không thêm nhân vật mới, không thay đổi bối cảnh bất ngờ hoặc đưa vào các yếu tố kỳ ảo.

CHỦ THỂ

Cô bé: Nhân vật nguyên bản là một cô bé người Nhật 13 tuổi với mái tóc nâu sẫm dài ngang vai, đôi mắt nâu, áo kiểu màu kem, chân váy xanh navy bạc màu, tất trắng, giày nâu và túi đeo vai bằng vải bố (canvas).

Xe đạp: Chiếc xe đạp thành phố cổ điển màu xanh bạc hà (mint-green) với ghi-đông màu bạc, yên xe màu nâu, giỏ lưới sắt phía trước và lốp xe màu đen.

Đạo cụ: Một chai soda chanh bằng thủy tinh trong suốt, ban đầu đặt trong giỏ xe và sau đó được cô bé cầm trên tay.

Đoàn tàu: Đoàn tàu chở khách địa phương nhỏ gồm hai toa mang màu kem và cam.

MÔI TRƯỜNG BỐI CẢNH

Vùng đồng quê Nhật Bản yên bình vào cuối mùa hè. Những con đường nhỏ hẹp, cánh đồng lúa xanh mướt rực rỡ, những ngôi nhà gỗ truyền thống, chuông gió treo dưới hiên, bờ sông phủ cỏ xanh, cây cầu đường sắt phía xa, những ngọn núi xanh rì và những đám mây trắng mùa hè khổng lồ.

Ánh nắng chiều muộn ấm áp với bóng đổ tự nhiên dịu nhẹ. Không có cảnh hoàng hôn hay sự thay đổi ánh sáng kịch tính.

PHONG CÁCH

Anime 2D điện ảnh cao cấp với phông nền vẽ tay tuyệt đẹp, đổ bóng cel-shading mềm mại, nét vẽ sạch sẽ, màu sắc tự nhiên, chuyển động môi trường nhẹ nhàng và diễn xuất nhân vật giàu biểu cảm nhưng tiết chế.

Tạo cảm giác êm đềm, hoài niệm về một buổi chiều hè tuổi thơ bình dị.

Tránh phong cách tả thực như ảnh chụp (photorealism), 3D CGI, ánh sáng neon, hiệu ứng quá đà và chuyển động máy quay nhân tạo.

ÂM THANH

Không có âm nhạc hay lời thoại.

Chỉ sử dụng âm thanh môi trường đồng quê tự nhiên: tiếng ve sầu, tiếng chim hót, gió thổi nhẹ, tiếng bánh xe đạp lăn, tiếng chuông gió, tiếng nước sông chảy, âm thanh từ chai soda và tiếng đoàn tàu chạy qua ở phía xa.

Giữ cho không gian âm thanh dịu dàng, giàu chất thơ và liền mạch.

MÁY QUAY VÀ BỐ CỤC KHUNG HÌNH

Bố cục khung hình điện ảnh 16:9. Các cú máy đi theo chuyển động (tracking shots) mượt mà, những góc cận cảnh gần gũi, chuyển động máy quay chậm rãi và bố cục phong cảnh tuyệt đẹp.

Sử dụng chuyển cảnh tự nhiên và ánh nắng mặt trời nhất quán.

DÒNG THỜI GIAN TỪNG CẢNH QUAY (SHOT-BY-SHOT TIMELINE)

CẢNH 1 (00:00-00:01.5) - CON ĐƯỜNG MÙA HÈ

Góc quay rộng (wide shot) mang tính điện ảnh về một con đường đồng quê yên bình được bao quanh bởi những cánh đồng lúa xanh tốt. Cô bé đạp chiếc xe màu xanh bạc hà chậm rãi hướng về phía những ngọn núi xa. Mái tóc cô bé khẽ bay trong làn gió ấm. Máy quay di chuyển theo (track) mượt mà phía sau lưng cô bé.

SFX: tiếng ve sầu, gió nhẹ, tiếng lốp xe đạp.

CẢNH 2 (00:01.5-00:03) - NHỮNG CHI TIẾT NHỎ BÉ

Góc cận cảnh thấp bên cạnh chiếc xe đạp. Bánh xe quay đều mượt mà khi ánh nắng lấp lánh xuyên qua các nan hoa. Cỏ cao và những bông hoa dại nhỏ xíu đung đưa dọc bên vệ đường. Máy quay đi theo bánh xe đang chuyển động với độ sâu trường ảnh nông (xóa phông nhẹ).

SFX: tiếng lốp xe lăn, tiếng cỏ xào xạc, tiếng côn trùng mùa hè.

CẢNH 3 (00:03-00:05) - CÁNH ĐỒNG RỘNG MỞ

Cú máy đi ngang (side-tracking shot) tuyệt đẹp quay cảnh cô bé đạp xe bên cạnh những cánh đồng lúa xanh bất tận. Những đám mây trắng xốp khổng lồ trôi chậm rãi phía trên những ngọn núi xa. Chân váy và mái tóc cô bé chuyển động tự nhiên trong gió. Ánh nắng rực rỡ tràn ngập khắp khung cảnh.

SFX: tiếng gió thổi qua cánh đồng lúa, tiếng chim hót từ xa, tiếng xích xe đạp.

CẢNH 4 (00:05-00:06.5) - CHIẾC CHUÔNG GIÓ

Cô bé đạp xe đi ngang qua một ngôi nhà gỗ truyền thống nhỏ. Máy quay lướt nhẹ theo chiếc chuông gió bằng thủy tinh treo dưới mái hiên khi nó khẽ đung đưa. Ánh nắng phản chiếu qua lớp thủy tinh trong khi cô bé tiếp tục đạp xe dọc con đường ở hậu cảnh.

SFX: tiếng chuông gió thanh mảnh, tiếng ve sầu, âm thanh xe đạp di chuyển nhẹ nhàng.

CẢNH 5 (00:06.5-00:08.5) - BỜ SÔNG

Góc quay rộng về một bờ sông phủ cỏ yên tĩnh. Cô bé đến nơi, dừng xe đạp bên cạnh một gốc cây râm mát, gạt chân chống xuống và ngồi xuống bãi cỏ. Ánh nắng lấp lánh trên mặt nước sông đang chảy. Máy quay từ từ tiến lại gần hơn.

SFX: tiếng xe đạp dừng lại, tiếng bước chân khẽ khàng, tiếng nước chảy.

CẢNH 6 (00:08.5-00:10) - NGỤM SODA MÙA HÈ

Góc trung cận cảnh (medium close-up) gần gũi. Cô bé lấy chai soda chanh từ giỏ xe đạp, mở nắp và uống một ngụm mát lành khi đang ngồi trên bãi cỏ. Những bọt khí nhỏ li ti sủi tăm qua lớp thủy tinh trong suốt. Cô bé mỉm cười bình yên.

SFX: tiếng mở nắp chai, tiếng sủi bọt nhẹ, làn gió mùa hè.

CẢNH 7 (00:10-00:12) - ĐOÀN TÀU ĐI QUA

Góc quay trung rộng (medium-wide shot) đậm chất điện ảnh từ phía sau vai cô bé. Một đoàn tàu địa phương màu kem và cam chầm chậm lăn bánh qua cây cầu đường sắt phía xa bắc ngang dòng sông. Cô bé lặng lẽ ngắm nhìn khi ánh nắng rực sáng trên những toa tàu đang đi qua.

SFX: tiếng bánh tàu lăn êm ả từ xa, tiếng nước sông, tiếng ve sầu.

CẢNH 8 (00:12-00:15) - KÝ ỨC MÙA HÈ (KHOẢNH KHẮC ĐẶC TRƯNG)

Máy quay từ từ bay lên cao phía trên bờ sông phủ cỏ, mở ra một bức tranh toàn cảnh nhìn từ trên không tuyệt đẹp. Làm lộ diện dòng sông xanh uốn lượn, những cánh đồng lúa xanh bất tận, những ngôi nhà đồng quê nằm rải rác, những ngọn núi xa xôi và đoàn tàu nhỏ vẫn đang tiếp tục lăn bánh qua cầu.

Cô bé giờ đây chỉ còn là một bóng hình nhỏ bé bình yên bên cạnh chiếc xe đạp đang đỗ dưới tán cây.

Bầu trời mùa hè xanh thẳm mênh mông và những đám mây trắng tuyệt đẹp chiếm lĩnh bố cục khung hình cuối cùng.

Chuyển động máy quay chậm dần rồi dừng lại ở một góc toàn cảnh (wide shot) đẹp đến nghẹt thở. Giữ nguyên khung hình cho đến khi kết thúc.

SFX: làn gió đồng quê ấm áp, tiếng đoàn tàu phía xa nhỏ dần rồi tan biến, tiếng ve sầu dịu nhẹ.

ĐƯỜNG CONG NĂNG LƯỢNG (ENERGY ARC)

Hồi 1 (0-5 giây): Tự do. Đạp xe chậm rãi, nắng ấm, khung cảnh mùa hè yên bình.

Hồi 2 (5-10 giây): Tĩnh lặng. Tiếng chuông gió, bờ sông, khoảnh khắc tĩnh mịch bên chai soda mát lạnh.

Hồi 3 (10-15 giây): Hoài niệm. Đoàn tàu đi qua, khung cảnh đồng quê rộng lớn mở ra và cái kết bình yên.

YÊU CẦU CUỐI CÙNG

Duy trì nhất quán tỷ lệ cơ thể nhân vật, trang phục, thiết kế xe đạp, ngoại hình đoàn tàu và địa hình cảnh quan.

Sử dụng chuyển động anime vẽ tay mượt mà, vật lý đạp xe chân thực, hiệu ứng gió thổi nhẹ nhàng và chuyển động mặt nước tự nhiên.

Không có thêm người khác, không nhân bản vật thể, không biến dạng nhân vật (morphing), không nhấp nháy hình ảnh (flickering), không phụ đề, không logo, không lớp phủ văn bản hay hình mờ (watermark).

Video hoàn chỉnh phải mang lại cảm giác như một ký ức đẹp đẽ, êm dịu về một buổi chiều mùa hè.
Giữ cho cây bonsai đầu tiên của bạn sống khỏe và bắt đầu tạo dáng: bản chất thực sự của bonsai là gì, loài cây của bạn thuộc nhóm trồng trong nhà hay ngoài trời, bảng thuật ngữ cho người mới, tưới nước theo cảm nhận độ ẩm thay vì theo lịch cố định, bảng ánh sáng và các mùa kèm cách bảo vệ mùa đông, kiến thức cơ bản về đất, chậu và thay chậu, bón phân, bảng chẩn đoán triệu chứng, cắt tỉa lần đầu an toàn, lịch chăm sóc và kế hoạch 4 tuần đầu tiên.
Hãy đóng vai một Huấn luyện viên Chăm sóc Bonsai cho Người mới bắt đầu. Bạn giúp những người mới hoàn toàn giữ cho cây bonsai đầu tiên của họ sống sót và khỏe mạnh, hiểu được vì sao cây có hình dáng như hiện tại và từ từ bắt đầu tạo dáng cho cây, dựa trên chính loài cây, điều kiện ánh sáng, khí hậu và lịch trình thực tế mà họ có. Bạn suy nghĩ như một người thầy kiên nhẫn tại câu lạc bộ bonsai, người đã chứng kiến rất nhiều cây đầu tay chết vì cùng một vài sai lầm quen thuộc: bạn giải thích những gì cây cần bằng ngôn ngữ giản dị, gắn mọi hướng dẫn với đúng loài cây của tôi, cửa sổ hay ban công nhà tôi, mùa hiện tại và thói quen sinh hoạt của tôi, đồng thời thẳng thắn chia sẻ rằng hầu hết cây của người mới gặp vấn đề là do cách tưới nước, thiếu sáng hoặc đem cây ngoài trời vào trồng trong nhà. Bạn không bao giờ hứa hẹn rằng cây chắc chắn sẽ hồi phục hay đạt được một dáng thế nhất định vào một ngày cụ thể; thay vào đó, bạn dạy tôi cách quan sát và đọc hiểu tình trạng của cây.

Tình huống của tôi:
- Cây của tôi: a small juniper I bought at a garden center, about 25 cm tall, label says "bonsai"
- Chậu và đất trồng: a shallow ceramic pot with one drainage hole, the soil looks dark and compact
- Vị trí đặt cây hiện tại: on my desk by a north-facing window in my apartment
- Không gian ngoài trời tôi có: a small east-facing balcony
- Khí hậu và mùa hiện tại: temperate, cold winters with frost, it is autumn now
- Cách tôi đang tưới nước: a small glass of water every Sunday
- Những biểu hiện tôi nhận thấy: some needles turning brown and dry at the tips
- Dụng cụ tôi có: regular household scissors, a watering can
- Thời gian tôi có thể dành cho cây: a few minutes each morning, more on weekends
- Điều tôi mong muốn: keep it alive first, later learn basic pruning and wiring

Trước tiên, trong một tin nhắn ngắn gọn, hãy hỏi tôi bất kỳ thông tin quan trọng nào còn thiếu: tên loài cây chính xác nếu tôi biết (hoặc mô tả về lá, vỏ cây và thân cây để bạn giúp nhận diện), tôi đã nuôi cây được bao lâu, chậu có thoát nước tốt không, đất có bị ướt sũng suốt nhiều ngày không, mỗi vị trí nhận được bao nhiêu giờ nắng trực tiếp, nhiệt độ thấp nhất vào mùa đông tại nơi tôi sống là bao nhiêu, và trong nhà có thú cưng hay trẻ nhỏ có thể cắn phải lá cây hay không. Sau đó, hãy hướng dẫn tôi qua các phần sau:

1. **Bản chất thực sự của Bonsai là gì (What a Bonsai Really Is)**: lời giải thích ngắn gọn, thân thiện rằng bonsai vốn là một cây gỗ hoặc cây bụi bình thường được giữ cho nhỏ gọn trong chậu nhờ kỹ thuật cắt tỉa và chăm sóc, chứ không phải một giống cây lùn đột biến đặc biệt, và vì sao điều đó có nghĩa là cây vẫn cần ánh sáng, nước, sự thông thoáng và chu kỳ các mùa giống hệt như những cây cùng loài mọc tự nhiên ngoài đời.

2. **Xác định trồng Trong nhà hay Ngoài trời trước tiên (Indoor or Outdoor First)**: dựa trên loài cây của tôi, hãy nói rõ đó là cây ngoài trời (ví dụ: tùng bách/juniper, thông, phong, du) hay là cây có thể chịu được môi trường trong nhà (ví dụ: sanh/si/ficus, ngọc bích/jade, một số loài cây nhiệt đới), giải thích vì sao cây ngoài trời sẽ suy yếu dần khi bị nhốt trong nhà, và chỉ cho tôi vị trí tốt nhất mà tôi thực sự có, kèm theo số giờ chiếu sáng mà cây cần.

3. **Các thuật ngữ Bonsai bạn sẽ gặp (Bonsai Words You Will Meet)**: một bảng thuật ngữ ngắn gọn gồm tên thuật ngữ và giải nghĩa dễ hiểu: nebari (bệ rễ), apex (ngọn cây), branch structure (cấu trúc cành), pinching (ngắt đọt), defoliation (vặt lá), wiring (uốn dây), repotting (thay chậu), root pruning (cắt tỉa rễ), bonsai soil (đất trồng bonsai), akadama, pumice (đá bọt), lava rock (đá nham thạch), dormancy (ngủ đông), jin và shari (lũa cành và lũa thân), và "pre-bonsai" (phôi bonsai).

4. **Tưới nước theo cảm nhận độ ẩm, không tưới theo lịch cố định (Watering by Feel, Not by Calendar)**: cách kiểm tra độ ẩm đất bằng ngón tay hoặc que đũa gỗ, ý nghĩa thực sự của việc "tưới đẫm cho đến khi nước chảy ra khỏi lỗ thoát nước dưới đáy chậu", vì sao việc tưới nhấp môi từng chút một mỗi tuần lại nguy hiểm, lượng nước tưới thay đổi thế nào theo nắng, gió, nhiệt độ và mùa, cùng một thói quen kiểm tra hàng ngày đơn giản phù hợp với buổi sáng của tôi.

5. **Ánh sáng, Độ thông thoáng và Các mùa (Light, Air, and Seasons)**: một bảng gồm các cột: mùa, vị trí nên đặt cây, lượng nắng cần thiết, quy luật tưới nước, hoạt động sinh trưởng của cây trong mùa đó và những dấu hiệu cần lưu ý. Bao gồm cách bảo vệ mùa đông cho các loài cây ngoài trời (che chắn khỏi sương giá khắc nghiệt, gió lùa và tình trạng khô kiệt) cũng như lý do vì sao hầu hết các loài cây ôn đới đều cần một giai đoạn ngủ đông lạnh giá.

6. **Đất trồng, Chậu và Thoát nước (Soil, Pot, and Drainage)**: vì sao đất thịt đóng bao thông thường ở tiệm cây cảnh dễ bị giữ nước lâu ngày và gây thối rễ, giá thể bonsai thoát nước tốt trông như thế nào, khi nào thực sự cần thay chậu (và khi nào chưa cần), cùng mùa thay chậu an toàn cho loài cây của tôi. Đừng khuyên tôi thay chậu ngay lập tức trừ khi có dấu hiệu nguy cấp rõ ràng như rễ đang thối hoặc nước hoàn toàn không thể thoát ra ngoài.

7. **Bón phân (Feeding)**: thời điểm và cách thức bón phân trong mùa sinh trưởng, quy trình bón phân nhẹ nhàng cho người mới bắt đầu, lý do cần ngừng hoặc giảm bón phân khi cây ngủ đông, và vì sao tuyệt đối không bón phân cho cây đang ốm yếu hoặc vừa mới thay chậu.

8. **Đọc hiểu tín hiệu của cây (Reading the Tree)**: một bảng xử lý sự cố gồm các cột: dấu hiệu nhìn thấy, nguyên nhân có khả năng xảy ra, những gì cần kiểm tra, cách xử lý. Bao quát các hiện tượng cháy nâu đầu lá, vàng lá, rụng lá, chồi non vươn dài yếu ớt và nhạt màu, lá bị dính nhớp hoặc có côn trùng nhỏ li ti, đốm trắng xù như bông, đất có mùi chua ủng, gốc cây lung lay, và cây không đâm chồi thức giấc vào mùa xuân. Hãy trung thực khi có những tổn thương không thể phục hồi và mục tiêu lúc đó chỉ là giữ cho phần còn lại của cây được khỏe mạnh.

9. **Cắt tỉa và Tạo dáng lần đầu (First Pruning and Shaping)**: những việc tôi có thể làm an toàn trong năm đầu tiên (ngắt đọt hoặc tỉa gọn chồi mới để giữ phom dáng, cắt bỏ cành khô chết), những kỹ thuật nên chờ thêm (cắt tỉa mạnh tay, uốn dây kẽm, xử lý rễ), những dụng cụ nào đáng mua trước tiên (một chiếc kéo tỉa bonsai sắc bén, kìm cạp xéo/concave cutter có thể mua sau), và cách bấm một vết cắt gọn sạch. Nếu tôi muốn thử uốn dây sau này, hãy giải thích nguyên tắc cơ bản và nguy cơ dây ăn lằn vào vỏ cây (wire scarring).

10. **Lịch chăm sóc đơn giản (A Simple Care Calendar)**: danh sách theo từng tháng dành riêng cho loài cây và khí hậu nơi tôi ở, mỗi tháng nêu một hoặc hai công việc trọng tâm.

11. **Kế hoạch 4 tuần đầu tiên (A First 4-Week Plan)**: theo từng tuần: những gì cần thay đổi ngay bây giờ (vị trí đặt cây, phương pháp tưới nước), những gì cần quan sát và ghi chép vào sổ nhật ký cây đơn giản (chụp ảnh, độ ẩm đất, chồi mới), và một kỹ năng nhỏ để thực hành mỗi tuần.

Quy tắc: luôn gắn liền lời khuyên với loài cây, điều kiện ánh sáng, khí hậu và mùa của tôi; không bao giờ đưa ra lịch tưới cố định làm quy tắc chính mà phải hướng dẫn cách kiểm tra đất; không khuyến nghị cắt tỉa nặng, cắt rễ hay thay chậu trái mùa hoặc trên cây đang suy yếu; cảnh báo rằng một số loài bonsai phổ biến (ví dụ: ngọc bích/jade, sanh/si/ficus, đỗ quyên/azalea, vạn tuế/sago palm - vốn không phải cây bonsai thực thụ) có thể gây ngộ độc cho thú cưng hoặc gây kích ứng da, và nhắc tôi kiểm tra kỹ loài cây của mình; không dùng thuốc trừ sâu hóa học làm bước đầu tiên mà hãy bắt đầu bằng việc kiểm tra thủ công và các biện pháp sinh học nhẹ nhàng; sử dụng ngôn ngữ bình dân, đoạn văn ngắn và bảng biểu ở những chỗ giúp dễ theo dõi. Kết thúc bằng việc chỉ rõ chính xác những gì tôi nên làm ngay hôm nay cho cây của mình trong ba đến năm bước ngắn gọn.

