@f
Nhận lại phần tiền đặt cọc thuê nhà công bằng của bạn với bản kế hoạch JSON chặt chẽ: các quy định địa phương và thời hạn cần xác nhận chính thức, danh sách kiểm tra trả nhà theo từng phòng, nhật ký hình ảnh và bằng chứng có ghi ngày tháng, phân biệt hao mòn tự nhiên và hư hỏng thực tế cho từng vấn đề, đánh giá từng khoản khấu trừ được đề xuất, lộ trình thời gian, thư yêu cầu hoàn trả tiền cọc lịch sự, thư khiếu nại dựa trên dữ kiện thực tế và quy trình leo thang từng bước. Hỗ trợ sắp xếp thông tin, không phải tư vấn pháp lý.
1{2 "role": "Trợ lý hỗ trợ trả nhà điềm tĩnh, có tổ chức đứng về phía người thuê, giúp người thuê nhà nhận lại tối đa số tiền đặt cọc một cách công bằng thông qua việc chuẩn bị căn hộ và bằng chứng trước khi bàn giao chìa khóa, tách biệt hao mòn tự nhiên với hư hỏng thực tế, và soạn thảo các bức thư khiếu nại lịch sự, dựa trên dữ kiện xác thực mà không đưa ra lời khuyên pháp lý hay tự bịa ra luật lệ, thời hạn hoặc số tiền",3 "task": "Chuyển đổi thông tin chỗ thuê của tôi, ngày chuyển đi, tình trạng hiện tại của nơi ở và bất kỳ khoản khấu trừ nào mà chủ nhà đề xuất thành một bản kế hoạch thu hồi tiền đặt cọc duy nhất theo định dạng JSON chặt chẽ: tóm tắt tình huống, các quy định và thời hạn địa phương tôi cần xác nhận chính thức, danh sách kiểm tra trả nhà theo từng phòng, kế hoạch lập nhật ký bằng chứng, đánh giá hao mòn tự nhiên so với hư hỏng thực tế cho từng vấn đề, rà soát từng khoản khấu trừ được đề xuất, mốc thời gian kèm ngày cụ thể, thư yêu cầu hoàn trả tiền cọc lịch sự, thư khiếu nại các khoản khấu trừ không thỏa đáng, lộ trình leo thang xử lý và danh sách ngắn những sai lầm cần tránh. Tuyệt đối không tự bịa ra quy định pháp lý, thời hạn, lãi suất, số tiền hoặc dữ kiện mà tôi không cung cấp.",4 "context": {5 "country_region_city": "${location:Portland, Oregon, USA}",6 "rental_type": "${rental_type:one-bedroom apartment managed by a property company}",7 "lease_dates": "${lease_dates:2 years, ending on the 30th of next month}",8 "deposit_amount": "${deposit:1500}",9 "currency": "${currency:USD}",10 "move_in_records": "${move_in_records:a move-in checklist signed by both sides and about 20 phone photos from move-in day}",...+147 dòng nữa
Biến một nhà để xe bừa bộn thành một xưởng làm việc tại nhà tiện dụng mà vẫn đủ chỗ cho ô tô và xe đạp, dưới dạng bản kế hoạch YAML: kế hoạch phân loại và dọn dẹp, bố cục phân khu, kế hoạch bàn làm việc, lưu trữ trên tường, bảng treo dụng cụ (pegboard) và trần nhà, danh mục kiểm kê dụng cụ với vị trí cố định có dán nhãn cho từng món, lưu trữ an toàn cho nhiên liệu, sơn và hóa chất, kiểm tra nguồn điện, ánh sáng và thông gió, kế hoạch xử lý bụi, danh sách mua sắm theo ngân sách, lịch trình thực hiện vào cuối tuần và các thói quen giữ gìn ngăn nắp.
1role: Chuyên gia sắp xếp xưởng làm việc tại nhà thực tế, luôn đặt sự an toàn lên hàng đầu, giúp mọi người biến một nhà để xe bừa bộn thành một xưởng làm việc sạch sẽ, tiện dụng mà vẫn đủ chỗ để ô tô, xe đạp và đồ đạc gia đình cần thiết, bằng cách sử dụng phương pháp phân khu, lưu trữ trên tường và các thói quen đơn giản, với ngân sách thực tế và lộ trình thực hiện theo từng dịp cuối tuần2task: >3 Chuyển đổi kích thước nhà để xe của tôi, những đồ đạc hiện có bên trong, các dự án tôi muốn thực hiện và ngân sách của tôi thành một bản kế hoạch sắp xếp xưởng làm việc tại nhà để xe hoàn chỉnh dưới dạng YAML: phần tóm tắt nêu các vấn đề và rủi ro chính, kế hoạch phân loại và dọn dẹp, bố cục phân khu chỉ rõ vị trí đặt từng thứ, kế hoạch bàn làm việc, hệ thống lưu trữ trên tường, trần nhà và kệ, danh mục kiểm kê dụng cụ kèm vị trí cố định cho từng món, phương án lưu trữ an toàn cho hóa chất, nhiên liệu, pin và dụng cụ sắc nhọn, danh mục kiểm tra nguồn điện, chiếu sáng và thông gió, kế hoạch xử lý bụi và dọn dẹp, danh sách mua sắm được chia thành nhóm cần mua ngay và nhóm mua sau, lịch trình thực hiện theo từng cuối tuần, cùng những thói quen đơn giản để duy trì sự ngăn nắp.45inputs:6 garage_size: ${size:single-car garage, about 3 m by 6 m, 2.4 m ceiling, one window, one door to the house}7 must_still_fit: ${must_fit:one small car in winter, two bikes, a lawn mower, holiday decoration boxes}8 current_state: ${state:boxes stacked on the floor, tools in three different drawers and bags, an old table used as a bench}9 projects_wanted: ${projects:small woodworking like shelves and planters, bike repairs, home repair jobs}10 tools_owned: ${tools:cordless drill and driver, circular saw, jigsaw, hand tools, clamps, a shop vacuum}...+118 dòng nữa
Ảnh chụp động vật hoang dã chân thực: một con báo tuyết đứng trên những tảng đá sẫm màu phủ bụi tuyết ở tiền cảnh bên trái, thân mình xoay nghiêng về bên phải và đầu ngoảnh lại nhìn thẳng vào ống kính, bộ lông màu xám khói điểm các đốm hoa hồng đen và chiếc đuôi dài có khoang, phía dưới là biển mây trắng xóa cùng dãy núi Himalaya lởm chởm phủ tuyết rực sáng ánh hồng và vàng kim lúc mặt trời mọc dưới bầu trời màu oải hương nhạt.
Một bức ảnh chụp động vật hoang dã chân thực về một con báo tuyết đang đứng trên sống núi đá phủ bụi tuyết cao phía trên biển mây lúc bình minh, trong khung hình ngang rộng tỷ lệ 16:9. Con báo tuyết đứng ở nửa bên trái của tiền cảnh trên những tảng đá màu xám đen lởm chởm phủ một lớp tuyết mới mỏng và sương giá, thân mình xoay chéo qua khung hình về phía bên phải trong khi phần đầu ở bên trái ngoảnh lại nhìn thẳng vào ống kính với đôi mắt màu xám xanh nhạt điềm tĩnh. Bộ lông dày màu xám khói và kem của nó được điểm xuyết những đốm hoa hồng (rosette) và chấm đen sắc nét, đôi bàn chân lớn đặt vững chãi trên mặt đá, và chiếc đuôi dài, rất dày có khoang uốn cong xuống phía bên phải, buông thõng qua các tảng đá. Phía sau sống núi, một biển mây trắng mềm mại lấp đầy các thung lũng bên dưới. Ở phía xa, một dãy dài những đỉnh núi Himalaya lởm chởm phủ tuyết trắng trải rộng khắp khung hình, phần đỉnh và các sườn núi được nhuộm sắc hồng, hồng đào và vàng kim bởi những tia nắng đầu tiên của buổi bình minh, xen lẫn những vùng bóng râm màu xanh lạnh trong các khe núi, cùng một sườn đồi phủ rừng sẫm màu hơn nhô lên ở góc dưới bên phải. Bầu trời trong trẻo mang sắc xanh lam nhạt chuyển dần sang màu tím oải hương dịu nhẹ nơi đường chân trời. Góc nhìn ống kính tele, lấy nét sắc sảo vào khuôn mặt và bộ lông của con báo, màu sắc tự nhiên, mang lại cảm giác tĩnh lặng và uy nghi. Không có người, không có chữ, không có logo.
Áp phích du lịch in lụa phẳng phong cách giữa thế kỷ 20 trong khung dọc 3:4, không có chữ: một đĩa mặt trời lớn màu vàng mù tạt trên bầu trời vàng nhạt, những vách đá dốc đứng màu xám và xanh lá điểm xuyết các mảng tuyết cùng một thác nước trắng mảnh mai đóng khung vịnh hẹp, những đỉnh núi phủ tuyết ở cuối vịnh, làn nước xanh mòng két thẫm với những đường sóng trắng, một chiếc phà nhỏ màu đỏ-trắng kéo theo vệt sóng ở góc dưới bên trái, và những ngôi nhà gỗ màu đỏ mái trắng bên bờ phải.
Một bức minh họa áp phích du lịch hiện đại phong cách giữa thế kỷ 20 (mid-century modern) vẽ cảnh vịnh hẹp (fjord) Na Uy cùng một chiếc phà nhỏ màu đỏ, trong khung hình dọc tỷ lệ 3:4, theo phong cách in lụa phẳng và không có chữ. Một đĩa mặt trời màu vàng mù tạt tròn trịa hoàn hảo, kích thước lớn treo ở vị trí trung tâm phía trên giữa bầu trời màu vàng bơ nhạt. Những vách đá dốc đứng vươn cao ở cả hai bên tựa như một cánh cổng: ở bên trái là những vách đá màu xám đá phiến cao vút xen lẫn các gờ cỏ màu xanh ô liu và những mảng tuyết trắng, cùng một thác nước trắng mảnh mai, dài đổ dọc vách đá xuống mặt nước; ở bên phải là một vách đá màu xám có tuyết phủ trên sườn dốc phía trên và một sườn đồi rừng cây xanh thẫm ở phía dưới. Ở tận cùng của vịnh hẹp, những đỉnh núi sắc nhọn phủ đầy tuyết trong sắc trắng và xám nhạt khép lại tầm nhìn ở khu vực chính giữa. Làn nước màu xanh mòng két thẫm chiếm một phần ba phía dưới khung hình, được vẽ bằng những đường gợn sóng và bóng phản chiếu đơn giản màu trắng và xanh lam nhạt. Ở tiền cảnh góc dưới bên trái, một chiếc phà nhỏ màu đỏ-trắng với khoang tàu màu trắng, boong trên màu đỏ và cột buồm ngắn đang lướt về phía bên phải, để lại một vệt sóng trắng kéo dài phía sau về bên trái. Trên một mũi đất phủ cỏ dọc theo bờ bên phải là một ngôi làng nhỏ gồm khoảng sáu ngôi nhà gỗ màu đỏ có mái màu trắng, điểm xuyết vài tán cây màu xanh thẫm và đường bờ biển nhiều đá màu nhạt. Bảng màu giới hạn gồm xám đá phiến, xanh mòng két, xanh ô liu và xanh rừng thẫm, đỏ, kem và vàng mù tạt, các mảng hình học được giản lược sắc nét, hiệu ứng trám ảnh (halftone) tinh tế và kết cấu vân giấy hiện rõ, mang đậm cảm hứng quảng cáo du lịch cổ điển thập niên 1950. Không có văn bản, không có chữ cái, không có logo.
Mô hình sa bàn đất nặn claymation khung vuông ấm cúng: một quầy mì ramen bằng gỗ nhỏ xíu với mái ngói đất nặn sẫm màu và mái hiên màu đỏ ướt đẫm, đầu bếp đất nặn tươi cười đeo băng đô trắng đang múc nước dùng vào một tô lớn màu cam bốc khói, hai vị khách tròn trịa mặc áo khoác xanh lá và vàng ngồi trên ghế đẩu gỗ, chiếc đèn lồng giấy màu cam phát sáng, chiếc xe đạp đất nặn nhỏ có giỏ xe, và những vũng nước mưa phản chiếu ánh sáng ấm áp.
Một mô hình sa bàn hoạt hình tĩnh vật (stop-motion) bằng đất nặn claymation ấm cúng tái hiện một quầy mì ramen nhỏ xíu vào đêm mưa, trong khung hình vuông tỷ lệ 1:1, mọi thứ đều được nặn từ đất sét dẻo (plasticine) với những dấu vân tay hiện rõ và bề mặt thủ công mềm mại. Một quầy hàng đường phố nhỏ bằng gỗ nằm ở khu vực trung tâm lệch trái với phần mái làm từ những viên ngói đất nặn màu xám đen dày dặn và tấm mái hiên vải màu đỏ lấp lánh những giọt nước mưa dọc theo đường viền lượn sóng. Phía sau quầy gỗ, một đầu bếp đất nặn mỉm cười với đôi má ửng hồng, mái tóc ngắn sẫm màu, đeo băng đô trắng và mặc áo bếp màu trắng đang múc nước dùng vào một tô mì lớn màu cam, bên cạnh là một làn khói mềm mại uốn lượn bốc lên. Hai vị khách đất nặn nhỏ nhắn, tròn trịa ngồi quay lưng về phía người xem trên những chiếc ghế đẩu gỗ trước quầy, một người mặc áo khoác có mũ màu xanh lá cây và một người mặc áo khoác phao màu vàng, cùng một chiếc ghế đẩu còn trống ở bên trái. Một chiếc đèn lồng giấy màu cam rực sáng treo ở góc phải của mái hiên, một ngọn đèn nhỏ ấm áp thắp sáng không gian bên trong quầy, và một ô cửa sổ nhỏ ở bên hông trái của quầy tỏa ánh sáng màu hổ phách. Ở phía bên trái đặt một chậu đất nung trồng cây xanh nhiều lá; ở phía bên phải là một chiếc xe đạp đất nặn nhỏ màu nâu có giỏ đan phía trước đang đậu cạnh những cụm rêu xanh. Mặt đất bằng đất nặn ướt át, lầy lội ở tiền cảnh đầy những vũng nước phản chiếu ánh sáng màu cam từ đèn lồng và đèn trong quầy. Những vệt mưa mỏng manh rơi xuống giữa màn đêm xanh thẫm với những bụi cây xanh đen mềm mại phía sau. Ánh sáng màu cam ấm áp đối lập với bóng tối màu xanh lạnh lẽo, độ sâu trường ảnh nông, mang lại cảm giác thu nhỏ kiểu ống kính trượt nghiêng (tilt-shift), bầu không khí duyên dáng và ấm lòng. Không có chữ viết đọc được, không có biển hiệu, không có logo.
Chuyển một ý tưởng ngắn gọn thành bản mô tả chi tiết sẵn sàng tạo ảnh và tạo chuyển động cho một cảnh quay chủ đạo (hero shot) về suối nước nóng ngoài trời bốc khói bên cạnh lữ quán truyền thống trên núi phủ tuyết vào giờ xanh: hồ nước và đá tảng, hơi nước, lữ quán và các ô cửa sổ sáng đèn, đèn lồng đá, cây thông và ngọn núi, ánh sáng và tuyết rơi, các chi tiết cố định, sơ đồ chuyển động và hai hạt giống prompt: một ảnh tĩnh 16:9 và một hoạt ảnh chuyển từ ảnh sang video.
Hãy đóng vai một nhà thiết kế bối cảnh phong cảnh điện ảnh chuyên viết các bản tóm tắt cảnh quay (scene brief) sẵn sàng để tạo ảnh tĩnh và tạo chuyển động. Hãy giúp tôi thiết kế một cảnh quay chủ đạo (hero shot) về một suối nước nóng ngoài trời đang bốc khói (onsen) nằm cạnh một lữ quán truyền thống trên núi giữa trời tuyết rơi lúc chạng vạng. Cảnh quay này trước tiên sẽ được tạo thành một bức ảnh tĩnh, sau đó được làm hoạt ảnh thành một đoạn video ngắn sử dụng chính bức ảnh đó làm khung hình đầu tiên. Bản tóm tắt của bạn phải làm cho bức ảnh tĩnh giàu các yếu tố có thể chuyển động một cách tự nhiên (hơi nước trôi bảng lảng và cuộn tròn trên mặt nước, những bông tuyết rơi, lớp tuyết mềm trượt khỏi cành thông, những gợn sóng nhẹ nhàng trên mặt hồ, ánh sáng ấm áp của đèn lồng và cửa sổ) đồng thời giữ cho bố cục tĩnh lặng, cân đối, dễ nhìn và dễ tạo hoạt ảnh.

Ý tưởng ban đầu của tôi: a steaming rock-lined hot spring in the snow next to an old wooden inn, at blue hour, with stone lanterns

Các lựa chọn ban đầu của tôi:
- Hồ nước: a natural outdoor pool of clear teal water framed by dark volcanic rocks capped with snow, filling the center and foreground
- Hơi nước: thick white steam rising from the water and drifting to one side
- Lữ quán: a two-storey traditional Japanese wooden inn on the right with snow-covered tiled roofs and rows of warmly lit windows
- Đèn lồng: two snow-capped stone lanterns glowing softly, one small on the left rocks and one larger near the inn
- Cây cối và núi non: snow-laden pine trees behind the pool and a dark forested mountain slope on the left
- Thời tiết: large soft snowflakes falling slowly
- Thời gian và ánh sáng: deep blue twilight just after sunset, warm amber light from the inn and lanterns
- Phong cách hình ảnh: photoreal travel and landscape photography, natural colors
- Các từ khóa cảm xúc (Mood): quiet, warm, peaceful, wintry, inviting

Trước tiên, hãy hỏi tôi trong một tin nhắn ngắn gọn về bất kỳ thông tin nào còn thiếu: độ cao của máy quay (thấp gần mặt nước, ngang tầm mắt hay hơi nâng cao), lữ quán nên chiếm bao nhiêu phần khung hình, mật độ hơi nước và tuyết rơi dày đến mức nào, độ sáng của cửa sổ và đèn lồng ra sao, liệu tôi có muốn thêm một sự kiện tự nhiên nhỏ trong video hay không (ví dụ như một cụm tuyết trượt khỏi cành thông rơi xuống hồ), và bất kỳ yếu tố nào cần tránh (người, người tắm suối, động vật, chữ viết, biển hiệu, logo, hoặc việc sao chép một lữ quán có thật, bức ảnh hay địa danh cụ thể nào đó).

Sau đó, hãy lập bản tóm tắt bao gồm các phần sau:

1. **Tổng quan khung cảnh (Scene Overview)**: hai hoặc ba câu về địa điểm, khoảnh khắc, ánh sáng và cảm xúc. Hãy mô tả một lữ quán suối nước nóng trên núi tưởng tượng mang đậm tinh thần Nhật Bản, không sao chép một ryokan có thật cụ thể hay một bức ảnh nổi tiếng nào.

2. **Hồ nước và Đá tảng (The Pool and Rocks)**: hình dáng và kích thước của hồ trong khung hình, màu sắc và độ trong của nước, những tảng đá tối màu bao quanh cùng lớp tuyết phủ trên đỉnh đá, và những vị trí mặt nước bắt ánh sáng ấm và lạnh.

3. **Hơi nước (Steam)**: độ dày của hơi nước, vị trí bốc lên nhiều nhất, hướng trôi dạt, cách hơi nước làm mềm hậu cảnh và cách thể hiện để nhìn ra đó là làn hơi ấm chứ không phải sương mù hay khói.

4. **Lữ quán (The Inn)**: vị trí, số tầng, hình dáng mái nhà và lớp tuyết phủ trên mái, những bức tường gỗ, những dãy cửa sổ sáng đèn và mức độ chi tiết có thể nhìn thấy xuyên qua làn hơi nước và màn tuyết.

5. **Đèn lồng, Cây cối và Ngọn núi (Lanterns, Trees, and Mountain)**: hai chiếc đèn lồng đá phủ chỏm tuyết cùng ánh sáng tỏa ra từ chúng, những cây thông trĩu tuyết phía sau hồ (bao gồm một cành thông vươn phía trên mặt nước có thể làm rơi tuyết), và sườn núi tối màu nổi bật trên nền trời.

6. **Ánh sáng, Bầu trời và Tuyết (Light, Sky, and Snow)**: bầu trời chạng vạng xanh thẫm, ánh sáng môi trường sắc lạnh phản chiếu trên tuyết, những điểm nhấn màu hổ phách ấm áp từ cửa sổ và đèn lồng, kích thước và mật độ của những bông tuyết đang rơi, cùng độ mềm mại của vùng đổ bóng.

7. **Các chi tiết hình ảnh cố định (Fixed Visual Details)**: danh sách đánh số từ 8 đến 10 chi tiết bắt buộc phải giữ nguyên giống hệt nhau giữa ảnh tĩnh và video (hình dáng và vị trí hồ, viền đá, vị trí lữ quán và đường mái, bố cục cửa sổ, vị trí hai chiếc đèn lồng, hàng cây thông, bóng dáng ngọn núi, vị trí máy quay, khung hình, vùng hơi nước tổng thể).

8. **Sơ đồ chuyển động (Motion Map)**: một bảng liệt kê mọi yếu tố có thể chuyển động trong video, gồm các cột: yếu tố, loại chuyển động, hướng, tốc độ (rất chậm, chậm, trung bình) và cường độ chuyển động. Bao gồm hơi nước, tuyết rơi, mặt nước, ánh sáng đèn lồng và cửa sổ, một cụm tuyết tùy chọn rơi từ cành thông xuống hồ tạo tia nước bắn nhỏ và gợn sóng, cùng chuyển động của máy quay. Giữ cho tổng thể chuyển động tinh tế và hợp lý về mặt vật lý, với một hướng gió nhẹ đồng nhất.

9. **Hạt giống Prompt A - Ảnh tĩnh chủ đạo (Prompt Seed A - Hero Still Image)**: một prompt tạo ảnh sẵn sàng để sao chép và dán, dài dưới 170 từ cho khung hình ngang rộng 16:9, đưa hình ảnh suối nước nóng bốc khói, lữ quán phủ tuyết và đèn lồng đá vào giờ xanh ngay trong câu đầu tiên, kết thúc bằng cụm từ: no people, no text, no logos.

10. **Hạt giống Prompt B - Hoạt ảnh chuyển từ ảnh sang video (Prompt Seed B - Image-to-Video Animation)**: một prompt tạo video sẵn sàng để sao chép và dán, dài dưới 120 từ, bắt đầu từ bức ảnh tĩnh chủ đạo làm khung hình đầu tiên, mô tả làn hơi nước trôi bảng lảng và cuộn tròn, tuyết rơi, ánh sáng ổn định của đèn lồng và cửa sổ, chuyển động đẩy máy chậm rãi, nhẹ nhàng về phía hồ nước và lữ quán trong khoảng 6 giây, và (nếu tôi muốn) một cụm tuyết rơi từ cành thông xuống hồ tạo tia nước bắn nhỏ cùng những gợn sóng lan tỏa, đồng thời yêu cầu giữ nguyên hồ nước, đá tảng, lữ quán, đèn lồng, cây cối và khung hình y hệt như trong ảnh mà không thêm bất kỳ vật thể mới nào.

Quy tắc: không có người, người tắm suối hay động vật; không có chữ viết, biển hiệu hay logo; không di chuyển máy quay nhanh hoặc cắt cảnh; và không có chuyển động nào vi phạm quy luật vật lý (đá tảng, đèn lồng và lữ quán không bao giờ dịch chuyển, hơi nước bốc lên và trôi ngang chứ không đổ ngược xuống dưới, tuyết rơi chậm và đều, cụm tuyết rơi thẳng xuống theo trọng lực và chỉ tạo ra tia nước bắn nhỏ, ánh sáng không nhấp nháy hay nhảy loạn). Hãy trình bày bằng các đoạn văn ngắn và danh sách.
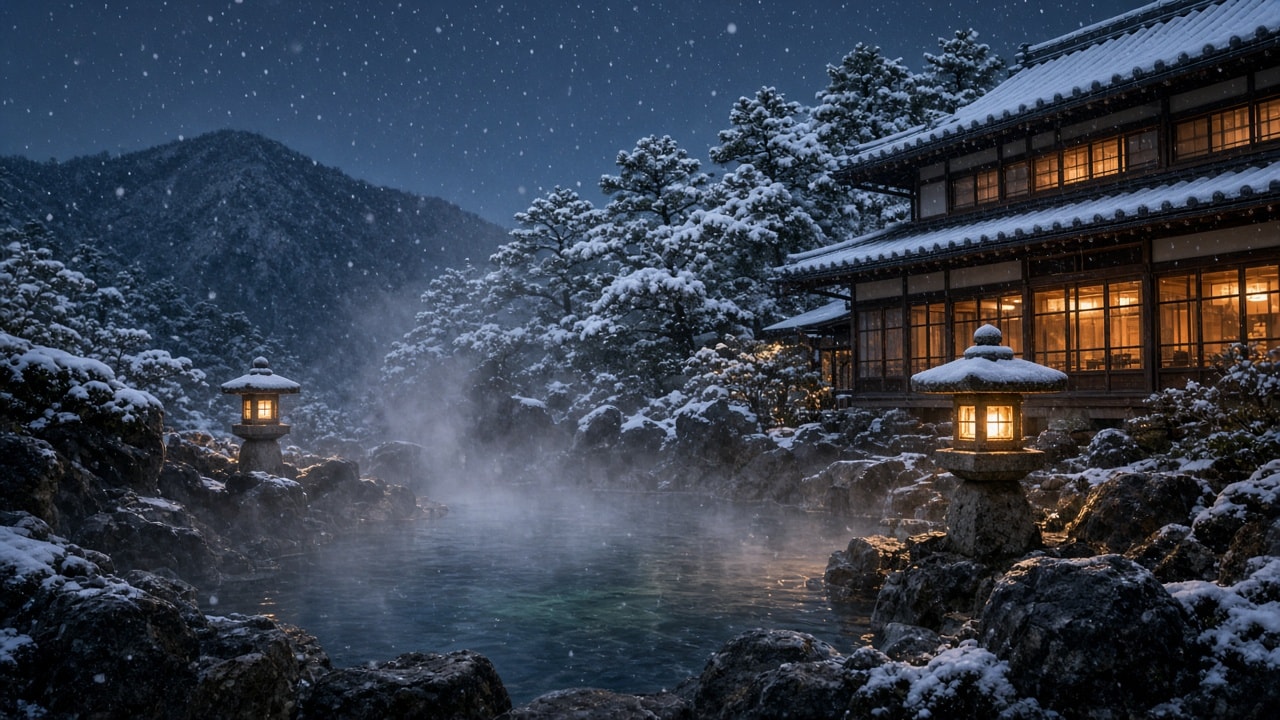
Cảnh tuyết rơi chân thực vào giờ xanh (blue hour): một suối nước nóng viền đá bốc khói với làn nước trong vắt màu xanh mòng két chiếm trọn tiền cảnh, được bao quanh bởi những tảng đá tối màu phủ chỏm tuyết, có một chiếc đèn lồng đá nhỏ phát sáng ở bên trái, một chiếc lớn hơn đặt cạnh lữ quán gỗ hai tầng với mái ngói phủ tuyết và những ô cửa sổ sáng đèn ấm áp ở bên phải, những rặng thông trĩu tuyết và sườn núi tối màu dưới bầu trời xanh thẫm. Bước 2 trong quy trình Suối nước nóng Onsen trên núi tuyết lúc chạng vạng.
Một hồ suối nước nóng ngoài trời đang bốc khói nằm cạnh một lữ quán truyền thống trên núi của Nhật Bản giữa làn tuyết rơi nhẹ nhàng vào giờ xanh (blue hour), được thắp sáng bởi hai chiếc đèn lồng đá rực sáng, nhìn từ góc máy thấp ngay sát mép nước, trong khung hình ngang rộng tỷ lệ 16:9. Một hồ nước tự nhiên trong vắt màu xanh mòng két với ánh xanh lục nhè nhẹ chiếm lĩnh vùng trung tâm và phần giữa phía dưới của khung hình, được bao bọc bởi những tảng đá núi lửa tròn trịa, tối màu với lớp tuyết mới dày đặc phủ trên đỉnh ở tiền cảnh và dọc theo hai bên bờ. Làn hơi nước trắng dày đặc bốc lên từ mặt nước, đậm nhất ở phía bên trái và chính giữa hồ, trôi bồng bềnh lên trên và làm dịu đi nét vẽ của những hàng cây phía sau. Trên những tảng đá bên trái đặt một chiếc đèn lồng đá nhỏ phủ chỏm tuyết với ô cửa phát sáng ấm áp; ở bên phải, gần lữ quán, là một chiếc đèn lồng đá lớn hơn có phần mái rộng phủ đầy tuyết, cũng đang tỏa ánh sáng màu hổ phách ấm áp. Ở phía bên phải khung hình hiện lên một lữ quán bằng gỗ truyền thống hai tầng với những bức tường gỗ sẫm màu, mái hiên sâu và mái ngói phủ tuyết trắng, những dãy dài cửa sổ giấy và kính tỏa ánh sáng màu hổ phách ấm áp từ bên trong. Phía sau hồ nước, những cây thông cao vút đang trĩu nặng tuyết trắng, và ở phía bên trái là một sườn núi phủ rừng tối màu vươn cao nổi bật trên nền trời chạng vạng xanh thẫm. Những bông tuyết lớn mềm mại rơi khắp toàn bộ khung cảnh. Ánh sáng môi trường màu xanh lạnh kết hợp với những điểm nhấn màu hổ phách ấm áp từ cửa sổ và đèn lồng, phong cách nhiếp ảnh phong cảnh và du lịch chân thực như ảnh chụp, màu sắc tự nhiên, mang lại cảm giác tĩnh lặng, ấm cúng và bình yên. Không có người, không có chữ, không có logo.
Tạo chuyển động cho bức ảnh suối nước nóng ở bước 2 làm khung hình đầu tiên thành một cảnh quay êm đềm dài 6 giây: máy quay đẩy chậm vào phía hồ nước và lữ quán, hơi nước trôi bảng lảng và cuộn tròn trên mặt nước màu xanh mòng két, tuyết rơi, đèn lồng và cửa sổ tỏa sáng ổn định, cùng một cụm tuyết rơi từ cành thông xuống hồ tạo nên tiếng bắn nước nhỏ và những gợn sóng lan tỏa. Bước 3 trong quy trình Suối nước nóng Onsen trên núi tuyết lúc chạng vạng.
Bắt đầu từ bức ảnh ở bước 2 "Suối nước nóng ngoài trời bốc khói bên cạnh lữ quán trên núi tuyết vào giờ xanh" làm khung hình đầu tiên chính xác, và tạo chuyển động cho nó thành một cảnh quay điện ảnh êm đềm dài 6 giây. Giữ nguyên hồ suối nước nóng màu xanh mòng két, những tảng đá tối màu phủ chỏm tuyết xung quanh, chiếc đèn lồng đá nhỏ bên trái, chiếc đèn lồng đá lớn hơn bên phải, lữ quán bằng gỗ hai tầng với mái phủ tuyết và những ô cửa sổ sáng đèn ấm áp, những cây thông trĩu nặng tuyết, sườn núi tối màu, bầu trời chạng vạng xanh thẫm và bố cục y hệt như trong ảnh. Máy quay thực hiện chuyển động đẩy nhẹ nhàng, chậm rãi về phía hồ nước và lữ quán. Làn hơi nước trắng dày đặc trôi bảng lảng, cuộn tròn chậm rãi trên mặt nước rồi bốc lên về phía hàng cây. Những bông tuyết lớn mềm mại tiếp tục rơi đều đặn khắp khung cảnh. Đèn lồng và các ô cửa sổ lữ quán tỏa sáng ổn định, không nhấp nháy. Khi cảnh quay đi được khoảng hai phần ba thời lượng, một cụm tuyết nhỏ trượt khỏi cành thông phía trên hồ và rơi thẳng xuống mặt nước gần khu vực trung tâm, tạo ra một tia nước bắn trắng nhỏ cùng những gợn sóng êm dịu lan rộng ra ngoài rồi mờ dần. Cảnh quay kết thúc trong sự tĩnh lặng khi làn hơi nước vẫn tiếp tục trôi. Chuyển động tự nhiên, chân thực, không cắt cảnh, không có người, không có động vật, không thêm vật thể mới, không có chữ. Âm thanh dịu nhẹ của tiếng nước sủi tăm, tiếng nước bắn khẽ khàng và sự tĩnh mịch của tuyết rơi.Kiểm tra lỗi (lint) tệp DNS zone hoặc tệp CSV xuất bản ghi từ nhà cung cấp trước khi nó làm sập website hoặc hệ thống email - phát hiện CNAME ở tên miền gốc (apex) hoặc nằm cạnh các bản ghi khác, MX/NS trỏ tới CNAME hoặc địa chỉ IP, thiếu dấu chấm ở cuối, thiếu hoặc trùng lặp bản ghi SPF, lỗi +all/?all và giới hạn 10 lần truy vấn (lookup), sự hiện diện của DMARC và DKIM, cú pháp và độ dài khóa, giá trị TTL quá cao hoặc quá thấp, địa chỉ IP nội bộ (private IP) và các lỗi cấu hình SOA. Trả về các bản ghi đã được sửa chuẩn xác. Bao gồm bộ kiểm tra lỗi bằng Python chạy ngoại tuyến dùng thư viện chuẩn (stdlib) kèm tùy chọn --self-test.
---
name: dns-zone-record-linter
description: Kiểm tra lỗi (lint) tệp DNS zone hoặc tệp CSV xuất bản ghi từ nhà cung cấp trước khi nó làm sập website hoặc hệ thống email - phát hiện CNAME ở tên miền gốc (apex) hoặc nằm cạnh các bản ghi khác, MX/NS trỏ tới CNAME hoặc địa chỉ IP, thiếu dấu chấm ở cuối, thiếu hoặc trùng lặp bản ghi SPF, lỗi +all/?all và giới hạn 10 lần truy vấn (lookup), sự hiện diện của DMARC và DKIM, cú pháp và độ dài khóa, giá trị TTL quá cao hoặc quá thấp, địa chỉ IP nội bộ (private IP) và các lỗi cấu hình SOA. Trả về các bản ghi đã được sửa chuẩn xác. Bao gồm bộ kiểm tra lỗi bằng Python chạy ngoại tuyến dùng thư viện chuẩn (stdlib) kèm tùy chọn --self-test.
---
# Công Cụ Kiểm Tra Bản Ghi DNS Zone (Linter)
Bạn rà soát các bản ghi DNS giống như cách một quản trị viên DNS cẩn trọng thực hiện trước khi chuyển đổi hệ thống hoặc đưa cấu hình email vào vận hành thực tế. Bạn tìm ra những sai sót âm thầm làm hỏng dịch vụ (bản ghi CNAME đặt ở tên miền gốc apex, bản ghi MX trỏ tới một CNAME, `mail.example.com` viết thiếu dấu chấm ở cuối, hai bản ghi SPF cùng tồn tại), giải thích hậu quả bằng ngôn từ dễ hiểu, và trả lại các bản ghi đã được chỉnh sửa chuẩn xác. Bạn làm việc ngoại tuyến dựa trên tệp đầu vào; tuyệt đối không bao giờ tuyên bố đã thực hiện truy vấn trực tiếp (live lookup) khi bạn không hề làm điều đó.
## Các tệp trong kỹ năng này
- `scripts/dns_lint.py` - phân tích cú pháp tệp BIND zone ($ORIGIN, $TTL, @, tên tương đối, SOA nhiều dòng, chuỗi TXT trong dấu ngoặc kép) hoặc tệp xuất CSV (name,type,value,ttl,priority) và báo cáo các lỗi phát hiện được kèm số dòng, sau đó liệt kê các đích trỏ nằm ngoài zone cần kiểm tra trực tiếp trên mạng (chỉ dùng thư viện chuẩn của Python 3.8+)
- `references/record-rules.md` - bộ quy tắc đằng sau mỗi mục kiểm tra kèm tham chiếu RFC: tính độc quyền của CNAME, đích trỏ của MX/NS, dấu chấm cuối, SPF, DMARC, DKIM, các giá trị TTL và SOA
- `references/finding-codes.md` - toàn bộ mã lỗi kèm mức độ nghiêm trọng, trường hợp nào có thể chấp nhận được, và cách khắc phục thông thường
- `templates/dns-review.md` - mẫu báo cáo đánh giá để gửi lại cho người dùng (tóm tắt, bản ghi đã sửa, các mục cần kiểm tra trực tiếp, lưu ý khi triển khai)
- `examples/example.com.zone` - một tệp zone được xuất ra trước khi chuyển nhà cung cấp DNS, cố tình cài sẵn các lỗi phổ biến
- `examples/example.com.fixed.zone` - tệp zone đã được sửa hoàn chỉnh (chạy kiểm tra sạch lỗi hoàn toàn)
- `examples/lint-report.md` - kết quả đầu ra thực tế của công cụ kiểm tra đối với tệp ví dụ bị lỗi
## Quy trình thực hiện
### 1. Thu thập các bản ghi và ngữ cảnh sử dụng
Yêu cầu người dùng cung cấp tệp zone (định dạng BIND, kết quả lệnh `dig AXFR` hoặc tệp xuất từ nhà cung cấp) hoặc tệp CSV (`name,type,value,ttl,priority`), tên zone, và mục đích sử dụng của tên miền đó: chỉ chạy website, có gửi email (dùng dịch vụ nào: Google Workspace, Microsoft 365, công cụ gửi bản tin newsletter, hệ thống hỗ trợ khách hàng helpdesk), hay hoàn toàn không dùng email. Nếu người dùng dán các bản ghi từ giao diện web của nhà cung cấp, hãy lưu ý rằng tên máy chủ (host name) ở đó thường không có dấu chấm ở cuối và các bản ghi NS/SOA thường do nhà cung cấp tự quản lý.
### 2. Chạy công cụ kiểm tra (linter)
```
python3 scripts/dns_lint.py examples/example.com.zone
python3 scripts/dns_lint.py records.csv --origin example.com
python3 scripts/dns_lint.py zone.db --origin example.com --min-severity MEDIUM --ignore CAA_MISSING --json
python3 scripts/dns_lint.py --self-test
```
Mã thoát 0 = không có phát hiện mức HIGH, 1 = có phát hiện mức HIGH, 2 = dữ liệu đầu vào không hợp lệ (dấu ngoặc đơn hoặc dấu ngoặc kép chưa đóng, chưa rõ tên zone). Nếu không thể chạy mã, hãy áp dụng thủ công các quy tắc trong `references/record-rules.md` theo đúng trình tự đó.
### 3. Đọc kết quả phát hiện
- **HIGH** làm hỏng quá trình phân giải tên miền hoặc gửi/nhận email ngay lập tức (xung đột CNAME, MX trỏ tới CNAME, thiếu dấu chấm ở cuối, tồn tại hai bản ghi SPF, dùng `+all`, đặt DMARC sai tên bản ghi, cú pháp SPF không hợp lệ, khóa DKIM yếu).
- **MEDIUM** là cấu hình sai hoặc tiềm ẩn rủi ro nhưng có thể vẫn hoạt động tạm thời (thiếu DMARC/DKIM/SPF, dùng `?all`, địa chỉ IP nội bộ, giá trị TTL quá cực đoan, đích trỏ lơ lửng không tồn tại, chỉ có duy nhất một máy chủ phân giải tên miền NS).
- **LOW** là các vấn đề về chuẩn hóa và dọn dẹp (bản ghi trùng lặp, `p=none`, khóa DKIM 1024-bit, không có bản ghi CAA, dùng kiểu bản ghi SPF cũ đã lỗi thời).
- Công cụ chỉ đếm các lượt truy vấn SPF ở cấp cao nhất; các chỉ thị `include` lồng nhau bên trong sẽ làm tăng thêm số lượt truy vấn thực tế. Công cụ không thể nhìn thấy các bản ghi nằm ở phía nhà cung cấp dịch vụ ngoài (như các selector DKIM do dịch vụ email tạo ra) hoặc các đích trỏ nằm ngoài phạm vi zone. Hãy nói rõ giới hạn này, đồng thời liệt kê các lệnh kiểm tra trực tiếp từ bảng "Out-of-zone targets" (`dig +short CNAME shop.example.com`, `dig TXT _dmarc.example.com`).
### 4. Bàn giao kết quả
Điền vào `templates/dns-review.md`: phần tóm tắt ngắn gọn, các bản ghi đã sửa theo đúng định dạng của người dùng (dòng cấu hình tệp zone hoặc các trường nhập liệu trên giao diện nhà cung cấp), những nội dung cần xác minh trực tiếp trên mạng, và trình tự triển khai an toàn: hạ thấp TTL trước một ngày, thực hiện thay đổi, kiểm tra xác nhận, sau đó nâng TTL trở lại; đừng quên tăng số serial của bản ghi SOA. Đối với các thay đổi liên quan đến email, hãy khuyến nghị cấu hình DMARC ở mức `p=none` kèm địa chỉ `rua` trước tiên, sau đó nâng lên `quarantine`, rồi mới đến `reject` một khi các báo cáo trả về đã hoàn toàn sạch lỗi.
## Ví dụ kết quả
Trên tệp `examples/example.com.zone`, công cụ báo cáo 19 phát hiện (7 mức HIGH, 8 mức MEDIUM, 4 mức LOW): website được chuyển đi bằng bản ghi `@ CNAME bakery-site.example.net.` (đặt CNAME ở ngay tên miền gốc apex, nằm cạnh SOA, NS, MX và TXT), `www` vừa có CNAME vừa có bản ghi TXT xác minh tên miền, `MX 10 mail.example.com` thiếu dấu chấm ở cuối nên bị hiểu thành `mail.example.com.example.com.`, MX dự phòng lại trỏ tới một bản ghi CNAME, có tới hai bản ghi `v=spf1` (một bản ghi dùng `?all`), DMARC đặt ở tên `dmarc` thay vì `_dmarc`, một selector DKIM cũ đã bị thu hồi khóa, địa chỉ liên hệ trong SOA chứa ký tự `@`, và bản ghi `intranet` công khai địa chỉ IP nội bộ 10.0.4.12. Tệp `examples/example.com.fixed.zone` đã khắc phục toàn bộ các lỗi trên và vượt qua bài kiểm tra hoàn toàn sạch sẽ (mã thoát 0).
## Quy tắc
- Không bao giờ tự bịa ra giá trị bản ghi (địa chỉ IP, khóa công khai DKIM, tên máy chủ của nhà cung cấp); hãy dùng các ký hiệu giữ chỗ (placeholder) và hướng dẫn rõ người dùng cần sao chép thông tin gì từ nhà cung cấp dịch vụ.
- Chỉ giữ duy nhất một bản ghi SPF cho mỗi tên miền/tên miền phụ; hãy gộp chung các chỉ thị `include` vào cùng một bản ghi thay vì tạo thêm bản ghi SPF thứ hai.
- Không đề xuất xóa các selector DKIM hoặc bản ghi MX có khả năng vẫn đang được sử dụng mà chưa hỏi xem những dịch vụ nào đang gửi email.
- Giải thích tác hại của việc thiếu dấu chấm ở cuối bằng cách viết rõ tên miền sau khi bị nối đuôi tự động, để người dùng nhìn thấy tận mắt lỗi sai đó.
- Đánh dấu bất kỳ mục nào cần truy vấn mạng thực tế là "cần xác minh trực tiếp" (to verify); tuyệt đối không trình bày như thể bạn đã kiểm tra rồi.
- Mọi thay đổi đối với bản ghi NS, MX hoặc các bản ghi ở tên miền gốc (apex) phải luôn đi kèm hướng dẫn triển khai và phương án hoàn tác (ghi lại giá trị cũ, thông số TTL, thời điểm cần kiểm tra).
FILE:references/record-rules.md
# Các quy tắc bản ghi DNS mà công cụ áp dụng
## Tên bản ghi và dấu chấm ở cuối (trailing dots)
- Trong tệp zone, một tên không có dấu chấm ở cuối được hiểu là tên tương đối: cả `www` và `mail.example.com` đều sẽ bị nối thêm hậu tố tên miền gốc ($ORIGIN) vào đuôi. Khi đó, `mail.example.com` nằm trong zone `example.com.` sẽ biến thành `mail.example.com.example.com.` - đây là lỗi sao chép và dán (copy-paste) phổ biến nhất. Hãy viết đầy đủ là `mail.example.com.` hoặc chỉ viết ngắn gọn là `mail`.
- Ký hiệu `@` đại diện cho tên miền gốc (origin / apex). Một dòng bắt đầu bằng khoảng trắng sẽ kế thừa lại tên chủ sở hữu (owner name) của dòng ngay phía trên nó.
- Biểu mẫu web của các nhà cung cấp DNS thường tự động xử lý dấu chấm cuối cho bạn; vì vậy công cụ sẽ bỏ qua bước kiểm tra dấu chấm cuối đối với dữ liệu đầu vào dạng CSV.
## CNAME (RFC 1034 3.6.2, RFC 2181 10.1)
- Một tên đã gắn bản ghi CNAME thì không được phép chứa bất kỳ dữ liệu bản ghi nào khác cùng tên (ngoại trừ các bản ghi DNSSEC). Các máy chủ phân giải (resolver) khi gặp CNAME sẽ chỉ trả về CNAME đó và phớt lờ toàn bộ phần còn lại, do đó nếu đặt bản ghi TXT hoặc MX cùng tên bên cạnh CNAME thì chúng sẽ bị vô hiệu hóa hoặc gây lỗi.
- Tên miền gốc (apex) luôn bắt buộc phải có bản ghi SOA và NS, vì vậy đặt bản ghi CNAME ở tên miền gốc không bao giờ hợp lệ theo chuẩn DNS. Hãy sử dụng bản ghi A/AAAA, hoặc tính năng ALIAS / ANAME / CNAME flattening của nhà cung cấp DNS (các tính năng này thực chất sẽ trả kết quả về dưới dạng bản ghi A/AAAA).
- Mỗi tên chỉ được phép có duy nhất một bản ghi CNAME. Việc nối chuỗi (CNAME trỏ sang một CNAME khác) vẫn hoạt động nhưng làm tốn thêm lượt truy vấn phân giải; hãy giữ chuỗi trỏ ngắn nhất có thể.
- Một bản ghi CNAME trỏ tới dịch vụ bên ngoài (trang bán hàng, trang trạng thái hệ thống, CDN) mà sau đó tài khoản dịch vụ đã bị hủy có thể bị kẻ khác đăng ký chiếm quyền điều khiển (tấn công chiếm quyền tên miền phụ - subdomain takeover). Hãy liệt kê các bản ghi dạng này và gỡ bỏ ngay những bản ghi không còn sử dụng.
## Đích trỏ của MX, NS, SRV (RFC 2181 10.3, RFC 5321 5.1, RFC 7505)
- Bản ghi MX, NS và SRV bắt buộc phải trỏ tới một tên máy chủ (host) có bản ghi A/AAAA trực tiếp, không được trỏ tới một bản ghi CNAME và cũng không được điền trực tiếp địa chỉ IP.
- Giá trị độ ưu tiên (preference) của MX càng nhỏ thì độ ưu tiên càng cao. Các máy chủ MX dự phòng phải thực sự được cấu hình để nhận thư cho tên miền đó, nếu không chúng sẽ chỉ trở thành nơi thu hút thư rác (spam).
- Bản ghi Null MX `MX 0 .` tuyên bố rõ rằng tên miền này không nhận bất kỳ email nào. Nếu sử dụng, nó phải là bản ghi MX duy nhất của tên miền đó.
- Hãy sử dụng ít nhất hai máy chủ NS nằm trên các mạng độc lập nhau; danh sách máy chủ NS khai báo tại nhà đăng ký tên miền (registrar delegation) phải khớp với các bản ghi NS bên trong tệp zone.
## SPF (RFC 7208)
- Chỉ được phép có duy nhất một bản ghi TXT `v=spf1` cho mỗi tên. Có hai bản ghi SPF = lỗi `permerror` = kiểm tra SPF thất bại đối với toàn bộ email gửi đi.
- Các thành phần (terms): `ip4:`, `ip6:`, `a`, `mx`, `include:`, `exists:`, `ptr` (đã ngừng khuyến nghị sử dụng), `all`, cùng các biến điều chỉnh (modifiers) `redirect=` và `exp=`. Các tiền tố định tính (qualifiers): `+` cho phép / pass (mặc định), `-` từ chối cứng / fail, `~` từ chối mềm / softfail, `?` trung lập / neutral.
- Tối đa 10 thành phần làm phát sinh truy vấn DNS (`include`, `a`, `mx`, `ptr`, `exists`, `redirect`), được tính tổng cộng xuyên suốt cả các chỉ thị `include` lồng bên trong. Các thành phần `ip4`/`ip6` không tốn lượt truy vấn DNS nào.
- Hãy kết thúc bản ghi bằng `-all` (hoặc `~all` trong giai đoạn thử nghiệm). Dùng `+all` đồng nghĩa với việc cho phép bất kỳ ai trên internet mạo danh bạn gửi thư; `?all` không mang lại tín hiệu bảo vệ nào. Mọi thành phần viết phía sau `all` đều bị bỏ qua.
- Kiểu bản ghi DNS mang tên SPF (type 99) đã bị khai tử; chỉ xuất bản SPF dưới dạng bản ghi TXT.
- Một chuỗi nằm trong cặp dấu ngoặc kép chỉ chứa được tối đa 255 byte; các bản ghi dài phải được tách thành nhiều chuỗi `"phần một" "phần hai"` và sẽ được hệ thống tự động nối liền lại với nhau (không tự thêm dấu cách ở giữa).
## DMARC (RFC 7489)
- Bản ghi TXT chỉ đặt tại `_dmarc.<domain>`. Phải bắt đầu bằng `v=DMARC1;` và bao gồm `p=none|quarantine|reject`. Chỉ có một bản ghi duy nhất.
- Thêm `rua=mailto:` để nhận báo cáo tổng hợp. Triển khai theo lộ trình `p=none` -> `quarantine` -> `reject`; giá trị `pct` dưới 100 sẽ áp dụng chính sách cho một phần lượng thư.
- Từ năm 2024, Gmail và Yahoo yêu cầu SPF, DKIM và DMARC (ít nhất là `p=none`) đối với những bên gửi thư số lượng lớn.
## DKIM (RFC 6376, RFC 8301, RFC 8463)
- Khóa được đặt tại `<selector>._domainkey.<domain>` dưới dạng TXT (`v=DKIM1; k=rsa; p=<base64>`) hoặc dưới dạng CNAME trỏ tới nhà cung cấp (Microsoft 365, nhiều ESP).
- Không được sử dụng khóa RSA dưới 1024 bit; mức khuyến nghị là 2048 bit. Có thể thêm Ed25519 (`k=ed25519`) song song với RSA.
- Giá trị `p=` để trống nghĩa là khóa đã bị thu hồi. Các selector không thể tự dò tìm được: việc không xuất hiện trong một tệp có nghĩa là "không có ở đây", chứ không phải "không có ở bất kỳ đâu".
## TTL và SOA (RFC 1035, RFC 2181 8, RFC 2308)
- TTL nằm trong khoảng 0..2147483647 s. Các giá trị thường dùng: 300-3600 s cho các bản ghi hay thay đổi, 3600-86400 s cho các bản ghi ổn định. Dưới 60 s thì nhiều bộ phân giải (resolver) đằng nào cũng tự nâng lên; trên một tuần thì một sai sót sẽ tồn đọng suốt cả tuần. Hãy hạ thấp TTL trước một ngày khi có thay đổi theo kế hoạch.
- `$TTL` thiết lập giá trị mặc định. Trường minimum của SOA là TTL lưu đệm âm (negative-caching TTL - khoảng thời gian trạng thái "không tồn tại" được lưu vào bộ nhớ đệm): 300-3600 s.
- Địa chỉ liên hệ SOA (rname) là một email được viết bằng dấu chấm: `hostmaster.example.com.` thay cho hostmaster@example.com.
- Tăng số serial của SOA sau mỗi lần thay đổi (YYYYMMDDnn).
## Địa chỉ và CAA
- A chứa địa chỉ IPv4, AAAA chứa địa chỉ IPv6. Các địa chỉ nội bộ (private), loopback và link-local không thuộc về một vùng (zone) công khai (hãy dùng DNS phân tách tầm nhìn - split-horizon DNS). Các dải địa chỉ dành cho tài liệu (192.0.2.0/24, 2001:db8::/32) có thể dùng bình thường trong các ví dụ.
- CAA (RFC 8659) giới hạn những tổ chức cấp phát chứng chỉ (CA) nào được phép cấp chứng chỉ cho tên miền: `@ CAA 0 issue "letsencrypt.org"`.
FILE:references/finding-codes.md
# Mã lỗi phát hiện (Finding codes)
| Mã | Mức độ | Vấn đề | Chấp nhận được khi | Cách sửa thông thường |
|---|---|---|---|---|
| CNAME_AT_APEX | HIGH | CNAME ở đỉnh vùng (apex) xung đột với SOA/NS, làm hỏng luồng thư | không bao giờ | dùng A/AAAA hoặc ALIAS/flattening của nhà cung cấp |
| CNAME_WITH_OTHER_DATA | HIGH | các bản ghi khác nằm cạnh CNAME bị bỏ qua | chỉ các bản ghi DNSSEC | chuyển TXT/MX đi nơi khác hoặc dùng A/AAAA |
| MULTIPLE_CNAME | HIGH | hai bản ghi CNAME cho cùng một tên | không bao giờ | giữ lại một bản ghi |
| MX_TO_CNAME / NS_TO_CNAME | HIGH | đích của MX/NS/SRV là một bí danh (alias) | không bao giờ (một số máy chủ dung thứ, nhưng nhiều máy chủ thì không) | trỏ tới máy chủ A/AAAA cuối cùng |
| TARGET_IS_IP | HIGH | giá trị MX/NS/CNAME là một địa chỉ IP | không bao giờ | dùng tên máy chủ có bản ghi A |
| MISSING_TRAILING_DOT | HIGH | tên đầy đủ không có dấu chấm ở cuối sẽ bị nối thêm miền gốc (origin) | không bao giờ | thêm dấu chấm hoặc viết ở dạng tương đối |
| OWNER_DOUBLED_ORIGIN | HIGH | tên chủ sở hữu `www.example.com` không có dấu chấm | không bao giờ | `www` hoặc `www.example.com.` |
| SPF_MULTIPLE | HIGH | hai bản ghi v=spf1 -> lỗi permerror | không bao giờ | gộp thành một bản ghi |
| SPF_PASS_ALL | HIGH | `+all`/`all` cấp quyền cho tất cả mọi người | không bao giờ | `-all` / `~all` |
| SPF_SYNTAX | HIGH | thành phần không xác định hoặc ip4/ip6 sai định dạng -> permerror | không bao giờ | sửa lại thành phần đó |
| SPF_TOO_MANY_LOOKUPS | HIGH | nhiều hơn 10 thành phần truy vấn (lookup) | không bao giờ | làm phẳng (flatten), xóa các include không dùng |
| TXT_STRING_TOO_LONG | HIGH | chuỗi trong ngoặc kép dài quá 255 byte | giao diện nhà cung cấp tự tách giúp bạn (đầu vào CSV không được kiểm tra) | tách thành từng đoạn nhỏ |
| DMARC_WRONG_NAME | HIGH | v=DMARC1 không nằm ở _dmarc | không bao giờ | chuyển sang `_dmarc` |
| DMARC_MULTIPLE / DMARC_SYNTAX | HIGH | bên nhận bỏ qua DMARC | không bao giờ | giữ một bản ghi hợp lệ duy nhất |
| DKIM_WRONG_NAME / DKIM_BAD_KEY | HIGH | không thể tìm thấy hoặc phân tích cú pháp khóa | không bao giờ | sao chép lại từ nhà cung cấp |
| DKIM_WEAK_KEY | HIGH | khóa RSA dưới 1024 bit | không bao giờ | xoay vòng khóa lên 2048 bit |
| SOA_RNAME_AT | HIGH | có ký tự `@` trong liên hệ SOA | không bao giờ | `hostmaster.example.com.` |
| NULL_MX_WITH_OTHERS | HIGH | có cả `MX 0 .` lẫn MX thực | không bao giờ | chỉ chọn một trong hai |
| BAD_ADDRESS / WRONG_ADDRESS_FAMILY / TTL_INVALID | HIGH | không thể nạp giá trị | không bao giờ | sửa lại giá trị |
| SPF_MISSING | MEDIUM | có MX nhưng không có SPF | không bao giờ đối với tên miền gửi/nhận thư | thêm một bản ghi SPF |
| DMARC_MISSING | MEDIUM | tên miền thư không có DMARC | không bao giờ | `v=DMARC1; p=none; rua=...` sau đó siết chặt dần |
| DKIM_NOT_FOUND | MEDIUM | không có selector trong tệp này | selector được lưu trữ ở nơi khác (kiểm tra trực tiếp) | công bố selector của nhà cung cấp |
| DKIM_REVOKED | MEDIUM | `p=` để trống | selector được chủ đích ngừng sử dụng (sau đó hãy xóa đi) | xóa bản ghi hoặc công bố khóa mới |
| SPF_NEUTRAL_ALL / SPF_NO_ALL / SPF_TERMS_AFTER_ALL | MEDIUM | chính sách yếu hoặc bị bỏ qua | giai đoạn thử nghiệm ngắn | kết thúc bằng `-all` / `~all` |
| MAYBE_MISSING_TRAILING_DOT | MEDIUM | trông giống tên bên ngoài vùng nhưng thiếu dấu chấm | thực sự là một tên tương đối | thêm dấu chấm |
| DANGLING_TARGET | MEDIUM | đích trong vùng không có bản ghi nào | được định nghĩa ở tệp hoặc view khác | thêm bản ghi hoặc sửa lại |
| MX_TARGET_NO_ADDRESS | MEDIUM | máy chủ thư không có A/AAAA | địa chỉ đến từ một vùng khác | thêm A/AAAA |
| PRIVATE_ADDRESS | MEDIUM | địa chỉ RFC 1918/loopback/link-local trong DNS công khai | vùng được chủ đích dùng riêng trong nội bộ | dùng DNS phân tách tầm nhìn (split-horizon) |
| TTL_TOO_LOW / TTL_TOO_HIGH | MEDIUM | dưới 60 s / trên 7 ngày | TTL ngắn trong đợt chuyển đổi theo kế hoạch; `_acme-challenge` | 300 s - 1 ngày |
| NS_MISSING / NS_SINGLE / SOA_MISSING | MEDIUM | tệp vùng (zone file) chưa hoàn chỉnh | NS/SOA do nhà cung cấp quản lý (đầu vào CSV bỏ qua phần này) | bổ sung đầy đủ |
| UNKNOWN_TYPE | MEDIUM | loại bản ghi không được nhận diện | loại bản ghi mới mà kịch bản chưa biết | kiểm tra lỗi chính tả |
| SPF_PTR / SPF_TYPE99 / SPF_LOOKUPS_NEAR_LIMIT | LOW | đã lỗi thời hoặc gần chạm ngưỡng giới hạn | - | thay thế / đếm trực tiếp các include lồng nhau |
| DMARC_MONITOR_ONLY / DMARC_NO_RUA / DMARC_PARTIAL_PCT | LOW | DMARC chưa thực thi chặn hoặc chưa gửi báo cáo | trong quá trình triển khai ban đầu | siết chặt sau khi xem xét báo cáo |
| DKIM_1024_KEY | LOW | RSA 1024-bit | nhà cung cấp không hỗ trợ 2048 | xoay vòng khóa khi có thể |
| NO_MAIL_POLICY / NULL_MX_SPF_NOT_FAIL | LOW | tên miền không dùng thư có thể bị giả mạo | - | null MX + `v=spf1 -all` + DMARC reject |
| CNAME_CHAIN / DUPLICATE_RECORD / CAA_MISSING / NO_DEFAULT_TTL / SOA_NEGATIVE_TTL_HIGH / INCLUDE_NOT_FOLLOWED | LOW | vệ sinh cấu hình (hygiene) | - | xem cột cách sửa trong báo cáo |
Mã thoát (Exit codes): 0 = không có lỗi HIGH, 1 = có lỗi HIGH, 2 = đầu vào không hợp lệ. Trong CI, hãy chặn ở mức HIGH và lưu danh sách `--ignore` bất kỳ trong kho mã nguồn kèm theo lý do.
## Các kiểm tra trực tiếp mà bộ linter không thể thực hiện (ngoại tuyến)
- Các đích nằm ngoài vùng: `dig +short A <target>`; một bản ghi CNAME trỏ tới máy chủ SaaS đã hủy đăng ký sẽ dẫn đến nguy cơ bị chiếm quyền điều khiển (subdomain takeover).
- Các include SPF lồng nhau: đếm đệ quy bằng `dig TXT <include>`, hoặc dùng công cụ kiểm tra SPF dựa trên bộ phân giải.
- Các selector DKIM do nhà cung cấp dịch vụ thư lưu trữ: `dig TXT <selector>._domainkey.<domain>` (Google: `google`, Microsoft 365: các bản ghi CNAME `selector1`/`selector2`).
- Ủy quyền (Delegation): `dig NS <domain> @a.gtld-servers.net` (hoặc máy chủ của TLD tương ứng) phải khớp với tập hợp NS của vùng.
FILE:templates/dns-review.md
# Đánh giá DNS: <domain>
**Nguồn:** <zone file / provider export, date> **Mục đích:** <website + Google Workspace mail + newsletter tool>
**Kết quả:** <HIGH n, MEDIUM n, LOW n> - <nhận định trong một câu, ví dụ: "việc gửi nhận thư đang gặp rủi ro cho đến khi SPF được gộp lại và MX được sửa">
## Cần sửa ngay (HIGH)
| # | Bản ghi hiện tại | Vấn đề | Thay thế bằng |
|---|---|---|---|
| 1 | `<@ CNAME bakery-site.example.net.>` | <CNAME ở đỉnh vùng làm ẩn MX/TXT> | `<@ A 192.0.2.10>` (hoặc ALIAS tại nhà cung cấp) |
| 2 | `<@ MX 10 mail.example.com>` | <thiếu dấu chấm ở cuối -> mail.example.com.example.com.> | `<@ MX 10 mail.example.com.>` |
## Cần sửa sớm (MEDIUM)
- <thêm TXT cho `_dmarc` với giá trị `v=DMARC1; p=none; rua=mailto:dmarc-reports@<domain>`>
## Vệ sinh cấu hình (LOW)
- <xóa bản ghi A trùng lặp của blog; thêm CAA>
## Tóm tắt xác thực thư điện tử
| Hạng mục | Hiện tại | Sau khi sửa |
|---|---|---|
| SPF | <2 bản ghi, ?all> | <1 bản ghi, bao gồm A + B, -all> |
| DKIM | <selector google 1024-bit, s2019 đã thu hồi> | <khóa 2048-bit, đã xóa selector ngừng sử dụng> |
| DMARC | <sai tên bản ghi> | <_dmarc p=none -> chuyển sang quarantine vào <date>> |
## Xác minh trực tiếp (chưa kiểm tra ngoại tuyến)
- `<dig +short CNAME shop.<domain>>` - <đích trỏ tới có còn được sử dụng không?>
- `<dig TXT google._domainkey.<domain>>` - <có khớp với bảng điều khiển của nhà cung cấp không?>
## Lộ trình triển khai (Rollout)
1. <hạ TTL của các bản ghi sắp thay đổi xuống 300 s, chờ hết một chu kỳ TTL cũ>
2. <áp dụng thay đổi, tăng số serial của SOA lên YYYYMMDDnn>
3. <xác minh bằng lệnh dig với máy chủ có thẩm quyền (authoritative servers) và bộ phân giải công khai; gửi một thư thử nghiệm và đọc tiêu đề Authentication-Results>
4. <nâng TTL trở lại 3600 s; xem xét các báo cáo DMARC sau 1-2 tuần>
**Hoàn tác (Rollback):** <các giá trị cũ được liệt kê ở trên; khôi phục lại chúng và chờ một chu kỳ TTL>
**Câu hỏi bỏ ngỏ:** <những dịch vụ nào gửi thư dưới danh nghĩa tên miền này? backupmx có còn được sử dụng không?>
FILE:examples/example.com.zone
; example.com - zone exported before the move to a new DNS host (has mistakes on purpose)
$ORIGIN example.com.
$TTL 3600
@ IN SOA ns1.example.net. hostmaster@example.com. (
2026103001 ; serial
7200 ; refresh
900 ; retry
1209600 ; expire
172800 ) ; minimum (negative caching)
@ IN NS ns1.example.net.
@ IN NS ns2.example.net.
; website moved to a static host
@ IN CNAME bakery-site.example.net.
www 30 IN CNAME bakery-site.example.net.
www IN TXT "site-verification=4f9c2a"
shop IN CNAME shops.myshopify.com
blog IN A 192.0.2.44
blog IN A 192.0.2.44
legacy 1209600 IN A 192.0.2.45
intranet IN A 10.0.4.12
; mail
@ IN MX 10 mail.example.com
@ IN MX 20 backupmx
backupmx IN CNAME mx2.example.net.
@ IN TXT "v=spf1 include:_spf.google.com ~all"
@ IN TXT "v=spf1 include:sendgrid.net ?all"
dmarc IN TXT "v=DMARC1; p=none"
google._domainkey IN TXT "v=DKIM1; k=rsa; p=MIGfMA0GCSqGSIb3DQEBAQUAA4GNADCBiQKBgQDbNfaf4mo/6FvrWAv3WssXhXwsdrJxrAuhIVcYXdrMZp55PDpEjo63C/vOuaStp58YtZTnzQlm0V3rjtvOP1XgGAy3LWurXdRkT0zOGxx0AMgjZfD/8QDgjF6f4VW9zmNytbD3EgZXxeGZSBw8JtTdT/rOEygTgYL5+x5DftDSFQIDAQAB"
s2019._domainkey IN TXT "v=DKIM1; k=rsa; p="
FILE:examples/example.com.fixed.zone
; example.com - corrected zone
$ORIGIN example.com.
$TTL 3600
@ IN SOA ns1.example.net. hostmaster.example.com. (
2026103002 ; serial (bumped)
7200 ; refresh
900 ; retry
1209600 ; expire
3600 ) ; minimum (negative caching)
@ IN NS ns1.example.net.
@ IN NS ns2.example.net.
@ IN CAA 0 issue "letsencrypt.org"
; website: A/AAAA at the apex (or the provider's ALIAS/flattening), CNAME only below it
@ IN A 192.0.2.10
@ IN AAAA 2001:db8::10
www IN CNAME bakery-site.example.net.
_site-verification.www IN TXT "site-verification=4f9c2a"
shop IN CNAME shops.myshopify.com.
blog IN A 192.0.2.44
legacy IN A 192.0.2.45
; intranet moved to the internal (split-horizon) view
; mail
@ IN MX 10 mail.example.com.
@ IN MX 20 mx2.example.net.
mail IN A 192.0.2.25
@ IN TXT "v=spf1 include:_spf.google.com include:sendgrid.net -all"
_dmarc IN TXT "v=DMARC1; p=quarantine; rua=mailto:dmarc-reports@example.com"
google._domainkey IN TXT ( "v=DKIM1; k=rsa; p=MIIBIjANBgkqhkiG9w0BAQEFAAOCAQ8AMIIBCgKCAQEAz7ouq6bH4GbHRPASRa3m/LiSvOKSZ7L7KZqE231EHY1s8FN9criBQkJXXmxkwPERQSVSyRIC4LjSpxwPTe6LEVhg7nrswTX1ktBbXMUmkgj8CPKV+yWzOsDOMk7kjqghuNWXD/R5K/mT7xbTiCaXztegoQi+"
"kVXf0xuMmQYLxVthdjIz1h2PORFhtjzwKYbpaMKjq2BWKIaNtaGBxc2kaSLyPw8W65+A7XeLhtKT8zcteU72IpdmibNsHlkBR0Hb7rQgb+0LgNVqPvF/mm37PKFPQPrfWjjL/Fc1MQoCm8jO3kI0O5ssuP7KKO7ZjtT4ekeHytw23INuPh/Kw1LqzwIDAQAB" )
FILE:examples/lint-report.md
# Báo cáo kiểm tra (lint) bản ghi DNS: example.com.zone
Vùng: example.com. Định dạng: zone Số bản ghi: 19 Phát hiện: 19 (HIGH 7, MEDIUM 8, LOW 4)
| Mức độ | Mã | Dòng | Tên | Loại | Vấn đề | Cách sửa |
|---|---|---|---|---|---|---|
| HIGH | SOA_RNAME_AT | 4 | @ | SOA | thông tin liên hệ 'hostmaster@example.com.' chứa ký tự '@'; trong DNS ký tự này phải được viết bằng dấu chấm | viết thông tin liên hệ là hostmaster.example.com. (ký tự @ đầu tiên đổi thành dấu chấm) |
| LOW | SOA_NEGATIVE_TTL_HIGH | 4 | @ | SOA | giá trị minimum của SOA là 172800 s: một tên bị xóa rồi thêm lại sẽ bị lưu trong bộ nhớ đệm là 'không tồn tại' suốt khoảng thời gian đó | đặt giá trị minimum của SOA (TTL lưu đệm âm) thành 300-3600 s |
| HIGH | CNAME_AT_APEX | 14 | @ | CNAME | CNAME tại đỉnh vùng (zone apex) xung đột với các bản ghi SOA và NS tại đó; việc tra cứu thư và các truy vấn khác sẽ bị lỗi | sử dụng các bản ghi A/AAAA ở đỉnh vùng, hoặc bản ghi ALIAS/ANAME/CNAME-flattening của nhà cung cấp |
| HIGH | CNAME_WITH_OTHER_DATA | 15 | www | CNAME | tên này có cả CNAME lẫn TXT; các bộ phân giải sẽ chỉ trả về CNAME | một tên đã có CNAME thì không được phép có bản ghi nào khác: hãy chuyển các bản ghi khác đi nơi khác hoặc thay thế CNAME bằng A/AAAA |
| MEDIUM | TTL_TOO_LOW | 15 | www | CNAME | TTL 30 s: làm tăng tải truy vấn, tra cứu chậm hơn, và nhiều bộ phân giải đằng nào cũng tự nâng giá trị này lên | sử dụng 300 s trở lên cho các bản ghi thông thường (chỉ hạ thấp khi có thay đổi theo kế hoạch) |
| MEDIUM | MAYBE_MISSING_TRAILING_DOT | 17 | shop | CNAME | 'shops.myshopify.com' trông giống một tên máy chủ đầy đủ nhưng không có dấu chấm ở cuối, nên sẽ bị hiểu thành shops.myshopify.com.example.com. | nếu đây là một tên máy chủ bên ngoài, hãy thêm dấu chấm ở cuối |
| LOW | DUPLICATE_RECORD | 19 | blog | A | giống hệt dòng 18 | xóa bản ghi bị trùng lặp |
| MEDIUM | TTL_TOO_HIGH | 20 | legacy | A | TTL 1209600 s (14 ngày): một giá trị sai sẽ bị lưu giữ trong bộ nhớ đệm suốt khoảng thời gian đó | sử dụng từ 1 giờ đến 1 ngày; nếu trên một tuần, các sai sót sẽ mất cả tuần để khắc phục |
| MEDIUM | PRIVATE_ADDRESS | 21 | intranet | A | 10.0.4.12 là địa chỉ nội bộ (private)/loopback; người dùng bên ngoài không thể truy cập và nó làm lộ cấu trúc mạng nội bộ | không công bố địa chỉ nội bộ/loopback trong một vùng công khai (hãy sử dụng DNS phân tách tầm nhìn - split-horizon DNS nếu cần) |
| HIGH | MISSING_TRAILING_DOT | 24 | @ | MX | 'mail.example.com' không có dấu chấm ở cuối, nên sẽ bị hiểu thành mail.example.com.example.com. | kết thúc các tên miền đủ điều kiện (FQDN) bằng một dấu chấm (mail.example.com.) hoặc viết ở dạng tương đối (mail) |
| MEDIUM | DANGLING_TARGET | 24 | @ | MX | đích MX mail không có bản ghi nào trong vùng này | thêm bản ghi trong vùng còn thiếu hoặc sửa lại tên đích |
| HIGH | MX_TO_CNAME | 25 | @ | MX | đích MX backupmx là một CNAME (không được phép theo RFC 2181 10.3) | trỏ MX vào một tên có các bản ghi A/AAAA (đích cuối cùng của CNAME) |
| HIGH | SPF_MULTIPLE | 28 | @ | TXT | có 2 bản ghi v=spf1 tại tên này (dòng 27, 28) | gộp thành MỘT bản ghi v=spf1 duy nhất; việc có hai bản ghi sẽ làm mọi kiểm tra SPF bị lỗi (permerror) |
| MEDIUM | SPF_NEUTRAL_ALL | 28 | @ | TXT | '?all' mang tính trung lập: những người gửi trái phép không bị đánh dấu | sử dụng ~all hoặc -all; ?all không cung cấp tín hiệu xử lý nào cho bên nhận |
| HIGH | DMARC_WRONG_NAME | 29 | dmarc | TXT | bản ghi DMARC không nằm tại _dmarc.<domain>, nên bên nhận không bao giờ nhìn thấy nó | DMARC chỉ được đọc từ _dmarc.<domain>; hãy chuyển bản ghi về đó |
| LOW | DKIM_1024_KEY | 30 | google._domainkey | TXT | khóa RSA có độ dài 1024 bit; mức khuyến nghị hiện nay là 2048 | lên kế hoạch xoay vòng sang khóa 2048-bit |
| MEDIUM | DKIM_REVOKED | 31 | s2019._domainkey | TXT | p= để trống: selector này đã bị thu hồi và thư được ký bằng nó sẽ trượt kiểm tra DKIM | giá trị p= rỗng có tác dụng thu hồi khóa; hãy xóa bản ghi nếu selector đã ngừng sử dụng, hoặc công bố khóa mới |
| MEDIUM | DMARC_MISSING | - | _dmarc | TXT | không có bản ghi DMARC: bên nhận không thể phân biệt thư giả mạo với thư thật của bạn, đồng thời Gmail/Yahoo yêu cầu DMARC đối với người gửi số lượng lớn | thêm bản ghi TXT tại _dmarc: "v=DMARC1; p=none; rua=mailto:dmarc@<domain>" sau đó chuyển dần sang quarantine/reject |
| LOW | CAA_MISSING | - | @ | CAA | không có bản ghi CAA: bất kỳ CA công khai nào cũng có thể cấp chứng chỉ cho tên miền này | tăng cường bảo mật tùy chọn: CAA 0 issue "<CA của bạn>" giúp giới hạn tổ chức nào được phép cấp chứng chỉ |
## Các đích ngoài vùng cần kiểm tra trực tiếp (không thực hiện lệnh gọi mạng nào)
| Đích | Được sử dụng bởi |
|---|---|
| bakery-site.example.net. | @ CNAME (dòng 14); www CNAME (dòng 15) |
| mx2.example.net. | backupmx CNAME (dòng 26) |
| ns1.example.net. | @ NS (dòng 10) |
| ns2.example.net. | @ NS (dòng 11) |
| shops.myshopify.com. | shop CNAME (dòng 17) |
FILE:scripts/dns_lint.py
#!/usr/bin/env python3
"""DNS zone record linter (Python 3.8+ standard library only, works offline).
Reads a BIND-style zone file or a CSV record list exported from a DNS provider and
reports common mistakes before they break web or mail delivery:
CNAME at the apex or next to other records, MX/NS pointing at a CNAME or an IP,
missing trailing dots (mail.example.com -> mail.example.com.example.com.), missing or
duplicate SPF, SPF syntax, +all/?all and the 10-lookup limit, DMARC and DKIM presence
and syntax, weak or revoked DKIM keys, TTL extremes, private addresses in a public
zone, SOA mistakes, duplicate records, and domains that send no mail but have no
"no mail" policy. Out-of-zone targets are listed for a separate live check.
Usage:
python3 dns_lint.py example.com.zone [--origin example.com] [--json]
[--min-severity LOW|MEDIUM|HIGH] [--ignore CODE,CODE]
python3 dns_lint.py records.csv --origin example.com (CSV columns: name,type,value[,ttl][,priority])
python3 dns_lint.py --self-test
Zone files: $ORIGIN, $TTL, @, relative names, blank owner (repeat previous), optional
TTL/class in either order, ( ) multi-line records, ; comments, quoted TXT strings.
Exit codes: 0 = no HIGH findings, 1 = HIGH findings, 2 = bad input.
"""
import argparse, base64, csv, io, ipaddress, json, os, re, sys
SEVERITIES = ["LOW", "MEDIUM", "HIGH"]
CLASSES = {"IN", "CH", "HS"}
TYPES = {"A", "AAAA", "CNAME", "MX", "NS", "TXT", "SPF", "SOA", "SRV", "CAA", "PTR", "DNAME",
"ALIAS", "ANAME", "DS", "DNSKEY", "RRSIG", "NSEC", "NSEC3", "NSEC3PARAM", "HTTPS",
"SVCB", "TLSA", "NAPTR", "SSHFP", "LOC", "HINFO", "CDS", "CDNSKEY"}
DNSSEC_TYPES = {"RRSIG", "NSEC", "NSEC3", "KEY"}
TARGET_TYPES = {"CNAME": -1, "MX": 1, "NS": 0, "PTR": 0, "DNAME": 0, "SRV": 3, "ALIAS": 0, "ANAME": 0}
COMMON_TLDS = set("com net org edu gov mil int io co dev app ai info biz me tv cloud xyz site online "
"shop store tech us uk de fr nl eu es it se no dk fi pl cz at ch be pt ie tr ru "
"jp cn kr in au nz ca br mx ar za sg hk tw".split())
INTERNAL_NETS = [ipaddress.ip_network(n) for n in (
"10.0.0.0/8", "172.16.0.0/12", "192.168.0.0/16", "100.64.0.0/10", "127.0.0.0/8", "169.254.0.0/16",
"0.0.0.0/8", "::1/128", "::/128", "fc00::/7", "fe80::/10")] # documentation ranges (192.0.2.0/24, 2001:db8::/32) are allowed
SPF_LOOKUP_TERMS = ("include", "a", "mx", "ptr", "exists", "redirect")
FIXES = {
"CNAME_AT_APEX": "use A/AAAA records at the apex, or your provider's ALIAS/ANAME/CNAME-flattening record",
"CNAME_WITH_OTHER_DATA": "a name with a CNAME may have no other records: move the other records or replace the CNAME with A/AAAA",
"MULTIPLE_CNAME": "keep exactly one CNAME for the name",
"MX_TO_CNAME": "point MX at a name with A/AAAA records (the CNAME's final target)",
"NS_TO_CNAME": "point NS at the name server's real host name (A/AAAA)",
"TARGET_IS_IP": "use a host name here and give that host an A/AAAA record",
"MISSING_TRAILING_DOT": "end fully qualified names with a dot (mail.example.com.) or write the relative form (mail)",
"MAYBE_MISSING_TRAILING_DOT": "if this is an outside host name, add the trailing dot",
"OWNER_DOUBLED_ORIGIN": "end the owner name with a dot or write it relative (www)",
"DANGLING_TARGET": "add the missing in-zone record or fix the target name",
"CNAME_CHAIN": "point straight at the final name; chains add lookups and break when one link changes",
"MX_TARGET_NO_ADDRESS": "add A/AAAA records for the mail host",
"NULL_MX_WITH_OTHERS": "a null MX ('0 .') must be the only MX; remove it or the others",
"SPF_MISSING": "publish one TXT \"v=spf1 ... -all\" (or ~all while testing) listing every service that sends as this domain",
"SPF_MULTIPLE": "merge into ONE v=spf1 record; two records make every SPF check fail (permerror)",
"SPF_TYPE99": "delete the SPF-type record; only the TXT record is used (RFC 7208)",
"SPF_SYNTAX": "fix the term; one bad term makes the whole record a permerror",
"SPF_PASS_ALL": "end with -all (or ~all while testing); +all lets anyone send as you",
"SPF_NEUTRAL_ALL": "use ~all or -all; ?all gives receivers no signal",
"SPF_NO_ALL": "end the record with -all or ~all (or redirect=)",
"SPF_TERMS_AFTER_ALL": "move 'all' to the end; terms after it are ignored",
"SPF_TOO_MANY_LOOKUPS": "flatten or remove includes, drop a/mx/ptr terms you do not need; nested includes count too",
"SPF_LOOKUPS_NEAR_LIMIT": "count nested includes with a live checker; they add to this number",
"SPF_PTR": "replace ptr with ip4/ip6 or include (ptr is deprecated and slow)",
"TXT_STRING_TOO_LONG": "split into quoted chunks of at most 255 characters: \"part1\" \"part2\"",
"DMARC_MISSING": "add TXT at _dmarc: \"v=DMARC1; p=none; rua=mailto:dmarc@<domain>\" then move to quarantine/reject",
"DMARC_MULTIPLE": "keep one DMARC record; with two, receivers ignore DMARC entirely",
"DMARC_SYNTAX": "start with v=DMARC1; and include p=none|quarantine|reject",
"DMARC_WRONG_NAME": "DMARC is only read from _dmarc.<domain>; move the record there",
"DMARC_MONITOR_ONLY": "after reviewing reports, move to p=quarantine, then p=reject",
"DMARC_NO_RUA": "add rua=mailto:... so you get aggregate reports",
"DMARC_PARTIAL_PCT": "raise pct to 100 once reports look clean",
"DKIM_NOT_FOUND": "publish the DKIM selector record(s) your mail provider gives you (<selector>._domainkey)",
"DKIM_WRONG_NAME": "DKIM keys live at <selector>._domainkey.<domain>",
"DKIM_REVOKED": "empty p= revokes the key; remove the record if the selector is retired, or publish the new key",
"DKIM_BAD_KEY": "copy the key again from the provider (base64, no spaces or quotes inside)",
"DKIM_WEAK_KEY": "rotate to a 2048-bit RSA key (or add an ed25519 selector alongside RSA)",
"DKIM_1024_KEY": "plan rotation to a 2048-bit key",
"NO_MAIL_POLICY": "for a domain that never sends mail: MX 0 . , TXT \"v=spf1 -all\" and _dmarc \"v=DMARC1; p=reject\"",
"NULL_MX_SPF_NOT_FAIL": "a no-mail domain should publish \"v=spf1 -all\"",
"TTL_TOO_LOW": "use 300 s or more for normal records (lower only for a planned change)",
"TTL_TOO_HIGH": "use 1 h to 1 day; above a week, mistakes take a week to undo",
"TTL_INVALID": "TTL must be 0..2147483647 seconds",
"NO_DEFAULT_TTL": "add $TTL at the top of the zone (e.g. $TTL 3600)",
"SOA_MISSING": "a zone file needs exactly one SOA at the apex",
"SOA_RNAME_AT": "write the contact as hostmaster.example.com. (first @ becomes a dot)",
"SOA_NEGATIVE_TTL_HIGH": "set the SOA minimum (negative-caching TTL) to 300-3600 s",
"NS_MISSING": "list the zone's name servers as NS records at the apex",
"NS_SINGLE": "use at least two name servers on separate networks",
"BAD_ADDRESS": "fix the address",
"WRONG_ADDRESS_FAMILY": "A takes IPv4, AAAA takes IPv6",
"PRIVATE_ADDRESS": "do not publish private/loopback addresses in a public zone (use split-horizon DNS if needed)",
"DUPLICATE_RECORD": "delete the duplicate",
"CAA_MISSING": "optional hardening: CAA 0 issue \"<your CA>\" limits who may issue certificates",
"UNKNOWN_TYPE": "check the record type spelling",
"PARSE_ERROR": "fix the line syntax",
"INCLUDE_NOT_FOLLOWED": "lint the included file separately",
}
class InputError(Exception):
pass
class Rec:
__slots__ = ("line", "name", "raw_name", "ttl", "type", "rdata", "raw")
def __init__(self, line, name, raw_name, ttl, rtype, rdata, raw):
self.line, self.name, self.raw_name, self.ttl = line, name, raw_name, ttl
self.type, self.rdata, self.raw = rtype, rdata, raw
def parse_ttl(tok):
t = tok.lower()
if t.isdigit():
return int(t)
m = re.fullmatch(r"((\d+)[wdhms])+", t)
if not m:
return None
mult = {"w": 604800, "d": 86400, "h": 3600, "m": 60, "s": 1}
return sum(int(n) * mult[u] for n, u in re.findall(r"(\d+)([wdhms])", t))
def tokenize(text):
"""Split one logical line into tokens; quoted strings keep their quotes."""
toks, i, n = [], 0, len(text)
while i < n:
c = text[i]
if c.isspace():
i += 1
elif c == '"':
j, buf = i + 1, ['"']
while j < n and text[j] != '"':
if text[j] == "\\" and j + 1 < n:
buf.append(text[j:j + 2]); j += 2; continue
buf.append(text[j]); j += 1
if j >= n:
raise InputError("unterminated quoted string")
buf.append('"'); toks.append("".join(buf)); i = j + 1
else:
j = i
while j < n and not text[j].isspace() and text[j] != '"':
j += 1
toks.append(text[i:j]); i = j
return toks
def strip_comment(line):
out, inq, i = [], False, 0
while i < len(line):
c = line[i]
if c == "\\" and i + 1 < len(line):
out.append(line[i:i + 2]); i += 2; continue
if c == '"':
inq = not inq
elif c == ";" and not inq:
break
out.append(c); i += 1
return "".join(out)
def logical_lines(text):
"""Yield (line_no, starts_with_space, content) joining ( ... ) groups."""
buf, start, depth, lead = [], 0, 0, False
for no, line in enumerate(text.splitlines(), 1):
body = strip_comment(line)
if depth == 0:
if not body.strip():
continue
start, lead, buf = no, body[:1].isspace(), []
inq = False
clean = []
for c in body:
if c == '"':
inq = not inq
if not inq and c in "()":
depth += 1 if c == "(" else -1
clean.append(" ")
continue
clean.append(c)
buf.append("".join(clean))
if depth <= 0:
depth = 0
yield start, lead, " ".join(buf)
if depth > 0:
raise InputError(f"line {start}: '(' is never closed")
def absname(raw, origin):
if raw == "@":
return origin
if raw.endswith("."):
return raw.lower()
return (raw + "." + origin).lower() if origin != "." else raw.lower() + "."
def parse_zone(text, origin, findings):
recs, last_owner, default_ttl, have_ttl_directive = [], None, None, False
for no, lead, content in logical_lines(text):
toks = tokenize(content)
if not toks:
continue
if toks[0].upper() == "$ORIGIN":
if len(toks) < 2:
raise InputError(f"line {no}: $ORIGIN needs a name")
origin = absname(toks[1], origin) if not toks[1].endswith(".") else toks[1].lower()
continue
if toks[0].upper() == "$TTL":
v = parse_ttl(toks[1]) if len(toks) > 1 else None
if v is None:
raise InputError(f"line {no}: bad $TTL")
default_ttl, have_ttl_directive = v, True
continue
if toks[0].upper() == "$INCLUDE":
add(findings, "LOW", "INCLUDE_NOT_FOLLOWED", no, "", "", f"$INCLUDE {toks[1] if len(toks) > 1 else ''} was not read")
continue
if lead:
if last_owner is None:
raise InputError(f"line {no}: record has no owner name and there is no previous one")
raw_owner = None
else:
raw_owner = toks.pop(0)
ttl, rtype = None, None
while toks:
t = toks[0]
if t.upper() in CLASSES:
toks.pop(0); continue
v = parse_ttl(t)
if v is not None and ttl is None and not t.upper() in TYPES:
ttl = v; toks.pop(0); continue
break
if not toks:
add(findings, "HIGH", "PARSE_ERROR", no, raw_owner or "", "", f"no record type in '{content.strip()}'")
continue
rtype = toks.pop(0).upper()
if rtype not in TYPES and not re.fullmatch(r"TYPE\d+", rtype):
add(findings, "MEDIUM", "UNKNOWN_TYPE", no, raw_owner or "", rtype, f"unknown record type '{rtype}'")
if raw_owner is not None:
name = absname(raw_owner, origin)
last_owner = (name, raw_owner)
name, raw_name = last_owner
recs.append(Rec(no, name, raw_name, ttl, rtype, toks, content.strip()))
return recs, origin, default_ttl, have_ttl_directive
def parse_csv(text, origin, findings):
rows = list(csv.DictReader(io.StringIO(text)))
if not rows:
raise InputError("CSV has no rows")
cols = {c.lower().strip(): c for c in rows[0].keys() if c}
for need in ("name", "type", "value"):
if need not in cols:
raise InputError(f"CSV needs columns name,type,value[,ttl][,priority] (missing '{need}')")
recs = []
base = origin.rstrip(".")
for i, r in enumerate(rows, 2):
g = lambda k: (r.get(cols[k]) or "").strip() if k in cols else ""
raw = g("name") or "@"
low = raw.lower().rstrip(".")
if raw == "@" or low == base:
name = origin
elif low.endswith("." + base):
name = low + "."
else:
name = low + "." + origin
rtype = g("type").upper()
value = g("value")
ttl = parse_ttl(g("ttl")) if g("ttl") else None
if rtype in ("TXT", "SPF"):
v = value
if not v.startswith('"'):
v = '"' + v.replace('"', '\\"') + '"'
toks = tokenize(v)
else:
toks = value.split()
if rtype in TARGET_TYPES and toks: # provider UIs show host names without the dot
idx = TARGET_TYPES[rtype]
if rtype == "MX" and len(toks) == 1:
toks = [g("priority") or "10"] + toks
if rtype == "SRV" and len(toks) == 3 and g("priority"):
toks = [g("priority")] + toks
k = len(toks) - 1 if idx == -1 else min(idx, len(toks) - 1)
if not toks[k].endswith(".") and toks[k] != "@":
toks[k] += "."
recs.append(Rec(i, name, raw, ttl, rtype, toks, ",".join(r.get(c) or "" for c in r)))
return recs, origin
def add(findings, sev, code, line, name, rtype, problem):
findings.append({"severity": sev, "code": code, "line": line, "name": name, "type": rtype,
"problem": problem, "fix": FIXES.get(code, "")})
def txt_strings(rec):
out = []
for t in rec.rdata:
if t.startswith('"') and t.endswith('"'):
out.append(re.sub(r"\\(.)", r"\1", t[1:-1]))
else:
out.append(t)
return out
def short(name, origin):
if name == origin:
return "@"
if name.endswith("." + origin):
return name[: -len(origin) - 1]
return name
def lint(text, origin=None, fmt=None, filename=""):
findings = []
if fmt is None:
fmt = "csv" if filename.lower().endswith(".csv") or text.lstrip().lower().startswith("name,") else "zone"
if origin is None:
m = re.search(r"^\$ORIGIN\s+(\S+)", text, re.M | re.I)
if m:
origin = m.group(1)
elif filename:
b = os.path.basename(filename)
for suf in (".zone", ".db", ".txt", ".csv"):
if b.lower().endswith(suf):
b = b[: -len(suf)]
for pre in ("db.",):
if b.startswith(pre):
b = b[len(pre):]
origin = b if "." in b else None
if not origin:
raise InputError("cannot tell the zone name: add $ORIGIN or pass --origin example.com")
origin = origin.lower().rstrip(".") + "."
if fmt == "csv":
recs, origin = parse_csv(text, origin, findings)
default_ttl, have_ttl = None, True
else:
recs, origin, default_ttl, have_ttl = parse_zone(text, origin, findings)
base = origin.rstrip(".")
by_name = {}
for r in recs:
by_name.setdefault(r.name, []).append(r)
types_at = lambda n: {r.type for r in by_name.get(n, [])}
in_zone = lambda n: n == origin or n.endswith("." + origin)
externals = {}
# SOA / NS / TTL
soa = [r for r in recs if r.type == "SOA"]
if fmt == "zone":
if not soa:
add(findings, "MEDIUM", "SOA_MISSING", 0, "@", "SOA", "no SOA record in the zone file")
for r in soa:
if len(r.rdata) >= 7:
rname = r.rdata[1]
if "@" in rname:
add(findings, "HIGH", "SOA_RNAME_AT", r.line, short(r.name, origin), "SOA", f"contact '{rname}' contains '@'; in DNS it is written with a dot")
neg = parse_ttl(r.rdata[6])
if neg is not None and neg > 86400:
add(findings, "LOW", "SOA_NEGATIVE_TTL_HIGH", r.line, short(r.name, origin), "SOA", f"SOA minimum {neg} s: a deleted-then-added name stays 'does not exist' in caches that long")
if default_ttl is None and neg is not None:
default_ttl = neg
else:
add(findings, "HIGH", "PARSE_ERROR", r.line, short(r.name, origin), "SOA", "SOA needs 7 fields: mname rname serial refresh retry expire minimum")
ns_apex = [r for r in by_name.get(origin, []) if r.type == "NS"]
if not ns_apex:
add(findings, "MEDIUM", "NS_MISSING", 0, "@", "NS", "no NS records at the apex")
elif len(ns_apex) == 1:
add(findings, "MEDIUM", "NS_SINGLE", ns_apex[0].line, "@", "NS", "only one name server: if it is down, the whole domain is down")
if not have_ttl:
add(findings, "LOW", "NO_DEFAULT_TTL", 0, "", "", "no $TTL directive; records without a TTL fall back to the SOA minimum or the server default")
for r in recs:
ttl = r.ttl if r.ttl is not None else default_ttl
if ttl is None:
continue
nm = short(r.name, origin)
if ttl > 2147483647:
add(findings, "HIGH", "TTL_INVALID", r.line, nm, r.type, f"TTL {ttl} is above 2147483647")
elif ttl > 604800:
add(findings, "MEDIUM", "TTL_TOO_HIGH", r.line, nm, r.type, f"TTL {ttl} s ({ttl // 86400} days): a wrong value stays cached that long")
elif ttl < 60 and not r.name.startswith("_acme-challenge."):
add(findings, "MEDIUM", "TTL_TOO_LOW", r.line, nm, r.type, f"TTL {ttl} s: extra query load, slower lookups, and many resolvers raise it anyway")
# owner names that repeat the origin
for r in recs:
if fmt == "zone" and r.raw_name not in (None, "@") and not r.raw_name.endswith(".") and \
(r.raw_name.lower() == base or r.raw_name.lower().endswith("." + base)):
add(findings, "HIGH", "OWNER_DOUBLED_ORIGIN", r.line, r.raw_name, r.type, f"owner '{r.raw_name}' has no trailing dot, so it becomes {r.name}")
# CNAME rules
for n, rs in by_name.items():
cn = [r for r in rs if r.type == "CNAME"]
if not cn:
continue
nm = short(n, origin)
if n == origin:
add(findings, "HIGH", "CNAME_AT_APEX", cn[0].line, nm, "CNAME", "CNAME at the zone apex conflicts with the SOA and NS records there; mail and other lookups break")
others = sorted({r.type for r in rs if r.type not in ("CNAME",) and r.type not in DNSSEC_TYPES})
if others and n != origin:
add(findings, "HIGH", "CNAME_WITH_OTHER_DATA", cn[0].line, nm, "CNAME", f"name has a CNAME and also {', '.join(others)}; resolvers return only the CNAME")
if len(cn) > 1:
add(findings, "HIGH", "MULTIPLE_CNAME", cn[1].line, nm, "CNAME", f"{len(cn)} CNAME records for one name")
# targets
for r in recs:
if r.type not in TARGET_TYPES or not r.rdata:
continue
idx = TARGET_TYPES[r.type]
if r.type == "MX" and len(r.rdata) < 2 or r.type == "SRV" and len(r.rdata) < 4:
add(findings, "HIGH", "PARSE_ERROR", r.line, short(r.name, origin), r.type, f"{r.type} needs " + ("preference and host" if r.type == "MX" else "priority weight port target"))
continue
raw = r.rdata[idx] if idx >= 0 else r.rdata[-1]
nm = short(r.name, origin)
if r.type == "MX" and raw == ".":
continue
try:
ipaddress.ip_address(raw.rstrip("."))
add(findings, "HIGH", "TARGET_IS_IP", r.line, nm, r.type, f"{r.type} target '{raw}' is an IP address; {r.type} must name a host")
continue
except ValueError:
pass
tgt = absname(raw, origin)
if fmt == "zone" and raw != "@" and not raw.endswith("."):
low = raw.lower()
if low == base or low.endswith("." + base):
add(findings, "HIGH", "MISSING_TRAILING_DOT", r.line, nm, r.type, f"'{raw}' has no trailing dot, so it means {absname(raw, origin)}")
tgt = low + "." # check the name that was meant
elif "." in low and low.rsplit(".", 1)[1] in COMMON_TLDS:
add(findings, "MEDIUM", "MAYBE_MISSING_TRAILING_DOT", r.line, nm, r.type, f"'{raw}' looks like a full host name but has no trailing dot, so it means {absname(raw, origin)}")
tgt = low + "."
if in_zone(tgt):
tt = types_at(tgt)
if r.type in ("MX", "NS", "SRV") and "CNAME" in tt:
code = {"MX": "MX_TO_CNAME", "NS": "NS_TO_CNAME", "SRV": "MX_TO_CNAME"}[r.type]
add(findings, "HIGH", code, r.line, nm, r.type, f"{r.type} target {short(tgt, origin)} is a CNAME (not allowed, RFC 2181 10.3)")
elif r.type == "CNAME" and "CNAME" in tt:
add(findings, "LOW", "CNAME_CHAIN", r.line, nm, r.type, f"CNAME to {short(tgt, origin)}, which is itself a CNAME")
elif not tt:
# wildcard or a deeper/glue name may exist elsewhere; only flag when no wildcard covers it
wild = "*." + tgt.split(".", 1)[1] if "." in tgt else ""
if wild not in by_name:
add(findings, "MEDIUM", "DANGLING_TARGET", r.line, nm, r.type, f"{r.type} target {short(tgt, origin)} has no records in this zone")
elif r.type == "MX" and not (tt & {"A", "AAAA"}):
add(findings, "MEDIUM", "MX_TARGET_NO_ADDRESS", r.line, nm, r.type, f"mail host {short(tgt, origin)} has no A/AAAA record")
else:
externals.setdefault(tgt, []).append(f"{nm} {r.type} (line {r.line})")
# addresses
for r in recs:
if r.type not in ("A", "AAAA") or not r.rdata:
continue
nm = short(r.name, origin)
try:
ip = ipaddress.ip_address(r.rdata[0])
except ValueError:
add(findings, "HIGH", "BAD_ADDRESS", r.line, nm, r.type, f"'{r.rdata[0]}' is not an IP address")
continue
if (r.type == "A") != (ip.version == 4):
add(findings, "HIGH", "WRONG_ADDRESS_FAMILY", r.line, nm, r.type, f"{r.type} record holds an IPv{ip.version} address")
elif any(ip in n for n in INTERNAL_NETS if n.version == ip.version):
add(findings, "MEDIUM", "PRIVATE_ADDRESS", r.line, nm, r.type, f"{ip} is a private/loopback address; outside users cannot reach it and it reveals internal layout")
# duplicates
seen = {}
for r in recs:
key = (r.name, r.type, " ".join(x.lower() for x in r.rdata))
if key in seen:
add(findings, "LOW", "DUPLICATE_RECORD", r.line, short(r.name, origin), r.type, f"same as line {seen[key]}")
else:
seen[key] = r.line
# TXT string length (zone files only: each quoted string max 255)
if fmt == "zone":
for r in recs:
if r.type in ("TXT", "SPF"):
for s in txt_strings(r):
if len(s.encode()) > 255:
add(findings, "HIGH", "TXT_STRING_TOO_LONG", r.line, short(r.name, origin), r.type, f"one quoted string is {len(s.encode())} bytes (max 255); the server rejects the zone or truncates it")
break
# mail: MX, SPF, DMARC, DKIM
txt_by_name = {}
for r in recs:
if r.type == "TXT":
txt_by_name.setdefault(r.name, []).append((r, "".join(txt_strings(r))))
for r in recs:
if r.type == "SPF":
add(findings, "LOW", "SPF_TYPE99", r.line, short(r.name, origin), "SPF", "SPF-type (99) record is obsolete and ignored")
spf_at = {}
for n, items in txt_by_name.items():
for r, s in items:
if re.match(r"(?i)v=spf1(\s|$)", s):
spf_at.setdefault(n, []).append((r, s))
if re.match(r"(?i)v=dmarc1", s) and not n.startswith("_dmarc."):
add(findings, "HIGH", "DMARC_WRONG_NAME", r.line, short(n, origin), "TXT", "DMARC record is not at _dmarc.<domain>, so receivers never see it")
if re.match(r"(?i)v=dkim1", s) and "._domainkey." not in "." + n:
add(findings, "HIGH", "DKIM_WRONG_NAME", r.line, short(n, origin), "TXT", "DKIM key is not under <selector>._domainkey, so signatures cannot be verified")
for n, items in spf_at.items():
nm = short(n, origin)
if len(items) > 1:
add(findings, "HIGH", "SPF_MULTIPLE", items[1][0].line, nm, "TXT", f"{len(items)} v=spf1 records at this name (lines {', '.join(str(i[0].line) for i in items)})")
for r, s in items:
check_spf(findings, r, s, nm)
mx_names = {}
for r in recs:
if r.type == "MX" and len(r.rdata) >= 2:
mx_names.setdefault(r.name, []).append(r)
for n, mxs in mx_names.items():
nulls = [r for r in mxs if r.rdata[1] == "."]
if nulls and len(mxs) > 1:
add(findings, "HIGH", "NULL_MX_WITH_OTHERS", nulls[0].line, short(n, origin), "MX", "null MX ('0 .') next to other MX records")
apex_mx = [r for r in mx_names.get(origin, []) if r.rdata[1] != "."]
apex_null = any(r.rdata[1] == "." for r in mx_names.get(origin, []))
apex_spf = spf_at.get(origin, [])
spf_sends = any(not re.fullmatch(r"(?i)v=spf1\s+-all", s.strip()) for _, s in apex_spf)
sends_mail = bool(apex_mx) or spf_sends
for n, mxs in mx_names.items():
if any(r.rdata[1] != "." for r in mxs) and n not in spf_at:
add(findings, "MEDIUM", "SPF_MISSING", mxs[0].line, short(n, origin), "TXT", "name receives mail (MX) but publishes no SPF record")
if apex_null and apex_spf and spf_sends:
add(findings, "LOW", "NULL_MX_SPF_NOT_FAIL", apex_spf[0][0].line, "@", "TXT", "null MX says no mail, but SPF still authorizes senders")
if apex_null and not apex_spf:
add(findings, "LOW", "NULL_MX_SPF_NOT_FAIL", 0, "@", "TXT", "null MX but no \"v=spf1 -all\"")
dm = [(r, s) for r, s in txt_by_name.get("_dmarc." + origin, []) if re.match(r"(?i)v=dmarc1", s.strip()) or "p=" in s.lower()]
dkim_names = [n for n in by_name if n.endswith("._domainkey." + origin)]
if sends_mail or apex_null:
if not dm:
add(findings, "MEDIUM", "DMARC_MISSING", 0, "_dmarc", "TXT", "no DMARC record: receivers cannot tell spoofed mail from yours, and Gmail/Yahoo require DMARC for bulk senders")
if dm:
if len(dm) > 1:
add(findings, "HIGH", "DMARC_MULTIPLE", dm[1][0].line, "_dmarc", "TXT", f"{len(dm)} DMARC records")
for r, s in dm:
check_dmarc(findings, r, s)
if sends_mail and not dkim_names:
add(findings, "MEDIUM", "DKIM_NOT_FOUND", 0, "*._domainkey", "TXT", "no <selector>._domainkey record: if you send mail, it is probably unsigned (checked only names in this file)")
for n in dkim_names:
for r in by_name[n]:
if r.type == "TXT":
check_dkim(findings, r, "".join(txt_strings(r)), short(n, origin))
if not sends_mail and not apex_null and not apex_spf:
add(findings, "LOW", "NO_MAIL_POLICY", 0, "@", "MX", "no MX and no SPF: if this domain never sends mail, say so, or spammers can spoof it freely")
has_web = any(r.type in ("A", "AAAA", "CNAME", "ALIAS", "ANAME") for r in recs)
if has_web and "CAA" not in types_at(origin):
add(findings, "LOW", "CAA_MISSING", 0, "@", "CAA", "no CAA record: any public CA may issue certificates for this domain")
order = {s: i for i, s in enumerate(reversed(SEVERITIES))}
findings.sort(key=lambda f: (f["line"] if f["line"] else 10 ** 6, order[f["severity"]], f["code"]))
return {"origin": origin, "format": fmt, "records": len(recs), "findings": findings,
"external_targets": [{"target": t, "used_by": u} for t, u in sorted(externals.items())]}
def check_spf(findings, r, s, nm):
terms = s.split()[1:]
lookups, seen_all = 0, None
for i, t in enumerate(terms):
q = t[0] if t[0] in "+-~?" else ""
body = t[len(q):].lower()
mech = re.split(r"[:=/]", body, maxsplit=1)[0]
if seen_all is not None and not body.startswith("exp="):
add(findings, "MEDIUM", "SPF_TERMS_AFTER_ALL", r.line, nm, "TXT", f"'{t}' comes after 'all' and is ignored")
seen_all = None
if mech == "all":
if q in ("", "+"):
add(findings, "HIGH", "SPF_PASS_ALL", r.line, nm, "TXT", f"'{t}' authorizes every server on the internet to send as this domain")
elif q == "?":
add(findings, "MEDIUM", "SPF_NEUTRAL_ALL", r.line, nm, "TXT", "'?all' is neutral: unauthorized senders are not marked")
seen_all = i
continue
if mech in ("include", "exists"):
if ":" not in body or not body.split(":", 1)[1]:
add(findings, "HIGH", "SPF_SYNTAX", r.line, nm, "TXT", f"'{t}' needs a domain ({mech}:example.net)")
lookups += 1
elif mech in ("a", "mx"):
lookups += 1
elif mech == "ptr":
lookups += 1
add(findings, "LOW", "SPF_PTR", r.line, nm, "TXT", "'ptr' is deprecated (RFC 7208 5.5)")
elif mech in ("ip4", "ip6"):
val = body.split(":", 1)[1] if ":" in body else ""
try:
net = ipaddress.ip_network(val, strict=False)
if (mech == "ip4") != (net.version == 4):
raise ValueError
except ValueError:
add(findings, "HIGH", "SPF_SYNTAX", r.line, nm, "TXT", f"'{t}' is not a valid {mech} address or range")
elif mech == "redirect":
lookups += 1
if "=" not in body:
add(findings, "HIGH", "SPF_SYNTAX", r.line, nm, "TXT", f"'{t}': use redirect=domain")
elif mech == "exp":
pass
else:
add(findings, "HIGH", "SPF_SYNTAX", r.line, nm, "TXT", f"unknown SPF term '{t}' (typo? e.g. ipv4: for ip4:, include= for include:)")
if not any(re.sub(r"^[+\-~?]", "", t).lower() == "all" for t in terms) and not any(t.lower().startswith("redirect=") for t in terms):
add(findings, "MEDIUM", "SPF_NO_ALL", r.line, nm, "TXT", "record has no 'all' or redirect=, so unlisted senders get a neutral result")
if lookups > 10:
add(findings, "HIGH", "SPF_TOO_MANY_LOOKUPS", r.line, nm, "TXT", f"{lookups} DNS-lookup terms at the top level alone (limit 10, RFC 7208 4.6.4); receivers return permerror")
elif lookups >= 8:
add(findings, "LOW", "SPF_LOOKUPS_NEAR_LIMIT", r.line, nm, "TXT", f"{lookups} lookup terms before counting nested includes (limit 10)")
def check_dmarc(findings, r, s):
tags = {}
parts = [p.strip() for p in s.split(";") if p.strip()]
if not parts or parts[0].replace(" ", "").upper() != "V=DMARC1":
add(findings, "HIGH", "DMARC_SYNTAX", r.line, "_dmarc", "TXT", "record must start with 'v=DMARC1;'")
for p in parts:
k, _, v = p.partition("=")
tags[k.strip().lower()] = v.strip()
p = tags.get("p", "").lower()
if p not in ("none", "quarantine", "reject"):
add(findings, "HIGH", "DMARC_SYNTAX", r.line, "_dmarc", "TXT", "missing or invalid p= (none, quarantine or reject); receivers ignore the record")
return
if p == "none":
add(findings, "LOW", "DMARC_MONITOR_ONLY", r.line, "_dmarc", "TXT", "p=none only monitors; spoofed mail is still delivered")
if "rua" not in tags:
add(findings, "LOW", "DMARC_NO_RUA", r.line, "_dmarc", "TXT", "no rua= address, so nobody sees the aggregate reports")
if tags.get("pct", "100").isdigit() and int(tags.get("pct", "100")) < 100:
add(findings, "LOW", "DMARC_PARTIAL_PCT", r.line, "_dmarc", "TXT", f"pct={tags['pct']}: the policy applies to only part of the failing mail")
def check_dkim(findings, r, s, nm):
tags = {}
for p in s.split(";"):
k, _, v = p.strip().partition("=")
if k:
tags[k.strip().lower()] = re.sub(r"\s+", "", v)
if "p" not in tags:
add(findings, "HIGH", "DKIM_BAD_KEY", r.line, nm, "TXT", "no p= tag: not a DKIM key record")
return
if tags["p"] == "":
add(findings, "MEDIUM", "DKIM_REVOKED", r.line, nm, "TXT", "p= is empty: this selector is revoked and mail signed with it fails DKIM")
return
try:
raw = base64.b64decode(tags["p"], validate=True)
except Exception:
add(findings, "HIGH", "DKIM_BAD_KEY", r.line, nm, "TXT", "p= is not valid base64 (stray quote, space or cut-off copy?)")
return
if tags.get("k", "rsa").lower() == "ed25519":
return
bits = rsa_bits(raw)
if bits is None:
add(findings, "HIGH", "DKIM_BAD_KEY", r.line, nm, "TXT", f"p= decodes to {len(raw)} bytes but is not an RSA public key (cut off?)")
elif bits < 1024:
add(findings, "HIGH", "DKIM_WEAK_KEY", r.line, nm, "TXT", f"RSA key is {bits} bits; keys under 1024 bits are rejected by receivers (RFC 8301)")
elif bits < 2048:
add(findings, "LOW", "DKIM_1024_KEY", r.line, nm, "TXT", f"RSA key is {bits} bits; 2048 is the current recommendation")
def der_read(b, i):
tag = b[i]; i += 1
ln = b[i]; i += 1
if ln & 0x80:
n = ln & 0x7F
ln = int.from_bytes(b[i:i + n], "big"); i += n
return tag, i, ln
def rsa_bits(raw):
"""Modulus size of an RSA SubjectPublicKeyInfo (or bare RSAPublicKey) in bits."""
try:
tag, i, ln = der_read(raw, 0)
if tag != 0x30:
return None
tag, j, l2 = der_read(raw, i)
if tag == 0x30: # SubjectPublicKeyInfo: algorithm, then BIT STRING
j += l2
tag, j, l3 = der_read(raw, j)
if tag != 0x03:
return None
j += 1 # unused-bits byte
tag, j, l4 = der_read(raw, j)
if tag != 0x30:
return None
tag, j, lm = der_read(raw, j)
elif tag == 0x02:
lm = l2
else:
return None
if tag != 0x02 or j + lm > len(raw):
return None
mod = raw[j:j + lm].lstrip(b"\x00")
return len(mod) * 8 if mod else None
except IndexError:
return None
def render(res, title, min_sev="LOW", ignore=()):
keep = [f for f in res["findings"] if SEVERITIES.index(f["severity"]) >= SEVERITIES.index(min_sev) and f["code"] not in ignore]
cnt = {s: sum(1 for f in keep if f["severity"] == s) for s in SEVERITIES}
out = [f"# DNS record lint: {title}", "",
f"Zone: {res['origin']} Format: {res['format']} Records: {res['records']} Findings: {len(keep)} (HIGH {cnt['HIGH']}, MEDIUM {cnt['MEDIUM']}, LOW {cnt['LOW']})", ""]
if keep:
out += ["| Sev | Code | Line | Name | Type | Problem | Fix |", "|---|---|---|---|---|---|---|"]
for f in keep:
out.append(f"| {f['severity']} | {f['code']} | {f['line'] or '-'} | {f['name'] or '-'} | {f['type'] or '-'} | {f['problem']} | {f['fix']} |")
else:
out.append("No findings.")
if res["external_targets"]:
out += ["", "## Out-of-zone targets to check live (no network calls were made)", "",
"| Target | Used by |", "|---|---|"]
for e in res["external_targets"]:
out.append(f"| {e['target']} | {'; '.join(e['used_by'])} |")
return "\n".join(out) + "\n", keep
def self_test():
Z = "$ORIGIN example.com.\n$TTL 3600\n@ IN SOA ns1 hostmaster 1 7200 900 1209600 300\n@ NS ns1\n@ NS ns2.example.net.\nns1 A 192.0.2.53\n"
MAIL = '@ MX 10 mail\nmail A 192.0.2.25\n@ TXT "v=spf1 mx -all"\n_dmarc TXT "v=DMARC1; p=reject; rua=mailto:d@example.com"\ns1._domainkey CNAME s1.dkim.example.net.\n@ CAA 0 issue "letsencrypt.org"\n'
k1024 = base64.b64encode(bytes.fromhex("30819f300d06092a864886f70d010101050003818d0030818902818100") + b"\xc1" + bytes(127) + bytes.fromhex("0203010001")).decode()
k512 = base64.b64encode(bytes.fromhex("305c300d06092a864886f70d0101010500034b003048024100") + b"\xc1" + bytes(63) + bytes.fromhex("0203010001")).decode()
def codes(text, **kw):
return [f["code"] for f in lint(text, **kw)["findings"]]
cases = [
("clean zone", Z + MAIL, lambda c: c == []),
("cname at apex", Z + MAIL + "@ CNAME shop.example.net.\n", lambda c: "CNAME_AT_APEX" in c),
("cname with other data", Z + MAIL + "www CNAME web.example.net.\nwww TXT \"x\"\n", lambda c: "CNAME_WITH_OTHER_DATA" in c),
("multiple cname", Z + MAIL + "www CNAME a.example.net.\nwww CNAME b.example.net.\n", lambda c: "MULTIPLE_CNAME" in c),
("mx to cname", Z + MAIL.replace("mail A 192.0.2.25", "mail CNAME mx.example.net."), lambda c: "MX_TO_CNAME" in c),
("ns to cname", Z.replace("ns1 A 192.0.2.53", "ns1 CNAME dns.example.net.") + MAIL, lambda c: "NS_TO_CNAME" in c),
("mx is ip", Z + MAIL.replace("MX 10 mail", "MX 10 192.0.2.25"), lambda c: "TARGET_IS_IP" in c),
("missing trailing dot", Z + MAIL + "www CNAME web.example.com\nweb A 192.0.2.80\n", lambda c: "MISSING_TRAILING_DOT" in c),
("maybe missing dot (outside name)", Z + MAIL + "shop CNAME shops.myshopify.com\n", lambda c: "MAYBE_MISSING_TRAILING_DOT" in c),
("owner doubled origin", Z + MAIL + "www.example.com A 192.0.2.80\n", lambda c: "OWNER_DOUBLED_ORIGIN" in c),
("relative target ok", Z + MAIL + "www CNAME web\nweb A 192.0.2.80\n", lambda c: c == []),
("dangling target", Z + MAIL + "www CNAME web\n", lambda c: "DANGLING_TARGET" in c),
("cname chain", Z + MAIL + "www CNAME web\nweb CNAME edge.example.net.\n", lambda c: "CNAME_CHAIN" in c),
("mx target no address", Z + MAIL.replace("mail A 192.0.2.25", "mail TXT \"x\""), lambda c: "MX_TARGET_NO_ADDRESS" in c),
("spf missing", Z + MAIL.replace('@ TXT "v=spf1 mx -all"\n', ""), lambda c: "SPF_MISSING" in c),
("spf multiple", Z + MAIL + '@ TXT "v=spf1 include:_spf.google.com ~all"\n', lambda c: "SPF_MULTIPLE" in c),
("spf +all", Z + MAIL.replace("mx -all", "mx +all"), lambda c: "SPF_PASS_ALL" in c),
("spf ?all", Z + MAIL.replace("mx -all", "mx ?all"), lambda c: "SPF_NEUTRAL_ALL" in c),
("spf no all", Z + MAIL.replace("mx -all", "mx"), lambda c: "SPF_NO_ALL" in c),
("spf terms after all", Z + MAIL.replace("mx -all", "-all mx"), lambda c: "SPF_TERMS_AFTER_ALL" in c),
("spf syntax typo", Z + MAIL.replace("mx -all", "ipv4:192.0.2.1 -all"), lambda c: "SPF_SYNTAX" in c),
("spf bad ip4", Z + MAIL.replace("mx -all", "ip4:300.1.1.1 -all"), lambda c: "SPF_SYNTAX" in c),
("spf too many lookups", Z + MAIL.replace("mx -all", " ".join(f"include:s{i}.example.net" for i in range(11)) + " -all"), lambda c: "SPF_TOO_MANY_LOOKUPS" in c),
("spf near limit", Z + MAIL.replace("mx -all", " ".join(f"include:s{i}.example.net" for i in range(8)) + " -all"), lambda c: "SPF_LOOKUPS_NEAR_LIMIT" in c and "SPF_TOO_MANY_LOOKUPS" not in c),
("spf ptr", Z + MAIL.replace("mx -all", "ptr -all"), lambda c: "SPF_PTR" in c),
("spf type99", Z + MAIL + '@ SPF "v=spf1 mx -all"\n', lambda c: "SPF_TYPE99" in c),
("split txt strings joined", Z + MAIL.replace('"v=spf1 mx -all"', '"v=spf1 mx " "-all"'), lambda c: c == []),
("txt string too long", Z + MAIL + '@ TXT "' + "a" * 300 + '"\n', lambda c: "TXT_STRING_TOO_LONG" in c),
("dmarc missing", Z + MAIL.replace('_dmarc TXT "v=DMARC1; p=reject; rua=mailto:d@example.com"\n', ""), lambda c: "DMARC_MISSING" in c),
("dmarc wrong name", Z + MAIL.replace("_dmarc TXT", "dmarc TXT"), lambda c: "DMARC_WRONG_NAME" in c and "DMARC_MISSING" in c),
("dmarc multiple", Z + MAIL + '_dmarc TXT "v=DMARC1; p=none"\n', lambda c: "DMARC_MULTIPLE" in c),
("dmarc no p", Z + MAIL.replace("p=reject; ", ""), lambda c: "DMARC_SYNTAX" in c),
("dmarc none + no rua + pct", Z + MAIL.replace("p=reject; rua=mailto:d@example.com", "p=none; pct=50"), lambda c: {"DMARC_MONITOR_ONLY", "DMARC_NO_RUA", "DMARC_PARTIAL_PCT"} <= set(c)),
("dkim not found", Z + MAIL.replace("s1._domainkey CNAME s1.dkim.example.net.\n", ""), lambda c: "DKIM_NOT_FOUND" in c),
("dkim revoked", Z + MAIL + 's2._domainkey TXT "v=DKIM1; k=rsa; p="\n', lambda c: "DKIM_REVOKED" in c),
("dkim bad base64", Z + MAIL + 's2._domainkey TXT "v=DKIM1; p=MIGf!!"\n', lambda c: "DKIM_BAD_KEY" in c),
("dkim 512-bit key", Z + MAIL + f's2._domainkey TXT "v=DKIM1; k=rsa; p={k512}"\n', lambda c: "DKIM_WEAK_KEY" in c),
("dkim 1024-bit key", Z + MAIL + f's2._domainkey TXT "v=DKIM1; k=rsa; p={k1024}"\n', lambda c: "DKIM_1024_KEY" in c),
("dkim wrong name", Z + MAIL + f's2.domainkey TXT "v=DKIM1; p={k1024}"\n', lambda c: "DKIM_WRONG_NAME" in c),
("null mx + spf -all, no mail checks", Z + '@ MX 0 .\n@ TXT "v=spf1 -all"\n_dmarc TXT "v=DMARC1; p=reject; rua=mailto:d@example.com"\n@ CAA 0 issue "letsencrypt.org"\n', lambda c: c == []),
("null mx with others", Z + MAIL + "@ MX 0 .\n", lambda c: "NULL_MX_WITH_OTHERS" in c),
("no mail policy", Z + '@ CAA 0 issue "letsencrypt.org"\n', lambda c: "NO_MAIL_POLICY" in c),
("ttl too low", Z + MAIL + "www 30 A 192.0.2.80\n", lambda c: "TTL_TOO_LOW" in c),
("acme ttl low ok", Z + MAIL + '_acme-challenge 30 TXT "token"\n', lambda c: c == []),
("ttl too high (units)", Z + MAIL + "www 2w A 192.0.2.80\n", lambda c: "TTL_TOO_HIGH" in c),
("no $TTL", Z.replace("$TTL 3600\n", "") + MAIL, lambda c: "NO_DEFAULT_TTL" in c),
("soa rname with @", Z.replace("hostmaster", "hostmaster@example.com.") + MAIL, lambda c: "SOA_RNAME_AT" in c),
("soa multi-line with comments", Z.replace("@ IN SOA ns1 hostmaster 1 7200 900 1209600 300", "@ IN SOA ns1 hostmaster (\n 2026103001 ; serial\n 7200 900 1209600\n 300 ) ; min") + MAIL, lambda c: c == []),
("single ns", Z.replace("@ NS ns2.example.net.\n", "") + MAIL, lambda c: "NS_SINGLE" in c),
("bad address", Z + MAIL + "www A 192.0.2.300\n", lambda c: "BAD_ADDRESS" in c),
("wrong family", Z + MAIL + "www AAAA 192.0.2.80\n", lambda c: "WRONG_ADDRESS_FAMILY" in c),
("private address", Z + MAIL + "intranet A 10.0.0.5\n", lambda c: "PRIVATE_ADDRESS" in c),
("duplicate record", Z + MAIL + "www A 192.0.2.80\nwww A 192.0.2.80\n", lambda c: "DUPLICATE_RECORD" in c),
("blank owner continues", Z + MAIL + "www A 192.0.2.80\n AAAA 2001:db8::80\n", lambda c: c == []),
("semicolon inside quotes kept", Z + MAIL.replace('"v=DMARC1; p=reject; rua=mailto:d@example.com"', '"v=DMARC1; p=reject; rua=mailto:d@example.com" ; comment'), lambda c: c == []),
("caa missing", Z + MAIL.replace('@ CAA 0 issue "letsencrypt.org"\n', ""), lambda c: c == ["CAA_MISSING"]),
("csv input", None, None),
("unterminated quote is input error", None, None),
]
passed = 0
for name, text, check in cases:
try:
if name == "csv input":
csvt = ("name,type,value,ttl,priority\n@,MX,mail.example.com,3600,10\nmail,A,192.0.2.25,3600,\n"
"@,TXT,v=spf1 include:_spf.google.com ~all,3600,\n@,TXT,v=spf1 mx -all,3600,\n"
"www.example.com,CNAME,example.com,300,\n@,CNAME,shop.example.net,300,\n")
res = lint(csvt, origin="example.com", fmt="csv")
c = [f["code"] for f in res["findings"]]
ok = {"SPF_MULTIPLE", "CNAME_AT_APEX", "DMARC_MISSING", "DKIM_NOT_FOUND"} <= set(c) and "MISSING_TRAILING_DOT" not in c and "MX_TO_CNAME" not in c
elif name == "unterminated quote is input error":
try:
lint(Z + '@ TXT "v=spf1 -all\n')
ok, c = False, "no error"
except InputError as e:
ok, c = True, str(e)
else:
c = codes(text)
ok = check(c)
except Exception as e: # noqa
ok, c = False, f"exception {e!r}"
passed += ok
print(("PASS " if ok else "FAIL ") + name + ("" if ok else f" got {c}"))
print(f"{passed}/{len(cases)} passed")
return 0 if passed == len(cases) else 1
def main(argv=None):
ap = argparse.ArgumentParser(description="Lint a DNS zone file or record list (offline)")
ap.add_argument("file", nargs="?")
ap.add_argument("--origin", help="zone name, e.g. example.com (default: $ORIGIN or the file name)")
ap.add_argument("--format", choices=["zone", "csv"], help="input format (default: by extension/content)")
ap.add_argument("--json", action="store_true")
ap.add_argument("--min-severity", default="LOW", choices=SEVERITIES)
ap.add_argument("--ignore", default="", help="comma-separated finding codes to skip")
ap.add_argument("--self-test", action="store_true")
a = ap.parse_args(argv)
if a.self_test:
return self_test()
if not a.file:
ap.error("give a zone file or CSV, or --self-test")
try:
with open(a.file, encoding="utf-8") as fh:
text = fh.read()
res = lint(text, origin=a.origin, fmt=a.format, filename=a.file)
except (OSError, InputError, UnicodeDecodeError) as e:
print(f"error: {e}", file=sys.stderr)
return 2
ignore = {c.strip().upper() for c in a.ignore.split(",") if c.strip()}
md, keep = render(res, os.path.basename(a.file), a.min_severity, ignore)
if a.json:
print(json.dumps({**res, "findings": keep}, indent=2))
else:
sys.stdout.write(md)
return 1 if any(f["severity"] == "HIGH" for f in keep) else 0
if __name__ == "__main__":
sys.exit(main())Xây dựng lịch kiểm tra tưới cây trong nhà từ danh sách các loại cây cùng kích thước và chất liệu chậu, điều kiện ánh sáng, khả năng thoát nước và ngày tưới gần nhất. Điều chỉnh từng khoảng thời gian chờ theo loại chậu, ánh sáng, độ ẩm và mùa (theo bán cầu, giãn cách dài hơn vào mùa đông), sắp xếp lịch kiểm tra vào các ngày cố định trong tuần đã chọn, giải thích rõ thế nào là 'cần tưới nước' và lượng nước cần tưới bao nhiêu, đồng thời cảnh báo các rủi ro như chậu không có lỗ thoát nước. Bao gồm bộ lập lịch bằng Python sử dụng thư viện chuẩn (stdlib) có tính năng xuất tệp .ics và --self-test.
---
name: houseplant-watering-schedule-planner
description: Xây dựng lịch kiểm tra tưới cây trong nhà từ danh sách các loại cây cùng kích thước và chất liệu chậu, điều kiện ánh sáng, khả năng thoát nước và ngày tưới gần nhất. Điều chỉnh từng khoảng thời gian chờ theo loại chậu, ánh sáng, độ ẩm và mùa (theo bán cầu, giãn cách dài hơn vào mùa đông), sắp xếp lịch kiểm tra vào các ngày cố định trong tuần đã chọn, giải thích rõ thế nào là 'cần tưới nước' và lượng nước cần tưới bao nhiêu, đồng thời cảnh báo các rủi ro như chậu không có lỗ thoát nước. Bao gồm bộ lập lịch bằng Python sử dụng thư viện chuẩn (stdlib) có tính năng xuất tệp .ics và --self-test.
---

# Công Cụ Lập Lịch Tưới Cây Trong Nhà

Bạn giúp mọi người giữ cho cây trồng trong nhà luôn tươi tốt mà không chỉ tưới máy móc theo lịch. Kế hoạch sẽ cho họ biết khi nào cần **kiểm tra** từng cây và cần quan sát dấu hiệu gì; họ chỉ tưới nước khi quy tắc riêng của cây đó báo đã đến lúc. Bạn điều chỉnh linh hoạt theo điều kiện thực tế (chậu cây, ánh sáng, hệ thống sưởi, mùa trong năm), giữ cho thói quen thật đơn giản (hai ngày kiểm tra cố định mỗi tuần nếu họ muốn), và chỉ ra những cách bố trí gây chết cây nhiều nhất: chậu không có lỗ thoát nước, cây mọng nước đặt ở góc tối, cây dương xỉ bị khô kiệt trong chậu đất nung (terracotta).

## Các tệp trong kỹ năng này

- `scripts/watering_planner.py` - đọc tệp CSV danh sách cây, gán cho mỗi cây một nhóm nhu cầu nước, tính toán khoảng thời gian giữa các lần kiểm tra theo mùa, tạo lịch trình (có tùy chọn khớp vào các ngày cố định trong tuần), ước tính lượng nước cho mỗi cây, gắn cờ cảnh báo các cách trồng rủi ro, và có thể xuất ra tệp .ics (chỉ dùng thư viện chuẩn của Python 3.8+)
- `references/plant-water-profiles.md` - sáu nhóm nhu cầu tưới nước, các loại cây phổ biến trong từng nhóm, cách kiểm tra "cần tưới nước" cũng như dấu hiệu tưới quá nhiều hoặc quá ít nước
- `references/adjustment-factors.md` - cách kích thước chậu, chất liệu chậu, ánh sáng, độ ẩm, mùa và khả năng thoát nước làm thay đổi khoảng cách giữa các lần kiểm tra, kèm theo các hệ số nhân mà kịch bản sử dụng và cách tinh chỉnh chúng sau vài tuần
- `templates/watering-plan.md` - bản kế hoạch dài một trang để gửi lại cho người dùng (lịch trình hàng tuần, bảng tóm tắt nhanh cho từng cây, các cảnh báo, ngày đánh giá lại)
- `examples/plants.csv` - mười chậu cây trong một căn hộ có bật sưởi vào thời điểm cuối tháng Mười
- `examples/plan-output.md` - kết quả đầu ra thực tế của bộ lập lịch cho danh sách cây đó

## Quy trình thực hiện

### 1. Thu thập danh sách cây trồng
Đối với mỗi cây: tên gọi, loại cây (tên loài hoặc mô tả kiểu "trông giống cây mọng nước"), đường kính chậu tính bằng cm, chất liệu chậu (nhựa, gốm tráng men, đất nung terracotta, vải trồng cây, chậu tự tưới), mức độ ánh sáng tại vị trí đặt cây (thấp = xa cửa sổ, trung bình, sáng = ánh sáng gián tiếp mạnh, trực tiếp = nắng chiếu thẳng lên lá hàng giờ liền), chậu có lỗ thoát nước hay không, và lần tưới nước gần nhất là khi nào. Hãy hỏi thêm về bán cầu nơi họ sống, căn nhà có đang bật sưởi hay không (không khí khô), và những ngày nào trong tuần thuận tiện cho việc kiểm tra nhanh. Nếu không rõ tên cây, hãy yêu cầu mô tả qua ảnh hoặc xếp tạm vào nhóm "top_dry" (khô lớp đất mặt) và nói rõ giả định đó.

### 2. Chạy bộ lập lịch
```
python3 scripts/watering_planner.py examples/plants.csv --start 2026-10-30 --weeks 6 --check-days Mon,Thu --humidity low
python3 scripts/watering_planner.py plants.csv --hemisphere south --weeks 8 --ics plants.ics
python3 scripts/watering_planner.py plants.csv --json
python3 scripts/watering_planner.py --self-test
```
Mã thoát 0 = đã tạo xong kế hoạch, 1 = đã tạo kế hoạch nhưng có cảnh báo mức HIGH cần xử lý ngay (ví dụ: không có lỗ thoát nước), 2 = dữ liệu đầu vào không hợp lệ (chất liệu hoặc mức ánh sáng không xác định, kích thước chậu tính bằng mm, định dạng ngày sai). Nếu không chạy mã, hãy tự tra bảng phân loại và tính theo các hệ số nhân trong tài liệu tham chiếu.

### 3. Kiểm tra kết quả trước khi bàn giao
- Mỗi cây đều có một khoảng cách kiểm tra ở thời điểm hiện tại và, nếu kế hoạch kéo dài sang mùa tiếp theo, khoảng cách mới tương ứng (ví dụ: "7 d (winter: 9 d)").
- Những loại cây ưa ẩm liên tục (dương xỉ, đuôi công calathea, lan ý, húng quế) có thể cần nhiều ngày kiểm tra hơn số ngày cố định trong lịch trình; bộ lập lịch sẽ chỉ rõ điều này. Hãy gợi ý thêm ngày kiểm tra thứ ba, đổi sang chậu nhựa, hoặc dùng chậu tự tưới riêng cho những cây này.
- "Overdue" (Quá hạn) có nghĩa là thời điểm tưới lần cuối cộng với khoảng cách kiểm tra đã trôi qua: hãy kiểm tra cây đó đầu tiên.
- Đọc kỹ các cảnh báo và đưa những cảnh báo mức HIGH thành hành động ưu tiên hàng đầu trong kế hoạch.

### 4. Bàn giao kết quả
Điền vào `templates/watering-plan.md`: lịch trình hàng tuần (kiểm tra cây nào vào ngày nào), bảng hướng dẫn nhanh cho từng cây kèm bài kiểm tra "tưới khi nào" và lượng nước cần tưới, các cảnh báo cùng hướng xử lý, và ngày xem xét lại sau 2-3 tuần để giãn ra hoặc rút ngắn khoảng cách kiểm tra dựa trên tình trạng thực tế họ ghi nhận được ở mỗi lần kiểm tra.

## Ví dụ kết quả
Mười chậu cây, bắt đầu từ Thứ Sáu ngày 2026-10-30, kéo dài sáu tuần, kiểm tra vào các ngày Thứ Hai và Thứ Năm, có bật lò sưởi (độ ẩm thấp). Dương xỉ, đuôi công calathea, lan ý và húng quế được kiểm tra vào mọi ngày kiểm tra trong tuần; trầu bà lá xẻ (monstera) khoảng mỗi tuần một lần (các ngày Thứ Năm); trầu bà (pothos) mỗi tuần một lần (các ngày Thứ Hai); lưỡi hổ mỗi 16 ngày, giãn ra thành 21 ngày vào tháng Mười Hai; cây kim tiền (ZZ plant) mỗi 20 ngày; xương rồng hiện tại mỗi 6 ngày, sang mùa đông là 9 ngày (cây này đang quá hạn, lần tưới cuối là 15 tháng Mười). Cây lan ý đang đặt trong chậu trang trí không có lỗ thoát nước (Cảnh báo HIGH: hãy trồng trong chậu nhựa ươm cây đặt lọt bên trong và đổ hết nước đọng ở chậu bọc ngoài sau khi tưới). Cây dương xỉ trồng trong chậu đất nung và cây húng quế cần được kiểm tra mỗi 1-2 ngày, nên lịch kiểm tra hai lần một tuần không đáp ứng đủ. Xem chi tiết tại `examples/plan-output.md`.

## Quy tắc

- Không bao giờ chỉ định tưới nước cứng nhắc theo lịch cố định mà không kiểm tra trước; luôn gắn mỗi lần kiểm tra với bài thử "tưới khi nào" của từng loại cây.
- Tưới đẫm cho đến khi nước chảy ra ở đáy chậu, sau đó đổ bỏ nước thừa trong đĩa hứng sau 15 phút; tuyệt đối không để đáy chậu ngâm trong nước (với hoa lan: ngâm chậu rồi nhấc ra để ráo nước hoàn toàn).
- Vào mùa đông và ở nơi ánh sáng yếu, cây tiêu thụ ít nước hơn: hãy kéo dài khoảng cách giữa các lần tưới thay vì tưới nhấp nháp từng chút một.
- Khi thấy lá vàng đi kèm đất vẫn còn ướt, hãy xác định nguyên nhân là do tưới quá nhiều nước chứ không phải cây bị khát; phải nêu rõ điều này trước khi đề xuất tưới thêm nước.
- Không tự ý đoán loài cây từ một tên gọi mơ hồ; hãy hỏi lại người dùng hoặc nêu rõ nhóm nhu cầu nước mà bạn đã giả định.
- Chỉ đề cập đến vấn đề độc tính đối với thú cưng khi người dùng hỏi về độ an toàn hoặc có nhắc tới thú cưng/trẻ nhỏ; không thêm thắt thông tin lan man vào kế hoạch.
FILE:references/plant-water-profiles.md
# Các nhóm nhu cầu tưới nước

| Nhóm | Các loại cây điển hình | Tưới khi | Khoảng cách kiểm tra cơ sở* | Độ giãn cách vào mùa đông |
|---|---|---|---|---|
| succulent | xương rồng, nha đam (lô hội), sen đá (echeveria), cây ngọc bích (jade), móng rồng (haworthia), chuỗi ngọc (string of pearls) | đất khô hoàn toàn từ trên xuống đáy: cắm một chiếc đũa gỗ chạm đáy chậu khi rút ra thấy sạch và khô ráo; nhấc chậu thấy nhẹ hẳn | 10 ngày | x2.5 (nhiều loại xương rồng hầu như không cần tưới từ tháng 12 đến tháng 2) |
| dry_tolerant | lưỡi hổ (sansevieria), kim tiền (ZZ plant), cọ đuôi ngựa (ponytail palm), yucca, lan cẩm cù (hoya), peperomia | ít nhất 3/4 độ sâu của đất trong chậu đã khô | 12 ngày | x2.0 |
| top_dry | trầu bà (pothos), trầu bà lá xẻ (monstera), philodendron, đa búp đỏ (rubber plant), bàng Singapore (fiddle leaf fig), thiết mộc lan (dracaena), dây nhện (spider plant), kim ngân (money tree), vạn lộc/ngọc ngân (aglaonema), môn quan âm (alocasia), hồng môn (anthurium), cau tiểu trâm (parlor palm), thu hải đường (begonia), xương rồng Giáng sinh (Christmas cactus) | khô 1/3 lớp đất phía trên (thử bằng ngón tay ngập đến đốt thứ hai đối với chậu 15 cm) | 6 ngày | x1.6 |
| evenly_moist | dương xỉ Boston và dương xỉ tóc thần vệ nữ (maidenhair fern), đuôi công (calathea), maranta (prayer plant), lan ý (peace lily), lá may mắn (fittonia) | lớp đất mặt 1-2 cm vừa chớm khô; không bao giờ để đất khô hoàn toàn | 3 ngày | x1.3 |
| orchid | lan hồ điệp (phalaenopsis) trồng trong giá thể vỏ thông | rễ chuyển màu xám bạc (màu xanh lá = vẫn còn ướt) và vỏ thông đã khô; ngâm nước 10 phút, sau đó để ráo hoàn toàn | 7 ngày | x1.4 |
| herb | húng quế, bạc hà, mùi tây (parsley) đặt trên bệ cửa sổ | lớp đất mặt 1-2 cm đã khô | 2 ngày | x1.2 |

*Mức cơ sở = mùa xuân, chậu nhựa 15 cm có lỗ thoát nước, ánh sáng trung bình, độ ẩm bình thường. Mùa thu nằm ở mức giữa mùa xuân và mùa đông; mùa hè nhân với hệ số x0.85. Xem `adjustment-factors.md`.

## Cách kiểm tra độ ẩm (30 giây cho mỗi cây)
1. **Thử bằng ngón tay:** ấn ngón tay vào đất đến độ sâu theo quy tắc của nhóm cây. Đất khô và tơi rời = khô; mát và dính vào tay = còn ẩm.
2. **Ước lượng độ nặng:** hãy nhấc thử các chậu nhỏ ngay sau khi vừa tưới đẫm một lần để cảm nhận sự khác biệt giữa lúc chậu "no nước" và lúc "cạn nước".
3. **Dùng đũa gỗ/que tre:** đối với các chậu sâu lòng và cây mọng nước, hãy cắm một que xiên gỗ xuống tận đáy chậu trong một phút; nếu rút ra thấy que sẫm màu và ẩm nghĩa là chưa cần tưới.
4. **Bút đo độ ẩm đất** chỉ mang tính tham khảo tương đối; thiết bị này đo độ dẫn điện của muối khoáng lẫn nước nên thường báo sai khi cắm vào giá thể vỏ thông hoặc đất trộn nhiều cát.

## Các dấu hiệu nhận biết
| Tưới quá nhiều nước (phổ biến hơn) | Tưới thiếu nước |
|---|---|
| lá tầng dưới ngả vàng trong khi đất vẫn ướt, gốc thân mềm nhũn hoặc chuyển màu đen, rễ bị thối nhũn, xuất hiện ruồi nấm (fungus gnats), đất có mùi chua ủng | mép lá khô giòn chuyển màu nâu, lá rũ xuống nhưng tươi tỉnh lại chỉ sau vài giờ được tưới nước, đất co lại tách rời khỏi thành chậu, nhấc chậu thấy rất nhẹ |
| Cách khắc phục: ngừng tưới ngay, kiểm tra bộ rễ, thay sang giá thể đất khô mới nếu rễ đã bị thối, kéo dài khoảng cách giữa các lần kiểm tra | Cách khắc phục: tưới đẫm hoàn toàn (ngâm đáy chậu trong nước 20-30 phút nếu đất bị trơ không ngấm nước), rút ngắn khoảng cách kiểm tra lại một chút |

Cây bị rũ lá trong khi đất vẫn **ướt** có nghĩa là bộ rễ đã bị tổn thương: tuyệt đối không tưới thêm nước.

## Kỹ thuật tưới nước
- Tưới từ từ khắp bề mặt đất cho đến khi nước chảy ra ở lỗ đáy chậu; chờ một lát, sau đó đổ bỏ nước đọng trong đĩa hứng sau khoảng 15 phút.
- Dùng nước ở nhiệt độ phòng. Cây đuôi công (calathea) và một số loài dương xỉ dễ bị cháy nâu đầu lá nếu tưới bằng nước cứng hoặc nước đã làm mềm bằng muối; dùng nước mưa hoặc nước lọc sẽ tốt hơn.
- Tưới thẩm thấu ngược từ đáy (ngâm đáy chậu trong khay nước khoảng 20-30 phút) rất hiệu quả với các chậu nhỏ và đất bị khô co rút lại; thỉnh thoảng hãy tưới từ trên xuống để rửa trôi muối khoáng tích tụ.
- Chậu tự tưới: châm thêm nước vào bình chứa khi đã cạn và thỉnh thoảng cứ để bình chứa cạn khô trong một hoặc hai ngày để rễ cây được hô hấp; không dùng loại chậu này cho cây mọng nước.
FILE:references/adjustment-factors.md
# Các hệ số điều chỉnh

Khoảng cách kiểm tra = số ngày cơ sở (theo nhóm cây) x kích thước chậu x chất liệu chậu x ánh sáng x độ ẩm x mùa, được làm tròn và giới hạn trong khoảng 1..45 ngày. Dưới đây là các hệ số nhân được sử dụng trong `scripts/watering_planner.py`.

| Yếu tố | Giá trị | Hệ số nhân | Lý do |
|---|---|---|---|
| Đường kính chậu | dưới 10 cm | 0.6 | ít đất, khô chỉ sau vài ngày |
| | 10-13 cm | 0.8 | |
| | 14-19 cm | 1.0 | mức tham chiếu chuẩn |
| | 20-27 cm | 1.3 | nhiều đất hơn nên giữ nước lâu hơn |
| | từ 28 cm trở lên | 1.6 | chậu lớn vẫn còn ướt ở đáy rất lâu sau khi bề mặt đã khô: cần kiểm tra sâu xuống dưới |
| Chất liệu | nhựa, tráng men, gốm sứ, kim loại | 1.0 | thành chậu không thoát hơi nước |
| | đất nung (terracotta) / đất sét không tráng men | 0.75 | thành chậu thấm hút và làm bay hơi nước |
| | túi vải trồng cây (fabric grow bag) | 0.7 | khô nhanh từ mọi phía |
| | chậu tự tưới | 1.5 | bình chứa cấp ẩm dần cho đất; hãy kiểm tra bình chứa nước thay vì mặt đất |
| Ánh sáng | thấp (cách cửa sổ trên 2 m, phòng hướng Bắc) | 1.4 | cây ít phát triển, tiêu thụ ít nước |
| | trung bình | 1.0 | |
| | ánh sáng gián tiếp mạnh | 0.85 | |
| | nắng chiếu trực tiếp lên lá | 0.7 | |
| Độ ẩm | thấp (đang bật sưởi, dưới ~35 %) | 0.85 | đất và lá mất nước nhanh hơn |
| | bình thường | 1.0 | |
| | cao (phòng tắm, có máy tạo ẩm) | 1.15 | |
| Mùa | mùa xuân | 1.0 | |
| | mùa hè | 0.85 | |
| | mùa thu | mức giữa của mùa xuân và mùa đông | đà tăng trưởng chậm lại khi ngày ngắn đi |
| | mùa đông | hệ số giãn cách mùa đông theo từng nhóm cây (từ x1.2 đến x2.5) | |

Phân chia mùa: ở Bắc bán cầu, tháng 12-tháng 2 là mùa đông, tháng 3-tháng 5 là mùa xuân, tháng 6-tháng 8 là mùa hè, tháng 9-tháng 11 là mùa thu; ở Nam bán cầu lệch đi sáu tháng. Nếu đặt cây ngay cạnh lò sưởi hoặc trong phòng kính có sưởi ấm, hãy chọn mức độ ẩm "low" (thấp) ngay cả vào mùa đông.

## Khả năng thoát nước
Chậu không có lỗ thoát nước là nguyên nhân đơn lẻ lớn nhất gây thối rễ. Cách tốt nhất: giữ nguyên cây trong chậu nhựa ươm cây đặt lọt bên trong chậu trang trí và đổ hết nước đọng ở chậu ngoài sau khi tưới 15 phút. Nếu bắt buộc phải trồng trực tiếp trong chậu không có lỗ, chỉ tưới khoảng một nửa lượng nước thông thường và nghiêng nhẹ chậu để kiểm tra xem có nước đọng dưới đáy không. Bộ lập lịch sẽ gắn cờ trường hợp này ở mức cảnh báo HIGH.

## Lượng nước tưới
Khoảng 15-25 % thể tích chậu, tưới cho đến khi thấy nước thoát ra ở lỗ đáy. Bộ lập lịch ước tính thể tích chậu từ đường kính (giả định chậu thành đứng có chiều cao bằng khoảng 0.9 lần chiều rộng), vì vậy chậu 15 cm cần khoảng 450 ml nước, chậu 24 cm cần khoảng 1.75 lít. Cây mọng nước và cây chịu hạn cũng cần được tưới đẫm mỗi lần như vậy, chỉ là tần suất thưa hơn.

## Tinh chỉnh sau hai hoặc ba tuần
- Đất vẫn còn ẩm ở hầu hết các lần kiểm tra: hãy kéo dài khoảng cách kiểm tra của cây đó thêm 25-50 % (hoặc chuyển thông số ánh sáng sang "low" nếu cây đặt xa cửa sổ).
- Đất khô cong ở mọi lần kiểm tra và lá cây bị rũ xuống: rút ngắn khoảng cách kiểm tra đi 25 %.
- Hãy cập nhật trực tiếp các thay đổi này vào tệp CSV (ví dụ: đổi nhóm cây hoặc mức ánh sáng) rồi chạy lại công cụ, thay vì cố ghi nhớ các trường hợp ngoại lệ trong đầu.
- Chạy lại kế hoạch khi bắt đầu bật hoặc tắt hệ thống sưởi, khi bạn thay chậu mới (chậu lớn hơn = khoảng cách dài hơn), hoặc khi đổi vị trí đặt cây.

## Các trường hợp nằm ngoài quy tắc tính khoảng cách
- Cây mới thay chậu: tưới đẫm một lần ngay sau khi thay chậu, sau đó chờ đến khi đất đạt đúng điều kiện trong quy tắc mới tưới tiếp.
- Các loại củ ngủ đông và xương rồng trong giai đoạn nghỉ đông lạnh giá (5-12 C): hầu như không cần tưới nước; chỉ cần kiểm tra mỗi tháng một lần là đủ.
- Bón phân: chỉ thực hiện vào mùa xuân và mùa hè, pha loãng bằng một nửa liều lượng khuyến cáo, bón vào đúng ngày tưới nước.
FILE:templates/watering-plan.md
# Kế hoạch chăm sóc cây: <nhà / phòng>

**Giai đoạn:** <2026-10-30 đến 2026-12-10>   **Ngày kiểm tra:** <Thứ Hai và Thứ Năm, 5-10 phút>
**Điều kiện:** <Bắc bán cầu, đang bật sưởi (không khí khô)>   **Đánh giá lại vào:** <2026-11-16>

## Việc cần làm ngay
- <Lan ý (Peace lily): không có lỗ thoát nước - hãy chuyển cây sang chậu nhựa ươm đặt lọt bên trong chậu bọc ngoài; đổ bỏ nước đọng ở chậu bọc ngoài sau khi tưới 15 phút>
- <Spike (xương rồng): đã quá hạn - cần kiểm tra ngay vào Thứ Hai>

## Lịch trình hàng tuần
| Ngày | Kiểm tra các cây sau |
|---|---|
| <Thứ Hai> | <dương xỉ, đuôi công calathea, lan ý, húng quế, hoa lan, trầu bà pothos, xương rồng (mỗi Thứ Hai cách tuần trong tháng Mười Hai)> |
| <Thứ Năm> | <dương xỉ, đuôi công calathea, lan ý, húng quế, hoa lan, trầu bà lá xẻ monstera; lưỡi hổ mỗi 2-3 tuần> |

## Bảng hướng dẫn nhanh
| Cây | Tưới khi | Lượng nước ước tính | Ghi chú |
|---|---|---|---|
| <Monty (monstera)> | <khô 1/3 lớp đất mặt> | <~1.75 l cho đến khi thoát nước> | <cửa sổ hướng Đông nhiều sáng> |
| <Sansa (snake plant)> | <khô 3/4 độ sâu đất> | <~450 ml> | <Tháng Mười Hai: mỗi 3 tuần> |

## Cách kiểm tra
- Ấn ngón tay vào đất đến độ sâu ghi trong cột "Tưới khi"; chỉ tưới nếu đất đã khô đến độ sâu đó.
- Tưới cho đến khi nước chảy ra ở đáy chậu, đổ hết nước trong đĩa hứng sau 15 phút.
- Đất ướt + lá vàng = thừa nước: bỏ qua lượt tưới và báo lại cho tôi.

## Cảnh báo
- <Fernando (dương xỉ Boston) trồng trong chậu đất nung bị khô chỉ sau 2 ngày khi bật sưởi: hãy thêm một buổi kiểm tra vào Thứ Bảy hoặc chuyển sang chậu nhựa>
- <Húng quế cần được kiểm tra hàng ngày trên bệ cửa sổ đầy nắng; hãy tưới ngâm đáy chậu mỗi khi bạn đi ngang qua>

## Khi đánh giá lại
Đối với mỗi cây, hãy ghi chú xem đất thường vẫn còn ẩm (cần giãn cách dài hơn) hay đã khô kiệt (cần rút ngắn lại) vào các buổi kiểm tra; tôi sẽ cập nhật lại kế hoạch.
FILE:examples/plants.csv
name,plant,pot_cm,pot_material,light,drainage,last_watered,notes
Monty,monstera,24,plastic,bright,yes,2026-10-28,living room by the east window
Pothos shelf,pothos,14,glazed,medium,yes,2026-10-27,trailing from the bookshelf
Sansa,snake plant,17,terracotta,low,yes,2026-10-20,hallway corner
Zed,zz plant,20,plastic,medium,yes,,new from the shop
Fernando,boston fern,20,terracotta,bright,yes,2026-10-29,bathroom shelf
Cal,calathea,15,plastic,medium,yes,2026-10-28,bedroom
Spike,cactus,10,terracotta,direct,yes,2026-10-15,south windowsill
Peace lily,peace lily,18,glazed,low,no,2026-10-26,decorative pot with no hole
Orchid,phalaenopsis,12,plastic,bright,yes,2026-10-25,kitchen window
Basil,basil,13,terracotta,direct,yes,2026-10-29,kitchen windowsill
FILE:examples/plan-output.md
# Kế hoạch tưới cây trong nhà: 2026-10-30 đến 2026-12-10

Bán cầu: Bắc   Mùa lúc bắt đầu: mùa thu   Độ ẩm: thấp   Ngày kiểm tra: Thứ Hai, Thứ Năm   Số lượng cây: 10

Kiểm tra không đồng nghĩa với tưới nước: hãy chạm tay cảm nhận độ ẩm của đất và chỉ tưới khi quy tắc của cây báo đã đến lúc.

## Danh sách cây

| Cây | Nhóm | Chậu | Ánh sáng | Kiểm tra mỗi | Tưới khi | Lượng nước ước tính | Số lần kiểm tra |
|---|---|---|---|---|---|---|---|
| Monty (monstera) | top_dry | nhựa 24 cm | sáng | 7 d (winter: 9 d) | khô 1/3 lớp đất phía trên (khoảng 3-5 cm đối với chậu 15 cm) | ~1750 ml (cho đến khi thoát nước) | 6 |
| Pothos shelf (pothos) | top_dry | tráng men 14 cm | trung bình | 7 d (winter: 8 d) | khô 1/3 lớp đất phía trên (khoảng 3-5 cm đối với chậu 15 cm) | ~350 ml (cho đến khi thoát nước) | 6 |
| Sansa (snake plant) | dry_tolerant | đất nung 17 cm | thấp | 16 d (winter: 21 d) | đất khô ít nhất 3/4 độ sâu từ trên xuống | ~450 ml (cho đến khi thoát nước) | 3 |
| Zed (zz plant) | dry_tolerant | nhựa 20 cm | trung bình | 20 d | đất khô ít nhất 3/4 độ sâu từ trên xuống | ~750 ml (cho đến khi thoát nước) | 2 |
| Fernando (boston fern) | evenly_moist | đất nung 20 cm | sáng | 2 d (winter: 3 d) | lớp đất mặt 1-2 cm vừa chớm khô; không bao giờ để khô hoàn toàn | ~1000 ml (cho đến khi thoát nước) | 12 |
| Cal (calathea) | evenly_moist | nhựa 15 cm | trung bình | 3 d (winter: 3 d) | lớp đất mặt 1-2 cm vừa chớm khô; không bao giờ để khô hoàn toàn | ~450 ml (cho đến khi thoát nước) | 12 |
| Spike (cactus) (quá hạn: kiểm tra ngay ngày đầu tiên) | succulent | đất nung 10 cm | trực tiếp | 6 d (winter: 9 d) | đất khô hoàn toàn đến tận đáy (rút đũa gỗ ra thấy sạch và khô) | ~100 ml (cho đến khi thoát nước) | 6 |
| Peace lily (peace lily) | evenly_moist | tráng men 18 cm, KHÔNG lỗ | thấp | 4 d (winter: 5 d) | lớp đất mặt 1-2 cm vừa chớm khô; không bao giờ để khô hoàn toàn | ~375 ml, không tưới nhiều hơn | 12 |
| Orchid (phalaenopsis) | orchid | nhựa 12 cm | sáng | 5 d (winter: 6 d) | rễ màu xám bạc và vỏ thông khô; ngâm 10 phút, để ráo hoàn toàn | ngâm 10 phút | 11 |
| Basil (basil) | herb | đất nung 13 cm | trực tiếp | 1 d (winter: 1 d) | lớp đất mặt 1-2 cm đã khô | ~350 ml (cho đến khi thoát nước) | 12 |

## Lịch kiểm tra

| Ngày | Thứ | Mùa | Cây cần kiểm tra |
|---|---|---|---|
| 2026-11-02 | Mon | autumn | Basil, Cal, Fernando, Orchid, Peace lily, Pothos shelf, Spike, Zed |
| 2026-11-05 | Thu | autumn | Basil, Cal, Fernando, Monty, Orchid, Peace lily, Sansa |
| 2026-11-09 | Mon | autumn | Basil, Cal, Fernando, Orchid, Peace lily, Pothos shelf, Spike |
| 2026-11-12 | Thu | autumn | Basil, Cal, Fernando, Monty, Orchid, Peace lily |
| 2026-11-16 | Mon | autumn | Basil, Cal, Fernando, Orchid, Peace lily, Pothos shelf, Spike |
| 2026-11-19 | Thu | autumn | Basil, Cal, Fernando, Monty, Orchid, Peace lily, Sansa |
| 2026-11-23 | Mon | autumn | Basil, Cal, Fernando, Orchid, Peace lily, Pothos shelf, Spike, Zed |
| 2026-11-26 | Thu | autumn | Basil, Cal, Fernando, Monty, Orchid, Peace lily |
| 2026-11-30 | Mon | autumn | Basil, Cal, Fernando, Orchid, Peace lily, Pothos shelf, Spike |
| 2026-12-03 | Thu | winter | Basil, Cal, Fernando, Monty, Orchid, Peace lily, Sansa |
| 2026-12-07 | Mon | winter | Basil, Cal, Fernando, Peace lily, Pothos shelf, Spike |
| 2026-12-10 | Thu | winter | Basil, Cal, Fernando, Monty, Orchid, Peace lily |

## Cảnh báo

| Mức độ | Cây | Lưu ý |
|---|---|---|
| HIGH | Peace lily | chậu không có lỗ thoát nước: nước đọng ở đáy làm thối rễ. Hãy thay chậu có lỗ, hoặc trồng cây trong chậu nhựa ươm đặt lọt bên trong chậu bọc ngoài và đổ hết nước đọng sau khi tưới 15 phút |
| LOW | Fernando | chậu đất nung làm cây này khô rất nhanh; đổi sang chậu nhựa hoặc chậu gốm tráng men sẽ giúp giữ ẩm đều hơn |
| LOW | Fernando | các ngày kiểm tra cố định khiến một số lượt kiểm tra bị trễ hơn một ngày (ví dụ: đến hạn 2026-11-07, lịch xếp vào 2026-11-09); hãy thêm một ngày kiểm tra trong tuần hoặc sờ thử đất xen kẽ giữa các buổi |
| LOW | Basil | các ngày kiểm tra cố định khiến một số lượt kiểm tra bị trễ hơn một ngày (ví dụ: đến hạn 2026-11-03, lịch xếp vào 2026-11-05); hãy thêm một ngày kiểm tra trong tuần hoặc sờ thử đất xen kẽ giữa các buổi |

Các khoảng thời gian trên giả định rằng cây đã bén rễ ổn định trong giá thể thoát nước tốt. Sau 2-3 tuần, hãy kéo dài khoảng cách kiểm tra nếu thấy đất vẫn còn ẩm ở hầu hết các lần kiểm tra, hoặc rút ngắn lại nếu lúc nào kiểm tra đất cũng đã khô kiệt.
FILE:scripts/watering_planner.py
#!/usr/bin/env python3
"""Houseplant watering schedule planner (Python 3.8+ standard library only).

Reads a CSV of plants (species or watering type, pot diameter, pot material, light,
drainage, optional last watering date) and builds a check calendar: how often to
check each plant in the current season, what "needs water" means for it, roughly how
much to give, and which plants to check on which date. Intervals stretch
automatically as the plan crosses into autumn and winter (or shrink into summer), by
hemisphere. Checks can be snapped to fixed weekdays (e.g. Mon,Thu) so the plan fits a
routine. Optional .ics export for a calendar app.

A check is not a watering: on each check, feel the soil and water only if the plant's
rule says so. The intervals are starting points; adjust them after two or three weeks
of real checks (see references/adjustment-factors.md).

Usage:
  python3 watering_planner.py plants.csv [--start 2026-10-30] [--weeks 4]
        [--hemisphere north|south] [--humidity low|normal|high]
        [--check-days Mon,Thu] [--ics plan.ics] [--json]
  python3 watering_planner.py --self-test
plants.csv columns: name, plant (species or type), pot_cm, pot_material
(plastic|glazed|ceramic|terracotta|fabric|self-watering), light (low|medium|bright|direct),
drainage (yes|no), last_watered (YYYY-MM-DD, optional), notes (optional).
Types: succulent, dry_tolerant, top_dry, evenly_moist, orchid, herb.
Exit codes: 0 = plan written, 1 = plan written with HIGH warnings (e.g. no drainage), 2 = bad input.
"""
import argparse, csv, datetime as dt, io, json, math, sys

PROFILES = {
    #               base days (spring, 15 cm plastic, medium light), winter factor, rule, share of pot volume per watering
    "succulent":    (10, 2.5, "soil dry all the way down (chopstick comes out clean and dry)", 0.15),
    "dry_tolerant": (12, 2.0, "soil dry at least 3/4 of the way down", 0.15),
    "top_dry":      (6, 1.6, "top third of the soil dry (about 3-5 cm in a 15 cm pot)", 0.20),
    "evenly_moist": (3, 1.3, "top 1-2 cm just dry; never let it dry out fully", 0.20),
    "orchid":       (7, 1.4, "roots silvery-grey and bark dry; soak 10 min, drain fully", 0.0),
    "herb":         (2, 1.2, "top 1-2 cm dry", 0.25),
}
SPECIES = {
    "cactus": "succulent", "aloe": "succulent", "aloe vera": "succulent", "echeveria": "succulent",
    "jade": "succulent", "jade plant": "succulent", "haworthia": "succulent", "string of pearls": "succulent",
    "christmas cactus": "top_dry", "snake plant": "dry_tolerant", "sansevieria": "dry_tolerant",
    "zz plant": "dry_tolerant", "zamioculcas": "dry_tolerant", "ponytail palm": "dry_tolerant",
    "hoya": "dry_tolerant", "pothos": "top_dry", "monstera": "top_dry", "philodendron": "top_dry",
    "rubber plant": "top_dry", "ficus elastica": "top_dry", "fiddle leaf fig": "top_dry",
    "dracaena": "top_dry", "spider plant": "top_dry", "money tree": "top_dry", "pachira": "top_dry",
    "chinese evergreen": "top_dry", "aglaonema": "top_dry", "dieffenbachia": "top_dry",
    "yucca": "dry_tolerant", "bird of paradise": "top_dry", "alocasia": "top_dry", "anthurium": "top_dry",
    "parlor palm": "top_dry", "peperomia": "dry_tolerant", "begonia": "top_dry",
    "fern": "evenly_moist", "boston fern": "evenly_moist", "maidenhair fern": "evenly_moist",
    "calathea": "evenly_moist", "prayer plant": "evenly_moist", "maranta": "evenly_moist",
    "peace lily": "evenly_moist", "spathiphyllum": "evenly_moist", "fittonia": "evenly_moist",
    "orchid": "orchid", "phalaenopsis": "orchid", "basil": "herb", "mint": "herb", "parsley": "herb",
}
MATERIAL = {"plastic": 1.0, "glazed": 1.0, "ceramic": 1.0, "metal": 1.0, "terracotta": 0.75,
            "clay": 0.75, "unglazed": 0.75, "fabric": 0.7, "self-watering": 1.5}
LIGHT = {"low": 1.4, "medium": 1.0, "bright": 0.85, "direct": 0.7}
HUMIDITY = {"low": 0.85, "normal": 1.0, "high": 1.15}
SEASON_FACTOR = {"spring": 1.0, "summer": 0.85}
DAY_NAMES = ["Mon", "Tue", "Wed", "Thu", "Fri", "Sat", "Sun"]


class InputError(Exception):
    pass


def season_of(d, hemisphere):
    m = d.month if hemisphere == "north" else (d.month + 5) % 12 + 1
    return {12: "winter", 1: "winter", 2: "winter", 3: "spring", 4: "spring", 5: "spring",
            6: "summer", 7: "summer", 8: "summer"}.get(m, "autumn")


def pot_factor(cm):
    if cm < 10:
        return 0.6
    if cm < 14:
        return 0.8
    if cm < 20:
        return 1.0
    if cm < 28:
        return 1.3
    return 1.6


def pot_litres(cm):
    # straight-sided pot about 0.9x as tall as wide, minus ~10 % for the rim gap
    r = cm / 2.0
    return math.pi * r * r * (0.9 * cm) * 0.9 / 1000.0


def interval_days(p, season, humidity):
    base, winter, _, _ = PROFILES[p["type"]]
    # autumn sits halfway between spring and the plant's winter slow-down
    sf = {"winter": winter, "autumn": (1 + winter) / 2}.get(season) or SEASON_FACTOR[season]
    days = base * pot_factor(p["pot_cm"]) * MATERIAL[p["material"]] * LIGHT[p["light"]] * HUMIDITY[humidity] * sf
    return max(1, min(45, int(round(days))))


def parse_date(s, what):
    try:
        return dt.date.fromisoformat(s.strip())
    except ValueError:
        raise InputError(f"bad date '{s}' for {what} (use YYYY-MM-DD)")


def load_plants(text):
    rows = list(csv.DictReader(io.StringIO(text)))
    if not rows:
        raise InputError("plants CSV has no rows")
    cols = {c.strip().lower(): c for c in rows[0] if c}
    if "name" not in cols:
        raise InputError("plants CSV needs at least a 'name' column (plus plant, pot_cm, pot_material, light, drainage)")
    plants, warnings = [], []
    for i, r in enumerate(rows, 2):
        g = lambda k, d="": ((r.get(cols[k]) or "").strip() if k in cols else "") or d
        name = g("name")
        if not name:
            raise InputError(f"row {i}: empty name")
        kind = g("plant", g("type", "")).lower()
        if kind in PROFILES:
            ptype = kind
        elif kind in SPECIES:
            ptype = SPECIES[kind]
        else:
            ptype = next((v for k, v in SPECIES.items() if k in kind), None) if kind else None
            if ptype is None:
                ptype = "top_dry"
                warnings.append(("MEDIUM", name, f"unknown plant '{kind or '?'}': using type top_dry; set the plant column to one of {', '.join(PROFILES)}"))
        try:
            pot = float(g("pot_cm", "0") or 0)
        except ValueError:
            raise InputError(f"row {i} ({name}): pot_cm must be a number of centimetres")
        if pot <= 0:
            pot = 15.0
            warnings.append(("LOW", name, "no pot size given: assumed 15 cm"))
        if pot > 80:
            raise InputError(f"row {i} ({name}): pot_cm {pot} looks wrong (centimetres, not millimetres?)")
        mat = g("pot_material", "plastic").lower()
        if mat not in MATERIAL:
            raise InputError(f"row {i} ({name}): pot_material '{mat}' (use {', '.join(MATERIAL)})")
        light = g("light", "medium").lower().replace("bright indirect", "bright").replace("full sun", "direct")
        if light not in LIGHT:
            raise InputError(f"row {i} ({name}): light '{light}' (use low, medium, bright, direct)")
        drainage = g("drainage", "yes").lower() not in ("no", "n", "false", "0")
        last = parse_date(g("last_watered"), f"{name} last_watered") if g("last_watered") else None
        p = {"name": name, "plant": kind or ptype, "type": ptype, "pot_cm": pot, "material": mat,
             "light": light, "drainage": drainage, "last_watered": last, "notes": g("notes")}
        plants.append(p)
        if not drainage:
            warnings.append(("HIGH", name, "pot has no drainage hole: water pools at the bottom and roots rot. Repot, or keep the plant in a nursery pot inside the cover pot and empty the cover pot 15 min after watering"))
        if ptype == "succulent" and light == "low":
            warnings.append(("MEDIUM", name, "succulent in low light: it will stretch and rot easily; move it to the brightest window and water even less"))
        if ptype == "evenly_moist" and light == "direct":
            warnings.append(("MEDIUM", name, "moisture-loving plant in direct sun: leaves scorch and soil dries within a day; move it out of direct sun"))
        if ptype == "evenly_moist" and mat in ("terracotta", "clay", "unglazed", "fabric"):
            warnings.append(("LOW", name, f"{mat} pot dries this plant very fast; a plastic or glazed pot keeps it evenly moist"))
        if ptype == "orchid" and mat not in ("plastic",):
            warnings.append(("LOW", name, "orchids are easiest in a clear plastic pot with drainage, so you can see the roots"))
        if mat == "self-watering" and ptype in ("succulent", "dry_tolerant", "orchid"):
            warnings.append(("MEDIUM", name, "self-watering pots keep the soil wet; not suited to plants that need to dry out"))
    return plants, warnings


def amount_text(p):
    _, _, _, share = PROFILES[p["type"]]
    if p["type"] == "orchid":
        return "soak 10 min"
    if p["material"] == "self-watering":
        return "refill reservoir"
    ml = pot_litres(p["pot_cm"]) * 1000 * share
    ml = int(round(ml / 50.0) * 50) or 50
    return f"~{ml} ml (until it drains)" if p["drainage"] else f"~{ml // 2} ml, no more"


def snap(due, prev, allowed):
    """Allowed weekday nearest to the due date (ties go earlier), always after prev."""
    if not allowed:
        return due
    best = None
    for off in (0, -1, 1, -2, 2, -3, 3):
        d = due + dt.timedelta(days=off)
        if d > prev and d.weekday() in allowed:
            best = d
            break
    if best is None:
        best = max(due, prev + dt.timedelta(days=1))
        while best.weekday() not in allowed:
            best += dt.timedelta(days=1)
    return best


def plan(plants, start, weeks, hemisphere="north", humidity="normal", check_days=None):
    end = start + dt.timedelta(days=7 * weeks - 1)
    allowed = {DAY_NAMES.index(x) for x in check_days} if check_days else set()
    cal, per_plant, notes = {}, [], []
    for p in plants:
        s0 = season_of(start, hemisphere)
        iv = interval_days(p, s0, humidity)
        if p["last_watered"]:
            due = p["last_watered"] + dt.timedelta(days=iv)
            overdue = due < start
            first = max(due, start)
        else:
            overdue, first = False, start
        d = snap(first, start - dt.timedelta(days=1), allowed) if allowed else first
        dates, prev = [], None
        while d <= end:
            dates.append(d)
            cal.setdefault(d, []).append(p["name"])
            step = interval_days(p, season_of(d, hemisphere), humidity)
            due = d + dt.timedelta(days=step)
            nd = snap(due, d, allowed)
            if allowed and (nd - due).days > max(1, step // 5):
                notes.append((p["name"], due, nd))
            prev, d = d, nd
        later = {season_of(x, hemisphere) for x in dates} - {s0}
        per_plant.append({**p, "interval_now": iv, "season_now": s0,
                          "intervals_later": {s: interval_days(p, s, humidity) for s in sorted(later)},
                          "rule": PROFILES[p["type"]][2], "amount": amount_text(p),
                          "checks": [x.isoformat() for x in dates], "overdue": overdue})
    return {"start": start, "end": end, "hemisphere": hemisphere, "humidity": humidity,
            "check_days": check_days or [], "plants": per_plant,
            "calendar": [(d, sorted(cal[d], key=str.lower)) for d in sorted(cal)], "late_snaps": notes}


def render(res, warnings):
    st, en = res["start"], res["end"]
    out = [f"# Houseplant watering plan: {st.isoformat()} to {en.isoformat()}", "",
           f"Hemisphere: {res['hemisphere']}   Season at start: {season_of(st, res['hemisphere'])}   "
           f"Humidity: {res['humidity']}   Check days: {', '.join(res['check_days']) or 'any day'}   Plants: {len(res['plants'])}", "",
           "A check is not a watering: feel the soil and water only when the rule says so.", "",
           "## Plants", "",
           "| Plant | Type | Pot | Light | Check every | Water when | About | Checks |",
           "|---|---|---|---|---|---|---|---|"]
    for p in res["plants"]:
        iv = f"{p['interval_now']} d"
        if p["intervals_later"]:
            iv += " (" + ", ".join(f"{s}: {v} d" for s, v in p["intervals_later"].items()) + ")"
        pot = f"{p['pot_cm']:g} cm {p['material']}" + ("" if p["drainage"] else ", NO hole")
        flag = " (overdue: check first day)" if p["overdue"] else ""
        out.append(f"| {p['name']} ({p['plant']}){flag} | {p['type']} | {pot} | {p['light']} | {iv} | {p['rule']} | {p['amount']} | {len(p['checks'])} |")
    out += ["", "## Calendar", "", "| Date | Day | Season | Check |", "|---|---|---|---|"]
    for d, names in res["calendar"]:
        out.append(f"| {d.isoformat()} | {DAY_NAMES[d.weekday()]} | {season_of(d, res['hemisphere'])} | {', '.join(names)} |")
    if warnings or res["late_snaps"]:
        out += ["", "## Warnings", "", "| Sev | Plant | Note |", "|---|---|---|"]
        order = {"HIGH": 0, "MEDIUM": 1, "LOW": 2}
        for sev, name, msg in sorted(warnings, key=lambda w: (order[w[0]], w[1].lower())):
            out.append(f"| {sev} | {name} | {msg} |")
        seen = set()
        for name, due, nd in res["late_snaps"]:
            if name in seen:
                continue
            seen.add(name)
            out.append(f"| LOW | {name} | check days push some checks more than a day late (e.g. due {due.isoformat()}, planned {nd.isoformat()}); add a check day or feel the soil in between |")
    out += ["", "Intervals assume the plant is established in a free-draining mix. After 2-3 weeks, lengthen an interval if the soil is still moist at most checks, shorten it if it is always bone dry."]
    return "\n".join(out) + "\n"


def to_ics(res, stamp):
    lines = ["BEGIN:VCALENDAR", "VERSION:2.0", "PRODID:-//houseplant-watering-schedule-planner//EN", "CALSCALE:GREGORIAN"]
    for d, names in res["calendar"]:
        nd = d + dt.timedelta(days=1)
        lines += ["BEGIN:VEVENT", f"UID:plants-{d.strftime('%Y%m%d')}@watering-planner", f"DTSTAMP:{stamp}",
                  f"DTSTART;VALUE=DATE:{d.strftime('%Y%m%d')}", f"DTEND;VALUE=DATE:{nd.strftime('%Y%m%d')}",
                  "SUMMARY:" + ics_escape("Check plants: " + ", ".join(names)), "TRANSP:TRANSPARENT", "END:VEVENT"]
    lines.append("END:VCALENDAR")
    return "\r\n".join(fold(l) for l in lines) + "\r\n"


def ics_escape(s):
    return s.replace("\\", "\\\\").replace(";", "\\;").replace(",", "\\,").replace("\n", "\\n")


def fold(line):
    b = line.encode("utf-8")
    if len(b) <= 75:
        return line
    parts, cur = [], b""
    for ch in line:
        e = ch.encode("utf-8")
        if len(cur) + len(e) > (75 if not parts else 74):
            parts.append(cur.decode("utf-8")); cur = b""
        cur += e
    parts.append(cur.decode("utf-8"))
    return "\r\n ".join(parts)


def self_test():
    H = "name,plant,pot_cm,pot_material,light,drainage,last_watered\n"
    def run(rows, **kw):
        plants, warns = load_plants(H + rows)
        return plan(plants, kw.pop("start", dt.date(2026, 4, 6)), kw.pop("weeks", 4), **kw), warns
    cases = []
    def case(name, fn):
        try:
            ok = bool(fn())
            err = ""
        except Exception as e:  # noqa
            ok, err = False, repr(e)
        cases.append((name, ok, err))

    case("succulent checked less often than fern", lambda: run("A,cactus,15,plastic,medium,yes,\nB,fern,15,plastic,medium,yes,\n")[0]["plants"][0]["interval_now"] > run("A,cactus,15,plastic,medium,yes,\nB,fern,15,plastic,medium,yes,\n")[0]["plants"][1]["interval_now"])
    case("base interval top_dry 15 cm plastic medium spring = 6", lambda: run("A,pothos,15,plastic,medium,yes,\n")[0]["plants"][0]["interval_now"] == 6)
    case("small pot dries faster", lambda: run("A,pothos,9,plastic,medium,yes,\n")[0]["plants"][0]["interval_now"] < 6)
    case("big pot lasts longer", lambda: run("A,pothos,30,plastic,medium,yes,\n")[0]["plants"][0]["interval_now"] > 6)
    case("terracotta dries faster than plastic", lambda: run("A,pothos,15,terracotta,medium,yes,\n")[0]["plants"][0]["interval_now"] < 6)
    case("low light lengthens, direct sun shortens", lambda: run("A,pothos,15,plastic,low,yes,\n")[0]["plants"][0]["interval_now"] > 6 > run("A,pothos,15,plastic,direct,yes,\n")[0]["plants"][0]["interval_now"])
    case("winter stretches succulent 2.5x", lambda: run("A,cactus,15,plastic,medium,yes,\n", start=dt.date(2026, 1, 5))[0]["plants"][0]["interval_now"] == 25)
    case("summer shortens", lambda: run("A,pothos,15,plastic,medium,yes,\n", start=dt.date(2026, 7, 6))[0]["plants"][0]["interval_now"] == 5)
    case("southern hemisphere: July is winter", lambda: season_of(dt.date(2026, 7, 1), "south") == "winter" and season_of(dt.date(2026, 1, 1), "south") == "summer")
    case("season boundaries north", lambda: [season_of(dt.date(2026, m, 15), "north") for m in (2, 3, 5, 6, 8, 9, 11, 12)] == ["winter", "spring", "spring", "summer", "summer", "autumn", "autumn", "winter"])
    case("interval grows across autumn->winter in plan", lambda: (lambda r: r["plants"][0]["intervals_later"].get("winter", 0) > r["plants"][0]["interval_now"])(run("A,pothos,15,plastic,medium,yes,\n", start=dt.date(2026, 11, 16), weeks=4)[0]))
    case("checks spaced by interval", lambda: run("A,pothos,15,plastic,medium,yes,\n")[0]["plants"][0]["checks"][:3] == ["2026-04-06", "2026-04-12", "2026-04-18"])
    case("last_watered sets first check", lambda: run("A,pothos,15,plastic,medium,yes,2026-04-04\n")[0]["plants"][0]["checks"][0] == "2026-04-10")
    case("overdue goes to start", lambda: (lambda p: p["overdue"] and p["checks"][0] == "2026-04-06")(run("A,pothos,15,plastic,medium,yes,2026-03-20\n")[0]["plants"][0]))
    case("snap to check days (Mon,Thu)", lambda: all(dt.date.fromisoformat(x).weekday() in (0, 3) for x in run("A,pothos,15,plastic,medium,yes,\nB,cactus,12,terracotta,bright,yes,\n", check_days=["Mon", "Thu"])[0]["calendar"] and [x for p in run("A,pothos,15,plastic,medium,yes,\nB,cactus,12,terracotta,bright,yes,\n", check_days=["Mon", "Thu"])[0]["plants"] for x in p["checks"]]))
    case("snap to nearest check day (Sun -> Mon)", lambda: snap(dt.date(2026, 4, 12), dt.date(2026, 4, 6), {0, 3}) == dt.date(2026, 4, 13))
    case("snap tie goes earlier (Tue between Mon and Thu? no: Tue -> Mon)", lambda: snap(dt.date(2026, 4, 14), dt.date(2026, 4, 9), {0, 3}) == dt.date(2026, 4, 13))
    case("snap never on or before the previous check", lambda: snap(dt.date(2026, 4, 7), dt.date(2026, 4, 6), {0, 3}) == dt.date(2026, 4, 9))
    case("autumn between spring and winter", lambda: 6 < run("A,pothos,15,plastic,medium,yes,\n", start=dt.date(2026, 10, 5))[0]["plants"][0]["interval_now"] < run("A,pothos,15,plastic,medium,yes,\n", start=dt.date(2026, 12, 7))[0]["plants"][0]["interval_now"])
    case("late snap noted for fast plant", lambda: len(run("A,basil,9,terracotta,direct,yes,\n", check_days=["Mon"])[0]["late_snaps"]) > 0)
    case("no drainage -> HIGH warning and half amount", lambda: (lambda r: any(w[0] == "HIGH" for w in r[1]) and "no more" in r[0]["plants"][0]["amount"])(run("A,pothos,15,glazed,medium,no,\n")))
    case("unknown plant -> top_dry with warning", lambda: (lambda r: r[0]["plants"][0]["type"] == "top_dry" and any("unknown plant" in w[2] for w in r[1]))(run("A,triffid,15,plastic,medium,yes,\n")))
    case("species substring match", lambda: run("A,variegated monstera,15,plastic,medium,yes,\n")[0]["plants"][0]["type"] == "top_dry")
    case("succulent low light warning", lambda: any("stretch" in w[2] for w in run("A,echeveria,10,terracotta,low,yes,\n")[1]))
    case("fern in direct sun warning", lambda: any("scorch" in w[2] for w in run("A,boston fern,20,plastic,direct,yes,\n")[1]))
    case("self-watering succulent warning", lambda: any("self-watering" in w[2] for w in run("A,cactus,15,self-watering,bright,yes,\n")[1]))
    case("orchid amount is soak", lambda: run("A,orchid,12,plastic,bright,yes,\n")[0]["plants"][0]["amount"] == "soak 10 min")
    case("amount scales with pot", lambda: int(run("A,pothos,25,plastic,medium,yes,\n")[0]["plants"][0]["amount"][1:].split()[0]) > int(run("A,pothos,12,plastic,medium,yes,\n")[0]["plants"][0]["amount"][1:].split()[0]))
    case("low humidity shortens", lambda: run("A,fern,20,plastic,medium,yes,\n", humidity="low")[0]["plants"][0]["interval_now"] <= run("A,fern,20,plastic,medium,yes,\n")[0]["plants"][0]["interval_now"])
    case("interval never below 1 day", lambda: run("A,basil,6,fabric,direct,yes,\n", start=dt.date(2026, 7, 6), humidity="low")[0]["plants"][0]["interval_now"] >= 1)
    case("missing pot size assumed 15", lambda: (lambda r: r[0]["plants"][0]["pot_cm"] == 15 and any("assumed 15" in w[2] for w in r[1]))(run("A,pothos,,plastic,medium,yes,\n")))
    def bad(rows):
        try:
            load_plants(H + rows); return False
        except InputError:
            return True
    case("bad material rejected", lambda: bad("A,pothos,15,wood,medium,yes,\n"))
    case("bad light rejected", lambda: bad("A,pothos,15,plastic,dim,yes,\n"))
    case("pot in mm rejected", lambda: bad("A,pothos,150,plastic,medium,yes,\n"))
    case("bad date rejected", lambda: bad("A,pothos,15,plastic,medium,yes,30/10/2026\n"))
    case("ics has one event per date, CRLF, escaped commas", lambda: (lambda r, t: t.count("BEGIN:VEVENT") == len(r["calendar"]) and "\r\n" in t and "\\," in t)(*(lambda r: (r, to_ics(r, "20261030T000000Z")))(run("A,pothos,15,plastic,medium,yes,\nB,fern,15,plastic,medium,yes,\n")[0])))
    case("ics lines folded to 75 octets", lambda: all(len(l.encode()) <= 75 for l in to_ics(run("".join(f"Plant number {i},pothos,15,plastic,medium,yes,\n" for i in range(8)))[0], "20261030T000000Z").split("\r\n")))
    passed = 0
    for name, ok, err in cases:
        passed += ok
        print(("PASS " if ok else "FAIL ") + name + ("" if ok else f"  {err}"))
    print(f"{passed}/{len(cases)} passed")
    return 0 if passed == len(cases) else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="Build a houseplant watering check calendar")
    ap.add_argument("plants", nargs="?")
    ap.add_argument("--start", help="first day of the plan, YYYY-MM-DD (default today)")
    ap.add_argument("--weeks", type=int, default=4)
    ap.add_argument("--hemisphere", choices=["north", "south"], default="north")
    ap.add_argument("--humidity", choices=list(HUMIDITY), default="normal", help="low = heating on / below ~35 %%")
    ap.add_argument("--check-days", help="snap checks to these weekdays, e.g. Mon,Thu")
    ap.add_argument("--ics", help="also write an .ics calendar file")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    if not a.plants:
        ap.error("give a plants CSV, or --self-test")
    try:
        start = parse_date(a.start, "--start") if a.start else dt.date.today()
        if not 1 <= a.weeks <= 26:
            raise InputError("--weeks must be 1..26")
        days = None
        if a.check_days:
            days = [x.strip()[:3].title() for x in a.check_days.split(",") if x.strip()]
            for x in days:
                if x not in DAY_NAMES:
                    raise InputError(f"unknown weekday '{x}' in --check-days")
        with open(a.plants, encoding="utf-8") as fh:
            plants, warnings = load_plants(fh.read())
    except (OSError, InputError, UnicodeDecodeError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    res = plan(plants, start, a.weeks, a.hemisphere, a.humidity, days)
    if a.ics:
        stamp = dt.datetime.now(dt.timezone.utc).strftime("%Y%m%dT%H%M%SZ")
        with open(a.ics, "w", encoding="utf-8", newline="") as fh:
            fh.write(to_ics(res, stamp))
    if a.json:
        out = {**res, "start": res["start"].isoformat(), "end": res["end"].isoformat(),
               "calendar": [{"date": d.isoformat(), "plants": n} for d, n in res["calendar"]],
               "late_snaps": [{"plant": n, "due": d.isoformat(), "planned": p.isoformat()} for n, d, p in res["late_snaps"]],
               "plants": [{**p, "last_watered": p["last_watered"].isoformat() if p["last_watered"] else None} for p in res["plants"]],
               "warnings": [{"severity": s, "plant": n, "note": m} for s, n, m in warnings]}
        print(json.dumps(out, indent=2))
    else:
        sys.stdout.write(render(res, warnings))
    return 1 if any(w[0] == "HIGH" for w in warnings) else 0


if __name__ == "__main__":
sys.exit(main())So sánh các phương án đi làm - ô tô (xăng hoặc xe điện), phương tiện công cộng, xe đạp, xe đạp điện, đi bộ, kết hợp luân phiên theo ngày và chặng gửi xe đi tàu/buýt (park-and-ride) - theo tháng và năm kèm chi phí tiền mặt, thời gian di chuyển trọn gói từ cửa đến cửa, chi phí thời gian tính theo mức giá trị giờ của riêng bạn, chi phí mỗi chuyến và lượng phát thải CO2. Tự động chọn giữa vé tháng và trả tiền từng lượt dựa trên số ngày bạn đi, tách biệt chi phí vận hành xe với chi phí cố định, đồng thời hiển thị mức giá trị hòa vốn của một giờ. Bao gồm bộ tính toán bằng Python sử dụng thư viện chuẩn (stdlib) kèm tùy chọn --self-test.
---
name: commute-cost-comparison-calculator
description: So sánh các phương án đi làm - ô tô (xăng hoặc xe điện), phương tiện công cộng, xe đạp, xe đạp điện, đi bộ, kết hợp luân phiên theo ngày và chặng gửi xe đi tàu/buýt (park-and-ride) - theo tháng và năm kèm chi phí tiền mặt, thời gian di chuyển trọn gói từ cửa đến cửa, chi phí thời gian tính theo mức giá trị giờ của riêng bạn, chi phí mỗi chuyến và lượng phát thải CO2. Tự động chọn giữa vé tháng và trả tiền từng lượt dựa trên số ngày bạn đi, tách biệt chi phí vận hành xe với chi phí cố định, đồng thời hiển thị mức giá trị hòa vốn của một giờ. Bao gồm bộ tính toán bằng Python sử dụng thư viện chuẩn (stdlib) kèm tùy chọn --self-test.
---

# Công Cụ Tính Toán & So Sánh Chi Phí Đi Lại

Bạn giúp người dùng quyết định cách đi làm bằng việc đặt mọi phương án lên cùng một bàn cân: tốn bao nhiêu tiền mặt, lấy đi bao nhiêu thời gian trong cuộc sống của họ, và khoảng thời gian đó đáng giá bao nhiêu đối với họ. Bạn chỉ tính những khoản thực sự thay đổi theo lựa chọn (nhiên liệu, phí gửi xe, giá vé, chi phí xe đạp), loại bỏ các khoản họ đằng nào cũng phải trả trừ khi họ thực sự bán chiếc ô tô đó, và thể hiện sự đánh đổi bằng một con số rõ ràng: "lái xe tiết kiệm được 32 giờ mất đi mỗi năm và tốn thêm $3,697, vì vậy phương án này chỉ đáng giá nếu một giờ của bạn trị giá hơn $115".

## Các tệp trong kỹ năng này

- `scripts/commute_cost.py` - đọc tệp JSON kịch bản (khoảng cách, số ngày đi làm, giá trị thời gian, các phương án) và in ra bảng so sánh, tóm tắt nổi bật, giá trị thời gian hòa vốn và ghi chú cho từng phương án; hỗ trợ hệ mét (km, L/100 km) và hệ Anh-Mỹ (mi, mpg), xe điện (EV), vé tháng phương tiện công cộng có mức trần chi phí ngày và trợ cấp từ công ty, phương án kết hợp luân phiên theo ngày và chuyến đi nhiều chặng (chỉ dùng thư viện chuẩn của Python 3.8+)
- `references/cost-components.md` - mọi trường thông tin của phương án, những khoản cần đưa vào cho từng loại phương tiện, nơi tra cứu số liệu và các khoảng giá trị điển hình
- `references/time-value-and-assumptions.md` - cách chọn giá trị cho một giờ thời gian, thời gian có thể tận dụng trên phương tiện công cộng, những yếu tố chưa nằm trong tổng chi phí (sức khỏe, độ an toàn, thời tiết, sự linh hoạt) và cách chạy kiểm tra độ nhạy
- `templates/commute-comparison.md` - bản tóm tắt quyết định để gửi lại cho người dùng
- `examples/commute.json` - quãng đường đi làm 11 dặm với các phương án lái xe, xe buýt + tàu điện nhẹ (light rail), xe đạp điện, kết hợp xe đạp điện/phương tiện công cộng và gửi xe đi tàu/buýt (park-and-ride)
- `examples/comparison-output.md` - kết quả đầu ra thực tế của công cụ tính toán cho kịch bản đó

## Quy trình thực hiện

### 1. Thu thập thông tin thực tế
Khoảng cách một chiều, số ngày đi làm mỗi tuần (làm việc kết hợp hybrid ảnh hưởng rất lớn) và số tuần làm việc mỗi năm, số phút di chuyển từ cửa đến cửa cho mỗi phương án (bao gồm cả đi bộ, chờ đợi, gửi xe và chuyển tuyến: hãy hỏi thời gian chuyến đi thực tế chứ không chỉ lấy ước tính trên bản đồ), và thông tin theo từng phương tiện: mức tiêu thụ nhiên liệu của ô tô, giá xăng/dầu hoặc giá điện, phí gửi xe và cầu đường, liệu họ có giữ lại chiếc xe dù không lái đi làm hay không; giá vé lẻ phương tiện công cộng, giá vé tháng, mức trần chi phí ngày, trợ cấp của công ty; giá mua xe đạp hoặc xe đạp điện, tuổi thọ dự kiến và chi phí bảo dưỡng. Hãy hỏi xem một giờ thời gian của họ đáng giá bao nhiêu, hoặc đưa ra một mức mặc định (bằng một nửa mức lương theo giờ của họ) và trình bày phân tích độ nhạy.

### 2. Chạy công cụ tính toán
```
python3 scripts/commute_cost.py examples/commute.json
python3 scripts/commute_cost.py scenario.json --days-per-week 3
python3 scripts/commute_cost.py scenario.json --value-of-time 0 --json
python3 scripts/commute_cost.py --self-test
```
Mã thoát 0 = đã in bảng so sánh, 2 = dữ liệu đầu vào không hợp lệ (thiếu trường, tỷ lệ kết hợp cộng lại không bằng 1, loại phương tiện không xác định, giá âm). Nếu không chạy mã, hãy làm theo các công thức trong `references/cost-components.md`.

### 3. Đọc kết quả
- Bảng được sắp xếp theo tổng chi phí (tiền mặt + chi phí thời gian); dòng tiêu đề chỉ ra phương án rẻ nhất về tiền mặt, rẻ nhất khi tính cả thời gian và nhanh nhất.
- **Giá trị thời gian hòa vốn (Break-even value of time)** so sánh từng phương án với phương án rẻ nhất về tiền mặt: một phương án tốn nhiều tiền hơn chỉ đáng chọn nếu một giờ của bạn có giá trị cao hơn con số được hiển thị. "Never" (Không bao giờ) có nghĩa là phương án đó vừa tốn kém hơn vừa không tiết kiệm được thời gian hữu ích.
- Thời gian ngồi trên phương tiện công cộng mà bạn có thể tận dụng (đọc sách, xử lý email) được khấu trừ thông qua `usable_time_share`; cùng trường này cũng có thể dùng để cộng điểm cho thời gian đạp xe nếu việc đó thay thế cho thời gian tập thể dục mà đằng nào bạn cũng thực hiện. Hãy nêu rõ bạn đã áp dụng cách nào.
- Kiểm tra ghi chú về phương tiện công cộng: khi chỉ đi làm 2-3 ngày một tuần, vé tháng thường đắt hơn trả tiền từng lượt; công cụ tính toán sẽ tự chọn cách rẻ hơn và ghi chú rõ điều đó.

### 4. Bàn giao kết quả
Điền vào `templates/commute-comparison.md`: khuyến nghị gói gọn trong một câu, bảng so sánh, các mức giá trị hòa vốn, những yếu tố làm thay đổi câu trả lời (số ngày làm hybrid, giá nhiên liệu, phí gửi xe, giá trị thời gian), những yếu tố chưa được định giá bằng tiền, và gợi ý dùng thử (ví dụ: thử nghiệm phương án kết hợp trong hai tuần trước khi mua sắm bất cứ thứ gì).

## Ví dụ kết quả
11 dặm mỗi chiều, 5 ngày một tuần, 46 tuần, thời gian được định giá ở mức $20/giờ (`examples/commute.json`). Rẻ nhất về tiền mặt: xe buýt + tàu điện nhẹ ở mức $49/tháng sau khi trừ $50 trợ cấp từ công ty (vé tháng $99 rẻ hơn so với $105 tiền mua vé lẻ). Rẻ nhất khi tính cả thời gian: gửi xe đi tàu/buýt - park and ride ($95 tiền mặt, tổng cộng $361/tháng) vì 80 % thời gian chặng đi tàu có thể tận dụng làm việc khác. Lái xe vào trung tâm thành phố là nhanh nhất (28 phút) nhưng tốn $357/tháng với $12/ngày phí gửi xe và chỉ đáng giá nếu một giờ trị giá hơn $115. Xe đạp điện tốn trọn gói $67/tháng và không phát thải, nhưng không tiết kiệm thời gian hữu ích với các thông số này; phương án này sẽ chiến thắng nếu việc đạp xe thay thế cho thời gian tập gym. Xem `examples/comparison-output.md`.

## Quy tắc

- Chỉ tính những chi phí thực sự thay đổi theo lựa chọn; chỉ đưa chi phí bảo hiểm ô tô, đăng kiểm và lãi vay mua xe vào nếu người đó thực sự từ bỏ chiếc xe (`count_fixed`).
- Sử dụng thời gian thực tế từ cửa đến cửa, bao gồm cả đi bộ, chờ đợi, gửi xe và chuyển tuyến.
- Không bao giờ trình bày giá trị thời gian như một sự thật hiển nhiên: đó là lựa chọn riêng của mỗi người; hãy hiển thị ít nhất một lần chạy kiểm tra độ nhạy (ví dụ: `--value-of-time 0` và mức lương theo giờ của họ).
- Giữ các yếu tố sức khỏe, an toàn và thời tiết nằm ngoài tổng số tiền nhưng hãy đề cập đến chúng; không rao giảng đạo đức về việc đi ô tô hay xe đạp.
- Nêu rõ mọi giả định kèm theo con số cụ thể (giá nhiên liệu, phí gửi xe, khấu hao trên mỗi dặm) để người dùng có thể tự điều chỉnh.
- Sử dụng đơn vị tiền tệ và đơn vị đo lường đúng như người dùng đang sử dụng; không trộn lẫn dặm (miles) và kilômét (kilometres) trong cùng một kịch bản.
FILE:references/cost-components.md
# Các thành phần chi phí và trường thông tin phương án

Các trường của kịch bản: `currency` (USD, EUR, GBP, TRY, ...), `units` (`metric`: km, L/100 km, giá mỗi lít; `imperial`: dặm/miles, mpg, giá mỗi gallon Mỹ), `one_way_distance`, `days_per_week` (mặc định là 5), `weeks_per_year` (mặc định là 46: trừ ngày lễ, ngày nghỉ ốm, công tác), `value_of_time_per_hour`, `options`.

Mọi phương án đều có: `name`, `mode`, `minutes_one_way` (từ cửa đến cửa), `distance_one_way` tùy chọn (mặc định lấy theo khoảng cách của kịch bản), `usable_time_share` tùy chọn (0..1).

## Ô tô (`mode: car`)
| Trường | Ý nghĩa | Giá trị điển hình |
|---|---|---|
| `fuel_economy_mpg` / `fuel_l_per_100km` | mức tiêu thụ thực tế trên tuyến đường này (lái xe trong phố tốn hơn thông số nhãn) | 25-35 mpg / 6-9 L/100 km |
| `fuel_price` | tính theo mỗi gallon / mỗi lít | giá tại trạm xăng địa phương |
| `fuel: "diesel"` | sử dụng hệ số phát thải CO2 của dầu diesel | mặc định là xăng (petrol) |
| `kwh_per_100` + `electricity_price` | xe điện thay vì nhiên liệu đốt trong (kWh trên mỗi 100 dặm hoặc km) | 25-35 kWh/100 mi, 16-22 kWh/100 km |
| `grid_kg_co2_per_kwh` | cường độ phát thải của lưới điện để tính CO2 cho xe điện | mặc định 0.4; 0.05 với thủy điện/điện hạt nhân, 0.7 với lưới điện phụ thuộc nhiều vào than đá |
| `maintenance_per_distance` | lốp xe, bảo dưỡng định kỳ, sửa chữa trên mỗi dặm/km | $0.08-0.12/mi, 0.05-0.08/km |
| `depreciation_per_distance` | phần giá trị mất đi chỉ do số dặm/km chạy thêm (không tính hao mòn theo tuổi xe) | $0.05-0.15/mi |
| `parking_per_day`, `tolls_per_day` | tính trên mỗi ngày đi làm | phí gửi xe tại nơi làm việc có thể chiếm tỷ trọng lớn nhất |
| `fixed_per_year` + `count_fixed` | bảo hiểm, đăng kiểm, lãi vay, khấu hao theo tuổi xe; chỉ được tính khi `count_fixed` là true | chỉ đặt là true nếu việc đi làm là lý do duy nhất để sở hữu chiếc xe |

Chi phí nhiên liệu = 2 x khoảng cách x số ngày / mpg x giá (hoặc x L/100 km / 100 x giá). Khí thải CO2: xăng 2.35 kg/L (8.89 kg mỗi gallon Mỹ), dầu diesel 2.68 kg/L (10.18 kg/gal), xe điện tính bằng số kWh x hệ số phát thải lưới điện.

Các mức chi phí trọn gói trên mỗi dặm (định mức khấu trừ thuế theo dặm, báo cáo "Your Driving Costs" của AAA) đã bao gồm cả chi phí cố định; chúng làm phóng đại chi phí cận biên của việc đi làm khi đằng nào người dùng vẫn giữ lại chiếc xe.

## Phương tiện công cộng (`mode: transit`)
| Trường | Ý nghĩa |
|---|---|
| `fare_per_ride`, `rides_per_day` (mặc định là 2) | giá vé lẻ; cộng thêm một lượt cho mỗi lần chuyển tuyến có thu phí (không được miễn phí) |
| `daily_cap` | mức trần giá vé tối đa trong ngày, nếu hệ thống giao thông có áp dụng |
| `monthly_pass` | giá vé tháng; công cụ tính toán sẽ so sánh 12 vé tháng với chi phí trả từng lượt cho số ngày thực tế đi lại và chọn phương án rẻ hơn |
| `subsidy_per_month` | khoản trợ cấp từ công ty hoặc phúc lợi miễn thuế, được khấu trừ trực tiếp (không bao giờ giảm xuống dưới 0) |
| `co2_g_per_passenger_km` | mặc định 80 g; tàu điện 20-40, xe buýt chạy dầu diesel 80-120 ở mức tải trọng trung bình |
| `usable_time_share` | tỷ lệ thời gian chuyến đi bạn có thể đọc sách hoặc làm việc (có chỗ ngồi, không bị căng thẳng vì chuyển tuyến): 0.2-0.8 |

## Xe đạp, xe đạp điện, đi bộ (`mode: bike | ebike | walk`)
| Trường | Ý nghĩa | Giá trị điển hình |
|---|---|---|
| `purchase_price`, `life_years` | phân bổ đều trong suốt vòng đời sử dụng (mặc định 5 năm); không dùng cho đi bộ | xe đạp điện $1,500-3,500 |
| `maintenance_per_year` | lốp, xích, má phanh, quỹ thay pin cho xe đạp điện | $100-300 |
| `gear_per_year` | đèn, khóa, áo mưa, thay mũ bảo hiểm | $50-150 |
| `kwh_per_100`, `electricity_price` | chi phí sạc xe đạp điện | 1-2 kWh trên mỗi 100 dặm |
| `other_per_month` | phí gửi xe đạp, thuê tủ đồ, thẻ phòng tắm | 0-30 |
Chi phí sở hữu được tính toàn bộ ngay cả trong phương án kết hợp: bạn vẫn phải trả tiền mua chiếc xe đạp dù đi 3 hay 5 ngày một tuần.

## Kết hợp (`mode: mix`)
`"shares": {"E-bike": 0.6, "Bus + light rail": 0.4}` chia số ngày đi làm giữa các phương án khác nhau (tổng các tỷ lệ cộng lại bằng 1). Mỗi phần được tính chi phí theo đúng số ngày sử dụng của phần đó, vì vậy phần đi phương tiện công cộng trong 2 ngày một tuần thường sẽ chuyển sang hình thức trả tiền từng lượt. Hãy sử dụng chế độ này cho việc đạp xe phụ thuộc vào thời tiết, lái xe kết hợp (hybrid), hoặc những ngày đi chung xe (carpool).

## Nhiều chặng (`mode: multi`)
`"legs": [ {car leg}, {transit leg} ]` cùng với `transfer_minutes`. Mỗi chặng cần có `distance_one_way` và `minutes_one_way` riêng; chi phí và số phút sẽ được cộng dồn lại. Hãy dùng chế độ này cho hình thức gửi xe đi tàu/buýt (park and ride), xe đạp + tàu hỏa, hoặc đi bộ + xe buýt.

## Lấy số liệu ở đâu
- Mức tiêu thụ nhiên liệu: xem trên đồng hồ hành trình (trip computer) của ô tô trong suốt một tuần đi làm thực tế.
- Phí gửi xe và giá vé: trang bảng giá của đơn vị vận hành; kiểm tra các phúc lợi từ công ty (trợ cấp phương tiện công cộng trước thuế, quy đổi chỗ đỗ xe thành tiền mặt - parking cash-out).
- Thời gian từ cửa đến cửa: bấm giờ một chuyến đi thực tế cho mỗi chiều vào đúng khung giờ cao điểm đi làm; cộng thêm 5 phút dự phòng cho sự dao động khi tìm chỗ đỗ xe hoặc chờ tàu/buýt.
FILE:references/time-value-and-assumptions.md
# Giá trị thời gian và những yếu tố chưa nằm trong tổng chi phí

## Cách chọn giá trị thời gian
- Không có con số nào là đúng tuyệt đối: đó là mức giá trị mà một giờ đi làm thực sự mang lại cho chính người đó.
- Mốc tham chiếu phổ biến: khoảng một nửa mức lương thực nhận theo giờ đối với việc di chuyển cá nhân (hướng dẫn định giá thời gian di chuyển của Bộ Giao thông Vận tải Hoa Kỳ sử dụng mức 50 % thu nhập theo giờ cho các chuyến đi cá nhân tại địa phương; di chuyển công tác được định giá ở mức 100 %).
- Một người hưởng lương cố định, không thể kiếm thêm thu nhập nhờ giảm thời gian đi lại có thể chọn mức giá trị thấp hơn; một người làm nghề tự do (freelancer) có thể tính phí cho những giờ tiết kiệm được sẽ chọn mức cao hơn.
- Luôn trình bày phân tích độ nhạy: `--value-of-time 0` (chỉ tính tiền mặt), mức giá trị đã chọn, và toàn bộ mức lương theo giờ của họ. Nếu thứ hạng các phương án không thay đổi, quyết định đó là vững chắc.

## Thời gian có thể tận dụng
`usable_time_share` khấu trừ khoảng thời gian bạn có thể tận dụng làm việc khác. Hướng dẫn ước tính sơ bộ:
| Tình huống | Tỷ lệ |
|---|---|
| Lái xe, đạp xe giữa dòng giao thông, đứng trên xe buýt đông đúc | 0 |
| Đi xe buýt có chỗ ngồi, các chặng ngắn, phải chuyển tuyến | 0.2-0.4 |
| Đi tàu có chỗ ngồi và bàn làm việc, hơn 20 phút liên tục không phải đổi chuyến | 0.6-0.8 |
| Đạp xe hoặc đi bộ giúp thay thế cho thời gian tập thể dục mà đằng nào bạn cũng làm | 0.3-0.7 (hãy nêu rõ điều này) |

## Những yếu tố không nằm trong tổng số tiền (cần đề cập đến)
- **Sức khỏe:** đạp xe hoặc đi bộ thường xuyên gắn liền với sức khỏe tim mạch tốt hơn; một số người đánh giá rất cao lợi ích này, số khác lại không quan tâm. Hãy sử dụng `usable_time_share` nếu họ muốn quy đổi lợi ích này thành tiền.
- **Độ an toàn:** rủi ro tai nạn giao thông trên mỗi dặm khác nhau tùy theo phương tiện và tuyến đường; một làn đường dành riêng cho xe đạp có rào chắn bảo vệ sẽ làm thay đổi hoàn toàn bức tranh tổng thể.
- **Thời tiết và mùa vụ:** hãy sử dụng phương án kết hợp (ví dụ: 60 % số ngày đi xe đạp) thay vì giả định ngày nào cũng có thể đạp xe.
- **Độ ổn định (Reliability):** một chuyến tàu mất 40 phút với biên độ dao động 10 phút có thể tốt hơn một chuyến lái xe trung bình 30 phút nhưng dao động từ 25 đến 60 phút; hãy hỏi về các khoản phạt hoặc hậu quả khi trễ giờ (ví dụ: đón con muộn tại nhà trẻ).
- **Sự linh hoạt và giá trị quyền chọn:** việc có sẵn ô tô để tạt qua giải quyết việc vặt trên đường, hoặc cho các tình huống khẩn cấp; dịch vụ thuê xe theo giờ hoặc ngân sách đi taxi có thể thay thế cho những ngày hiếm hoi đó (cộng thêm vào mục `other_per_month`).
- **Mức độ căng thẳng và sự thoải mái:** đừng định giá bằng tiền, nhưng hãy hỏi người dùng về yếu tố này.

## Các kịch bản kiểm tra độ nhạy đáng thực hiện
- Làm việc kết hợp (Hybrid work): `--days-per-week 3` thường làm đảo ngược sự lựa chọn giữa vé tháng và trả tiền từng lượt, đồng thời khiến việc sở hữu chiếc ô tô thứ hai trở nên kém kinh tế hơn hẳn.
- Phí gửi xe: sự thay đổi về giá gửi xe (hoặc khoản tiền công ty thưởng khi không dùng chỗ đỗ xe) thường là đòn bẩy đơn lẻ lớn nhất.
- Giá nhiên liệu hoặc giá điện biến động +-25 %.
- Bán chiếc ô tô thứ hai: chạy lại tính toán với `count_fixed: true` cho phương án ô tô để thấy toàn bộ khoản tiền tiết kiệm được.

## Kiểm tra tính hợp lý trước khi trình bày
- Chi phí tiền mặt mỗi chuyến khi lái xe tối thiểu phải bằng chi phí nhiên liệu + phí gửi xe mỗi chuyến.
- Chi phí tiền mặt mỗi tháng cho phương tiện công cộng không được vượt quá giá vé tháng trừ khi vé tháng không bao phủ hết tuyến đường đó.
- Số giờ mỗi tháng = số phút một chiều x 2 x số ngày mỗi tháng / 60.
- Nếu phương án "chiến thắng" phụ thuộc vào một mức giá trị thời gian cách quá xa so với con số người dùng đưa ra, hãy nói rõ điều đó một cách thẳng thắn.
FILE:templates/commute-comparison.md
# Các phương án đi làm: <nhà> đến <nơi làm việc>

**Chuyến đi:** <11 dặm mỗi chiều, 5 ngày/tuần, 46 tuần/năm>   **Giá trị thời gian áp dụng:** <$20/giờ (khoảng một nửa lương theo giờ)>
**Khuyến nghị:** <một câu, ví dụ: "Gửi xe đi tàu/buýt (Park and ride): $95/tháng tiền mặt, 40 phút từ cửa đến cửa, phần lớn thời gian đi tàu có thể tận dụng để xử lý email">

## Bảng so sánh (theo tháng)
| Phương án | Tiền mặt | Từ cửa đến cửa | Số giờ | Chi phí thời gian | Tổng cộng | CO2 kg/năm |
|---|---|---|---|---|---|---|
| <Park and ride> | <$95> | <40 min> | <25.6> | <$266> | <$361> | <999> |
| <Bus + light rail> | <$49> | <46 min> | <29.4> | <$411> | <$460> | <651> |

## Khi nào một phương án đắt đỏ hơn mới đáng tiền
| Phương án | Chi phí tăng thêm mỗi năm | Số giờ mất đi được tiết kiệm | Đáng giá nếu một giờ trị giá trên |
|---|---|---|---|
| <Drive downtown> | <$3,697> | <32> | <$115/hour> |

## Những yếu tố sẽ làm thay đổi câu trả lời
- <Làm việc kết hợp (3 ngày): vé tháng phương tiện công cộng không còn có lợi; trả tiền từng lượt ...>
- <Khoản tiền thưởng không dùng chỗ đỗ xe từ công ty sẽ khiến việc lái xe đắt thêm $230/tháng nữa>
- <Nếu chuyến đi bằng xe đạp điện thay thế cho việc tập gym, phương án xe đạp điện sẽ vươn lên ...>

## Những yếu tố chưa được định giá bằng tiền
- <sức khỏe, độ an toàn trên tuyến đường, những ngày thời tiết xấu, độ ổn định giờ giấc, nhu cầu dùng ô tô để đón con đi học>

## Các giả định
- <nhiên liệu $3.40/gal ở mức tiêu thụ 28 mpg; bảo dưỡng $0.10/mi; khấu hao theo số dặm $0.08/mi; phí gửi xe $12/ngày>
- <vé tháng phương tiện công cộng $99, trợ cấp từ công ty $50/tháng, 30 % thời gian đi xe buýt/tàu có thể tận dụng>
- <vẫn giữ ô tô để đi cuối tuần, do đó chi phí bảo hiểm và đăng kiểm không được tính vào>

## Bước tiếp theo
<Thử nghiệm phương án kết hợp trong hai tuần trước khi mua xe đạp điện; bấm giờ thực tế từng chuyến từ cửa đến cửa.>
FILE:examples/commute.json
{
  "currency": "USD",
  "units": "imperial",
  "one_way_distance": 11,
  "days_per_week": 5,
  "weeks_per_year": 46,
  "value_of_time_per_hour": 20,
  "options": [
    {
      "name": "Drive downtown",
      "mode": "car",
      "minutes_one_way": 28,
      "fuel_economy_mpg": 28,
      "fuel_price": 3.4,
      "maintenance_per_distance": 0.1,
      "depreciation_per_distance": 0.08,
      "parking_per_day": 12,
      "tolls_per_day": 0,
      "fixed_per_year": 1900,
      "count_fixed": false
    },
    {
      "name": "Bus + light rail",
      "mode": "transit",
      "minutes_one_way": 46,
      "fare_per_ride": 2.75,
      "monthly_pass": 99,
      "subsidy_per_month": 50,
      "usable_time_share": 0.3
    },
    {
      "name": "E-bike",
      "mode": "ebike",
      "minutes_one_way": 42,
      "purchase_price": 2200,
      "life_years": 5,
      "maintenance_per_year": 250,
      "gear_per_year": 100,
      "kwh_per_100": 1.5,
      "electricity_price": 0.17
    },
    {
      "name": "E-bike 3 days, transit 2 days",
      "mode": "mix",
      "shares": {"E-bike": 0.6, "Bus + light rail": 0.4}
    },
    {
      "name": "Park and ride",
      "mode": "multi",
      "transfer_minutes": 6,
      "legs": [
        {"mode": "car", "distance_one_way": 4, "minutes_one_way": 10, "fuel_economy_mpg": 28, "fuel_price": 3.4,
         "maintenance_per_distance": 0.1, "depreciation_per_distance": 0.08, "parking_per_day": 0},
        {"mode": "transit", "distance_one_way": 7, "minutes_one_way": 24, "fare_per_ride": 2.75, "monthly_pass": 99,
         "subsidy_per_month": 50, "usable_time_share": 0.8}
      ]
    }
  ]
}
FILE:examples/comparison-output.md
# So sánh chi phí đi làm

Một chiều: 11 dặm   Số ngày đi làm: 19.2/tháng (230/năm)   Giá trị thời gian: $20.00/giờ   Tiền tệ: USD

| Phương án | Tiền mặt / tháng | Tiền mặt / năm | Mỗi chuyến | Từ cửa đến cửa (một chiều) | Số giờ / tháng | Chi phí thời gian / tháng | Tổng cộng / tháng | CO2 kg / năm |
|---|---|---|---|---|---|---|---|---|
| Park and ride | $95.22 | $1,143 | $2.48 | 40 min | 25.6 | $266 | **$361** | 999 |
| Bus + light rail | $49.00 | $588 | $1.28 | 46 min | 29.4 | $411 | **$460** | 651 |
| E-bike 3 days, transit 2 days | $66.48 | $798 | $1.73 | 44 min | 27.9 | $487 | **$553** | 261 |
| E-bike | $66.91 | $803 | $1.75 | 42 min | 26.8 | $537 | **$604** | 0 |
| Drive downtown | $357 | $4,285 | $9.32 | 28 min | 17.9 | $358 | **$715** | 1,607 |

Được sắp xếp theo tổng chi phí (tiền mặt + chi phí thời gian).

## Điểm nổi bật

- Rẻ nhất về tiền mặt: **Bus + light rail** ($49.00/tháng).
- Rẻ nhất khi tính cả thời gian: **Park and ride** ($361/tháng ở mức $20.00/giờ).
- Nhanh nhất: **Drive downtown** (28 phút một chiều, 17.9 giờ/tháng).

## Giá trị thời gian hòa vốn (so với Bus + light rail, phương án rẻ nhất về tiền mặt)

| Phương án | Tiền mặt tăng thêm / năm | Số giờ mất đi tiết kiệm được / năm | Đáng giá nếu một giờ của bạn trị giá hơn |
|---|---|---|---|
| Drive downtown | $3,697 | 32 | $115/hour |
| E-bike | $215 | không có (mất thêm 75 giờ) | không bao giờ xét về chi phí: phương án này không tiết kiệm thời gian hữu ích |
| E-bike 3 days, transit 2 days | $210 | không có (mất thêm 45 giờ) | không bao giờ xét về chi phí: phương án này không tiết kiệm thời gian hữu ích |
| Park and ride | $555 | 87 | $6.35/hour |

## Ghi chú cho từng phương án

- **Drive downtown** (car): mỗi tháng: nhiên liệu/năng lượng $51.20, bảo dưỡng + khấu hao $75.90, phí gửi xe + cầu đường $230; chi phí cố định (bảo hiểm, đăng kiểm) không được tính: đằng nào bạn vẫn giữ lại chiếc xe
- **Bus + light rail** (transit): mỗi tháng: tiền vé $49.00; dùng vé tháng (rẻ hơn mức $105/tháng nếu trả từng lượt cho 19.2 ngày/tháng); đã khấu trừ trợ cấp từ công ty $50.00/tháng
- **E-bike** (ebike): mỗi tháng: tiền xe + bảo dưỡng $65.83, nhiên liệu/năng lượng $1.08; chi phí sở hữu được tính toàn bộ (chúng không giảm đi vào những ngày bạn không đạp xe)
- **E-bike 3 days, transit 2 days** (mix): E-bike 60 % số ngày (11.5/tháng): chi phí sở hữu được tính toàn bộ (chúng không giảm đi vào những ngày bạn không đạp xe); Bus + light rail 40 % số ngày (7.7/tháng): trả tiền từng lượt (mua vé tháng sẽ tốn tới $99.00/tháng cho 7.7 ngày/tháng)
- **Park and ride** (multi): chặng 2 (transit): dùng vé tháng (rẻ hơn mức $105/tháng nếu trả từng lượt cho 19.2 ngày/tháng); chặng 2 (transit): đã khấu trừ trợ cấp từ công ty $50.00/tháng

Chi phí thời gian = số giờ x giá trị thời gian x (1 - tỷ lệ chuyến đi bạn có thể tận dụng để đọc sách hoặc làm việc). Chưa bao gồm: lợi ích sức khỏe, rủi ro tai nạn, những ngày thời tiết xấu và giá trị quyền chọn của việc có sẵn ô tô; xem references/time-value-and-assumptions.md.
FILE:scripts/commute_cost.py
#!/usr/bin/env python3
"""Commute cost comparison calculator (Python 3.8+ standard library only).

Compares commute options - car (fuel or electric), transit, bike, e-bike, walking,
day-share mixes ("bike 3 days, train 2 days") and same-day multi-leg trips ("drive to
the station, then train") - per month and per year: cash cost, time spent, time cost at
your own hourly value, total, cost per trip and CO2. For transit it picks the cheaper of
pay-per-ride (with a daily cap) and a monthly pass for the days you actually ride; for
cars it separates running costs from fixed costs you would keep paying anyway. It also
prints break-even values of time: how much an hour must be worth to you before a faster,
dearer option pays off.

Usage:
  python3 commute_cost.py scenario.json [--value-of-time 25] [--days-per-week 3] [--json]
  python3 commute_cost.py --self-test
scenario.json: {"currency": "USD", "units": "imperial"|"metric", "one_way_distance": 11,
  "days_per_week": 5, "weeks_per_year": 46, "value_of_time_per_hour": 20,
  "options": [{"name": "...", "mode": "car|transit|bike|ebike|walk|mix|multi", ...}]}
See references/cost-components.md for every option field.
Exit codes: 0 = comparison printed, 2 = bad input.
"""
import argparse, json, sys

PETROL_CO2 = {"metric": 2.35, "imperial": 8.89}   # kg CO2 per litre / per US gallon burned (diesel: 2.68 / 10.18)
DIESEL_CO2 = {"metric": 2.68, "imperial": 10.18}
KM_PER_UNIT = {"metric": 1.0, "imperial": 1.609344}
LABELS = {"energy": "fuel/energy", "running": "maintenance + depreciation", "parking_tolls": "parking + tolls",
          "fixed": "fixed costs", "fares": "fares", "ownership": "bike + upkeep", "other": "other"}
MODES = {"car", "transit", "bike", "ebike", "walk", "mix", "multi"}
SYMBOLS = {"USD": "$", "EUR": "€", "GBP": "£", "TRY": "₺", "CAD": "C$", "AUD": "A$", "JPY": "¥", "INR": "₹"}


class InputError(Exception):
    pass


def num(o, key, default=None, lo=0.0, hi=None, who=""):
    v = o.get(key, default)
    if v is None:
        raise InputError(f"{who}: '{key}' is required")
    if isinstance(v, bool) or not isinstance(v, (int, float)):
        raise InputError(f"{who}: '{key}' must be a number")
    if v < lo or (hi is not None and v > hi):
        raise InputError(f"{who}: '{key}' = {v} is out of range" + (f" ({lo}..{hi})" if hi is not None else f" (>= {lo})"))
    return float(v)


def car_cost(o, sc, days, who):
    """Annual cost dict for a car over `days` commute days."""
    units = sc["units"]
    d = num(o, "distance_one_way", sc["distance"], who=who) * 2 * days      # user units per year
    if "kwh_per_100" in o:
        kwh = d / 100 * num(o, "kwh_per_100", who=who)
        energy = kwh * num(o, "electricity_price", who=who)
        co2 = kwh * num(o, "grid_kg_co2_per_kwh", 0.4, who=who)
    else:
        if units == "imperial":
            vol = d / num(o, "fuel_economy_mpg", lo=1, who=who)
        else:
            vol = d / 100 * num(o, "fuel_l_per_100km", lo=0.5, who=who)
        energy = vol * num(o, "fuel_price", who=who)
        co2 = vol * (DIESEL_CO2 if o.get("fuel") == "diesel" else PETROL_CO2)[units]
    running = d * (num(o, "maintenance_per_distance", 0, who=who) + num(o, "depreciation_per_distance", 0, who=who))
    daily = days * (num(o, "parking_per_day", 0, who=who) + num(o, "tolls_per_day", 0, who=who))
    fixed = num(o, "fixed_per_year", 0, who=who) if o.get("count_fixed", False) else 0.0
    return {"energy": energy, "running": running, "parking_tolls": daily, "fixed": fixed,
            "co2": co2, "notes": ([] if o.get("count_fixed", False) or not o.get("fixed_per_year") else
                                  ["fixed costs (insurance, registration) not counted: you keep the car anyway"])}


def transit_cost(o, sc, days, who):
    rides = num(o, "rides_per_day", 2, lo=1, who=who)
    fare = num(o, "fare_per_ride", who=who)
    cap = o.get("daily_cap")
    per_day = fare * rides if cap is None else min(fare * rides, num(o, "daily_cap", who=who))
    payg_year = per_day * days
    best, note = payg_year, "pay per ride"
    if o.get("monthly_pass") is not None:
        pass_year = num(o, "monthly_pass", who=who) * 12
        months_days = days / 12
        if pass_year < payg_year:
            best, note = pass_year, f"monthly pass (cheaper than {fmt_plain(payg_year / 12, sc['sym'])}/month pay per ride at {months_days:.1f} days/month)"
        else:
            note = f"pay per ride (pass would cost {fmt_plain(pass_year / 12, sc['sym'])}/month at {months_days:.1f} days/month)"
    subsidy = num(o, "subsidy_per_month", 0, who=who) * 12
    best = max(0.0, best - subsidy)
    km = num(o, "distance_one_way", sc["distance"], who=who) * 2 * days * KM_PER_UNIT[sc["units"]]
    co2 = km * num(o, "co2_g_per_passenger_km", 80, who=who) / 1000
    return {"fares": best, "co2": co2, "notes": [note] + ([f"employer subsidy {fmt_plain(subsidy / 12, sc['sym'])}/month deducted"] if subsidy else [])}


def bike_cost(o, sc, days, who, mode):
    d = num(o, "distance_one_way", sc["distance"], who=who) * 2 * days
    own = 0.0
    if mode != "walk":
        life = num(o, "life_years", 5, lo=0.5, who=who)
        own = num(o, "purchase_price", 0, who=who) / life
    own += num(o, "maintenance_per_year", 0, who=who) + num(o, "gear_per_year", 0, who=who)
    energy = 0.0
    if mode == "ebike":
        kwh = d / 100 * num(o, "kwh_per_100", 1.2, who=who)
        energy = kwh * num(o, "electricity_price", 0, who=who)
    extra = num(o, "other_per_month", 0, who=who) * 12
    return {"ownership": own, "energy": energy, "other": extra, "co2": 0.0,
            "notes": ["ownership costs counted in full (they do not shrink on days you do not ride)"] if own else []}


def option_cost(o, sc, days, who):
    mode = o.get("mode")
    if mode == "car":
        c = car_cost(o, sc, days, who)
    elif mode == "transit":
        c = transit_cost(o, sc, days, who)
    elif mode in ("bike", "ebike", "walk"):
        c = bike_cost(o, sc, days, who, mode)
    else:
        raise InputError(f"{who}: mode '{mode}' is not allowed here (use car, transit, bike, ebike, walk)")
    minutes = num(o, "minutes_one_way", who=who, lo=1)
    cash = sum(v for k, v in c.items() if k not in ("co2", "notes"))
    return {"cash": cash, "minutes": minutes, "co2": c["co2"], "notes": c["notes"],
            "usable": num(o, "usable_time_share", 0, hi=1, who=who),
            "breakdown": {k: v for k, v in c.items() if k not in ("co2", "notes")}}


def evaluate(sc_raw, value_override=None, dpw_override=None):
    if not isinstance(sc_raw, dict) or not isinstance(sc_raw.get("options"), list) or not sc_raw["options"]:
        raise InputError("scenario needs an 'options' list")
    units = sc_raw.get("units", "metric")
    if units not in KM_PER_UNIT:
        raise InputError("units must be 'metric' or 'imperial'")
    cur = sc_raw.get("currency", "USD")
    sc = {"units": units, "distance": num(sc_raw, "one_way_distance", who="scenario", lo=0.1),
          "sym": SYMBOLS.get(cur, f"{cur} ")}
    dpw = dpw_override if dpw_override is not None else num(sc_raw, "days_per_week", 5, lo=0.5, hi=7, who="scenario")
    wpy = num(sc_raw, "weeks_per_year", 46, lo=1, hi=52, who="scenario")
    days = dpw * wpy
    vot = value_override if value_override is not None else num(sc_raw, "value_of_time_per_hour", 0, who="scenario")
    by_name = {}
    for i, o in enumerate(sc_raw["options"]):
        if not isinstance(o, dict) or not o.get("name") or o.get("mode") not in MODES:
            raise InputError(f"option {i + 1}: needs a 'name' and a 'mode' ({', '.join(sorted(MODES))})")
        if o["name"] in by_name:
            raise InputError(f"option name '{o['name']}' is used twice")
        by_name[o["name"]] = o
    results = []
    for o in sc_raw["options"]:
        who = o["name"]
        if o["mode"] == "mix":
            shares = o.get("shares")
            if not isinstance(shares, dict) or not shares:
                raise InputError(f"{who}: mix needs 'shares', e.g. {{\"Bike\": 0.6, \"Transit\": 0.4}}")
            tot = sum(shares.values())
            if abs(tot - 1) > 0.001:
                raise InputError(f"{who}: shares add up to {tot:g}, not 1")
            cash = co2 = hours = eff = 0.0
            notes, parts = [], []
            for nm, sh in shares.items():
                if nm not in by_name or by_name[nm]["mode"] in ("mix",):
                    raise InputError(f"{who}: share '{nm}' must name another non-mix option")
                sub = by_name[nm]
                part = multi_cost(sub, sc, days * sh, nm) if sub["mode"] == "multi" else option_cost(sub, sc, days * sh, nm)
                cash += part["cash"]; co2 += part["co2"]
                h = part["minutes"] * 2 * days * sh / 60
                hours += h; eff += h * (1 - part["usable"])
                parts.append(f"{nm} {sh * 100:.0f} % of days ({days * sh / 12:.1f}/month): {part['notes'][0] if part['notes'] else 'as above'}")
            minutes = hours * 60 / (2 * days)
            results.append(row(who, "mix", cash, minutes, hours, eff, vot, co2, days, parts))
            continue
        part = multi_cost(o, sc, days, who) if o["mode"] == "multi" else option_cost(o, sc, days, who)
        hours = part["minutes"] * 2 * days / 60
        results.append(row(who, o["mode"], part["cash"], part["minutes"], hours, hours * (1 - part["usable"]), vot,
                           part["co2"], days, part["notes"], part.get("breakdown")))
    return {"currency": sc_raw.get("currency", "USD"), "units": units, "one_way_distance": sc["distance"],
            "days_per_year": days, "days_per_month": days / 12, "value_of_time_per_hour": vot,
            "options": results, "break_even": break_even(results)}


def multi_cost(o, sc, days, who):
    legs = o.get("legs")
    if not isinstance(legs, list) or len(legs) < 2:
        raise InputError(f"{who}: multi needs at least two 'legs'")
    cash = co2 = minutes = 0.0
    notes, usable_min = [], 0.0
    for j, leg in enumerate(legs, 1):
        if leg.get("mode") in ("mix", "multi"):
            raise InputError(f"{who} leg {j}: legs cannot be mix or multi")
        if "distance_one_way" not in leg:
            raise InputError(f"{who} leg {j}: each leg needs its own 'distance_one_way'")
        p = option_cost(leg, sc, days, f"{who} leg {j}")
        cash += p["cash"]; co2 += p["co2"]; minutes += p["minutes"]
        usable_min += p["minutes"] * p["usable"]
        notes += [f"leg {j} ({leg['mode']}): {n}" for n in p["notes"]]
    minutes += num(o, "transfer_minutes", 0, who=who)
    return {"cash": cash, "co2": co2, "minutes": minutes, "notes": notes or ["legs summed"],
            "usable": usable_min / minutes if minutes else 0.0}


def row(name, mode, cash, minutes, hours, eff_hours, vot, co2, days, notes, breakdown=None):
    tcost = eff_hours * vot
    return {"name": name, "mode": mode, "cash_year": cash, "cash_month": cash / 12, "minutes_one_way": minutes,
            "hours_month": hours / 12, "lost_hours_month": eff_hours / 12, "time_cost_month": tcost / 12, "total_month": (cash + tcost) / 12,
            "total_year": cash + tcost, "cost_per_trip": cash / (2 * days), "co2_kg_year": co2,
            "notes": notes, "breakdown": breakdown or {}}


def break_even(results):
    """For each option, the hourly value of time at which it ties with the cheapest-cash option.
    Uses lost hours (time you cannot use for reading or work), the same basis as the time cost."""
    base = min(results, key=lambda r: r["cash_year"])
    out = []
    for r in results:
        if r is base:
            continue
        extra = r["cash_year"] - base["cash_year"]
        hours_saved = (base["lost_hours_month"] - r["lost_hours_month"]) * 12
        if hours_saved > 0.01:
            out.append({"option": r["name"], "vs": base["name"], "extra_cash_year": extra,
                        "hours_saved_year": hours_saved, "break_even_per_hour": extra / hours_saved})
        else:
            out.append({"option": r["name"], "vs": base["name"], "extra_cash_year": extra,
                        "hours_saved_year": hours_saved, "break_even_per_hour": None})
    return out


def fmt_plain(v, sym="$"):
    return f"{sym}{v:,.0f}" if abs(v) >= 100 else f"{sym}{v:,.2f}"


def render(res):
    sym = SYMBOLS.get(res["currency"], res["currency"] + " ")
    f = lambda v: fmt_plain(v, sym)
    du = "mi" if res["units"] == "imperial" else "km"
    out = [f"# Commute cost comparison", "",
           f"One way: {res['one_way_distance']:g} {du}   Commute days: {res['days_per_month']:.1f}/month ({res['days_per_year']:.0f}/year)   "
           f"Value of time: {f(res['value_of_time_per_hour'])}/hour   Currency: {res['currency']}", "",
           "| Option | Cash / month | Cash / year | Per trip | Door to door (one way) | Hours / month | Time cost / month | Total / month | CO2 kg / year |",
           "|---|---|---|---|---|---|---|---|---|"]
    rs = res["options"]
    for r in sorted(rs, key=lambda r: r["total_month"]):
        out.append(f"| {r['name']} | {f(r['cash_month'])} | {f(r['cash_year'])} | {f(r['cost_per_trip'])} | {r['minutes_one_way']:.0f} min | "
                   f"{r['hours_month']:.1f} | {f(r['time_cost_month'])} | **{f(r['total_month'])}** | {r['co2_kg_year']:,.0f} |")
    cheapest = min(rs, key=lambda r: r["cash_year"])
    best_total = min(rs, key=lambda r: r["total_year"])
    fastest = min(rs, key=lambda r: r["minutes_one_way"])
    out += ["", "Sorted by total (cash + time cost).", "",
            "## Headline", "",
            f"- Cheapest in cash: **{cheapest['name']}** ({f(cheapest['cash_month'])}/month).",
            f"- Cheapest once time counts: **{best_total['name']}** ({f(best_total['total_month'])}/month at {f(res['value_of_time_per_hour'])}/hour).",
            f"- Fastest: **{fastest['name']}** ({fastest['minutes_one_way']:.0f} min one way, {fastest['hours_month']:.1f} h/month)."]
    out += ["", f"## Break-even value of time (vs {cheapest['name']}, the cheapest in cash)", "",
            "| Option | Extra cash / year | Lost hours saved / year | Worth it if your hour is worth more than |", "|---|---|---|---|"]
    for b in res["break_even"]:
        if b["break_even_per_hour"] is None:
            verdict = "never on cost: it does not save usable time" if b["extra_cash_year"] > 0 else "always: same cash, no more lost time"
            hs = f"{b['hours_saved_year']:.0f}" if b["hours_saved_year"] >= 0 else f"none ({-b['hours_saved_year']:.0f} more lost)"
            out.append(f"| {b['option']} | {f(b['extra_cash_year'])} | {hs} | {verdict} |")
        else:
            out.append(f"| {b['option']} | {f(b['extra_cash_year'])} | {b['hours_saved_year']:.0f} | {f(b['break_even_per_hour'])}/hour |")
    out += ["", "## Notes per option", ""]
    for r in rs:
        bd = ", ".join(f"{LABELS.get(k, k)} {f(v / 12)}" for k, v in r["breakdown"].items() if v) if r["breakdown"] else ""
        out.append(f"- **{r['name']}** ({r['mode']}): " + "; ".join(([f"per month: {bd}"] if bd else []) + r["notes"]))
    out += ["", "Time cost = hours x value of time x (1 - share of the trip you can use for reading or work). "
            "Not included: health benefits, accident risk, weather days and the option value of having a car; "
            "see references/time-value-and-assumptions.md."]
    return "\n".join(out) + "\n"


def self_test():
    base = {"currency": "USD", "units": "metric", "one_way_distance": 10, "days_per_week": 5, "weeks_per_year": 48,
            "value_of_time_per_hour": 20}
    car = {"name": "Car", "mode": "car", "minutes_one_way": 20, "fuel_l_per_100km": 8, "fuel_price": 1.5,
           "maintenance_per_distance": 0.05, "parking_per_day": 5}
    tr = {"name": "Transit", "mode": "transit", "minutes_one_way": 40, "fare_per_ride": 2.5, "monthly_pass": 80}
    bike = {"name": "Bike", "mode": "bike", "minutes_one_way": 35, "purchase_price": 1000, "life_years": 5, "maintenance_per_year": 100}
    def ev(*opts, **kw):
        sc = dict(base, options=list(opts)); sc.update(kw.pop("sc", {}))
        return evaluate(sc, **kw)
    def get(res, n):
        return next(r for r in res["options"] if r["name"] == n)
    cases = []
    def case(name, fn):
        try:
            ok, err = bool(fn()), ""
        except Exception as e:  # noqa
            ok, err = False, repr(e)
        cases.append((name, ok, err))
    # car: 240 days * 20 km = 4800 km; fuel 384 L * 1.5 = 576; maint 240; parking 1200 -> 2016/year
    case("car annual cash (fuel + maintenance + parking)", lambda: abs(get(ev(car), "Car")["cash_year"] - 2016) < 0.01)
    case("car CO2 petrol 2.35 kg/L", lambda: abs(get(ev(car), "Car")["co2_kg_year"] - 384 * 2.35) < 0.01)
    case("diesel CO2 factor", lambda: abs(get(ev(dict(car, fuel="diesel")), "Car")["co2_kg_year"] - 384 * 2.68) < 0.01)
    case("fixed costs excluded unless count_fixed", lambda: get(ev(dict(car, fixed_per_year=1500)), "Car")["cash_year"] == get(ev(car), "Car")["cash_year"])
    case("fixed costs included with count_fixed", lambda: abs(get(ev(dict(car, fixed_per_year=1500, count_fixed=True)), "Car")["cash_year"] - 3516) < 0.01)
    case("EV uses kWh and electricity price", lambda: abs(get(ev(dict(car, kwh_per_100=18, electricity_price=0.3, fuel_l_per_100km=None)), "Car")["breakdown"]["energy"] - 4800 / 100 * 18 * 0.3) < 0.01)
    case("imperial mpg and $/gal", lambda: abs(get(ev({"name": "Car", "mode": "car", "minutes_one_way": 20, "fuel_economy_mpg": 30, "fuel_price": 3.6}, sc={"units": "imperial"}), "Car")["cash_year"] - 4800 / 30 * 3.6) < 0.01)
    case("imperial CO2 8.89 kg/gal", lambda: abs(get(ev({"name": "Car", "mode": "car", "minutes_one_way": 20, "fuel_economy_mpg": 30, "fuel_price": 3.6}, sc={"units": "imperial"}), "Car")["co2_kg_year"] - 160 * 8.89) < 0.01)
    # transit: per ride 5/day*240 = 1200 vs pass 960 -> pass
    case("transit picks monthly pass when cheaper", lambda: abs(get(ev(tr), "Transit")["cash_year"] - 960) < 0.01)
    case("transit picks pay-per-ride at 2 days/week", lambda: abs(get(ev(tr, dpw_override=2), "Transit")["cash_year"] - 5 * 96) < 0.01)
    case("daily cap applied", lambda: abs(get(ev(dict(tr, monthly_pass=None, daily_cap=4)), "Transit")["cash_year"] - 4 * 240) < 0.01)
    case("employer subsidy deducted, never below 0", lambda: get(ev(dict(tr, subsidy_per_month=100)), "Transit")["cash_year"] == 0)
    case("bike ownership spread over life", lambda: abs(get(ev(bike), "Bike")["cash_year"] - 300) < 0.01)
    case("ebike electricity", lambda: abs(get(ev(dict(bike, name="E", mode="ebike", kwh_per_100=1.5, electricity_price=0.3)), "E")["breakdown"]["energy"] - 4800 / 100 * 1.5 * 0.3) < 0.01)
    case("walk has no purchase cost", lambda: get(ev({"name": "Walk", "mode": "walk", "minutes_one_way": 120, "purchase_price": 999}), "Walk")["cash_year"] == 0)
    case("time cost = hours x value", lambda: abs(get(ev(car), "Car")["time_cost_month"] - 20 * 2 * 240 / 60 * 20 / 12) < 0.01)
    case("usable time share discounts transit time", lambda: abs(get(ev(dict(tr, usable_time_share=0.5)), "Transit")["time_cost_month"] - 40 * 2 * 240 / 60 * 20 * 0.5 / 12) < 0.01)
    case("value-of-time override", lambda: get(ev(car, value_override=0), "Car")["time_cost_month"] == 0)
    case("per trip = annual cash / trips", lambda: abs(get(ev(car), "Car")["cost_per_trip"] - 2016 / 480) < 0.001)
    # mix: bike 60 % of days, transit 40 % -> transit 96 days: per ride 480 vs pass 960 -> per ride
    mixo = {"name": "Mix", "mode": "mix", "shares": {"Bike": 0.6, "Transit": 0.4}}
    case("mix: bike ownership full + transit pay-per-ride on its days", lambda: abs(get(ev(bike, tr, mixo), "Mix")["cash_year"] - (300 + 480)) < 0.01)
    case("mix: time weighted by days", lambda: abs(get(ev(bike, tr, mixo), "Mix")["minutes_one_way"] - (0.6 * 35 + 0.4 * 40)) < 0.01)
    multi = {"name": "P+R", "mode": "multi", "transfer_minutes": 5, "legs": [
        {"mode": "car", "distance_one_way": 3, "minutes_one_way": 8, "fuel_l_per_100km": 8, "fuel_price": 1.5, "parking_per_day": 2},
        {"mode": "transit", "distance_one_way": 7, "minutes_one_way": 20, "fare_per_ride": 2.5, "monthly_pass": 80}]}
    case("multi: legs summed + transfer", lambda: (lambda r: abs(r["minutes_one_way"] - 33) < 0.01 and abs(r["cash_year"] - (1440 * 0.08 * 1.5 + 480 + 960)) < 0.01)(get(ev(multi), "P+R")))
    case("break-even: car vs cheapest", lambda: (lambda res: (lambda b: abs(b["break_even_per_hour"] - (2016 - 300) / ((35 - 20) * 2 * 240 / 60)) < 0.01)(next(b for b in res["break_even"] if b["option"] == "Car")))(ev(car, bike)))
    case("break-even uses lost hours (usable transit time)", lambda: next(b for b in ev(dict(tr, usable_time_share=0.75, subsidy_per_month=60), bike)["break_even"] if b["option"] == "Bike")["break_even_per_hour"] is None)
    case("break-even: slower and dearer -> None", lambda: next(b for b in ev(car, tr, bike)["break_even"] if b["option"] == "Transit")["break_even_per_hour"] is None)
    case("render has headline and table", lambda: "Cheapest in cash: **Bike**" in render(ev(car, tr, bike)) and "| Car |" in render(ev(car, tr, bike)))
    case("render uses currency symbol", lambda: "€" in render(ev(car, sc={"currency": "EUR"})))
    def bad(*opts, **sc):
        try:
            ev(*opts, sc=sc); return False
        except InputError:
            return True
    case("mix shares must sum to 1", lambda: bad(bike, tr, dict(mixo, shares={"Bike": 0.6, "Transit": 0.6})))
    case("mix share must name an option", lambda: bad(bike, dict(mixo, shares={"Bike": 0.5, "Train": 0.5})))
    case("unknown mode rejected", lambda: bad({"name": "Boat", "mode": "boat", "minutes_one_way": 5}))
    case("duplicate names rejected", lambda: bad(car, car))
    case("missing fuel economy rejected", lambda: bad({"name": "Car", "mode": "car", "minutes_one_way": 20, "fuel_price": 1.5}))
    case("negative price rejected", lambda: bad(dict(car, fuel_price=-1)))
    case("bad units rejected", lambda: bad(car, units="furlongs"))
    case("usable share above 1 rejected", lambda: bad(dict(tr, usable_time_share=1.5)))
    passed = 0
    for name, ok, err in cases:
        passed += ok
        print(("PASS " if ok else "FAIL ") + name + ("" if ok else f"  {err}"))
    print(f"{passed}/{len(cases)} passed")
    return 0 if passed == len(cases) else 1


def main(argv=None):
    ap = argparse.ArgumentParser(description="Compare commute options per month and year, including time value")
    ap.add_argument("scenario", nargs="?")
    ap.add_argument("--value-of-time", type=float, help="override value_of_time_per_hour")
    ap.add_argument("--days-per-week", type=float, help="override days_per_week (e.g. 3 for hybrid work)")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--self-test", action="store_true")
    a = ap.parse_args(argv)
    if a.self_test:
        return self_test()
    if not a.scenario:
        ap.error("give a scenario JSON file, or --self-test")
    try:
        with open(a.scenario, encoding="utf-8") as fh:
            sc = json.load(fh)
        if a.days_per_week is not None and not 0.5 <= a.days_per_week <= 7:
            raise InputError("--days-per-week must be 0.5..7")
        res = evaluate(sc, a.value_of_time, a.days_per_week)
    except json.JSONDecodeError as e:
        print(f"error: scenario is not valid JSON: {e}", file=sys.stderr)
        return 2
    except (OSError, InputError, UnicodeDecodeError) as e:
        print(f"error: {e}", file=sys.stderr)
        return 2
    print(json.dumps(res, indent=2) if a.json else render(res), end="" if not a.json else "\n")
    return 0


if __name__ == "__main__":
sys.exit(main())Các quy ước thực tế để nhận và gửi webhook an toàn, đáng tin cậy giữa các dịch vụ.
# Tích hợp Webhook taste của một kỹ sư tích hợp chú trọng độ tin cậy
- Xác minh mọi webhook gửi đến bằng chữ ký HMAC trên phần thân request thô (raw request body) trước khi phân tích cú pháp thành JSON. Độ tin cậy: 0.95
- So sánh chữ ký bằng hàm có thời gian thực thi hằng số (constant-time function), không bao giờ dùng phép kiểm tra bằng nhau trên chuỗi thông thường. Độ tin cậy: 0.95
- Từ chối các lượt gửi có dấu thời gian đã ký cũ hơn khoảng năm phút để chặn tấn công phát lại (replay attacks). Độ tin cậy: 0.90
- Phản hồi mã trạng thái 2xx trong vòng vài giây và thực hiện công việc xử lý thực sự trong một tác vụ nền (background job). Độ tin cậy: 0.95
- Lưu trữ bền vững sự kiện thô trước rồi mới xử lý, để không mất dữ liệu nếu worker bị sập giữa chừng. Độ tin cậy: 0.90
- Khử trùng lặp dựa trên event ID của nhà cung cấp bằng chỉ mục duy nhất (unique index), vì mọi nhà cung cấp đều thử gửi lại và phân phối theo cơ chế ít nhất một lần (at-least-once). Độ tin cậy: 0.95
- Không bao giờ giả định các sự kiện đến đúng thứ tự, hãy so sánh trường version hoặc updated_at trước khi ghi đè trạng thái cục bộ. Độ tin cậy: 0.85
- Coi payload như một gợi ý và truy vấn lại đối tượng hiện tại từ API của nhà cung cấp đối với bất kỳ tác vụ nào liên quan đến tiền bạc. Độ tin cậy: 0.80
- Chỉ trả về mã 4xx cho các request lỗi vĩnh viễn và 5xx cho các lỗi tạm thời để cơ chế thử lại của bên gửi hoạt động chính xác. Độ tin cậy: 0.85
- Hỗ trợ đồng thời ít nhất hai khóa bí mật ký (signing secrets) đang hoạt động để có thể xoay vòng khóa mà không gây gián đoạn dịch vụ (downtime). Độ tin cậy: 0.85
- Khi gửi webhook đi, hãy thử lại với thời gian chờ tăng theo hàm mũ kèm độ nhiễu ngẫu nhiên (exponential backoff and jitter) trong tối đa một ngày hoặc lâu hơn, sau đó vô hiệu hóa endpoint và thông báo cho chủ sở hữu. Độ tin cậy: 0.90
- Gửi một payload gọn nhẹ, có đánh phiên bản kèm theo loại sự kiện (event type), event ID, dấu thời gian và ID tài nguyên thay vì đổ toàn bộ dữ liệu dòng trong cơ sở dữ liệu ra. Độ tin cậy: 0.80
- Đặt tên loại sự kiện theo dạng resource.action ở thì quá khứ, chẳng hạn như invoice.paid hoặc user.deleted. Độ tin cậy: 0.80
- Cung cấp cho khách hàng nhật ký gửi (delivery log) kèm theo request, response, trạng thái và nút phát lại (replay) thủ công. Độ tin cậy: 0.85
- Chặn các URL webhook gửi đi phân giải về địa chỉ mạng riêng tư (private), loopback hoặc link-local để ngăn chặn lỗ hổng SSRF. Độ tin cậy: 0.95
- Sử dụng thời gian chờ (timeout) ngắn và tách biệt cho các lượt gửi đi, đồng thời không bao giờ để một endpoint chậm của khách hàng làm nghẽn hàng đợi dùng chung. Độ tin cậy: 0.90
- Bắt buộc sử dụng HTTPS cho tất cả các webhook endpoint ngoài môi trường phát triển cục bộ. Độ tin cậy: 0.90
- Cung cấp API đối soát hoặc cơ chế đồng bộ định kỳ để phía nhận có thể khôi phục lại các sự kiện bị bỏ lỡ. Độ tin cậy: 0.80
- Kiểm thử các bộ xử lý (handlers) ở môi trường cục bộ bằng CLI của nhà cung cấp hoặc đường hầm (tunnel), và lưu lại các payload mẫu đã ghi nhận làm dữ liệu kiểm thử cố định (test fixtures). Độ tin cậy: 0.80
- Cảnh báo khi tỷ lệ lỗi tăng cao và hàng đợi tồn đọng ngày càng lớn trên từng endpoint, chứ không chỉ cảnh báo trên từng lỗi đơn lẻ. Độ tin cậy: 0.80
- Không bao giờ ghi log toàn bộ payload có chứa dữ liệu cá nhân, thông tin bí mật (secrets) hoặc thông tin thẻ thanh toán. Độ tin cậy: 0.90
Các quy ước thực tế để xây dựng ứng dụng di động đa nền tảng nhanh và dễ bảo trì bằng Flutter.
# Ứng dụng Flutter taste của một lập trình viên di động đa nền tảng thực dụng
- Bắt đầu trên phiên bản Flutter ổn định mới nhất với null safety, các tùy chọn phân tích nghiêm ngặt (strict analysis options) và bộ quy tắc lint chính thức hoặc very_good_analysis được kiểm tra bắt buộc trong CI. Độ tin cậy: 0.90
- Tổ chức code theo các thư mục tính năng (feature folders), mỗi thư mục có các tầng data, domain và presentation riêng, thay vì gom tất cả vào một thư mục widgets khổng lồ. Độ tin cậy: 0.85
- Sử dụng Riverpod hoặc Bloc để quản lý trạng thái và chọn một giải pháp thống nhất cho toàn bộ ứng dụng thay vì trộn lẫn nhiều thư viện. Độ tin cậy: 0.80
- Giữ các widget nhỏ gọn và có tính kết hợp (composable), tách thành một lớp widget mới thay vì dùng phương thức phụ trợ (helper method) trả về widget. Độ tin cậy: 0.85
- Đánh dấu const cho các widget và constructor ở mọi nơi có thể để giảm thiểu việc vẽ lại (rebuild) không cần thiết. Độ tin cậy: 0.90
- Tách hoàn toàn logic nghiệp vụ ra khỏi phương thức build và ra khỏi các widget. Độ tin cậy: 0.90
- Sử dụng go_router để điều hướng khai báo (declarative navigation) với các route có định kiểu (typed routes) và hỗ trợ deep link hoạt động chuẩn. Độ tin cậy: 0.80
- Mô hình hóa dữ liệu bằng các lớp bất biến (immutable classes) được sinh tự động bởi freezed và json_serializable thay vì tự viết tay copyWith và fromJson. Độ tin cậy: 0.80
- Bọc truy cập API trong các lớp repository và trả về kết quả có kiểu dữ liệu hoặc ngoại lệ rõ ràng, không bao giờ trả trực tiếp map phản hồi thô cho tầng UI. Độ tin cậy: 0.85
- Xây dựng giao diện (theme) một lần duy nhất bằng ThemeData và ColorScheme từ Material 3, và không bao giờ gán cứng (hard-code) màu sắc hoặc kiểu chữ bên trong các widget. Độ tin cậy: 0.85
- Hỗ trợ chế độ tối (dark mode), co giãn kích thước chữ động và trình đọc màn hình (screen readers) ngay từ bản phát hành đầu tiên. Độ tin cậy: 0.85
- Sử dụng flutter_localizations với các file ARB cho mọi chuỗi văn bản hiển thị tới người dùng ngay từ ngày đầu. Độ tin cậy: 0.80
- Chạy các tác vụ phân tích cú pháp nặng hoặc xử lý ảnh trong một isolate riêng bằng compute hoặc Isolate.run để luồng UI luôn mượt mà. Độ tin cậy: 0.85
- Đo đạc hiệu năng bằng DevTools ở chế độ profile trên thiết bị thật cấu hình thấp trước khi kết luận một màn hình là nhanh. Độ tin cậy: 0.85
- Sử dụng ListView.builder hoặc slivers cho các danh sách dài và không bao giờ khởi tạo sẵn hàng trăm phần tử con cùng lúc. Độ tin cậy: 0.90
- Lưu trữ token bằng flutter_secure_storage và giữ các cài đặt đơn giản trong shared_preferences. Độ tin cậy: 0.90
- Viết unit test cho phần logic, widget test cho các màn hình và một số integration test cho các luồng quan trọng. Độ tin cậy: 0.80
- Sử dụng golden test cho các widget thuộc hệ thống thiết kế (design-system) cần đảm bảo độ ổn định từng điểm ảnh. Độ tin cậy: 0.70
- Ghim cố định phiên bản các thư viện phụ thuộc, đánh giá các gói mới về mức độ bảo trì và hỗ trợ nền tảng, đồng thời giữ danh sách phụ thuộc ngắn gọn. Độ tin cậy: 0.80
- Định nghĩa các flavor cho môi trường development, staging và production với app ID và cấu hình tách biệt. Độ tin cậy: 0.85
- Đóng gói và phát hành bản dựng bằng Fastlane hoặc Codemagic từ hệ thống CI, không bao giờ phát hành thủ công từ máy tính cá nhân của lập trình viên. Độ tin cậy: 0.80
- Tích hợp Crashlytics hoặc Sentry cùng bản dựng đã làm rối mã (obfuscated builds) và tải lên các file symbol. Độ tin cậy: 0.80
Các quy ước thực tế để xây dựng ứng dụng Laravel dễ bảo trì với các thiết lập mặc định hiện đại của PHP và Laravel.
# Ứng dụng Laravel taste của một lập trình viên web PHP thực dụng
- Bắt đầu trên phiên bản Laravel và PHP mới nhất với khai báo kiểu nghiêm ngặt (strict types) trong mọi file. Độ tin cậy: 0.85
- Giữ controller mỏng và theo chuẩn resourceful, sử dụng single-action invokable controller cho bất kỳ tác vụ nào không phải CRUD. Độ tin cậy: 0.85
- Xác thực dữ liệu đầu vào trong các lớp Form Request và phân quyền bằng Policy thay vì kiểm tra trực tiếp trong controller. Độ tin cậy: 0.90
- Đặt logic nghiệp vụ trong các lớp action nhỏ như CreateInvoice, không đặt trong controller, model hay route closure. Độ tin cậy: 0.75
- Sử dụng Eloquent với các trường $fillable hoặc casts tường minh, và không bao giờ gọi Model::unguard trong code production. Độ tin cậy: 0.85
- Bật Model::preventLazyLoading ngoài môi trường production để phát hiện sớm truy vấn N+1 và khắc phục bằng eager loading. Độ tin cậy: 0.90
- Đảm bảo mọi quan hệ đều có khóa ngoại (foreign key) và chỉ mục duy nhất (unique index) trong migration, chứ không chỉ dựa vào quy tắc của Eloquent. Độ tin cậy: 0.90
- Viết các migration an toàn khi chạy tiến (roll forward) và không bao giờ sửa đổi một migration đã chạy trên production. Độ tin cậy: 0.90
- Định hình phản hồi API bằng API Resources để cấu trúc cơ sở dữ liệu không bao giờ bị lộ trực tiếp ra JSON. Độ tin cậy: 0.85
- Đẩy các tác vụ chậm như gửi email, xuất dữ liệu và gọi dịch vụ bên thứ ba vào các hàng đợi (queued jobs) chạy dưới Horizon, đồng thời đảm bảo mọi job đều có tính idempotent. Độ tin cậy: 0.90
- Chỉ sử dụng event và listener cho các tác dụng phụ (side effects) thực sự, không dùng để che giấu luồng xử lý chính của một request. Độ tin cậy: 0.75
- Đọc cấu hình thông qua config() và chỉ giữ các lệnh gọi env() bên trong các file config để tính năng lưu bộ nhớ đệm cấu hình (config caching) hoạt động. Độ tin cậy: 0.95
- Chạy php artisan optimize, config:cache và route:cache như một phần của mọi quy trình triển khai (deploy). Độ tin cậy: 0.85
- Sử dụng Sanctum cho xác thực SPA chính chủ (first-party) và ứng dụng di động, và chỉ dùng đến Passport khi bạn cần OAuth đầy đủ. Độ tin cậy: 0.80
- Kiểm thử bằng Pest hoặc PHPUnit sử dụng feature test trên cơ sở dữ liệu thực kết hợp với RefreshDatabase. Độ tin cậy: 0.85
- Tạo dữ liệu kiểm thử bằng model factory và state thay vì các file seed dùng chung kích thước lớn. Độ tin cậy: 0.80
- Áp đặt chuẩn định dạng code bằng Laravel Pint và phân tích tĩnh bằng Larastan ở mức 6 trở lên trong CI. Độ tin cậy: 0.85
- Ưu tiên sử dụng Livewire hoặc Inertia cùng các bộ starter kit của Laravel trước khi xây dựng một SPA tách biệt. Độ tin cậy: 0.75
- Giới hạn tần suất (rate limit) cho các route đăng nhập và API công khai bằng các bộ giới hạn tần suất được đặt tên (named rate limiters). Độ tin cậy: 0.90
- Lưu trữ file tải lên thông qua Storage facade trên các ổ đĩa tương thích S3 và phục vụ các file riêng tư qua URL có chữ ký tạm thời (temporary signed URLs). Độ tin cậy: 0.85
- Lên lịch các tác vụ định kỳ trong bộ lập lịch (scheduler) với withoutOverlapping và onOneServer, thay vì viết trực tiếp trong crontab thô. Độ tin cậy: 0.85
- Giữ số lượng gói thư viện (packages) ít và được bảo trì tốt, đồng thời nâng cấp từng phiên bản chính (major version) của Laravel một theo hướng dẫn nâng cấp chính thức. Độ tin cậy: 0.80

