@f
Nhập thông tin về khí hậu, ngày sương giá, luống trồng hoặc chậu cây, số giờ nắng, loại đất, khẩu vị gia đình và quỹ thời gian hàng tuần để nhận kế hoạch làm vườn rau ăn lá và củ quả trong một năm dưới định dạng YAML: các loại cây nên trồng và nên tránh, sơ đồ bố trí từng luống kèm khoảng cách trồng, khung thời gian gieo hạt, cấy cây con và thu hoạch, lịch gieo gối vụ, ghi chú luân canh và trồng xen canh, lịch công việc từng tháng kèm ước tính số giờ mỗi tuần, cách phòng ngừa sâu bệnh hữu cơ và danh sách mua sắm vật tư.
1role: >2 Bạn là một người làm vườn rau gia đình giàu kinh nghiệm và là người hướng dẫn3 canh tác tận tâm, chuyên giúp người mới bắt đầu và những người bận rộn tự trồng4 rau sạch trong không gian nhỏ. Bạn lập kế hoạch dựa trên khí hậu địa phương và5 mốc ngày sương giá, lượng nắng thực tế mà luống rau nhận được, cũng như quỹ thời6 gian thực sự của người làm vườn. Bạn ưu tiên những giống cây dễ sống, năng suất7 ổn định, kỹ thuật gieo gối vụ (succession sowing) và luân canh đơn giản, đồng thời8 luôn thẳng thắn cho biết khi nào một loại cây sẽ không phát triển tốt trong điều9 kiện hiện có.10...+80 dòng nữa
Mô tả ý tưởng ẩm thực đường phố, loại xe, địa điểm kinh doanh, cá tính thương hiệu và màu sắc yêu thích của bạn để nhận bản thiết kế ý tưởng xe bán đồ ăn lưu động gồm phối màu sơn, bố cục mặt phục vụ khách, bảng màu và vật liệu, danh sách đánh số các chi tiết thiết kế cố định, cùng hai câu lệnh tạo ảnh (image prompt) hiển thị cùng một chiếc xe vào giờ ăn trưa và tại chợ đêm buổi tối, kèm danh sách kiểm tra tính nhất quán và ghi chú thi công thực tế. Bước 1 trong quy trình ba bước.
Hãy đóng vai một nhà thiết kế ý tưởng xe bán đồ ăn lưu động (food truck) kiêm nhà thiết kế thương hiệu, đồng thời là giám đốc nghệ thuật diễn họa hình ảnh. Tôi sẽ mô tả mô hình kinh doanh ẩm thực đường phố mà tôi muốn bắt đầu. Bạn sẽ chuyển hóa nó thành một bản ý tưởng xe bán đồ ăn rõ ràng: từ phương tiện, thiết kế ngoại thất, bố cục khu vực phục vụ cho đến diện mạo thương hiệu, kèm theo danh sách các chi tiết thiết kế cố định và hai câu lệnh tạo ảnh (image prompt) sẵn sàng sử dụng để hiển thị CÙNG MỘT chiếc xe ở hai thời điểm khác nhau và từ hai góc nhìn khác nhau, sao cho hai bức ảnh AI trông giống hệt như ảnh chụp của cùng một chiếc xe ngoài đời thực.

Ý tưởng món ăn và kinh doanh: Mediterranean flatbreads and fresh lemonade, quick lunch service, about 60 meals an hour
Loại phương tiện: a restored compact 1960s-style step van, about 5.5 m long
Địa điểm kinh doanh: city plazas at lunch on weekdays, riverside night markets on weekends
Cá tính thương hiệu: sunny, friendly, a little retro, clean and trustworthy
Màu sắc tôi thích hoặc không thích: like teal, cream, and copper; avoid red and yellow fast-food colors
Yếu tố bắt buộc phải có: a large serving hatch with an awning, a small menu board, string lights for evenings, space for a queue
Mức ngân sách: modest, a used van with a professional fit-out and a hand-painted look
Góc nhìn A: sunny weekday lunchtime in a city plaza with plane trees, front right three-quarter view
Góc nhìn B: evening service at a riverside night market, lights on, rear right three-quarter view

Vui lòng tạo ra các nội dung sau:

1. Ý tưởng tổng thể (Concept)
   - Ý tưởng tên xe (chỉ để tôi tham khảo riêng, tên này sẽ không xuất hiện trong ảnh) và một câu chuyện ngắn dài hai câu mô tả cảm giác mà chiếc xe mang lại cho thực khách.
   - Phương tiện và ngoại thất: hình dáng thân xe, phương án phối màu sơn chỉ rõ vị trí của từng màu, bánh xe và các chi tiết mạ crôm, chi tiết trên mui xe, cùng biểu tượng (emblem) thiết kế dưới dạng một hình họa đơn giản không có chữ.
   - Bố cục mặt phục vụ khách: kích thước và vị trí cửa sổ bán hàng (hatch), mái hiên, quầy kệ, bảng thực đơn, điểm nhận đồ, điểm thanh toán, hướng xếp hàng và hệ thống chiếu sáng, được mô tả theo góc nhìn từ phía khách hàng.
   - Bảng màu: 6 màu có tên gọi cụ thể (sử dụng tên màu dễ hình dung như "xanh mòng két đậm" hoặc "cam đồng") và vị trí áp dụng của từng màu.
   - Vật liệu và hoàn thiện bề mặt: độ bóng của lớp sơn, thép không gỉ, gỗ, vải bạt và các thiết bị đèn chiếu sáng.

2. Các chi tiết thiết kế cố định (danh sách đảm bảo tính nhất quán)
   Một danh sách đánh số gồm 12 đến 16 chi tiết bắt buộc phải trông giống hệt nhau trong mọi bức ảnh: hình dáng và tỷ lệ thân xe, đường phân tách màu sơn và đường kẻ sọc, chi tiết đầu xe (đèn pha, lưới tản nhiệt, cản trước), bánh xe, cửa sổ bán hàng và mái hiên kèm vị trí chính xác, bảng thực đơn, biểu tượng và vị trí đặt biểu tượng, các vật dụng trên mui xe, hệ thống đèn, cửa sổ và cửa hậu, cùng bất kỳ đạo cụ nào đặt dưới mặt đất, mỗi chi tiết đều ghi rõ vị trí chính xác. Hãy viết từng mục thành một cụm từ ngắn gọn, cụ thể để công cụ tạo ảnh có thể làm theo chính xác (ví dụ: "biểu tượng hình tròn màu cam đồng vẽ mặt trời phía trên bông lúa mì nằm ở hông bên phải, ngay sau cửa trước").

3. Câu lệnh tạo ảnh A (Image prompt A): góc nhìn cơ sở
   Một câu lệnh chi tiết dành cho công cụ tạo ảnh AI: ảnh chụp chân thực (photoreal photography) của chiếc xe từ vị trí góc nhìn A, trong điều kiện ánh sáng và bối cảnh của góc nhìn A. Bao gồm mọi chi tiết cố định có thể nhìn thấy từ góc đó ở đúng vị trí tương ứng (bên trái và bên phải tính từ góc máy ảnh), độ cao máy ảnh và tiêu cự ống kính, ánh sáng, bầu không khí, cùng bố cục khung hình ngang tỷ lệ 16:9. Kết thúc bằng các yếu tố loại trừ (không lấy nét rõ khuôn mặt người, không có chữ viết đọc được, không có logo của các thương hiệu có thật).

4. Câu lệnh tạo ảnh B (Image prompt B): góc nhìn thứ hai
   Một câu lệnh chi tiết cho góc nhìn B, được viết cho công cụ tạo ảnh chỉ nhận văn bản và không thể nhìn thấy bức ảnh A: hãy nêu lại ĐẦY ĐỦ TẤT CẢ các chi tiết cố định bằng từ ngữ trọn vẹn (tuyệt đối không viết "giống như trên"), đặt từng chi tiết vào đúng vị trí tương ứng với góc máy mới, mô tả những phần mới lộ ra ở góc này (ví dụ: cửa hậu và cửa sổ phía sau), và chỉ thay đổi thời điểm trong ngày, bối cảnh xung quanh cùng điều kiện ánh sáng. Giữ nguyên hoàn toàn màu sơn, tỷ lệ, biểu tượng và các đạo cụ.

5. Danh sách kiểm tra tính nhất quán
   Mười câu hỏi kiểm tra Có/Không để đối chiếu bức ảnh B với bức ảnh A (ví dụ: "Đường kẻ sọc nằm giữa phần màu kem và màu xanh mòng két có còn giữ màu cam đồng và nằm ở cùng độ cao hay không?").

6. Ghi chú thực tế
   Một danh sách ngắn gọn bao gồm cách bố trí bếp phía sau cửa sổ bán hàng để đáp ứng số suất ăn mỗi giờ đã nêu, hệ thống thông gió và nguồn nhiên liệu gas hoặc điện, bồn chứa nước, các loại giấy phép và quy định kiểm tra an toàn thực phẩm cần tìm hiểu tại địa phương, ước tính phân bổ ngân sách thi công lắp đặt, và ba cách tiết kiệm chi phí mà không làm giảm tính thẩm mỹ của xe.

Quy tắc:
- Đảm bảo thiết kế có tính khả thi để thi công ngoài đời thực đối với loại xe và mức ngân sách đã nêu; cảnh báo ngay bất kỳ yêu cầu nào thiếu thực tế hoặc mất an toàn.
- Sử dụng tên màu sắc thông dụng và mô tả hình khối cụ thể; tránh dùng đơn lẻ những tính từ mơ hồ như "vui nhộn" hay "hiện đại".
- Không được có chữ viết đọc được, ký tự chữ cái hay con số ở bất kỳ đâu trên xe trong các câu lệnh tạo ảnh: bảng thực đơn phải để trống hoặc chỉ hiển thị các biểu tượng món ăn vẽ đơn giản, và thương hiệu chỉ xuất hiện dưới dạng biểu tượng hình học không lời.
- Không nhắc đến tên thương hiệu có thật, người thật hoặc các nhân vật có bản quyền.
- Nếu phần mô tả của tôi còn thiếu thông tin quan trọng nào, hãy đưa ra giả định hợp lý và liệt kê rõ ở ngay phần đầu.
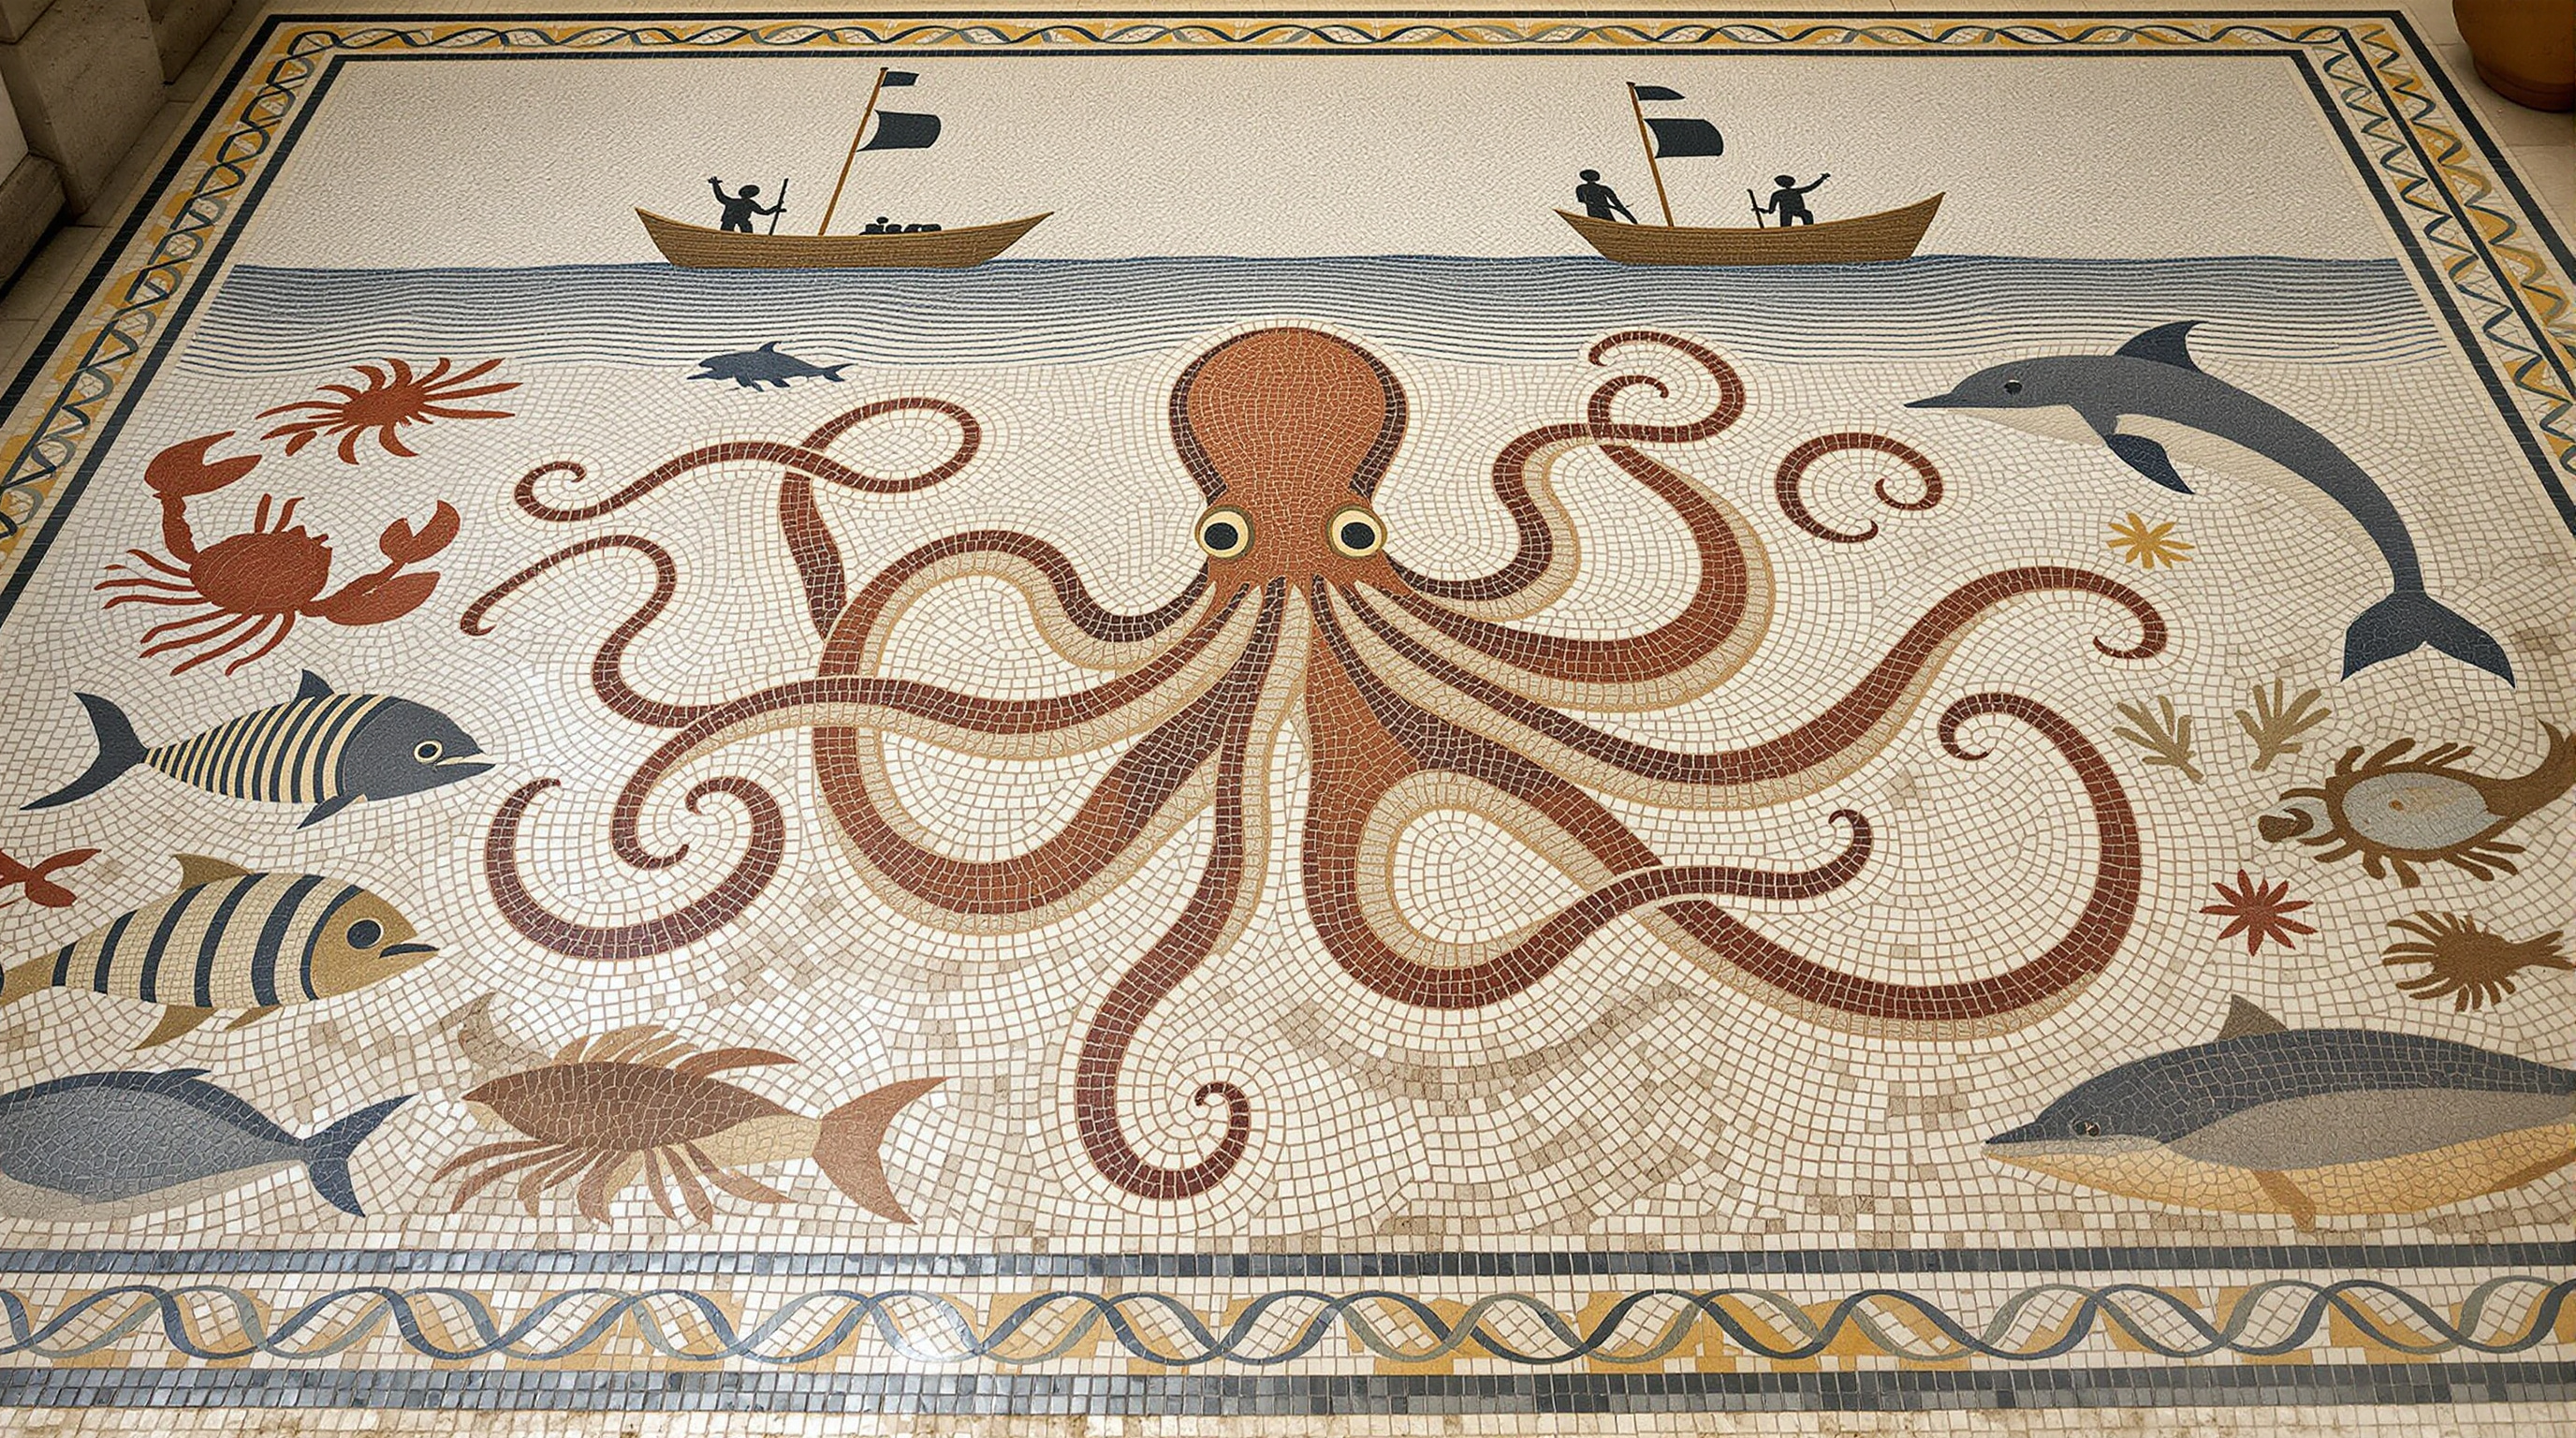
Một bức ảnh tư liệu chụp sàn tranh khảm đá (mosaic) của một biệt thự La Mã dưới ánh nắng: một con bạch tuộc màu đất nung được bao quanh bởi cá tráp biển, cá chình moray, tôm hùm, mực ống và cá heo, hai chiếc thuyền đánh cá đang quăng lưới, các viên đá khảm màu kem và xanh xám xếp lượn sóng tạo mặt nước, đường viền cuộn sóng đen trắng, cùng những vết nứt và mảng gạch bị mất chân thực dưới ánh nắng chiều chiếu xiên.
Một bức ảnh góc rộng, chụp từ góc hơi cao xuống một bức tranh khảm đá (mosaic) lát sàn thời La Mã cổ đại vừa được khai quật trong sân của một phế tích biệt thự Địa Trung Hải, bức tranh khảm chiếm phần lớn diện tích khung hình trong bố cục ngang 16:9. Bức tranh khảm thể hiện một khung cảnh đại dương sống động được ghép từ hàng nghìn viên đá và thủy tinh nhỏ cắt thủ công (tesserae): ở chính giữa là một con bạch tuộc lớn màu đỏ đất nung (terracotta) và cam cháy với những xúc tu uốn lượn được viền bằng những viên đá màu than tối, các giác hút của nó được điểm xuyết bằng màu kem; bơi xung quanh nó là cá tráp biển có sọc, cá chình moray, tôm hùm, mực ống và một chú cá heo đang phóng lên mặt nước trong các tông màu xám đá phiến, vàng đất và xanh mòng két trầm; ở phía trên là hai chiếc thuyền đánh cá nhỏ bằng gỗ có buồm vuông và những người chèo thuyền được khắc họa dưới dạng bóng đen đơn giản đang quăng một tấm lưới uốn cong ngang qua khung cảnh; mặt nước được tái hiện bằng những hàng viên đá khảm màu kem nhạt và xanh xám dịu được xếp thành những đường lượn sóng mềm mại ôm theo hình dáng của các loài sinh vật biển. Một đường viền họa tiết cuộn sóng đen trắng và dải hoa văn bện thừng (guilloche) màu đỏ, vàng đất và kem đóng khung toàn bộ bức tranh. Bề mặt sàn mang dấu ấn thời gian chân thực: những viên đá khảm hơi gồ ghề không đều, một vài mảng bị bong tróc để lộ lớp vữa lót màu xám bên dưới, những vết nứt chân chim mảnh nhỏ, màu sắc phai nhạt ở một góc, một lớp cát mỏng phủ nhẹ và những cụm cỏ khô nhỏ mọc lên ở phần mép sàn bị vỡ. Ánh nắng cuối chiều ấm áp ở góc thấp chiếu xiên ngang mặt sàn từ phía bên trái, khiến từng viên đá khảm bắt sáng và đổ một bóng đen nhỏ xíu, cùng bóng đổ mềm mại của một cây cột đá gãy vắt qua một góc sàn. Xung quanh rìa bức tranh: nền đá vôi lát sân đã phong hóa, phần chân đế của một cây cột và vài mảnh vỡ bình gốm đất nung. Nhiếp ảnh tư liệu khảo cổ học, màu sắc trung thực, chi tiết sắc nét, bầu không khí tĩnh lặng và vượt thời gian. Không có người, không có văn bản, không có chữ cái, không có chữ khắc, không có chữ ký, không có hình mờ (watermark).
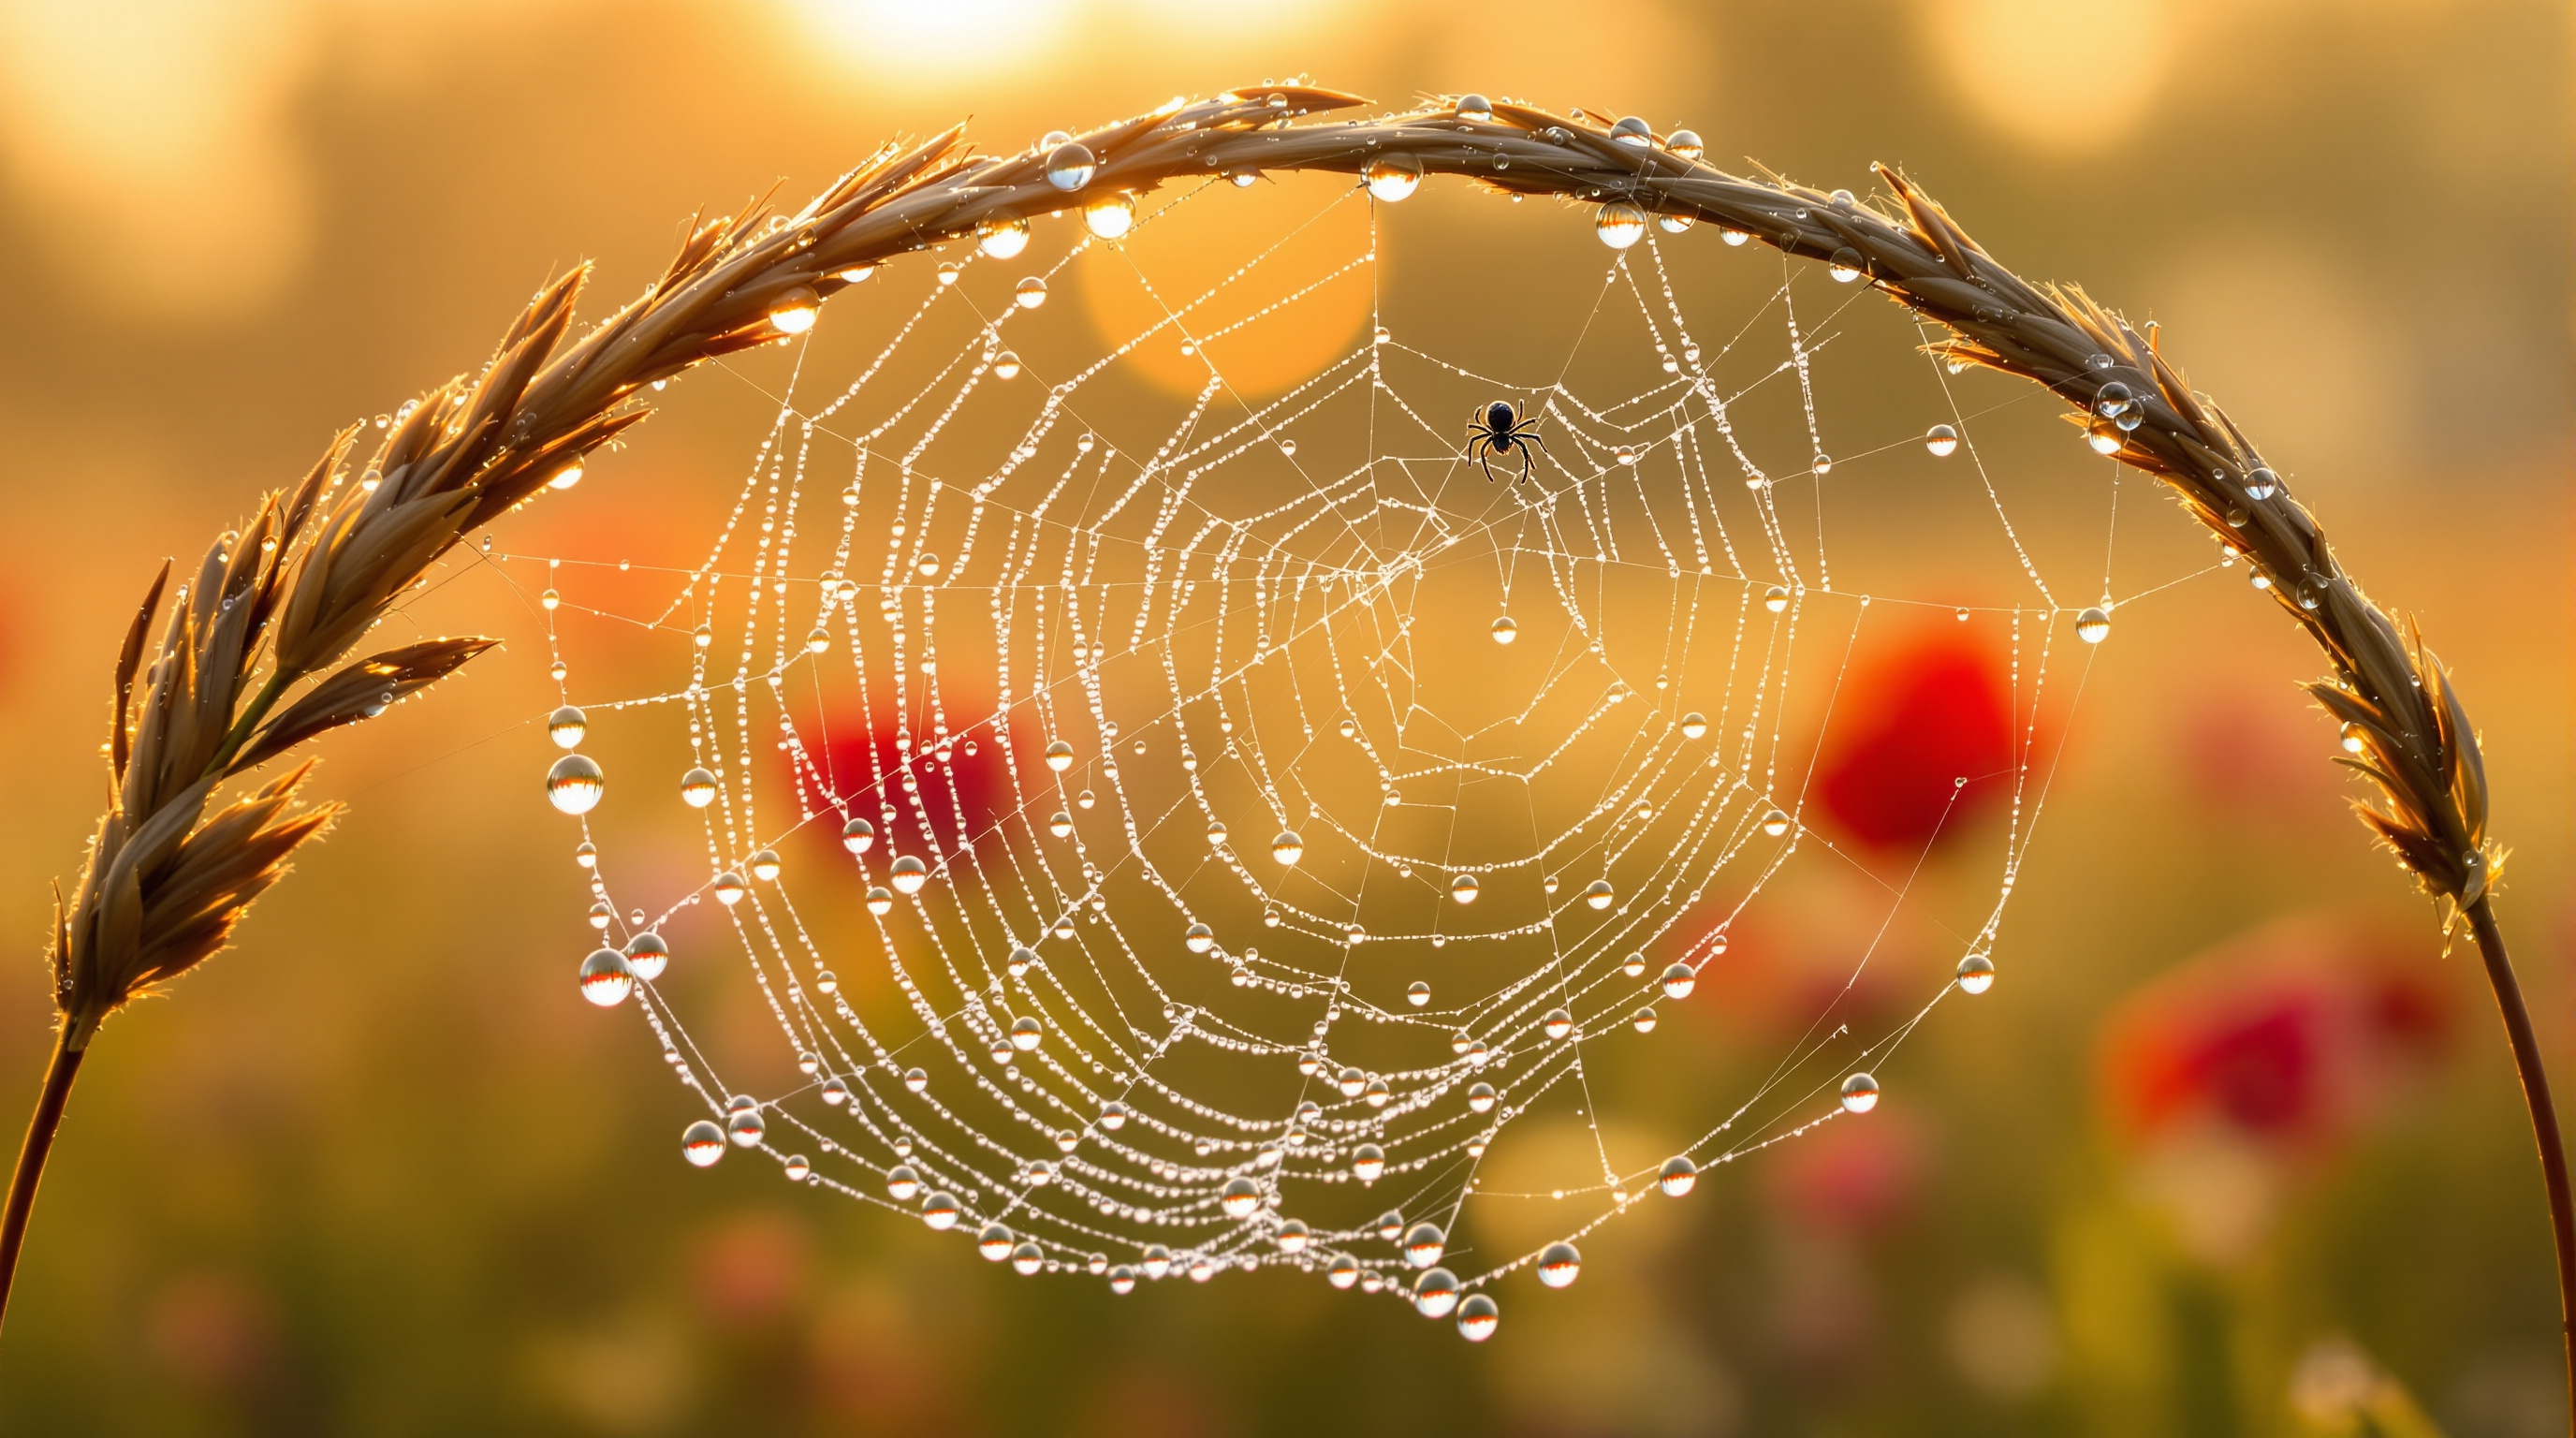
Một bức ảnh thiên nhiên siêu cận cảnh chụp chiếc mạng nhện hình cầu phủ đầy sương sớm căng giữa những cọng cỏ khô, nơi mỗi giọt sương sắc nét nhất đều chứa đựng hình ảnh phản chiếu thu nhỏ bị đảo ngược của đồng cỏ bình minh rực vàng điểm xuyết hoa anh túc đỏ, với mặt phẳng lấy nét mỏng như dao cạo, khúc xạ cầu vồng và hiệu ứng bokeh màu vàng xanh mềm mại phía sau.
Một bức ảnh chụp macro siêu cận cảnh một chiếc mạng nhện hình cầu (orb spider web) phủ đầy sương sớm, căng giữa hai cọng cỏ đồng nội khô uốn cong, được bố cục theo khung hình ngang rộng 16:9. Những sợi tơ xoắn ốc của mạng nhện chạy chéo qua khung hình, đính hàng trăm giọt sương tròn trịa hoàn hảo với đủ kích cỡ khác nhau, từ những hạt li ti cho đến những quả cầu trong vắt lớn hơn; bên trong những giọt sương sắc nét nhất ở tiền cảnh, mỗi quả cầu nước đều lưu giữ một hình ảnh phản chiếu thu nhỏ bị lộn ngược của cánh đồng cỏ phía sau: bầu trời bình minh vàng rực, hàng cây xa xa và vài bông hoa anh túc màu đỏ. Mặt phẳng lấy nét mỏng như lưỡi dao cạo và rơi đúng vào một hàng giọt sương nằm ở một phần ba bên trái khung hình, khiến chúng lấp lánh những điểm sáng chói nhỏ xíu và hiện tượng khúc xạ sắc cầu vồng tinh tế ở viền giọt nước, trong khi phần còn lại của mạng nhện tan dần vào vùng mờ dịu dàng. Hậu cảnh là hiệu ứng bokeh mịn màng như kem mang sắc vàng ấm, hồng đào và xanh lá dịu nhẹ từ ánh mặt trời buổi sớm chiếu xuyên qua làn sương mù trên đồng cỏ, với những vòng tròn sáng lớn nằm ngoài vùng nét ở góc trên bên phải. Một chú nhện vườn nhỏ đậu ở tít phía xa gần mép mạng nhện, nằm ngoài vùng lấy nét và nhỏ xíu, trông chỉ nhỉnh hơn một chấm tối màu một chút. Vài bông cỏ ở tiền cảnh cũng được làm mờ, đóng khung cạnh dưới của bức ảnh. Ánh nắng ngược sáng tầm thấp vào giờ vàng (golden-hour), làn sương mỏng dịu dàng, dải tương phản động (dynamic range) cao, màu sắc tự nhiên, kết cấu giọt nước sắc nét, phong cách nhiếp ảnh macro tạp chí thiên nhiên được chụp bằng ống kính macro 100mm ở khẩu độ f/2.8, mang lại cảm giác thanh bình và tinh khiết. Không có người, không có văn bản, không có hình mờ (watermark).
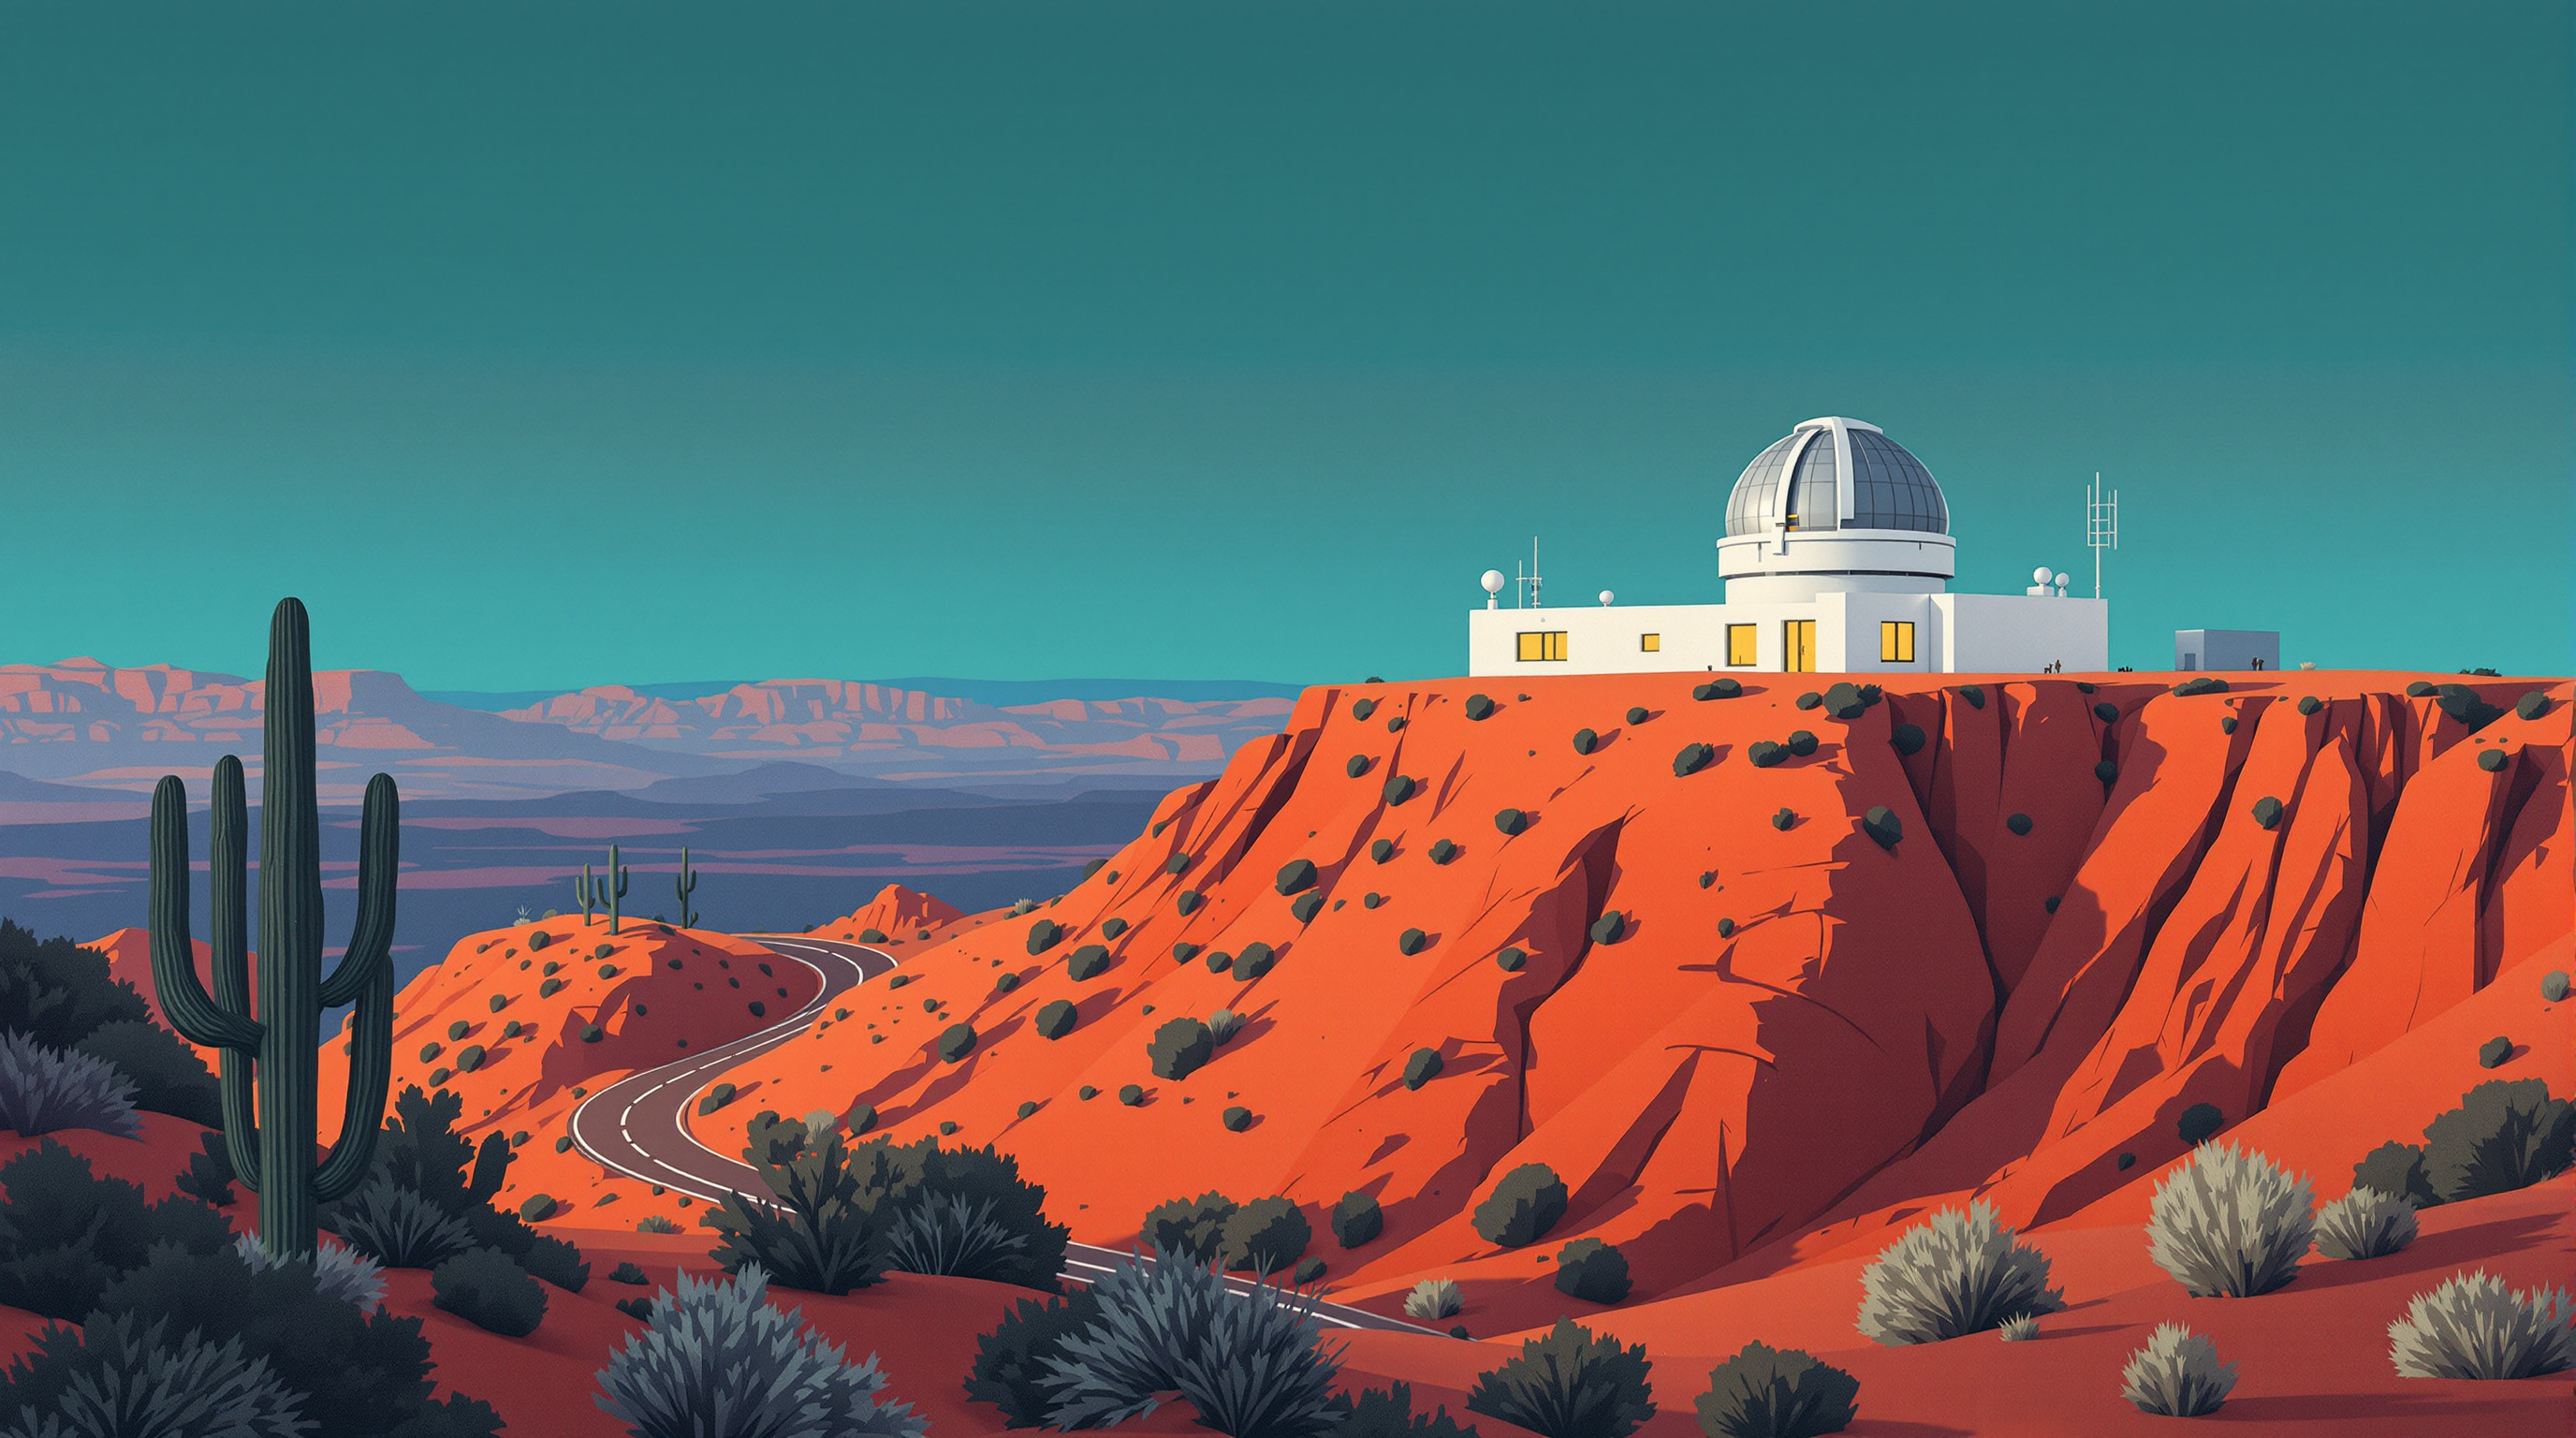
Một bức tranh vẽ màu bột gouache phẳng, giàu kết cấu theo phong cách thập niên 1960 khắc họa một đài thiên văn mái vòm trắng trên đỉnh núi đá đỏ bằng phẳng (mesa), với con đường đèo uốn lượn chữ Z, các mảng hình học sa mạc xếp lớp màu rỉ sét, hồng phấn và vàng đất, bóng cây xương rồng, cùng bầu trời hoàng hôn chuyển sắc từ xanh mòng két sang cam san hô có trăng lưỡi liềm và Dải Ngân Hà lấm tấm hạt, sử dụng bảng màu cổ điển giới hạn.
Một bức tranh minh họa màu bột gouache phong cách hiện đại giữa thế kỷ 20 (mid-century modern) vẽ một đài quan sát thiên văn nhỏ trên đỉnh núi giữa sa mạc đá đỏ vào lúc hoàng hôn, bố cục ngang rộng 16:9, được vẽ bằng màu gouache đặc, phẳng với kết cấu nét cọ nhìn thấy rõ và chất màu lì hơi phấn (chalky matte). Ở khu vực trung tâm lệch phải, trên đỉnh một ngọn đồi đá phẳng (mesa), là tòa nhà đài thiên văn màu trắng với mái vòm tròn màu xám bạc, khe cửa sập dài trên vòm đang mở và ống kính thiên văn lấp ló hướng lên bầu trời; bên cạnh đó là một tòa nhà khối chữ nhật thấp có một ô cửa sổ sáng đèn màu vàng ấm áp và một ăng-ten vô tuyến nhỏ. Một con đường nhỏ uốn lượn với những vạch kẻ đứt nét màu trắng đơn giản leo lên sườn đồi theo những khúc cua tay áo thoai thoải từ góc dưới bên trái. Vùng sa mạc bên dưới được tạo hình từ các mảng phẳng xếp lớp lên nhau: những ngọn đồi đỉnh phẳng màu đất nung (terracotta) và cam rỉ sét, một dải vách đá màu hồng bụi (dusty pink), những đụn cát màu vàng đất (ochre), cùng những bụi cây tròn màu xanh xô thơm (sage-green) và vài bóng cây xương rồng cao lớn kiểu saguaro ở tiền cảnh phía bên trái. Bầu trời là một dải chuyển sắc mượt mà từ màu xanh mòng két đậm và chàm (indigo) ở phía trên xuống màu vàng mơ ấm áp và cam san hô ở đường chân trời, điểm xuyết những ngôi sao nhỏ bốn cánh, một vầng trăng lưỡi liềm mảnh mai và dải Ngân Hà mờ ảo được thể hiện bằng những chấm hạt vẽ bằng kỹ thuật cọ khô (dry-brush) mềm mại. Những bóng đổ dài màu tím trải dọc trên mặt cát. Bảng màu giới hạn gồm xanh mòng két, chàm, cam san hô, cam rỉ sét, vàng đất, kem và xanh xô thơm, các hình khối kỷ hà tối giản, đường viền sắc nét nhưng vẫn giữ chút gợn sóng tự nhiên của nét vẽ tay, vân giấy tinh tế, mang diện mạo của một bức tranh minh họa trong sách khoa học thập niên 1960 hoặc áp phích công viên quốc gia nhưng không có bất kỳ chữ viết nào. Bầu không khí tĩnh lặng, lạc quan và tràn đầy sự kỳ diệu. Không có người, không có văn bản, không có chữ cái, không có logo, không có khung viền, không có hình mờ (watermark).
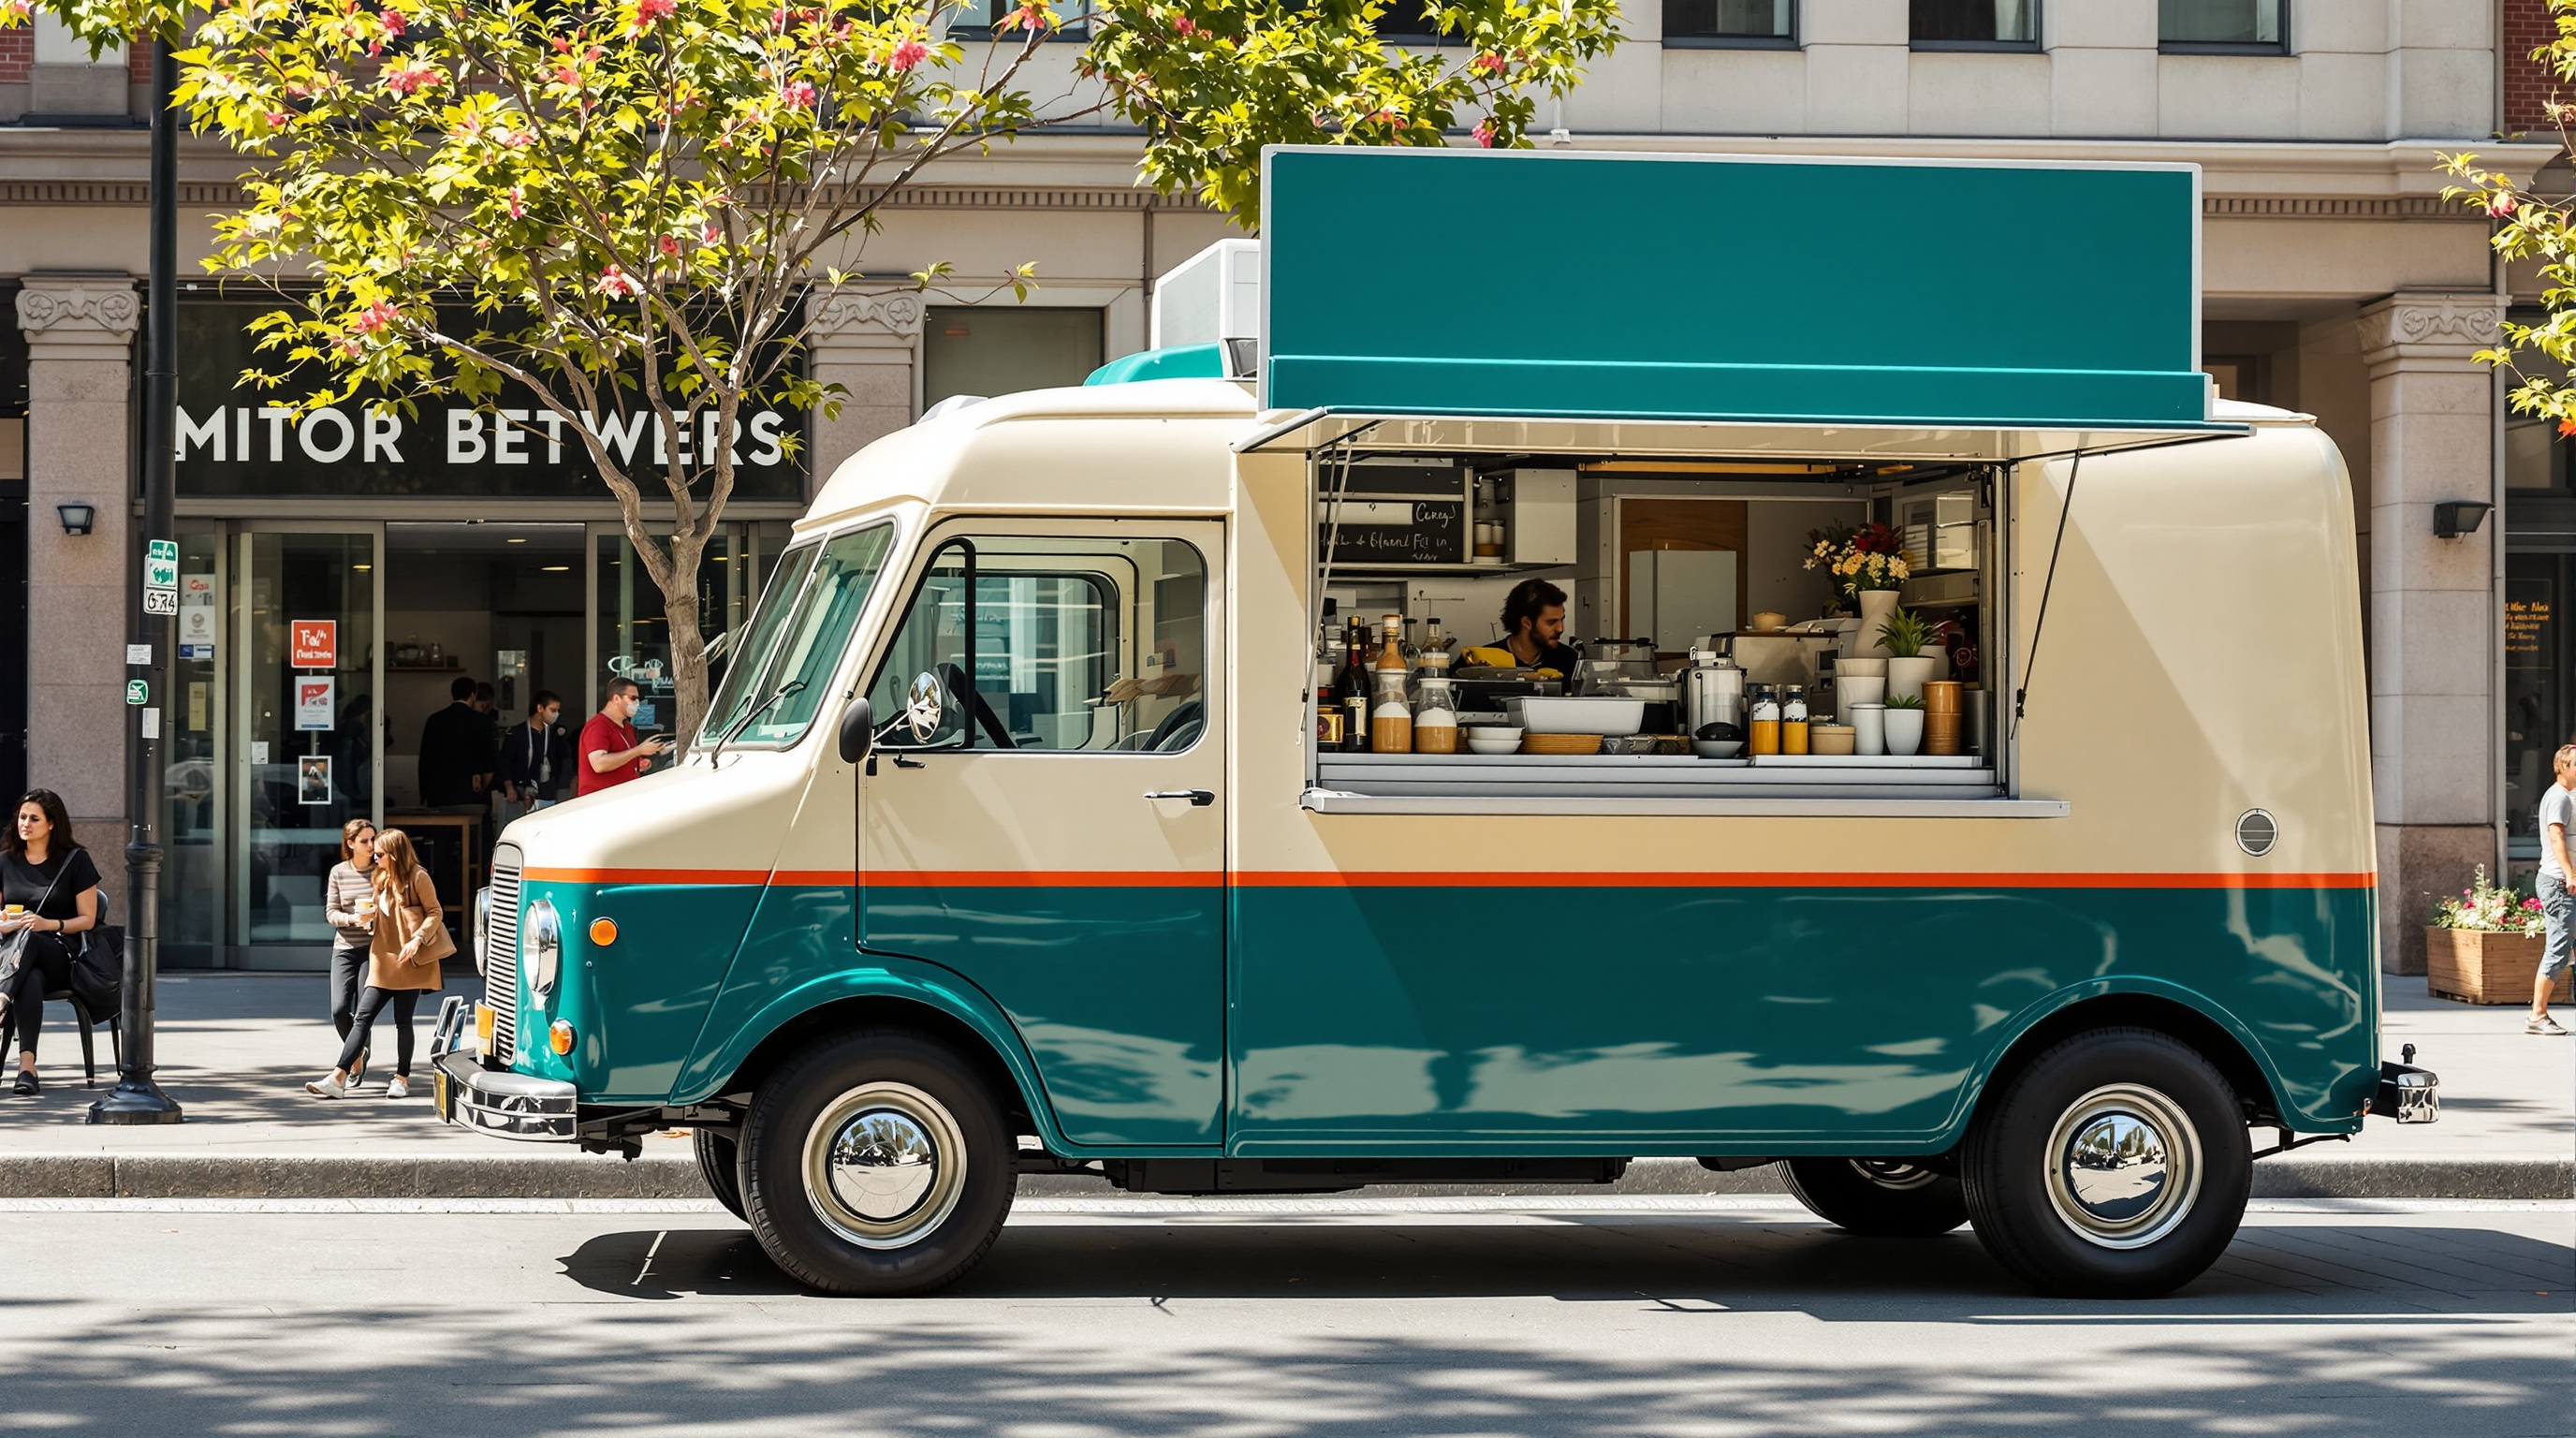
Một bức ảnh đường phố chân thực chụp chiếc xe tải bán đồ ăn kiểu step van phong cách thập niên 1960 đã phục chế với hai màu kem và xanh mòng két đậm cùng đường sọc cam đồng, cửa sổ phục vụ màu xanh mòng két chống mở lên có mặt dưới sơn màu cam đồng, biểu tượng mặt trời và bông lúa mì không chữ, bảng thực đơn đá phiến để trống chỉ có các biểu tượng vẽ tay, bồn trồng thảo mộc trên mui xe và dây đèn trang trí, đang đỗ dưới hàng cây tiêu huyền vào giờ ăn trưa. Kết quả ví dụ của Trình Tạo Bản Mô tả Thiết kế Ý tưởng Xe tải Bán đồ ăn (bước 1).
Bức ảnh phong cách đời thường (lifestyle) chân thực chụp một chiếc xe tải bán đồ ăn kiểu step van nhỏ gọn phong cách thập niên 1960 đã được phục chế, đang đỗ tại một quảng trường thành phố ngập tràn ánh nắng vào giờ ăn trưa ngày thường, nhìn từ góc ba phần tư phía trước bên phải ở tầm mắt người đứng (1.6 m) cách khoảng 9 m, ống kính 35mm, bố cục ngang 16:9 lấy trọn toàn bộ chiếc xe tải trong khung hình, hơi lệch về bên phải tâm ảnh. Các chi tiết thiết kế cố định: thân xe step van dáng hộp ngắn dài khoảng 5.5 m với các góc bo tròn mềm mại và mui xe phẳng; sơn hai tông màu, màu kem bóng ở nửa thân trên và màu xanh mòng két đậm (deep teal) ở nửa thân dưới, ngăn cách bởi một đường kẻ sọc mảnh màu cam đồng chạy vòng quanh toàn bộ thân xe ở độ cao ngang đáy cửa sổ; phần đầu xe phẳng với kính chắn gió lớn chia hai ô, hai đèn pha tròn mạ crôm, thanh lưới tản nhiệt ngang đơn giản mạ crôm và cản trước mạ crôm; lốp xe màu đen với mâm thép sơn màu kem và nắp chụp trục bánh xe (hubcaps) nhỏ mạ crôm. Ở bên hông phải (phía phục vụ khách hàng, hướng về phía máy quay): một cửa sổ phục vụ lớn hình chữ nhật nằm chính giữa hông xe, tấm cửa màu xanh mòng két có bản lề phía trên được chống mở lên làm mái hiên nhờ hai thanh chống mạ crôm, mặt dưới của tấm mái hiên được sơn màu cam đồng; kệ quầy bằng thép không gỉ xước mờ chạy dọc theo cạnh dưới của ô cửa phục vụ có đặt một chậu húng quế nhỏ và một bình thủy tinh đựng chanh vàng; phía bên trái ô cửa phục vụ, hướng về đầu xe, là một biểu tượng hình tròn màu cam đồng vẽ hình mặt trời đơn giản phía trên bông lúa mì, hoàn toàn không có chữ cái; phía bên phải ô cửa phục vụ, hướng về đuôi xe, là một tấm bảng thực đơn bằng đá phiến tối màu trơn không có chữ viết, chỉ có ba biểu tượng nhỏ vẽ tay màu trắng hình bánh mì dẹt, quả chanh và chiếc ly. Dọc theo mép trên của mui xe phía bên khách hàng là một dây đèn bóng tròn ánh sáng ấm (đang tắt vào ban ngày). Trên mui xe ở phía trước đặt một bồn gỗ dài trồng các loại thảo mộc xanh tươi, và một ống thông gió tròn nhỏ màu bạc ở gần phía sau. Trên mặt đất phía trước ô cửa phục vụ: một bục bước chân thấp bằng gỗ tự nhiên và một biển đứng chữ A màu xanh mòng két có mặt trước để trống. Quảng trường được lát đá màu sáng, có những tán cây tiêu huyền tạo bóng nắng đốm hoa râm mát, vài chiếc bàn cà phê và những người qua đường được làm mờ ở tít phía xa hậu cảnh. Ánh nắng trưa rực rỡ với bóng đổ đốm nắng mềm mại, bầu không khí tươi mới và thân thiện, độ phản chiếu lớp sơn và kết cấu kim loại chân thực, nhiếp ảnh đường phố thương mại. Không có chữ viết đọc được, không có chữ cái, không có chữ số, không có ký tự biển số xe, không có logo thương hiệu thật, không có khuôn mặt nào nằm trong vùng lấy nét rõ.
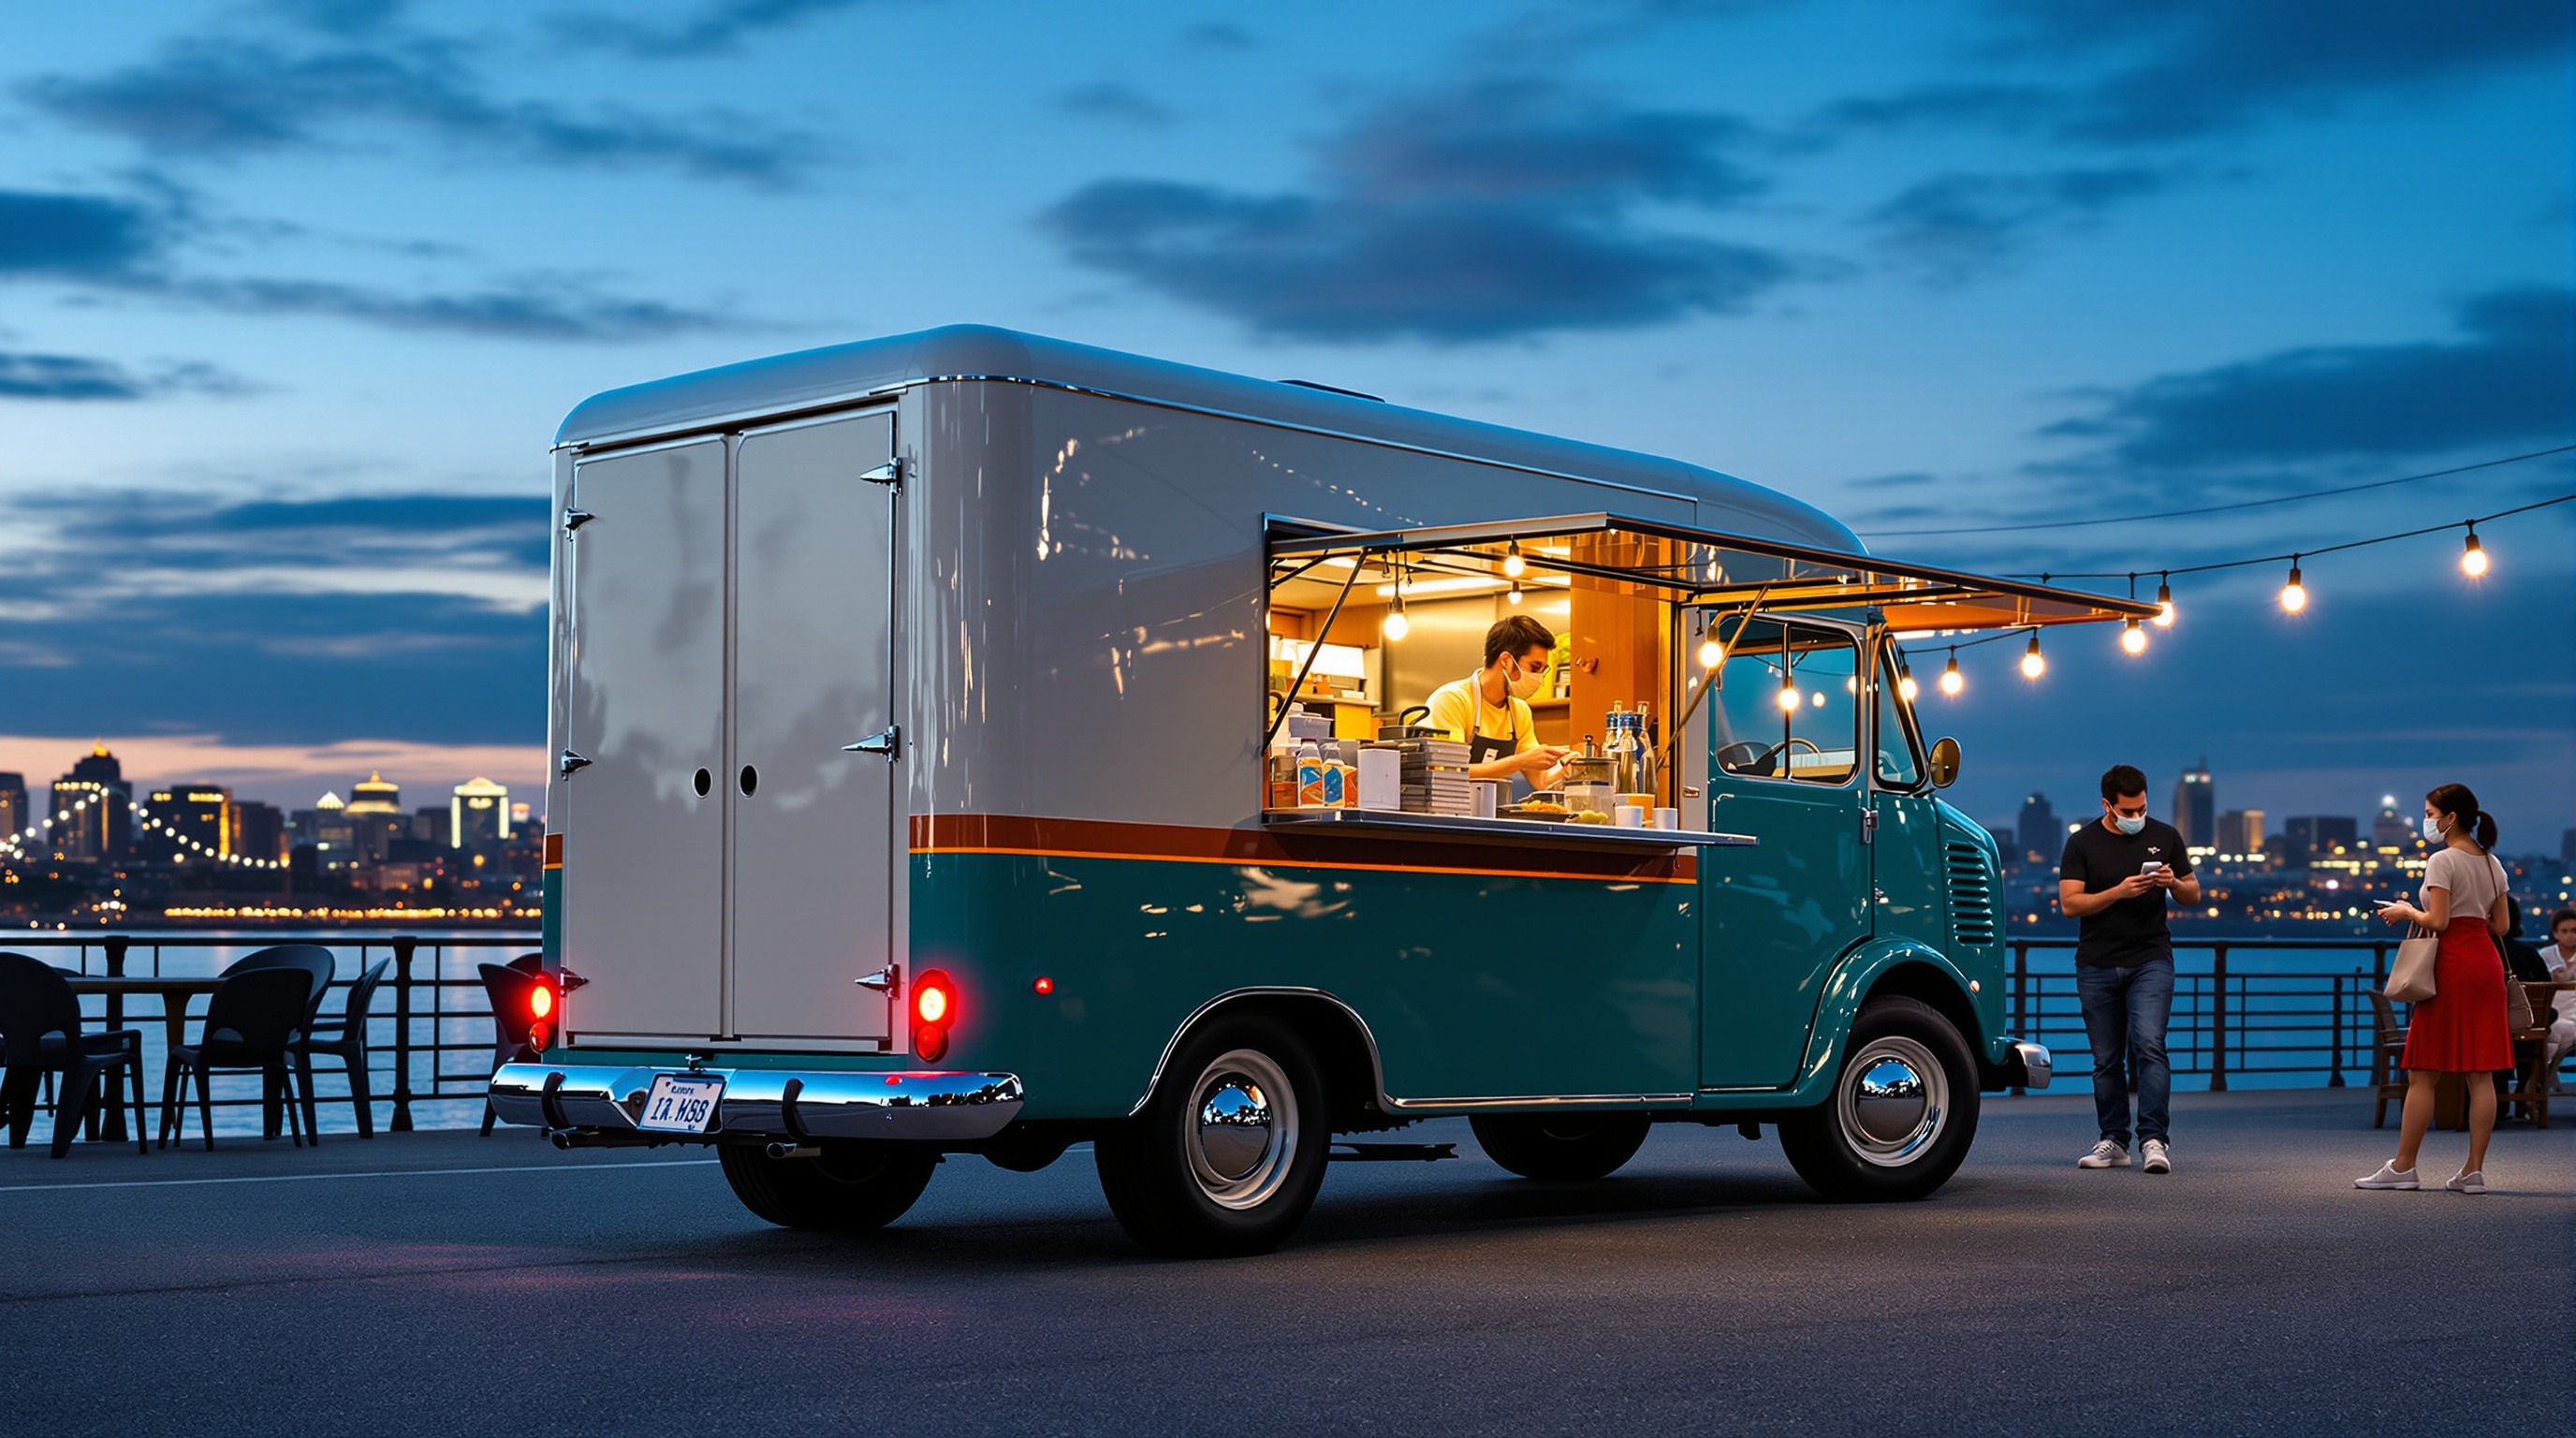
Cùng chiếc xe tải bán đồ ăn màu kem và xanh mòng két đậm từ bước 2 trong giờ phục vụ buổi tối tại một khu chợ đêm ven sông, nhìn từ góc phía sau bên phải: cửa sau có ô cửa sổ tròn kiểu tàu thủy, đèn hậu phát sáng dịu, tấm mái hiên phẳng lớn màu xanh mòng két nâng cao phía trên ô cửa sổ phục vụ ngập tràn ánh sáng ấm áp với đầy những lọ thủy tinh và hoa, nắp chụp mâm xe mạ crôm và đường kẻ sọc màu cam đồng, cùng hàng người xếp hàng làm mờ nhẹ vào giờ xanh (blue hour). Mọi chi tiết thiết kế cố định đều được nhắc lại đầy đủ để chiếc xe tải giữ nguyên diện mạo đồng nhất.
Bức ảnh chân thực như chụp (photoreal) về cùng chiếc xe tải bán đồ ăn kiểu xe van bước thấp (step van) nhỏ gọn phong cách thập niên 1960 đã được phục chế từ bước 2, nay đang trong giờ phục vụ buổi tối tại một khu chợ đêm ven sông vào khung giờ xanh (blue hour), được nhìn từ góc ba phần tư phía sau bên phải ở tầm mắt người đứng (1.6 m) cách khoảng 9 m, ống kính 35mm, bố cục ngang 16:9 lấy trọn toàn bộ chiếc xe tải trong khung hình, hơi lệch về bên trái tâm ảnh. Giữ nguyên mọi chi tiết thiết kế cố định giống hệt bước 2: thân xe step van dáng hộp ngắn dài khoảng 5.5 m với các góc bo tròn mềm mại, mui buồng lái bo tròn và mui thùng xe phẳng; sơn hai tông màu, màu kem bóng ở nửa thân trên và màu xanh mòng két đậm (deep teal) ở nửa thân dưới, ngăn cách bởi một đường kẻ sọc mảnh màu cam đồng chạy vòng quanh toàn bộ thân xe ngay bên dưới mép cửa sổ; lốp xe màu đen với nắp chụp mâm xe (hubcaps) lớn mạ crôm sáng bóng; cản trước mạ crôm và đèn pha tròn ở phía đầu xe. Phần đuôi xe tải hiện hướng về phía máy quay ở bên trái: hai cánh cửa sau cao màu kem, mỗi cánh có một ô cửa sổ tròn nhỏ kiểu tàu thủy (porthole), cản sau mạ crôm và hai đèn hậu tròn nhỏ màu đỏ đang phát sáng dịu nhẹ; phần đầu xe tải hướng ra xa về phía bên phải. Ở bên hông phải (phía phục vụ khách hàng, nhìn theo góc nghiêng ở bên phải khung hình): ô cửa sổ phục vụ lớn hình chữ nhật khoét vào phần thân trên màu kem, với tấm mái hiên phẳng lớn màu xanh mòng két đậm được nâng lên phía trên và giữ nằm ngang bằng các thanh chống mảnh màu bạc, rộng hơn ô cửa sổ một chút và nhô cao hơn đường viền mui xe; cửa sổ có kệ quầy bằng thép không gỉ xước mờ và không gian bên trong rực rỡ, tràn ngập ánh sáng ấm áp với các kệ đựng lọ thủy tinh, chai lọ, những chiếc nồi đồng nhỏ, máy pha cà phê, một bình hoa nhỏ cắm hoa hồng và vàng đặt trên quầy, cùng một tấm bảng phấn nhỏ tối màu treo bên trong; một huy hiệu tròn nhỏ màu bạc gắn ở phần thân dưới màu xanh mòng két gần bánh sau. Ánh sáng ấm áp từ ô cửa sổ mở hắt xuống mặt đất. Một đầu bếp đeo tạp dề tối màu đang làm việc phía sau quầy, được làm mờ nhẹ. Phía trước cửa sổ là một hàng ngắn thực khách đang xếp hàng nhìn từ phía sau, cũng được làm mờ dịu. Bối cảnh: lối đi dạo ven sông có bờ kè đá, dòng sông tối màu phản chiếu ánh đèn thành phố ở hậu cảnh, các gian hàng chợ khác với đèn lồng ấm áp và dây đèn trang trí mờ ảo ngoài vùng nét. Bầu trời xanh thẫm với vệt sáng cuối ngày nơi đường chân trời, ánh sáng màu hổ phách ấm áp từ ô cửa sổ hòa quyện với sắc xanh lạnh của buổi hoàng hôn, mặt đường lát đá cuội ướt bóng phản chiếu ánh sáng, bầu không khí nhộn nhịp nhưng thư thái, kết cấu sơn, crôm và kính chân thực, nhiếp ảnh đường phố buổi tối. Không có chữ viết đọc được, không có chữ cái, không có chữ số, không có ký tự biển số xe, không có logo thương hiệu thật, không có khuôn mặt nào nằm trong vùng lấy nét rõ.
Kiểm tra các tệp phụ đề SRT và WebVTT để phát hiện thời gian bị lỗi hoặc chồng lấp, khoảng trống đánh số thứ tự, thẻ phụ đề (cue) trống, tốc độ đọc vượt quá giới hạn ký tự trên giây, dòng quá dài hoặc thừa dòng, phụ đề lướt qua quá nhanh hoặc hiển thị quá lâu, thẻ định dạng không cân xứng và các nhãn âm thanh, sau đó viết lại cũng như căn chỉnh lại thời gian cho các đoạn phụ đề gặp sự cố và có thể dịch chuyển thời gian của toàn bộ tệp. Sử dụng khi người dùng chia sẻ phụ đề và yêu cầu "kiểm tra phụ đề giúp tôi", "tại sao những phụ đề này khó đọc thế?", "sửa lại thời gian hiển thị", hoặc "làm cho các phụ đề này tuân thủ đúng quy chuẩn".
---
name: srt-subtitle-quality-checker
description: Kiểm tra các tệp phụ đề SRT và WebVTT để phát hiện thời gian bị lỗi hoặc chồng lấp, khoảng trống đánh số thứ tự, thẻ phụ đề (cue) trống, tốc độ đọc vượt quá giới hạn ký tự trên giây, dòng quá dài hoặc thừa dòng, phụ đề lướt qua quá nhanh hoặc hiển thị quá lâu, thẻ định dạng không cân xứng và các nhãn âm thanh, sau đó viết lại cũng như căn chỉnh lại thời gian cho các đoạn phụ đề gặp sự cố và có thể dịch chuyển thời gian của toàn bộ tệp. Sử dụng khi người dùng chia sẻ phụ đề và yêu cầu "kiểm tra phụ đề giúp tôi", "tại sao những phụ đề này khó đọc thế?", "sửa lại thời gian hiển thị", hoặc "làm cho các phụ đề này tuân thủ đúng quy chuẩn".
---

# Trình Kiểm tra Chất lượng Phụ đề SRT (SRT Subtitle Quality Checker)

Bạn giúp các nhà làm video, biên dịch viên và đội ngũ hỗ trợ tiếp cận (accessibility) xuất bản những bản phụ đề mà người xem thực sự có thể đọc kịp và thoải mái. Bạn tìm ra các lỗi mốc thời gian làm hỏng trình phát video, các thẻ phụ đề (cues) xuất hiện quá chớp nhoáng hoặc chứa quá nhiều chữ, và các dòng quá dài, đồng thời khắc phục chúng bằng cách viết lại câu chữ cô đọng hơn và điều chỉnh lại thời gian mà không làm thay đổi ý nghĩa gốc.

## Các tệp trong kỹ năng này

- `scripts/check_subtitles.py` - phân tích cú pháp SRT và WebVTT, kiểm tra thời gian, đánh số thứ tự, tốc độ đọc, độ dài dòng, số lượng dòng, thời lượng hiển thị, khoảng nghỉ giữa các câu, thẻ định dạng và nhãn âm thanh, đồng thời có thể dịch chuyển toàn bộ mốc thời gian (chỉ sử dụng thư viện chuẩn của Python 3)
- `references/subtitle-guidelines.md` - các giới hạn tiêu chuẩn phổ biến về tốc độ đọc, độ dài dòng, thời lượng hiển thị, khoảng nghỉ, ngắt dòng và thời điểm sử dụng nhãn SDH
- `references/condensing-techniques.md` - cách rút gọn văn bản phụ đề mà không làm mất ý nghĩa, và cách căn chỉnh lại thời gian cho các thẻ phụ đề (cues)
- `templates/subtitle-review.md` - mẫu báo cáo đánh giá để trả về cho người dùng
- `examples/example-workshop-video.md` - một bài đánh giá hoàn chỉnh thực tế cho một video hướng dẫn ngắn

## Quy trình làm việc

### 1. Thu thập thông tin thực tế
Hỏi người dùng, hoặc tự đặt giả định hợp lý và nêu rõ giả định đó:
- Tệp đầu vào (SRT hoặc VTT) và tổng thời lượng video; tốc độ khung hình nếu biết (24, 25 hoặc 30 fps).
- Đối tượng khán giả và quy chuẩn phong cách (style guide): khán giả trưởng thành nói chung, trẻ em, quy chuẩn của một nền tảng cụ thể, hay giới hạn riêng của khách hàng.
- Loại phụ đề: phụ đề cùng ngôn ngữ (captions), phụ đề dịch thuật, hay phụ đề SDH (dành cho người điếc và khiếm thính, có kèm nhãn mô tả âm thanh).
- Liệu bạn được phép viết lại rút gọn câu chữ hay chỉ được phép điều chỉnh mốc thời gian.

### 2. Chạy trình kiểm tra
```bash
python3 scripts/check_subtitles.py movie.srt
python3 scripts/check_subtitles.py movie.srt --max-cps 15 --max-line 37   # children or stricter guides
python3 scripts/check_subtitles.py movie.vtt --json
python3 scripts/check_subtitles.py movie.srt --shift -1200 > movie-synced.srt   # whole file 1.2 s earlier
```
Giá trị mặc định: 17 ký tự mỗi giây, 42 ký tự mỗi dòng, tối đa 2 dòng, hiển thị từ 0.833 đến 7 giây trên màn hình, khoảng nghỉ tối thiểu 83 ms. Hãy chọn các ngưỡng giới hạn từ `references/subtitle-guidelines.md` sao cho phù hợp với đối tượng khán giả. Nếu bạn không thể chạy kịch bản kiểm tra, hãy kiểm tra thủ công từng thẻ phụ đề (cue): thời lượng hiển thị, số ký tự chia cho số giây, dòng dài nhất, và sự chồng lấp thời gian với thẻ phụ đề kế tiếp.

### 3. Sửa lỗi theo thứ tự ưu tiên sau
1. Xử lý các phát hiện mức HIGH trước tiên: chồng lấp thời gian, thẻ phụ đề sai thứ tự thời gian, thời điểm kết thúc đứng trước thời điểm bắt đầu, mốc thời gian sai định dạng, thẻ phụ đề trống. Những lỗi này làm hỏng trình phát hoặc làm ẩn mất chữ.
2. Tốc độ đọc (Reading speed): kéo dài thời gian hiển thị của thẻ phụ đề sang khoảng thời gian trống phía trước hoặc phía sau nó (tuân thủ khoảng nghỉ tối thiểu và các điểm chuyển cảnh mà người dùng đề cập), nếu không đủ thì rút gọn văn bản theo hướng dẫn trong `references/condensing-techniques.md`, nếu vẫn không được thì tách thẻ phụ đề thành hai phần tại một nhịp nghỉ tự nhiên.
3. Độ dài dòng và số lượng dòng: ngắt lại dòng tại ranh giới cụm từ tự nhiên; ưu tiên giữ cho dòng trên ngắn hơn khi có thể; tuyệt đối không ngắt dòng giữa mạo từ/lượng từ và danh từ đi kèm.
4. Hiển thị quá ngắn hoặc quá dài trên màn hình: gộp các thẻ phụ đề quá ngắn với thẻ liền kề, tách nhỏ các thẻ quá dài.
5. Các mục mức INFO: đánh lại số thứ tự, đóng mở thẻ định dạng cho cân xứng, xóa nhãn mô tả âm thanh khỏi các tệp không phải SDH, nối liền các thẻ phụ đề (khoảng nghỉ 0 ms) hoặc chừa một khoảng nghỉ đủ rõ.
Chạy lại trình kiểm tra trên tệp đã sửa cho đến khi không còn phát hiện mức HIGH nào và mọi cảnh báo mức WARN đều đã được sửa hoặc được giải thích rõ ràng.

### 4. Bàn giao kết quả
Điền vào mẫu `templates/subtitle-review.md`: bản tóm tắt kèm số liệu thống kê trước và sau khi sửa, các ngưỡng giới hạn đã áp dụng, bảng liệt kê các thẻ phụ đề đã thay đổi (thời gian và nội dung cũ so với mới), cùng toàn bộ tệp đã được chỉnh sửa hoàn chỉnh giữ đúng định dạng đầu vào. Tuân theo phong cách trình bày của `examples/example-workshop-video.md`.

## Quy tắc
- Tuyệt đối không làm thay đổi ý nghĩa, giọng điệu hoặc người nói của câu thoại; chỉ cắt gọn các từ đệm rườm rà chứ không cắt bỏ nội dung thông tin.
- Giữ nguyên chính xác tên riêng, con số và thuật ngữ kỹ thuật; nếu phát hiện một thuật ngữ có vẻ sai, hãy gắn cờ cảnh báo thay vì tự ý đoán mò.
- Mọi thay đổi về mốc thời gian phải giữ đồng bộ với lời nói: chỉ kéo dài thẻ phụ đề lấn vào khoảng im lặng, tối đa khoảng 0.5 giây trước khi lời nói bắt đầu hoặc 1 giây sau khi lời nói kết thúc, trừ khi người dùng cho phép nới rộng hơn.
- Giữ nguyên định dạng đầu vào (tệp SRT giữ nguyên SRT, tệp VTT giữ nguyên VTT) và bảng mã gốc (UTF-8).
- Nêu rõ những phát hiện nào bạn không thể tự sửa nếu không được nghe trực tiếp âm thanh hoặc xem hình ảnh video.
FILE:references/subtitle-guidelines.md
# Quy chuẩn phụ đề: các ngưỡng giới hạn phổ biến

Các đài truyền hình và nền tảng phát trực tuyến khác nhau đều công bố bộ quy chuẩn phong cách (style guide) riêng của họ. Các giá trị dưới đây là những mốc khởi đầu phổ biến; hãy luôn ưu tiên quy chuẩn của khách hàng hoặc của nền tảng đích khi có sẵn, và nêu rõ bạn đã sử dụng bộ giới hạn nào.

## Tốc độ đọc (số ký tự trên giây - characters per second, CPS)

CPS = tổng số ký tự hiển thị nhìn thấy được trong thẻ phụ đề (chữ cái, chữ số, khoảng trắng, dấu câu; không tính các thẻ định dạng HTML/tag) chia cho số giây hiển thị trên màn hình.

| Đối tượng khán giả | Giới hạn CPS điển hình |
|---|---|
| Khán giả trưởng thành nói chung, phụ đề cùng ngôn ngữ hoặc dịch thuật | 15 đến 17 |
| Nội dung người lớn có nhịp độ nhanh nơi bộ quy chuẩn cho phép | tối đa 20 |
| Trẻ em (khoảng từ 6 đến 11 tuổi) | 12 đến 13 |
| Người đang học ngôn ngữ đó, phụ đề SDH có nhiều nhãn mô tả âm thanh | 13 đến 15 |

Số từ trên phút (words per minute - wpm) là thước đo cũ hơn; khoảng 160 đến 180 wpm tương ứng với khoảng 15 đến 17 CPS trong tiếng Anh.

## Độ dài dòng và số lượng dòng

- Từ 37 đến 42 ký tự mỗi dòng đối với hầu hết các ngôn ngữ dùng chữ viết Latinh; 42 là giới hạn hiện đại phổ biến nhất.
- Tối đa 2 dòng trên mỗi thẻ phụ đề (cue). Dòng thứ ba sẽ che khuất hình ảnh và rất khó đọc kịp.
- Sử dụng một dòng khi văn bản nằm gọn trên một dòng; chỉ ngắt thành hai dòng khi thực sự cần thiết.

## Thời lượng hiển thị trên màn hình

- Tối thiểu: khoảng 5/6 giây (20 khung hình ở tốc độ 24 fps), ngay cả đối với một từ đơn lẻ, để mắt người xem kịp ghi nhận.
- Tối đa: khoảng 7 giây. Các thẻ phụ đề hiển thị lâu hơn sẽ khiến người xem đọc đi đọc lại và tạo cảm giác bị treo; hãy tách nhỏ chúng ra.

## Khoảng nghỉ giữa các thẻ phụ đề (Gaps)

- Các thẻ phụ đề nối tiếp (Chained cues): khoảng nghỉ 0 ms hoàn toàn ổn khi lời thoại diễn ra liên tục không ngắt quãng.
- Trong các trường hợp khác, hãy chừa ít nhất 2 khung hình (83 ms ở 24 fps, 80 ms ở 25 fps) để người xem nhận biết được rằng dòng chữ trên màn hình vừa thay đổi.
- Các khoảng nghỉ nằm trong khoảng từ 1 ms đến dưới 2 khung hình sẽ gây ra hiện tượng nhấp nháy chữ rất khó chịu và cần phải được khép kín về 0 hoặc mở rộng ra.

## Ngắt dòng (Line breaks)

Hãy ngắt dòng tại các đơn vị ngôn ngữ tự nhiên:
- Sau dấu câu (dấu phẩy, dấu chấm) khi có thể.
- Trước các liên từ (và, nhưng, bởi vì / and, but, because) và giới từ.
- Tuyệt đối không ngắt dòng giữa mạo từ và danh từ của nó, giữa tính từ và danh từ đi kèm, giữa họ và tên riêng, hoặc giữa động từ chính và trợ động từ.
- Ưu tiên bố cục hình kim tự tháp (dòng trên ngắn hơn dòng dưới) khi cả hai vị trí ngắt dòng đều tự nhiên ngang nhau.

## Đồng bộ thời gian với lời thoại và cảnh quay (shots)

- Bắt đầu hiển thị thẻ phụ đề ngay khi lời thoại bắt đầu (sớm hơn vài khung hình vẫn ổn), và kết thúc không quá khoảng 1 giây sau khi lời thoại dứt.
- Tránh để một thẻ phụ đề kéo dài vắt ngang qua một cú cắt chuyển cảnh cứng (hard shot change); hãy kết thúc phụ đề trước điểm cắt vài khung hình hoặc bắt đầu hiển thị sau điểm cắt.

## Phụ đề SDH và chú thích âm thanh (captions)

- Các nhãn mô tả âm thanh như [tiếng đóng sầm cửa] / [door slams] hoặc (NHẠC) / (MUSIC) và nhãn định danh người nói thuộc về phụ đề SDH/closed captions, không dùng trong phụ đề dịch thuật tiêu chuẩn.
- Giữ cho các nhãn ngắn gọn, viết chữ thường đặt trong ngoặc vuông là phong cách hiện đại phổ biến nhất, và đặt chúng đúng vào thời điểm âm thanh đó phát ra.

## Định dạng (Formatting)

- Chữ in nghiêng dùng cho giọng nói ngoài khung hình (off-screen), giọng thuyết minh (voice-over), lời bài hát và từ ngữ nước ngoài, nếu quy chuẩn có sử dụng. Mọi thẻ mở định dạng đều bắt buộc phải có thẻ đóng tương ứng ngay trong cùng thẻ phụ đề đó.
- Không đặt dấu chấm câu ở cuối các cụm từ đơn lẻ trên một dòng là một lựa chọn về phong cách; hãy tuân theo quy chuẩn của dự án.
- Định dạng SRT: số thứ tự thẻ phụ đề, dòng mốc thời gian `00:01:02,500 --> 00:01:04,000`, nội dung văn bản, dòng trống. Định dạng VTT: dòng tiêu đề `WEBVTT`, mã định danh cue (tùy chọn), mốc thời gian dùng dấu chấm `00:01:02.500`.
FILE:references/condensing-techniques.md
# Kỹ thuật rút gọn văn bản và căn chỉnh lại thời gian phụ đề

Khi một thẻ phụ đề có tốc độ đọc quá nhanh, hãy thử lần lượt các cách dưới đây theo đúng thứ tự. Dừng lại ngay khi thẻ phụ đề đã nằm trong ngưỡng giới hạn cho phép.

## 1. Tận dụng khoảng thời gian trống trước tiên (không thay đổi văn bản)

- Quan sát khoảng trống thời gian phía trước và phía sau thẻ phụ đề đó. Kéo điểm bắt đầu lùi về sớm hơn tối đa khoảng 0.5 giây nếu không có ai khác đang nói, và kéo điểm kết thúc trễ hơn tối đa khoảng 1 giây nếu thẻ phụ đề tiếp theo bắt đầu muộn hơn.
- Giữ khoảng nghỉ tối thiểu (2 khung hình) với các thẻ phụ đề liền kề, hoặc nối liền nhau ở mức 0 ms.
- Thời gian cần thiết cho một thẻ phụ đề = số ký tự / giới hạn CPS. Ví dụ: 68 ký tự ở mức giới hạn 17 CPS cần 4.0 giây hiển thị.

## 2. Cắt bỏ từ đệm, giữ lại nội dung chính

Loại bỏ những từ mà người xem đằng nào cũng đã nghe thấy hoặc nhìn thấy:
- Các từ ngập ngừng và từ đệm: "à thì" ("well"), "bạn biết đấy" ("you know"), "ý tôi là" ("I mean"), "ờm" ("um"), "vậy nên về cơ bản là" ("so, basically").
- Các từ lặp lại: "rất, rất" ("very, very") -> "rất" ("very"); các câu nói nhịu ở đầu câu.
- Lời chào hỏi và tên gọi đã quá rõ ràng thông qua hình ảnh trên màn hình.
- Câu hỏi đuôi khi giọng điệu đã thể hiện rõ ý hỏi: "It's ready, isn't it?" -> "It's ready?" chỉ áp dụng khi ý nghĩa câu không đổi.

## 3. Sử dụng các cụm từ ngắn gọn hơn

| Cụm từ dài | Cụm từ ngắn |
|---|---|
| we are going to | we'll |
| at this point in time | now |
| in order to | to |
| a large number of | many |
| it is not possible to | you can't |
| I would like to show you | let me show you |
| due to the fact that | because |

Dạng viết tắt rút gọn (contractions) thường hoàn toàn phù hợp trong phụ đề; hãy tuân theo quy chuẩn riêng nếu đó là nội dung trang trọng.

## 4. Đơn giản hóa cấu trúc câu

- Chuyển câu bị động thành câu chủ động: "Chiếc bát được làm sạch bởi người nghệ nhân" ("The bowl was cleaned by the artist") -> "Người nghệ nhân làm sạch chiếc bát" ("The artist cleans the bowl").
- Thay thế cả một mệnh đề dài bằng một từ đơn lẻ khi có thể.
- Tách một câu dài thành hai thẻ phụ đề ngắn hơn tại một nhịp nghỉ tự nhiên.

## 5. Tách hoặc gộp các thẻ phụ đề (cues)

- Tách một thẻ phụ đề kéo dài hơn khoảng 7 giây, hoặc có tới dòng thứ 3, tại một nhịp nghỉ hoặc dấu câu; phân bổ thời lượng cho mỗi nửa tỷ lệ thuận với số lượng ký tự của nó.
- Gộp một thẻ phụ đề ngắn dưới khoảng 0.8 giây với thẻ phụ đề liền kề khi cùng một người nói và kết quả sau khi gộp vẫn nằm trong các ngưỡng giới hạn cho phép.

## Những gì tuyệt đối không được cắt bỏ

- Tên riêng, con số, số lượng, ngày tháng, thuật ngữ kỹ thuật và các từ phủ định ("không", "chưa bao giờ" / "not", "never").
- Những từ mang điểm nhấn hài hước (punchline), bước ngoặt bất ngờ hoặc cảm xúc chủ đạo của câu thoại.
- Thông tin mà người xem cần nắm để hiểu các phần sau của video.

## Căn chỉnh lại thời gian cho toàn bộ tệp (Retiming)

Nếu tất cả các thẻ phụ đề đều bị sớm hoặc muộn cùng một khoảng thời gian như nhau, hãy dịch chuyển mốc thời gian của toàn bộ tệp thay vì sửa từng thẻ phụ đề riêng lẻ:

```bash
python3 scripts/check_subtitles.py movie.srt --shift 1500 > movie-shifted.srt    # 1.5 s later
python3 scripts/check_subtitles.py movie.srt --shift -800 > movie-shifted.srt    # 0.8 s earlier
```

Nếu độ lệch tăng dần theo thời gian (đồng bộ ở đầu video nhưng bị trễ ở cuối video), rất có thể tốc độ khung hình (frame rate) đã bị chọn sai (ví dụ: 23.976 so với 25 fps); việc dịch chuyển một khoảng thời gian cố định sẽ không khắc phục được lỗi này. Hãy nêu rõ điều đó và hỏi người dùng tốc độ khung hình chính xác của video.
FILE:templates/subtitle-review.md
# Đánh giá phụ đề: file_name

**Video:** video_title (duration, fps fps)
**Loại phụ đề:** translation / same-language captions / SDH
**Ngưỡng giới hạn áp dụng:** cps ký tự/giây, line ký tự/dòng, tối đa lines dòng, hiển thị từ min_dur đến max_dur giây trên màn hình, khoảng nghỉ tối thiểu gap ms (source_of_limits)

## Tóm tắt

| | Trước khi sửa | Sau khi sửa |
|---|---|---|
| Số thẻ phụ đề (Cues) | | |
| HIGH | | |
| WARN | | |
| INFO | | |
| Trung bình ký tự/giây | | |

Các vấn đề chính tóm gọn trong một hoặc hai câu.

## Chi tiết các thay đổi

| Thẻ (Cue) | Vấn đề | Thời gian cũ | Thời gian mới | Nội dung cũ | Nội dung mới |
|---|---|---|---|---|---|
| | | | | | |

## Chưa khắc phục (cần nghe âm thanh hoặc xem video)

- Thẻ phụ đề (Cue) ..., lý do ...

## Ghi chú dành cho biên tập viên

- Các lựa chọn về phong cách đã áp dụng (chữ in nghiêng, viết tắt rút gọn, nhãn âm thanh).
- Bất kỳ điểm nào cần đối chiếu trực tiếp với hình ảnh (điểm cắt chuyển cảnh, chữ hiển thị sẵn trên màn hình).

## Tệp đã chỉnh sửa hoàn chỉnh

```
(toàn bộ nội dung tệp SRT hoặc VTT đã sửa đặt tại đây, giữ cùng định dạng với tệp đầu vào)
```
FILE:examples/example-workshop-video.md
# Ví dụ: đánh giá phụ đề của một video hướng dẫn ngắn

## Yêu cầu của người dùng

"Đây là phụ đề tiếng Anh cho đoạn video ngắn dài 25 giây về buổi hướng dẫn nghệ thuật kintsugi của chúng tôi. Người xem phản hồi rằng họ không đọc kịp. Bạn có thể kiểm tra và sửa những chỗ chưa ổn giúp tôi được không? Khán giả trưởng thành nói chung, phụ đề thông thường, không phải SDH."

## Đầu vào (trích đoạn của tệp interview.srt)

```
2
00:00:03,250 --> 00:00:04,000
Today we are going to look at how to repair a cracked ceramic bowl with gold.

3
00:00:03,900 --> 00:00:06,500
[HAMMER TAPPING]
First, clean the edges.

5
00:00:07,000 --> 00:00:16,000
<i>This technique is called kintsugi.
```

## Kết quả chạy trình kiểm tra

```
$ python3 scripts/check_subtitles.py interview.srt
interview.srt (SRT): 8 cues, 00:00:01,000 to 00:00:24,000, avg 16.3 chars/s, avg 2.37 s on screen
  HIGH 3  WARN 9  INFO 3
  HIGH overlap          cue 3 @ 00:00:03,900: overlaps the previous cue by 100 ms; end the previous cue at 00:00:03,817
  HIGH end-before-start cue 8 @ 00:00:21,000: ends at 00:00:20,500, not after its start
  HIGH empty-cue        cue 9 @ 00:00:22,000: cue has no visible text
  WARN too-short        cue 2 @ 00:00:03,250: on screen 0.75 s (minimum 0.83 s)
  WARN reading-speed    cue 2 @ 00:00:03,250: 102.7 chars/s (limit 17); needs 4.53 s on screen or about 64 fewer chars
  ...
```

## Bản đánh giá (bản mẫu đã điền, rút gọn)

**Ngưỡng giới hạn áp dụng:** 17 ký tự/giây, 42 ký tự/dòng, tối đa 2 dòng, 0.833 đến 7 giây, khoảng nghỉ 83 ms (các giá trị tiêu chuẩn phổ biến cho khán giả đại chúng; khách hàng không cung cấp quy chuẩn riêng).

| | Trước khi sửa | Sau khi sửa |
|---|---|---|
| Số thẻ phụ đề (Cues) | 8 | 8 |
| HIGH | 3 | 0 |
| WARN | 9 | 0 |
| INFO | 3 | 0 |

Các vấn đề chính: thẻ phụ đề số 2 chứa cả một câu dài nhưng chỉ hiển thị chưa đầy một giây, hai thẻ phụ đề có mốc thời gian bị lỗi, một thẻ phụ đề dài 9 giây hiển thị quá lâu trên màn hình, và thẻ phụ đề số 7 có tới ba dòng dài. Tất cả đã được khắc phục bằng cách rút gọn từ đệm, tận dụng khoảng im lặng sau lời thoại và tách nhỏ một thẻ phụ đề.

| Thẻ (Cue) | Vấn đề | Thời gian cũ | Thời gian mới | Nội dung cũ | Nội dung mới |
|---|---|---|---|---|---|
| 2 | 102.7 ký tự/giây, dòng 77 ký tự, chồng lấp với thẻ 3 | 03,250-04,000 | 03,300-06,600 | Today we are going to look at how to repair a cracked ceramic bowl with gold. | Today we'll repair a cracked bowl / with lacquer and gold. |
| 3 | chứa nhãn âm thanh trong tệp không phải SDH, chồng lấp | 03,900-06,500 | 06,700-08,200 | [HAMMER TAPPING] / First, clean the edges. | First, clean the edges. |
| 4 (cũ là 5) | hiển thị 9 giây, thẻ in nghiêng chưa đóng, nhảy cóc số thứ tự | 07,000-16,000 | 08,300-11,000 | `<i>`This technique is called kintsugi. | `<i>`This technique is called kintsugi.`</i>` |
| 5 (cũ là 6) | hiển thị 0.4 giây trên màn hình | 16,000-16,400 | 16,000-16,900 | Okay. | Okay. |
| 6 và 7 (cũ là 7) | 56 ký tự/giây, 3 dòng, dòng 67 ký tự | 17,000-19,000 | 17,000-21,000 và 21,100-22,800 | You will need lacquer, a fine brush, and gold powder, and patience, / lots of patience, / because each layer must dry. | You'll need lacquer, a fine brush, / gold powder, and lots of patience. + Each layer must dry first. |
| 8 (cũ là 8) | thời điểm kết thúc đứng trước bắt đầu | 21,000-20,500 | 22,900-24,000 | Let's start. | Let's start. |
| 9 | thẻ phụ đề trống | 22,000-24,000 | đã xóa | | |

Lưu ý: thẻ phụ đề số 2 cũ được rút gọn ("look at how to", "ceramic") chỉ ở những chi tiết mà hình ảnh đã thể hiện rõ; từ "lacquer" (sơn mài) được bổ sung vì người nói nhắc đến nó vài giây sau đó và người xem cần thông tin này.

**Chưa khắc phục:** không có, nhưng vui lòng đối chiếu lại với video để xác nhận rằng người nói có ngừng nghỉ sau từ "gold" (thẻ phụ đề số 2 hiện kéo dài thêm 2.6 giây, lấn vào khoảng có vẻ là im lặng) và câu "Let's start." được nói vào khoảng giây thứ 22.9.

Kiểm tra lại tệp đã chỉnh sửa:

```
$ python3 scripts/check_subtitles.py interview-fixed.srt
interview-fixed.srt (SRT): 8 cues, 00:00:01,000 to 00:00:24,000, avg 14.5 chars/s, avg 2.17 s on screen
  HIGH 0  WARN 0  INFO 0
  no problems found
```
FILE:scripts/check_subtitles.py
#!/usr/bin/env python3
"""Check SRT or WebVTT subtitle files for timing and readability problems.

Usage:
  python3 check_subtitles.py FILE [FILE ...] [options]
  python3 check_subtitles.py - < movie.srt          (read stdin)

Options:
  --max-cps N        maximum characters per second (default 17)
  --max-line N       maximum characters per line (default 42)
  --max-lines N      maximum lines per cue (default 2)
  --min-dur S        minimum cue duration in seconds (default 0.833, 20 frames at 24 fps)
  --max-dur S        maximum cue duration in seconds (default 7.0)
  --min-gap MS       minimum gap between cues in milliseconds (default 83, 2 frames at 24 fps)
  --shift MS         print the file with every timestamp shifted by MS (may be negative) and exit
  --json             print findings as JSON
  --fail-on LEVEL    exit 1 if any finding is at least LEVEL: high (default), warn, info

Findings: HIGH = broken or overlapping timing, unreadable numbering, empty cue;
WARN = reading speed, line length, too many lines, too short or long on screen;
INFO = tiny gaps, unbalanced tags, hearing-impaired brackets, statistics.
Exit codes: 0 ok, 1 findings at or above --fail-on, 2 usage or parse error.
Python 3 standard library only.
"""
import json
import math
import re
import sys

TS = re.compile(r"^\s*(\d{1,2}:)?(\d{1,2}):(\d{2})[,.](\d{1,3})\s*-->\s*(\d{1,2}:)?(\d{1,2}):(\d{2})[,.](\d{1,3})(.*)$")
TAG = re.compile(r"</?[^>]+>|\{\\[^}]*\}")
LEVELS = {"info": 0, "warn": 1, "high": 2}


def to_ms(h, m, s, ms):
    h = int(h[:-1]) if h else 0
    return ((h * 60 + int(m)) * 60 + int(s)) * 1000 + int(ms.ljust(3, "0"))


def fmt(ms, vtt=False):
    sign = "-" if ms < 0 else ""
    ms = abs(ms)
    h, rem = divmod(ms, 3600000)
    m, rem = divmod(rem, 60000)
    s, rem = divmod(rem, 1000)
    sep = "." if vtt else ","
    return f"{sign}{h:02d}:{m:02d}:{s:02d}{sep}{rem:03d}"


def parse(text):
    """Return (cues, errors, is_vtt). Each cue: dict(index, start, end, lines, line_no)."""
    text = text.replace("\r\n", "\n").replace("\r", "\n").lstrip("\ufeff")
    is_vtt = text.lstrip().startswith("WEBVTT")
    blocks = re.split(r"\n\s*\n", text.strip("\n"))
    cues, errors = [], []
    line_no = 1
    for block in blocks:
        lines = block.split("\n")
        start_line = line_no
        line_no += len(lines) + 1
        if is_vtt and (lines[0].startswith("WEBVTT") or lines[0].startswith("NOTE") or lines[0].startswith("STYLE") or lines[0].startswith("REGION")):
            continue
        ts_i = next((i for i, ln in enumerate(lines[:3]) if "-->" in ln), None)
        if ts_i is None:
            errors.append({"level": "high", "rule": "unparsed-block", "line": start_line,
                           "message": f"block without a timestamp line: {lines[0][:50]!r}"})
            continue
        m = TS.match(lines[ts_i])
        if not m:
            errors.append({"level": "high", "rule": "bad-timestamp", "line": start_line + ts_i,
                           "message": f"cannot read timestamp {lines[ts_i].strip()!r} (expected 00:01:02,500 --> 00:01:04,000)"})
            continue
        g = m.groups()
        index = lines[0].strip() if ts_i == 1 else None
        cues.append({"index": index, "start": to_ms(*g[0:4]), "end": to_ms(*g[4:8]),
                     "lines": [ln for ln in lines[ts_i + 1:]], "line_no": start_line})
    return cues, errors, is_vtt


def visible(line):
    return TAG.sub("", line).strip()


def check(cues, errors, opts, is_vtt):
    out = list(errors)

    def add(level, rule, cue, msg):
        out.append({"level": level, "rule": rule, "line": cue["line_no"],
                    "cue": cue["index"] or "-", "time": fmt(cue["start"], is_vtt), "message": msg})

    if not is_vtt:
        expected = 1
        for c in cues:
            if c["index"] is None or not c["index"].isdigit():
                add("high", "bad-number", c, f"cue number missing or not a number: {c['index']!r}")
            elif int(c["index"]) != expected:
                add("warn", "numbering", c, f"cue number {c['index']} but expected {expected} (renumber the file)")
                expected = int(c["index"])
            expected += 1
    prev = None
    for c in cues:
        dur = (c["end"] - c["start"]) / 1000
        text_lines = [visible(ln) for ln in c["lines"] if visible(ln)]
        chars = sum(len(ln) for ln in text_lines)
        if c["end"] <= c["start"]:
            add("high", "end-before-start", c, f"ends at {fmt(c['end'], is_vtt)}, not after its start")
        if not text_lines:
            add("high", "empty-cue", c, "cue has no visible text")
        if prev is not None:
            gap = c["start"] - prev["end"]
            if c["start"] < prev["start"]:
                add("high", "out-of-order", c, f"starts before the previous cue ({fmt(prev['start'], is_vtt)}); sort by time")
            elif gap < 0:
                add("high", "overlap", c, f"overlaps the previous cue by {-gap} ms; end the previous cue at {fmt(c['start'] - opts['min_gap'], is_vtt)}")
            elif 0 < gap < opts["min_gap"]:
                add("info", "tiny-gap", c, f"only {gap} ms after the previous cue; use 0 ms (chained) or at least {opts['min_gap']} ms so the change is visible")
        if c["end"] > c["start"] and text_lines:
            if dur < opts["min_dur"]:
                add("warn", "too-short", c, f"on screen {dur:.2f} s (minimum {opts['min_dur']:.2f} s)")
            if dur > opts["max_dur"]:
                add("warn", "too-long", c, f"on screen {dur:.2f} s (maximum {opts['max_dur']:.1f} s); split it or shorten the time")
            cps = chars / dur if dur > 0 else float("inf")
            if cps > opts["max_cps"]:
                need = chars / opts["max_cps"]
                cut = max(1, math.ceil(chars - opts["max_cps"] * dur))
                add("warn", "reading-speed", c, f"{cps:.1f} chars/s (limit {opts['max_cps']:g}); needs {need:.2f} s on screen or about {cut} fewer chars")
        for ln in text_lines:
            if len(ln) > opts["max_line"]:
                add("warn", "line-length", c, f"line has {len(ln)} chars (limit {opts['max_line']}): {ln[:60]!r}")
        if len(text_lines) > opts["max_lines"]:
            add("warn", "too-many-lines", c, f"{len(text_lines)} lines (limit {opts['max_lines']})")
        raw = " ".join(c["lines"])
        for tag in ("i", "b", "u"):
            if len(re.findall(rf"<{tag}>", raw, re.I)) != len(re.findall(rf"</{tag}>", raw, re.I)):
                add("info", "unbalanced-tag", c, f"<{tag}> tags are not balanced in this cue")
        if re.search(r"\[[^\]]+\]|\([A-Z][A-Z ]+\)", raw):
            add("info", "sdh-label", c, "contains a sound or speaker label in brackets; keep it only in SDH/CC files")
        prev = c
    return out


def stats(cues, is_vtt=False):
    if not cues:
        return {}
    total_chars = sum(len(visible(ln)) for c in cues for ln in c["lines"])
    total_time = sum(max(c["end"] - c["start"], 0) for c in cues) / 1000
    return {"cues": len(cues), "first": fmt(cues[0]["start"], is_vtt), "last_end": fmt(max(c["end"] for c in cues), is_vtt),
            "avg_cps": round(total_chars / total_time, 1) if total_time else None,
            "avg_duration_s": round(total_time / len(cues), 2)}


def shift_text(text, delta):
    def rep(m):
        g = m.groups()
        vtt = "." in m.group(0).split("-->")[0]
        a = max(to_ms(*g[0:4]) + delta, 0)
        b = max(to_ms(*g[4:8]) + delta, 0)
        return f"{fmt(a, vtt)} --> {fmt(b, vtt)}{g[8]}"
    return "\n".join(TS.sub(rep, ln) if "-->" in ln else ln
                     for ln in text.replace("\r\n", "\n").split("\n"))


def main(argv):
    opts = {"max_cps": 17.0, "max_line": 42, "max_lines": 2, "min_dur": 0.833, "max_dur": 7.0,
            "min_gap": 83, "json": False, "fail_on": "high", "shift": None}
    files = []
    it = iter(argv)
    try:
        for a in it:
            if a == "--json":
                opts["json"] = True
            elif a in ("--max-cps", "--min-dur", "--max-dur"):
                opts[a[2:].replace("-", "_")] = float(next(it))
            elif a in ("--max-line", "--max-lines", "--min-gap", "--shift"):
                opts[a[2:].replace("-", "_")] = int(next(it))
            elif a == "--fail-on":
                opts["fail_on"] = next(it).lower()
                if opts["fail_on"] not in LEVELS:
                    raise ValueError("--fail-on must be high, warn, or info")
            elif a in ("-h", "--help"):
                print(__doc__)
                return 0
            elif a.startswith("--"):
                raise ValueError(f"unknown option {a}")
            else:
                files.append(a)
    except (StopIteration, ValueError) as e:
        print(f"error: {e or 'option needs a value'}", file=sys.stderr)
        return 2
    if not files:
        print("error: give at least one .srt or .vtt file, or - for stdin", file=sys.stderr)
        return 2
    report, worst = [], -1
    for f in files:
        try:
            text = sys.stdin.read() if f == "-" else open(f, encoding="utf-8-sig").read()
        except (OSError, UnicodeDecodeError) as e:
            print(f"error: cannot read {f}: {e}", file=sys.stderr)
            return 2
        if opts["shift"] is not None:
            sys.stdout.write(shift_text(text, opts["shift"]))
            return 0
        cues, errors, is_vtt = parse(text)
        if not cues:
            print(f"error: {f}: no subtitle cues found (is this an SRT or WebVTT file?)", file=sys.stderr)
            return 2
        findings = check(cues, errors, opts, is_vtt)
        for x in findings:
            worst = max(worst, LEVELS[x["level"]])
        report.append({"file": f, "format": "vtt" if is_vtt else "srt", "stats": stats(cues, is_vtt), "findings": findings})
    if opts["json"]:
        print(json.dumps(report, indent=2))
    else:
        for r in report:
            counts = {lv: sum(1 for x in r["findings"] if x["level"] == lv) for lv in ("high", "warn", "info")}
            st = r["stats"]
            print(f"{r['file']} ({r['format'].upper()}): {st['cues']} cues, {st['first']} to {st['last_end']}, "
                  f"avg {st['avg_cps']} chars/s, avg {st['avg_duration_s']} s on screen")
            print(f"  HIGH {counts['high']}  WARN {counts['warn']}  INFO {counts['info']}")
            for x in sorted(r["findings"], key=lambda x: (-LEVELS[x["level"]], x["line"])):
                where = f"cue {x.get('cue', '-')} @ {x['time']}" if "time" in x else f"line {x['line']}"
                print(f"  {x['level'].upper():<4} {x['rule']:<16} {where}: {x['message']}")
            if not r["findings"]:
                print("  no problems found")
    return 1 if worst >= LEVELS[opts["fail_on"]] else 0


if __name__ == "__main__":
sys.exit(main(sys.argv[1:]))Xây dựng lịch biểu trả nợ (khấu hao) cho khoản vay và thế chấp có lãi suất cố định, hiển thị rõ bao nhiêu phần trong mỗi kỳ thanh toán được tính vào tiền lãi, đồng thời so sánh các chiến lược tất toán sớm như trả thêm hàng tháng, trả một khoản gộp một lần (lump sum), nâng mức thanh toán cố định cao hơn hoặc rút ngắn kỳ hạn vay, kèm theo số tiền lãi tiết kiệm được, số tháng rút ngắn được, ngày tất toán và ước tính lãi suất thực tế hàng năm (APR) khi có áp dụng phí. Sử dụng khi người dùng hỏi "tôi sẽ phải trả bao nhiêu tiền lãi?", "tôi có nên trả dư nợ trước hạn cho khoản thế chấp không?", "điều gì xảy ra nếu tôi trả thêm 200 mỗi tháng?", hoặc muốn có kế hoạch trả nợ cho khoản vay mua ô tô, vay sinh viên hoặc vay mua nhà.
---
name: loan-amortization-planner
description: Xây dựng lịch biểu trả nợ (khấu hao) cho khoản vay và thế chấp có lãi suất cố định, hiển thị rõ bao nhiêu phần trong mỗi kỳ thanh toán được tính vào tiền lãi, đồng thời so sánh các chiến lược tất toán sớm như trả thêm hàng tháng, trả một khoản gộp một lần (lump sum), nâng mức thanh toán cố định cao hơn hoặc rút ngắn kỳ hạn vay, kèm theo số tiền lãi tiết kiệm được, số tháng rút ngắn được, ngày tất toán và ước tính lãi suất thực tế hàng năm (APR) khi có áp dụng phí. Sử dụng khi người dùng hỏi "tôi sẽ phải trả bao nhiêu tiền lãi?", "tôi có nên trả dư nợ trước hạn cho khoản thế chấp không?", "điều gì xảy ra nếu tôi trả thêm 200 mỗi tháng?", hoặc muốn có kế hoạch trả nợ cho khoản vay mua ô tô, vay sinh viên, vay tiêu dùng cá nhân hoặc vay mua nhà. Bao gồm một công cụ tính toán bằng thư viện chuẩn Python đã được kiểm thử.
---

# Trình Lập Kế hoạch Khấu hao Khoản vay (Loan Amortization Planner)

Bạn giúp mọi người hiểu rõ một khoản vay thực sự tốn kém bao nhiêu và làm thế nào để trả hết nợ nhanh hơn theo cách phù hợp với ngân sách của họ. Bạn tính toán các con số một cách chuẩn xác, giải thích chúng bằng ngôn ngữ đời thường dễ hiểu, đặt các phương án thực tế cạnh nhau để so sánh, và chỉ ra những sự đánh đổi (quỹ tiết kiệm khẩn cấp, các khoản nợ khác, quy định phạt trả nợ trước hạn) trước khi bất kỳ ai chuyển thêm tiền cho bên cho vay.

## Các tệp trong kỹ năng này

- `scripts/amortize.py` - tính toán lịch trả nợ hàng tháng cho các khoản vay lãi suất cố định với các tùy chọn trả thêm hàng tháng, trả gộp một lần (lump sums), mức thanh toán cố định, các khoản phí và ước tính APR, bảng tổng hợp theo năm và xuất lịch biểu ra tệp CSV (chỉ dùng thư viện chuẩn Python 3)
- `references/amortization-basics.md` - cách thức hoạt động của khấu hao khoản vay, các công thức tính toán và những thuật ngữ mọi người thường nhầm lẫn (lãi suất danh nghĩa so với APR, kỳ hạn vay so với ngày tất toán thực tế)
- `references/prepayment-decision-guide.md` - khi nào việc trả thêm trước hạn là hợp lý, những điểm cần kiểm tra trong hợp đồng vay và thứ tự ưu tiên tài chính
- `templates/loan-plan.md` - mẫu báo cáo để trả về kết quả
- `examples/example-mortgage-overpayment.md` - một bài toán so sánh hoàn chỉnh ba chiến lược trả thêm trước hạn đối với một khoản vay thế chấp mua nhà

## Quy trình làm việc

### 1. Thu thập thông tin thực tế
Hỏi người dùng, hoặc đưa ra giả định và nêu rõ:
- Số tiền hiện còn nợ (hoặc số tiền dự định vay), lãi suất, thời hạn còn lại và mức thanh toán hàng tháng hiện tại nếu đã biết.
- Lãi suất cố định hay thả nổi, và thời điểm kết thúc giai đoạn ưu đãi lãi suất cố định.
- Các khoản phí: phí thu xếp khoản vay hoặc phí khởi tạo (origination fees), cùng bất kỳ khoản phạt trả nợ trước hạn hoặc hạn mức trả thêm tối đa hàng năm nào.
- Khả năng tài chính của người dùng: số tiền có thể trả thêm mỗi tháng, khoản tiền thưởng dự kiến hoặc khoản tiền có sẵn một lần, cùng quỹ tiết kiệm khẩn cấp và các khoản nợ khác của họ.
- Mục tiêu hướng tới: tổng tiền lãi thấp nhất, sạch nợ trước một cột mốc thời gian nhất định, hay mức đóng hàng tháng nhẹ nhàng nhất.

### 2. Chạy kịch bản cơ sở (baseline)
```bash
python3 scripts/amortize.py --principal 300000 --rate 4.5 --years 30 --start 2026-12
python3 scripts/amortize.py --principal 18500 --rate 7.9 --months 48 --fee 400   # car loan with a fee: APR estimate
```
Kiểm tra xem số tiền thanh toán tính ra có khớp với bảng sao kê của bên cho vay trong phạm vi sai số vài xu (cents) hay không. Nếu không khớp, khoản vay có thể áp dụng quy tắc đếm ngày khác, đã cộng gộp phí vào dư nợ gốc, hoặc có kèm phí bảo hiểm trong khoản đóng hàng tháng: hãy hỏi lại người dùng, hoặc sử dụng tham số `--payment` với số tiền thực tế.

### 3. Chạy các kịch bản so sánh
```bash
python3 scripts/amortize.py --principal 300000 --rate 4.5 --years 30 --extra 200
python3 scripts/amortize.py --principal 300000 --rate 4.5 --years 30 --lump 12:10000 --lump 24:10000
python3 scripts/amortize.py --principal 300000 --rate 4.5 --years 30 --payment 2000 --yearly
python3 scripts/amortize.py --principal 300000 --rate 4.5 --years 20                # shorter term
python3 scripts/amortize.py ... --schedule plan.csv --json
```
So sánh từ 2 đến 4 phương án mà người dùng thực sự có khả năng chi trả. Đối với mỗi phương án, hãy ghi lại tổng chi hàng tháng, ngày tất toán, tổng tiền lãi phải trả, số tiền lãi tiết kiệm được và số tháng rút ngắn được. Nếu bạn không thể chạy script, hãy sử dụng các công thức trong `references/amortization-basics.md` và lưu ý rằng các con số là ước tính xấp xỉ.

### 4. Kiểm tra quyết định tài chính, không chỉ nhìn vào phép toán
Đối chiếu lần lượt theo `references/prepayment-decision-guide.md`: ưu tiên quỹ dự phòng khẩn cấp trước, trả các khoản nợ có lãi suất cao hơn trước, kiểm tra phí phạt và hạn mức trả nợ trước hạn, lưu ý các tác động về thuế cần kiểm tra theo quy định địa phương, và so sánh với tỷ suất sinh lời sau thuế của phương án thay thế (gửi tiết kiệm hoặc đầu tư). Không bao giờ trình bày như thể việc trả nợ trước hạn lúc nào cũng là lựa chọn đúng đắn tuyệt đối.

### 5. Bàn giao kết quả
Điền vào mẫu `templates/loan-plan.md`: tóm tắt khoản vay trong một dòng, kịch bản cơ sở, bảng so sánh các kịch bản, khuyến nghị kèm theo lý do, những câu hỏi cần trao đổi với bên cho vay và các bước tiếp theo. Tuân theo phong cách trình bày của `examples/example-mortgage-overpayment.md`.

## Quy tắc
- Hiển thị mọi con số kèm theo đơn vị tiền tệ và làm tròn số tiền đến hàng xu (cents) hoặc đơn vị lẻ tương ứng; gắn nhãn rõ ràng các con số ước tính là ước tính.
- Công cụ tính toán giả định lãi suất cố định, thanh toán định kỳ hàng tháng và các khoản trả thêm được trừ thẳng vào dư nợ gốc ngay lập tức trong khi vẫn giữ nguyên mức đóng hàng tháng định kỳ (nhờ đó rút ngắn kỳ hạn vay). Hãy nêu rõ giả định này, đồng thời lưu ý trường hợp lãi suất thả nổi hoặc trường hợp bên cho vay chọn cách tính lại mức đóng hàng tháng thấp hơn thay vì rút ngắn kỳ hạn.
- Không đưa ra lời khuyên đầu tư cá nhân hoặc tư vấn thuế; hãy giải thích sự đánh đổi và hướng dẫn người dùng những điểm cần kiểm tra lại với bên cho vay hoặc cố vấn tài chính được cấp phép.
- Nếu một khoản thanh toán hàng tháng thậm chí không đủ để bù đắp phần tiền lãi phát sinh, hãy cảnh báo thật rõ ràng và dừng lại: dư nợ sẽ ngày càng phình to thêm.
- Giữ cho phần giải thích ngắn gọn và cụ thể: "cứ mỗi 100 trả thêm sẽ giúp tiết kiệm khoảng 120 tiền lãi" hiệu quả hơn nhiều so với cả một đoạn văn lý thuyết dài dòng.
FILE:references/amortization-basics.md
# Kiến thức cơ bản về khấu hao khoản vay (Amortization)

## Cách một khoản vay lãi suất cố định được trả dần cho đến hết

Mỗi tháng, bên cho vay tính lãi dựa trên số dư nợ gốc hiện còn lại. Khoản tiền bạn đóng hàng tháng trước tiên sẽ dùng để trả phần lãi đó; phần tiền còn dư lại mới được trừ vào số dư nợ (tiền gốc). Vì số dư nợ giảm dần, nên phần tiền lãi phải trả sẽ thu nhỏ lại qua từng tháng và phần trả nợ gốc sẽ tăng dần lên, trong khi tổng số tiền đóng mỗi tháng vẫn giữ nguyên không đổi. Những kỳ thanh toán đầu tiên chủ yếu là trả lãi; những kỳ thanh toán về cuối chủ yếu là trả gốc.

## Các công thức tính toán

- Lãi suất hàng tháng: r = lãi suất năm / 12 (ví dụ: 4.5% -> 0.00375).
- Số tiền thanh toán mỗi tháng cho khoản vay P trong n tháng: M = P * r / (1 - (1 + r)^-n). Với r = 0: M = P / n.
- Tiền lãi trong tháng này: dư nợ hiện tại * r. Tiền gốc trả được trong tháng này: M - tiền lãi.
- Tổng tiền lãi phải trả: tổng của tất cả các phần tiền lãi hàng tháng, hoặc xấp xỉ bằng M * n - P.
- Số tháng cần thiết để trả hết nợ với mức đóng hàng tháng M: n = -ln(1 - P * r / M) / ln(1 + r). Nếu P * r >= M thì khoản vay sẽ không bao giờ trả hết được.

Kiểm tra nhanh: Vay 200,000 ở mức lãi suất 6% trong 30 năm -> đóng 1,199.10 mỗi tháng. Vay 300,000 ở mức lãi suất 4.5% trong 30 năm -> đóng 1,520.06 mỗi tháng.

## Tại sao việc trả thêm tiền lại giúp tiết kiệm nhiều đến vậy

Một khoản trả thêm sẽ làm giảm ngay lập tức số dư nợ gốc, nhờ đó mọi tháng tiếp theo sau đó đều chỉ tính lãi trên một số dư nhỏ hơn. Số tiền tiết kiệm được xấp xỉ bằng số tiền trả thêm nhân với mức lãi suất mà khoản tiền đó lẽ ra sẽ phải gánh chịu trong suốt quãng thời gian còn lại của khoản vay. Đó là lý do tại sao số tiền trả thêm ở giai đoạn đầu của khoản vay lại giúp tiết kiệm được nhiều tiền lãi hơn hẳn so với cùng số tiền đó nhưng trả vào giai đoạn cuối.

## Các thuật ngữ mọi người thường nhầm lẫn

| Thuật ngữ | Ý nghĩa |
|---|---|
| Lãi suất danh nghĩa (Nominal rate) | Mức lãi suất hàng năm ghi trong hợp đồng, được dùng để chia ra tính lãi hàng tháng. |
| Lãi suất thực tế hàng năm (APR) | Mức lãi suất phần trăm hàng năm đã bao gồm cả các khoản phí; dùng để so sánh các gói vay với nhau. Một khoản vay có lãi suất danh nghĩa thấp hơn nhưng phí cao thì có thể có APR cao hơn. |
| Kỳ hạn vay (Term) | Khoảng thời gian vay theo kế hoạch ban đầu (ví dụ: 30 năm). |
| Ngày tất toán (Payoff date) | Thời điểm số dư nợ thực sự về bằng 0; sẽ đến sớm hơn nếu có các khoản trả thêm. |
| Rút ngắn kỳ hạn so với giảm số tiền đóng hàng tháng (Reduce term vs reduce payment) | Sau khi bạn trả dư thêm một khoản tiền, một số ngân hàng giữ nguyên mức đóng hàng tháng và rút ngắn kỳ hạn vay (giúp tiết kiệm nhiều tiền lãi hơn), trong khi một số khác lại giữ nguyên kỳ hạn và tính lại mức đóng hàng tháng thấp xuống. Hãy hỏi rõ ngân hàng xem họ áp dụng cách nào. |
| Dư nợ gốc (Principal) | Số tiền gốc hiện vẫn còn nợ, không tính phần lãi sẽ phát sinh trong tương lai. |
| Lịch biểu trả nợ / khấu hao (Amortization schedule) | Bảng chi tiết từng tháng thể hiện số tiền đóng, phần trả lãi, phần trả gốc và dư nợ còn lại. |

## Làm tròn số và những chênh lệch nhỏ

Các tổ chức cho vay thường làm tròn số tiền đến hàng xu (cents) vào mỗi tháng và có thể áp dụng cách tính lãi theo ngày thực tế (số ngày thực tế / 365) thay vì lấy lãi suất năm chia đều cho 12. Do đó, kết quả thực tế có thể chênh lệch vài xu mỗi tháng và vài đơn vị tiền tệ trong tổng số tiền lãi. Kỳ thanh toán cuối cùng thường sẽ điều chỉnh bù trừ toàn bộ phần chênh lệch do làm tròn này.

## Giới hạn của công cụ tính toán lãi suất cố định

- Lãi suất thả nổi hoặc lãi suất tham chiếu (tracker rates): hãy chạy các kịch bản ở mức lãi suất hiện tại và ở mức tăng thêm +1 và +2 điểm phần trăm.
- Giai đoạn chỉ trả lãi (interest-only), khoản thanh toán dồn cục cuối kỳ (balloon payments), thời gian ân hạn tạm dừng trả nợ (payment holidays): cần mô hình hóa riêng biệt hoặc tính thủ công.
- Phí bảo hiểm, tiền ký quỹ (escrow) hoặc phí quản lý tài khoản nằm gộp bên trong khoản đóng hàng tháng không phải là tiền lãi; hãy tách chúng ra trước khi thực hiện so sánh.
FILE:references/prepayment-decision-guide.md
# Tôi có nên trả hết khoản vay sớm hơn không? Hướng dẫn ra quyết định

Việc trả thêm tiền trước hạn cho một khoản vay mang lại một mức "sinh lời" đảm bảo, không rủi ro, đúng bằng mức lãi suất của khoản vay đó. Điều này rất tốt, nhưng không phải lúc nào cũng là cách sử dụng tối ưu nhất đối với khoản tiền nhàn rỗi. Hãy lần lượt xem xét qua các bước dưới đây theo đúng thứ tự.

## 1. An toàn là trên hết
- Quỹ dự phòng khẩn cấp: hãy giữ khoảng 3 đến 6 tháng chi phí sinh hoạt thiết yếu trong tài khoản tiết kiệm dễ rút trước khi tính đến chuyện trả thêm nợ trước hạn. Tiền một khi đã chuyển cho ngân hàng để trả nợ thì rất khó rút ngược trở lại khi cần gấp.
- Thu nhập ổn định: nếu sắp có sự thay đổi công việc, nghỉ thai sản hoặc một khoản chi tiêu lớn sắp tới, hãy ưu tiên tích lũy tiền mặt trước.

## 2. Trả khoản nợ đắt đỏ nhất trước
Xếp hạng các khoản nợ theo lãi suất (phương pháp thác đổ - avalanche method): thẻ tín dụng và thấu chi trước, sau đó đến vay tiêu dùng cá nhân và vay mua ô tô, cuối cùng là vay sinh viên và vay thế chấp mua nhà (mortgage). Trả vượt mức cho khoản nợ có lãi suất cao nhất trước tiên. Nếu vấn đề nằm ở việc duy trì động lực, việc tất toán khoản nợ có dư nợ nhỏ nhất trước (phương pháp quả cầu tuyết - snowball) vẫn có thể chấp nhận được, nhưng hãy nêu rõ chi phí chênh lệch phải trả thêm là bao nhiêu.

## 3. Đọc kỹ hợp đồng
- Phí phạt trả nợ trước hạn hoặc phí tất toán sớm (thường tính theo tỷ lệ phần trăm trên số tiền trả vượt mức, chủ yếu áp dụng trong thời gian ưu đãi lãi suất cố định).
- Hạn mức trả vượt miễn phí hàng năm (ví dụ: được trả trước tối đa 10% dư nợ mỗi năm mà không mất phí).
- Khoản tiền trả vượt mức sẽ làm giảm thời hạn vay hay giảm số tiền phải trả hàng tháng? Bạn có được quyền lựa chọn không?
- Số tiền trả vượt tối thiểu cho mỗi lần và cách thức thực hiện (trực tuyến, qua điện thoại, hoặc bằng văn bản yêu cầu).

## 4. So sánh với các phương án thay thế
- Khoản đóng góp quỹ hưu trí đối ứng từ công ty (employer retirement matching) thường có lợi hơn bất kỳ khoản trả nợ trước hạn nào: hãy nhận tối đa khoản đối ứng này trước.
- So sánh lãi suất khoản vay với mức sinh lời sau thuế và sau phí mà bạn có thể nhận được từ tiền gửi tiết kiệm. Khoản vay thế chấp lãi suất 2% so với tài khoản tiết kiệm lãi suất 4%: gửi tiết kiệm thắng về mặt toán học. Khoản vay mua ô tô lãi suất 7% so với tài khoản tiết kiệm lãi suất 3%: trả nợ trước hạn thắng.
- Đầu tư có thể vượt qua mức lãi suất vay thấp trong dài hạn nhưng đi kèm rủi ro; trong khi lợi ích tiết kiệm lãi từ việc trả nợ trước hạn là chắc chắn 100%.
- Thuế: ở một số quốc gia, tiền lãi vay thế chấp mua nhà được khấu trừ thuế thu nhập, làm giảm mức lãi suất thực tế. Hãy kiểm tra quy định tại địa phương; tuyệt đối không tự suy đoán.

## 5. Chọn chiến lược phù hợp
| Chiến lược | Phù hợp khi |
|---|---|
| Trả thêm một khoản cố định mỗi tháng | Thu nhập ổn định; tạo dựng thói quen; tiết kiệm được nhiều tiền lãi nhất trên cùng một tổng số tiền trả thêm nếu bắt đầu sớm. |
| Trả gộp từng khoản lớn (tiền thưởng, tiền hoàn thuế) | Thu nhập không đều theo tháng; giữ được sự linh hoạt về dòng tiền trong suốt năm. |
| Nâng mức thanh toán cố định hàng tháng cao hơn | Muốn ấn định một ngày thoát nợ rõ ràng. |
| Tái cấp vốn (refinance) sang kỳ hạn ngắn hơn | Có mức lãi suất mới thấp hơn và đủ khả năng chi trả khoản thanh toán hàng tháng cao hơn; cần so sánh kỹ các loại phí. |
| Giữ tiền mặt, trả nợ trước hạn sau | Giai đoạn lãi suất cố định sắp kết thúc (sau đó có thể trả trước mà không bị phạt), hoặc quỹ dự phòng khẩn cấp chưa đủ. |

## 6. Rà soát định kỳ
Tính toán lại các con số mỗi năm một lần, khi lãi suất thay đổi hoặc khi thu nhập thay đổi. Nhắc người dùng rằng các khoản trả thêm tự nguyện luôn có thể tạm dừng bất cứ lúc nào; còn mức thanh toán cố định theo hợp đồng mới thường không thể tự ý giảm xuống.
FILE:templates/loan-plan.md
# Kế hoạch khoản vay: loan_name

**Khoản vay:** balance ở mức lãi suất rate% (fixed_or_variable), còn lại remaining_term, thanh toán payment mỗi tháng, kỳ thanh toán đầu tiên trong kế hoạch này vào start_month
**Phí và quy định:** fees; hạn mức hoặc phí phạt trả nợ trước hạn: prepayment_rules
**Mục tiêu:** goal
**Ngân sách dành cho thanh toán thêm:** extra_budget

## Mốc cơ sở (Baseline)

- Khoản thanh toán hàng tháng:
- Tổng tiền lãi tính từ hiện tại:
- Ngày tất toán dự kiến:
- Cơ cấu kỳ thanh toán đầu tiên: tiền lãi ... / tiền gốc ...

## Các kịch bản so sánh

| Phương án | Chi trả hàng tháng | Ngày tất toán | Tổng tiền lãi | Tiền lãi tiết kiệm được | Số tháng rút ngắn |
|---|---|---|---|---|---|
| Mốc cơ sở (Baseline) | | | | - | - |
| A: | | | | | |
| B: | | | | | |
| C: | | | | | |

## Khuyến nghị

Phương án ... bởi vì:
1.
2.
3.

Những sự đánh đổi cần lưu ý:

## Danh sách kiểm tra trước khi trả nợ trước hạn

- [ ] Quỹ dự phòng khẩn cấp đủ trang trải ... tháng chi phí
- [ ] Không còn khoản nợ nào khác có lãi suất cao hơn (hoặc khoản nợ đó đã được ưu tiên trả trước)
- [ ] Đã kiểm tra phí phạt / hạn mức trả nợ trước hạn với bên cho vay
- [ ] Đã thiết lập khoản trả vượt để rút ngắn thời hạn vay (hoặc giảm số tiền trả hàng tháng, nếu muốn)

## Câu hỏi dành cho bên cho vay

1.
2.

## Các bước tiếp theo

1.
2.

*Giả định: lãi suất cố định, thanh toán hàng tháng, các khoản trả thêm được trừ trực tiếp vào dư nợ gốc ngay lập tức. Đây là các con số ước tính, không phải lời khuyên tài chính.*
FILE:examples/example-mortgage-overpayment.md
# Ví dụ: so sánh ba chiến lược trả nợ trước hạn khoản vay thế chấp mua nhà

## Yêu cầu của người dùng

"Chúng tôi còn dư nợ thế chấp mua nhà là 320,000 với lãi suất cố định 4.1% và thời hạn còn lại 25 năm, kỳ thanh toán đầu tiên của kế hoạch này là vào tháng 12 năm 2026. Chúng tôi có thể trả thêm khoảng 300 mỗi tháng, hoặc dùng khoản tiền thưởng 15,000 mỗi năm trong ba năm tới. Một người bạn khuyên chúng tôi nên chuyển hẳn sang mức trả 2,400 một tháng. Phương án nào là tốt nhất? Chúng tôi đã có quỹ tiết kiệm đủ cho 6 tháng chi phí sinh hoạt và không có khoản nợ nào khác. Ngân hàng cho phép trả vượt tối đa 10% dư nợ mỗi năm mà không mất phí."

## Câu lệnh chạy

```bash
python3 scripts/amortize.py --principal 320000 --rate 4.1 --years 25 --start 2026-12
python3 scripts/amortize.py --principal 320000 --rate 4.1 --years 25 --start 2026-12 --extra 300
python3 scripts/amortize.py --principal 320000 --rate 4.1 --years 25 --start 2026-12 --lump 12:15000 --lump 24:15000 --lump 36:15000
python3 scripts/amortize.py --principal 320000 --rate 4.1 --years 25 --start 2026-12 --payment 2400
```

Kết quả đầu ra (đã rút gọn):

```
Baseline: 1,706.80 per month, interest 192,038.38, total paid 512,038.38, paid off 2051-11 (300 payments)
Plan (+300.00/month): paid off 2046-02 (231 payments), interest 143,068.39
  Saves 48,969.99 interest and 69 months (5 y 9 m); every 100 of extra saves 70.97
Plan (lump sums 15,000.00 in payment 12, 15,000.00 in payment 24, 15,000.00 in payment 36): paid off 2046-11 (240 payments), interest 133,018.73
  Saves 59,019.65 interest and 60 months (5 y 0 m); every 100 of extra saves 131.15
Plan (fixed payment 2,400.00): paid off 2041-10 (179 payments), interest 107,805.37
  Saves 84,233.01 interest and 121 months (10 y 1 m)
```

## Kế hoạch khoản vay (bản mẫu đã điền, rút gọn)

**Khoản vay:** 320,000.00 ở mức lãi suất cố định 4.1%, còn lại 25 năm, thanh toán 1,706.80 mỗi tháng, kỳ thanh toán đầu tiên vào tháng 12 năm 2026
**Phí và quy định:** trả vượt mức tối đa 10% dư nợ mỗi năm được miễn phí
**Mục tiêu:** trả ít tiền lãi hơn mà không làm mất đi sự linh hoạt tài chính

| Phương án | Chi trả hàng tháng | Ngày tất toán | Tổng tiền lãi | Tiền lãi tiết kiệm được | Số tháng rút ngắn |
|---|---|---|---|---|---|
| Mốc cơ sở (Baseline) | 1,706.80 | 2051-11 | 192,038.38 | - | - |
| A: +300 mỗi tháng | 2,006.80 | 2046-02 | 143,068.39 | 48,969.99 | 69 |
| B: Thưởng 15,000 từ năm 1 đến năm 3 | 1,706.80 + tổng cộng 45,000 | 2046-11 | 133,018.73 | 59,019.65 | 60 |
| C: Cố định 2,400 mỗi tháng | 2,400.00 | 2041-10 | 107,805.37 | 84,233.01 | 121 |

**Khuyến nghị:** Chọn Phương án B, kết hợp thêm Phương án A nếu ngân sách cho phép. Các khoản tiền thưởng được đóng vào giai đoạn đầu của khoản vay, nên cứ mỗi 100 trả vượt sẽ tiết kiệm được khoảng 131 tiền lãi, cao gấp gần hai lần hiệu quả của kế hoạch trả thêm hàng tháng (khoảng 71 trên mỗi 100, vì phần lớn số tiền đó được trả rải rác vào những năm về sau). Phương án này không đòi hỏi thay đổi ngân sách chi tiêu hàng tháng, và mỗi khoản 15,000 đều nằm gọn trong hạn mức miễn phí 10% hàng năm (32,000 trong năm thứ nhất). Phương án C tiết kiệm được nhiều lãi nhất vì nó bơm thêm tổng cộng khoảng 124,000 trong suốt 15 năm, nhưng lại làm tăng mức chi cố định hàng tháng thêm 693; chỉ nên áp dụng nếu mức chi này hoàn toàn thoải mái với bạn, và hãy thiết lập nó dưới dạng khoản trả thêm tự nguyện định kỳ thay vì sửa mức thanh toán cứng trong hợp đồng để có thể tạm dừng khi cần.

**Sự đánh đổi:** số tiền đã trả vượt vào khoản vay thế chấp rất khó rút ra lại; hãy giữ nguyên quỹ dự phòng khẩn cấp 6 tháng không đụng tới. Nếu tài khoản tiết kiệm của bạn trả lãi cao hơn 4.1% sau thuế, việc gửi tiết kiệm có thể thắng việc trả nợ trước hạn về mặt tính toán; hãy kiểm tra mức lãi suất thực tế và các quy định thuế tại địa phương.

**Câu hỏi dành cho bên cho vay:**
1. Các khoản trả vượt mức sẽ làm rút ngắn thời hạn vay và giữ nguyên số tiền trả hàng tháng (như giả định ở trên), hay sẽ tính toán lại để giảm số tiền trả hàng tháng?
2. Hạn mức miễn phí 10% được làm mới theo năm dương lịch hay theo năm hợp đồng vay?

*Giả định: lãi suất cố định trong toàn bộ thời hạn, thanh toán hàng tháng, các khoản trả vượt được trừ trực tiếp vào dư nợ gốc ngay lập tức. Đây là số liệu ước tính, không phải lời khuyên tài chính.*
FILE:scripts/amortize.py
#!/usr/bin/env python3
"""Fixed-rate loan amortization with extra payments and scenario comparison.

Usage:
  python3 amortize.py --principal 250000 --rate 4.2 --years 30 [options]
  python3 amortize.py --principal 18000 --rate 7.9 --months 60 --extra 150

Options:
  --principal N      amount borrowed (required)
  --rate PCT         nominal annual interest rate in percent, e.g. 4.2 (required; 0 allowed)
  --years N | --months N   term (one of them is required)
  --start YYYY-MM    month of the first payment (default: next month)
  --extra N          extra amount added to every monthly payment
  --extra-from N     payment number where --extra starts (default 1)
  --lump N:AMOUNT    one-off extra payment in payment number N (repeatable)
  --payment N        pay this fixed monthly amount instead of the computed one
  --fee N            one-off upfront fees, used for the cost and APR estimate
  --schedule FILE    write the full monthly schedule as CSV
  --yearly           print a year-by-year table
  --json             print the result as JSON

Extra payments are assumed to reduce principal immediately with no prepayment
penalty and the same monthly payment (term shortens). Rates are nominal annual,
compounded monthly (rate / 12 per month). Money is rounded to cents each month.
Exit codes: 0 ok, 2 usage or input error. Python 3 standard library only.
"""
import argparse
import csv
import datetime as dt
import json
import sys


def monthly_payment(principal, annual_rate, n):
    r = annual_rate / 100 / 12
    if r == 0:
        return principal / n
    return principal * r / (1 - (1 + r) ** -n)


def add_months(ym, k):
    y, m = ym
    m0 = m - 1 + k
    return (y + m0 // 12, m0 % 12 + 1)


def schedule(principal, annual_rate, n, payment=None, extra=0.0, extra_from=1, lumps=None):
    r = annual_rate / 100 / 12
    base = round(payment if payment else monthly_payment(principal, annual_rate, n), 2)
    lumps = lumps or {}
    bal = round(principal, 2)
    rows = []
    k = 0
    while bal > 0.005:
        k += 1
        if k > 1200:
            raise ValueError("the loan is not paid off within 100 years; the payment is too small for the interest")
        interest = round(bal * r, 2)
        if base + (extra if k >= extra_from else 0) <= interest and not lumps.get(k):
            raise ValueError(f"payment {base:.2f} does not cover the monthly interest {interest:.2f}; the balance would grow")
        sched = min(base, bal + interest)
        if payment is None and k == n:
            sched = bal + interest  # last scheduled payment absorbs the rounding difference
        ext = min(extra if k >= extra_from else 0.0, max(bal + interest - sched, 0))
        lump = min(lumps.get(k, 0.0), max(bal + interest - sched - ext, 0))
        principal_paid = round(sched + ext + lump - interest, 2)
        bal = round(bal - principal_paid, 2)
        rows.append({"n": k, "payment": round(sched, 2), "extra": round(ext + lump, 2), "interest": interest,
                     "principal": principal_paid, "balance": max(bal, 0.0)})
    return base, rows


def summarize(rows):
    return {"months": len(rows), "total_interest": round(sum(x["interest"] for x in rows), 2),
            "total_paid": round(sum(x["payment"] + x["extra"] for x in rows), 2),
            "total_extra": round(sum(x["extra"] for x in rows), 2)}


def apr_estimate(principal, fee, payment, n):
    """Annual rate that makes the payments worth principal - fee (bisection)."""
    target = principal - fee
    lo, hi = 0.0, 1.0
    for _ in range(100):
        mid = (lo + hi) / 2
        r = mid / 12
        pv = payment * n if r == 0 else payment * (1 - (1 + r) ** -n) / r
        lo, hi = (mid, hi) if pv > target else (lo, mid)
    return round(lo * 100, 3)


def fmt_ym(ym):
    return f"{ym[0]:04d}-{ym[1]:02d}"


def main(argv):
    p = argparse.ArgumentParser(add_help=True, description="Loan amortization with extra payments")
    p.add_argument("--principal", type=float, required=True)
    p.add_argument("--rate", type=float, required=True)
    g = p.add_mutually_exclusive_group(required=True)
    g.add_argument("--years", type=float)
    g.add_argument("--months", type=int)
    p.add_argument("--start")
    p.add_argument("--extra", type=float, default=0.0)
    p.add_argument("--extra-from", type=int, default=1)
    p.add_argument("--lump", action="append", default=[])
    p.add_argument("--payment", type=float)
    p.add_argument("--fee", type=float, default=0.0)
    p.add_argument("--schedule")
    p.add_argument("--yearly", action="store_true")
    p.add_argument("--json", action="store_true")
    try:
        a = p.parse_args(argv)
    except SystemExit as e:
        return 0 if e.code == 0 else 2
    try:
        n = a.months if a.months else round(a.years * 12)
        if a.principal <= 0 or n <= 0 or a.rate < 0 or a.extra < 0 or a.fee < 0:
            raise ValueError("principal and term must be positive; rate, extra, and fee cannot be negative")
        if a.rate > 100:
            raise ValueError("rate is in percent per year, e.g. 4.2 for 4.2%")
        lumps = {}
        for item in a.lump:
            num, _, amt = item.partition(":")
            try:
                if not num.isdigit():
                    raise ValueError
                value = float(amt)
            except ValueError:
                raise ValueError(f"--lump must look like 24:5000 (payment number:amount), got {item!r}") from None
            lumps[int(num)] = lumps.get(int(num), 0.0) + value
        if a.start:
            try:
                y, m = a.start.split("-")
                start = (int(y), int(m))
            except ValueError:
                raise ValueError(f"--start must look like 2026-11, got {a.start!r}") from None
            if not 1 <= start[1] <= 12:
                raise ValueError("--start month must be 01 to 12")
        else:
            t = dt.date.today()
            start = add_months((t.year, t.month), 1)
        base_pay, base_rows = schedule(a.principal, a.rate, n, payment=None)
        scenario = bool(a.extra or lumps or a.payment)
        pay, rows = schedule(a.principal, a.rate, n, payment=a.payment, extra=a.extra,
                             extra_from=a.extra_from, lumps=lumps) if scenario else (base_pay, base_rows)
    except ValueError as e:
        print(f"error: {e}", file=sys.stderr)
        return 2

    base_sum, plan_sum = summarize(base_rows), summarize(rows)
    result = {
        "inputs": {"principal": a.principal, "annual_rate_pct": a.rate, "term_months": n, "first_payment": fmt_ym(start),
                   "extra_monthly": a.extra, "extra_from_payment": a.extra_from, "lumps": lumps, "fixed_payment": a.payment, "fees": a.fee},
        "baseline": {"monthly_payment": base_pay, **base_sum, "payoff": fmt_ym(add_months(start, base_sum["months"] - 1))},
    }
    if a.fee:
        result["baseline"]["apr_estimate_pct"] = apr_estimate(a.principal, a.fee, base_pay, n)
        result["baseline"]["total_cost_incl_fees"] = round(base_sum["total_interest"] + a.fee, 2)
    if scenario:
        result["plan"] = {"monthly_payment": pay, **plan_sum, "payoff": fmt_ym(add_months(start, plan_sum["months"] - 1)),
                          "months_saved": base_sum["months"] - plan_sum["months"],
                          "interest_saved": round(base_sum["total_interest"] - plan_sum["total_interest"], 2)}
        if plan_sum["total_extra"]:
            result["plan"]["interest_saved_per_100_extra"] = round(100 * result["plan"]["interest_saved"] / plan_sum["total_extra"], 2)
    yearly = []
    for i in range(0, len(rows), 12):
        chunk = rows[i:i + 12]
        yearly.append({"year": i // 12 + 1, "paid": round(sum(x["payment"] + x["extra"] for x in chunk), 2),
                       "interest": round(sum(x["interest"] for x in chunk), 2),
                       "principal": round(sum(x["principal"] for x in chunk), 2), "end_balance": chunk[-1]["balance"]})
    result["yearly"] = yearly
    first = base_rows[0]
    result["baseline"]["first_payment_split"] = {"interest": first["interest"], "principal": first["principal"]}

    if a.schedule:
        try:
            with open(a.schedule, "w", newline="", encoding="utf-8") as f:
                w = csv.writer(f)
                w.writerow(["n", "month", "payment", "extra", "interest", "principal", "balance"])
                for x in rows:
                    w.writerow([x["n"], fmt_ym(add_months(start, x["n"] - 1)), f"{x['payment']:.2f}", f"{x['extra']:.2f}",
                                f"{x['interest']:.2f}", f"{x['principal']:.2f}", f"{x['balance']:.2f}"])
        except OSError as e:
            print(f"error: cannot write schedule {a.schedule}: {e.strerror}", file=sys.stderr)
            return 2
    if a.json:
        print(json.dumps(result, indent=2))
        return 0
    b = result["baseline"]
    print(f"Loan {a.principal:,.2f} at {a.rate}% for {n} months, first payment {fmt_ym(start)}")
    print(f"Baseline: {b['monthly_payment']:,.2f} per month, interest {b['total_interest']:,.2f}, "
          f"total paid {b['total_paid']:,.2f}, paid off {b['payoff']} ({b['months']} payments)")
    if a.fee:
        print(f"  With fees {a.fee:,.2f}: total cost of borrowing {b['total_cost_incl_fees']:,.2f}, APR about {b['apr_estimate_pct']}%")
    print(f"  First payment: {first['interest']:,.2f} interest, {first['principal']:,.2f} principal")
    if scenario:
        pl = result["plan"]
        what = []
        if a.payment:
            what.append(f"fixed payment {a.payment:,.2f}")
        if a.extra:
            what.append(f"+{a.extra:,.2f}/month" + (f" from payment {a.extra_from}" if a.extra_from > 1 else ""))
        if lumps:
            what.append("lump sums " + ", ".join(f"{v:,.2f} in payment {k}" for k, v in sorted(lumps.items())))
        print(f"Plan ({'; '.join(what)}): paid off {pl['payoff']} ({pl['months']} payments), "
              f"interest {pl['total_interest']:,.2f}")
        ms = pl["months_saved"]
        if ms >= 0 and pl["interest_saved"] >= 0:
            print(f"  Saves {pl['interest_saved']:,.2f} interest and {ms} months ({ms // 12} y {ms % 12} m)"
                  + (f"; every 100 of extra saves {pl['interest_saved_per_100_extra']:,.2f}" if pl.get("interest_saved_per_100_extra") else ""))
        else:
            print(f"  WARNING: this plan costs {-pl['interest_saved']:,.2f} MORE interest and takes {-ms} months longer than the baseline")
    if a.yearly:
        print(f"\nYear-by-year ({'plan' if scenario else 'baseline'}):")
        print(f"{'Year':>4} {'Paid':>12} {'Interest':>12} {'Principal':>12} {'Balance':>12}")
        for y in yearly:
            print(f"{y['year']:>4} {y['paid']:>12,.2f} {y['interest']:>12,.2f} {y['principal']:>12,.2f} {y['end_balance']:>12,.2f}")
    if a.schedule:
        print(f"\nSchedule written to {a.schedule} ({len(rows)} rows)")
    return 0


if __name__ == "__main__":
    sys.exit(main(sys.argv[1:]))
Đánh giá Dockerfile về bảo mật, dung lượng image, bộ nhớ đệm bản dựng (build cache) và độ tin cậy khi chạy (runtime): bí mật (secrets) bị gắn cứng vào các lớp (layers), chạy dưới quyền root, base image chưa ghim phiên bản, lệnh curl truyền thẳng qua pipe vào shell, sử dụng sai lệnh ADD, bộ nhớ đệm apt và pip còn sót lại, cài đặt gói phụ thuộc làm hỏng cache, lệnh CMD dạng shell, và thiếu bản dựng đa giai đoạn (multi-stage builds) hoặc kiểm tra sức khỏe (health checks), sau đó viết lại một Dockerfile đã sửa lỗi và tệp .dockerignore. Sử dụng khi người dùng chia sẻ một Dockerfile và hỏi "hãy đánh giá Dockerfile của tôi", "tại sao image của tôi lại nặng như vậy?", hoặc "container này có an toàn không?".
---
name: dockerfile-best-practices-reviewer
description: Đánh giá Dockerfile về bảo mật, dung lượng image, bộ nhớ đệm bản dựng (build cache) và độ tin cậy khi chạy (runtime): bí mật (secrets) bị gắn cứng vào các lớp (layers), chạy dưới quyền root, base image chưa ghim phiên bản, lệnh curl truyền thẳng qua pipe vào shell, sử dụng sai lệnh ADD, bộ nhớ đệm apt và pip còn sót lại trong các lớp, cài đặt gói phụ thuộc làm hỏng cache, lệnh CMD dạng shell, và thiếu bản dựng đa giai đoạn (multi-stage builds) hoặc kiểm tra sức khỏe (health checks), sau đó viết lại một Dockerfile đã sửa lỗi và tệp .dockerignore. Sử dụng khi người dùng chia sẻ một Dockerfile và hỏi "hãy đánh giá Dockerfile của tôi", "tại sao image của tôi lại nặng như vậy?", "container này có an toàn không?", hoặc "tại sao mỗi lần build lại cài đặt lại các gói phụ thuộc?". Bao gồm một công cụ kiểm lỗi (linter) bằng thư viện chuẩn Python đã được kiểm thử.
---

# Trình Đánh giá Thực hành Tốt nhất cho Dockerfile

Bạn giúp các lập trình viên xuất xưởng những container image nhỏ gọn, xây dựng lại (rebuild) nhanh chóng và vận hành an toàn. Bạn đọc một Dockerfile theo cách của một kỹ sư nền tảng (platform engineer) cẩn trọng: bạn tìm ra những điểm làm rò rỉ thông tin bí mật hoặc trao quyền root, những gì khiến image bị phình to, và những gì buộc quá trình build lại diễn ra chậm chạp, đồng thời bạn trả về một Dockerfile đã được hiệu chỉnh mà vẫn build và chạy đúng ứng dụng đó.

## Các tệp trong kỹ năng này

- `scripts/lint_dockerfile.py` - phân tích cú pháp một Dockerfile (các dòng nối tiếp, bản dựng đa giai đoạn) và báo cáo các phát hiện ở mức HIGH, WARN và INFO kèm theo cách khắc phục cho từng vấn đề (chỉ dùng thư viện chuẩn Python 3)
- `references/dockerfile-rules.md` - mọi quy tắc mà linter kiểm tra, lý do tại sao nó quan trọng và mẫu chuẩn cần dùng
- `references/language-patterns.md` - các mẫu đa giai đoạn (multi-stage) đã được kiểm chứng cho Node.js, Python, Go và Java, cùng với một tệp .dockerignore khởi đầu
- `templates/dockerfile-review.md` - mẫu báo cáo đánh giá để trả về kết quả
- `examples/example-node-api-review.md` - một bài đánh giá mẫu hoàn chỉnh cho Dockerfile của một Node.js API

## Quy trình làm việc

### 1. Thu thập thông tin thực tế
Hỏi người dùng, hoặc đưa ra giả định và nêu rõ:
- Tệp Dockerfile, và tệp .dockerignore nếu có.
- Ngôn ngữ và framework, cách ứng dụng được build và khởi chạy, cùng cổng (port) lắng nghe.
- Môi trường chạy ứng dụng (Kubernetes, ECS, máy ảo chạy Docker Compose, máy tính cá nhân) và liệu nền tảng đó đã có cơ chế kiểm tra sức khỏe (health checks) hay chưa.
- Các ràng buộc: base image bắt buộc (registry của công ty, distroless, Alpine hay Debian), các thư viện phụ thuộc gốc (native dependencies), và liệu quá trình build có sử dụng BuildKit hay không.

### 2. Chạy công cụ kiểm lỗi (linter)
```bash
python3 scripts/lint_dockerfile.py Dockerfile
python3 scripts/lint_dockerfile.py services/*/Dockerfile --fail-on warn    # stricter, for CI
python3 scripts/lint_dockerfile.py - --json < Dockerfile
```
Công cụ linter là bước quét nhanh đầu tiên dựa trên các mẫu nhận diện (patterns), chứ không phải là một quá trình build thực sự. Hãy tự mình đọc kỹ toàn bộ Dockerfile: linter không thể biết liệu một gói phần mềm có thực sự cần thiết hay không, liệu một tệp được sao chép vào có chứa thông tin bí mật hay không, hoặc liệu ứng dụng có ghi dữ liệu vào một đường dẫn mà người dùng không phải root (non-root user) không thể truy cập hay không. Nếu bạn không thể chạy script, hãy áp dụng thủ công theo `references/dockerfile-rules.md`.

### 3. Sửa lỗi theo thứ tự này
1. Bảo mật (HIGH): loại bỏ các giá trị bí mật trực tiếp (literal secrets) khỏi ENV, ARG và RUN, thay vào đó hãy sử dụng cơ chế gắn kết bí mật (secret mounts) của BuildKit hoặc cấu hình lúc chạy (runtime); nhắc người dùng xoay vòng (rotate) bất kỳ khóa bí mật nào đã từng bị commit hoặc đẩy lên trong một image. Thêm chỉ thị USER không phải root. Thay thế cú pháp curl-pipe-shell và lệnh chmod 777.
2. Tính tái lập (Reproducibility): ghim (pin) các base image vào một thẻ phiên bản cụ thể (hoặc mã băm digest đối với các bản dựng đòi hỏi độ đảm bảo cao) và sử dụng cài đặt theo tệp khóa (npm ci, pip kèm tệp khóa requirements, go mod download).
3. Bộ nhớ đệm bản dựng (Build cache): sao chép các tệp khai báo phụ thuộc (manifests) trước, tiến hành cài đặt, rồi mới sao chép mã nguồn. Kết hợp lệnh cập nhật (update) và cài đặt (install) vào cùng một chỉ thị RUN.
4. Dung lượng (Size): sử dụng bản dựng đa giai đoạn (multi-stage build), chọn base image lúc chạy dạng slim hoặc distroless, không cài các gói khuyến nghị đi kèm (recommended packages), dọn dẹp bộ nhớ đệm trình quản lý gói trong cùng một lớp (layer), và dùng tệp .dockerignore tốt.
5. Lúc chạy (Runtime): dùng CMD hoặc ENTRYPOINT ở dạng thực thi (exec-form), mỗi container một tiến trình, thêm HEALTHCHECK nếu nền tảng không có bộ dò (probe) riêng, thiết lập WORKDIR và quyền sở hữu tệp hợp lý.
Chạy lại linter trên tệp đã sửa cho đến khi không còn phát hiện mức HIGH nào và mọi cảnh báo WARN đều đã được sửa hoặc giải thích rõ.

### 4. Bàn giao kết quả
Điền vào mẫu `templates/dockerfile-review.md`: tóm tắt, bảng phát hiện lỗi, Dockerfile đã sửa kèm chú thích ngắn gọn, tệp .dockerignore, hướng dẫn cách build và kiểm thử, cùng ước tính tác động về dung lượng và thời gian build lại. Sử dụng các mẫu từ `references/language-patterns.md` và tuân theo phong cách trình bày của `examples/example-node-api-review.md`.

## Quy tắc
- Giữ nguyên hành vi của ứng dụng: cùng lệnh khởi chạy, cổng, biến môi trường và các tệp lúc chạy, trừ khi người dùng đồng ý thay đổi chúng.
- Không bao giờ in ra hoặc lặp lại một giá trị bí mật thực sự tìm thấy trong tệp; chỉ đề cập đến nó bằng tên biến và nhắc người dùng xoay vòng (rotate) khóa bí mật đó.
- Không tuyên bố dung lượng image chính xác tuyệt đối khi chưa thực hiện build thực tế; hãy đưa ra các khoảng ước tính và hướng dẫn cách đo lường (`docker image ls`, `docker history`).
- Ưu tiên các base image chính thức, được duy trì đều đặn; nêu rõ sự đánh đổi giữa Alpine (musl) so với Debian slim và distroless đối với ngôn ngữ lập trình của người dùng.
- Giải thích mỗi thay đổi trong một dòng để người dùng nắm được quy tắc cốt lõi chứ không chỉ thấy phần sửa lỗi.
FILE:references/dockerfile-rules.md
# Các quy tắc Dockerfile được kiểm tra bởi linter

Mỗi quy tắc bao gồm: dấu hiệu được phát hiện, lý do tại sao nó quan trọng và mẫu chuẩn cần sử dụng thay thế.

## HIGH (bảo mật)

### secret-in-env / secret-in-run
Phát hiện: ENV hoặc ARG có tên như PASSWORD, SECRET, TOKEN, API_KEY, ACCESS_KEY, PRIVATE_KEY, CREDENTIALS đi kèm giá trị trực tiếp; tham số `--password=...` hoặc URL dạng `user:pass@` trong chỉ thị RUN; tên biến ARG trông giống như thông tin bí mật (WARN).
Lý do: mọi giá trị ENV và tham số build (build arg) đều được lưu trong cấu hình và lịch sử của image (`docker history --no-trunc`). Bất kỳ ai có thể kéo (pull) image về đều có thể đọc được nó. Việc xóa nó ở một lớp (layer) sau đó không làm nó biến mất khỏi lịch sử.
Sử dụng thay thế:
```dockerfile
# syntax=docker/dockerfile:1
RUN --mount=type=secret,id=npm_token \
    NPM_TOKEN="$(cat /run/secrets/npm_token)" npm ci
```
Build bằng lệnh `docker build --secret id=npm_token,src=$HOME/.npm_token .`. Truyền các bí mật lúc chạy (runtime secrets) dưới dạng biến môi trường từ nền tảng vận hành hoặc trình quản lý bí mật (secrets manager). Xoay vòng bất kỳ bí mật nào đã từng nằm trong một image.

### root-user
Phát hiện: không có chỉ thị USER trong giai đoạn (stage) cuối cùng, hoặc đặt USER root / 0.
Lý do: một tiến trình thoát ra khỏi phạm vi ứng dụng dưới quyền root bên trong container sẽ có quyền lực lớn hơn rất nhiều đối với máy chủ (host) và các container khác.
Sử dụng thay thế: tạo một người dùng và chuyển đổi quyền trước chỉ thị CMD; nhiều image chính thức đã tích hợp sẵn một người dùng (`node`, `nobody`).
```dockerfile
RUN groupadd -r app && useradd -r -g app -u 10001 app
COPY --chown=app:app . /app
USER app
```

### curl-pipe-shell
Phát hiện: `curl ... | sh` hoặc `wget ... | bash`.
Lý do: thực thi bất cứ thứ gì máy chủ trả về mà không có bước kiểm tra tính toàn vẹn; một đoạn script bị xâm phạm hoặc bị thay đổi sẽ đi thẳng vào mọi bản dựng.
Sử dụng thay thế: tải xuống, xác minh mã kiểm tra (checksum), sau đó mới chạy.
```dockerfile
RUN curl -fsSLo /tmp/install.sh https://example.com/install.sh \
    && echo "<sha256>  /tmp/install.sh" | sha256sum -c - \
    && sh /tmp/install.sh && rm /tmp/install.sh
```

### chmod-777
Phát hiện: `chmod 777` hoặc `chmod -R 777`.
Lý do: bất kỳ người dùng hoặc tiến trình nào trong container đều có thể sửa đổi các tệp đó, bao gồm cả mã nguồn ứng dụng.
Sử dụng thay thế: dùng `COPY --chown=app:app` và `chmod 755` cho các tệp thực thi, `644` cho các tệp thông thường.

## WARN

| Quy tắc | Dấu hiệu phát hiện | Lý do | Cách khắc phục |
|---|---|---|---|
| unpinned-base | FROM không có thẻ (tag) hoặc dùng `:latest` | bản dựng thay đổi âm thầm; khó tái lập hoặc quay lui (roll back) | `FROM node:20.11-bookworm-slim` hoặc ghim mã băm digest `@sha256:...` |
| use-copy | Dùng ADD cho các tệp cục bộ hoặc URL | ADD tự động giải nén các tệp lưu trữ và tải xuống mà không kiểm tra checksum | Dùng COPY cho các tệp; dùng curl kèm kiểm tra checksum hoặc `ADD --checksum=` cho URL; ADD vẫn phù hợp đối với các tệp nén tar cục bộ mà bạn muốn tự động giải nén |
| update-alone | Chạy `apt-get update` (hoặc apk/yum) mà không kèm install trong cùng một lệnh RUN | lớp update đã lưu cache sẽ bị tái sử dụng cùng với một dòng install mới hơn về sau, khiến các gói được lấy từ chỉ mục (index) đã cũ | `RUN apt-get update && apt-get install -y ...` |
| cache-bust | Cài đặt gói phụ thuộc sau lệnh `COPY . .` | bất kỳ thay đổi mã nguồn nào cũng làm mất hiệu lực lớp cài đặt, khiến mọi lần build đều phải cài đặt lại toàn bộ | sao chép các tệp khai báo (manifests) trước, cài đặt, rồi mới sao chép mã nguồn |
| sudo | Dùng sudo trong RUN | không cần thiết (quá trình build vốn chạy dưới quyền root cho đến khi gặp chỉ thị USER), lại làm cài thêm tệp nhị phân setuid | chạy bước đó trước chỉ thị USER |
| ssh-port | EXPOSE 22 | các container không nên chạy dịch vụ nền SSH (SSH daemons) | dùng `docker exec`, `kubectl exec` |
| multiple-cmd | Có nhiều hơn một CMD hoặc ENTRYPOINT trong cùng một giai đoạn | chỉ có chỉ thị cuối cùng có hiệu lực; thường là do nhầm lẫn | chỉ giữ lại một chỉ thị |

## INFO

| Quy tắc | Cách khắc phục |
|---|---|
| apt-recommends | `apt-get install -y --no-install-recommends ...` |
| apt-lists | kết thúc cùng lệnh RUN đó bằng `&& rm -rf /var/lib/apt/lists/*` |
| apk-cache | `apk add --no-cache ...` |
| pip-cache | `pip install --no-cache-dir ...` hoặc dùng cơ chế gắn kết bộ nhớ đệm (cache mount) của BuildKit |
| npm-ci | `npm ci --omit=dev` sử dụng chính xác theo tệp khóa (lockfile) |
| shell-form | `CMD ["node", "server.js"]` để ứng dụng chạy dưới dạng PID 1 và nhận được tín hiệu SIGTERM giúp tắt ứng dụng an toàn (graceful shutdown) |
| cd-in-run | `WORKDIR /app` |
| no-healthcheck | `HEALTHCHECK CMD curl -fsS http://localhost:3000/health || exit 1` nếu nền tảng không có bộ dò (probe); Kubernetes bỏ qua HEALTHCHECK và sử dụng cơ chế probe riêng của nó |
| single-stage | thực hiện build trong một giai đoạn builder; chỉ sao chép kết quả đầu ra sang một giai đoạn runtime gọn nhẹ (slim) |
| many-layers | gộp các bước RUN có liên quan lại với nhau; tạo ít lớp (layers) hơn nhưng có mục đích rõ ràng |
| dockerignore | loại trừ `.git`, `node_modules`, `.env*`, thư mục đầu ra bản dựng, nhật ký (logs) và các tệp bí mật cục bộ |

## Những gì linter không thể nhìn thấy
- Liệu các tệp được sao chép vào có chứa thông tin bí mật hay không (hãy kiểm tra `.dockerignore` và kho mã nguồn).
- Các gói phần mềm tồn tại lỗ hổng bảo mật trong base image hoặc thư viện phụ thuộc: hãy đề xuất tích hợp công cụ quét image vào quy trình CI.
- Liệu người dùng không phải root (non-root user) có quyền ghi tại các thư mục mà ứng dụng cần ghi dữ liệu hay không (logs, uploads, caches).
- Các vấn đề về kiến trúc phần cứng (arm64 so với amd64), các mô-đun gốc (native modules) và khả năng tương thích với thư viện musl của Alpine.
FILE:references/language-patterns.md
# Các mẫu đa giai đoạn (Multi-stage) theo ngôn ngữ lập trình

Điều chỉnh phiên bản cho phù hợp với dự án. Tất cả các ví dụ đều chạy dưới quyền người dùng không phải root, sử dụng CMD ở dạng thực thi (exec-form) và loại bỏ các công cụ build khỏi image lúc chạy (runtime image).

## Node.js (npm)
```dockerfile
# syntax=docker/dockerfile:1
FROM node:20.11-bookworm-slim AS deps
WORKDIR /app
COPY package.json package-lock.json ./
RUN npm ci --omit=dev

FROM node:20.11-bookworm-slim AS build
WORKDIR /app
COPY package.json package-lock.json ./
RUN npm ci
COPY . .
RUN npm run build

FROM node:20.11-bookworm-slim
ENV NODE_ENV=production
WORKDIR /app
COPY --from=deps /app/node_modules ./node_modules
COPY --from=build --chown=node:node /app/dist ./dist
USER node
EXPOSE 3000
CMD ["node", "dist/server.js"]
```
Bỏ qua giai đoạn build nếu không có bước biên dịch. Chỉ sử dụng `node:<version>-alpine` nếu các mô-đun gốc (native modules) hoạt động tốt với musl.

## Python (pip)
```dockerfile
FROM python:3.12-slim AS build
WORKDIR /app
RUN python -m venv /venv
ENV PATH="/venv/bin:$PATH"
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

FROM python:3.12-slim
ENV PATH="/venv/bin:$PATH" PYTHONDONTWRITEBYTECODE=1 PYTHONUNBUFFERED=1
WORKDIR /app
COPY --from=build /venv /venv
RUN useradd -r -u 10001 app
COPY --chown=app:app . .
USER app
EXPOSE 8000
CMD ["gunicorn", "-b", "0.0.0.0:8000", "app:app"]
```
Nếu các gói thư viện cần trình biên dịch (như psycopg2, numpy biên dịch từ mã nguồn), chỉ cài đặt `build-essential` trong giai đoạn build.

## Go
```dockerfile
FROM golang:1.22 AS build
WORKDIR /src
COPY go.mod go.sum ./
RUN go mod download
COPY . .
RUN CGO_ENABLED=0 go build -trimpath -ldflags="-s -w" -o /out/app ./cmd/app

FROM gcr.io/distroless/static-debian12:nonroot
COPY --from=build /out/app /app
USER nonroot
ENTRYPOINT ["/app"]
```
Một tệp thực thi nhị phân Go tĩnh chạy trên nền distroless hoặc scratch sẽ tạo ra các image chỉ nặng từ vài MB đến vài chục MB.

## Java (Maven)
```dockerfile
FROM maven:3.9-eclipse-temurin-21 AS build
WORKDIR /src
COPY pom.xml .
RUN mvn -q dependency:go-offline
COPY src ./src
RUN mvn -q package -DskipTests

FROM eclipse-temurin:21-jre
RUN useradd -r -u 10001 app
WORKDIR /app
COPY --from=build --chown=app:app /src/target/app.jar app.jar
USER app
EXPOSE 8080
ENTRYPOINT ["java", "-XX:MaxRAMPercentage=75", "-jar", "app.jar"]
```

## Tệp .dockerignore khởi đầu
```
.git
.gitignore
.dockerignore
Dockerfile*
node_modules
dist
build
target
__pycache__
*.pyc
.venv
.env
.env.*
*.log
coverage
.idea
.vscode
secrets/
*.pem
*.key
```

## Đo lường kết quả
- Chạy `docker build -t app:review .` sau đó dùng `docker image ls app:review` để kiểm tra dung lượng.
- Dùng `docker history app:review` để xem những lớp (layers) nào đang chiếm nhiều dung lượng.
- Thay đổi một tệp mã nguồn và thực hiện build lại: bước cài đặt gói phụ thuộc phải hiển thị trạng thái CACHED.
FILE:templates/dockerfile-review.md
# Đánh giá Dockerfile: service_name

**Ứng dụng:** language_and_framework, khởi chạy bằng lệnh start_command, cổng port
**Chạy trên nền tảng:** platform
**Kết quả Linter:** HIGH high / WARN warn / INFO info trước khi sửa; HIGH 0 / WARN warn_after / INFO info_after sau khi sửa

## Tóm tắt

Hai hoặc ba câu: vấn đề bảo mật lớn nhất, vấn đề lớn nhất về dung lượng hoặc tốc độ, và mức độ cải thiện dự kiến.

## Các phát hiện chi tiết

| # | Mức độ | Dòng | Vấn đề | Cách khắc phục |
|---|---|---|---|---|
| 1 | HIGH | | | |

## Hành động cần thực hiện bên ngoài Dockerfile

- Xoay vòng (Rotate): (tên của bất kỳ khóa bí mật nào đã từng nằm trong tệp hoặc image, tuyệt đối không nêu giá trị của chúng)
- Nền tảng vận hành: các bộ dò kiểm tra sức khỏe (health probes), hệ thống tệp chỉ đọc (read-only filesystem), giới hạn tài nguyên (resource limits)

## Dockerfile đã hiệu chỉnh

```dockerfile
(full corrected Dockerfile with one-line comments on changed parts)
```

## .dockerignore

```
(các mục loại trừ)
```

## Build và xác minh

```bash
docker build -t image:review .
docker run --rm -p port:port image:review
docker image ls image:review
python3 scripts/lint_dockerfile.py Dockerfile
```

## Tác động dự kiến (ước tính)

- Dung lượng image: giảm từ khoảng ... xuống còn khoảng ...
- Build lại sau khi thay đổi mã nguồn: lớp cài đặt gói phụ thuộc được lấy từ bộ nhớ đệm (cached)
- Bảo mật: chạy dưới quyền non-root, không lưu bí mật trong các lớp, đã ghim phiên bản base image
FILE:examples/example-node-api-review.md
# Ví dụ: Đánh giá Dockerfile của một Node.js API

## Yêu cầu của người dùng

"Image của dịch vụ orders API bên mình nặng tới 1.2 GB và mỗi lần build lại đều cài đặt lại toàn bộ các gói npm, ngay cả khi mình chỉ sửa một dòng code. Bạn có thể đánh giá giúp mình tệp Dockerfile này được không? Dịch vụ chạy trên Kubernetes, ứng dụng Express, lệnh chạy `node server.js`, cổng 3000. Theo mình biết thì không dùng mô-đun gốc (native modules) nào."

## Dockerfile đầu vào

```dockerfile
FROM node
ENV NODE_ENV=production
ENV DB_PASSWORD=supersecret123
RUN apt-get update
RUN apt-get install -y curl git build-essential
WORKDIR /app
COPY . .
RUN npm install
RUN curl -fsSL https://example.com/install-agent.sh | bash
RUN chmod -R 777 /app
ADD config.json /app/config.json
EXPOSE 3000 22
CMD node server.js
```

## Kết quả chạy Linter

```
$ python3 scripts/lint_dockerfile.py Dockerfile
Dockerfile: 1 stage(s): node
  HIGH 4  WARN 5  INFO 7
  HIGH line 1   root-user       the final image runs as root
  HIGH line 3   secret-in-env   ENV DB_PASSWORD contains a literal secret; it is stored in the image layers and history
  HIGH line 9   curl-pipe-shell downloads a script and pipes it straight into a shell
  HIGH line 10  chmod-777       chmod 777 makes files writable by every user
  WARN line 1   unpinned-base   base image 'node' has no tag, so it means :latest and changes without notice
  WARN line 4   update-alone    'apt-get update' runs in its own layer; a later install may use a stale cached index
  WARN line 8   cache-bust      dependencies are installed after 'COPY . .' (line 7), so any source change reinstalls them
  WARN line 11  use-copy        ADD is used for local files; it also auto-extracts archives and fetches URLs
  WARN line 12  ssh-port        port 22 (SSH) is exposed; containers should not run an SSH server
  INFO line 1   no-healthcheck  no HEALTHCHECK in the final stage
  INFO line 1   single-stage    build tools are installed in the only stage, so they ship in the final image
  INFO line 5   apt-recommends  apt installs recommended packages too
  INFO line 5   apt-lists       apt package lists are left in the layer (tens of MB)
  INFO line 7   dockerignore    COPY of the whole build context
  INFO line 8   npm-ci          npm install can change the lockfile and versions
  INFO line 13  shell-form      shell-form CMD runs under /bin/sh -c, so the app is not PID 1 and may miss SIGTERM
```

## Báo cáo đánh giá (đã điền vào mẫu, rút gọn)

**Kết quả Linter:** HIGH 4 / WARN 5 / INFO 7 trước khi sửa; HIGH 0 / WARN 0 / INFO 0 sau khi sửa

**Tóm tắt:** Image này đang chứa sẵn mật khẩu cơ sở dữ liệu trong các lớp của nó, chạy dưới quyền root, và truyền thẳng một script tải từ xa vào bash để thực thi. Image bị phình to vì sử dụng bản `node` đầy đủ kèm theo các trình biên dịch và git, đồng thời build chậm vì lệnh `COPY . .` nằm trước `npm install`. Bản Dockerfile hai giai đoạn (two-stage) đã sửa sẽ loại bỏ thông tin bí mật, chạy dưới tài khoản người dùng `node` có sẵn, và lưu cache cho các gói phụ thuộc; dung lượng dự kiến sẽ giảm xuống còn khoảng 200 đến 300 MB thay vì 1.2 GB (đo thực tế bằng lệnh `docker image ls`).

| # | Mức độ | Dòng | Vấn đề | Cách khắc phục |
|---|---|---|---|---|
| 1 | HIGH | 3 | Giá trị DB_PASSWORD trực tiếp trong ENV, hiển thị rõ trong `docker history` | đã xóa; truyền vào từ Kubernetes Secret lúc chạy (runtime) |
| 2 | HIGH | - | chạy dưới quyền root | dùng `USER node` (có sẵn trong image chính thức) |
| 3 | HIGH | 9 | script cài đặt từ xa được truyền thẳng qua pipe vào bash | đã xóa: hiện tại agent được chuyển sang chạy như một Kubernetes sidecar; nếu bắt buộc phải giữ lại, hãy tải xuống, xác minh checksum rồi mới chạy |
| 4 | HIGH | 10 | chmod -R 777 /app | thay bằng `COPY --chown=node:node` |
| 5 | WARN | 1 | base image `node` không gắn thẻ phiên bản | đổi thành `node:20.11-bookworm-slim` |
| 6 | WARN | 4 | lệnh apt-get update nằm ở một lớp riêng biệt | gộp chung với lệnh install và dọn dẹp danh sách gói |
| 7 | WARN | 8 | chạy npm install sau lệnh `COPY . .` | sao chép các tệp khai báo (manifests) trước, chạy `npm ci --omit=dev` trong một giai đoạn deps riêng |
| 8 | WARN | 11 | dùng ADD cho một tệp cục bộ | đổi sang COPY |
| 9 | WARN | 12 | EXPOSE 22 | đã xóa; sử dụng `kubectl exec` khi cần |
| 10 | INFO | 5, 13 | chứa công cụ build và git trong image lúc chạy, lệnh CMD ở dạng shell | đã loại bỏ (vì không có mô-đun gốc), chuyển CMD sang dạng thực thi (exec-form) |

**Hành động cần thực hiện bên ngoài Dockerfile:** xoay vòng (đổi mới) mật khẩu DB_PASSWORD ngay lập tức (vì nó đã nằm trong mọi image được đẩy lên từ trước đến nay), và gắn nó vào Deployment từ một Kubernetes Secret. Kubernetes bỏ qua chỉ thị HEALTHCHECK trong Dockerfile, vì vậy hãy cấu hình thêm readiness probe và liveness probe trỏ vào đường dẫn `/health`; chỉ thị HEALTHCHECK bên dưới vẫn hữu ích khi chạy Docker và Compose ở môi trường cục bộ.

## Dockerfile đã hiệu chỉnh

```dockerfile
# syntax=docker/dockerfile:1
FROM node:20.11-bookworm-slim AS deps
WORKDIR /app
COPY package.json package-lock.json ./
RUN npm ci --omit=dev

FROM node:20.11-bookworm-slim
ENV NODE_ENV=production
WORKDIR /app
RUN apt-get update \
    && apt-get install -y --no-install-recommends curl \
    && rm -rf /var/lib/apt/lists/*
COPY --from=deps /app/node_modules ./node_modules
COPY --chown=node:node src/ ./src/
COPY --chown=node:node config.json ./
USER node
EXPOSE 3000
HEALTHCHECK --interval=30s --timeout=3s CMD curl -fsS http://localhost:3000/health || exit 1
CMD ["node", "src/server.js"]
```

## .dockerignore

```
.git
node_modules
.env
.env.*
*.log
coverage
Dockerfile*
```

## Xác minh

```
$ python3 scripts/lint_dockerfile.py Dockerfile
Dockerfile: 2 stage(s): node:20.11-bookworm-slim AS deps, node:20.11-bookworm-slim
  HIGH 0  WARN 0  INFO 0
  no problems found
```

Lưu ý: mã nguồn hiện nằm trong thư mục `src/`, vì vậy lệnh khởi chạy đã đổi thành `node src/server.js`; nếu tệp khởi점 (entry file) của bạn nằm ở vị trí khác, hãy giữ nguyên đường dẫn ban đầu của bạn. Nếu phát sinh một thư viện phụ thuộc thực sự cần đến trình biên dịch, chỉ cài đặt `build-essential` và `python3` trong giai đoạn `deps`.
FILE:scripts/lint_dockerfile.py
#!/usr/bin/env python3
"""Review a Dockerfile for security, image size, build cache, and reliability problems.

Usage:
  python3 lint_dockerfile.py Dockerfile [more Dockerfiles] [--json] [--fail-on high|warn|info]
  python3 lint_dockerfile.py - < Dockerfile

Checks (rule ids in brackets):
  HIGH  secrets in ENV/ARG or in RUN (secret-in-env, secret-in-run), final stage runs as root
        (root-user), pipe from curl/wget to a shell (curl-pipe-shell), chmod 777 (chmod-777)
  WARN  untagged or :latest base image (unpinned-base), ADD for local files or URLs (use-copy),
        apt/apk/yum update without install in the same RUN (update-alone), COPY of the whole
        context before installing dependencies (cache-bust), sudo (sudo), EXPOSE 22 (ssh-port),
        more than one CMD or ENTRYPOINT in a stage (multiple-cmd)
  INFO  apt-get without --no-install-recommends or without cleaning lists, pip without
        --no-cache-dir, npm install instead of npm ci, shell-form CMD/ENTRYPOINT, cd in RUN
        instead of WORKDIR, no HEALTHCHECK, single-stage build with build tools, many RUN layers,
        COPY of the whole context (check .dockerignore)
Exit codes: 0 ok, 1 findings at or above --fail-on (default high), 2 usage or read error.
Python 3 standard library only.
"""
import json
import re
import shlex
import sys

LEVELS = {"info": 0, "warn": 1, "high": 2}
SECRET_KEY = re.compile(r"(PASSWORD|PASSWD|SECRET|TOKEN|API_?KEY|ACCESS_?KEY|PRIVATE_?KEY|CREDENTIALS?)", re.I)
BUILD_TOOLS = re.compile(r"\b(build-essential|gcc|g\+\+|make|cmake|maven|gradle|golang|rustc|cargo|npm run build|go build|mvn )", re.I)


def logical_lines(text):
    """Join continuation lines; return list of (line_no, instruction, args). Skips comments and parser directives."""
    out, buf, start = [], "", None
    escape = "\\"
    for i, raw in enumerate(text.replace("\r\n", "\n").split("\n"), 1):
        m = re.match(r"^#\s*escape\s*=\s*(\S)", raw)
        if m and not out and not buf:
            escape = m.group(1)
            continue
        s = raw.strip()
        if not buf and (not s or s.startswith("#")):
            continue
        if buf and s.startswith("#"):
            continue
        if start is None:
            start = i
        if s.endswith(escape):
            buf += s[:-1] + " "
            continue
        buf += s
        parts = buf.split(None, 1)
        out.append((start, parts[0].upper(), parts[1] if len(parts) > 1 else ""))
        buf, start = "", None
    if buf:
        parts = buf.split(None, 1)
        out.append((start, parts[0].upper(), parts[1] if len(parts) > 1 else ""))
    return out


def review(text):
    lines = logical_lines(text)
    findings = []

    def add(level, rule, line, msg, fix):
        findings.append({"level": level, "rule": rule, "line": line, "message": msg, "fix": fix})

    if not any(ins == "FROM" for _, ins, _ in lines):
        raise ValueError("no FROM instruction found (is this a Dockerfile?)")
    stages, cur = [], None
    for ln, ins, args in lines:
        if ins == "FROM":
            m = re.match(r"(?:--platform=\S+\s+)?(\S+)(?:\s+AS\s+(\S+))?", args, re.I)
            cur = {"line": ln, "image": m.group(1) if m else args, "name": m.group(2) if m else None, "ins": []}
            stages.append(cur)
        elif cur is not None:
            cur["ins"].append((ln, ins, args))
    names = {s["name"].lower() for s in stages if s["name"]}
    arg_names = {a.split("=")[0].strip() for _, i, a in lines if i == "ARG"}

    for s in stages:
        img = s["image"]
        if img.lower() in names or img == "scratch" or img.startswith("$"):
            pass
        elif "@sha256:" in img:
            pass
        elif ":" not in img.split("/")[-1]:
            add("warn", "unpinned-base", s["line"], f"base image '{img}' has no tag, so it means :latest and changes without notice",
                f"pin a version, e.g. {img}:<version>-slim, or a digest")
        elif img.endswith(":latest"):
            add("warn", "unpinned-base", s["line"], f"base image '{img}' uses :latest", "pin a specific version tag or digest")

    final = stages[-1]
    run_count = 0
    for idx, s in enumerate(stages):
        cmds = [x for x in s["ins"] if x[1] in ("CMD", "ENTRYPOINT")]
        for kind in ("CMD", "ENTRYPOINT"):
            k = [x for x in cmds if x[1] == kind]
            if len(k) > 1:
                add("warn", "multiple-cmd", k[-1][0], f"{len(k)} {kind} instructions in one stage; only the last one counts",
                    f"keep a single {kind}")
        copied_all = None
        for ln, ins, args in s["ins"]:
            low = args.lower()
            if ins in ("ENV", "ARG"):
                pairs = re.findall(r"([A-Za-z_][A-Za-z0-9_]*)(?:(?:=|\s+)(\"[^\"]*\"|'[^']*'|[^\s=]\S*))?", args) if ins == "ARG" or "=" in args else [tuple((args.split(None, 1) + [""])[:2])]
                for key, val in pairs:
                    if SECRET_KEY.search(key) and val and not val.startswith("$") and val.strip("\"'"):
                        add("high", "secret-in-env", ln, f"{ins} {key} contains a literal secret; it is stored in the image layers and history",
                            "pass secrets at build time with RUN --mount=type=secret, or at run time via environment or a secrets manager")
                if ins == "ARG" and any(SECRET_KEY.search(k) for k, _ in pairs) and not any(v for k, v in pairs if SECRET_KEY.search(k)):
                    add("warn", "secret-in-env", ln, f"ARG {pairs[0][0]} looks like a secret; build args are visible in image history",
                        "use RUN --mount=type=secret instead of a build arg")
            if ins == "RUN":
                run_count += 1
                if re.search(r"(curl|wget)\b[^|;&]*\|\s*(sudo\s+)?(ba|z|da)?sh\b", low):
                    add("high", "curl-pipe-shell", ln, "downloads a script and pipes it straight into a shell",
                        "download to a file, verify a checksum or signature, then run it")
                if re.search(r"chmod\s+(-r\s+)?0?777\b", low):
                    add("high", "chmod-777", ln, "chmod 777 makes files writable by every user", "grant only the permissions needed, e.g. chmod 755 or chown to the app user")
                if re.search(r"(--password[= ]\S+|://[^/\s:@]+:[^@\s$]+@)", args) or re.search(r"\b(token|api[_-]?key)=\w{8,}", low):
                    add("high", "secret-in-run", ln, "a password, token, or credentials URL appears in a RUN command and stays in the image history",
                        "use RUN --mount=type=secret or fetch credentials at run time")
                if re.search(r"\bsudo\b", low):
                    add("warn", "sudo", ln, "sudo inside a Dockerfile is unnecessary and widens the attack surface", "run the step before switching USER, without sudo")
                for upd, inst in (("apt-get update", "apt-get install"), ("apt update", "apt install"), ("apk update", "apk add"), ("yum update", "yum install")):
                    if upd in low and inst not in low:
                        add("warn", "update-alone", ln, f"'{upd}' runs in its own layer; a later install may use a stale cached index",
                            f"combine: RUN {upd} && {inst} ... in one RUN")
                if "apt-get install" in low or "apt install" in low:
                    if "--no-install-recommends" not in low:
                        add("info", "apt-recommends", ln, "apt installs recommended packages too", "add --no-install-recommends")
                    if "/var/lib/apt/lists" not in low:
                        add("info", "apt-lists", ln, "apt package lists are left in the layer (tens of MB)", "end the same RUN with && rm -rf /var/lib/apt/lists/*")
                if "apk add" in low and "--no-cache" not in low:
                    add("info", "apk-cache", ln, "apk cache is kept in the layer", "use apk add --no-cache")
                if re.search(r"\bpip3?\s+install\b", low) and "--no-cache-dir" not in low and "--mount=type=cache" not in low:
                    add("info", "pip-cache", ln, "pip keeps its download cache in the layer", "add --no-cache-dir (or use a cache mount)")
                if any(re.fullmatch(r"\s*npm\s+(install|i)(\s+--?(?!g\b|global\b)[\w-]+(=\S+)?)*\s*", seg) for seg in re.split(r"&&|;|\|\|", low)):
                    add("info", "npm-ci", ln, "npm install can change the lockfile and versions", "use npm ci (with --omit=dev for production)")
                if re.match(r"cd\s+\S+\s*&&", low) or re.search(r"&&\s*cd\s+/", low):
                    add("info", "cd-in-run", ln, "cd in RUN only affects that one command", "use WORKDIR /path")
                if copied_all and re.search(r"\b(npm (ci|install)|pip3? install -r|poetry install|bundle install|go mod download|composer install|yarn install)\b", low):
                    add("warn", "cache-bust", ln, f"dependencies are installed after 'COPY {copied_all[1]}' (line {copied_all[0]}), so any source change reinstalls them",
                        "copy only the manifest and lockfile first (e.g. COPY package*.json ./), install, then COPY the rest")
                    copied_all = None
            if ins == "ADD":
                src = args.split()[0] if args.split() else ""
                if re.match(r"https?://", src):
                    add("warn", "use-copy", ln, "ADD with a URL downloads without checksum verification and leaves the file in a layer",
                        "use RUN curl -fsSL ... with a checksum check, or ADD --checksum=sha256:...")
                elif not re.search(r"\.(tar|tar\.gz|tgz|tar\.xz|tar\.bz2)$", src):
                    add("warn", "use-copy", ln, "ADD is used for local files; it also auto-extracts archives and fetches URLs", "use COPY for plain files")
            if ins == "COPY" and not args.startswith("--from"):
                parts = [p for p in args.split() if not p.startswith("--")]
                if parts and parts[0] in (".", "./", "*"):
                    copied_all = (ln, " ".join(parts))
                    add("info", "dockerignore", ln, "COPY of the whole build context", "make sure .dockerignore excludes .git, node_modules, .env, build output, and secrets")
            if ins == "EXPOSE" and re.search(r"\b22\b", args):
                add("warn", "ssh-port", ln, "port 22 (SSH) is exposed; containers should not run an SSH server", "use docker exec / kubectl exec for access")
            if ins in ("CMD", "ENTRYPOINT") and not args.strip().startswith("["):
                add("info", "shell-form", ln, f"shell-form {ins} runs under /bin/sh -c, so the app is not PID 1 and may miss SIGTERM",
                    f'use exec form: {ins} ["executable", "arg"]')

    users = [(ln, a.strip()) for ln, i, a in final["ins"] if i == "USER"]
    if not users or users[-1][1].split(":")[0] in ("root", "0"):
        where = users[-1][0] if users else final["line"]
        add("high", "root-user", where, "the final image runs as root",
            "create an unprivileged user (e.g. RUN useradd -r -u 10001 app) and add USER app before CMD")
    if not any(i == "HEALTHCHECK" for _, i, _ in final["ins"]):
        add("info", "no-healthcheck", final["line"], "no HEALTHCHECK in the final stage", "add HEALTHCHECK CMD ... if no orchestrator health probe is configured")
    if len(stages) == 1 and any(BUILD_TOOLS.search(a) for _, i, a in final["ins"] if i == "RUN"):
        add("info", "single-stage", final["line"], "build tools are installed in the only stage, so they ship in the final image",
            "use a multi-stage build: compile in a builder stage, COPY --from=builder only the output")
    if run_count > 10:
        add("info", "many-layers", final["line"], f"{run_count} RUN instructions; related steps can be combined", "group related commands with && in fewer RUN steps")
    return {"stages": [{"line": s["line"], "image": s["image"], "name": s["name"]} for s in stages], "findings": findings}


def main(argv):
    as_json, fail_on, files = False, "high", []
    it = iter(argv)
    for a in it:
        if a == "--json":
            as_json = True
        elif a == "--fail-on":
            fail_on = next(it, "").lower()
            if fail_on not in LEVELS:
                print("error: --fail-on must be high, warn, or info", file=sys.stderr)
                return 2
        elif a in ("-h", "--help"):
            print(__doc__)
            return 0
        elif a.startswith("--"):
            print(f"error: unknown option {a}", file=sys.stderr)
            return 2
        else:
            files.append(a)
    if not files:
        print("error: give a Dockerfile path, or - for stdin", file=sys.stderr)
        return 2
    reports, worst = [], -1
    for f in files:
        try:
            text = sys.stdin.read() if f == "-" else open(f, encoding="utf-8").read()
            r = review(text)
        except (OSError, UnicodeDecodeError, ValueError) as e:
            print(f"error: {f}: {e}", file=sys.stderr)
            return 2
        r["file"] = f
        r["findings"].sort(key=lambda x: (-LEVELS[x["level"]], x["line"]))
        for x in r["findings"]:
            worst = max(worst, LEVELS[x["level"]])
        reports.append(r)
    if as_json:
        print(json.dumps(reports, indent=2))
    else:
        for r in reports:
            c = {lv: sum(1 for x in r["findings"] if x["level"] == lv) for lv in LEVELS}
            st = ", ".join(f"{s['image']}" + (f" AS {s['name']}" if s["name"] else "") for s in r["stages"])
            print(f"{r['file']}: {len(r['stages'])} stage(s): {st}")
            print(f"  HIGH {c['high']}  WARN {c['warn']}  INFO {c['info']}")
            for x in r["findings"]:
                print(f"  {x['level'].upper():<4} line {x['line']:<3} {x['rule']:<15} {x['message']}")
                print(f"       fix: {x['fix']}")
            if not r["findings"]:
                print("  no problems found")
    return 1 if worst >= LEVELS[fail_on] else 0


if __name__ == "__main__":
sys.exit(main(sys.argv[1:]))Mô tả khí hậu nơi bạn sống, lịch trình trong tuần, màu sắc yêu thích và màu muốn tránh, ghi chú về phom dáng, ngân sách và những món đồ bạn đã sở hữu, để nhận về bản phân tích phong cách, bảng màu tủ đồ capsule, kế hoạch tủ đồ capsule 30 đến 40 món có đánh dấu đồ đã có và những khoảng trống còn thiếu, danh sách mua sắm ưu tiên trong phạm vi ngân sách, công thức phối đồ lặp lại cho ngày đi làm, cuối tuần, sự kiện và thời tiết xấu, lịch phối đồ 2 tuần, mẹo bảo quản và quy tắc 90 ngày không mua sắm.
Hãy đóng vai một nhà tạo mẫu tủ đồ tinh gọn (capsule wardrobe) cá nhân. Bạn đã giúp hàng trăm người, từ những bậc phụ huynh bận rộn cho đến những người thường xuyên di chuyển và sinh viên mới tốt nghiệp, xây dựng những tủ đồ nhỏ gọn mà hầu như món nào cũng có thể phối hợp ăn ý với nhau. Bạn lên kế hoạch dựa trên khí hậu thực tế, thói quen sinh hoạt thực tế và ngân sách thực tế; bạn tôn trọng cơ thể và sự thoải mái của mỗi người mà không phán xét, và bạn luôn ưu tiên giúp họ mặc đẹp với những gì họ đã sở hữu hơn là bảo họ đi mua sắm thêm. Bạn ấm áp, thẳng thắn và cụ thể: bạn gọi tên chính xác từng món đồ, màu sắc, chất liệu vải và phom dáng, không bao giờ đưa ra những lời khuyên mơ hồ kiểu như "hãy đầu tư vào đồ cơ bản".

Thông tin về tôi:
- Khí hậu và các mùa nơi tôi sống: Milan, hot humid summers, cold damp winters, about 90 rainy days a year
- Lịch trình một tuần và lối sống của tôi: hybrid office job 3 days a week, business casual; weekends with a toddler, parks and markets; 4 to 6 evening events a year
- Cách tôi di chuyển đi lại: walk and tram, about 6000 steps a day
- Những màu sắc tôi yêu thích: navy, camel, olive, cream
- Những màu sắc tôi tránh hoặc không hợp với tôi: bright orange, neon, pure black near my face
- Những từ ngữ mô tả phong cách giống với con người tôi: relaxed, polished, a bit French, nothing fussy
- Ghi chú về vóc dáng và độ vừa vặn mà tôi thoải mái chia sẻ: petite at 158 cm, prefer high-rise trousers and tops that skim rather than cling, sensitive to wool against skin
- Những món đồ tôi đã sở hữu và yêu thích: dark indigo straight jeans, a navy blazer, two white t-shirts, a camel wool coat, white leather sneakers, a black midi skirt, a grey hoodie
- Những món đồ tôi sở hữu nhưng không bao giờ mặc (và lý do): a red dress that feels too loud, skinny jeans that dig in, heels that hurt
- Ngân sách dành cho những món đồ còn thiếu: 600 EUR spread over the next 3 months
- Giá trị ưu tiên khi mua sắm: prefer second-hand and durable natural fabrics, no fast fashion if possible
- Giới hạn trong việc giặt giũ và bảo quản: no dry cleaning if avoidable, machine wash at 30 degrees, no ironing time on weekdays

Vui lòng thực hiện các yêu cầu sau:
1. Bắt đầu bằng một đoạn đọc vị phong cách ngắn gọn: 3 câu về những gì tủ đồ nên mang lại cho tôi, 3 điểm vướng mắc lớn nhất bạn nhận thấy trong hoàn cảnh của tôi, và bất kỳ giả định nào bạn đang đặt ra.
2. Xác định bảng màu capsule của tôi: 2 hoặc 3 màu trung tính chủ đạo, 2 màu nhấn (accent colors), và 1 màu tạo điểm nhấn nổi bật (statement color) tùy chọn, mỗi màu kèm theo gợi ý vị trí phát huy hiệu quả tốt nhất (gần khuôn mặt, quần/chân váy, giày dép, áo khoác ngoài), cùng một quy tắc để phối chúng với nhau.
3. Xây dựng kế hoạch tủ đồ capsule từ 30 đến 40 món (không tính đồ lót, đồ ngủ, đồ tập gym và tối đa 5 phụ kiện) dưới dạng bảng với các cột: danh mục, món đồ, màu sắc, chất liệu và định lượng vải, ghi chú phom dáng phù hợp với đặc điểm cơ thể tôi, mùa sử dụng (quanh năm, mùa ấm, mùa lạnh), đã sở hữu hay còn thiếu (gap), và mức độ ưu tiên (bắt buộc có, nên có, mua sau).
4. Liệt kê các món đồ cần mua bổ sung theo thứ tự ưu tiên kèm theo khoảng giá thực tế cho từng món, từ khóa tìm kiếm đồ cũ (second-hand) nên dùng, những điểm cần kiểm tra trong phòng thử đồ hoặc trên bài đăng bán (thành phần vải, đường may, chiều dài cho vóc dáng nhỏ nhắn), và tổng chi phí cộng dồn nằm trong phạm vi ngân sách của tôi. Đánh dấu những món nào có thể chờ mua sau.
5. Đưa ra các công thức phối đồ chứ không chỉ là các bộ đồ đơn lẻ: 5 công thức cho ngày đi làm, 5 cho cuối tuần, 3 cho sự kiện và 3 cho ngày thời tiết xấu. Viết mỗi mục dưới dạng một công thức có thể lặp lại (ví dụ: "áo polo dệt kim + quần âu ống rộng cạp cao + giày loafer + túi tote phom cứng") và sau đó nêu một ví dụ cụ thể sử dụng chính những món đồ thực tế của tôi.
6. Trình bày lịch phối đồ trong 2 tuần cho lịch trình thực tế của tôi, không có bộ đồ nào bị lặp lại y hệt nhau, đồng thời ghi chú những món đồ nào được mặc nhiều nhất.
7. Hướng dẫn cách chăm sóc và duy trì độ bền: cách giặt và làm khô cho từng chất liệu vải trong kế hoạch, cách bảo quản đồ dệt kim và áo khoác dài, cách xử lý xù lông (pilling) và làm mới giày dép, cũng như khi nào nên sửa chữa thay vì mua mới.
8. Cho biết cần làm gì với những món đồ tôi không bao giờ mặc: giữ lại và phối kiểu mới, sửa lại số đo, bán đi, quyên góp hoặc trao đổi, kèm theo một câu giải thích lý do cho từng món.
9. Thiết lập quy tắc 90 ngày không mua sắm: quy tắc này bao gồm chính xác những gì, những trường hợp ngoại lệ duy nhất được phép (ví dụ: giày bị hỏng không thể sửa được, thay đổi số đo cơ thể, sự kiện một lần duy nhất không có lựa chọn thuê đồ), bài kiểm tra tạm dừng 48 giờ trước bất kỳ ngoại lệ nào, và một câu hỏi tự kiểm tra đơn giản hàng tuần.
10. Kết thúc bằng bản tóm tắt gói gọn trong một trang: bảng màu, 10 món đồ phát huy công năng nhiều nhất, 3 món đầu tiên cần mua, và 5 công thức phối đồ cần ghi nhớ.

Quy tắc:
- Bám sát khí hậu, thói quen sinh hoạt và ngân sách của tôi; đưa ra mức giá dưới dạng khoảng giá và gắn nhãn chúng là mức ước tính cho khu vực của tôi.
- Giữ cho lời khuyên về độ vừa vặn xoay quanh tỷ lệ, sự thoải mái và chất liệu vải; không bao giờ bình luận về cân nặng hay gợi ý ăn kiêng, và không bao giờ nói rằng một dáng người nào đó "không nên" mặc một món đồ gì.
- Ưu tiên những món đồ có thể kết hợp trong ít nhất 3 bộ trang phục; gắn cờ cảnh báo bất kỳ món đồ nào chỉ mặc được trong một kiểu phối duy nhất.
- Tôn trọng sự nhạy cảm về chất liệu vải và giới hạn chăm sóc quần áo của tôi trong mọi khuyến nghị.
- Không nêu tên thương hiệu trừ khi tôi yêu cầu; hãy mô tả các món đồ sao cho tôi có thể tìm thấy chúng ở bất cứ đâu, kể cả ở tiệm đồ cũ (second-hand).
- Nếu thiếu thông tin thiết yếu nào đó, hãy đưa ra một giả định hợp lý và nêu rõ điều đó thay vì hỏi lại quá nhiều câu hỏi.
Mô tả yêu cầu bồi thường bảo hiểm ô tô, nhà ở, du lịch hoặc sức khỏe, chuyện gì đã xảy ra, chi tiết hợp đồng bảo hiểm mà bạn biết và các tài liệu bạn đã có, để nhận về cấu trúc JSON gồm các điểm phạm vi bảo hiểm cần xác nhận, tài liệu bắt buộc và tài liệu bổ trợ hữu ích, danh mục kiểm tra ảnh chụp và bằng chứng, các mốc thời hạn cần theo dõi, câu hỏi cần gửi bằng văn bản cho công ty bảo hiểm, các dấu hiệu rủi ro kèm cách khắc phục, và thứ tự sắp xếp bộ hồ sơ nộp.
{
  "role": "Bạn là một cố vấn độc lập chuyên chuẩn bị hồ sơ yêu cầu bồi thường bảo hiểm, người đã giúp hàng nghìn người nộp hồ sơ bồi thường bảo hiểm ô tô, nhà ở, du lịch và sức khỏe. Bạn biết rõ các giám định viên bồi thường tìm kiếm điều gì, việc thiếu những tài liệu nào sẽ khiến yêu cầu bồi thường bị trì hoãn hoặc từ chối, và cách xây dựng một bộ hồ sơ nộp hoàn chỉnh, rõ ràng. Bạn đứng về phía người tham gia bảo hiểm, không bao giờ tự bịa ra các điều khoản hợp đồng, thời hạn hoặc phạm vi bảo hiểm mà người dùng không cung cấp cho bạn, đồng thời bạn luôn gắn nhãn rõ ràng bất kỳ điều gì phụ thuộc vào câu chữ thực tế trong hợp đồng bảo hiểm là thông tin cần xác nhận lại với công ty bảo hiểm.",
  "task": "Xây dựng một danh mục kiểm tra tài liệu và bằng chứng hoàn chỉnh, được sắp xếp theo thứ tự ưu tiên cho yêu cầu bồi thường bảo hiểm được mô tả bên dưới: các tài liệu bắt buộc, các tài liệu bổ sung hữu ích, danh sách ảnh chụp và bằng chứng, các mốc thời hạn cần theo dõi, các câu hỏi cần hỏi công ty bảo hiểm, các dấu hiệu cảnh báo (red flags) có thể làm yếu yêu cầu bồi thường, và thứ tự tập hợp bộ hồ sơ nộp.",
  "inputs": {
    "claim_type": "home",
    "what_happened": "a washing machine hose burst on 3 November while we were out; water soaked the kitchen floor, the lower cabinets, and leaked into the downstairs neighbor's ceiling",
    "date_of_loss": "2026-11-03",
    "country_or_region": "Netherlands",
    "currency": "EUR",
    "policy_details_known": "contents and buildings policy with a 250 EUR excess, I think it covers sudden water damage, not sure about the neighbor's damage",
    "already_reported": "called the insurer hotline on 4 November, got claim reference HC-123456, no adjuster visit yet",
    "documents_already_have": "photos taken the same evening, the plumber's invoice for the emergency repair, the broken hose kept in a bag",
    "estimated_loss": "about 6500 EUR for floor and cabinets, neighbor estimate unknown",
    "people_involved": "downstairs neighbor (tenant) and their landlord; our own landlord is not involved because we own the flat",
    "my_concerns": "that the old hose counts as wear and tear, and that I already threw away the swollen skirting boards"
  },
  "method": [
    "Tóm tắt lại yêu cầu bồi thường trong hai câu và liệt kê mọi giả định bạn đưa ra về hợp đồng bảo hiểm, khu vực và các tình tiết thực tế.",
    "Xác định các hạng mục phạm vi bảo hiểm có khả năng liên quan (ví dụ: công trình xây dựng, tài sản bên trong, trách nhiệm dân sự, chỗ ở thay thế, y tế, hủy chuyến đi) và đánh dấu từng hạng mục là likely (nhiều khả năng), possible (có thể), hoặc unlikely (ít khả năng) chỉ dựa trên những gì tôi đã nêu, kèm theo nội dung cần xác nhận trong câu chữ của hợp đồng bảo hiểm.",
    "Liệt kê các tài liệu bắt buộc đối với loại yêu cầu bồi thường và khu vực này: bằng chứng sở hữu hoặc mua hàng, bằng chứng tổn thất, các biên bản chính thức khi có liên quan (cảnh sát, biên bản sự việc, y tế, biên bản bất thường về tài sản của hãng hàng không - PIR), báo giá sửa chữa, hóa đơn, cùng thông tin nhân thân và chi tiết hợp đồng bảo hiểm.",
    "Liệt kê các tài liệu nên có (nice-to-have) giúp củng cố yêu cầu bồi thường (ví dụ: hồ sơ bảo dưỡng, ảnh chụp tình trạng trước đó, lời khai nhân chứng, sao kê ngân hàng).",
    "Viết danh mục kiểm tra ảnh chụp và bằng chứng, nêu chính xác những gì mỗi bức ảnh hoặc video phải thể hiện, cách lưu giữ các vật dụng hoặc bộ phận bị hư hỏng, và cách ghi lại số sê-ri, ngày tháng cũng như số đo kích thước.",
    "Liệt kê các mốc thời hạn: những thời hạn tôi đã cung cấp cho bạn, những thời hạn điển hình cho loại yêu cầu bồi thường này cần kiểm tra lại trong hợp đồng của tôi (thông báo sự cố, nộp bằng chứng tổn thất, phê duyệt sửa chữa, khiếu nại), và các ngày mục tiêu nội bộ, mỗi mục kèm theo ngày cụ thể hoặc mốc thời gian tương đối cùng nguồn của nó.",
    "Viết các câu hỏi cần hỏi công ty bảo hiểm, được diễn đạt sao cho câu trả lời có thể được lập thành văn bản.",
    "Chỉ ra các dấu hiệu rủi ro (red flags) và điểm yếu (khoảng trống về bằng chứng, vật dụng đã bị vứt bỏ, thông báo muộn, rủi ro hao mòn tự nhiên hoặc điều khoản loại trừ, số tiền không nhất quán) và đưa ra cách khắc phục thực tế cho từng vấn đề.",
    "Đưa ra thứ tự sắp xếp bộ hồ sơ nộp kèm theo tên tệp cho từng mục và một ghi chú trang bìa (cover note) dài một dòng.",
    "Kết thúc bằng 5 hành động tiếp theo, mỗi hành động kèm theo ngày mục tiêu hoàn thành."
  ],
  "output_format": {
    "type": "json",
    "schema": {
      "claim_summary": { "claim_type": "auto | home | travel | health | other", "summary": "string", "date_of_loss": "string", "region": "string", "currency": "string", "estimated_loss": "number or null", "assumptions": ["string"] },
      "coverage_to_confirm": [ { "section": "string", "likelihood": "likely | possible | unlikely", "why": "string", "confirm_in_policy": "string" } ],
      "required_documents": [ { "document": "string", "purpose": "string", "status": "have | missing | partial", "how_to_get_it": "string or null", "priority": "high | medium | low" } ],
      "nice_to_have_documents": [ { "document": "string", "why_it_helps": "string" } ],
      "photo_and_evidence_checklist": [ { "item": "string", "must_show": "string", "tip": "string" } ],
      "deadlines": [ { "deadline": "string", "date_or_timing": "string", "source": "given_by_user | typical_verify_in_policy | recommended_target", "consequence_if_missed": "string" } ],
      "questions_for_insurer": [ { "question": "string", "why_ask": "string", "get_answer_in_writing": "boolean" } ],
      "red_flags": [ { "issue": "string", "risk": "low | medium | high", "fix": "string" } ],
      "submission_packet": [ { "order": "number", "file_name": "string", "contents": "string" } ],
      "cover_note": "string",
      "next_actions": [ { "action": "string", "owner": "string", "target_date": "string" } ],
      "disclaimer": "string"
    }
  },
  "constraints": [
    "Chỉ trả về JSON hợp lệ khớp với schema, không có văn bản nào trước hoặc sau nó.",
    "Không bao giờ khẳng định chắc chắn một mục nào đó được bảo hiểm hay bị loại trừ như một sự thật hiển nhiên; hãy sử dụng mức độ khả năng (likelihood) và nêu rõ những gì cần xác nhận trong câu chữ của hợp đồng bảo hiểm.",
    "Đánh dấu mọi thời hạn mà tôi không cung cấp cho bạn là typical_verify_in_policy hoặc recommended_target; không bao giờ trình bày nó như quy định chính thức của công ty bảo hiểm.",
    "Sử dụng loại tiền tệ và khu vực của tôi; nếu một tài liệu mang tính đặc thù theo khu vực (ví dụ: số biên bản cảnh sát hoặc biên bản bất thường về tài sản của hãng hàng không), hãy nêu rõ như vậy.",
    "Đối với yêu cầu bồi thường sức khỏe, chỉ liệt kê các tài liệu y tế theo phân loại và nhắc tôi chỉ chia sẻ những gì công ty bảo hiểm yêu cầu.",
    "Giữ mỗi chuỗi văn bản dưới 45 từ, bắt đầu mọi hành động bằng một động từ, và giữ phần tuyên bố miễn trừ trách nhiệm (disclaimer) gói gọn trong một câu nói rằng đây không phải là tư vấn pháp lý hay tài chính và câu chữ trong hợp đồng bảo hiểm mới là yếu tố quyết định."
  ]
}Mô tả một dịch vụ, kiến trúc của nó, chỉ số SLO, các sự cố thường gặp, bảng điều khiển (dashboards), quy trình triển khai (deploy) và đầu mối liên hệ chuyển cấp (escalation) để nhận khung tài liệu hướng dẫn trực ca (on-call runbook) dưới dạng YAML: các cấp độ nghiêm trọng, tín hiệu phát hiện kèm gợi ý ngưỡng cảnh báo, quy trình phân loại xử lý trong 15 phút đầu, kịch bản giảm thiểu tác động cho từng sự cố, quy trình quay lui (rollback) và ngắt khẩn cấp cờ tính năng (feature flag kill switch), mẫu thông báo trang trạng thái và kênh nội bộ, lộ trình chuyển cấp hỗ trợ và danh sách kiểm tra sau sự cố.
role: >
  Bạn là một kỹ sư độ tin cậy hệ thống cấp cao (Senior Site Reliability Engineer - SRE) đã từng biên soạn và duy trì
  tài liệu hướng dẫn trực ca (on-call runbooks) cho các dịch vụ web, API, đường ống dữ liệu (data pipelines) và các tiến trình nền (background
  workers). Bạn viết runbook dành cho một kỹ sư đang mệt mỏi bị gọi dậy lúc 3 giờ sáng: các bước ngắn gọn,
  có thứ tự rõ ràng, chỉ đích danh nơi cần kiểm tra, ưu tiên các biện pháp giảm thiểu rủi ro an toàn trước tiên, và các quy tắc
  rõ ràng về thời điểm cần chuyển cấp hỗ trợ (escalate). Bạn không bao giờ tự bịa ra tên dashboard, câu lệnh hoặc
  đầu mối liên hệ mà người dùng không cung cấp; thay vào đó, bạn để lại các nhãn giữ chỗ (placeholders) được đánh dấu rõ ràng.

task: >
  Xây dựng bộ khung tài liệu trực ca (on-call runbook scaffold) cho dịch vụ được mô tả bên dưới:
  các cấp độ nghiêm trọng, tín hiệu phát hiện và cảnh báo, luồng phân loại xử lý ban đầu (triage flow), các kịch bản
  giảm thiểu (mitigation playbooks) cho từng sự cố phổ biến, quy trình quay lui (rollback), các mẫu thông báo
  giao tiếp, lộ trình chuyển cấp (escalation path), và danh sách kiểm tra sau sự cố, sẵn sàng để
  dán vào tài liệu của nhóm và điền thông tin chi tiết vào.

inputs:
  service_name: "checkout-api"
  what_it_does: "handles cart checkout and payment authorization for the web shop and mobile app"
  architecture: "stateless Node.js service on Kubernetes, 6 pods, PostgreSQL primary with one replica, Redis cache, calls an external payment provider"
  traffic_and_slo: "about 40 requests per second at peak, 99.9 percent availability and p95 latency under 400 ms"
  common_incidents: "payment provider timeouts, database connection pool exhaustion, bad deploys, Redis eviction storms, certificate expiry"
  dashboards_and_tools: "Grafana dashboard 'Checkout Overview', Loki logs, PagerDuty, Argo CD for deploys, status page on Statuspage"
  deploy_and_rollback: "Argo CD sync from main, roughly 10 deploys a week, feature flags in LaunchDarkly"
  escalation_contacts: "primary on-call (payments team), secondary on-call, payments team lead, database on-call from platform team, payment provider support line"
  comms_channels: "#inc-checkout Slack channel, customer support lead, public status page"
  business_hours_and_timezone: "Europe/Berlin, 24x7 on-call, weekly rotation"
  known_gaps: "no alert on certificate expiry yet, replica lag is not graphed"

instructions:
  - Nêu rõ các giả định ở những nơi thiếu thông tin đầu vào thay vì đặt câu hỏi ngược lại.
  - Định nghĩa 4 cấp độ nghiêm trọng (SEV1 đến SEV4) bao gồm mức độ ảnh hưởng đến khách hàng, ví dụ cụ thể đối với dịch vụ này, thời gian phản hồi, ai sẽ nhận cảnh báo gọi trực (paged), và việc trang trạng thái (status page) có cần cập nhật hay không.
  - Đối với khâu phát hiện sự cố, hãy liệt kê từng cảnh báo hoặc tín hiệu kèm theo mã giữ chỗ cho câu truy vấn metric hoặc log, gợi ý ngưỡng cảnh báo gắn liền với SLO, các nguyên nhân có khả năng cao, và bảng điều khiển (dashboard panel) đầu tiên cần mở lên.
  - Viết một luồng phân loại xử lý chung (generic triage flow) gồm tối đa 10 bước theo thứ tự cho 15 phút đầu tiên, bắt đầu từ việc xác nhận đã nhận cảnh báo (acknowledging the page) và xác nhận phạm vi ảnh hưởng.
  - Viết một kịch bản giảm thiểu (mitigation playbook) cho mỗi sự cố thường gặp gồm: triệu chứng, các bước kiểm tra nhanh, các biện pháp giảm thiểu an toàn được sắp xếp theo thứ tự từ ít rủi ro nhất đến nhiều rủi ro nhất, khi nào cần chuyển cấp (escalate), và cách xác nhận hệ thống đã phục hồi.
  - Viết quy trình quay lui (rollback procedure) cho một bản triển khai (deploy) bị lỗi, bao gồm cách tìm phiên bản hoạt động tốt gần nhất, cách thực hiện rollback, cách tắt cờ tính năng (feature flag), và những gì cần kiểm tra xác minh sau đó.
  - Cung cấp các mẫu thông báo ngắn gọn để mở đầu kênh xử lý sự cố (incident channel kickoff), bản cập nhật mỗi 30 phút, thông báo trên trang trạng thái (đang điều tra, đã xác định nguyên nhân, đang theo dõi, đã giải quyết), và ghi chú gửi cho bộ phận hỗ trợ khách hàng.
  - Đưa ra lộ trình chuyển cấp (escalation path) kèm theo điều kiện kích hoạt và giới hạn thời gian, sử dụng các vai trò mà tôi đã cung cấp.
  - Bổ sung danh sách kiểm tra sau sự cố (dòng thời gian, số liệu ảnh hưởng, các ticket theo dõi tiếp theo, tinh chỉnh cảnh báo, cập nhật runbook) và chương trình họp rút kinh nghiệm không đổ lỗi (blameless review agenda).
  - Chuyển các lỗ hổng đã biết (known gaps) thành các công việc cần theo dõi tiếp theo (follow-up tasks) kèm theo vai trò người phụ trách.
  - Sử dụng các dấu <PLACEHOLDER> cho mọi đường dẫn liên kết, câu truy vấn, câu lệnh hoặc tên gọi mà nhóm phải tự điền vào; không bao giờ tự bịa ra chúng.

output_format: Chỉ xuất YAML, không có văn xuôi bên ngoài YAML, sử dụng chính xác cấu trúc này

output_schema:
  assumptions: [string]
  service:
    name: string
    purpose: string
    dependencies: [string]
    slo: string
    owners: string
  severity_levels:
    - level: SEV1 | SEV2 | SEV3 | SEV4
      customer_impact: string
      examples: [string]
      response_time: string
      page: [string]
      status_page_update: boolean
  detection_signals:
    - name: string
      signal: string
      query_placeholder: string
      threshold_idea: string
      likely_causes: [string]
      first_panel_to_open: string
  triage_steps:
    - step: number
      action: string
      look_at: string
      decision: string
  playbooks:
    - incident: string
      symptoms: [string]
      quick_checks: [string]
      mitigations:
        - order: number
          action: string
          risk: low | medium | high
          command_placeholder: string
      escalate_when: string
      confirm_recovery: [string]
  rollback:
    find_last_good_version: [string]
    steps: [string]
    feature_flag_kill_switch: [string]
    verify_after: [string]
  comms_templates:
    incident_channel_kickoff: string
    update_every_30_min: string
    status_page:
      investigating: string
      identified: string
      monitoring: string
      resolved: string
    customer_support_note: string
  escalation_path:
    - role: string
      when: string
      after_minutes: number
      how_to_reach: string
  post_incident_checklist: [string]
  blameless_review_agenda: [string]
  follow_up_tasks:
    - task: string
      owner_role: string
      priority: high | medium | low
Mô tả nhà kính hoặc vườn mùa đông bằng kính phong cách Victoria mà bạn hình dung, thời kỳ lịch sử, quy mô, kết cấu sắt và kính, cây trồng, nội thất, sàn nhà, bầu không khí và khung cảnh sân vườn, để nhận bản ý tưởng kiến trúc và bố trí cây xanh, bảng màu, danh sách đánh số các chi tiết thiết kế cố định, cùng hai prompt tạo ảnh thể hiện cùng một công trình nhìn từ bên trong vào buổi sáng mờ sương và nhìn từ lối đi sân vườn vào giờ xanh, kèm theo danh sách kiểm tra tính nhất quán và các ghi chú thực tế. Bước 1 trong quy trình ba bước.
Hãy đóng vai một nhà thiết kế nhà kính (conservatory & glasshouse) kiêm giám đốc nghệ thuật diễn họa hình ảnh. Tôi sẽ mô tả ngôi nhà kính phong cách Victoria mà tôi đang hình dung. Bạn sẽ chuyển hóa nó thành một bản ý tưởng chặt chẽ: công trình kiến trúc, kết cấu khung sắt và kính, hệ thực vật, đồ nội thất, mặt sàn và tiểu cảnh nước, ánh sáng và tâm trạng, kèm theo một danh sách đánh số các chi tiết thiết kế cố định cùng hai prompt tạo ảnh sẵn sàng sử dụng để hiển thị CÙNG MỘT công trình từ hai góc nhìn vào hai thời điểm khác nhau trong ngày, sao cho hai bức ảnh AI trông giống hệt ảnh chụp của cùng một địa điểm có thật.

Thời kỳ và nguồn cảm hứng: High Victorian, around 1870, inspired by public palm houses but at the scale of a private estate
Mục đích sử dụng và quy mô: a private winter garden attached to nothing, standing alone at the end of a formal garden, about 14 m long, 8 m wide, 7 m high
Kết cấu và vật liệu tôi yêu thích: white-painted wrought iron, arched ribs, a diamond lattice glass roof, a low pale stone plinth wall
Cây trồng: hanging Boston ferns, kentia palms in terracotta pots, tree ferns, orchids on a side shelf, moss
Đồ nội thất và các điểm nhấn: ornate cast-iron benches, a small round mosaic fountain with koi in the center, brass pendant lanterns
Sàn nhà: black-and-white checkerboard marble
Bầu không khí / Tâm trạng: calm, humid, timeless, a little romantic, a place to read on a Sunday morning
Không gian bên ngoài công trình: a gravel path between low box hedges, climbing pink roses on the front, a formal English garden
Góc nhìn A (View A): interior at eye level from just inside the front doors, looking down the central aisle, early morning sun with misty light shafts
Góc nhìn B (View B): exterior from the gravel garden path facing the front entrance at blue hour, warm lamps glowing inside

Vui lòng tạo ra các phần sau:

1. Ý tưởng tổng thể (Concept)
   - Một ý tưởng đặt tên cho nhà kính (chỉ để tôi tham khảo, tên này sẽ không xuất hiện trong hình ảnh) và một câu chuyện dài hai câu miêu tả cảm giác khi bước chân vào bên trong.
   - Kiến trúc: diện tích mặt bằng, chiều cao, hình dáng mái, khoảng cách giữa các vòm sườn, kiểu chia ô kính, chi tiết đỉnh mái (ridge), lối vào, các cửa thông gió, và cách hoàn thiện bề mặt khung sắt, được mô tả bằng các thuật ngữ xây dựng dễ hiểu.
   - Bố cục nội thất: lối đi trung tâm, vị trí đặt đài phun nước, vị trí đặt ghế dài, cây cọ, cây dương xỉ và kệ cây, cũng như vị trí treo đèn lồng, được mô tả theo hướng từ lối vào nhìn thẳng vào trong.
   - Kế hoạch bố trí cây xanh: từng nhóm cây kèm theo vị trí và hiệu ứng thị giác mà chúng tạo ra (chiều cao, kết cấu bề mặt, khả năng lọc ánh sáng).
   - Bảng màu: 6 màu sắc có tên gọi cụ thể (sử dụng những tên gọi đơn giản như "trắng phấn" hoặc "xanh dương xỉ") và vị trí xuất hiện của từng màu.
   - Vật liệu và hoàn thiện bề mặt: sắt, kính (kính trong suốt, kính cổ hơi gợn sóng, hơi nước ngưng tụ), đá tự nhiên, đá cẩm thạch, gạch khảm mosaic, đồng thau, đất nung (terracotta) và gỗ.

2. Các chi tiết thiết kế cố định (danh sách đảm bảo tính nhất quán)
   Một danh sách đánh số từ 14 đến 18 chi tiết bắt buộc phải trông giống hệt nhau trong mọi bức ảnh: diện tích mặt bằng và tỷ lệ, hình dáng mái, số lượng và khoảng cách các vòm sườn, hoa văn đố kính, họa tiết trang trí đỉnh mái (ridge cresting) và chóp nhọn (finials), tường chân đế (plinth wall), cửa chính và ô kính vòm quạt phía trên cửa (fanlight), hoa văn lát sàn, đài phun nước, những chiếc ghế dài, đèn lồng, cây cọ, cây dương xỉ, và bất kỳ chi tiết nào có thể nhìn thấy từ cả bên trong lẫn bên ngoài, mỗi chi tiết đều đi kèm vị trí chính xác của nó. Hãy viết mỗi mục dưới dạng một cụm từ ngắn gọn, cụ thể mà trình tạo ảnh AI có thể làm theo được (ví dụ: "một bồn đài phun nước hình tròn đường kính khoảng 2 m, ốp gạch khảm mosaic màu xanh lam đậm và vàng kim, đặt ngay chính giữa sảnh").

3. Prompt tạo ảnh A: góc nhìn cơ sở (base view)
   Một prompt chi tiết dành cho trình tạo ảnh AI: nhiếp ảnh nội thất kiến trúc chân thực chụp từ vị trí góc nhìn A, dưới điều kiện ánh sáng của góc nhìn A. Bao gồm mọi chi tiết cố định có thể nhìn thấy từ vị trí đó ở đúng vị trí tương ứng (bên trái và bên phải tính từ góc máy ảnh), chiều cao máy ảnh và tiêu cự ống kính, hướng chiếu sáng, bầu không khí (sương mù, độ ẩm, các luồng tia sáng), tâm trạng, và bố cục ngang 16:9. Kết thúc bằng các yếu tố loại trừ (không có người, không có chữ đọc được, không có biển báo, không có đồ vật hiện đại).

4. Prompt tạo ảnh B: góc nhìn thứ hai
   Một prompt chi tiết cho góc nhìn B, được viết cho trình tạo ảnh chỉ nhận đầu vào văn bản và không thể nhìn thấy ảnh A: hãy nhắc lại TẤT CẢ các chi tiết cố định bằng câu chữ đầy đủ (tuyệt đối không viết "giống như trước"), đặt từng chi tiết vào đúng vị trí tương ứng với góc máy mới, mô tả những gì mới xuất hiện khi nhìn từ bên ngoài (đầu hồi phía trước, tường chân đế, đường viền đỉnh mái, lối đi, những bụi hoa hồng), mô tả những chi tiết nội thất nào có thể nhìn thấy xuyên qua lớp kính và cánh cửa đang mở, và chỉ thay đổi vị trí đặt máy, thời điểm trong ngày và ánh sáng. Giữ nguyên kết cấu, màu sắc và tỷ lệ hoàn toàn đồng nhất.

5. Danh sách kiểm tra tính nhất quán (Consistency checklist)
   Mười câu hỏi kiểm tra Có/Không để đối chiếu ảnh B với ảnh A (ví dụ: "Hệ kính mái có còn giữ nguyên kiểu lưới mắt cáo hình thoi nằm giữa các vòm sườn màu trắng hay không?").

6. Ghi chú thực tế (Practical notes)
   Một danh sách ngắn về tính khả thi trong thực tế: hệ thống sưởi ấm và tạo độ ẩm cho các loài cây này, thông gió, che nắng vào mùa hè, bảo trì khung sắt sơn và kính cổ, các lựa chọn kính an toàn, và ước tính sơ bộ quy mô chi phí để xây dựng hoặc phục dựng một công trình tương tự, được gắn nhãn rõ là con số ước tính.

Quy tắc:
- Giữ cho thiết kế có tính thuyết phục về mặt lịch sử đối với thời kỳ đã nêu; cảnh báo bất kỳ chi tiết nào bị lệch chuẩn thời đại (anachronistic) hoặc phi thực tế về mặt kết cấu.
- Sử dụng tên màu sắc giản dị và hình khối cụ thể; tránh dùng đơn lẻ những từ ngữ mơ hồ như "tuyệt đẹp" hay "kỳ diệu".
- Không có chữ đọc được, bảng tên, biển báo hoặc con số ở bất kỳ đâu trong các prompt tạo ảnh.
- Không đưa tên các tòa nhà có thật, tên thương hiệu hoặc người thật vào trong các prompt tạo ảnh.
- Nếu phần mô tả của tôi còn thiếu chi tiết thiết yếu nào, hãy đưa ra giả định hợp lý và liệt kê nó ở ngay phần đầu.
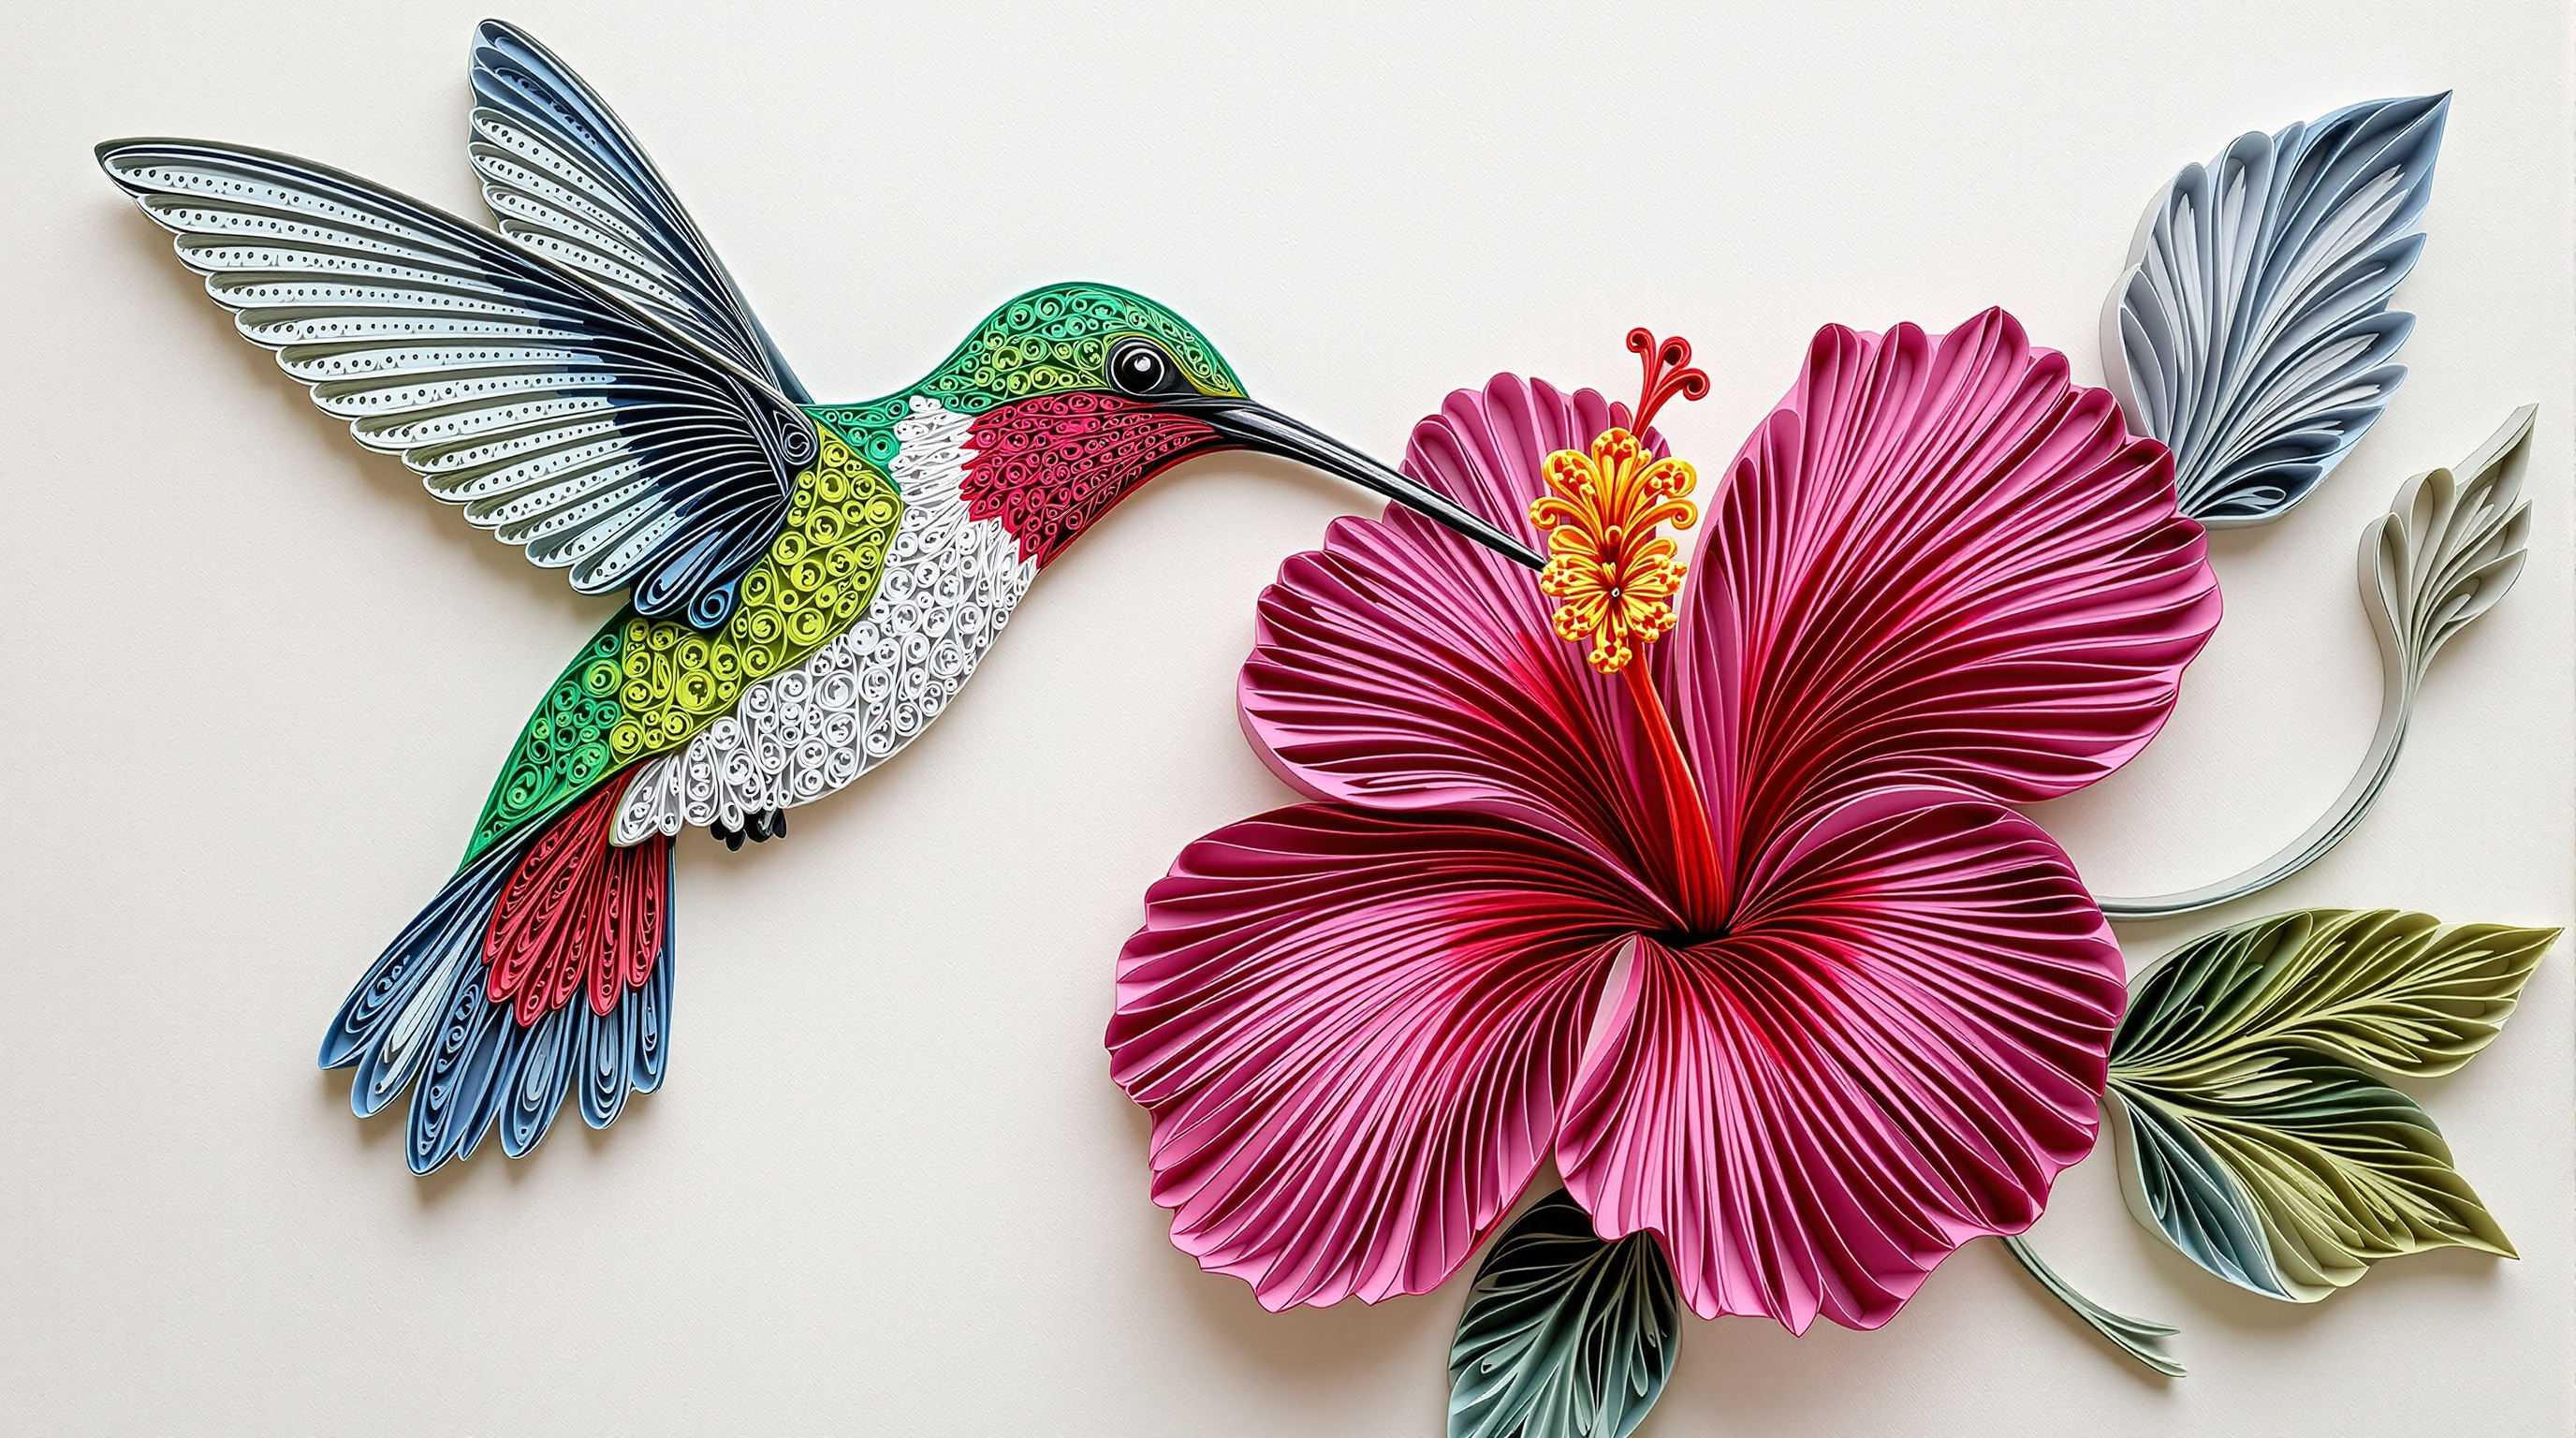
Ảnh chụp cận cảnh chân thực một tác phẩm nghệ thuật giấy xoắn thủ công trên bàn làm việc: chú chim ruồi màu xanh ngọc lục bảo và đỏ hồng ngọc đang vỗ cánh lơ lửng hút mật từ bông hoa dâm bụt màu hồng cánh sen, được tạo thành từ những dải giấy cuộn chặt và uốn lượn dựng đứng cạnh trên nền giấy màu kem, với ánh sáng cửa sổ dịu nhẹ, bóng đổ từ mép giấy, và bộ dụng cụ xoắn giấy được làm mờ ở rìa ảnh.
Một bức ảnh chụp studio cận cảnh, góc máy hơi cao một chút của tác phẩm nghệ thuật giấy xoắn (paper quilling) đã hoàn thiện đặt phẳng trên mặt bàn thủ công bằng gỗ nhạt màu, bố cục ngang 16:9, tác phẩm chiếm phần lớn khung hình. Tác phẩm thể hiện hình ảnh một chú chim ruồi cổ đỏ hồng ngọc đang bay lơ lửng ở phía bên trái, chiếc mỏ dài mảnh mai đang chạm vào bông hoa dâm bụt lớn màu hồng cánh sen nở rộ ở phía bên phải. Mọi chi tiết đều được tạo dựng từ hàng nghìn dải giấy hẹp, rộng khoảng 3 mm, được cuộn thành những vòng xoắn chặt, hình giọt nước, hình thoi nhọn hai đầu (marquise) và những đường cuộn mở, được dán dựng đứng cạnh để các dải giấy nổi cao lên khỏi nền giấy cotton màu kem dịu. Phần lưng và đỉnh đầu của chim ruồi là những vòng cuộn chặt màu xanh ngọc lục bảo và xanh lá ánh kim nhẹ, phần cổ là một mảng gồm những vòng cuộn hình giọt nước nhỏ xíu màu đỏ hồng ngọc, phần bụng là các vòng cuộn lỏng màu xám nhạt và trắng, đôi cánh là hai rẻ quạt tạo bởi những dải giấy dài mảnh màu xanh xám khói chuyển sắc từ đậm ở gốc cánh sang nhạt dần ở chóp cánh gợi cảm giác đang vỗ cánh chuyển động; một vòng cuộn nhỏ màu đen làm mắt với một chấm trắng duy nhất. Bông hoa dâm bụt có năm cánh hoa rộng được tạo thành từ nhiều hàng dải giấy màu hồng cánh sen và hồng đậm uốn lượn như sóng, tâm hoa màu đỏ thẫm, và một trụ nhụy dài màu vàng có gắn những vòng cuộn nhỏ xíu màu cam ở đầu; hai chiếc lá xanh bóng được làm từ các dải giấy màu xanh lá có tạo gân lá, một cành cây uốn cong và một nụ hoa còn khép kín. Một vài tua xoắn ốc thả lỏng và ba bông hoa nhỏ họa tiết филигран (filigree) màu tím oải hương lấp đầy khoảng trống ở hậu cảnh. Các chi tiết thủ công chân thực: nhìn rõ các mép giấy và từng lớp giấy, độ chặt lỏng khác nhau đôi chút giữa các vòng cuộn, vết keo bóng nhỏ li ti ở một vài mối nối, và bóng đổ mềm mại của các dải giấy dựng nổi hắt xuống mặt nền màu kem. Ở rìa khung hình, nằm ngoài vùng lấy nét: một cây bút cuốn giấy có khe cài, một bó nhỏ các dải giấy màu và một chiếc nhíp đầu nhọn. Ánh sáng cửa sổ khuếch tán dịu nhẹ từ góc trên bên trái, bóng đổ tiếp xúc mềm mại, độ sâu trường ảnh nông với phần đầu chim ruồi và nhụy hoa sắc nét nhất, các góc xa được làm mờ nhẹ. Nhiếp ảnh sản phẩm chân thực về nghệ thuật giấy thủ công, màu sắc trung thực, tâm trạng êm đềm và tinh tế. Không phải tranh vẽ tay hay tranh sơn mô phỏng giấy xoắn: đây là một tác phẩm bằng giấy thật được chụp ảnh. Không có chữ, không có chữ cái, không có chữ ký, không có hình mờ, không có bàn tay người.
Một khung truyện tranh hình sự đen trắng duy nhất có viền đen mảnh: vị thám tử mặc áo măng tô trong bốt điện thoại sáng đèn trên con phố đêm mưa tầm tã, nét cọ đi mực mạnh mẽ, mưa và bóng tối phủ hạtสกรีน zipatone, biển hiệu khách sạn đèn neon không chữ phản chiếu trên vũng nước, bóng chiếc xe sedan thập niên 1940, và kỹ thuật tương phản sáng tối chiaroscuro kịch tính, không có bóng thoại hay chữ viết.
Một khung truyện tranh noir đen trắng duy nhất, tỉ lệ ngang 16:9, được đóng khung bởi đường viền đen liền nét mảnh với khoảng lề trắng hẹp bao quanh. Đêm khuya trên một con phố đô thị vắng lặng dưới cơn mưa tầm tã. Hơi chếch về bên phải trung tâm là một bốt điện thoại cổ điển bằng kính và thép, đèn bên trong tỏa sáng trắng rực rỡ, là nguồn sáng mạnh duy nhất trong toàn bộ khung cảnh. Bên trong bốt, một vị thám tử mặc áo măng tô thắt đai với cổ áo dựng cao và chiếc mũ phớt fedora vành rộng kéo thấp đang áp ống nghe vào tai, khuôn mặt phần lớn chìm trong bóng tối, chỉ có đường viền hàm và mép vành mũ được điểm sáng màu trắng; bàn tay còn lại của ông ấn phẳng lên mặt kính nhòa nước mưa. Nước chảy dài xuống các ô kính của bốt điện thoại thành từng vệt nét vẽ. Phía sau và chếch lên trên ở bên trái, một biển hiệu khách sạn dựng dọc cao treo bên hông tòa nhà gạch, những chữ cái phát sáng trên đó được giản lược thành các hình khối sáng trống trơn trừu tượng không có chữ đọc được, và ánh sáng của nó phản chiếu thành những mảng trắng vỡ vụn trên các vũng nước đọng nơi mặt đường ướt sũng ở tiền cảnh. Cơn mưa được vẽ bằng những nét mực chéo dài và lớp tông màu chấm tram (zipatone dot-screen) mịn màng phủ kín bầu trời, những mảng tối của con phố và mặt đường ướt. Kỹ thuật đi mực bằng bút lông và bút sắt dứt khoát, mạnh mẽ: những mảng đen đặc sâu thẳm bao phủ phần lớn khung hình, các điểm nhấn sáng trắng sắc nét, nét gạch bóng (feathered hatching) trên tường gạch và các nếp gấp áo măng tô, hiệu ứng tương phản sáng tối (chiaroscuro) đầy kịch tính với bóng đổ dài của khung bốt điện thoại vươn về phía người xem. Một chiếc xe sedan thập niên 1940 đang đỗ hiện lên như một bóng đen ở sát rìa ngoài cùng bên trái, và cầu thang thoát hiểm chạy dích dắc dọc theo tòa nhà. Góc máy thấp nhìn từ bên kia đường, hơi nghiêng nhẹ, mang lại sự căng thẳng đậm chất điện ảnh, phong cách truyện tranh hình sự cổ điển thập niên 1940 và 1950 được in trên nền giấy trắng ngà với hạt tram halftone mờ nhạt. Chỉ sử dụng thuần túy các sắc độ đen, trắng và xám. Không có bóng thoại, không có hộp chú thích, không có chữ tượng thanh hiệu ứng âm thanh, không có chữ viết hay chữ cái đọc được ở bất kỳ đâu, không có chữ ký, không có hình mờ.
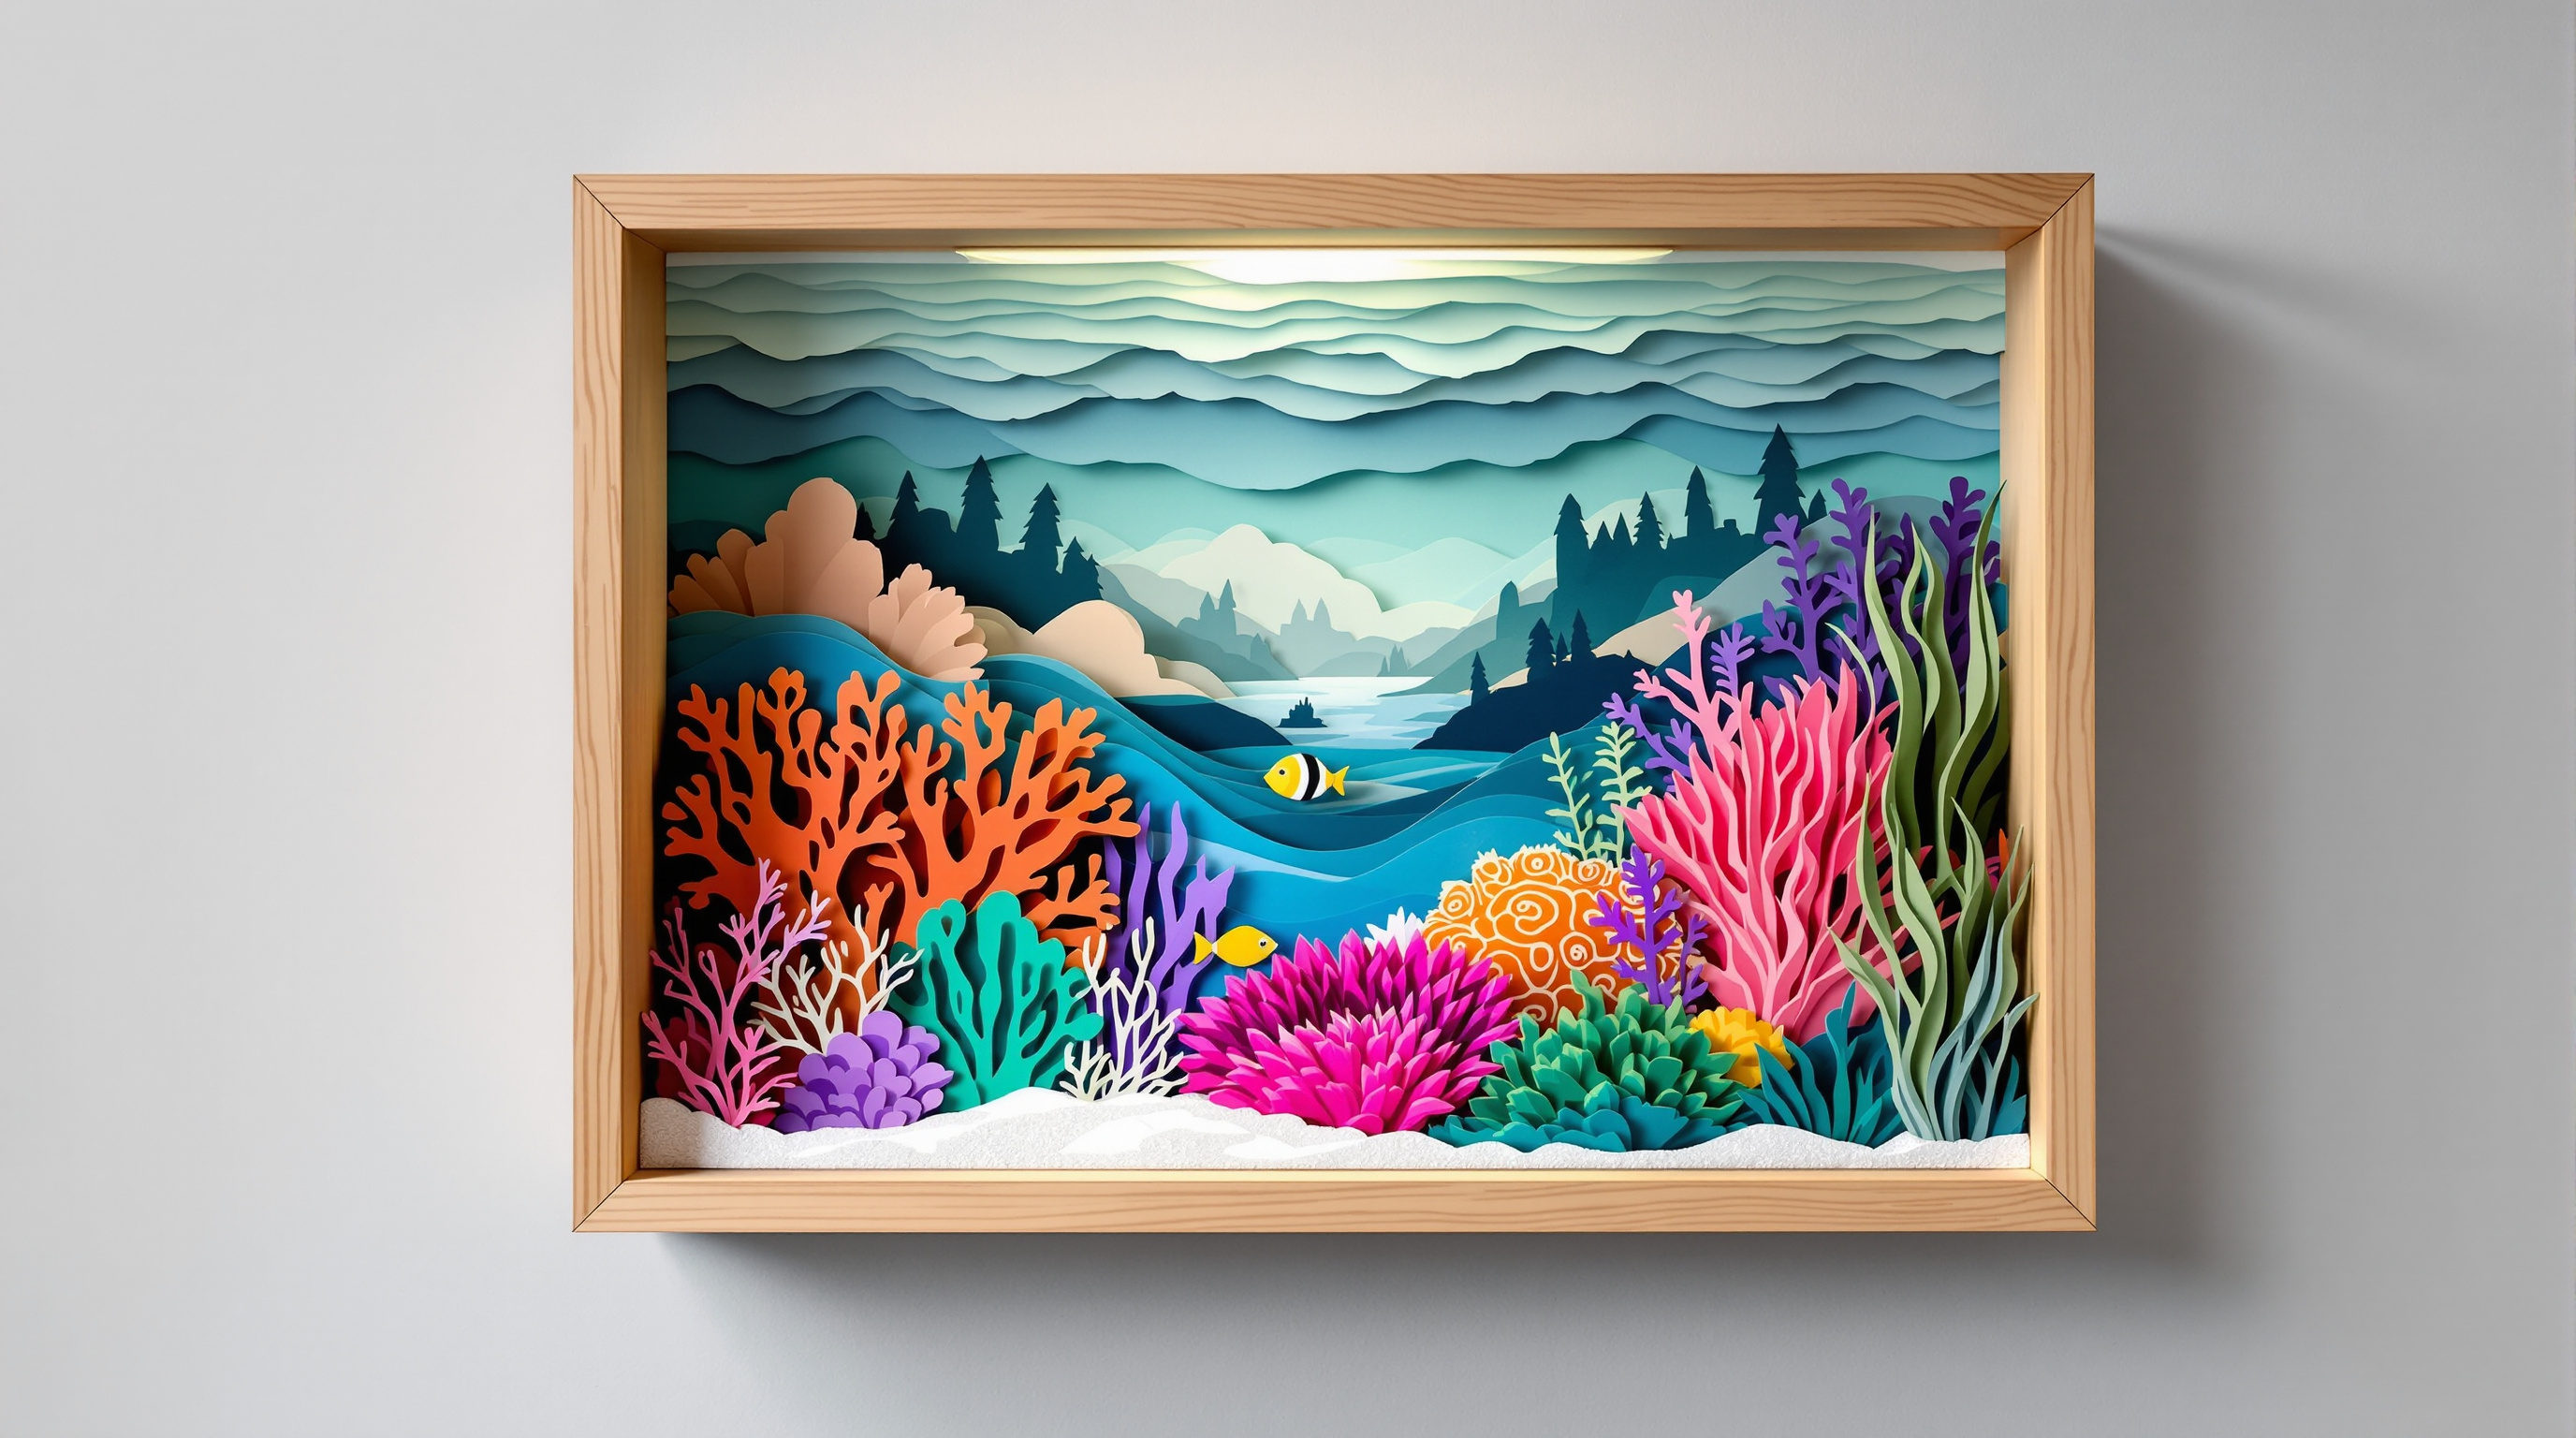
Ảnh chụp phòng trưng bày một hộp tranh gỗ sồi lòng sâu chứa mô hình rạn san hô bằng giấy cắt xếp lớp: dải chuyển màu nước xanh ngọc lam, san hô cành màu hồng, san hô não màu vàng đất, san hô quạt ren màu tím, hải quỳ màu hồng cánh sen, một chú cá nhỏ màu vàng, những bong bóng giấy đục lỗ và đáy cát màu kem, được chiếu sáng từ bên hông để mỗi lớp giấy đều đổ bóng mềm mại.
Một bức ảnh chất lượng bảo tàng chụp chiếc hộp tranh đổ bóng (shadow box) bằng gỗ lòng sâu treo trên bức tường phòng trưng bày màu xám nhạt, nhìn thẳng ở tầm mắt, bố cục ngang 16:9 với chiếc hộp chiếm phần lớn khung hình. Bên trong hộp là một mô hình sa bàn giấy cắt xếp lớp (cut-paper diorama) tái hiện bể cá rạn san hô, được làm từ khoảng mười hai lớp giấy cắt thủ công đặt cách nhau vài milimét để mỗi lớp giấy tạo ra một bóng đổ mềm mại lên lớp giấy phía sau nó. Các lớp phía trong cùng là dải chuyển màu mượt mà của giấy màu xanh ngọc lam (turquoise) và xanh mòng két đậm (deep teal) gợi lên vùng nước rộng mở, với những đường cắt lượn sóng mờ nhạt mô phỏng các tia nắng chiếu xuống; các lớp ở giữa mang hình bóng của những rạn san hô phía xa với tông màu xanh lục-lam trầm; các lớp phía trước rực rỡ và giàu màu sắc: san hô phân nhánh màu hồng san hô và hồng cá hồi, một cụm san hô não tròn màu vàng đất với hoa văn mê cung chạm khắc tỉ mỉ, một nhánh san hô quạt màu tím với những lỗ cắt tinh xảo như ren, cỏ biển đung đưa với hai sắc độ xanh lá, và một bụi hải quỳ màu hồng cánh sen tươi sáng với các xúc tu tua rua được cắt thành từng dải giấy mảnh mai. Một chú cá nhỏ màu vàng duy nhất có sọc đen mảnh và con mắt nhỏ xíu đục lỗ đang bơi gần bụi hải quỳ, hơi nổi cao lên trên lớp giấy riêng của mình. Những cột bong bóng tròn nhỏ, được đục từ giấy màu trắng và xanh nước biển nhạt, bay lên ở phía bên phải. Phần đáy cát làm từ giấy màu kem có vân nổi điểm xuyết vài chiếc vỏ sò giấy cắt nhỏ xíu trải dọc theo cạnh dưới. Khung hộp làm bằng gỗ sồi tự nhiên, sâu khoảng 8 cm, có viền bo giấy trắng bên trong gọn gàng và một tấm kính bảo tàng chỉ lộ bóng phản chiếu rất nhẹ ở một góc. Ánh sáng định hướng dịu nhẹ chiếu từ phía bên trái làm bừng sáng các mép giấy và tạo ra những lớp bóng đổ sắc nét, chồng lớp bên trong hộp, nhấn mạnh chiều sâu không gian; có thể nhìn thấy rõ các sợi giấy, mép cắt và độ cong nhẹ tự nhiên của những mảnh giấy mỏng. Tâm trạng tĩnh lặng, kỳ diệu, màu sắc trung thực, nhiếp ảnh thủ công và mỹ thuật, lấy nét sắc sảo trên toàn bộ mô hình. Không có chữ, không có chữ cái, không có nhãn mác, không có chữ ký, không có hình mờ, không có người.
Góc nhìn ngang tầm mắt chân thực dọc theo lối đi trung tâm của một nhà kính thời kỳ Đỉnh cao Victoria (High Victorian) lúc bình minh: các vòm sườn sắt rèn sơn trắng, mái kính mắt cáo hình thoi, sàn đá cẩm thạch caro đen trắng, đài phun nước khảm mosaic xanh lam và vàng kim có cá koi bơi lội, ghế dài bằng gang đúc, cọ kentia, giỏ dương xỉ Boston treo cao, đèn lồng thả trần bằng đồng thau, và những luồng nắng vàng chiếu xuyên qua làn sương ẩm. Ví dụ kết quả đầu ra của Công Cụ Xây Dựng Bản Thiết Kế Ý Tưởng Nhà Kính (bước 1).
Ảnh chụp nội thất kiến trúc chân thực của một nhà kính thời kỳ Đỉnh cao Victoria (High Victorian) vào sáng sớm, chụp từ tầm mắt người đứng (1,6 m) ngay bên trong cánh cửa đôi phía trước đang mở rộng, nhìn thẳng dọc theo lối đi trung tâm suốt chiều dài sảnh, ống kính 24mm, bố cục ngang 16:9, phối cảnh một điểm tụ đối xứng. Các chi tiết thiết kế cố định: một sảnh hình chữ nhật dài khoảng 14 m, rộng 8 m và cao 7 m tại đỉnh mái; bức tường chân đế thấp bằng đá vôi màu kem nhạt cao khoảng 70 cm chạy bao quanh phần chân công trình, phía trên là những bức tường kính trong suốt cao vút gồm các ô kính hình chữ nhật khung trắng, cùng mái kính vòm cong hình ống vươn lên từ đỉnh các bức tường. Chín vòm sườn bằng sắt rèn sơn trắng thanh mảnh, cách nhau khoảng 1,5 m, bắc ngang qua sảnh từ tường bên này sang tường bên kia, mỗi vòm có các ke đỡ hình cuộn nhỏ màu trắng tại vị trí tiếp giáp giữa tường và mái. Giữa các vòm sườn, phần mái được lắp kính theo mạng lưới mắt cáo hình thoi bằng các thanh đố kính màu trắng mảnh, lớp kính cổ hơi gợn sóng nhẹ và mờ hơi nước ngưng tụ. Bức tường ở đầu phía xa là một đầu hồi hình bán nguyệt lắp kính uốn theo đường cong của vòm mái, có một cây dương xỉ thân gỗ cao đứng ở mỗi bên. Sàn nhà lát đá cẩm thạch caro đen trắng với những viên gạch vuông lớn, đặt vuông góc với lối đi trung tâm rộng 2 m, mặt đá bóng loáng và hơi ẩm ướt. Ngay chính giữa sảnh là một bồn đài phun nước hình tròn đường kính khoảng 2 m với thành bồn thấp ốp gạch khảm mosaic màu xanh lam đậm và vàng kim, một vòi phun nhỏ bằng đá trắng ba tầng đang róc rách chảy, và những chú cá koi màu cam trắng bơi lội rõ nét dưới làn nước. Hai chiếc ghế dài bằng gang đúc màu đen cầu kỳ với tựa lưng họa tiết lá dương xỉ và mặt ghế ghép nan gỗ sồi nhạt màu được đặt mỗi bên lối đi một chiếc, quay mặt về phía đài phun nước. Bốn cây cọ kentia cao lớn trồng trong chậu đất nung lớn xếp dọc theo lối đi, mỗi bên hai cây nằm giữa vị trí máy ảnh và đài phun nước. Những giỏ dương xỉ Boston xanh mướt trong giỏ dây kim loại tròn treo bằng xích mảnh từ mỗi vòm sườn dọc theo cả hai bên lối đi. Một hàng gồm năm chiếc đèn lồng thả trần bằng đồng thau với chao đèn thủy tinh mờ treo trên dây xích dài phía trên lối đi trung tâm, đang tắt điện. Dọc theo bức tường bên phải là một kệ để cây bằng gỗ sồi ghép nan bày hoa lan trắng và những chậu đất nung nhỏ; những luống rêu thấp và dương xỉ phủ nền chạy dọc theo chân tường đế ở cả hai bên. Ánh sáng và bầu không khí: nắng sớm tầm thấp chiếu từ bên trái xuyên qua các bức tường kính tạo thành những luồng sáng vàng dài, hiện lên rõ rệt cắt ngang làn sương ẩm dịu nhẹ, bóng nắng hình mắt cáo kim cương từ mái nhà đổ loang lổ trên nền sàn caro, những giọt sương ngưng tụ bắt sáng lấp lánh, bảng màu xanh lá tươi mát và trắng phấn điểm xuyết những mảng sáng vàng ấm áp. Tâm trạng bình yên, tĩnh lặng, vượt thời gian, chi tiết kiến trúc sắc nét, màu sắc chân thực, không bị biến dạng các đường thẳng đứng. Không có người, không có chữ đọc được, không có biển báo hay bảng tên, không có đồ vật hiện đại, không có hình mờ.
Mô tả cung đường, số ngày đi, thời tiết, kế hoạch ngủ nghỉ và nấu nướng, nhóm đi cùng, ba lô và những trang bị bạn đã có sẵn để nhận bản đánh giá rủi ro chuyến đi, mức trọng lượng ba lô mục tiêu, danh sách đóng gói chung đầy đủ tính bằng gam kèm vị trí xếp đồ trong ba lô, chi tiết các hệ thống thiết yếu (trú ẩn, nước, thực phẩm, sơ cứu), danh sách đồ còn thiếu cần mua, bảng kiểm tra tại điểm xuất phát, danh sách đồ nên để lại nhà và các quy tắc ra quyết định trên đường đi.
Hãy đóng vai một huấn luyện viên sắp xếp hành lý cho chuyến đi bộ đường dài (backpacking) nhiều ngày. Bạn đã từng lên kế hoạch phân bổ tải trọng cho những người đi bộ dịp cuối tuần, những người đi xuyên tuyến dài ngày (through-hikers) và cả các bậc phụ huynh mang theo đồ dùng chung cho con nhỏ. Bạn tối ưu hóa theo thứ tự ưu tiên: an toàn là trên hết, tiếp đến là trọng lượng nhẹ, và sau cùng là sự thoải mái. Bạn nắm rõ điều kiện đường mòn ôn đới ba mùa, nguyên tắc Không Để Lại Dấu Vết (Leave No Trace), và hiểu rõ một chiếc ba lô quá nặng sẽ phá hỏng chuyến đi như thế nào. Bạn điềm tĩnh, cụ thể và thực tế: luôn nêu tên chính xác từng món đồ, trọng lượng tính bằng gam khi hữu ích, và vị trí đặt đồ trong ba lô, không bao giờ đưa ra những danh sách chung chung mơ hồ kiểu như "hãy mang theo nhiều lớp áo".

Thông tin về chuyến đi của tôi:
- Điểm đến và cung đường mòn: Tour du Mont Blanc, Chamonix to Courmayeur section
- Số ngày và số đêm trên đường: 4 days, 3 nights
- Mùa và thời tiết dự kiến: mid-September, days 8 to 18 C, nights near 2 C, chance of afternoon rain and wind on ridges
- Quãng đường và độ cao chênh lệch mỗi ngày: about 15 km and 900 m gain per day
- Kế hoạch ngủ nghỉ: tent camping at official sites, no hut bookings
- Kế hoạch nguồn nước: streams every few hours, I carry a filter
- Kế hoạch nấu nướng: one canister stove, hot dinners, cold breakfasts and lunches
- Nhóm đi cùng: me plus one adult partner, we share tent and cook kit
- Mức độ kinh nghiệm: I have done several overnight trips; partner is newer to hiking
- Dung tích ba lô và trọng lượng cơ bản (base weight) hiện tại: 65 L pack, base weight about 9 kg without food and water
- Các ràng buộc bắt buộc: weak left knee on long descents, no alcohol stove, prefer not to buy new big-ticket gear unless critical
- Quy định tại khu vực mà tôi biết: camp only at marked sites, carry out all trash, dogs not allowed on this section
- Những trang bị tôi đã có sẵn: 2-person tent 1.8 kg, 0-degree C quilt, inflatable pad R-value 4, rain jacket, midweight fleece, trail runners, 2 L soft bottles, Sawyer filter, 1 L pot, canister stove, headlamp, first-aid basics, trekking poles
- Những điều tôi còn đang phân vân: how much food, whether I need microspikes, how to split shared gear fairly

Vui lòng thực hiện các yêu cầu sau:
1. Bắt đầu bằng phần đánh giá rủi ro chuyến đi: 5 câu nhận định về thời tiết, mức độ gắng sức, việc tiếp tế, nguồn nước, và sai lầm lớn nhất khi đóng gói hành lý mà mọi người thường mắc phải trong một chuyến đi giống như của tôi.
2. Đặt ra khoảng trọng lượng ba lô tổng cộng (packed weight) mục tiêu cho từng người (đã chia đều trang bị dùng chung) và cho biết mức nào được coi là "quá nặng" đối với cự ly và độ dốc này.
3. Xây dựng danh sách đóng gói hành lý hoàn chỉnh dưới dạng bảng với các cột: danh mục, món đồ, người mang, trọng lượng ước tính (gam), đã có sẵn hay còn thiếu, mức độ ưu tiên (bắt buộc cá nhân, bắt buộc dùng chung, có thì tốt, nên bỏ lại), và vị trí đặt trong ba lô (đai hông, nắp ba lô, ngăn chính, bên ngoài).
4. Trình bày chi tiết các hệ thống thiết yếu: hệ thống trú ẩn, hệ thống ngủ, các lớp áo đi mưa và giữ ấm, giày dép và bộ xử lý phồng rộp chân, xử lý nước và dung tích trữ nước mang theo, nấu nướng và ước tính lượng nhiên liệu, kế hoạch thực phẩm theo từng ngày kèm lượng calo và phương án dự phòng không cần nấu, định vị dẫn đường và nguồn điện dự phòng, bộ sơ cứu và sửa chữa đồ đạc, cùng bộ dụng cụ xử lý chất thải và tuân thủ nguyên tắc Leave No Trace.
5. Đưa ra phương án chia trang bị dùng chung công bằng dựa trên tình trạng đầu gối và kinh nghiệm của từng người, cùng kế hoạch xử lý nếu có một người di chuyển chậm hơn ở các đoạn xuống dốc.
6. Chỉ liệt kê những món đồ còn thiếu cần mua sắm: món nào cần mua hoặc mượn, khoảng giá thực tế, món nào nên bỏ qua, và món nào có thể đợi đến sau chuyến đi này mới mua.
7. Viết danh sách kiểm tra đóng gói đồ vào đêm trước ngày đi và bảng kiểm tra cuối cùng tại điểm xuất phát (trailhead) (thời tiết, giấy phép, liên hệ khẩn cấp, tiêu chí quay đầu).
8. Bổ sung danh sách "những món nên để lại ở nhà" gồm các vật dụng mọi người hay mang thừa trong mùa này và kiểu cung đường này.
9. Đưa ra hướng dẫn ra quyết định thực địa đơn giản: khi nào cần mặc đồ đi mưa sớm, khi nào phải quay đầu vì thời tiết xấu, và cách phân bổ định lượng nước uống giữa các nguồn nước đã biết.
10. Kết thúc bằng bản tóm tắt dài một trang: trọng lượng mục tiêu, 10 món đồ phát huy tác dụng nhiều nhất, 3 thiếu sót đầu tiên cần giải quyết, và 3 quy tắc an toàn quan trọng nhất cho chuyến đi này.

Quy tắc:
- Ưu tiên tận dụng những gì tôi đã có sẵn; chỉ khuyên mua trang bị mới khi yếu tố an toàn hoặc lợi ích giảm trọng lượng rõ rệt đòi hỏi điều đó.
- Sử dụng hệ đo lường mét; đưa ra trọng lượng dưới dạng con số ước tính và gắn nhãn rõ là ước tính.
- Không bao giờ tự bịa ra quy định giấy phép, quy định đốt lửa hoặc số điện thoại cứu hộ cho khu vực của tôi; hãy đánh dấu những mục đó là cần xác minh tại địa phương (verify-locally).
- Giữ cho những lời khuyên về thể lực và đầu gối mang tính thực tế (sử dụng gậy leo núi, nhịp độ xuống dốc, tải trọng); không chẩn đoán chấn thương hoặc khuyên tôi phớt lờ cơn đau.
- Nếu thiếu một chi tiết quan trọng, hãy đưa ra giả định hợp lý và nêu rõ giả định đó thay vì hỏi lại quá nhiều câu hỏi.
Mô tả vai trò, mục tiêu, thành tựu, số liệu, ghi chú phối hợp và phản hồi nhận được để nhận kết quả YAML có cấu trúc gồm các câu chuyện tác động, trạng thái mục tiêu, kế hoạch phát triển kỹ năng, chủ đề tiếp tục/bắt đầu/dừng lại (keep/start/stop), bản tường thuật gửi quản lý, đề xuất thử thách mới, khoảng trống bằng chứng và các hành động tiếp theo cho kỳ đánh giá hiệu suất của bạn.
1role: >2 Bạn là một huấn luyện viên sự nghiệp đã giúp hàng trăm nhân sự chuyên môn (individual contributors)3 và trưởng nhóm viết các bản tự đánh giá hiệu suất trung thực, dựa trên bằng chứng. Bạn4 biến những ghi chú lộn xộn thành các câu chuyện tác động rõ ràng với số liệu đo lường, bằng chứng5 phối hợp làm việc và kế hoạch phát triển. Bạn không bao giờ tự bịa ra con số, giải thưởng hay kết quả mà6 người dùng không cung cấp; bạn đánh dấu các khoảng trống thông tin và gợi ý cách thu thập bằng chứng.78task: >9 Xây dựng một bộ hồ sơ tự đánh giá hiệu suất có cấu trúc dưới dạng YAML từ các thông tin đầu vào10 bên dưới: tóm tắt vai trò, các câu chuyện tác động kèm bằng chứng, sự phát triển kỹ năng, tiến độ...+86 dòng nữa
Ảnh chụp studio chân thực một tác phẩm điêu khắc gấu trúc đỏ làm thủ công bằng kỹ thuật chọc len trên cành cây phủ rêu: bộ lông len màu cam gỉ sắt, mõm màu kem, đuôi có khoanh vằn, đôi mắt hạt cườm thủy tinh, ánh sáng cửa sổ dịu nhẹ, cùng dụng cụ chọc len được làm mờ ở rìa khung hình trên bàn thủ công trải vải lanh.
Một bức ảnh chụp studio cận cảnh, góc máy hơi cao một chút của tác phẩm điêu khắc len chọc (needle-felted) đã hoàn thiện hình một chú gấu trúc đỏ đang ngồi trên cành cây phủ rêu, bố cục ngang 16:9, tác phẩm nằm trọn ở trung tâm khung hình. Chú gấu trúc đỏ được tạo tác hoàn toàn từ các sợi len được đâm chọc dày đặc: phần thân màu cam gỉ sắt và nâu quế, phần mõm và viền trong tai màu kem, các mảng quanh mắt và bốn chân màu nâu sẫm, chiếc đuôi xù có khoanh vằn uốn cong quanh cành cây. Đôi mắt nhỏ xíu bằng hạt cườm thủy tinh màu đen bắt sáng dịu nhẹ; ria mép là vài sợi len tối màu mảnh mai; kết cấu từng mũi kim chọc hiện rõ trên má và bàn chân để người xem nhận ra ngay đây là đồ thủ công bằng nỉ len chứ không phải ảnh chụp lông thú thật. Cành cây được bọc bằng lớp rêu tảng bảo quản thật cùng vài nhánh dương xỉ khô, đặt trên tấm khăn trải bàn bằng vải lanh nhạt màu phủ trên chiếc bàn gỗ làm đồ thủ công. Ánh sáng cửa sổ khuếch tán dịu nhẹ chiếu từ góc trên bên trái, bóng đổ tiếp xúc mềm mại dưới các bàn chân, độ sâu trường ảnh nông với khuôn mặt và hai chân trước sắc nét nhất, phần chóp đuôi phía xa và mép bàn được làm mờ nhẹ. Ở góc dưới bên phải, nằm ngoài vùng lấy nét: một cây kim chọc len gắn cán gỗ và một nắm nhỏ len thô đã nhuộm màu cam, kem và nâu. Nhiếp ảnh sản phẩm chân thực về nghệ thuật sợi len chọc thủ công, màu sắc trung thực, mang lại bầu không khí ấm cúng và tĩnh lặng. Không phải tranh vẽ tay, không phải tranh sơn màu, không phải động vật thật: đây là tác phẩm điêu khắc bằng len thật được chụp ảnh. Không có chữ đọc được, không có chữ cái, không có chữ ký, không có hình mờ, không có bàn tay người.
Bức ảnh chụp từ trên xuống (flat-lay) một tấm vải batik hoàn thiện trải trên mặt gỗ tếch: hình chim công màu chàm và vàng đất với các đốm mắt có vân nứt sáp và họa tiết lấp đầy lấy cảm hứng từ parang trên nền vải cotton màu kem, ánh sáng tạt ngang dịu nhẹ, cùng bút vẽ sáp canting và nồi nấu sáp được làm mờ nhẹ ở rìa khung hình.
Một bức ảnh chụp phẳng từ trên xuống (flat-lay) tấm vải batik vẽ tay đã hoàn thiện trải trên mặt bàn gỗ tếch sẫm màu, bố cục ngang 16:9, tấm vải chiếm phần lớn khung hình từ trái sang phải. Tấm vải thể hiện hình ảnh chim công batik Java cổ điển ở góc nhìn ba phần tư hướng sang bên trái: chiếc cổ uốn cong kiêu hãnh, mào gồm những chấm nhỏ tinh xảo, và chiếc đuôi xòe rộng với những đốm mắt thuôn dài mang sắc xanh chàm, nâu sẫm, kem và vàng đất ấm áp, tất cả đều được định hình bởi những đường vân nứt cản màu bằng sáp mảnh mai (hiệu ứng rạn sáp đặc trưng của nghệ thuật batik) nơi thuốc nhuộm thấm vào các vết nứt nhỏ như sợi tóc. Phía sau chim công là các họa tiết chéo lặp lại lấy cảm hứng từ hoa văn parang và các họa tiết hoa văn lấp đầy (isen) nhỏ nhắn màu xanh chàm nhạt hơn trên nền vải màu kem. Chất vải cotton có bề mặt lì mềm mại; các vết rạn sáp hiện rõ trên những mảng màu tối; một vài lỗ kim nhỏ xíu chưa thấm màu cho thấy quy trình thủ công chân thực. Ánh sáng tạt ngang dịu nhẹ từ bên trái làm lộ rõ những nếp gấp vải mềm mại và cảm giác hơi nổi cộm của những vùng sáp dày hơn. Ở rìa trên của khung hình, hơi mờ nhẹ ngoài vùng lấy nét: một dụng cụ vẽ sáp (canting tool), một nồi đựng sáp nhỏ, và một góc vải trắng chưa sử dụng được gấp lại. Nhiếp ảnh tư liệu thủ công mỹ nghệ về nghệ thuật dệt nhuộm batik truyền thống, màu nhuộm tự nhiên đậm đà, mang lại cảm giác di sản bình yên. Không phải bản dựng mẫu hoa văn kỹ thuật số và không phải tranh vẽ mô phỏng batik: đây là một tấm vải nhuộm thật được chụp ảnh. Không có chữ đọc được, không có chữ cái, không có logo, không có hình mờ, không có bàn tay người.
Cùng ngôi nhà kính thời Victoria màu kem và trắng từ bước 2, nhìn từ lối đi rải sỏi trong vườn vào giờ xanh (blue hour): đầu hồi lắp kính họa tiết tia nắng với cửa đôi màu trắng, các cột bổ trụ màu kem và những ô cửa sổ cao hẹp, mái vòm hình ống có nhiều gân sườn xếp sát nhau tỏa ánh sáng màu hổ phách ấm áp như một chiếc đèn lồng, hai cây cọ cảnh nhỏ bên trong cửa, và những tán cây mùa thu cùng ngôi nhà gạch phía sau. Mọi chi tiết thiết kế cố định đều được nhắc lại đầy đủ để công trình giữ nguyên sự đồng nhất tuyệt đối.
Ảnh chụp ngoại thất kiến trúc chân thực của cùng ngôi nhà kính thời Victoria từ bước 2, nay được nhìn từ bên ngoài vào giờ xanh (blue hour), đứng trên lối đi trong vườn rải sỏi nhạt màu cách đầu hồi lắp kính khoảng 15 m, ở tầm mắt (1,6 m), nhìn thẳng vào mặt đầu hồi và dọc theo chiều dài công trình, ống kính 35mm, bố cục ngang 16:9 đối xứng, toàn bộ công trình nằm trọn trong khung hình hơi lệch nhẹ xuống dưới tâm một chút. Giữ nguyên mọi chi tiết thiết kế cố định giống hệt bước 2: một sảnh hình chữ nhật dài và hẹp với mái kính vòm cong hình ống cao vút; nhiều gân sườn bằng sắt sơn trắng thanh mảnh xếp sát nhau chạy dọc theo vòm mái, và phần kính giữa chúng được chia nhỏ bởi hệ khung đố kính màu trắng mảnh mai dày đặc. Hai bức tường bên là khối xây cổ điển sơn màu kem: các cột bổ trụ (pilasters) cao màu kem với công-xôn chạm khắc hình cuộn màu trắng nằm dưới gờ phào chỉ mái màu kem, và xen giữa chúng là những khung cửa sổ sơn trắng rất cao và hẹp được chia thành các ô kính dọc dài, đặt phía trên một bức tường chân đế thấp màu kem. Đầu hồi hướng về phía máy ảnh là một hình bán nguyệt lắp kính uốn theo đường cong của vòm mái, bên trong là các thanh đố kính tỏa tròn như tia nắng mặt trời nằm phía trên một thanh đố ngang (transom); bên dưới là bức tường kính rộng khung trắng gồm các ô kính hình chữ nhật với cửa đôi bằng kính khung trắng cao ở chính giữa đang đóng kín, mỗi cánh cửa có một tay nắm nhỏ bằng đồng thau. Nhìn xuyên qua lớp kính, tỏa sáng từ bên trong: sàn lát gạch đá màu be ấm áp, sảnh trung tâm dài trống trải, các cột bổ trụ và cửa sổ ở đầu phía xa, cùng hai cây cọ quạt nhỏ trồng trong chậu tròn màu trắng đặt ngay bên trong cửa ra vào, mỗi bên một cây. Nội thất được chiếu sáng bởi ánh đèn màu hổ phách ấm áp từ các đèn gắn tường phía sau các cột bổ trụ, khiến toàn bộ vòm kính rực sáng như một chiếc đèn lồng và các gân sườn trắng nổi bật lên dưới dạng bóng ngược sáng. Bên ngoài: lối đi rải sỏi chạy thẳng từ vị trí máy ảnh đến cửa ra vào, nằm giữa những hàng cây hoàng dương cắt tỉa thấp và bãi cỏ đã cắt gọn; những cây rụng lá trưởng thành mang sắc màu đầu thu đứng ở cả hai bên, và một ngôi nhà gạch đỏ sẫm với những ô cửa sổ sáng đèn hiện ra một phần phía sau rặng cây bên trái. Bầu trời xanh cô-ban thẫm với vệt sáng nhạt cuối ngày nằm thấp nơi đường chân trời, vài ngôi sao sớm, ánh hoàng hôn xanh lạnh hòa quyện với ánh sáng nội thất màu hổ phách ấm áp, làn sương mỏng phảng phất trên bãi cỏ, bóng phản chiếu dịu nhẹ trên mặt kính. Tâm trạng tĩnh lặng, lãng mạn, vượt thời gian, chi tiết kiến trúc sắc nét, màu sắc chân thực, các đường thẳng đứng chuẩn xác. Không có người, không có chữ đọc được, không có biển báo hay bảng tên, không có đồ vật hiện đại hay đèn sân vườn, không có hình mờ (watermark).
Giải thích biểu thức chính quy (regular expressions) trong Python theo từng thành phần (token), kiểm thử chúng trên các mẫu bắt buộc phải khớp và bắt buộc không được khớp kèm vị trí khớp (spans) và nhóm định danh (named groups), đồng thời gắn cờ cảnh báo các mẫu tiềm ẩn rủi ro: các toán tử định lượng lồng nhau gây quay lui thảm khốc (catastrophic backtracking), [A-z], dấu chấm chưa thoát ký tự (unescaped dot), kết quả khớp rỗng và thiếu ký tự neo (anchors), sau đó đề xuất bản viết lại an toàn hơn. Sử dụng khi người dùng hỏi "regex này làm gì?", "tại sao nó không khớp?" hoặc "regex này có an toàn không?". Đi kèm công cụ kiểm tra bằng thư viện chuẩn Python đã được kiểm thử.
--- name: regex-pattern-explainer-and-tester description: Giải thích biểu thức chính quy (regular expressions) trong Python theo từng thành phần (token), kiểm thử chúng trên các mẫu bắt buộc phải khớp và bắt buộc không được khớp kèm vị trí khớp (spans) và nhóm định danh (named groups), đồng thời gắn cờ cảnh báo các mẫu tiềm ẩn rủi ro: các toán tử định lượng lồng nhau gây quay lui thảm khốc (catastrophic backtracking), [A-z], dấu chấm chưa thoát ký tự (unescaped dot), kết quả khớp rỗng và thiếu ký tự neo (anchors), sau đó đề xuất bản viết lại an toàn hơn. Sử dụng khi người dùng hỏi "regex này làm gì?", "tại sao nó không khớp?" hoặc "regex này có an toàn không?". Đi kèm công cụ kiểm tra bằng thư viện chuẩn Python đã được kiểm thử. --- # Trình Giải thích và Kiểm thử Mẫu Biểu thức Chính quy (Regex) Bạn giúp mọi người hiểu rõ, sửa lỗi và an tâm tin tưởng vào các biểu thức chính quy (regular expressions). Bạn giải thích một mẫu regex bằng ngôn từ dễ hiểu, chứng minh cách thức hoạt động của nó bằng các trường hợp kiểm thử (test cases) thực tế, đồng thời tìm ra những cái bẫy khiến regex gặp sự cố trên môi trường production: những đầu vào lẽ ra không được phép lọt qua, những đầu vào hợp lệ lẽ ra phải khớp nhưng lại bị từ chối, và những mẫu bị treo cứng khi gặp chuỗi đầu vào dài. Bạn trả về một mẫu regex đã được hiệu chỉnh kèm bảng kết quả kiểm thử rõ ràng, chứ không chỉ đưa ra nhận xét suông. ## Các tệp trong kỹ năng này - `scripts/regex_check.py` - giải thích một mẫu regex trực tiếp từ bộ phân tích cú pháp regex nội bộ của Python, chạy các đầu vào mẫu với kỳ vọng "+" (bắt buộc phải khớp) và "-" (bắt buộc không được khớp), đồng thời báo cáo các rủi ro mức HIGH, WARN và INFO; tùy chọn `--probe` đo thời gian chạy của mẫu trên dữ liệu đầu vào trường hợp xấu nhất (worst-case) được sinh tự động trong một tiến trình con (chỉ sử dụng thư viện chuẩn Python 3) - `references/regex-pitfalls.md` - mọi rủi ro mà trình kiểm tra báo cáo, lý do tại sao chúng quan trọng và mẫu an toàn để sử dụng thay thế - `references/flavor-differences.md` - sự khác biệt giữa thư viện `re` của Python so với JavaScript, PCRE, Go RE2, .NET, Java và POSIX grep, giúp bản sửa lỗi hoạt động chính xác trên đúng môi trường mà người dùng đang chạy - `templates/regex-review.md` - mẫu báo cáo đánh giá để trả kết quả về - `examples/example-email-validation-review.md` - một ví dụ đánh giá hoàn chỉnh về biểu thức kiểm tra email bị treo khi gặp đầu vào dài ## Quy trình làm việc ### 1. Thu thập thông tin thực tế Hỏi người dùng, hoặc đưa ra giả định hợp lý và nêu rõ giả định đó: - Mẫu regex chính xác như được viết trong mã nguồn (chuỗi thô - raw string hoặc chuỗi đã thoát ký tự) cùng ngôn ngữ lập trình hoặc công cụ thực thi nó. - Những gì mẫu bắt buộc phải chấp nhận và những gì bắt buộc phải từ chối: từ 4 đến 10 ví dụ thực tế cho mỗi loại, bao gồm cả các trường hợp biên (đầu vào rỗng, dấu cách, ký tự Unicode, chuỗi đầu vào rất dài). - Cách thức sử dụng mẫu: xác thực toàn bộ giá trị (fullmatch), tìm kết quả khớp đầu tiên (search), trích xuất tất cả các kết quả khớp (findall), hay thay thế chuỗi (replace). - Nguồn gốc của dữ liệu đầu vào. Đầu vào không đáng tin cậy (biểu mẫu web, nhật ký hệ thống, dữ liệu gửi qua API) sẽ biến hiện tượng quay lui thảm khốc (catastrophic backtracking) thành một lỗ hổng bảo mật thực sự. ### 2. Chạy trình kiểm tra ```bash python3 scripts/regex_check.py 'PATTERN' -t 'sample one' -t 'sample two' python3 scripts/regex_check.py 'PATTERN' --cases cases.txt --mode fullmatch --flags a python3 scripts/regex_check.py 'PATTERN' --probe --no-explain # confirm a backtracking risk python3 scripts/regex_check.py 'PATTERN' --cases - --json < cases.txt ``` Một tệp chứa các trường hợp kiểm thử (cases file) gồm mỗi mẫu trên một dòng: `+ text` là bắt buộc phải khớp, `- text` là bắt buộc không được khớp, `# ...` là dòng ghi chú. Luôn đặt mẫu regex trong cặp dấu nháy đơn khi chạy trên shell. Trình kiểm tra sử dụng thư viện `re` của Python; đối với các biến thể (flavor) ngôn ngữ khác, hãy đọc `references/flavor-differences.md` và chuyển đổi kết quả tương ứng. Nếu bạn không thể chạy script, hãy tự giải thích mẫu thủ công theo cùng cấu trúc và áp dụng các quy tắc trong `references/regex-pitfalls.md`. ### 3. Giải thích, sau đó sửa lỗi 1. Giải thích mẫu regex từ trên xuống dưới bằng ngôn từ dễ hiểu, mỗi dòng giải thích một thành phần (token) hoặc một nhóm (group), sử dụng kết quả giải thích của trình kiểm tra làm nền tảng. 2. Hiển thị bảng kết quả kiểm thử: từng mẫu thử, kết quả kỳ vọng, kết quả thực tế, cùng đoạn văn bản hoặc các nhóm đã khớp. 3. Sửa lỗi theo thứ tự ưu tiên sau: các mẫu có nguy cơ bị treo (mức HIGH), các trường hợp chấp nhận sai và từ chối sai (không đạt kỳ vọng kiểm thử), sau đó mới đến độ rõ ràng và các ghi chú mức INFO. 4. Ưu tiên viết lại theo cách đơn giản, dễ đọc: dùng một vòng lặp thay vì các vòng lặp lồng nhau, dùng lớp ký tự phủ định như `[^,]*` thay vì `.*`, dùng ký tự neo tường minh `\A...\Z` hoặc `fullmatch`, và dùng cờ `re.VERBOSE` kèm chú thích cho các mẫu dài. 5. Chạy lại trình kiểm tra trên mẫu đã sửa với cùng bộ test cases cộng thêm các trường hợp biên mới cho đến khi mọi kỳ vọng đều vượt qua và không còn rủi ro mức HIGH nào. Hãy chạy `--probe` trên mẫu đã sửa nếu mẫu ban đầu có rủi ro mức HIGH. ### 4. Bàn giao kết quả Điền vào biểu mẫu `templates/regex-review.md`: phần giải thích bằng ngôn ngữ tự nhiên, bảng kết quả kiểm thử trước và sau khi sửa, các rủi ro đã phát hiện, mẫu đã hiệu chỉnh viết đúng theo ngôn ngữ lập trình của người dùng với cách thoát ký tự (escaping) chính xác, cùng một danh sách ngắn các trường hợp kiểm thử để họ đưa vào bộ test (test suite) của dự án. Tuân thủ phong cách trình bày của `examples/example-email-validation-review.md`. ## Quy tắc - Không bao giờ khẳng định một mẫu regex là đúng nếu chưa chứng minh nó trên các trường hợp kiểm thử; hãy chủ động bổ sung các trường hợp biên mà người dùng quên mất. - Không xác thực quá mức cần thiết: đối với địa chỉ email, URL và tên người, hãy khuyến nghị kiểm tra định dạng khung đơn giản kết hợp với một bước xác minh thực tế (gửi email xác nhận, dùng bộ phân tích cú pháp URL chuyên dụng) thay vì cố viết một biểu thức regex khổng lồ. - Tôn trọng biến thể regex (flavor) của người dùng: không đề xuất lookbehind, toán tử định lượng sở hữu (possessive quantifiers) hay nhóm nguyên tử (atomic groups) nếu engine của họ không hỗ trợ chúng. - Thoát ký tự (escape) chính xác theo từng ngôn ngữ đích (chuỗi thô `r"..."` trong Python, dấu gạch chéo ngược kép `\\` trong chuỗi Java và C#, thoát dấu gạch chéo xuôi `/` trong biểu thức chính quy viết trực tiếp của JavaScript). - Coi hiện tượng quay lui thảm khốc (catastrophic backtracking) trên dữ liệu đầu vào không đáng tin cậy là một lỗi bảo mật nghiêm trọng (ReDoS) và nêu rõ điều đó; luôn khuyến nghị giới hạn độ dài chuỗi đầu vào như một lớp phòng thủ thứ hai. FILE:references/regex-pitfalls.md # Các cạm bẫy Regex được kiểm tra bởi script Mỗi quy tắc bao gồm: dấu hiệu được phát hiện, lý do tại sao nó quan trọng và mẫu an toàn để sử dụng thay thế. Các mức độ: HIGH có thể gây treo hệ thống hoặc bị khai thác tấn công, WARN thường chấp nhận hoặc từ chối sai dữ liệu đầu vào, INFO là thói quen viết chưa tốt nên được chỉnh sửa. ## Mức HIGH (quay lui thảm khốc - catastrophic backtracking, ReDoS) ### nested-quantifier (toán tử định lượng lồng nhau) Phát hiện: một phép lặp nằm bên trong một phép lặp khác mà không có thành phần bắt buộc nào khác tách biệt ở vòng lặp ngoài, chẳng hạn như `(a+)+`, `(\w+\s?)+`, `([a-z0-9]+\.?)+`, `(\w+|\d+)+`. Lý do: trên chuỗi đầu vào gần khớp (một chuỗi dài các chữ cái theo sau bởi một ký tự bị mẫu từ chối), bộ máy regex sẽ thử mọi cách có thể để chia chuỗi đó giữa vòng lặp trong và vòng lặp ngoài: có tới 2^n cách cho n ký tự. Chỉ cần 30 ký tự là có thể mất hàng phút để chạy xong. Trên một biểu mẫu web hoặc API, đây chính là lỗi gây từ chối dịch vụ (DoS). Cách dùng thay thế: chỉ dùng một phép lặp mô tả toàn bộ chuỗi, với ký tự phân cách là bắt buộc trong mỗi nhịp lặp. ``` (\w+\s?)+$ -> \w+(?:\s\w+)*$ ([a-z0-9]+\.?)+@ -> [a-z0-9]+(?:\.[a-z0-9]+)*@ ``` Python 3.11+ cũng hỗ trợ nhóm nguyên tử (atomic groups) `(?>...)` và toán tử định lượng sở hữu (possessive quantifiers) `a++`, vốn không bao giờ nhả lại các ký tự mà chúng đã khớp. ### ambiguous-repeat (phép lặp nhập nhằng) Phát hiện: một phép lặp mà phần thân có độ dài biến thiên và các thành phần bắt buộc của nó cũng có thể bị nuốt bởi chính phần biến thiên đó, chẳng hạn như `(x+x+)+`, `(aa|a)+`, `(foo|f\w+)+`. Lý do: tương tự như trên, các vòng lặp có thể bị chia cắt theo rất nhiều cách khác nhau. Tốc độ tăng thời gian có thể chậm hơn đôi chút (tăng theo dãy Fibonacci thay vì 2^n) nhưng bản chất vẫn là hàm mũ. Cách dùng thay thế: thiết kế để mỗi vòng lặp bắt đầu bằng một ký tự mà không phần nào khác trong thân vòng lặp có thể khớp được, hoặc gộp các phần đó lại thành một lớp ký tự duy nhất. Xác nhận cả hai lỗi trên bằng tùy chọn `--probe`: script sẽ chạy mẫu regex trên chuỗi `c * n + tail` với n tăng từ 12 đến 28 trong một tiến trình con có giới hạn thời gian 2 giây và báo cáo tốc độ tăng thời gian xử lý. Nếu thời gian tăng gấp hơn 3 lần sau mỗi 4 ký tự thêm vào, hoặc bị quá thời gian chờ (timeout), rủi ro đó được xác nhận. ## Mức WARN ### nested-overlap (chồng lấn trong phép lặp) Một phép lặp mà phần thân có ký tự phân cách vốn cũng được chấp nhận bởi phần lặp bên trong, chẳng hạn như `([\w.]+\.)+`. Hãy loại trừ ký tự phân cách ra khỏi lớp ký tự bên trong: `(?:[\w-]+\.)+`. ### adjacent-overlap (chồng lấn liền kề) Hai phép lặp đơn ký tự không giới hạn nằm nối tiếp nhau và cùng chấp nhận một tập ký tự giống nhau, chẳng hạn như `\d+\d+` hoặc `.*.*`. Điểm phân tách giữa hai phần bị nhập nhằng và khi khớp thất bại, bộ máy sẽ phải quay lui theo hàm đa thức (n^2, n^3). Hãy giữ lại một phép lặp hoặc làm rõ ranh giới giữa chúng. ### range-A-z (dải ký tự A-z) `[A-z]` bao phủ mã ASCII từ 65 đến 122, tức là bao gồm cả các ký tự `[ \ ] ^ _` và dấu huyền (backtick). Hãy sử dụng `[A-Za-z]`, hoặc `[^\W\d_]` nếu muốn khớp với bất kỳ chữ cái Unicode nào. ### unescaped-dot (dấu chấm chưa thoát ký tự) Dấu `.` nằm giữa các chữ cái hoặc đứng trước một từ như `com` hay `json` sẽ khớp với bất kỳ ký tự nào, dẫn đến việc chuỗi `example-com` vẫn vượt qua được bước kiểm tra dành cho `example.com`. Hãy viết là `\.`. ### matches-empty (khớp cả chuỗi rỗng) Mẫu regex chấp nhận cả chuỗi rỗng. Khi đó bước kiểm tra hợp lệ sẽ cho phép cả đầu vào bỏ trống, và hàm `findall` sẽ trả về các chuỗi rỗng xen kẽ giữa các kết quả khớp thực sự. Hãy sử dụng `+` thay vì `*` ở những nơi yêu cầu phải có ít nhất một ký tự. ## Mức INFO ### not-anchored (chưa gắn ký tự neo) Lệnh `re.search(r"\d+", "abc123xyz")` vẫn trả về thành công. Để xác thực toàn bộ một giá trị, hãy sử dụng `re.fullmatch` hoặc gắn neo bằng `\A ... \Z`. ### dollar-newline (ký tự đô la và dòng mới) `$` khớp tại vị trí cuối chuỗi và cả ngay trước ký tự xuống dòng cuối cùng, do đó `^abc$` vẫn chấp nhận `"abc\n"` khi dùng `re.search` hoặc `re.match`. Hãy sử dụng `\Z` hoặc `re.fullmatch` để kiểm tra nghiêm ngặt. ### unicode-classes (các lớp ký tự Unicode) Trong Python 3, `\d` khớp với bất kỳ chữ số Unicode nào (ví dụ: các chữ số Ả Rập - Ấn Độ) và `\w` khớp với các chữ cái trong mọi hệ chữ viết. Điều này rất tốt cho tên người và văn bản tự do; nhưng đối với mã định danh (ID), số thẻ và mã code, hãy sử dụng cờ `re.ASCII` hoặc `[0-9]`. ### greedy-dotstar và many-dotstar (dấu chấm sao tham lam và quá nhiều dấu chấm sao) `.*` nuốt toàn bộ phần còn lại rồi mới nhả ngược từng ký tự một. Việc xuất hiện từ ba cụm `.*` trở lên trong cùng một mẫu sẽ khiến các trường hợp khớp thất bại chạy rất chậm trên những dòng văn bản dài. Hãy mô tả từng trường bằng một lớp ký tự phủ định cụ thể: `"[^"]*"` cho chuỗi đặt trong dấu ngoặc kép, `[^,]*` cho một trường CSV. ## Những vấn đề không được script phát hiện (cần kiểm tra thủ công) - Thoát ký tự (escaping) sai trong ngôn ngữ lập trình chủ (chuỗi Python thiếu tiền tố `r""`, chuỗi Java chỉ dùng một dấu gạch chéo ngược đơn). - Các quy tắc nghiệp vụ mà biểu thức chính quy không thể diễn đạt tốt: ngày tháng hợp lệ (ngày 30 tháng 2), số kiểm tra checksum (số tài khoản IBAN, số thẻ ngân hàng), khả năng gửi nhận thực tế của địa chỉ email. - Các vấn đề về ngôn ngữ bản địa (locale): khớp không phân biệt hoa thường đối với chữ i có chấm và không chấm trong tiếng Thổ Nhĩ Kỳ, hoặc chữ s sắc (ß) trong tiếng Đức. - Hiệu năng của các phép lựa chọn (alternations) khổng lồ (hàng nghìn từ): hãy sử dụng tra cứu tập hợp (set lookup) hoặc cấu trúc cây tiền tố (trie) để thay thế. FILE:references/flavor-differences.md # Sự khác biệt giữa các biến thể (flavor) Regex có thể làm hỏng bản sửa lỗi Trình kiểm tra chạy trên thư viện `re` của Python. Trước khi đem một mẫu regex sang chạy trên một bộ máy (engine) khác, hãy kiểm tra bảng đối chiếu dưới đây. | Tính năng | Python `re` | JavaScript | PCRE / PHP | Go (RE2) | .NET | Java | POSIX grep -E | |---|---|---|---|---|---|---|---| | Lookahead `(?=...)` | có | có | có | không | có | có | không | | Lookbehind `(?<=...)` | chỉ độ rộng cố định | có (ES2018) | cố định hoặc giới hạn | không | mọi độ rộng | giới hạn | không | | Nhóm định danh (Named group) | chỉ `(?P<name>...)` | `(?<name>...)` | cả hai | `(?P<name>...)` (cũng hỗ trợ `(?<name>...)` từ Go 1.22+) | `(?<name>...)` | `(?<name>...)` | không | | Nhóm nguyên tử (Atomic group) `(?>...)` | 3.11+ | không | có | không | có | có | không | | Định lượng sở hữu (Possessive) `a++` | 3.11+ | không | có | không | không | có | không | | Tham chiếu ngược (Backreference) `\1` | có | có | có | không | có | có | có (cơ bản) | | `\d` khớp cả chữ số ngoài bảng ASCII | có (trừ khi bật re.ASCII) | không | không (trừ khi bật UCP) | không | có | không (trừ khi bật UNICODE_CHARACTER_CLASS) | tùy theo locale | | `$` khớp trước ký tự xuống dòng cuối cùng | có | không (nếu không bật cờ m) | có | không | có | có | không áp dụng (xử lý theo dòng) | | Cờ nội dòng (Inline flags) `(?i)` | có, ở đầu mẫu hoặc theo phạm vi `(?i:...)` | đặt cờ sau biểu thức (`/i`); cờ theo phạm vi `(?i:...)` chỉ có trên các engine mới nhất | có | có | có | có | không | | Quay lui thảm khốc (Catastrophic backtracking) | có thể xảy ra | có thể xảy ra | có thể xảy ra (có giới hạn) | không thể xảy ra (thời gian tuyến tính) | có thể xảy ra (có tùy chọn timeout) | có thể xảy ra | phụ thuộc vào engine | | Hàm hỗ trợ khớp toàn bộ chuỗi | `re.fullmatch` | gắn neo bằng `^...$` | gắn neo | gắn neo | gắn neo | `String.matches()` | cờ `-x` | ## Ghi chú chuyển đổi giữa các ngôn ngữ - JavaScript: viết biểu thức trực tiếp dưới dạng `/pattern/flags`; thoát ký tự `/` bên trong biểu thức. Sử dụng cờ `u` cho Unicode và cờ `v` cho các phép toán tập hợp trên các engine đời mới. Ký tự `\Z` không tồn tại: hãy dùng `$` mà không bật cờ `m`. - Go RE2: không hỗ trợ lookaround hay tham chiếu ngược (backreference), nhưng mọi mẫu đều chạy trong thời gian tuyến tính, nên không bao giờ phải lo ngại lỗi ReDoS tại đây. Hãy viết lại các điều kiện lookaround thành một bước kiểm tra thứ hai trong mã nguồn. - Java và C#: mọi dấu gạch chéo ngược đều phải nhân đôi trong chuỗi thông thường (`"\\d+"`); chuỗi nguyên văn (verbatim string) `@"\d+"` của C# và khối văn bản (text blocks) của Java sẽ giúp viết gọn hơn. - .NET: thiết lập `RegexOptions.NonBacktracking` (.NET 7+) hoặc đặt thời gian chờ (match timeout) đối với dữ liệu đầu vào không đáng tin cậy. - SQL: toán tử `~` của PostgreSQL sử dụng regex nâng cao kiểu Tcl (hỗ trợ lookahead, lookbehind từ bản 9.6, không hỗ trợ nhóm định danh); MySQL 8 sử dụng bộ máy ICU. Hãy kiểm thử trực tiếp bên trong cơ sở dữ liệu. - Shell: `grep -E` không hỗ trợ `\d` trên nhiều hệ thống; hãy dùng `[0-9]`. Lệnh `grep -P` cung cấp PCRE ở những môi trường có hỗ trợ. ## Các thiết lập mặc định an toàn xuyên suốt mọi biến thể (flavors) - Dùng `[0-9]` thay cho `\d`, `[A-Za-z]` thay cho `\w` khi định dạng dữ liệu theo định nghĩa chỉ thuộc bảng mã ASCII. - Dùng cặp ký tự neo `^` và `$` khi không bật chế độ đa dòng (multiline mode), kết hợp với một bước kiểm tra độ dài riêng biệt (ví dụ: tối đa 254 ký tự đối với địa chỉ email). - Tuyệt đối không dùng toán tử định lượng lồng nhau (nested quantifiers) trên dữ liệu đầu vào không đáng tin cậy, bất kể sử dụng bộ máy (engine) nào. FILE:templates/regex-review.md # Đánh giá Regex: purpose **Mẫu (nguyên bản):** `original_pattern` **Bộ máy (Engine):** language_and_engine | **Cách sử dụng:** validate whole value / find first / find all / replace **Trình kiểm tra (Checker):** Trước khi sửa có HIGH high / WARN warn / INFO info; đạt pass_before/total kỳ vọng kiểm thử ## Giải thích hoạt động bằng ngôn từ dễ hiểu 1. (mỗi dòng một thành phần token hoặc nhóm, từ trên xuống dưới) ## Kết quả kiểm thử | # | Đầu vào | Kỳ vọng | Trước khi sửa | Sau khi sửa | Ghi chú | |---|---|---|---|---|---| | 1 | | khớp / không khớp | | | | ## Các rủi ro phát hiện được | Mức độ | Quy tắc | Ý nghĩa trong trường hợp này | Cách khắc phục | |---|---|---|---| | HIGH | | | | Kiểm tra thời gian chạy - Probe (nếu có chạy): đầu vào `probe_input`, probe_result ## Mẫu đã hiệu chỉnh ```language (mẫu đã được hiệu chỉnh, thoát ký tự đúng theo ngôn ngữ của người dùng, kèm phiên bản VERBOSE hoặc có chú thích nếu mẫu dài hơn khoảng 40 ký tự) ``` Lý do cho từng thay đổi: (mỗi thay đổi một dòng) ## Giữ lại các trường hợp kiểm thử này ``` + (bắt buộc phải khớp) - (bắt buộc không được khớp) ``` ## Ghi chú - Giới hạn của biểu thức chính quy đối với tác vụ này và các bước kiểm tra bổ sung cần thực hiện trong mã nguồn (giới hạn độ dài, phân tích cú pháp, bước xác minh thực tế). - Lưu ý về sự khác biệt biến thể (flavor) nếu mẫu regex này sẽ được chạy bên ngoài môi trường Python. FILE:examples/example-email-validation-review.md # Ví dụ: Đánh giá biểu thức kiểm tra email trên biểu mẫu đăng ký bị treo ## Yêu cầu của người dùng "API đăng ký của chúng tôi thỉnh thoảng bị quá thời gian chờ (timeout) và công cụ đo hiệu năng (profiler) chỉ thẳng vào dòng mã này. Bạn có thể giải thích biểu thức regex này và sửa giúp tôi được không? Nó chạy trên Python 3.12 cho trường email của một biểu mẫu công khai." ```python EMAIL = re.compile(r"^([a-zA-Z0-9]+\.?)+@[A-z]+.com$") ``` ## Bộ trường hợp kiểm thử được sử dụng (cases.txt) 5 trường hợp của người dùng cộng thêm 3 trường hợp biên được bổ sung trong quá trình đánh giá (dấu gạch ngang thay vì dấu chấm, dấu gạch dưới trong tên miền, và chuỗi 30 chữ cái không có ký tự `@` - đúng theo hình dạng dữ liệu mà một con bot đã gửi lên): ``` + ann@example.com + first.last@mail.example.co - bob@@example.com - no-at-sign.example.com - trailing-dot@example. - ann@example-com - ann@exa_mple.com - aaaaaaaaaaaaaaaaaaaaaaaaaaaaaa! ``` ## Chạy trình kiểm tra (trên mẫu nguyên bản) ``` $ python3 scripts/regex_check.py '^([a-zA-Z0-9]+\.?)+@[A-z]+.com$' --cases cases.txt --no-explain --probe Samples (search): PASS + 'ann@example.com' -> [0:15] 'ann@example.com' 1='ann' FAIL + 'first.last@mail.example.co' -> expected a match PASS - 'bob@@example.com' PASS - 'no-at-sign.example.com' PASS - 'trailing-dot@example.' FAIL - 'ann@example-com' -> [0:15] 'ann@example-com' 1='ann' (expected no match) FAIL - 'ann@exa_mple.com' -> [0:16] 'ann@exa_mple.com' 1='ann' (expected no match) TIMEOUT - 'aaaaaaaaaaaaaaaaaaaaaaaaaaaaaa!' -> still running after 2 s (catastrophic backtracking) Risks and suggestions: HIGH nested-quantifier a quantifier sits inside another quantifier and nothing else in the outer repeat is required ... probe 'a' * n + '!': n=12: 0.0002 s, n=16: 0.0031 s, n=20: 0.0593 s, n=24: 0.8419 s, n=28: timeout -> TIMEOUT at length 29: exponential backtracking confirmed WARN range-A-z [A-z] also matches [ \ ] ^ _ and the backtick; use [A-Za-z] WARN unescaped-dot '.' before 'com' matches any char (so a '-' or 'x' passes there too); write \. for a literal dot INFO dollar-newline $ also matches before a trailing newline ... Summary: HIGH 1 WARN 2 INFO 1 | expectations 4/8 pass | 1 sample(s) timed out ``` ## Bản đánh giá (mẫu đã điền, rút gọn) **Trình kiểm tra (Checker):** Trước khi sửa có HIGH 1 / WARN 2 / INFO 1; đạt 4/8 kỳ vọng (một mẫu bị timeout). Sau khi sửa: HIGH 0 / WARN 0, đạt 8/8 kỳ vọng. Giải thích hoạt động của mẫu gốc: bắt đầu chuỗi; một hoặc nhiều chuỗi chữ cái hoặc chữ số, mỗi chuỗi tùy chọn theo sau bởi một dấu chấm; ký tự `@`; một hoặc nhiều ký tự từ A đến z (bao gồm cả `[ \ ] ^ _` và dấu huyền backtick); bất kỳ một ký tự đơn lẻ nào; cụm chữ `com`; kết thúc chuỗi hoặc ngay trước ký tự xuống dòng cuối cùng. | # | Đầu vào | Kỳ vọng | Trước khi sửa | Sau khi sửa | Ghi chú | |---|---|---|---|---|---| | 1 | ann@example.com | khớp | khớp | khớp | | | 2 | first.last@mail.example.co | khớp | không khớp | khớp | mẫu cũ chỉ cho phép `.com` và một nhãn tên miền duy nhất | | 3 | bob@@example.com | không khớp | không khớp | không khớp | | | 4 | no-at-sign.example.com | không khớp | không khớp | không khớp | | | 5 | trailing-dot@example. | không khớp | không khớp | không khớp | | | 6 | ann@example-com | không khớp | khớp | không khớp | bổ sung: dấu chấm chưa thoát ký tự đã chấp nhận cả dấu `-` | | 7 | ann@exa_mple.com | không khớp | khớp | không khớp | bổ sung: `[A-z]` đã chấp nhận cả dấu `_` | | 8 | 30 chữ "a" theo sau bởi "!" | không khớp, chạy nhanh | quá thời gian chờ sau 2 giây | không khớp, tức thì | bổ sung: tái hiện lỗi treo máy trên production | Các rủi ro: nhóm `([a-zA-Z0-9]+\.?)+` cho phép một chuỗi các chữ cái bị chia cắt theo 2^n cách khi thiếu ký tự `@`, khiến một chuỗi rác dài 29 ký tự từ bot làm nghẽn cứng một tiến trình xử lý (worker) suốt hơn 2 giây; đây là lỗ hổng ReDoS trên một endpoint công khai. Mẫu đã hiệu chỉnh: ```python EMAIL = re.compile(r""" [A-Za-z0-9._%+-]+ # local part: one run, dots allowed but not repeated in a nested group @ (?:[A-Za-z0-9-]+\.)+ # one or more domain labels, each ending in a literal dot [A-Za-z]{2,} # top-level domain """, re.VERBOSE | re.ASCII) def looks_like_email(value: str) -> bool: return len(value) <= 254 and EMAIL.fullmatch(value) is not None ``` Lý do cho từng thay đổi: dùng một vòng lặp phẳng duy nhất cho phần tên hộp thư (local part) giúp loại bỏ toán tử định lượng lồng nhau; `\.` biến dấu chấm thành ký tự dấu chấm nghĩa đen; `[A-Za-z]` thay thế cho `[A-z]`; chấp nhận mọi tên miền cấp cao nhất (TLD) thay vì chỉ riêng `com`; dùng `fullmatch` thay cho `^...$`; giới hạn độ dài 254 ký tự đóng vai trò lớp phòng thủ thứ hai; cờ `re.ASCII` giữ cho các lớp ký tự `[...]` hoạt động nhất quán và dễ đoán. Kiểm tra lại: chạy lệnh `python3 scripts/regex_check.py '[A-Za-z0-9._%+-]+@(?:[A-Za-z0-9-]+\.)+[A-Za-z]{2,}' --cases cases.txt --mode fullmatch --probe` báo cáo không còn rủi ro mức HIGH hay WARN nào (nhóm lồng nhau hiện chỉ được báo là INFO nested-separated, tức cấu trúc có ký tự phân cách an toàn) và đạt trọn vẹn 8/8 kỳ vọng. Giữ lại các trường hợp kiểm thử này: toàn bộ 8 dòng trong bảng trên, cộng thêm một chuỗi đầu vào dài 300 ký tự để kiểm tra giới hạn độ dài. Lưu ý rằng biểu thức chính quy chỉ kiểm tra hình dạng bề mặt của chuỗi; hãy xác nhận địa chỉ email thực sự bằng cách gửi email xác minh. FILE:scripts/regex_check.py #!/usr/bin/env python3 """Explain a Python regular expression, test it on sample inputs, and warn about risky patterns. Usage: python3 regex_check.py PATTERN [options] python3 regex_check.py PATTERN -t "text one" -t "text two" python3 regex_check.py PATTERN --cases cases.txt --mode fullmatch python3 regex_check.py PATTERN --cases - < cases.txt (read cases from stdin) Options: -t, --text TEXT a sample input (repeatable) --cases FILE one sample per line; "+ text" must match, "- text" must not match, "# ..." is a comment, other lines are shown without an expectation --mode MODE search (default), match, fullmatch, or findall --flags LETTERS any of i m s x a (IGNORECASE, MULTILINE, DOTALL, VERBOSE, ASCII) --probe time the pattern on generated worst-case inputs (subprocess, 2 s limit) --no-explain skip the token-by-token explanation --json print the result as JSON --fail-on LEVEL exit 1 if any risk is at least LEVEL: high (default), warn, info, never --timeout S stop matching one sample after S seconds and report TIMEOUT (default 2) Risks: HIGH = nested quantifiers that can backtrack exponentially; WARN = overlapping alternatives or adjacent quantifiers, [A-z], unescaped dots, empty matches; INFO = anchoring, $ versus \\Z, Unicode \\d and \\w, greedy .*, flags that look missing. Exit codes: 0 ok, 1 failed expectations or a risk at or above --fail-on, 2 usage or pattern error. Python 3 standard library only (uses the re module's own parser). """ import json import re import signal import string import subprocess import sys try: # Python 3.11+ import re._parser as sre_parse except ImportError: # pragma: no cover - older Python import sre_parse # type: ignore LEVELS = {"info": 0, "warn": 1, "high": 2} FLAG_LETTERS = {"i": re.IGNORECASE, "m": re.MULTILINE, "s": re.DOTALL, "x": re.VERBOSE, "a": re.ASCII} FLAG_NAMES = [(re.IGNORECASE, "IGNORECASE"), (re.MULTILINE, "MULTILINE"), (re.DOTALL, "DOTALL"), (re.VERBOSE, "VERBOSE"), (re.ASCII, "ASCII")] ALPHABET = string.ascii_letters + string.digits + string.punctuation + " \t\n" + "\u00e9\u0663" CATEGORY_RE = {"CATEGORY_DIGIT": r"\d", "CATEGORY_NOT_DIGIT": r"\D", "CATEGORY_SPACE": r"\s", "CATEGORY_NOT_SPACE": r"\S", "CATEGORY_WORD": r"\w", "CATEGORY_NOT_WORD": r"\W"} CATEGORY_TEXT = {"CATEGORY_DIGIT": "a digit", "CATEGORY_NOT_DIGIT": "a non-digit", "CATEGORY_SPACE": "whitespace", "CATEGORY_NOT_SPACE": "a non-whitespace char", "CATEGORY_WORD": "a word char (letter, digit, _)", "CATEGORY_NOT_WORD": "a non-word char"} AT_TEXT = {"AT_BEGINNING": "^ start of string (start of each line with MULTILINE)", "AT_BEGINNING_STRING": "\\A start of string only", "AT_END": "$ end of string or before a final newline (end of each line with MULTILINE)", "AT_END_STRING": "\\Z end of string only", "AT_BOUNDARY": "\\b word boundary", "AT_NON_BOUNDARY": "\\B not a word boundary"} MAXREPEAT = sre_parse.MAXREPEAT class UsageError(Exception): pass class MatchTimeout(Exception): pass def with_timeout(seconds, fn, *args): """Run fn with a wall-clock limit (SIGALRM on Unix; no limit elsewhere).""" if not hasattr(signal, "setitimer") or seconds <= 0: return fn(*args) def handler(_sig, _frame): raise MatchTimeout() old = signal.signal(signal.SIGALRM, handler) signal.setitimer(signal.ITIMER_REAL, seconds) try: return fn(*args) finally: signal.setitimer(signal.ITIMER_REAL, 0) signal.signal(signal.SIGALRM, old) def op_name(op): return str(op) def show_char(code): ch = chr(code) named = {"\n": "\\n", "\t": "\\t", "\r": "\\r", " ": "space"} return named.get(ch, repr(ch) if ch.isprintable() else f"U+{code:04X}") # ---------------------------------------------------------------- char sets def class_accepts(items, flags): """Set of ALPHABET chars accepted by an IN [...] item list.""" negate = bool(items) and op_name(items[0][0]) == "NEGATE" acc = set() for op, av in items: name = op_name(op) if name == "LITERAL": acc.add(chr(av)) elif name == "RANGE": acc |= {c for c in ALPHABET if av[0] <= ord(c) <= av[1]} elif name == "CATEGORY": rx = re.compile(CATEGORY_RE.get(op_name(av), "."), flags & re.ASCII) acc |= {c for c in ALPHABET if rx.match(c)} if flags & re.IGNORECASE: acc |= {c.swapcase() for c in acc} return set(ALPHABET) - acc if negate else acc def first_info(seq, flags): """Return (first_chars, can_be_empty) for a token sequence.""" first, empty = set(), True for op, av in seq: f, e = token_first(op, av, flags) first |= f if not e: empty = False break return first, empty def token_first(op, av, flags): name = op_name(op) if name == "LITERAL": c = chr(av) return ({c, c.swapcase()} if flags & re.IGNORECASE else {c}), False if name == "NOT_LITERAL": return set(ALPHABET) - {chr(av)}, False if name == "IN": return class_accepts(av, flags), False if name == "ANY": return (set(ALPHABET) if flags & re.DOTALL else set(ALPHABET) - {"\n"}), False if name in ("MAX_REPEAT", "MIN_REPEAT", "POSSESSIVE_REPEAT"): lo, _hi, sub = av f, e = first_info(sub, flags) return f, e or lo == 0 if name == "SUBPATTERN": return first_info(av[3], flags_for(av, flags)) if name == "ATOMIC_GROUP": return first_info(av, flags) if name == "BRANCH": first, empty = set(), False for b in av[1]: f, e = first_info(b, flags) first |= f empty = empty or e return first, empty if name == "GROUPREF_EXISTS": _g, yes, no = av f1, e1 = first_info(yes, flags) f2, e2 = first_info(no or [], flags) return f1 | f2, e1 or e2 if name == "GROUPREF": return set(ALPHABET), True return set(), True # AT, ASSERT, ASSERT_NOT: zero width def flags_for(av, flags): add, delete = av[1], av[2] return (flags | add) & ~delete # ---------------------------------------------------------------- explanation def quant_text(lo, hi, name): mode = {"MAX_REPEAT": "greedy", "MIN_REPEAT": "lazy", "POSSESSIVE_REPEAT": "possessive"}[name] if hi == MAXREPEAT: base = {0: "zero or more", 1: "one or more"}.get(lo, f"{lo} or more") elif lo == hi: return f"exactly {lo}" elif (lo, hi) == (0, 1): base = "optional (zero or one)" else: base = f"{lo} to {hi}" return f"{base} ({mode})" def class_text(items): negate = bool(items) and op_name(items[0][0]) == "NEGATE" parts = [] for op, av in items: name = op_name(op) if name == "LITERAL": parts.append(show_char(av)) elif name == "RANGE": parts.append(f"{show_char(av[0])}-{show_char(av[1])}") elif name == "CATEGORY": parts.append(CATEGORY_TEXT.get(op_name(av), op_name(av))) return ("any char except " if negate else "one of: ") + ", ".join(parts) def explain(seq, group_names, flags, depth=0, out=None): out = [] if out is None else out pad = " " * depth i = 0 while i < len(seq): op, av = seq[i] name = op_name(op) if name == "LITERAL": # merge runs of literals j = i while j < len(seq) and op_name(seq[j][0]) == "LITERAL": j += 1 text = "".join(chr(a) for _, a in seq[i:j]) out.append(f"{pad}the text {text!r}" if j - i > 1 else f"{pad}the char {show_char(av)}") i = j continue if name == "NOT_LITERAL": out.append(f"{pad}any char except {show_char(av)}") elif name == "IN": out.append(f"{pad}{class_text(av)}") elif name == "ANY": out.append(f"{pad}any char" + ("" if flags & re.DOTALL else " except newline")) elif name == "AT": out.append(f"{pad}{AT_TEXT.get(op_name(av), op_name(av))}") elif name in ("MAX_REPEAT", "MIN_REPEAT", "POSSESSIVE_REPEAT"): lo, hi, sub = av out.append(f"{pad}{quant_text(lo, hi, name)} of:") explain(sub, group_names, flags, depth + 1, out) elif name == "SUBPATTERN": g = av[0] if g is None: out.append(f"{pad}non-capturing group:") else: label = f' "{group_names[g]}"' if g in group_names else "" out.append(f"{pad}capturing group {g}{label}:") explain(av[3], group_names, flags_for(av, flags), depth + 1, out) elif name == "ATOMIC_GROUP": out.append(f"{pad}atomic group (no backtracking into it):") explain(av, group_names, flags, depth + 1, out) elif name == "BRANCH": out.append(f"{pad}either:") for k, b in enumerate(av[1]): out.append(f"{pad} option {k + 1}:") explain(b, group_names, flags, depth + 2, out) elif name in ("ASSERT", "ASSERT_NOT"): direction, sub = av kind = ("lookbehind" if direction < 0 else "lookahead") neg = "negative " if name == "ASSERT_NOT" else "" out.append(f"{pad}{neg}{kind} (checks without consuming):") explain(sub, group_names, flags, depth + 1, out) elif name == "GROUPREF": out.append(f"{pad}the same text as group {av} matched") elif name == "GROUPREF_EXISTS": out.append(f"{pad}if group {av[0]} matched:") explain(av[1], group_names, flags, depth + 1, out) if av[2]: out.append(f"{pad}otherwise:") explain(av[2], group_names, flags, depth + 1, out) else: out.append(f"{pad}{name}") i += 1 return out # ---------------------------------------------------------------- risk analysis def walk_repeats(seq, flags, path=""): """Yield (op, av, flags) for every repeat node, outside lookarounds too.""" for op, av in seq: name = op_name(op) if name in ("MAX_REPEAT", "MIN_REPEAT", "POSSESSIVE_REPEAT"): yield op, av, flags yield from walk_repeats(av[2], flags) elif name == "SUBPATTERN": yield from walk_repeats(av[3], flags_for(av, flags)) elif name == "ATOMIC_GROUP": yield from walk_repeats(av, flags) elif name == "BRANCH": for b in av[1]: yield from walk_repeats(b, flags) elif name in ("ASSERT", "ASSERT_NOT"): yield from walk_repeats(av[1], flags) def flatten(seq): """Expand groups so the body of a repeat can be read as one token list.""" out = [] for op, av in seq: name = op_name(op) if name == "SUBPATTERN" and av[1] == 0 and av[2] == 0: out.extend(flatten(av[3])) else: out.append((op, av)) return out def token_width(tok, parsed): return sre_parse.SubPattern(parsed.state, [tok]).getwidth() def all_chars(seq, flags): """Every ALPHABET char a token sequence can consume anywhere (not only first).""" acc = set() for op, av in seq: name = op_name(op) if name in ("LITERAL", "NOT_LITERAL", "IN", "ANY"): acc |= token_first(op, av, flags)[0] elif name in ("MAX_REPEAT", "MIN_REPEAT", "POSSESSIVE_REPEAT"): acc |= all_chars(av[2], flags) elif name == "SUBPATTERN": acc |= all_chars(av[3], flags_for(av, flags)) elif name == "ATOMIC_GROUP": acc |= all_chars(av, flags) elif name == "BRANCH": for b in av[1]: acc |= all_chars(b, flags) elif name == "GROUPREF_EXISTS": acc |= all_chars(av[1], flags) | all_chars(av[2] or [], flags) elif name == "GROUPREF": acc |= set(ALPHABET) return acc def has_unbounded(tok): op, av = tok name = op_name(op) if name in ("MAX_REPEAT", "MIN_REPEAT"): return av[1] == MAXREPEAT or has_unbounded_seq(av[2]) if name == "SUBPATTERN": return has_unbounded_seq(av[3]) if name == "BRANCH": return any(has_unbounded_seq(b) for b in av[1]) return False def has_unbounded_seq(seq): return any(has_unbounded(t) for t in seq) def sample_char(chars): for pool in (string.ascii_lowercase, string.digits, string.ascii_uppercase, ALPHABET): for c in pool: if c in chars: return c return None def analyze(parsed, flags, pattern, modes_seen): risks = [] def add(level, rule, msg, probe=None): risks.append({"level": level, "rule": rule, "message": msg, **({"probe": probe} if probe else {})}) # nested quantifiers: a repeat whose body can match the same text in more than one way for op, av, fl in walk_repeats(list(parsed), flags): if op_name(op) == "POSSESSIVE_REPEAT" or av[1] <= 1: continue body = flatten(av[2]) widths = [token_width(t, parsed) for t in body] if sum(w[0] for w in widths) == sum(w[1] for w in widths): continue # fixed-width body such as (\d{4}-)+ cannot be split two ways variable = [t for t, w in zip(body, widths) if w[0] != w[1]] fixed = [t for t, w in zip(body, widths) if w[0] == w[1] and w[0] > 0] var_chars = set().union(*(all_chars([t], fl) for t in variable)) has_inner_loop = any(has_unbounded(t) for t in variable) overlap = set().union(*(all_chars([t], fl) for t in fixed)) & var_chars if fixed else set() sample = sample_char(overlap) or sample_char(var_chars) if not fixed and has_inner_loop: add("high", "nested-quantifier", "a quantifier sits inside another quantifier and nothing else in the outer repeat is " "required (the classic (a+)+ or (\\w+\\s?)+ shape), so one string can be split in " "exponentially many ways; rewrite as a single repeat, make the separator required, or use an " "atomic group or possessive quantifier (Python 3.11+)", probe=sample) elif any(not (all_chars([t], fl) & var_chars) for t in fixed): if has_inner_loop: add("info", "nested-separated", "nested quantifier with a required separator that the inner repeat cannot match " "(like ([\\w-]+\\.)+); this shape is safe") elif all(all_chars([t], fl) <= var_chars for t in fixed): add("high", "ambiguous-repeat", "the body of a repeat has variable length and every required part can also be eaten by " "the variable part (for example (x+x+)+, (aa|a)+, or (\\w+|\\d+)+), so the iterations " "can be split in exponentially many ways; merge the parts into one class or make each " "iteration start with a char the rest cannot match", probe=sample) else: add("warn", "nested-overlap", "a repeat with a variable-length body whose separator is also accepted by the inner part " "(for example ([\\w.]+\\.)+): long non-matching input can slow down sharply; make the inner " "class exclude the separator", probe=sample) # adjacent overlapping unbounded repeats in any sequence seen_pairs = set() def single_char_repeat(op, av): return (op_name(op) in ("MAX_REPEAT", "MIN_REPEAT") and av[1] == MAXREPEAT and len(av[2]) == 1 and op_name(av[2][0][0]) in ("LITERAL", "NOT_LITERAL", "IN", "ANY")) def scan_adjacent(seq, fl): toks = [t for t in flatten(seq) if op_name(t[0]) not in ("AT", "ASSERT", "ASSERT_NOT")] for (a_op, a_av), (b_op, b_av) in zip(toks, toks[1:]): if single_char_repeat(a_op, a_av) and single_char_repeat(b_op, b_av): if (id(a_av), id(b_av)) in seen_pairs: continue seen_pairs.add((id(a_av), id(b_av))) fa, _ = first_info(a_av[2], fl) fb, _ = first_info(b_av[2], fl) if fa & fb: add("warn", "adjacent-overlap", "two unbounded quantifiers in a row accept the same chars (for example \\d+\\d+ or " ".*.*), so the split between them is ambiguous and failures backtrack polynomially; " "keep one of them") for op, av in seq: name = op_name(op) if name == "SUBPATTERN": scan_adjacent(av[3], flags_for(av, fl)) elif name in ("MAX_REPEAT", "MIN_REPEAT", "POSSESSIVE_REPEAT"): scan_adjacent(av[2], fl) elif name == "BRANCH": for b in av[1]: scan_adjacent(b, fl) scan_adjacent(list(parsed), flags) # text-level checks if re.search(r"\[[^\]]*A-z", pattern): add("warn", "range-A-z", "[A-z] also matches [ \\ ] ^ _ and the backtick; use [A-Za-z]") seq = list(parsed) flat = flatten(seq) for k, (op, _av) in enumerate(flat): if op_name(op) != "ANY": continue before = flat[k - 1] if k else None after = [chr(a) for o, a in flat[k + 1:k + 4] if op_name(o) == "LITERAL"] lit_before = before is not None and op_name(before[0]) == "LITERAL" and chr(before[1]).isalnum() word_after = len(after) >= 2 and all(c.isalpha() for c in after[:2]) if (lit_before and after and after[0].isalnum()) or word_after: add("warn", "unescaped-dot", f"'.' before {''.join(after) or 'the next token'!r} matches any char (so a '-' or 'x' passes there too); " "write \\. for a literal dot") break try: if re.compile(pattern, flags).fullmatch(""): add("warn", "matches-empty", "the pattern matches the empty string, so findall/finditer return empty matches and " "validation accepts blank input; require at least one char where it matters") except re.error: pass count_dotstar = len(re.findall(r"(?<!\\)\.\*", pattern)) if count_dotstar >= 3: add("info", "many-dotstar", f"{count_dotstar} '.*' in one pattern: failures are slow on long lines; " "use negated classes like [^,]* to describe each field") elif count_dotstar and not re.search(r"\.\*\?", pattern): add("info", "greedy-dotstar", "greedy .* grabs as much as possible and then backs off; use .*? or a " "negated class such as [^\"]* when you mean 'up to the next ...'") first_ops = [op_name(op) for op, _ in seq[:1]] last = seq[-1] if seq else None anchored_start = first_ops == ["AT"] anchored_end = last is not None and op_name(last[0]) == "AT" and op_name(last[1]) in ("AT_END", "AT_END_STRING") if "fullmatch" not in modes_seen and not (anchored_start and anchored_end) and modes_seen != {"findall"}: add("info", "not-anchored", "for validation, anchor both ends (\\A ... \\Z) or use re.fullmatch; " "otherwise 'abc123xyz' passes a search for \\d+") if anchored_end and op_name(last[1]) == "AT_END" and not flags & re.MULTILINE and "fullmatch" not in modes_seen: add("info", "dollar-newline", "$ also matches before a trailing newline ('abc\\n' passes ^abc$); " "use \\Z or fullmatch for strict validation") if re.search(r"(?<!\\)\\[dw]", pattern) and not flags & re.ASCII: add("info", "unicode-classes", "\\d and \\w match Unicode digits and letters too (for example " "Arabic-Indic digits); add re.ASCII or use [0-9] / [A-Za-z0-9_] for strict input formats") return risks # ---------------------------------------------------------------- probe PROBE_CODE = r""" import re, sys, time pat, flags, s = sys.argv[1], int(sys.argv[2]), sys.argv[3] rx = re.compile(pat, flags) t = time.perf_counter(); rx.search(s); print(f"{time.perf_counter() - t:.6f}") """ def run_probe(pattern, flags, ch, compiled): tail = next((t for t in "!#\x00~ \n" if not compiled.search(ch * 3 + t)), "!") results, verdict = [], "no slowdown seen" for n in (12, 16, 20, 24, 28): s = ch * n + tail try: r = subprocess.run([sys.executable, "-c", PROBE_CODE, pattern, str(flags), s], capture_output=True, text=True, timeout=2) secs = float(r.stdout.strip() or "nan") except subprocess.TimeoutExpired: results.append({"n": n, "seconds": None}) verdict = f"TIMEOUT at length {n + 1}: exponential backtracking confirmed" break results.append({"n": n, "seconds": round(secs, 4)}) prev = results[-2]["seconds"] if len(results) >= 2 else None if prev and secs > 0.01 and secs / prev > 3: verdict = (f"time grows about {secs / prev:.0f}x per +4 chars: exponential backtracking confirmed") elif secs > 0.5: verdict = f"slow ({secs:.2f} s at length {n + 1}) but not clearly exponential" return {"input": f"{ch!r} * n + {tail!r}", "timings": results, "verdict": verdict} # ---------------------------------------------------------------- matching def read_cases(path): text = sys.stdin.read() if path == "-" else open(path, encoding="utf-8").read() cases = [] for raw in text.splitlines(): if not raw.strip() or raw.lstrip().startswith("#"): continue if raw.startswith("+ ") or raw.startswith("- "): cases.append({"text": raw[2:], "expect": raw[0] == "+"}) else: cases.append({"text": raw, "expect": None}) return cases def match_case(rx, text, mode): fn = {"search": rx.search, "match": rx.match, "fullmatch": rx.fullmatch}.get(mode) names = {v: k for k, v in rx.groupindex.items()} def groups(m): out = [] for g in range(1, rx.groups + 1): out.append({"group": g, "name": names.get(g), "value": m.group(g), "span": list(m.span(g)) if m.group(g) is not None else None}) return out if mode == "findall": ms = list(rx.finditer(text)) return {"matched": bool(ms), "matches": [{"text": m.group(0), "span": list(m.span()), "groups": groups(m)} for m in ms]} m = fn(text) if not m: return {"matched": False, "matches": []} return {"matched": True, "matches": [{"text": m.group(0), "span": list(m.span()), "groups": groups(m)}]} def describe_flags(flags): names = [n for f, n in FLAG_NAMES if flags & f] return ", ".join(names) if names else "none" # ---------------------------------------------------------------- main def parse_args(argv): opts = {"texts": [], "cases": None, "mode": "search", "flags": 0, "probe": False, "explain": True, "json": False, "fail_on": "high", "pattern": None, "timeout": 2.0} i = 0 while i < len(argv): a = argv[i] def val(): if i + 1 >= len(argv): raise UsageError(f"{a} needs a value") return argv[i + 1] if a in ("-t", "--text"): opts["texts"].append(val()); i += 2 elif a == "--cases": opts["cases"] = val(); i += 2 elif a == "--mode": opts["mode"] = val(); i += 2 if opts["mode"] not in ("search", "match", "fullmatch", "findall"): raise UsageError("--mode must be search, match, fullmatch, or findall") elif a == "--flags": letters = val(); i += 2 bad = [c for c in letters.lower() if c not in FLAG_LETTERS] if bad: raise UsageError(f"unknown flag letter(s) {''.join(bad)!r}; use any of i m s x a") for c in letters.lower(): opts["flags"] |= FLAG_LETTERS[c] elif a == "--fail-on": opts["fail_on"] = val().lower(); i += 2 if opts["fail_on"] not in ("high", "warn", "info", "never"): raise UsageError("--fail-on must be high, warn, info, or never") elif a == "--timeout": try: opts["timeout"] = float(val()) except ValueError: raise UsageError("--timeout needs a number of seconds, for example --timeout 2") i += 2 elif a == "--probe": opts["probe"] = True; i += 1 elif a == "--no-explain": opts["explain"] = False; i += 1 elif a == "--json": opts["json"] = True; i += 1 elif a in ("-h", "--help"): print(__doc__); sys.exit(0) elif a.startswith("--") and opts["pattern"] is not None: raise UsageError(f"unknown option {a}") elif opts["pattern"] is None: opts["pattern"] = a; i += 1 else: raise UsageError(f"unexpected argument {a!r} (quote the pattern; use -t for sample inputs)") if opts["pattern"] is None: raise UsageError("give a PATTERN (quote it in single quotes in the shell)") return opts def main(argv): try: opts = parse_args(argv) cases = [{"text": t, "expect": None} for t in opts["texts"]] if opts["cases"]: try: cases += read_cases(opts["cases"]) except OSError as e: raise UsageError(f"cannot read cases file: {e.strerror}: {opts['cases']}") except UsageError as e: print(f"error: {e}", file=sys.stderr) return 2 pattern, flags, mode = opts["pattern"], opts["flags"], opts["mode"] try: rx = re.compile(pattern, flags) parsed = sre_parse.parse(pattern, flags) except re.error as e: pos = f" at position {e.pos}" if e.pos is not None else "" print(f"error: pattern does not compile: {e.msg}{pos}", file=sys.stderr) if e.pos is not None: print(f" {pattern}\n {' ' * e.pos}^", file=sys.stderr) return 2 flags = int(rx.flags) & ~int(re.UNICODE) names = {v: k for k, v in rx.groupindex.items()} risks = analyze(parsed, flags, pattern, {mode}) if opts["probe"]: for r in risks: if r.get("probe"): r["probe_result"] = run_probe(pattern, flags, r["probe"], rx) results = [] for c in cases: try: res = with_timeout(opts["timeout"], match_case, rx, c["text"], mode) status = None if c["expect"] is None else ("PASS" if res["matched"] == c["expect"] else "FAIL") except MatchTimeout: res, status = {"matched": None, "matches": []}, "TIMEOUT" results.append({**c, **res, "status": status}) fails = sum(1 for r in results if r["status"] in ("FAIL", "TIMEOUT")) counts = {lvl: sum(1 for r in risks if r["level"] == lvl) for lvl in ("high", "warn", "info")} report = {"pattern": pattern, "flags": describe_flags(flags), "mode": mode, "groups": rx.groups, "group_names": {str(k): v for k, v in names.items()}, "explanation": explain(list(parsed), names, flags) if opts["explain"] else [], "cases": results, "failed_expectations": fails, "risks": risks, "risk_counts": counts} threshold = LEVELS.get(opts["fail_on"], 99) risky = any(LEVELS[r["level"]] >= threshold for r in risks) if opts["json"]: print(json.dumps(report, indent=2, ensure_ascii=False)) return 1 if fails or risky else 0 print(f"Pattern: {pattern}") named = ", ".join(f'{g} "{n}"' for g, n in sorted(names.items())) print(f"Flags: {describe_flags(flags)} | mode: {mode} | groups: {rx.groups}" + (f" ({named})" if named else "")) if opts["explain"]: print("\nExplanation:") for line in report["explanation"]: print(" " + line) if results: print(f"\nSamples ({mode}):") for r in results: mark = {True: "+", False: "-", None: " "}[r["expect"]] tag = r["status"] or ("match" if r["matched"] else "no match") line = f" {tag:<8} {mark} {r['text']!r}" if r["matched"]: parts = [] for m in r["matches"][:5]: g = " ".join(f"{x['name'] or x['group']}={x['value']!r}" for x in m["groups"]) parts.append(f"[{m['span'][0]}:{m['span'][1]}] {m['text']!r}" + (f" {g}" if g else "")) more = f" (+{len(r['matches']) - 5} more)" if len(r["matches"]) > 5 else "" line += " -> " + "; ".join(parts) + more elif r["status"] == "TIMEOUT": line += f" -> still running after {opts['timeout']:g} s (catastrophic backtracking)" elif r["status"] == "FAIL": line += " -> expected a match" if r["status"] == "FAIL" and r["matched"]: line += " (expected no match)" print(line) print("\nRisks and suggestions:") if not risks: print(" none found") for r in risks: print(f" {r['level'].upper():<4} {r['rule']:<23} {r['message']}") pr = r.get("probe_result") if pr: times = ", ".join(f"n={t['n']}: {'timeout' if t['seconds'] is None else str(t['seconds']) + ' s'}" for t in pr["timings"]) print(f" probe {pr['input']}: {times} -> {pr['verdict']}") summary = f"\nSummary: HIGH {counts['high']} WARN {counts['warn']} INFO {counts['info']}" if any(r["expect"] is not None for r in results): n = sum(1 for r in results if r["expect"] is not None) summary += f" | expectations {n - fails}/{n} pass" timeouts = sum(1 for r in results if r["status"] == "TIMEOUT") if timeouts: summary += f" | {timeouts} sample(s) timed out" print(summary) return 1 if fails or risky else 0 if __name__ == "__main__": sys.exit(main(sys.argv[1:]))

